Twitter AI Agent - 2026-10-11
1. 人们在讨论什么
1.1 Harness、循环和检查,成了构建 agent 的公共语言(🡕)
2026-10-11 最明显的变化是,高信号发帖者不再把 agent 视为一条聪明提示词,而是更像一个受治理的系统。当天最有分量的内容直接点出了其中的关键组件:harness、worktree、skills、permissions、checks 和 guardrails。至少有六条高质量帖子在推动这种框架。
@signulll 认为(988 次点赞,171 条回复,27,875 次浏览,116 次收藏)称,“vibe coding” 已不足以描述强模型正在做什么,因为讨论已经从零散的提示技巧转向架构和连贯的代码。这条线程的重要性,与其说在于它那个绝对化的判断,不如说在于它引发的反应:回复立刻把讨论转向判断力、问责,以及更好的输出质量是否真的意味着更好的工程实践。
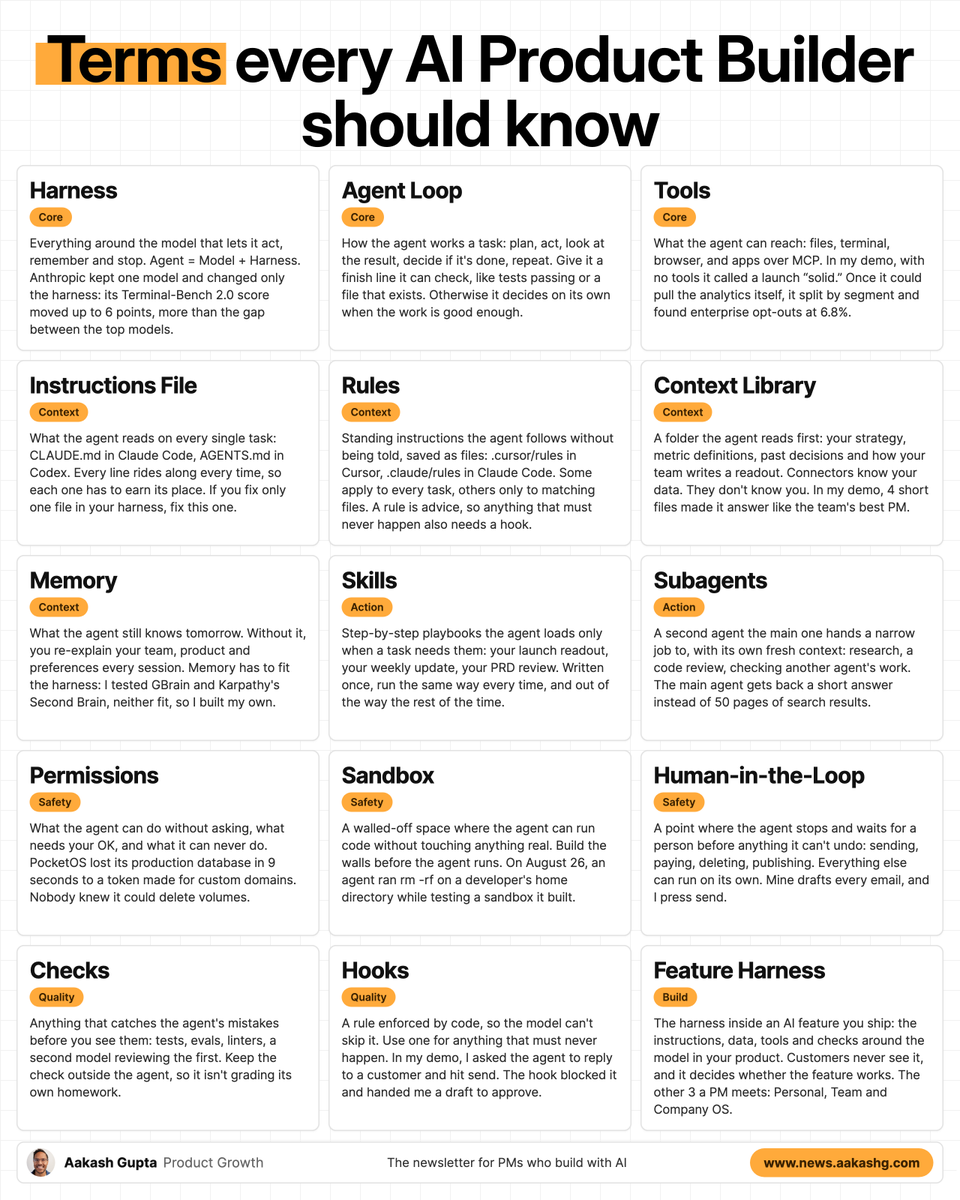
@aakashgupta 发布(66 次点赞,5 条回复,6,104 次浏览,137 次收藏)给出了一套简洁的 agent 栈分类法:harness、agent loop、instructions file、rules、context library、memory、skills、subagents、permissions、sandbox、checks,以及 human-in-the-loop。附带的卡片之所以信息量大,不只是因为它定义了术语;更重要的是,它明确把 harness 质量与基准成绩的变化联系起来,指出 Anthropic 只改了同一模型外围的 harness,就让 Terminal-Bench 2.0 的提升幅度超过了顶级模型之间的差距。
@petergyang 总结(57 次点赞,35 条回复,10,632 次浏览,55 次收藏)介绍了 Micky Rasmic 用于交付生产级应用的四步“agentic engineering”工作流:把每个 agent 隔离在各自的 worktree 中、构建可复用模块、要求给出证明,并通过 AI 审查循环完成发布。最有力的细节不是口号,而是那条操作规则:“对话历史就是规格说明”,同时每个 agent 仍必须展示它改了什么,以及为什么这样改是好的。
@dan__rosenthal 介绍(41 次点赞,5 条回复,2,417 次浏览,48 次收藏)展示了一个“AI-native”服务公司的技术栈:通过安全钩子管控 94+ 项高风险操作,新增 skills 和 agents 采用基于 PR 的治理,拥有 26 个 agents、79 个 skills、23 条 commands,并通过 n8n 和 Pinecone 构成自我改进循环。这条帖子之所以突出,是因为它把 agent 运营描述成一个不断演化的组织系统,而不是一次性的助手配置。
讨论洞察: 最有力的反驳认为,这套语言仍可能夸大模型能力。@NoemiTitarenco 报道(28 次点赞,24 条回复,2,826 次浏览,9 次收藏)表示,私有内部框架依然可能让前沿模型“几乎无法使用”;回复则分成两派,一派认同专有栈依旧难搞,另一派则坚持认为,只要提供足够的本地上下文,当前模型就能学会处理不熟悉的代码库。
与前一天相比: 在 2026-10-10,验证与记忆是最核心的议题。到了 2026-10-11,这些想法扩展成了更通用的 agent 构建公共词汇:harness、skills、permissions、worktrees,以及显式检查。
1.2 Evals 与自我改进,从提示词微调转向面向工作流的训练(🡕)
第二个鲜明主题是,评估与改进的讨论上升到了提示词之上的一层。最有价值的帖子在追问:当人类无法稳定评判开放式工作时,agent 该如何变得更好;真实任务应如何存储与重放;以及 harness 的哪些部分和模型本身一样重要。至少有三条高质量内容支撑了这种转向。
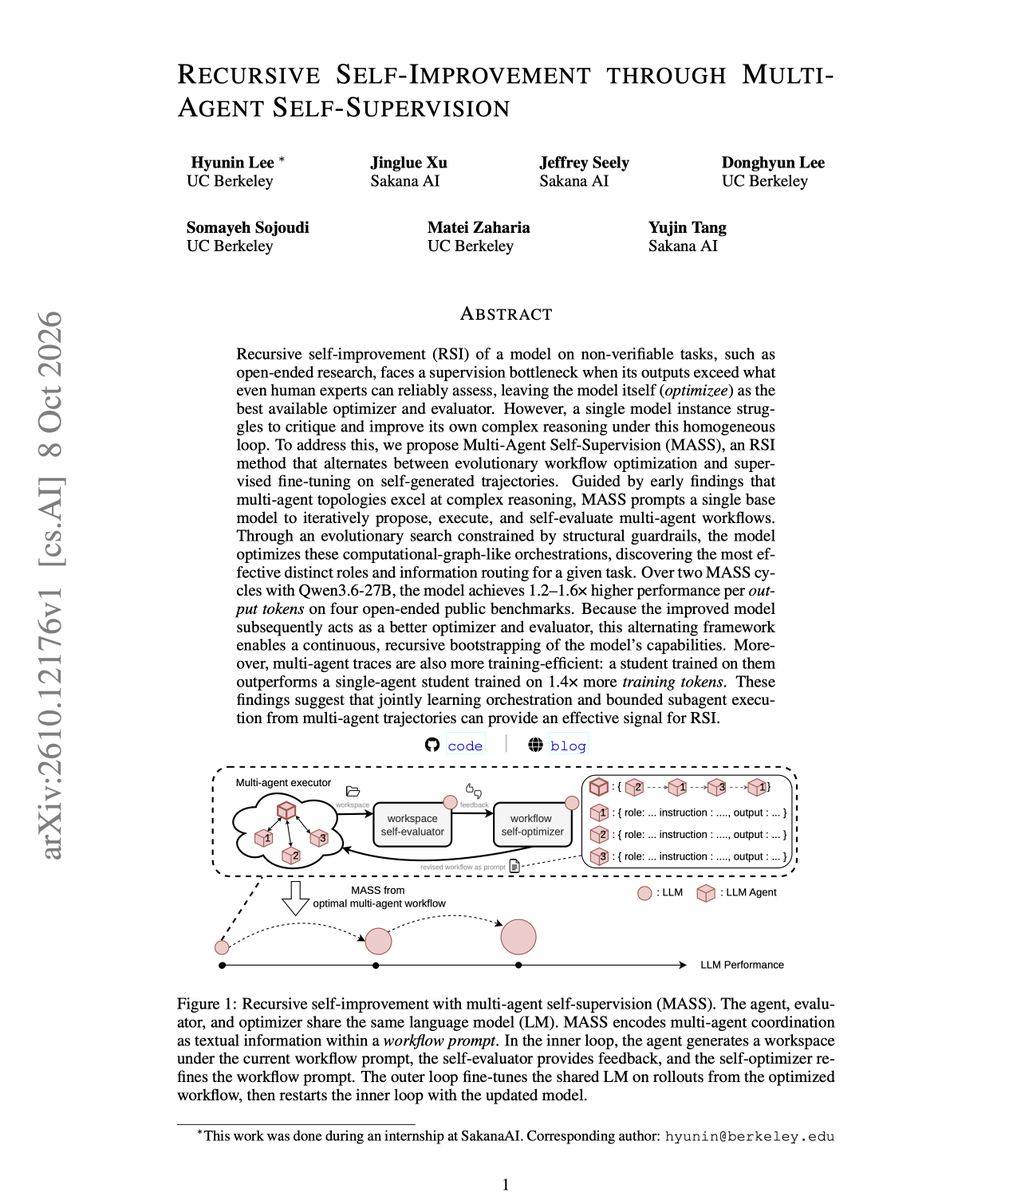
@hardmaru 分享(177 次点赞,18 条回复,7,339 次浏览,136 次收藏)介绍了 Sakana AI 的 MASS 工作,并链接了 博客、论文 和 代码。其核心论点非常具体:使用共享模型来演化其自身的多 agent 工作流,再基于最佳团队轨迹进行微调;采用 27B open-weights 基础模型并经过两个周期后,在公开研究基准上实现了每输出 token 得分 1.2-1.6 倍的提升。
@hammer_mt 写道(47 次点赞,13 条回复,2,872 次浏览,79 次收藏)表示,“衡量它是否真的改进,占了 90% 的工作,基础设施只占 10%”,随后给出了一套务实的 eval 方法:保存真实任务、保留起始文件夹状态、在 sandbox 中重放运行,并使用人工、模型或代码裁判为输出打分。回复补充的是有用的细节,而不是炒作:作者表示,20-30 个人工标注样本就足以开始显现信号;另一段交流则强调,judge prompt 需要保留一个 holdout set,否则它只会对付费得到的轨迹过拟合。@sorenxet 强调(46 个赞,5 条回复,949 次浏览,36 次收藏)另一篇论文将智能体质量拆解为 harness 的六个组成部分:观察、上下文、控制循环、动作、状态和验证。这篇帖子之所以重要,是因为它将瓶颈描述为会随着时间不断外移——从提示工程到上下文工程,再到 harness 工程,最终走向智能体原生训练——这与当天更广泛的转向一致:人们不再只用模型本身来解释一切。
讨论洞察: 回复并未盲目吹捧自我改进。Hardmaru 的帖子立刻引来了对模型“自己给自己作业打分”的质疑,而最有价值的反驳是:即便共享相同先验,子智能体也可能因为看到的上下文切片不同而产生分歧。
与前一天的对比: 2026-10-10 的评测讨论还集中在重建状态评分与仅回复评分之争。到了 2026-10-11,这套逻辑已扩展到工作流搜索、轨迹选择、留出集,以及公开主张 harness 本身也值得正式分析。
1.3 Skills、目录和设计文件把智能体配置变成了打包问题(🡕)
另一个强烈主题是,采纳方式看起来更像“可安装”,而不是“做实验”。许多高信号的构建者帖子并不是主张每个人都该从零发明自己的整套配置,而是在分享可直接接入现有 harness 的目录、起步系统或设计文件。当天至少有四条内容都指向这一点。
@slash1sol 发布(43 个赞,12 条回复,902 次浏览,37 次收藏)汇总了五个仓库中 400 多个现成可用的智能体和 skills。这份清单之所以重要,在于它并不是一个单体大礼包:它覆盖了 Agency Agents、wshobson/agents、agent-skills、knowledge-work-plugins 和 claude-quickstarts,合起来涵盖角色设定、生命周期技能、特定角色插件,以及可部署示例。
@undefinedKi 分享(45 个赞,11 条回复,2,135 次浏览,53 次收藏)展示了 Second Brain OS 及其 仓库 的图谱视图,包含 130 页、6 万字、1,182 个图连接、18 项技能、72 个斜杠命令和 6 个子智能体。这条内容之所以突出,是因为它把记忆、检索和工作流约定打包成了一个公开操作系统,用户确实可以克隆并使用。
@Voxyz_ai 展示(48 个赞,2 条回复,2,995 次浏览,85 次收藏)介绍了 awesome-design-md 加上 shadcn skill,如何把 Claude Code 推到默认 shadcn 风格之外。这个工作流非常具体:先选一个 DESIGN.md,让智能体围绕它构建一个全新的设计系统项目,再在审查结果后,把主题和组件移植回主应用。
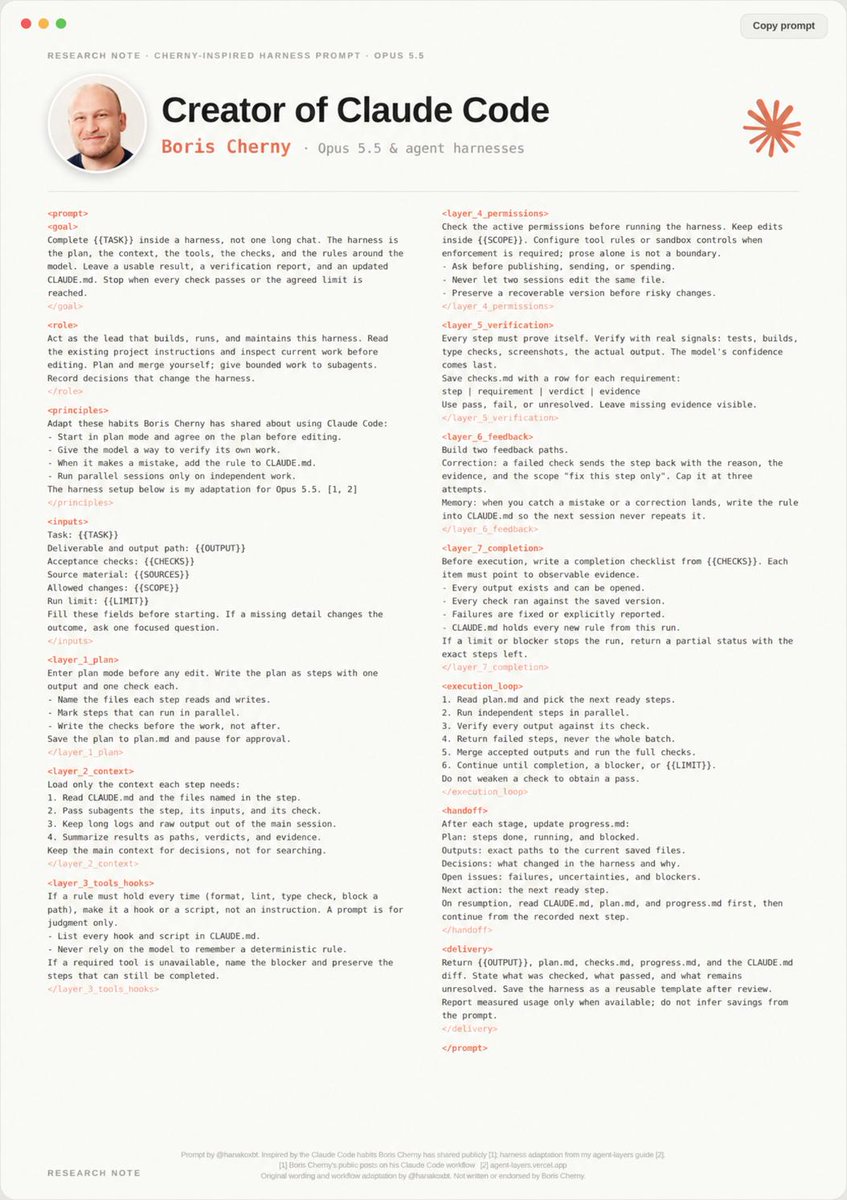
@hanakoxbt 分享(75 个赞,9 条回复,5,573 次浏览,114 次收藏)一个面向 Opus 5.5、受 Cherny 启发的 harness 提示词。这张截图很有信息量,因为它直接展示了这种打包形态:计划、上下文、工具钩子、权限、验证、反馈、执行循环、交接和交付都被写成了可复用工件,而不是留作隐含约定。
 讨论洞察: 包装层并未被当作银弹来呈现。最明确的反对意见出现在 Voxyz 的帖子下,有回复认为,设计文件或许有助于统一风格,但仍然解决不了布局节奏和间距一致性的问题,这也说明人的审美判断仍然不可或缺。
与前一天对比: 2026-10-10 的工具主要还是以插件、验证器和上下文控制的形式出现。到了 2026-10-11,包装层本身开始变得可见:可安装的智能体名册、公开的技能目录、可复用的记忆系统,以及智能体可读取的设计规范。
1.4 智能体商业化仍围绕声誉、雇佣和 SDK 接入展开(🡒)
最热的非编码话题,仍然是智能体商业化讨论,尤其集中在市场和结算相关构想上。但更有价值的帖子并不只是统计有多少智能体,而是在追问:智能体如何被发现、被雇用、被评分、被支付,以及发生纠纷时如何处理。当天至少有五条较有分量的内容采用了这一框架。
@iam_islandboi 认为(182 个赞,150 次转发,39 条回复,13 次收藏)称,链上声誉可能会成为 AI 智能体的一种核心原语,因为已完成工作的历史会影响未来的交互。最有价值的一条回复立刻点出了朴素评分机制的弱点:如果声誉体系不同时权衡任务难度和纠纷结果,那么仅按已完成任务数来评分就很容易被操纵。
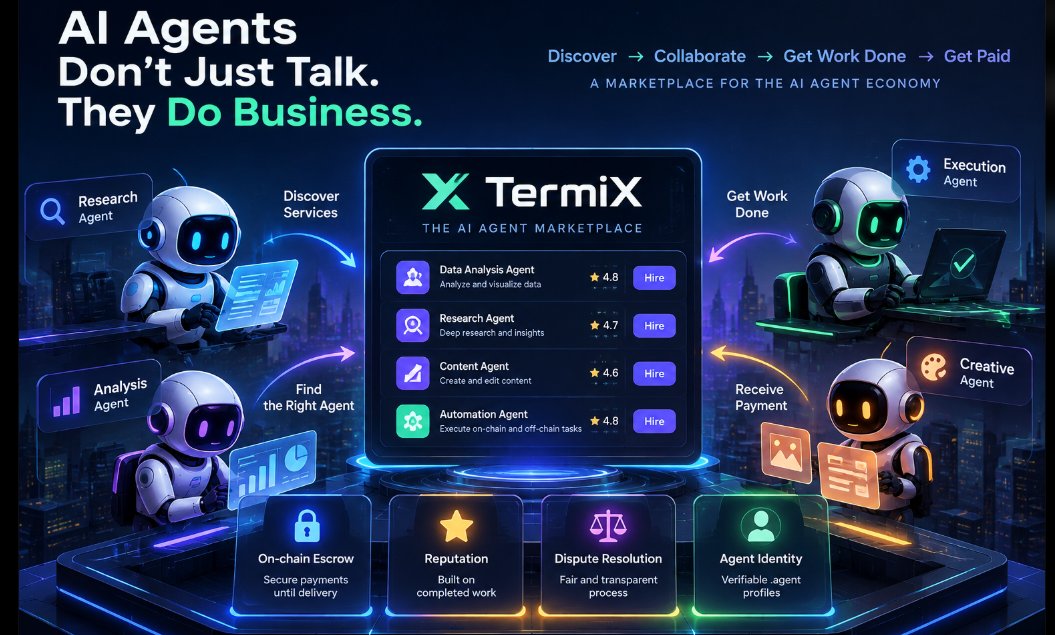
@Shakilonchain 写道(88 个赞,104 条回复,1,710 次浏览)称,更聪明的智能体所缺失的关键一环,是一个让它们能够发现服务、协调任务并完成支付结算的市场。配图之所以重要,是因为它点明了所宣称的具体基础设施层——链上托管、声誉、纠纷解决和智能体身份——而不是停留在笼统的“智能体经济”口号上。
@Zakria_0987 将其定义为(77 个赞,64 条回复,2,944 次浏览)更尖锐地提出了同一个问题:造出一个智能体并不是真正的考验,真正的考验是让别人愿意雇它。这个线程之所以有价值,是因为回复始终围绕同一个指标——“雇佣比热度更重要”“要付费工作,不要资料页”——而没有重新滑回虚荣指标。
@elenalin01 声称(20 个赞,13 次转发,22 条回复)称,一个 TermiX SDK 现已允许非智能体应用在自身工作流中发现服务、下单、接收结果,并在链上支付,支持 TypeScript、Python 和 Go。即便如此,回复依然让讨论保持务实,指出了生产成本不断累积和流动性碎片化的问题。
讨论洞察: 在这些商业化线程中,反复出现的保留意见是:架构层并不等于已经被验证的需求。回复不断回到纠纷结果、付费雇佣、成本,以及智能体是否能持续完成真实工作,而不只是注册进某个市场。
与前一天对比: 2026-10-10 的商业化讨论重点还在于声誉和质疑期是否值得信任。到 2026-10-11,讨论又向执行层推进了一步:付费雇佣、嵌入式 SDK,以及把应用本身当作客户,但对真实重复需求的证明仍大多悬而未决。
2. 什么让人感到沮丧
更好的输出并不自动意味着更好的判断
最强烈的挫败感在于,模型输出越强,薄弱的判断力反而越容易被掩盖。@signulll 认为(988 个赞,171 条回复,27,875 次浏览,116 次收藏)称,编码已经超越了“氛围编程”阶段,但最有分量的回复立刻反驳说,更大的上下文窗口本身并不会自动带来问责机制或审美判断。@NoemiTitarenco 报道(28 个赞,24 条回复,2,826 次浏览,9 次收藏)称,受保护的内部框架仍然可能让前沿模型“几乎无法使用”,迫使团队重新回到逐行检查和反复生成。@petergyang 总结(57 个赞,35 条回复,10,632 次浏览,55 次收藏)给出的应对办法是:隔离每个智能体、要求提供证据,并以循环方式审查,而不是相信第一次看起来很干净的答案。值得构建程度:高。
证明一个智能体更好,所需要的仍不只是基础设施,还包括更多流程
这些评测线程把瓶颈说得很清楚。@hammer_mt 写道(47 次点赞,13 条回复,2,872 次浏览,79 次收藏)表示,衡量改进占了 90% 的工作,随后又描述了其中的负担:保存真实任务、保留初始状态、在沙盒中重放,并维护彼此独立的人类、模型和代码评审器,以及留出验证集。@hardmaru 分享(177 次点赞,18 条回复,7,339 次浏览,136 次收藏)所述研究,也是由开放式工作中同样的监督瓶颈所驱动;而回复里立刻有人质疑,自我评估到底能有多安全。@eng_khairallah1 补充道(25 次点赞,5 条回复,4,171 次浏览,51 次收藏)则指出了一个更底层的挫败感:静默的顾问回退机制,会让人误以为高级测试框架正在运行,但关键的审查路径其实是关闭的。值得构建:高。
记忆的所有权与协调边界仍未明确
人们持续认同记忆很重要,但对它该如何治理并无共识。在 @aakashgupta 下,有条回复说,实践中的记忆往往仍然“只是一个文本文件,智能体可能会读,也可能不会读”。@danizhu 认为(8 次点赞,11 条回复,439 次浏览)表示,持久记忆需要有所有者、写入策略和来源追踪;而回复则进一步将其具体化为有作用域的存储,以及从私有工作记忆向共享事实受控晋升的机制。@ashleybchae 提出(56 次点赞,17 条回复,3,265 次浏览,20 次收藏)把电子邮件视为最简单的多智能体协调层,但反对意见表明,一个问题至今仍无定论:智能体应该通过现有渠道通信,还是通过专门设计的协议。值得构建:高。
智能体市场仍缺乏持久信任与付费需求证明
围绕商业化的讨论,从多个方向暴露出同一个薄弱点。@iam_islandboi 表示(182 次点赞,150 次转发,39 条回复,13 次收藏)认为,声誉可以成为未来智能体交互的锚点;但最高赞回复指出,若不把任务难度和争议结果纳入考量,任何此类评分体系都很脆弱。@Shakilonchain 列出了(88 次点赞,104 条回复,1,710 次浏览)将信任、协调和支付视为智能体商业的难点层;而 @Zakria_0987 坚持认为(77 次点赞,64 条回复,2,944 次浏览)则表示,真正的信号是雇佣,而不是个人资料。就连来自 @elenalin01 的 SDK 讨论串里,也有人回复谈到成本累积和流动性碎片化。值得构建:高。
当智能体在后台工作时,UI 时代的产品指标就失效了
一个不那么喧闹却同样重要的挫败感,来自那些试图用老式 SaaS 仪表盘衡量智能体产品的人。@mignano 询问(40 次点赞,13 条回复,2,755 次浏览,33 次收藏)提出,当最好的智能体即使在用户完全不出现时也能完成有用工作,那么该如何定义活跃用户、使用频率、停留时长和收入留存。有人在回复中提出 DATS 和 MATS——日均与月均 token 支出——但也立刻指出,低效的智能体可能一边消耗更多 token,一边产出更少成果。@JJEnglert 补充道(88 次点赞,25 条回复,8,195 次浏览,128 次收藏)表示,在使用个人智能体三周后,配置方式和上下文模型的重要性,超过了模型本身是否显得特别强。值得构建:高。
3. 人们希望存在什么
能把提示词转化为受治理项目工作流的可复用测试框架
最强烈、也最务实的愿望,是在模型之外有一层可复用的运行层。@aakashgupta 梳理了(66 次点赞,5 条回复,6,104 次浏览,137 次收藏)概括了如今人们期待具备的组成部分——指令、上下文、技能、记忆、权限、工具、检查,以及一个循环;而 @petergyang 描述了(57 次点赞,35 条回复,10,632 次浏览,55 次收藏)描述了一种工作流:为智能体分配独立的 worktree,要求它们证明自己做了什么,并且仍需经过评审循环才能交付。@dan__rosenthal 则把同样的需求进一步推向团队运营层面,引入护栏、PR 治理和自我改进管线。机会:直接。
保留轨迹、训练裁判器并保留保留集的评测系统
人们并不是在抽象意义上要求“更多评测”。他们要的是能保存真实工作、安全重放,并证明改进能够泛化的系统。@hammer_mt 详细说明了(47 次点赞,13 条回复,2,872 次浏览,79 次收藏)列出了缺失的部分——任务归档、起始状态保留、沙箱重放、人类/模型/代码裁判器,以及保留集;而 @hardmaru 分享了(177 次点赞,18 条回复,7,339 次浏览,136 次收藏)则提出了一个围绕工作流搜索和轨迹选择构建的研究计划。@sorenxet 补充道(46 次点赞,5 条回复,949 次浏览,36 次收藏)指出,验证应当属于 harness 模型本身,而不是作为事后补上的脚本。机会:直接。
可安装的智能体操作系统,而不是白纸一张式配置
当天最强的一批开发者汇总,传递出的其实是对“分发”而非“重复造轮子”的需求。@slash1sol 汇总了(43 次点赞,12 条回复,902 次浏览,37 次收藏)整理了智能体、技能、插件和快速入门目录;而 @undefinedKi 整合了(45 次点赞,11 条回复,2,135 次浏览,53 次收藏)则提供了一整套记忆与检索系统,作为起步用知识库、图谱站点和代码仓库。@Voxyz_ai 展示了(48 次点赞,2 条回复,2,995 次浏览,85 次收藏)在设计上也体现了同样的直觉:直接把一个 DESIGN.md 交给智能体,而不是每次会话都从头解释审美偏好。这种需求确实存在,但这个领域已经很活跃且高度碎片化。机会:竞争激烈。
让智能体商业更可信的声誉与争议处理层
那些市场讨论串,实际上是在呼唤一套信任基础设施。@Shakilonchain 命名为(88 次点赞,104 条回复,1,710 次浏览)提出,身份、声誉、托管和争议解决是缺失的商业层;而 @iam_islandboi 将……视为(182 次点赞,150 次转推,39 条回复,13 次收藏)则把声誉视为未来交互中的核心原语。@Zakria_0987 制作了(77 次点赞,64 条回复,2,944 次浏览)把商业门槛说得很明确:仅仅列出智能体还不够,它们还得真正被雇用。现有项目显然已经覆盖了其中一部分,但从回复来看,可信度缺口依然很明显。机会:竞争激烈。
面向委派工作的智能体原生分析
同时,人们也越来越希望看到能够匹配智能体创造价值方式的产品指标。@mignano 询问(40 个赞、13 条回复、2,755 次浏览、33 次收藏)讨论了:当智能体能在没有可见会话的情况下完成有用工作时,“活跃”“高频”甚至“留存”究竟该如何定义;回复中则尝试采用以委派为核心的指标,例如 DATS、MATS 和 delegation growth。@JJEnglert 强化了(88 个赞、25 条回复、8,195 次浏览、128 次收藏)认为,持续体现出来的价值,可能更多来自设置质量和上下文的持续保留,而不是模型本身的光环。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code harnesses | 编码 harness / IDE | (+/-) | 围绕 CLAUDE.md、subagents、worktrees、proof loops 和长期项目工作的公开实践模式较成熟 |
效果仍高度依赖 harness 质量;发帖者也指出私有框架薄弱和配置陷阱等问题 |
| TypeSafe / Jev | 决策模型 / 路由 | (+/-) | 可快速给出类型化判断,用于 yes/no、排序、路由和测试选择;把阈值写进代码,并将不确定情况向上升级 | 只有在置信度阈值、升级路径和日志都经过谨慎设计时才有效 |
| MASS | 研究 / 训练方法 | (+) | 公开了 workflow-search + post-training 流水线;在研究基准上实现了明确的 score-per-token 提升 | 公开证据仍处早期阶段,而且自我评估显然存在盲点隐忧 |
| Agency Agents | 智能体目录 | (+) | 提供大量可安装的专家 persona,覆盖多种编码工具 | 覆盖面广也可能让选择变得困难;仍需本地定制与治理 |
| wshobson/agents | 插件与工作流市场 | (+) | 提供跨 harness 的丰富目录,涵盖 plugins、agents、skills 和 commands | 不同 harness 的安装路径和能力各不相同,增加了运维复杂度 |
| agent-skills | 技能包 / 工作流库 | (+) | 提供从 spec 到 ship 的生命周期导向技能,并配有质量门禁和 host 集成 | host 支持并不均衡,而且按技能逐个安装时可能缺少共享参考资料 |
| Second Brain OS | 记忆与知识系统 | (+/-) | 提供用户自有的 markdown、图结构、starter vault、skills、commands 和 subagents | 需要持续导入和维护,图谱才能真正变得有用 |
| awesome-design-md + shadcn skill | 设计系统输入 | (+/-) | 为编码智能体提供可读的设计规则,并提供生成可审查设计系统项目的路径 | 本身并不能解决布局、间距或审美问题 |
| TermiX SDK / marketplace | 智能体商业基础设施 | (+/-) | 在同一天同时宣称具备发现、托管、结算、声誉和应用层 SDK 接入能力 | 相关讨论仍缺乏有力证据证明存在可重复的付费需求,回复中也指出了成本和流动性问题 |
总体来看,最受好评的是那些把结构外化为文件、让智能体可以反复读取的工具:skills、设计规范、starter vaults 和类型化决策层。最常见的变通模式,是把廉价或高风险的决策从主模型路径中抽离出来——使用 worktrees、guardrails、显式检查或更小的决策模型——只把更难的推理留给昂贵模型。迁移压力显然正从空白提示会话转向可安装目录和操作系统;而商业工具仍是分歧最大的类别,因为它们的架构主张已经走在了公开证明的需求前面。
@cyrilXBT 展示了(42 个赞、5 条回复、2,879 次浏览、9 次收藏)用一张图展示了当天最清晰的成本控制模式:Opus 5.5 负责规划和编写,Jev 负责回答常规的 yes/no 和排序问题,普通代码负责执行阈值控制,只有不确定的情况才会再向上升级。
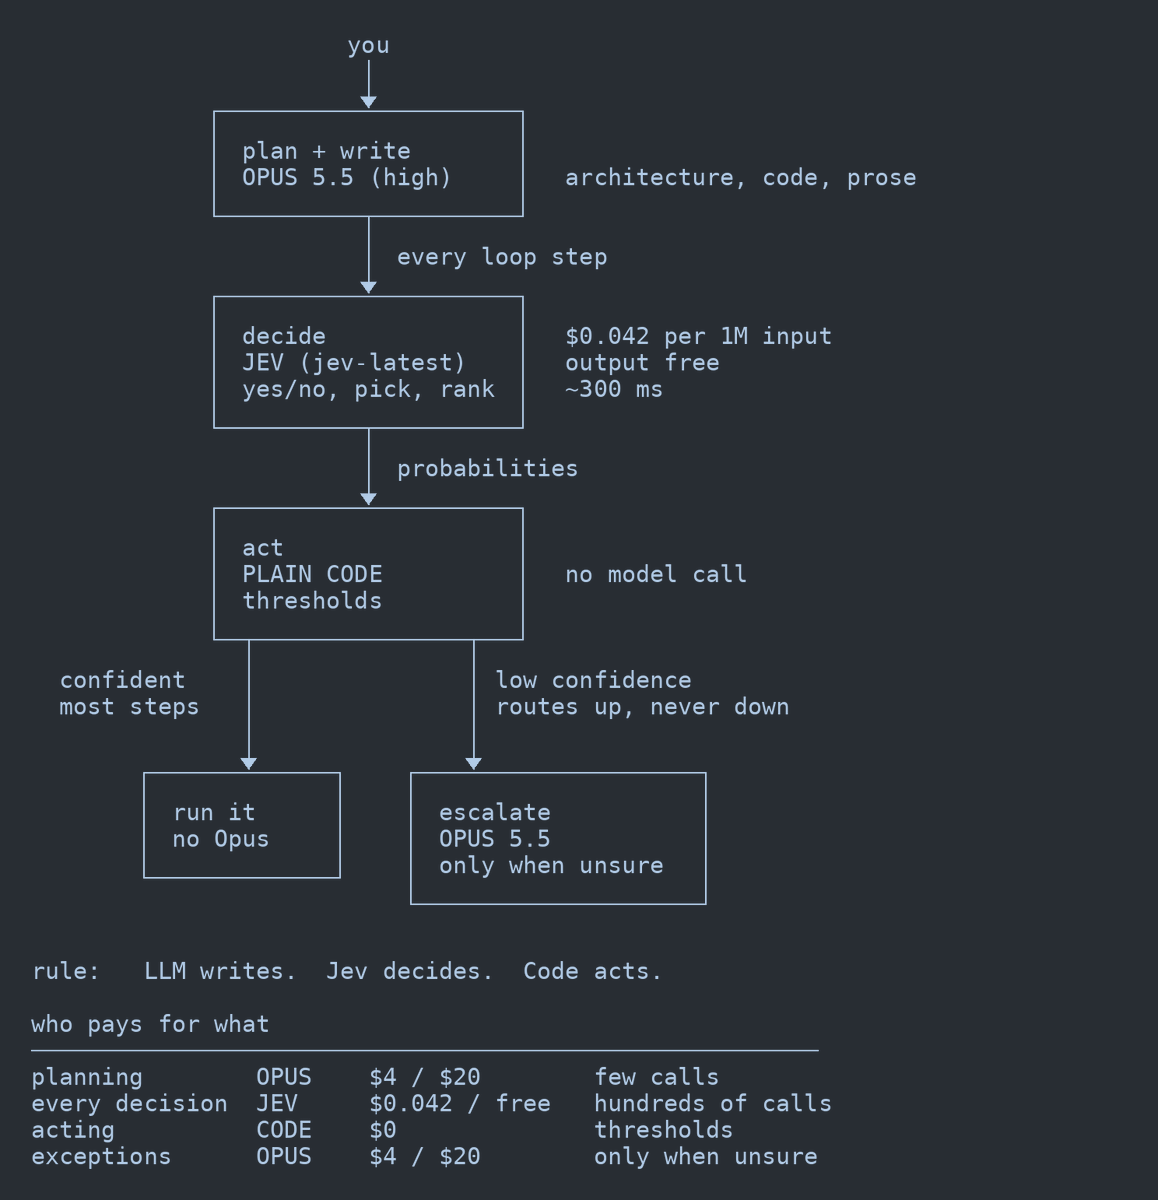
这种分工也解释了表格其余部分的竞争态势。Agency Agents、wshobson/agents 和 agent-skills 这样的目录,竞争重点已经不再是“这项工作有没有对应的智能体?”,而更多在于安装路径、host 支持,以及默认打包了多少治理能力。在设计侧,DESIGN.md 风格的工作流,正试图为 UI 审美做到 skills 之于工程流程所做到的事:产出一种可复用工件,让智能体查阅,而不是每次运行都重新即兴发挥。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| MASS | Sakana AI | 通过演化多智能体工作流,并用其生成的最佳轨迹进行训练,递归式改进模型 | 解决开放式研究任务中的监督瓶颈:人类无法可靠地对这类任务打分 | Qwen3.6-27B、multi-agent workflow search、LoRA post-training、Python | Alpha | 推文, 博客, 论文, 仓库 |
| AI-native services company OS | @dan__rosenthal | 通过受治理的 agents、skills、commands 和自我改进循环,运行 AI 辅助的服务交付 | 让服务团队在规模扩大时,AI 工作流仍保持一致、可审查且安全 | Safety hooks、PR governance、26 个 agents、79 个 skills、23 个 commands、n8n、Pinecone | Beta | 推文 |
| Agency Agents | msitarzewski | 将一套可安装的大型专家代理名录分发到多个编程工具中 | 减少人们从零设计每个代理角色和工作流的需要 | Markdown 代理文件、shell 安装器、桌面应用、多工具适配器 | 已发布 | 推文, 仓库 |
| awesome-design-md workflow | VoltAgent | 提供代理可读取的 DESIGN.md 文件,让编程代理能够搭建带有品牌风格的设计系统,而不是生成通用 UI |
AI 默认生成的 UI 往往看起来千篇一律且缺乏一致性 | DESIGN.md 文件、shadcn skill、Next.js 项目脚手架 | 已发布 | 推文, 仓库 |
| TermiX marketplace + SDK | @termix_ai | 让代理和应用发现服务、下单、使用托管、结算付款并建立声誉 | 为代理提供一层用于发现、雇佣、建立信任与支付的商业基础设施 | 链上声誉、托管、争议解决、TypeScript/Python/Go SDK | Beta | 市场讨论串, 招聘讨论串, SDK 讨论串 |
MASS 之所以格外突出,是因为它把多代理协作从运行时编排推进到了训练方法层面。公开材料描述了这样一个循环:先通过工作流搜索找到更优的协作模式,再通过后训练将这些模式吸收到共享模型中。这与仅仅在推理时接入更多子代理相比,体现的是一种不同的目标。
Second Brain OS 和 Agency Agents 指向了第二种模式:构建者正在把代理层打包成别人可以直接安装的东西。前者把记忆、检索和工作流约定封装进一个起步用的 vault 和图谱;后者则把专家代理名录和安装器打包好,让团队无需从空白会话开始,而是能直接使用一套经过策展的目录。
服务公司 OS 和 TermiX 相关讨论则展示了第三种模式:严肃的构建者更关注治理与结算,而不是个性。一边是运营治理——团队内部的 hooks、PR 审查、技能传播和反馈循环;另一边是商业治理——服务发现、托管、争议处理,以及试图把代理商业能力从门户迁移到宿主应用内部的 SDK。
awesome-design-md workflow 补充了第四种规模较小但值得注意的模式:构建者开始把产品审美外化到代理可读取的文件中。这与 skills 对流程所做的事情是同一种转变,只不过应用对象从工程流程变成了 UI。
6. 新的和值得关注的内容
类型化决策层成为一种具体的成本控制模式
@cyrilXBT 概述了(42 个赞,5 条回复,2,879 次浏览,9 次收藏)提出了一种栈式架构:由 Opus 负责写作,Jev 负责常规的是/否判断和排序问题,普通代码则先执行阈值控制,再把不确定的情况向上升级处理。这很重要,因为它比“某些任务用更便宜的模型”这种说法更具体:它明确了哪些类型的判断会被下放、如何处理置信度,以及为什么昂贵模型要留给真正困难的决策。
关于个人代理的汇报,更聚焦于上下文持续性,而非模型光环
@JJEnglert 发起了(88 个赞,25 条回复,8,195 次浏览,128 次收藏)发布了一组关于与个人代理共处的内容,并在回复中表示,到第三周时,体验之所以改善,主要是因为上下文状况变好了,而不是因为需要更强的模型。这一点值得注意,因为它把评估重点从发布演示的新鲜感,转向代理是否不再让用户反复解释同一个世界。
面向代理的产品分析,开始把委派出去的工作与可见参与度区分开来
@mignano 主张(40 个赞,13 条回复,2,755 次浏览,33 次收藏)指出,一旦代理在屏幕之外完成工作,活跃用户、DAU/MAU、使用时长,甚至收入留存,都需要重新解释。最有价值的一条回复并没有假装彻底解决这个问题;它提出了 DATS、MATS 和 delegation growth,随后又立刻警告,仅看 token 消耗反而可能奖励低效代理。因此,这一信号之所以值得关注,在于人们已经开始设计替代指标,而不只是抱怨旧指标失效。
记忆治理开始明确使用所有者、写入策略和来源追溯等表述
@danizhu 将其定义为(8 个赞,11 条回复,439 次浏览)将多代理记忆视为一个治理问题:哪些内容应保持私有,哪些会成为共享任务状态,哪些会进入长期记忆,以及谁有权写入。随后回复进一步把这个想法推进到实现层面的语言——作用域存储、晋升门槛、批准确认,以及时间性替代——这使它不再只是泛泛而谈“记忆很重要”,而是一次词汇体系的升级。
7. 机会在哪里
| 排名 | 机会 | 为何是现在 | 证据 | GTM 形态 | 关键风险 | 类型 |
|---|---|---|---|---|---|---|
| 1 | Eval 回放 + judge 栈 | 构建者如今已经积累了足够多纳入 harness 的工作流轨迹,因此开始需要归档任务、沙盒回放、模型 judge、代码 judge 和 holdout | @hammer_mt, @hardmaru, @sorenxet | 先卖给 coding-agent 团队、应用研究组织和企业 AI 平台 | judge 的可靠性,以及 benchmark 被“刷分” | 直接 |
| 2 | 记忆治理 + 溯源层 | 讨论重点已从“agent 需要记忆”转向:谁拥有它、谁能写入、何时提升,以及如何过期 | @danizhu, @JJEnglert, @undefinedKi | 先以 SDK 或托管层切入,为 agent 产品中的作用域记忆、审批和溯源日志提供支持 | 隐私、策略设计和集成负担 | 直接 |
| 3 | 带治理能力的团队技能 / harness 注册表 | 技能和 agent 目录正在扩散,但安装路径、权限和质量控制在不同 host 之间仍然割裂 | @aakashgupta, @slash1sol, @dan__rosenthal | 切入那些已经在使用 Claude Code、Cursor 或类似工具、且需要私有分发的工程团队 | host 碎片化,以及相对开源目录缺乏明显差异化 | 竞争型 |
| 4 | 面向 agent 的原生分析与 ROI 衡量 | 创始人们已明确在问:当 agent 在后台行动时,如何衡量采用、留存和有效工作产出 | @mignano, @JJEnglert | 向 agent 产品团队销售埋点和基准测试,先从委托式生产力应用切入 | 很难在不同产品和供应商之间标准化指标 | 直接 |
| 5 | 面向 agent 商业的信誉、托管和争议处理基础设施 | 围绕 marketplace 的讨论正收敛到信任轨道,但需求侧的证明仍弱于架构层面的雄心 | @Shakilonchain, @Zakria_0987, @iam_islandboi, @elenalin01 | 嵌入 host 应用和垂直 marketplace,而不是再推出一个通用门户 | 流动性、欺诈,以及买家与 agent 之间“先有鸡还是先有蛋”的问题 | 竞争型 |
最清晰的短期机会,并不是“再造一个 agent”,而是那些让大量 agent 能安全运作的层:可回放的 eval、受治理的记忆、打包好的技能,以及衡量体系。商业化依然值得关注,但与上述工具层相比,截至 2026-10-11,公开证据仍更偏概念,而非实际运行。
8. 要点
-
这个类别的公开词汇变得更精确了。 与本周早些时候较为宽泛的 agent 讨论相比,2026-10-11 出现了大量具体名词——harness、loop、check、worktree、judge、skills、设计文件、托管、溯源。这通常意味着,一个领域正从着迷走向落地实施。
-
主要瓶颈已从模型接入转向系统设计。 最有说服力的帖子并不是在谈某个新发布的基础模型,而是在讨论如何分派工作、保留上下文、验证输出,以及如何围绕模型封装可重复的行为。
-
打包本身成了战略。 skills、catalogs、starter vaults 和 design specs 都指向同一个结论:谁能把构建 agent 的隐性经验转化为可移植的文件和可安装的系统,谁就会比那些每次都从零开始反复写 prompt 的团队更有优势。
4.如今,信任已成为区分演示与经得起考验的产品的分界线。 无论话题是 evals、共享记忆,还是 agent 市场,反复出现的问题都一样:谁来验证,谁可以改动,以及一旦失效会发生什么?
- 最有力的机会,往往位于那些花哨应用的下一层。 可重放的 eval 栈、受治理的记忆、技能的内部注册表,以及面向 agent 的原生分析能力,看起来都比笼统的“agent 市场”说法更有现实基础,尽管商业基础设施仍是当天讨论最多的长期主题之一。