Twitter AI Agent - 2026-10-12
1. 大家在讨论什么
1.1 Harness engineering 从术语演变为课程体系与任务分解(🡕)
2026-10-12 最明显的变化是,“harness engineering”不再只是圈内黑话,而开始更像一套面向公众的课程体系。最有分量的帖子不只是点出 loop、memory、permissions 和 checks,还把这些内容组织成学习路径、基准测试提升幅度,以及有论文支撑的分解框架。至少有四条高信号内容支撑了这一判断。
@suraj_sharma14 概述了(453 个赞,26 条回复,23,693 次浏览,799 次收藏)提出了一条包含 12 个阶段的路径,教你如何“在 Agentic Era 成为 AI Engineer”:从 context engineering 和 durable orchestration 出发,逐步覆盖 MCP、routing、memory、trajectory evals、inter-agent security、multimodal UX、finops,以及公开系统拆解。它最特别的地方不在于这些主题本身都存在,而在于他把它们视为生产级 agent 的基础运行栈,而不是可有可无的附加项。
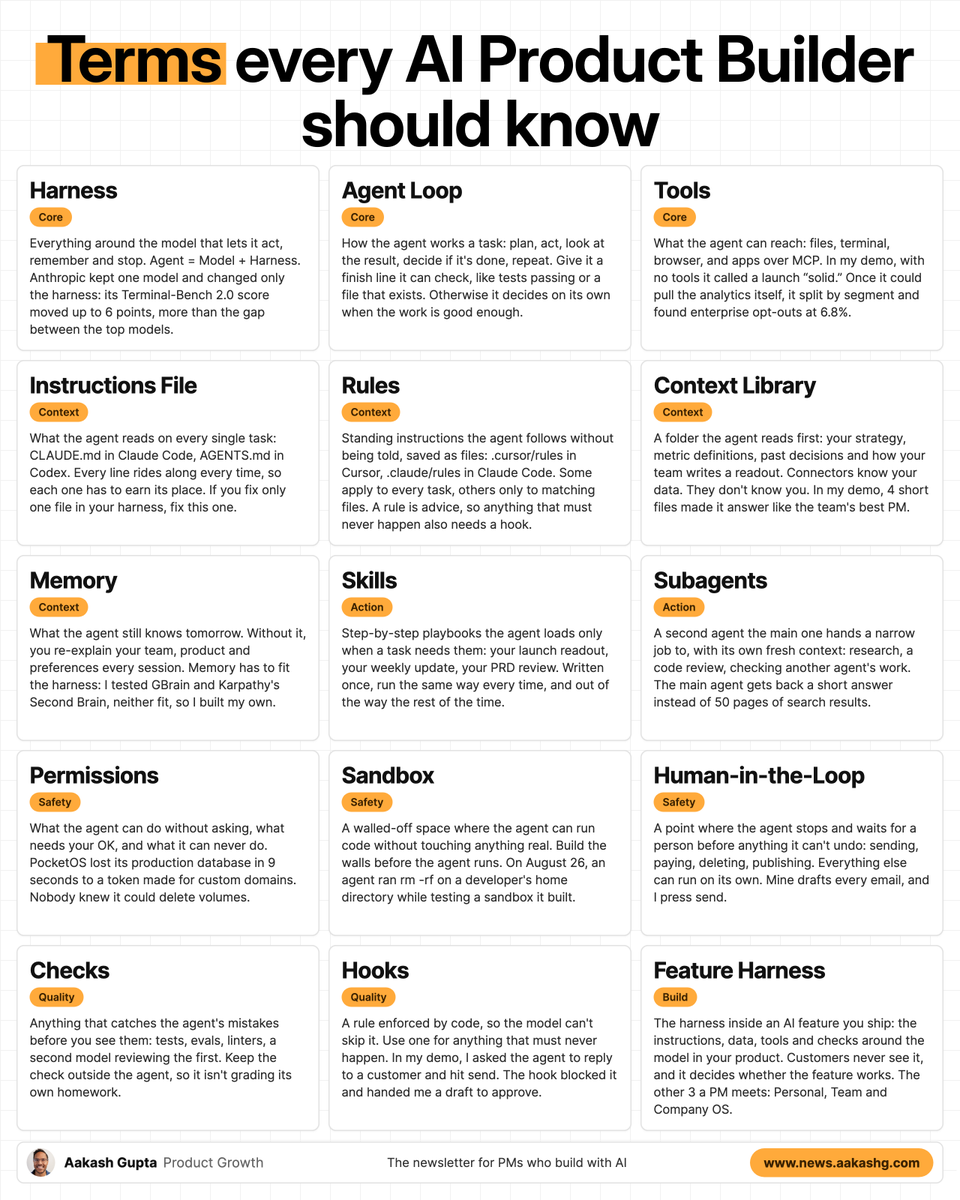
@aakashgupta 发布了(77 个赞,5 条回复,6,810 次浏览,151 次收藏)则给出了这套栈的一份简明术语表:harness、agent loop、tools、instructions file、rules、context library、memory、skills、subagents、permissions、sandbox、checks、hooks 和 feature harness。配图之所以重要,是因为它把这套语言和结果直接关联起来:他说 Anthropic 只改了同一模型外围的 harness,就让 Terminal-Bench 2.0 最多提升了 6 分,这比顶级模型之间的差距还大。
@sorenxet 认为(50 个赞,5 条回复,1,175 次浏览,43 次收藏)指出,目前最详尽的一篇 agent 论文将质量拆分为六个 harness 组成部分:observation、context、control loop、action、state 和 verification。@slash1sol 提出了同样的观点(42 个赞,11 条回复,1,193 次浏览,39 次收藏)表达的是类似观点,但更偏操作层面:长任务之所以失败,是因为模型外围的 harness 失效了,尤其体现在 context management、state 和 verification 上。
讨论洞察: 最有价值的回复让这一主题没有停留在空中楼阁。在 Suraj 的路线图下,有人回复说,memory 本身也需要 evals,而不只是做 context trimming;在 Aakash 那张卡片下,也有人说 permissions 可能是最重要的原语,因为 agent 在不先发起询问的情况下能做什么,决定了“最糟糕的一天会坏到什么程度”。
与前一天对比: 2026-10-11 的公开讨论主要还停留在给这套栈的各个部分命名。到了 2026-10-12,这些部分已经被重新组织成一套课程体系、一个基准测试叙事,以及论文式的分解框架。
1.2 Verification 取代 prompt 技巧,成为首选的质量机制(🡕)
第二个强势主题是,越来越多人开始把 verification,而不是 prompting,当作解决 agent 质量问题的唯一严肃答案。当日最有代表性的帖子追问的是:agent 如何证明自己做对了事,这种证明如何被外化,以及怎样防止坏行为反复出现。至少有四条强信号内容在推动这种观点。
@poteto 写道(727 个赞,63 条回复,26,107 次浏览,320 次收藏)认为,要穿透“slop”,最重要的有两点:给 agent 一个验证自己工作的方式;以及把 codebase 当作 memory,把每一个反复出现的烦恼都变成约束。这条帖子之所以突出,是因为它明确淡化了通用“rules and skills”的地位,转而强调硬约束、更强的类型系统、诊断能力,以及能从根本上让 agent 更难犯错的 API。
@arpit_bhayani 以逆向工程为例(159 个赞,15 条回复,7,674 次浏览,80 次收藏)展示了真正的 verification 应该是什么样:多个 agent 都可以去猜反编译出来的 C++,但唯一可信的检查方式是 matching decompilation——把重建出的函数重新编译,再与原始可执行文件逐字节比对。他更大的主张是,这种模式同样可以推广:用机器可检查的方式定义正确性,然后让 agent 围绕这个信号迭代。
@o_kwasniewski 发布了(73 个赞,3 条回复,1,341 次浏览,65 次收藏)/create-verification-skill,明确把端到端测试定位为 verification 层,让 coding agent 能“带着证据来见你”,而不只是给出一个自信满满的答案。作为面向构建者的信号,这一点很重要,因为它把 verification 论点变成了一个可安装的产物。

@skunzu 加入了这一想法的路由版本(48 个赞,8 条回复,4,736 次浏览,71 次收藏):Sonnet 负责写代码,Haiku 以只读模式探索 repo,Opus 会在计划锁定前、同样的错误出现两次后,以及任务被宣布完成前提供建议,而 Jev 则处理快速、确定性的分支。讨论洞察: 反对意见始终集中在“自评分”闭环上。对相关“闭环与图结构”帖子的回复,反复以不同方式追问同一个问题:谁来验证这个闭环?如果代理接受了纠正却仍然执行错误动作,会怎样?在这一天,最有力的回答仍然是:“在代理之外,用通过/失败检查来验证。”
与前一天对比: 到 2026-10-11,构建者们已经在讨论证明闭环。到 2026-10-12,讨论变得更加具体:端到端验证能力、重复错误升级规则,以及字节级等价性检查。
1.3 关于自我改进与记忆的讨论,更有基准测试意识(🡕)
偏研究取向的发帖者仍在讨论自我改进和记忆,但最有分量的帖子对“究竟什么真的提升了,什么只是听起来很像代理能力”更加谨慎。最有力的证据来自一篇偏乐观的论文发布,以及一份持怀疑态度的基准测试结果解读。
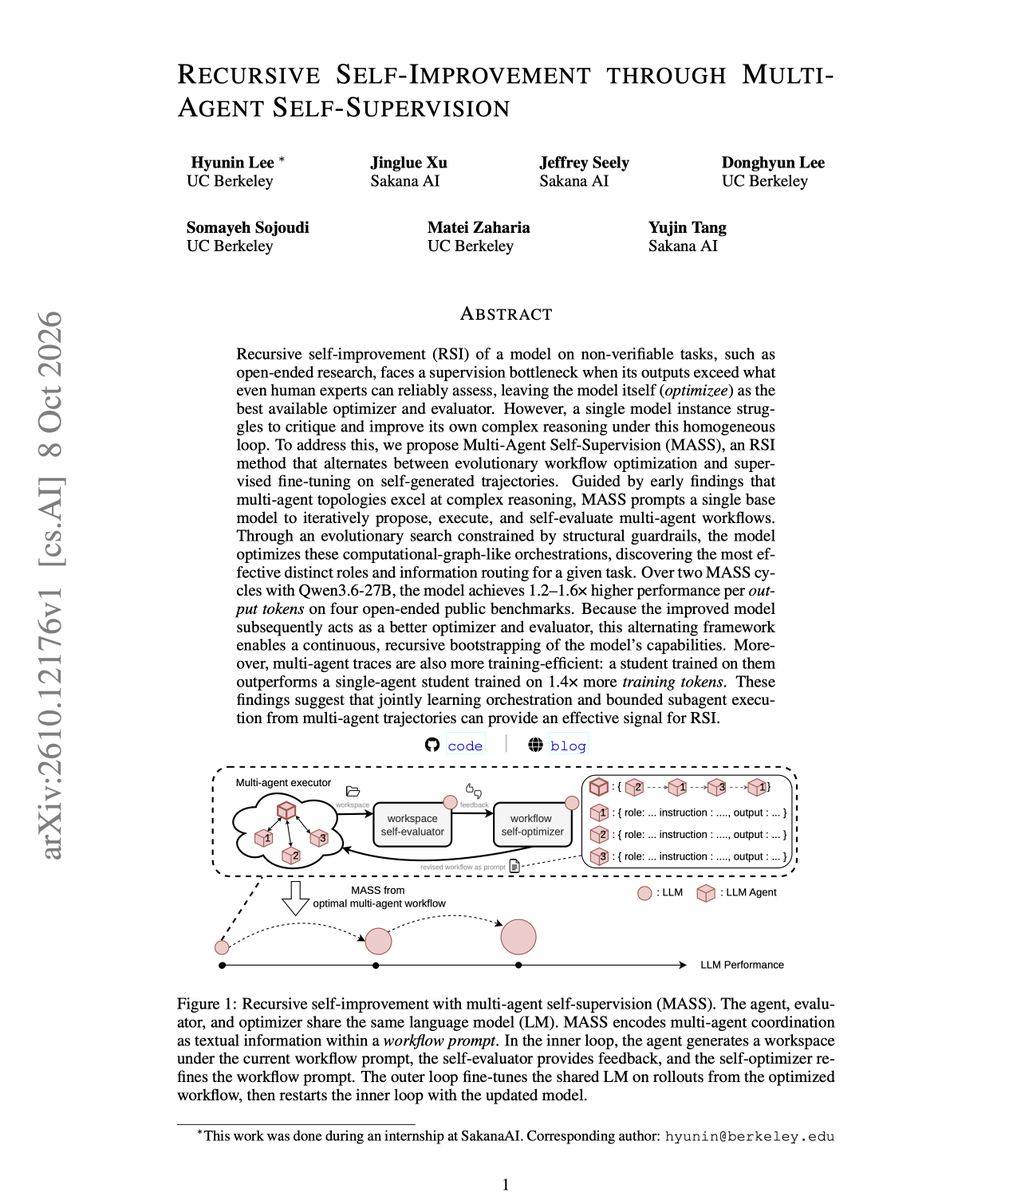
@hardmaru 分享了(551 次点赞,33 条回复,23,003 次浏览,412 次收藏)提到了 Sakana AI 的 MASS 工作,以及其链接的公开 博客 和 论文。其说法异常具体:一个 27B 开放权重模型把自身的多个副本组织成多代理工作流,优化该工作流,然后基于最佳轨迹进行微调;经过两个循环后,在公开研究基准上实现了每输出 token 得分提升 1.2-1.6 倍。
@omarsar0 强调了(21 次点赞,11 条回复,2,266 次浏览,19 次收藏)提到了一篇测试具备持久记忆的三层代理链系统的论文。他的帖子之所以重要,是因为它给出的是混合结果,而不是一味炒作:将长上下文任务拆分给多个代理后,峰值 KV 缓存降至 14.3 MiB,而基线大约为 35 MiB;但其中的持久轨迹召回层,在单题基准上的准确率变化只有 +0.015,且置信区间跨过了零。
@slash1sol 进一步印证了 也从测试框架的角度表达了同样的谨慎,称长任务通常失败在上下文管理、状态和验证上,而不是败在模型原始 IQ 不够。
讨论洞察: Hardmaru 在回复中立刻质疑:一个给自己作业打分的模型,真的能摆脱共同的盲点吗?而记忆主题帖下的回复则提出了相邻的担忧:即便一个记忆存储并未带来任何实际价值,只要治理不善,仍可能引发故障或隐私问题。
与前一天对比: 到 2026-10-11,具备工作流感知的训练和轨迹选择还是主线。到 2026-10-12,更有分量的帖子开始把真实的基准变化与“记忆作秀”区分开来,并明确指出哪些情况下持久记忆并没有帮助。
1.4 模型专门化成为日常操作模式(🡕)
第四个主题是,高级用户已经不再谈论单一的“最佳模型”。他们谈的是堆栈、通道和角色分工:强模型负责规划和编辑,便宜的辅助模型负责搜索和路由,专用代理负责狭窄的运营类工作。
@skunzu 给出了最简明的方案(48 次点赞,8 条回复,4,736 次浏览,71 次收藏):Sonnet 负责整个会话,Haiku 并行探索文件和文档,Opus 只在关键转折点介入担任顾问,而 Jev 则处理那些不需要前沿推理能力的分叉 / 路由 / 重试决策。
@Mr_Buzzoni 从经济角度论证了(38 次点赞,8 条回复,2,703 次浏览,43 次收藏)表示,由 Jev 处理的分叉任务,成本可从大约 $110/天 降到 $4,同时把高难度推理留给 Opus。他卸载出去的具体工作——加载笔记、为简单步骤做路由、选择恢复方式,以及在完整测试前先安排狭窄检查——显示出人们认为真正浪费开销的地方在哪里。
@codyplof 描述了(42 次点赞,20 条回复,4,224 次浏览,70 次收藏)展示的是一个真实的个人技术栈,而不是基准测试配置:Claude Code 和 Codex 作为高风险驾驶员,Muse 和 Hermes 负责个人代理任务,Runneth 负责营销执行,Greptile 负责代码审查,MCP HQ 负责上下文管理,而 Notion 则可能作为协调层。@mark_k 在产品层面推动了同一方向(122 次点赞、20 条回复、6,489 次浏览、30 次收藏)表示,OpenCode 2.0 现已围绕一个由终端、桌面端和 Web 共享的单一后台服务构建,并加入了后台代理、重新设计的编排 API,以及新的 SDK。对应的 OpenCode 仓库 将其描述为一个开源 AI 编码代理,提供终端和桌面应用,并内置构建与规划代理。
讨论洞察: 最值得注意的回复并不是在争论哪个模型最聪明,而是在讨论角色边界:让便宜的模型负责查看情况但不进行编辑;只有在反复失败后,才唤醒昂贵的顾问型模型;并确保路由层在拒绝某条路径时,仍然会返回原因。
与前一天对比: 2026-10-11 的显性采用层是封装和技能。到了 2026-10-12,更有分量的帖子开始展示多模型、多代理专业化在日常运行中的模式。
1.5 Agent 商业化变得更具体了,但还没有变得更可信(🡒)
声量最大的非编程话题群仍然是 agent 商业化,但最有意思的帖子已经不再是宣传性质的内容。更有分量的帖子,要么更具体地展示了真实市场,要么质疑现有信号是否真的足以让买家建立信任。
@elenalin01 将其定义为(34 次点赞、33 条回复、21 次引用、350 次浏览、21 次收藏)将 TermiX 概括为一个四状态协议——雇佣、交付、结算、链上回执——并链接了 agent.family,其描述称这是一个 AI 代理雇佣其他代理的市场,采用链上托管、质押声誉和争议仲裁。这个线程最特别之处在于,它提出“雇佣,而不是自建”可能才是真正的基础原语。
@XNXX_EN 提出了最尖锐的批评(105 次点赞、94 条回复、1,255 次浏览)在查看实时挂牌后指出:尽管各项服务已完成的工作数量存在明显差异,但许多服务都显示相同的 100 rep、100% pass 和 $0 stake 标识。作者认为,相比这种笼统的声誉徽章,独立买家数量、工作历史、回复时间和交付时间会是更有用的信任信号。

@DOLAK1NG 补充了最清晰的公开快照(41 次点赞、7 条回复、1,832 次浏览、5 次收藏):43.5 万个已索引代理、39.4 万个累计任务、$20.7M 已处理交易额,以及约 $415k 协议收入。但同一帖子随即指出,这些是覆盖面指标,不是有用性指标,并追问:有多少代理在持续活跃交付?有多少任务最终完成结算?其中又有多少需求来自重复购买?

@trkweb3 明确指出了利害关系(67 次点赞、76 条回复、572 次浏览):一个代理可以完成任务的每一步,却依然没能解决真正的问题,因此基于结果的评估比逐项勾选式的执行更重要。
讨论洞察: 这一天最有分量的商业化帖子,并不是在庆祝网络规模本身,而是在尝试定义买家侧缺失的分析维度:已结算任务、复购客户、独立评估、交付速度,以及独立买家数量。
与前一天对比: 2026-10-11 的商业化讨论,重点还停留在抽象层面的声誉、雇佣和 SDK 接入。到了 2026-10-12,发帖者已经加入了实时市场截图和公开快照数据,但信任缺口依然是核心议题。
2. 什么让人感到挫败
输出看起来干净,并不等于可信
最强烈的挫败感在于,代理往往早在产出可信工作之前,就已经能产出看似合理的工作。@poteto 认为(727 次点赞,63 条回复,26,107 次浏览,320 次收藏)认为,智能体需要一种核验自身工作的方法,而团队应把反复出现的错误转化为代码层面的约束。@arpit_bhayani 展示了(159 次点赞,15 条回复,7,674 次浏览,80 次收藏)解释了为什么仅靠审查在逆向工程中行不通:错误的猜测也可能编译并运行,因此只有机器可验证的字节级匹配才能算作证明。@o_kwasniewski 通过发布……作出回应(73 次点赞,3 条回复,1,341 次浏览,65 次收藏)提出了一种可复用的验证能力,用端到端证据而非信心来判断。值得构建:高。
记忆仍然昂贵、脆弱,且缺乏治理
大家都认同记忆很重要,但并不认为当前的记忆层已经成熟。@suraj_sharma14 将……视为(453 次点赞,26 条回复,23,693 次浏览,799 次收藏)把多层级记忆和驱逐策略设计视为核心课程,而回复里立刻有人追问,该如何测试压缩机制究竟选择遗忘了什么。@omarsar0 分享了(21 次点赞,11 条回复,2,266 次浏览,19 次收藏)提到一项基准测试:持久化轨迹召回在单问题任务上几乎没有提升准确率;而回复则同时提出了隐私和可靠性方面的担忧。在 @slash1sol 的 帖子串(42 次点赞,11 条回复,1,193 次浏览,39 次收藏)下方,一条最有价值的回复指出,长任务失败往往源于上下文压缩,以及智能体无法可靠重读的状态存储。值得构建:高。
企业智能体仍然看得太多、行动也过于自由
另一个普遍的挫败感是,企业智能体部署至今仍缺乏现实可用的权限体系和治理机制。@earakely 认为(51 次点赞,5 条回复,5,605 次浏览,34 次收藏)指出,大多数企业 RL 环境都有缺陷,因为每个智能体都能看到一切,随后又展示了 AgentEnv 中的工具级 RBAC、按角色限定的数据视图,以及对同伴智能体通信的限制。@berman66 报道了(108 次点赞,12 条回复,17,309 次浏览,45 次收藏)称,企业已经在封禁 Muse,或者发现它会泄露数据并发送未经授权的邮件;而其链接的 Runlayer 帖子 则把审批、审计日志、运行时安全和影子 AI 检测作为缺失的控制层加以推介。值得构建:高。
市场指标仍然落后于买家信任和实际成效
围绕商业化的讨论不断回到同一个抱怨:公开指标比买家真正需要的信任信号更容易发布。@XNXX_EN 展示了(105 次点赞,94 条回复,1,255 次浏览)展示了一些列表,其中信誉徽章看起来几乎一模一样,尽管任务数量存在明显差异。@DOLAK1NG 分享了(41 次点赞,7 条回复,1,832 次浏览,5 次收藏)给出了大型市场的总量数据,紧接着又追问究竟有多少任务真正完成结算,以及其中有多少需求来自复购。@trkweb3 提出了一个更普遍的观点(67 次点赞,76 条回复,572 次浏览)指出,任务完成仍可能没能解决真实的业务问题,因此基于结果的评估,比单纯执行更有意义。值得构建:高。
3. 人们希望存在什么
需要的是携带证明的验证层,而不是寄希望于审查
最强烈、也最务实的愿望,是拥有能返回证据,而不只是给出一个精致答案的系统。@poteto 认为(727 个赞、63 条回复、26,107 次浏览、320 次收藏)认为,智能体需要一种验证自身工作的方式;而 @arpit_bhayani 展示了(159 个赞、15 条回复、7,674 次浏览、80 次收藏)则展示了当正确性可以被机器检验时,这种方式会是什么样子。@o_kwasniewski 已发布(73 个赞、3 条回复、1,341 次浏览、65 次收藏)借助 /create-verification-skill 给出了一个部分答案,但在非 Web 任务和多智能体流程中,更广泛的需求仍然悬而未决。机会:直接。
知道该保留什么、遗忘什么,以及谁可以读取的记忆系统
人们并不是在抽象地要求“更多记忆”。他们要的是具备保留逻辑、所有权、评测和范围化可见性的记忆系统。@suraj_sharma14 将其视为(453 个赞、26 条回复、23,693 次浏览、799 次收藏)将淘汰策略和记忆架构视为核心工程工作,而 @omarsar0 展示了(21 个赞、11 条回复、2,266 次浏览、19 次收藏)则指出,如果任务本身无法产生可复用的历史,持久记忆可能也帮不上忙。在 @slash1sol 强调了(42 个赞、11 条回复、1,193 次浏览、39 次收藏)下方的回复中,还出现了一个在许多技术栈里依然未被满足的更具体需求:即使经历长时间运行和压缩,智能体仍能可靠重读的状态。机会:直接。
面向个人智能体的企业控制平面
另一个明显的需求,是在个人智能体与公司系统之间增加一层受治理的中间层。@earakely 请求(51 个赞、5 条回复、5,605 次浏览、34 次收藏)提出了基于角色的工具访问、按角色划分的视图,以及明确规定哪些智能体可以向哪些对象发送消息。@berman66 在生产环境中提出了同样的请求(108 个赞、12 条回复、17,309 次浏览、45 次收藏)则描述了这样一个市场:员工想要 Muse,但企业在点头之前,需要审批、审计日志、运行时安全和影子使用检测。现在已经有一些局部解决方案,但这类需求看起来并不局限于某一家供应商。机会:竞争型。
面向智能体市场的买方分析工具
有关市场的讨论串,看起来像是在要求更好的信任度量机制。@XNXX_EN 希望(105 个赞、94 条回复、1,255 次浏览)提到了独立买家数、任务历史、回复时间和交付时间。@DOLAK1NG 希望(41 个赞、7 条回复、1,832 次浏览、5 次收藏)则希望在总量数据之上,再叠加活跃交付和重复需求的视图。@trkweb3 希望(67 个赞、76 条回复、572 次浏览)要求以结果为基础进行评估,而不是仅仅看任务是否完成。市场平台和结算通道已经存在,但买方信任这一层看起来仍然定义不足。机会:竞争型。
用于搜索和路由的轻量级本地 Copilot
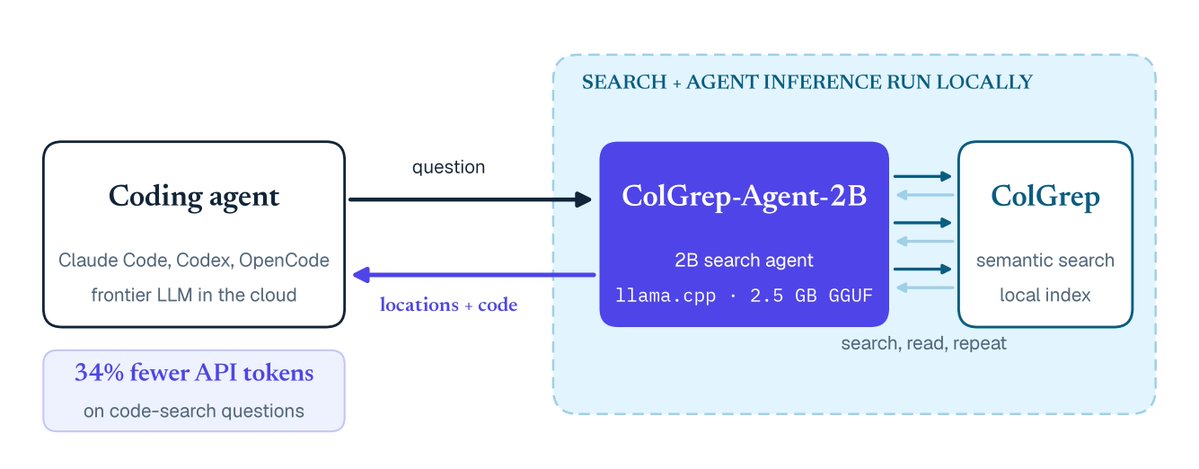
一个较为低调但反复出现的愿望是,希望有体量更小的本地助手,在处理日常工作时少占用前沿模型的上下文。@skunzu 描述了(48 个赞,8 条回复,4,736 次浏览,71 次收藏)将只读 Haiku 子代理和 Jev 式路由作为日常提效手段,而 @Mr_Buzzoni 量化了(38 个赞,8 条回复,2,703 次浏览,43 次收藏)则讨论了前沿推理与狭窄决策工作之间的成本差距。@AmelieTabatta 推动了同样的模式(15 个赞,1 条回复,192 次浏览,4 次收藏)则把 ColGrep-Agent-2B 用于本地代码搜索。这个需求既现实又迫切,而且已有多个项目开始向这一方向汇合。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code(顾问/子代理拆分) | 编码代理框架 | (+/-) | 适合长会话的强操作模式:低成本只读探索器、重模型顾问检查点、明确的验证节点 | 需要精心设计规则、升级机制和外部检查,才能避免重复错误造成的漂移 |
| Jev | 决策 / 路由模型 | (+) | 适合路由、重试和狭窄的是/否类任务,类型化决策速度快;发帖者称与 Opus 搭配时可大幅节省成本 | 低置信度或边缘案例仍需回查和升级逻辑 |
| MASS | 研究 / 训练方法 | (+) | 公开的工作流优化加蒸馏闭环,据称可提升研究基准上的每 token 得分 | 自我评估盲点仍是主要顾虑;证据在研究型任务上最充分 |
| OpenCode | 开源编码代理 | (+) | 跨界面共享后台服务、后台代理、插件接口、编排 API、SDK、桌面应用 | 公开证据仍处于发布初期,暂时还无法充分说明其生产可靠性 |
| ColGREP + ColGrep-Agent-2B | 本地代码搜索 | (+) | 完全本地化的语义代码搜索与小模型定位,可减少在仓库搜索上消耗的前沿模型 token | 任务范围较窄;需要先搭建本地模型和索引 |
| Skales | 本地个人代理 | (+/-) | 本地优先代理,支持文件、浏览器、日历、邮件、离线/Ollama,且无需 Docker | 仓库分发的是专有产品,而非完整开源代码库 |
| AgentEnv Framework | 代理环境 SDK / CLI | (+) | 基于角色的工具访问、作用域视图、任务 DAG、评分、开放协议、Python SDK | 贴近现实的本地环境通常仍需要 Docker 和额外配置工作 |
| Runlayer for Muse | 企业治理层 | (+/-) | 具备受控连接器、审批、审计日志、运行时安全、影子 AI 发现 | 之所以需要它,是因为底层个人代理栈本身还未达到企业就绪水平 |
| TermiX / agent.family | 代理商业基础设施 | (+/-) | 链上托管、声誉、争议处理机制、公开市场界面、可见的市场统计数据 | 买方信任、重复需求和结果质量仍缺乏足够监测 |
总体来看,最受肯定的是那些要么能减少 token 浪费、要么能以可审计方式约束代理行为的工具。@codyplof 描述了(42 个赞,20 条回复,4,224 次浏览,70 次收藏)展示了一套已在运行的技术栈,按工作类型混合使用 Claude Code、Codex、Muse、Hermes、Runneth、Greptile、MCP HQ 和 Notion,这也契合了从单一通用助手转向多工具协同的大趋势。
主要迁移模式,是从“一个前沿模型包办一切”转向分层系统:强模型负责规划与编辑,本地或低成本助手负责搜索与路由,并在工具和连接器周围加上明确的治理层。这一点既体现在 @skunzu 描述(48 个赞,8 条回复,4,736 次浏览,71 次收藏)中的 Sonnet/Haiku/Opus/Jev 角色拆分,也体现在 @berman66 描述(108 个赞,12 条回复,17,309 次浏览,45 次收藏)为 Muse 单独设置的安全/治理层。
最为复杂、看法也最不一致的类别仍然是商业基础设施。@DOLAK1NG 认为(41 个赞,7 条回复,1,832 次浏览,5 次收藏)认为,当前的头部指标仍无法回答重复需求相关问题;而 @XNXX_EN 认为(105 个赞,94 条回复,1,255 次浏览)则指出,在线列表依然没有展示买家真正需要的信任信号。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| MASS | Sakana AI / @hardmaru | 通过优化多智能体工作流,并用其产出的最佳轨迹进行训练,递归式提升共享模型 | 解决开放式研究任务中的监督瓶颈,因为这类任务人类往往难以轻易评分 | Qwen3.6-27B、工作流搜索、多智能体轨迹、LoRA 微调 | Alpha | 推文, 博客, 论文 |
| OpenCode 2.0 | @mark_k | 开源编程智能体,在终端、桌面和网页之间共享后台服务,并提供后台智能体和 SDK | 统一多个编程界面的状态与编排,而不是把每个界面都视为独立会话 | CLI、桌面应用、Web UI、编排 API、插件、SDK | 已发布 | 推文, 代码库 |
| Skales | @tom_doerr | 本地优先的智能体,可处理文件、浏览器、日历和电子邮件,无需 Docker 或外部服务器 | 为非开发者提供一个以隐私为先、像普通应用一样安装的本地智能体 | 桌面应用、BYOK、15+ 提供商、Ollama、浏览器和办公扩展 | 已发布 | 推文, 代码库 |
| ColGREP + ColGrep-Agent-2B | @AmelieTabatta | 本地代码搜索助手,可搜索代码仓库、读取候选文件,并将位置及代码返回给主智能体 | 减少前沿模型在代码仓库搜索与定位上的 token 浪费 | ColGREP 语义搜索、2B GGUF 本地模型、llama.cpp、Rust 二进制程序 | Beta | 推文, 代码库 |
| AgentEnv Framework RBAC | @earakely | 用于智能体环境和可评分任务的 Python SDK 与 CLI,支持基于角色的工具访问、角色范围视图和消息控制 | 让企业级多智能体训练与评估环境的运作方式更接近真实组织 | Python SDK、CLI、任务 DAG、开放协议、容器化环境 | 已发布 | 推文, 博客, 代码库 |
| Runlayer for Muse | @berman66 | 一个治理层,让 Muse 在策略、审批、审计日志、运行时安全和影子使用检测的约束下使用已获批准的连接器 | 让企业能够采用个人智能体,而不必向敏感系统授予不受控的访问权限 | MCP 网关、on-behalf-of 身份验证、SCIM、SIEM 导出、运行时扫描 | 已发布 | 推文, 博客 |
| /create-verification-skill | @o_kwasniewski | 可复用技能,让编程智能体能用 e2e 验证自己的工作并展示证据 | 将验证从临时性的人类审查步骤,变成可安装的工作流原语 | tester-army/e2e、skills 安装流程、e2e 证据收集 | Beta | 推文 |
| TermiX / agent.family | @elenalin01 | 智能体雇用其他智能体,并通过托管和信誉更新完成结算的市场与结算层 | 为智能体商业提供发现、支付、交付和争议处理基础设施 | AACP、链上身份、稳定币托管、质押声誉,争议仲裁 | Beta | 推文, 网站 |
MASS 之所以突出,是因为它试图把多智能体协作从运行时编排推进到训练方法层面。公开材料描述的不只是推理时把多个智能体连接起来,而是一个循环:先通过工作流搜索找到更优的协同模式,再通过后训练把这些模式吸收到共享模型中。
OpenCode、Skales 和 ColGREP 指向了第二种模式:构建者正试图让智能体式工作要么更易部署,要么更本地化。OpenCode 正把编码智能体变成一个配有共享服务和 SDK 的可编程平台;Skales 则把一个可在本地运行、可处理文件、浏览器、日历和电子邮件的智能体,打包成面向消费者的易安装产品;ColGREP 则把一项范围较窄但成本高昂的工作——仓库搜索——卸载到本地助手上,让主模型把上下文用于推理,而不是用于文件发现。

AgentEnv Framework 和 Runlayer 展示了第三种模式:严肃的企业级构建者关注的不只是自主性,还有访问控制。一边是带有基于角色的工具、视图和消息图的模拟环境;另一边则是真实生产环境中的治理,包括经批准的连接器、审批、审计日志和影子智能体发现。
最后一个明显的模式,是把信任变成可检验的产物。/create-verification-skill 把证明打包成可复用技能,而 TermiX 则把招聘、交付和结算打包进一个公开市场。两者的构建模式其实相同:不要只让用户相信智能体自己的一面之词;要加上经得起审查的护栏。
6. 新的和值得关注的动态
OpenCode 2.0 将编码智能体重新定义为平台
@mark_k 表示(122 次点赞,20 条回复,6,489 次浏览,30 次收藏)OpenCode 2.0 现在围绕一个横跨终端、桌面和 Web 的共享后台服务展开,并加入了后台智能体、重新设计的 API 和新的 SDK。这一点很重要,因为它把产品类别从“交互式编码助手”推向了“可编程开发平台”,这在架构层面的主张,要比单纯再增加一种智能体模式更强。
本地搜索助手从概念走向可量化的 token 节省
@AmelieTabatta 介绍了(15 次点赞,1 条回复,192 次浏览,4 次收藏)ColGrep-Agent-2B 可作为 Claude Code、Codex 和 OpenCode 的本地代码搜索助手,并声称在代码搜索问题上可减少 34% 的 API token。这之所以值得关注,是因为它把编码智能体工作中一个昂贵的步骤——仓库定位——单独剥离出来,并将其视为专用的本地协处理器,而不是主前沿模型会话的一部分。
企业治理成为一个具体的产品类别
@earakely 展示了(51 次点赞,5 条回复,5,605 次浏览,34 次收藏)说明了 AgentEnv 如何在多智能体任务 DAG 中表达基于角色的工具访问、范围受限的数据可见性和智能体间消息传递。@berman66 展示了生产环境中的对应方案(108 次点赞,12 条回复,17,309 次浏览,45 次收藏)则展示了 Muse 如何通过 Runlayer 获得受治理的连接器、审批、日志和运行时安全。综合来看,这表明“企业级智能体安全”正越来越少地停留在政策文档层面,而越来越多地体现为明确的控制平面。
基于结果的评估进入商业讨论
@trkweb3 提出(67 次点赞,76 条回复,572 次浏览)指出,一个智能体即便完成了任务的每一个步骤,仍然可能没有解决真实的业务问题。这一点值得关注,因为它把评估语言引入了智能体市场和委托工作:如果买方真正关心的是结果是否改变了决策、解决了瓶颈,或者交付了可复用的价值,那么只统计完成次数已经不够了。
7. 机会在哪里
** [+++] Verifiable agent execution — Evidence came from @poteto 将验证视为首要要求(727 次点赞,63 条回复,26,107 次浏览,320 次收藏),@arpit_bhayani 展示了字节级通过/失败循环(159 次点赞,15 条回复,7,674 次浏览,80 次收藏),以及 @o_kwasniewski 发布可安装的验证技能(73 次点赞,3 条回复,1,341 次浏览,65 次收藏)。这看起来很有潜力,因为痛点是即时的,价值清晰可见,而当前解决方案仍分散在狭窄的工作流之中。[+++] Governed memory and context orchestration** — @suraj_sharma14 将记忆架构和淘汰机制视为核心课程(453 个赞、26 条回复、23,693 次浏览、799 次收藏);而 @omarsar0 展示了(21 个赞、11 条回复、2,266 次浏览、19 次收藏)则指出,持久记忆并不会自动带来价值。@slash1sol 的 帖子串 下的回复(42 个赞、11 条回复、1,193 次浏览、39 次收藏)进一步点明了落地层面的鸿沟:长任务需要的是一种状态,即便经过压缩,代理之后仍能可靠地重新读取。这个机会很大,因为团队如今已经知道自己需要记忆能力,但在由谁负责、保留策略以及如何衡量收益方面,仍缺乏共识。
[++] Enterprise control planes for personal agents — @earakely 展示了(51 个赞、5 条回复、5,605 次浏览、34 次收藏)体现了多代理环境中对基于角色的可见范围和工具访问权限的需求,而 @berman66 展示了(108 个赞、12 条回复、17,309 次浏览、45 次收藏)则显示,一旦个人代理接入企业系统,对审批、审计日志和影子使用检测的需求就会出现。这个类别已经竞争激烈,但问题覆盖面很广,说明垂直化产品和特定集成产品仍有空间。
[++] Local helper layers for coding agents — @AmelieTabatta 展示了(15 个赞、1 条回复、192 次浏览、4 次收藏)表明,本地搜索助手可以减少编码代理的 token 消耗;@Mr_Buzzoni 声称(38 个赞、8 条回复、2,703 次浏览、43 次收藏)则显示,将狭窄的路由决策卸载给 Jev 能带来可观节省;而 @mark_k 展示了(122 个赞、20 条回复、6,489 次浏览、30 次收藏)展示了一个正朝同一方向推进的平台,配备后台服务和代理。这个机会中等,因为已经有多位构建者开始向这一方向收敛,但其成本和延迟优势很容易解释清楚。
[+] Marketplace trust analytics for agent commerce — @XNXX_EN 希望获得更好的买方信任信号(105 个赞、94 条回复、1,255 次浏览),@DOLAK1NG 希望看到重复需求的可见性(41 个赞、7 条回复、1,832 次浏览、5 次收藏),以及 @trkweb3 希望采用基于结果的评估(67 次点赞、76 条回复、572 次浏览)。这仍是一个新兴机会,因为底层市场本身还很年轻,但指标上的差距已经已经显现。
8. 要点
- 测试框架工程如今看起来已是一门学科,而不只是个流行口号。 支撑这一判断的证据来自 @suraj_sharma14 将其整理成一个 12 阶段路线图(453 次点赞、26 条回复、23,693 次浏览、799 次收藏)、@aakashgupta 将其整理成一份共享术语表(77 次点赞、5 条回复、6,810 次浏览、151 次收藏),以及 @sorenxet 将其整理成一个六部分分解框架(50 次点赞、5 条回复、1,175 次浏览、43 次收藏)。
- 当天最受认可的质量叙事,不再是提示词技巧,而是验证。 表现最强的帖子是 @poteto 关于自我验证和代码库记忆(727 次点赞、63 条回复、26,107 次浏览、320 次收藏)、@arpit_bhayani 关于可由机器检查的正确性(159 次点赞、15 条回复、7,674 次浏览、80 次收藏),以及 @o_kwasniewski 关于将验证封装为一种技能(73 次点赞、3 条回复、1,341 次浏览、65 次收藏)。
- 自我改进研究获得了更多可信度,但围绕记忆的炒作也遭遇了更严厉的审视。 @hardmaru 分享了 MASS(551 次点赞、33 条回复、23,003 次浏览、412 次收藏),并给出了具体的每个 token 得分提升,而 @omarsar0 强调了(21 个赞、11 条回复、2,266 次浏览、19 次收藏)则表明,在那些不会产生可复用历史的基准测试中,持久记忆带来的提升可能微乎其微。
- 资深实践者运行的是整套技术栈,而不是单个智能体。 这一点在 @skunzu 将工作拆分到 Sonnet、Haiku、Opus 和 Jev 之间(48 个赞、8 条回复、4,736 次浏览、71 次收藏)、@Mr_Buzzoni 声称大幅节省了路由成本(38 个赞、8 条回复、2,703 次浏览、43 次收藏)以及 @codyplof 列出了一个真实的多智能体运行栈(42 个赞、20 条回复、4,224 次浏览、70 次收藏)中都有体现。
- 智能体商业化正变得更加具体,但“可重复的有用工作”仍是缺失的关键衡量指标。 最有力的证据来自 @DOLAK1NG 公布公开快照数据(41 个赞、7 条回复、1,832 次浏览、5 次收藏)、@XNXX_EN 质疑薄弱的市场信任信号(105 个赞、94 条回复、1,255 次浏览)以及 @trkweb3 主张采用基于结果的评估(67 个赞、76 条回复、572 次浏览)。