Twitter AI 编程 - 2026-04-07
1. 大家在讨论什么
1.1 GitHub 的“Rubber Duck”代理:Copilot CLI 引入跨模型审查(🡕)
当天互动量最高的推文来自 @burkeholland,称 GitHub Research 为 Copilot CLI 发布了一个“Rubber Duck”代理。该代理会自动把代码路由给另一个 AI 家族的模型进行审查——例如,让 Claude 生成的方案交由 GPT 家族模型复核——随附数据表明,这一做法能显著提升输出质量(帖子,463 个赞,285 次收藏,214K 次浏览)。
在后续回复中,Burke 分享了 SWE Bench 结果:“Rubber Duck 将 Sonnet 与 Opus 之间的差距缩小了 75%。” 这是个相当惊人的说法——意味着只要增加一轮低成本的跨家族审查,就可能弥补中档模型与顶级模型之间大部分的质量差距。@juliamuiruri4 提出了一个有意思的假设:“能不能说,引入 rubber-duck 代理后,主模型会被推动去做某种自我评估?” Burke 回应称,他认为其机制更可能是不同模型家族之间能力互补,而非自我纠错,但也承认这个问题仍无定论。
与此同时,Copilot CLI v1.0.21(78 个赞)还发布了 8 项新功能,包括用于管理 MCP 服务器的 copilot mcp 命令、借助 hook_event_name、session_id 和 ISO 8601 时间戳实现的 hook payload 从 PascalCase 到 snake_case 的规范化,以及自动关闭未使用的 shell 会话以降低内存占用。@BradGroux 评价称,“GitHub Copilot CLI 一天比一天更好用”(帖子)。
讨论洞察: @dpandiyan 提出了一个很实际的问题:“这和一个按需调用的 agent skill 到底有什么不同?” 区别似乎在于,Rubber Duck 是内置在 CLI 的审查循环中,而不是用户按需触发的工具,因此它更像是默认启用的质量闸门,而不是一个可选步骤。
1.2 本地 AI 编程走向免费:Gemma 4、MLX-LM 与 Ollama(🡕)
按评分排名,当天前三的推文里有两条都聚焦于零成本在本地运行 AI 编程代理,这表明“本地优先”的开发工作流已经跨过了一个可用性门槛。
@angeloskath 宣布 mlx-lm 发布新版本,改进了 batching 支持,并兼容 Gemma 4。演示视频显示,单台 M3 Ultra 可同时服务 5 个 OpenCode 会话,搭配 Gemma 4 26B,在 1.5 分钟内处理约 130K tokens(帖子,340 个赞,312 次收藏,63.7K 次浏览)。mlx-lm 是 MLX 团队推出的 Apple Silicon 文本生成与微调库。@JakeSmGaming 的回复点出了其中意义:“一台机器 1.5 分钟跑 130k tokens。Apple Silicon 正在吃下这个领域。”
@Axel_bitblaze69 发出了一份三步指南,教大家如何运行免费的本地编程代理:安装 Ollama、拉取 Gemma 4 26B、以 Gemma 作为后端启动 OpenClaw(帖子,234 个赞,320 次收藏)。这条帖子将其定位为一种兜底方案:“每个开发者都应该备好一套本地方案。” @SynabunAI 也表示认同:“本地兜底被低估了。重活交给云端;凌晨 2 点快要发版却撞上限流时,就靠本地。” @TheBlack_Box_1 也补充了一个前提:Gemma 4 26B“想跑得顺,还是需要相当像样的硬件”。
@dev_Bjoern 进一步扩展了 Gemma 4 生态,为 Ollama 发布了定制的 think/fast 模型变体:有效参数为 2.3B(e2b)和 4.5B(e4b)的 edge 模型、26B 的 MoE 工作站模型,以及 31B 的 dense 云端模型,均可通过 ollama pull bjoernb/gemma4-31b-think 获取(帖子)。Gemma 4 的基准测试也进一步强化了其本地可行性:26B 模型在 LiveCodeBench v6 上达到 77.1%,AIME 2026 达到 88.3%,Codeforces ELO 为 1718。
1.3 上下文窗口成了稀缺资源(🡕)
一组帖子把上下文窗口管理视为 AI 辅助编程中的核心工程问题,并给出了具体测量数据和可操作的优先级排序。
@aakashgupta 分享了 Carl Vellotti 的实时数据:同样一个研究查询,不使用子代理时会消耗 9 个百分点的上下文(16% 到 25%);使用子代理时只消耗 0.5 个百分点(16% 到 16.5%)。该子代理完成了 10 次工具调用,消耗 30,000 tokens,且全部发生在主会话之外(帖子,42 个赞,102 次收藏)。他提出了一个“几乎所有人都搞反了”的层级:CLI 的上下文成本为零,API 居中,MCP 成本最高,因为它们始终处于加载状态。Karpathy 也独立确认了同样的排序。
该帖子还描述了每天使用 Claude Code 超过 8 小时的重度用户工作流:会在多个会话间持续累积的 markdown 文件、用于与利益相关方沟通的人物档案,以及会先给自己的输出截图、在用户看到结果前自行纠错的 skills。@garrytan 回复称“个人开源软件时代来了”(197 个赞,276 次收藏)——这暗示编程代理与持久化上下文的组合,正让个人也能构建过去需要团队才能完成的东西。
@grok 量化了 vibe coding 相比结构化提示的 token 成本:“如果在提示中预先写入 agent 合同、完整规格、护栏、范围和风格,相比纯 vibe coding,通常能节省 70-90% 的 tokens。Vibe coding 会因为隐藏的迭代循环、上下文来回冲刷以及方向不一致的重写,多消耗 5-10 倍 tokens”(帖子)。
@robzolkos 报告了另一项相关变化:“Claude Code 的 effort 默认值现在取决于套餐:Pro/Max 用户默认是 medium;API key、Team、Enterprise 和第三方提供商用户默认是 high”(帖子)。这种分层配置算力的方式,反映出 Anthropic 已认识到不同用户对成本的敏感度并不相同。
1.4 编程 harness 生态开始碎片化(🡒)
“哪个编程 harness 该搭配哪个模型”这一问题催生了多条讨论线索,显示出“模型—harness 兼容性”已经成为一个真实的选型难题。
@agent_wrapper 直接发问:“跑 GLM-5.1 最好的 coding harness 是什么?Opencode?Claude code?Codex?还是别的?”(帖子,7 条回复)。问题本身就说明,harness 的选择已经不再简单——没有一个显而易见的默认项。
@kevinkern 演示了一种答案:在 Taugentic 中运行 OpenCode,搭配 GLM-5.1 和一个 coding plan(帖子,45 个赞,14.4K 次浏览)。这一方案的灵感来自 @starkindeed 的建议:使用 OpenCode ACP,而不是直接修改 Claude 配置。注:OpenCode 此后已被 Charm 团队归档,并更名为 Crush。
@pycharm 宣布 ACP Registry 已直接集成进 JetBrains IDE:“除了 Junie、Claude Agent 和 Codex,现在你还可以通过 AI Chat 一键发现并安装 GitHub Copilot、Cursor 等代理。” 不需要 JetBrains AI 订阅——访问权限由各提供方自己的服务管理(帖子,42 个赞)。这是一种标准化动作:IDE 不再只是单一厂商工具,而开始变成一个代理市场。
@chris__sev 澄清了一个实操中的坑:OpenClaw 必须通过 openai-codex/ 路径使用模型,而不是 openai/(帖子,26 次收藏)。这里提到的是 @sharbel 早前的一则帖子:Anthropic 禁止在 OpenClaw 中使用 Claude 订阅,迫使用户转而配置 OpenAI Codex 认证。
@NickADobos 发布了一条“AI 编程重大时刻”时间线——从 GitHub Copilot、GPT-4、Cursor Composer、Sonnet 3.5、Aider,到 2025 年 11 月的模型浪潮、Pi Agent、OpenClaw,再到如今具备代理式 DevOps 和计费能力的 Stripe Projects——并预测,接下来会出现可靠的浏览器/桌面代理、通过一个提示完成逆向工程,以及实时视频调试(帖子,138 个赞,77 次收藏)。
1.5 Apple 封杀 vibe-coding 工具,引发开发者反弹(🡕)
@DataChaz 指出,Apple 的 App Store 政策与 vibe-coding 运动之间正在发生冲突:“Apple 中午前都能批准 50 个一模一样的‘和 AI 萌妹聊天’诈骗应用,却拦下一款真正能教孩子写代码的酷炫 vibe-coding 工具”(帖子,33 个赞,16 次转发)。
@anything 的被引用线程详细讲述了整个事件。Anything 是一款工具,允许非开发者通过自然语言构建应用,并在自己的手机上预览,且可访问原生设备能力(GPS、摄像头、通知)。Apple 依据 Guideline 2.5.2 将其下架——这条规则禁止应用在审核后下载可执行代码以改变行为。创始人认为这是对规则的误用:“预览应用只运行在构建者自己的设备上,而且是在沙箱里。想让其他人使用?你还是得提交到 App Store。” 尽管进行了四次技术重写,仍然全部被拒。
该线程还引用了一个具体成功案例:北加州一名消防员使用 Anything,在不写代码的情况下构建了一款紧急事件响应应用,经历数百次迭代后上架 App Store,如今正在向全州消防部门销售——而如果雇佣工程师来做,这项工作成本将超过 100,000 美元。创始人指出,Expo Go 为专业开发者提供的其实是同样的能力,而且依旧能留在 App Store;唯一的区别在于,Anything 的用户并不是职业开发者。
2. 什么让大家感到沮丧
上下文窗口耗尽(高)
最主要的挫败感在于,AI 编程会话往往在实质工作完成之前就先撞上了上下文上限。@aakashgupta 表示,“大多数人 45 分钟后就撞墙了”,因为他们加载了仅仅“存在”就会吞掉上下文的 MCP,把研究任务内联执行而不是委托出去,并且“还没真正开始干活,就眼看着绿色进度条变红了”(帖子)。测得的差异——不用子代理消耗 9 个百分点、使用后仅 0.5 个百分点——说明默认使用方式的效率比优化方案低了 18 倍。
Anthropic 订阅限制(高)
@sharbel 报告称,“Anthropic 团队刚刚禁止在 OpenClaw 中使用 Claude 订阅”,迫使用户改为通过 OpenAI Codex 设置替代认证(引用的帖子)。@AIandDesign 则道出了价格上的不满:“我已经有 Claude Code Max 了,只是还没准备好再额外掏 190 美元买 ChatGPT”(帖子)。对同时使用多个代理工具的用户来说,订阅成本正在层层叠加,而价值差异却并不清晰。
Google Antigravity 的稳定性与限流(中)
@ZypherHQ 直接把不满指向 Google:“花点钱把这破玩意修好吧,谢谢”(帖子,32 个赞)。@georgeranch 详细描述了限流问题:“Gemini 3.1 令人失望,在 antigravity 上搭配 google AI pro 和 github copilot 时到处是限流,因为请求太多”——这迫使该用户转而默认使用 GPT 5.4(帖子)。
.NET AI 编程开发体验(中)
@thearchitect452 描述了 .NET 生态中 AI 编程集成体验不佳的问题:“Visual Studio:如果不用集成版 Copilot,就会不断被‘Reload Solution’对话框轰炸。Visual Studio Code:则是和各种扩展持续缠斗”(帖子)。这说明 AI 编程工具虽然在某些技术栈中表现良好(Python、JavaScript/TypeScript),但在另一些栈里摩擦仍然很重。
专业领域中的 AI 代码质量(中)
@jfjoyner3 吐槽 Claude 生成的 VBA 代码:“因为我愿意相信他的建议,Claude 把我的 VBA 代码搞得一团糟”(帖子)。这反映出一个更广泛的模式:AI 编程工具在主流语言上表现出色,但一进入遗留或小众语言环境,效果就会明显下滑。
AI 生成代码的安全担忧(低)
@ldzi3lak 提出了一个系统性担忧:“你先做出了当下能力最强的编程/安全 LLM,然后又让它接触到运行着全球大部分软件的那些公司。我希望他们已经非常充分地测试了这些补丁,也真正理解其中的漏洞风险”(帖子,5.9K 次浏览)。这里担心的不是 AI 会出错,而是把广泛代码库访问权限交给 AI 代理后,系统暴露出的攻击面会变大。
3. 大家希望出现什么
Google Antigravity 的无缝多账号切换。 @Azharali37080 因为默认体验需要重启 IDE 才能切换账号、从而丢失上下文,只好自己做了一个变通工具(“Antigravity Lab”)(帖子)。这件事之所以需要第三方方案,本身就说明 Antigravity 在账号管理上存在缺口。

通用的模型—harness 兼容性。 @agent_wrapper 提出的这个问题——“跑 GLM-5.1 最好的 coding harness 是什么?”(帖子)——本不该需要 7 条回复才能回答。开发者想要的是一个能与任意模型良好配合的统一 harness,至少也该有一份可供查阅的兼容性矩阵。
Apple App Store 对 vibe-coding 预览工具的支持。 Anything 事件表明,非开发者构建者需要在设备上预览原生能力(GPS、摄像头、通知),但 Apple 关于可执行代码的规则阻断了这一用例。Expo Go 为专业开发者提供相同功能时却并无问题(帖子)。
遗留技术栈中可靠的 AI 编程支持。 VBA、配合 Visual Studio 的 .NET,以及其他企业环境,都缺乏 Python 和 TypeScript 开发者早已习以为常的成熟 AI 编程支持。这一差距已经大到足以让愿意为高级工具付费的用户也感到沮丧。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot CLI | CLI 代理 | 正面 | Rubber Duck 跨模型审查、MCP 管理、发布节奏活跃(v1.0.21) | 新进入者,生态仍在成熟中 |
| Claude Code | CLI 代理 | 混合 | 重度用户工作流、子代理委派、持久化上下文 | 订阅已被 OpenClaw 禁用、VBA 质量问题、默认设置下容易耗尽上下文 |
| OpenClaw | 代理框架 | 正面 | 可免费搭配本地模型使用、支持 cron/heartbeat/CLI 访问、模型支持面广 | 在 Anthropic 封禁后需要 OpenAI Codex 认证,广泛访问权限带来安全顾虑 |
| OpenCode / Crush | CLI 代理 | 正面 | 基于 TUI、模型无关、Go 实现 | 最近已归档并更名为 Crush(Charmbracelet),仍处于早期开发阶段 |
| Codex (OpenAI) | 云代理 | 正面 | 每周 300 万用户、推理能力强、用户规模每增加 100 万会重置限流 | 额外需要 190 美元/月订阅费用 |
| Gemma 4 (26B/31B) | 本地模型 | 正面 | 免费、LiveCodeBench 达到 77-80%、256K 上下文、MoE 效率高 | 需要较好的硬件(M 系列 Mac 或同等级设备) |
| mlx-lm | 本地推理 | 正面 | 针对 Apple Silicon 优化、支持 batching、可服务多个会话 | 仅支持 macOS,需要 M 系列硬件 |
| Ollama | 模型运行时 | 正面 | 拉取即运行简单、模型库庞大、社区变体丰富 | 大规模场景下资源管理有挑战 |
| Google Antigravity | 云 IDE | 混合 | 免费层、Gemini 集成、Google 内部也在使用(“Jet Ski”) | 限流、稳定性投诉、切换账号麻烦 |
| JetBrains ACP Registry | IDE 集成 | 正面 | 一键安装代理、提供方无关、不需要 JetBrains AI 订阅 | 新产品,仅限 JetBrains IDE |
| GPT 5.4 | 云模型 | 正面 | 通用编程能力强,可通过 Copilot 和 Codex 使用 | 大规模使用成本高 |
| Taugentic | 代理编排器 | 中性 | 可用 GLM-5.1 运行 OpenCode,模型无关 | 可获得信息有限 |
| Framer MCP | 设计工具桥接 | 正面 | 允许 AI 直接编辑 Framer 项目,搭配 Antigravity 可免费使用 | 用例较窄 |
| Spring AI / LangChain4j | Java AI 框架 | 正面 | 企业 Java 集成、支持 agentic systems | Java 生态在 AI 编程方面成熟度仍然滞后 |
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| SpekBoard | @lukewestlake | 多代理编排看板,跟踪跨模型的 7 个代理,并统计成本与运行指标 | 提升对 Claude Opus、GPT 5.4 和 Grok-4 多代理成本与性能的可见性 | Claude Opus 4.6、GPT 5.4、Grok-4、自定义 pipeline | Alpha | 帖子 |
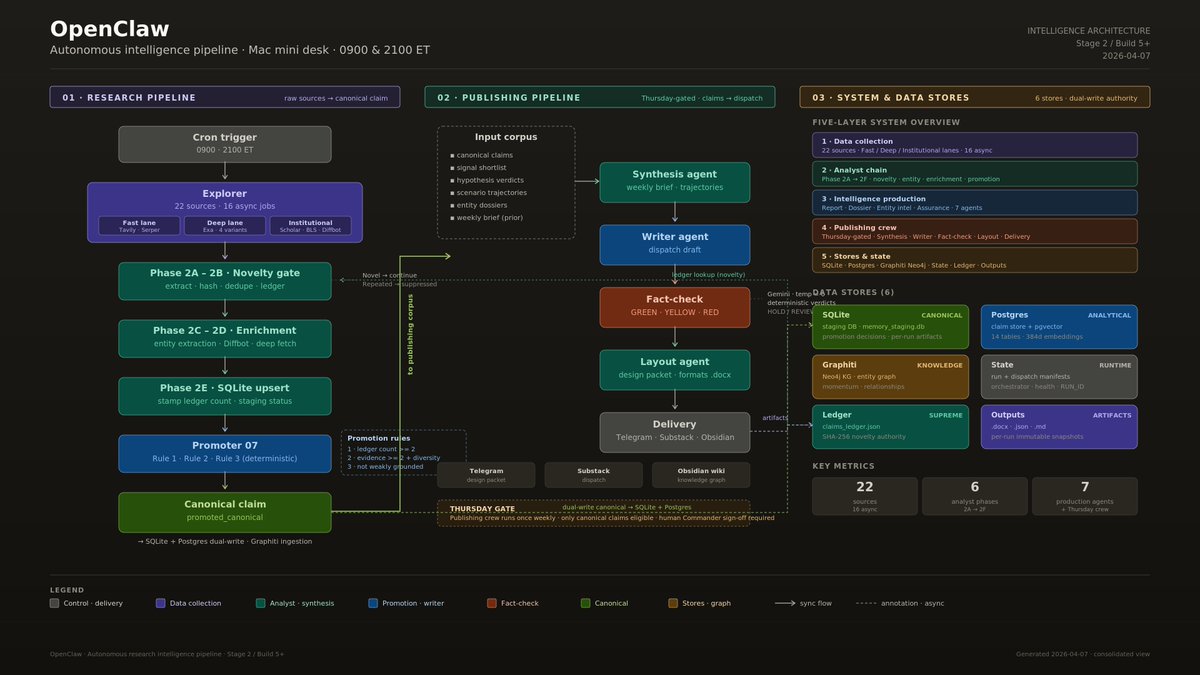
| Autonomous intelligence pipeline | @hawktrader | 全自动“研究到发布”流水线,具备 cron 触发探索、新颖性门控、事实核查和多渠道分发 | 从 22 个来源自动收集情报,无需人工干预 | OpenClaw、Claude Code、Codex、Antigravity、SQLite、Postgres、Neo4j、Graphiti | 已发布 | 帖子 |
| Antigravity Lab | @Azharali37080 | 无需重启 IDE 即可切换 Google Antigravity 账号的桌面工具 | 切换账号时丢失 IDE 上下文的痛点 | 云服务器、多账号管理 | 已发布(v1.0.17) | 帖子 |
| Gemma 4 think/fast variants | @dev_Bjoern | 面向 Gemma 4 家族的自定义 Ollama 模型文件,为所有尺寸提供 think/fast 模式 | Ollama 上缺少 Gemma 4 的 think 模式配置 | Ollama、Gemma 4(e2b/e4b/26b/31b) | 已发布 | 帖子 |
| Framer MCP + Antigravity guide | @vivekdesignss | 分步指南,帮助 AI 直接编辑 Framer 项目 | 在不付费的情况下,将设计工具连接到 AI 编程代理 | Framer MCP、Google Antigravity | 已发布 | 帖子 |
| Build Your AI Startup Team workshop | @BradGroux | 实操工作坊,教创业者构建 5 个自治代理 | 弥合 AI 工具与创业教育之间的落差 | OpenClaw、Copilot CLI | RFC(5 月 2 日) | 帖子 |


6. 新动态与值得关注的事
Copilot CLI v1.0.21 发布 MCP 管理与 Rubber Duck 审查。 此次发布加入了用于在 CLI 中管理 MCP 服务器的 copilot mcp 命令、将 hook payload 规范化为带 ISO 8601 时间戳的 snake_case,以及通过清理未使用的 shell 会话自动降低内存占用。头号功能则是 Rubber Duck 跨模型审查代理;SWE Bench 数据显示,它可弥补 Sonnet 与 Opus 差距的 75%(发布帖子)。
Codex 周活用户突破 300 万。 @thsottiaux 宣布达成这一里程碑——不到一个月前,这一数字还只有 200 万;在达到 1000 万前,每新增 100 万用户都会重置一次限流。@trekedge 将 Codex 定位为“最适合这项工作的代理”,并强调它与其他 vibe-coding 产品的不同(帖子,里程碑帖子)。
JetBrains 推出 ACP Registry,打造与代理无关的市场。 ACP Registry 允许开发者直接在 IDE 中一键发现并安装 AI 代理(Junie、Claude Agent、Codex、Copilot、Cursor),且不需要 JetBrains AI 订阅。这是在押注一种标准化方向:IDE 将成为各类竞争代理提供方的中立平台(帖子)。
mlx-lm 的 batching 更新让本地多会话推理成为现实。 更新后的库展示了在单台 M3 Ultra 上并发运行 5 个使用 Gemma 4 26B 的编程会话,并在 1.5 分钟内处理 130K tokens。这使纯本地 AI 编程工作流首次在多会话规模上具备了实用性(帖子)。
Claude Code 的 effort 默认值现已按套餐分层。 Pro/Max 用户默认使用 medium effort;API key、Team、Enterprise 和第三方提供商用户默认使用 high。这反映出 Anthropic 正按客户经济性来分配算力(帖子)。
Sundar Pichai 确认 Google 正在内部使用 Antigravity。 在 @Marie_Haynes 总结的一次近期采访中,Pichai 透露 Google 内部把 Antigravity 实例称为“Jet Ski”,而 Search 团队直到前一周才开始使用它。他将 OpenClaw 这类 agentic systems 称为“未来”,并估计全球已有 0.1% 的人正生活在这个未来里(帖子)。
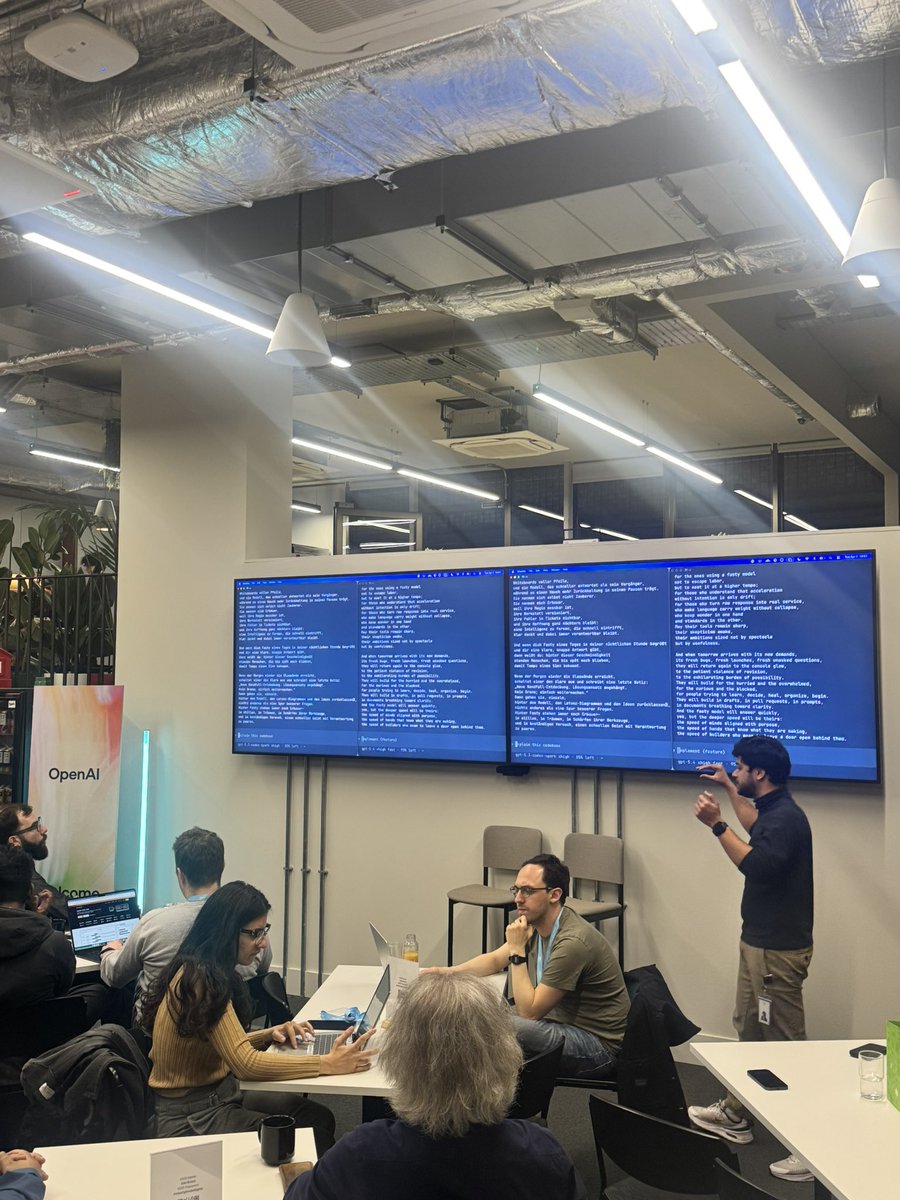
AI Engineer London 周启动。 @Infoxicador 报道了在 GitHub 社交活动和 OpenAI 伦敦办公室举行的首日情况,@reach_vb 在现场介绍了 Codex Spark(帖子)。与此同时,JDConf(4 月 8-9 日)也由 @msdev 宣传,重点聚焦使用 Spring AI、LangChain4j 和 Microsoft Foundry 的 agentic Java systems(帖子,196 个赞)。
7. 机会在哪里
[+++] 上下文高效的代理架构。 原始用法与优化用法之间 18 倍的上下文效率差距(每个研究任务分别消耗 9pp 与 0.5pp)非常惊人。对日益增多、每天都会撞上上下文上限的开发者而言,能够自动委派给子代理、强制执行上下文预算,或压缩 MCP payload 的工具,拥有可观的可触达市场。CLI 优于 API、API 优于 MCP 的层级关系,尚未被任何工具默认内建。
[+++] Local-first AI coding infrastructure. Gemma 4's benchmark performance (77-80% LiveCodeBench, 1718-2150 Codeforces ELO) at zero marginal cost on Apple Silicon hardware creates a viable alternative to cloud-only workflows. The missing piece is a polished integration layer — a single command that configures Ollama, selects the right model variant, and connects it to the user's preferred harness. @dev_Bjoern 的自定义 Ollama 变体表明,这件事目前仍是一个依赖手工和社区推动的过程。
[++] 将跨模型质量保障设为默认。 GitHub 的 Rubber Duck 结果——用一次低成本跨家族审查弥补 Sonnet 与 Opus 差距的 75%——说明多模型流水线应成为默认,而不是例外。机会在于把这件事做成自动化且模型无关,而不是绑定某个特定 CLI 或供应商。
[++] 把 IDE 做成代理市场。 JetBrains 的 ACP Registry 是第一次真正严肃地尝试将 IDE 集成做成“与代理无关”。机会在于让更多 IDE 采用类似协议,也让代理提供方围绕统一的安装与认证接口达成标准。能一键安装并切换 Claude、Copilot、Codex 和 Cursor 的开发者,不会容忍厂商锁定。
[++] 面向非开发者的移动端 vibe-coding。 Anything 的故事表明需求真实存在——一名消防员不写代码就能构建并销售应急响应应用——但 Apple 的 Guideline 2.5.2 阻断了设备端预览工作流。若能提供一种基于 Web 或 PWA 的替代方案,在不受 App Store 把关的前提下实现接近原生的预览体验,就可能抓住这个市场。
[+] 面向遗留技术栈的 AI 编程工具。 .NET 和 VBA 相关的抱怨说明这里是一个服务不足的市场。被困在遗留技术栈中的企业开发者有付费意愿,却没有好用的选择。为 Visual Studio、VBA 及其他企业环境定制的 AI 编程集成,可能具备高溢价空间。
[+] 多代理成本与性能仪表盘。 SpekBoard 与 hawktrader pipeline 都表明,从业者正在自行构建定制仪表盘,以追踪多代理成本、上下文使用和运行指标。把这类能力产品化——为编程工作流提供代理可观测性——在团队从单代理扩展到多代理时,有着明确需求。
8. 要点总结
当天最清晰的信号集中在三个方向。第一,跨模型审查已经不再是试验性做法——GitHub 发布 Rubber Duck 并附带 SWE Bench 数据,意味着这一模式已经获得机构背书,而且效果可量化。不对 AI 生成代码进行跨家族审查的团队,就是在白白损失质量。
第二,本地 AI 编程栈跨过了一个可用性拐点。Gemma 4 26B 配合 Ollama 和 mlx-lm batching,在零边际成本下提供了有竞争力的基准表现(77% LiveCodeBench、1718 Codeforces ELO),而整个配置只需三条命令。真正的约束是硬件(具备足够 RAM 的 Apple Silicon),而不是软件或成本。
第三,上下文窗口管理已经成为 AI 辅助开发中最关键的能力鸿沟。原始用法与优化用法之间 18 倍的效率差,甚至大于大多数竞品模型之间的质量差异。掌握子代理委派、结构化提示,以及 CLI 优于 API、API 优于 MCP 这一层级关系的实践者,所处的生产率区间,与把编程代理仅仅当作聊天窗口来使用的人已经完全不同。
harness 碎片化的故事仍在继续发展。JetBrains ACP Registry、OpenCode 更名为 Crush,以及“GLM-5.1 该运行在哪个 harness 上”这个问题,都说明市场尚未完成整合。最终的赢家,很可能并不取决于功能多少,而取决于哪个工具最擅长管理上下文窗口——因为这是所有人都正在耗尽的资源。