Twitter AI 编程 - 2026-04-09
1. 人们在讨论什么
1.1 代码库感知型智能体正在挑战“Grep and Pray”范式 🡕
当天互动量最高的帖子来自 @BniWael。该用户 推出了 SoulForge(524 个赞、834 次收藏、5.7 万次浏览),直接抨击了当前编程智能体浏览代码仓库的方式:“大家都在争论 Claude Code、Codex 和 OpenCode 谁更强。与此同时,它们的 token 还在白白燃烧,因为智能体每次收到提示都要 grep 整个仓库,然后碰运气,却对代码库架构一无所知。”
SoulForge 的核心观点是:智能体性能的瓶颈在于定向与理解代码,而不是模型能力本身。该工具启动时会构建代码库的实时依赖图——对每个文件、符号和导入按重要性排序,结合 git 历史,并实时更新。智能体需要上下文时,会进行外科手术式读取(比如从一个 500 行文件中只提取单个函数),而不是把整个文件塞进上下文窗口。开源仓库(525 个 star,TypeScript)配备四层代码智能栈:LSP、ts-morph、tree-sitter,以及正则回退。内嵌的 Neovim 实例提供跳转到定义、查找引用和调用层级等能力——也就是 IDE 具备的那种智能,而不是基于模式匹配的近似替代品。
其基准测试说法非常具体:同一个 bug、同一个 Claude Opus 4.6、同一个代码库——6 分 22 秒对 11 分 18 秒(快 1.8 倍),1.70 美元对 3.52 美元(便宜 2.1 倍)。多智能体调度会并行运行探索、编码和搜索智能体,并通过共享上下文总线协作,避免重复劳动或产生文件冲突。模型路由则允许用户用 Opus 负责规划、Gemini 负责调研、Haiku 负责快速修改,并通过 Ollama 使用本地模型处理一次性任务。
其他功能包括多标签页会话(最多 5 个并发),每个标签页可单独指定模型并协调 git;$0 压缩(实时跟踪上下文状态,无需额外发起 LLM 调用即可触发压缩);兼容 Claude Code 的 .claude/settings.json 格式的生命周期钩子;以及可通过 Ctrl+S 浏览的可安装技能注册表。该工具支持 20 多家提供商,包括 Anthropic、OpenAI、Google,以及通过 Ollama 接入的本地模型。
@yabsssai 的回复追问:“架构知识”究竟如何具体降低成本——答案是,依赖图消除了主导大多数智能体会话的探索轮次。另一条回复则 @ 了 @ThePrimeagen,指出其内嵌 Neovim 集成。
1.2 OpenAI 新增每月 100 美元 Pro 档,Codex 定价逐渐清晰 🡕
OpenAI 推出新的中间价位方案,主导了当天关于定价的讨论。@Cointelegraph 率先爆出了消息(115 个赞、1.48 万次浏览):每月 100 美元的 ChatGPT Pro 档,为 Codex 提供相当于每月 20 美元 Plus 方案 5 倍的用量,面向高强度 AI 编程工作流。@MacRumors 确认了细节(93 个赞、2.36 万次浏览):现有每月 200 美元的 Pro 档提供 20 倍用量,此外上线促销期间,100 美元订阅者在 5 月 31 日前可获得相当于 Plus 10 倍的用量。
现在的定价结构与 Anthropic 完全一致:20 美元、100 美元和 200 美元三档。OpenAI 还在“重新平衡”Plus 用户的 Codex 用量,让用户能把更多会话分散到一周内,而不是在单日内拉长会话时长——这暗示重度用户此前可能频繁耗尽日配额并因此流失。
@DjaniWhaleSkul 给出了 持怀疑态度的看法:“从图上看得很清楚,OpenAI 一旦靠 Codex 拿稳用户盘,就会改规则。”@cosmosdigitalz 在回复 Cointelegraph 帖子时表示:“ChatGPT 想和 Claude 竞争,但 Claude 已经遥遥领先。”另一位 @DjaniWhaleSkul 则预测,定价最终会让雇佣人类开发者再次变得更有性价比。
1.3 移动端智能体控制与多模型编排走向主流 🡕
@damnGruz 发布了当天互动量第二高的帖子,介绍 Lunel(518 个赞、544 次收藏、6.8 万次浏览):这是一款开源 iOS 应用,可通过手机运行 Codex、OpenCode、Claude Code,以及完整开发环境。该帖引用转发了 @theo 的帖子;后者此前曾问:“我想用手机控制我的智能体。你们想要什么样的工作流?”Lunel 给出了一个现成、可用的答案。后续回复称,欧洲地区的可用性仍在推进中。
在多模型方面,@acolombiadev 通过 GitHub Copilot CLI 演示了 同时运行 Claude Opus 4.6、GPT 5.4 和 Gemini 3(127 个赞、85 次收藏),由一个主智能体综合多个模型各自独立完成的代码审查结果。该技术来自 @Ryan_Hecht 在 GitHub Checkout YouTube 节目中的分享。@josephficara 在回复中确认:“让 LLM 组成审查委员会,是我们团队的标准做法。”他们把多模型审查固化成智能体技能,用于生成 PR 内联反馈和 Markdown 分析报告。
@kjehiel 提出了一个实际问题:“Gemini 模型从 copilot cli 里消失了。几周前还好好的。”跨平台的模型可用性不稳定,正逐渐成为反复出现的摩擦点。
1.4 开发者身份问题变得更尖锐了 🡒
@brandenflasch 提出了一个看似简单、却引来大量实质性回复的问题:“在使用 Codex 和 Claude Code 进行构建的时代,怎样的人算是软件开发者 / 工程师,怎样的人不算?”(10 个赞、7 条回复、2,200 次浏览)。
@ChadMoran 给出了获赞最多的回复(22 个赞):“你得能自己推理并调试代码。我觉得我们正走向一种新的‘产品工程师’角色——那些能有效说清自己想要什么、并拿到好结果的人。我认为软件工程师和产品经理正在合流。”@brian_henderson 则拿音乐作比:“很多人都能借助工具创作音乐。技能面更广的人,更有可能成为成功的音乐人。”
@jamwt 在另一条高互动的 回复 @martin_casado 中提出了相关立场(141 个赞、2.6 万次浏览):“这就是为什么大家需要用比如 cursor 和 opencode。不要让实验室掌控这些服务。可能是个激进观点,但我们也应该按 API 价格买 token,而且要用 composer 2。用赔本引流把更好的应用打成灰,长期来看对消费者会非常糟糕。”其担忧在于:实验室的补贴式定价会摧毁独立工具,最终把开发者锁进供应商生态。
2. 什么让人沮丧
Google Antigravity 高价低可靠(严重程度:高)
@dongqubo 发布了一条关于每月 250 美元 Google AI Ultra 的 重复出现的服务器错误截图:连续四次点击 Continue(36 秒、5 秒、5 秒、55 秒),全部返回“我们的服务器当前正处于高流量状态”。该用户表示,这不是个例——“几周来每天、整天都是这样。Antigravity 根本没法用。”

@Yashavanth_g_h 则遇到了另一种故障模式:5 分钟内耗尽模型配额。设置截图显示了 Antigravity 提供的完整模型列表——Gemini 3.1 Pro、Gemini 3 Flash、Claude Sonnet 4.6(Thinking)、Claude Opus 4.6(Thinking)和 GPT-OSS 120B——不同模型的刷新窗口从 5 小时到 5 天不等。

@MATEOINRL 免费把 Antigravity 和 Codex 搭配使用,但也承认 “Google 把 antigravity 搞砸得很彻底。”
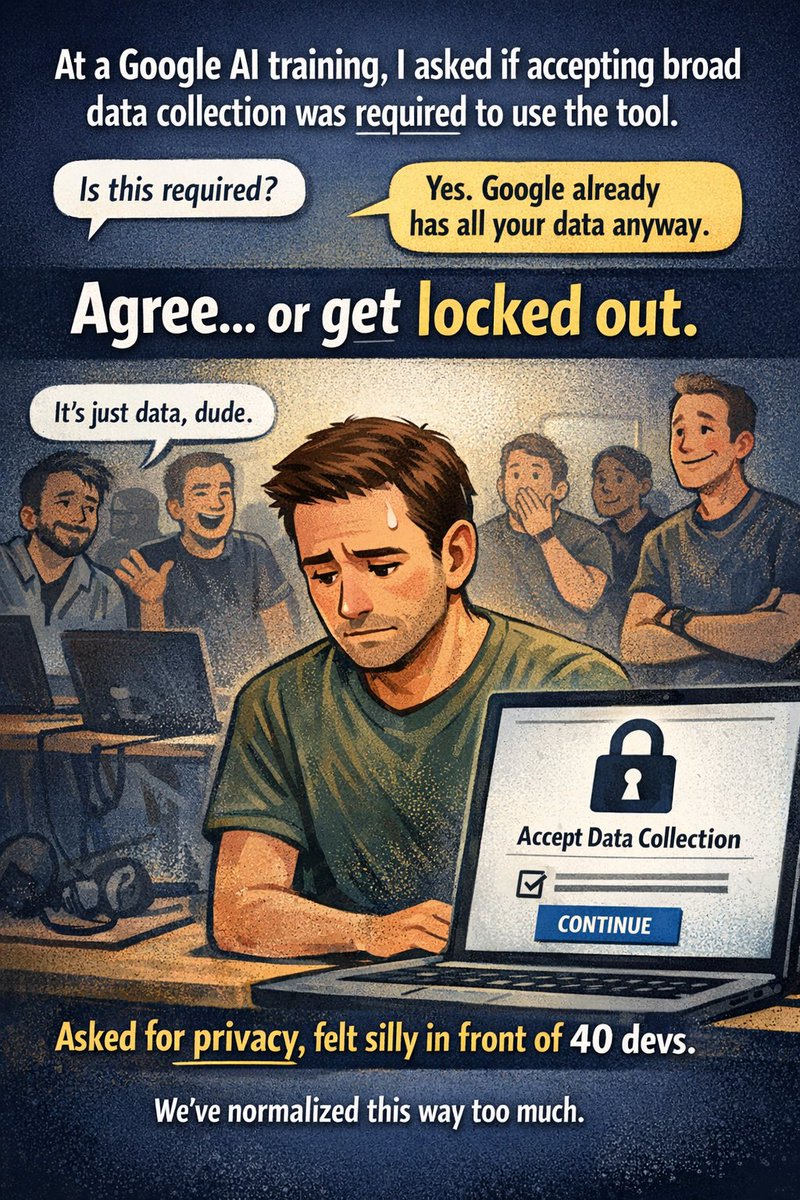
Google AI 培训活动中被迫同意数据使用(严重程度:中)
@danicuki 讲述了自己在一场 Google AI 培训活动上,为了使用 Antigravity 被 被迫接受广泛的数据收集:“‘我要继续的话必须同意这个吗?’回答是:‘对。’接着又说:‘反正 Google 早就有你的所有数据了。’”问题不完全在政策本身,而在于当时的社交氛围——在 40 位开发者面前询问隐私问题,反而会让人显得不近人情。“我们已经把监控正常化到这种地步:现在连提出边界都像是不合理的要求。”
GitHub 使用 Copilot 用户数据训练 AI(严重程度:中)
@gthimmes 指出,“GitHub 现在将使用 Free、Pro 和 Pro+ 用户的 Copilot 数据来训练 AI 模型。默认已选择加入。”。担忧在于:“你用来写代码的工具,正在从你写代码的方式里学习,不管你有没有同意。”
所有平台都存在限速(严重程度:中)
限速成了一个横跨平台的共同痛点。@MelansonIndus 在回复 Copilot CLI 的多模型演示时说:“然后你发几个请求就会被限流。”Antigravity 用户则报告称,5 分钟内就会耗尽配额。整体模式是:每个平台都展示出强大能力,但都被使用上限卡住,而重度用户几乎立刻就会撞线。
3. 人们希望存在什么
与高价相匹配的可靠基础设施
用户支付的价格与实际获得的服务之间存在明显落差。每月 250 美元的 Google AI Ultra 持续报服务器错误。OpenAI 的回应——新增 100 美元档——解决了定价颗粒度问题,却没有解决高阶用户真正需要的底层可靠性。高强度编码会话需要的是持续、可预测的吞吐,而不是分层开放、但未必随时可用的容量。
与模型无关的智能体可移植性
@brennoferrari 的 obsidian-mind v4 解决了持久记忆的问题——同一套 vault、hooks 和命令可跨 Claude Code、Codex CLI 和 Gemini CLI 使用。更广泛的期待是:所有智能体工具都应具备可移植性——会话进行到一半撞上 Claude 的限速,直接切到 Gemini 继续干。@jamwt 提出的“不要让实验室掌控这些服务”、改用 API 定价,反映的也是同样的需求。@carlsue 描述了一种 务实的拆分:“建议用 opus 做代码审查或架构设计,用 Codex 来写真正能跑的代码。”
智能体协作式终端工作流
@MrOcelot1976 描述了一个 多智能体终端工作流:多个智能体在同一个终端里,借助 GitHub 上的 Claude-Code-Base 搜索协同工作:“看它们来回发消息很有意思。它们各有所长,能互相补位,而且相处得不错。”@bedesqui 指出,OpenCode 的 Web UI 与 Tailscale 的组合 支持通过别名从任意设备连接到 localhost——对远程访问智能体来说,这是专用移动应用之外的一种轻量替代方案。
不受额度墙限制的智能体基准测试
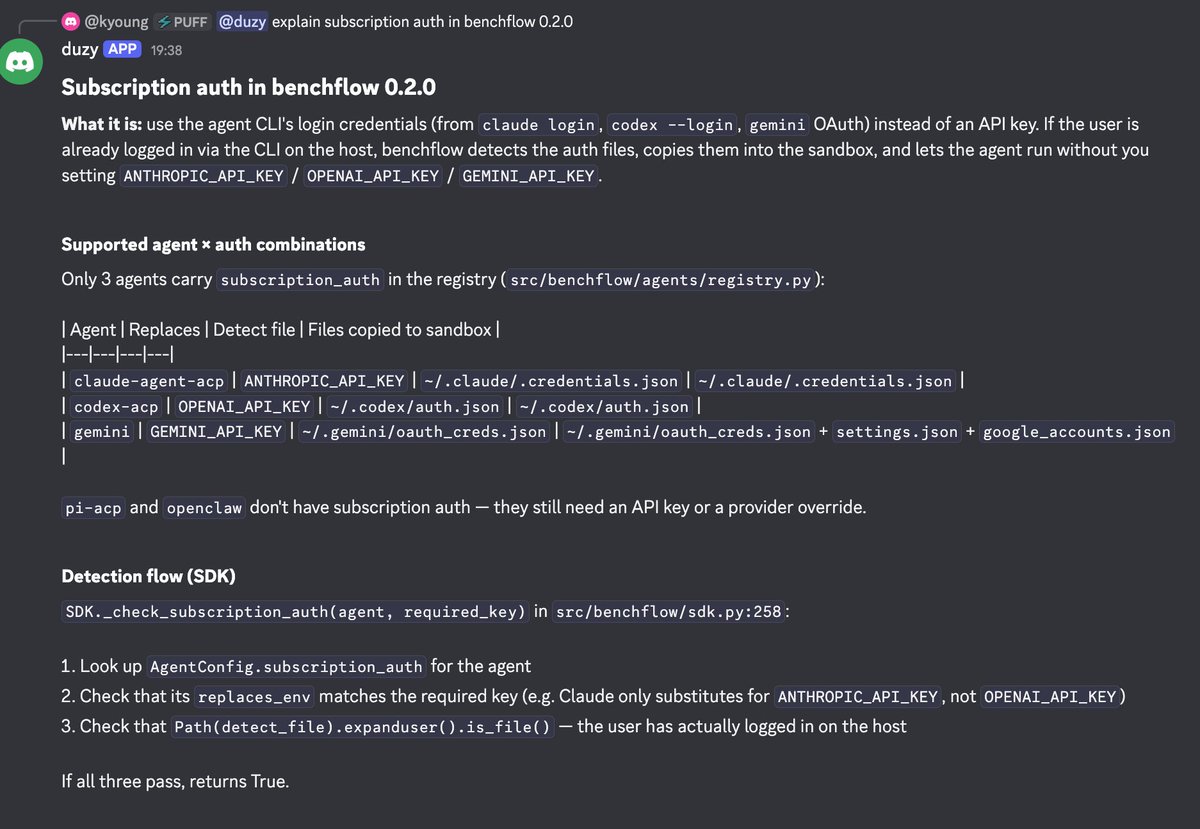
@xdotli 预览了 benchflow 0.2.0,用来解决针对订阅制智能体运行基准测试的问题。该工具会检测主机上的 CLI 登录凭据(claude login、codex --login、gemini OAuth),并将其注入沙箱化基准环境,从而无需单独准备 API 密钥。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| SoulForge | 编程智能体 | 正面 | 实时依赖图,基准测试中快 1.8 倍/便宜 2.1 倍,内嵌 Neovim,多智能体调度,支持 33 种语言 | 525 个 star,进入市场较晚,依赖 Neovim |
| Lunel | 移动端智能体控制 | 正面 | 可通过手机运行 Codex/OpenCode/Claude Code,开源,iOS 应用 | 欧洲地区暂不可用,GitHub 仓库目前无法公开检索到 |
| GitHub Copilot CLI | 智能体编排 | 正面 | 可同时运行 Claude Opus 4.6、GPT 5.4 和 Gemini 3,并综合审查结果 | 多模型运行时会被限速,Gemini 模型间歇性不可用 |
| Claude Code | 编程智能体 | 褒贬不一 | 新增用于后台脚本的 Monitor 工具,代码产出能力强 | 存在限速,对供应商锁定的担忧 |
| OpenAI Codex | 编程智能体 | 褒贬不一 | 新增 100 美元档,提供 5 倍用量,集成面广(Shopify、Cursor、VS Code) | Plus 档被“重新平衡”以分散用量,引发对价格升级的担忧 |
| Google Antigravity | 编程平台 | 负面 | 提供免费层,可访问多模型(Gemini、Claude、GPT-OSS) | 每月 250 美元却有严重可靠性问题,被迫同意数据使用,5 分钟内耗尽配额 |
| obsidian-mind | 智能体记忆 | 正面 | 为 3 个智能体提供持久记忆 vault,GitHub 1,866 个 star,支持 session/standup/dump 命令 | 需要 Obsidian,依赖 Python |
| benchflow | 基准测试 | 正面 | 支持订阅认证(无需 API 密钥),基于 Docker,支持 WebArena/SWE-Bench | 仍处早期(v0.2.0),支持的智能体有限 |
| OpenCode | 编程智能体 | 正面 | 开源,带 Web UI,兼容 Tailscale,便于远程访问 | 生态规模小于 Claude Code/Codex |
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| SoulForge | @BniWael | 具备代码库感知能力、带实时依赖图的编程智能体 | 智能体把轮次浪费在定向上,而不是真正工作 | TypeScript、Neovim、LSP、tree-sitter | 已发布 | GitHub |
| Lunel | @damnGruz | 通过手机控制编程智能体的移动应用 | 移动端无法管理 Codex/Claude Code/OpenCode 会话 | iOS、开源 | 已发布 | 帖子 |
| obsidian-mind v4 | @brennoferrari | 让 AI 智能体跨会话保留持久记忆的 Obsidian vault | 智能体会忘记跨会话上下文,每次都要重新解释 | Python、Obsidian、Claude Code/Codex CLI/Gemini CLI hooks | 已发布 | GitHub |
| benchflow 0.2.0 | @xdotli | 支持订阅凭据透传的 AI 基准测试运行时 | LLM 额度墙阻碍基准测试运行 | Python、Docker | Beta | GitHub |
| VoxHeart | @MrShiLLi | 带程序化生成、建造、火车和电力系统的体素游戏 | 用 AI 编程给孩子做游戏 | Claude Code | Alpha | 帖子 |
| Sober Tracking App | @MarcusFurrelius | 基于 Algorand 区块链的戒酒追踪应用 | 记录个人康复里程碑(戒酒超过 9 年) | Google Gemini、Antigravity、VibeKit | Alpha | 帖子 |
6. 新动态与值得关注的项目
OpenAI 每月 100 美元 Pro 档。 Codex 新增的中间价位位于 20 美元 Plus 方案与 200 美元 Pro 方案之间。它提供相当于 Plus 5 倍的用量,且上线促销期间到 5 月 31 日前翻倍至 10 倍。这表明重度 Codex 用户已经超出 Plus 的承载范围,但又不愿直接跳到 200 美元。现在的定价结构与 Anthropic 完全一致。来源
Claude Code Monitor 工具。 Anthropic 的 @noahzweben 宣布:Claude 现在可以 创建在需要时唤醒 agent 的后台脚本。使用场景包括跟踪日志错误、轮询 PR,以及其他事件驱动型工作流。@obie 称其为 “CLAUDE CODE 重磅新功能”(17 个赞、16 次收藏、5,800 次浏览),@CodedVibes 则指出其意义:“它不再等你了。它会自行观察并采取行动。” 这让 Claude Code 从一个被动响应工具转向主动监控工具,并通过消除轮询循环显著节省 token。其架构模式——由后台脚本基于外部事件唤醒智能体,而不是持续轮询——与生产监控系统多年前采用的模式相同,如今开始进入 AI 编程工具。
Shopify AI 工具包。 Shopify 推出了集成,与 Claude Code、Codex、Cursor 和 VS Code 集成,用于店铺管理。@AskMattCaron 是一名 SEO 专家,他立刻发出警告:“请不要只是点一下‘SEO optimize’,就指望有好结果。”他的担忧非常具体——90% 的 Shopify 店铺都存在关键词蚕食:多个页面争夺相同关键词,collection 页面与博客文章互相重叠,还有一些没人记得创建过的落地页在悄悄抢走权重。在这团乱局上再叠加 AI 生成的 SEO 文案,只会进一步强化问题。“在坏掉的地基上踩油门,只会更快开到错误的目的地。”这个警告不只适用于 Shopify:当 AI 工具包接入那些已经背负内容债的平台时,幼稚的自动化会比人工流程更快放大结构性问题。@Pepecash_sol 已经预见到这种碰撞:“shopify 卖家马上就要发现 vibe coding 了,而没人准备好迎接这一切。”
Anything Vibe Coding 市场。 @chrisjarou 强调了 Anything 的 一个 marketplace 的发布,在这里,用 vibe coding 做出的应用可以被购买、改编和出售。这是首次出现围绕 AI 生成应用形成二级市场、并将其当作可交易资产的案例。
墨西哥首场 OpenAI Codex Meetup。 @_javierivero 组织并主持了 墨西哥首场 Codex 社区活动(130 个赞),现场分享了如何用 Claude Code、Codex、Cursor 等工具搭建任务可用性的“工厂”。这场活动表明,Codex 社群正在美国之外形成。
“Claude Code Developer”招聘,年薪 15 万美元。 @startaicompany 发布了 全远程职位,招聘一名“AI Native Claude Code developer”,基本年薪 15 万美元,另加股权。职位名称本身——以工具而非语言或框架定义角色——标志着 AI 原生开发岗位的表述方式正在发生变化。
7. 机会在哪里
[+++] 代码库智能层。 SoulForge 的热度(4,881 互动分、834 次收藏)表明,市场对“先理解代码结构再行动”的智能体存在强烈需求。依赖图方法——按重要性给文件排序、跟踪符号关系、进行外科手术式读取——几乎将智能体成本减半。如今几乎所有编程智能体都能从这一层获益,但大多数仍默认依赖 grep 式发现。构建一个可插接任意智能体的独立代码库智能服务,而非只服务某个特定 CLI 工具,将覆盖最广的市场。SoulForge 同时支持 20 多家提供商并具备模型路由,这说明真正可防御的组件是智能层,而不是模型本身。
[++] 智能体订阅凭据管理。 benchflow 0.2.0 解决了一个狭窄但不断增长的问题:在沙箱中使用订阅凭据而不是 API 密钥来运行编程智能体。随着越来越多开发者通过订阅方案(而不是裸 API)使用 Claude Code、Codex 和 Gemini CLI,任何需要在自动化或基准测试环境中调用这些智能体的工具都会撞上凭据墙。一个能够在容器化环境中检测、轮换并注入订阅认证的通用凭据代理,应用场景不止基准测试——CI/CD 流水线、智能体间委派和沙箱编排都面临同样的限制。
[++] 移动优先的智能体编排。 Lunel 的互动表现(3,376 分,6.8 万次浏览下有 544 次收藏)说明,用手机控制编程智能体并不是可有可无的附加功能——它是对一位拥有 80 多万粉丝创作者提问的直接回应。随着智能体处理复杂任务所需时间越来越长,“运行在服务器上的智能体”与“离开办公桌的开发者”之间的鸿沟也在扩大。面向移动端设计的通知、审批和引导界面——而不是缩小版终端——有明确的产品空间。欧洲地区的可用性也已经有人提出需求。
[+] AI 工具可靠性监控。 Google Antigravity 的定价(每月 250 美元)与其可靠性(持续服务器错误、5 分钟配额耗尽)之间的反差,催生了对 AI 编程工具可用性、吞吐和配额消耗进行独立监控的需求。一个专为 AI 编程平台打造的“宕机了吗”服务——跟踪 Codex 配额重置、Antigravity 服务器可用性、Claude 限速,以及 Gemini 模型在不同入口的可用情况——将服务于越来越多依赖这些服务正常运行的开发者。这类服务的数据也能帮助用户做购买决策:今天,用户在承诺订阅之前,无法比较 20 至 250 美元价格带内各家服务的可靠性。
[+] Platform-Aware AI Automation Guardrails. The Shopify AI Toolkit launch and @AskMattCaron 对关键词蚕食问题的即时警告揭示了一个机会:AI 工具在执行之前就应理解平台特定约束。一个具备 Shopify 感知能力的智能体,如果能在生成新内容前先审计竞争页面、重复 meta 标题和重定向链,就能避免“在坏掉的地基上踩油门”这种失败模式。同样的模式也适用于任何 AI 自动化可能放大既有结构性问题的平台——WordPress SEO、AWS 基础设施即代码、数据库 schema 迁移,都有通用 AI 工具往往忽略的领域特定前提条件。
8. 要点
今天最强烈的信号是,智能体的智能正从模型本身转向其周边基础设施。SoulForge 带来的 2 倍性能提升,并不是因为模型更强,而是因为它更理解模型所处的代码库。obsidian-mind 让智能体的记忆能够跨会话、跨提供商保留。benchflow 则让智能体凭据能在沙箱中工作。这些都是让现有模型更高效的基础设施玩法,而它们获得关注的速度,甚至快过模型本身的改进速度。
定价趋同正在加速。 OpenAI 新增的 100 美元档,与 Anthropic 的 Max 5x 方案完全镜像。两家公司都已经落在 20/100/200 美元这组自然分层上,分别对应个人开发者、重度用户和团队。Google 仍是那个每月 250 美元、却明显更不可靠的异类,这为竞争对手争取那些对 Antigravity 失望、但又想要多模型访问的用户打开了窗口。
开发者身份问题已经不再只是哲学讨论。 当一则招聘以 15 万美元年薪招募“Claude Code Developer”,而社区成员又在认真讨论使用 Codex 是否算工程师时,软件开发角色的重定义已经开始。无论是 @ChadMoran 提出的“产品工程师”框架,还是 @jamwt 对 API 价格透明的坚持,都指向同一个新共识:价值正从代码生产转向代码推理,从使用工具转向不被工具绑定。