Twitter AI 编程 - 2026-04-17
1. 人们在讨论什么
1.1 GitHub Copilot 速率限制危机逼近临界点 🡕
当天关于 Copilot 速率限制问题最详尽的梳理,来自 @OwenGregorian,后者 分享了 The Register 的完整报道(6 个赞、1 个收藏、1,024 次浏览)。文中记录了几件事:2026 年 3 月发现的令牌计数漏洞,低估了 Claude Opus 4.6、GPT-5.4 等新模型的令牌消耗;漏洞修复后,限制值恢复为原先配置,导致最长达 181 小时的锁定;Anthropic 的 Opus 4.6 Fast 面向 Copilot Pro+ 用户下线;以及 GitHub 因滥用暂停了所有 GitHub Copilot Pro 免费试用。文中引用的一名开发者称,自己遭遇了 44 小时的“每周速率限制”,并表示切换到 Auto 模式后,“性能明显更差”。
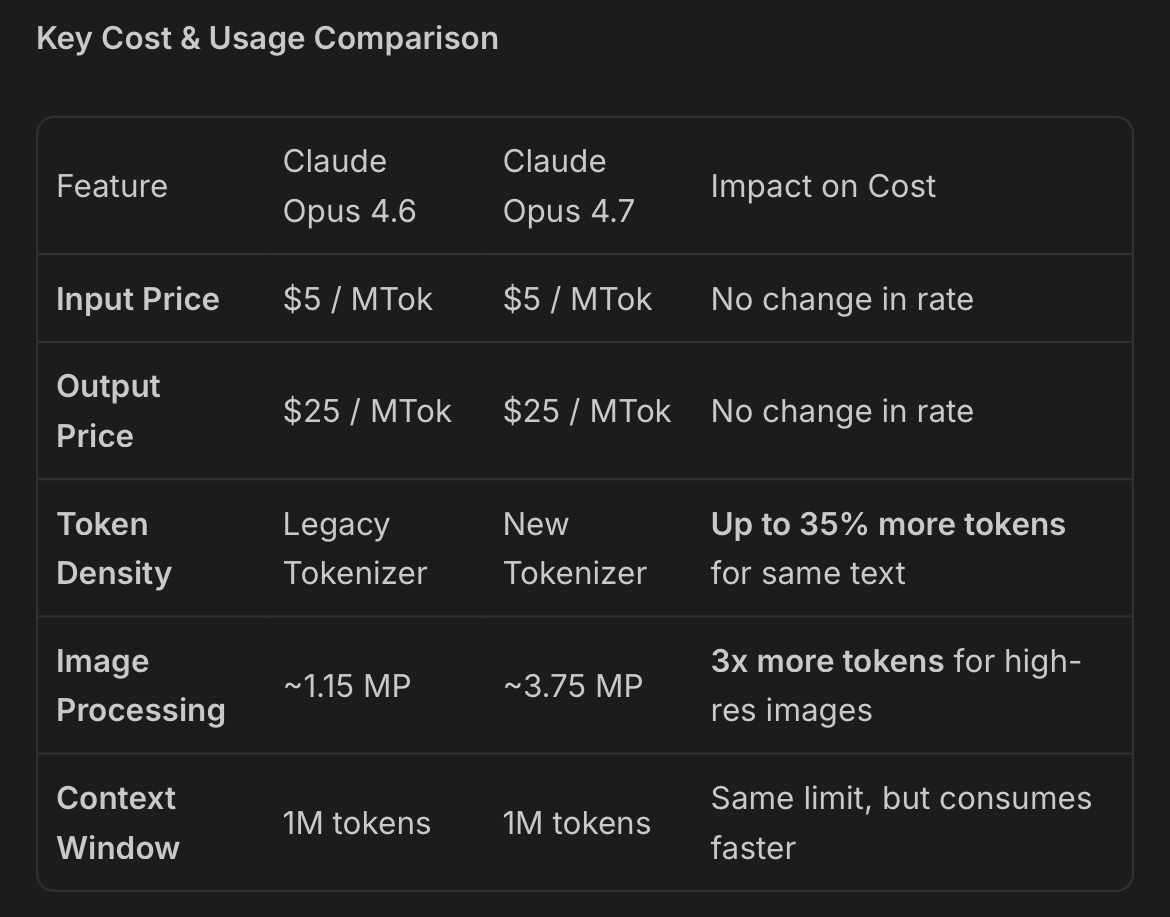
@edandersen 提供了量化分析(2 个赞、3 条回复、195 次浏览)显示,Opus 4.7 的新分词器在处理相同文本时会多产生 35% 的令牌,在处理高分辨率图像时则会多产生 3 倍令牌(约从 1.15MP 到 3.75MP),而 API 定价仍维持不变:输入 $5/MTok,输出 $25/MTok。他指出,单凭这一点仍无法解释 GitHub Copilot 使用量倍率为何会从 3 倍升到 7.5 倍,这意味着 Anthropic 可能调整了向 Microsoft 收取的价格。
此外,@shaneleexcx 链接到一篇 GitHub 博文(1 个赞、1 个收藏)宣布,自 4 月 24 日起,Free、Pro 和 Pro+ 用户的 Copilot 交互数据——包括输入、输出、代码片段和上下文——将用于模型训练,除非用户主动退出。Business 和 Enterprise 用户不在此列。这项政策变化进一步加深了速率限制问题造成的信任流失。
讨论要点: The Register 将这场危机界定为定价模型崩塌,而非容量问题:新模型打破了固定费率订阅赖以成立的成本假设。分词器分析则给出了一个具体机制——在每令牌价格不变的情况下,Opus 4.7 让文本令牌数膨胀 35%,图像令牌数膨胀 3 倍。两者叠加,对订阅用户形成双重挤压。
与前一天对比: 昨天还只是用户对速率限制的抱怨;今天则升级为行业媒体的调查报道,附带结构性分析、量化成本拆解,以及一项在开发者信任层面另开战线的数据使用政策变化。
1.2 Warp 正在构建多智能体评审层 🡕
Warp 在一天内发布了两项重要功能。@warpdotdev 宣布推出 /remote control(48 个赞、3 条引用、1,566 次浏览):可通过网页或手机分享编码智能体会话,并支持实时光标,兼容 Claude Code、Codex 和 OpenCode。随后在一篇 第二篇帖子(36 个赞、8 个收藏、1,250 次浏览)中,Warp 又推出了终端内代码评审,用于审查智能体编写的代码,支持 diff 视图、LSP 悬停提示与跳转到定义,以及可发回给智能体的行内评论——“像做 PR review 一样,但无需离开终端”。
@draginol(Brad Wardell,Stardock CEO)推荐了 Clairvoyance(4 个赞、2 个收藏、570 次浏览),展示了它如何在单一界面中,通过 8 个具名且职责分工明确的 AI“员工”智能体(Bug Fixer、Memory Monger、Publisher 等)管理一个游戏迁移项目:“我人在咖啡店,却可以通过和 Claude Code 对话,安全地让我的桌面电脑干活。”
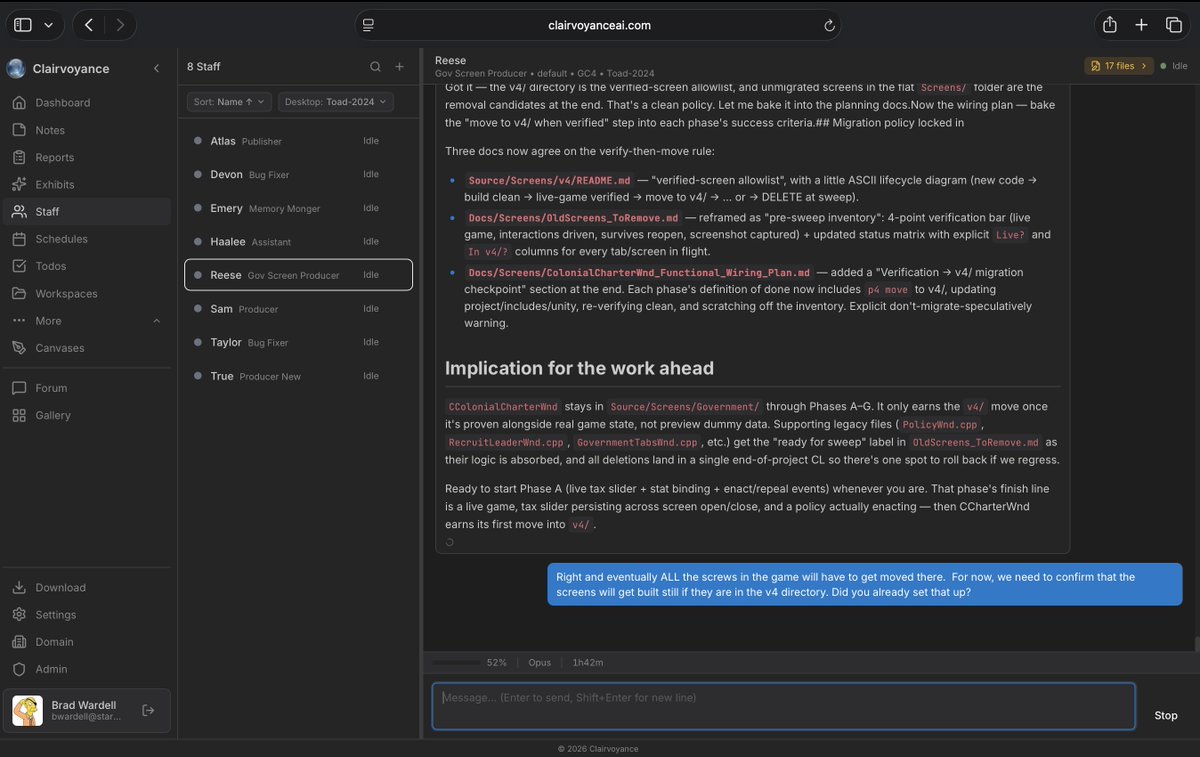
讨论要点: 智能体交互正在分化出两种不同模式:Warp 把终端当作评审界面,把 PR 式工作流带到智能体输出上;Clairvoyance 则把智能体当作一支可管理的团队,具名分工、任务委派。两者都基于同一个前提:用户需要监督和审查智能体的工作,而不只是接收结果。
与前一天对比: 昨天 Warp 发布的是智能体通知功能(任务完成或被阻塞时提醒);今天则扩展到完整的远程会话共享和终端内代码评审,从被动监控走向跨设备主动协作。
1.3 令牌压缩正在成为一个新品类 🡕
同一天出现了两个彼此独立、却在解决同一问题的工具:AI 编程智能体会把大量令牌浪费在嘈杂的 shell 输出和样板化上下文上。
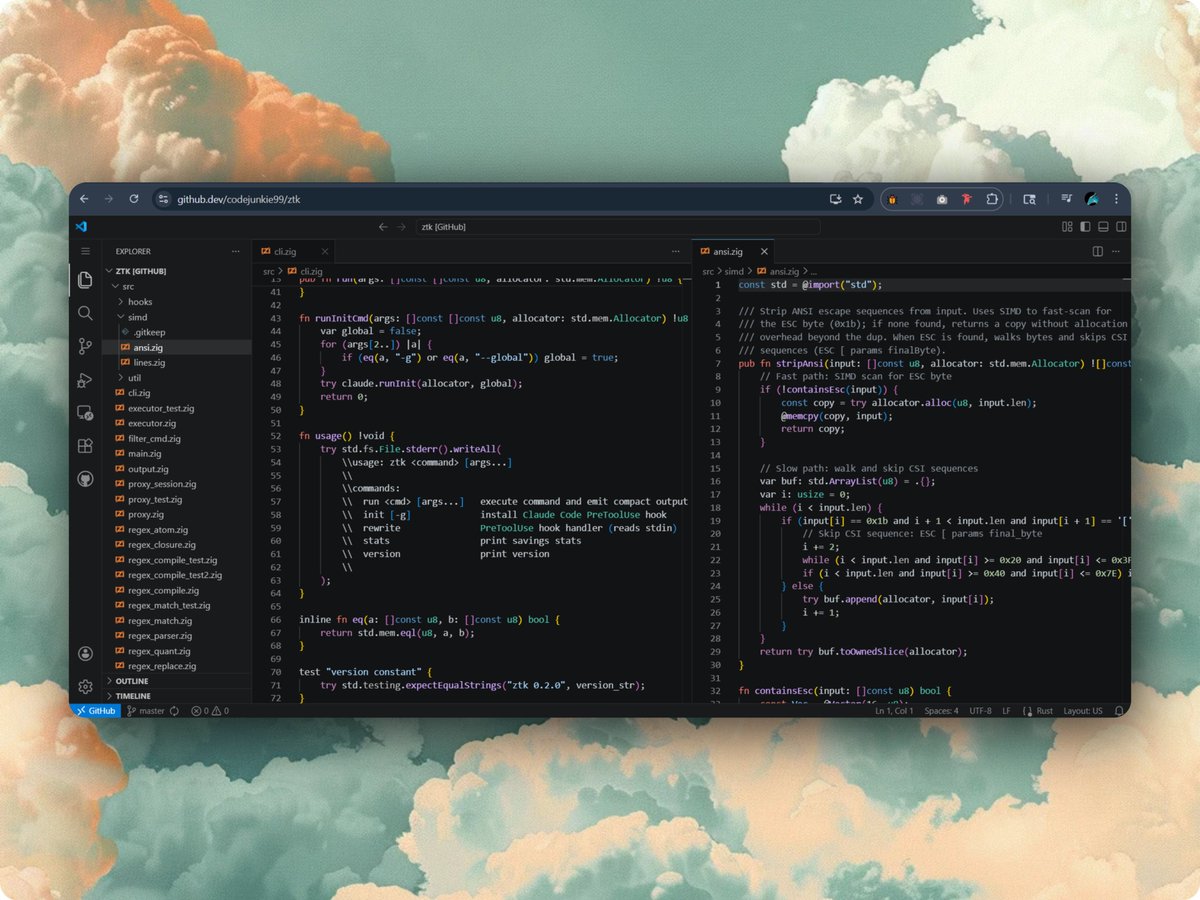
@ItsRoboki 分享了 ztk(2 个赞、1 个收藏、23 次浏览),这是一款基于 Zig 的 CLI 工具,位于 Claude Code 与 shell 之间,在命令输出到达模型前先做压缩。GitHub 仓库 记录了它在 256 条真实命令上的表现:总体令牌削减 90.6%;git diff HEAD~5 从 92,000 个令牌降到 18,000 个;cargo test(全部通过)从 397 个令牌降到 21 个。该二进制文件大小仅 260KB、零依赖,内置 56 个过滤器,支持 SIMD 文本处理,并有 217 个测试。
@pratikbin 称赞了 Headroom 压缩引擎(1 个赞、1 次转发、1 个收藏、26 次浏览)称,在 Opus 4.7 令牌消耗偏高的情况下,这个工具与 Claude Code 配合良好。GitHub 仓库 显示,Headroom 作为任意智能体与 LLM 提供方之间的代理运行,并提供 Python 和 TypeScript SDK。配图中的仪表板显示:642 次请求共节省 6,822,424 个令牌,省下 $27.35,缓存命中率 93.2%,且零失败。

讨论要点: 两个独立工具同时瞄准同一问题,说明需求真实存在。ztk 工作在 shell 层(命令输出进入上下文窗口前先压缩),Headroom 工作在 API 层(压缩智能体与 LLM 之间的全部上下文)。两者都在回应同一经济压力:Opus 4.7 令牌膨胀 35%,再叠加速率限制收紧,使上下文效率不再只是优化项,而成了硬性要求。
与前一天对比: 昨天,令牌压缩还不是一个显著话题;今天,它已以两个带有可量化结果的已发布工具正式出现,直接由 Opus 4.7 的令牌成本上升和 Copilot 速率限制收紧所推动。
1.4 Claude Code 与 Codex:转用之争升温 🡕
@chatgpt21 为 Claude Code 辩护(10 个赞、4 条回复、634 次浏览)回击了 @theo 的批评,称:“它是 4 个月前由一个人做出来的。对于一款 100% 靠 vibe coding 完成所有更新的产品来说,它已经非常惊艳。”他还把它定位为“首个触达如此多用户的 vibe coded 软件”,并称“每天有数百万人在使用”。
@2sush 注意到开发者正在转向其他工具(4 个赞、89 次浏览)表示自己从 Claude Code 转向了 Codex:“事实证明,如果所谓‘最佳模型’会在截止日期前突然崩掉,那这个称号就毫无意义。”与此同时,@weswinder 指出了 Codex 的弱点(6 个赞、5 条回复、329 次浏览)写道:“如果 Codex 能做设计,我真的会拿它做所有事。它非常聪明,但每次看到输出长什么样,我都很失望。”@jskoiz 的回复则精准概括了这种审美:“你是不喜欢那种为了让它‘更突出’而加一圈额外边框、再套在更大圆角矩形里的圆角矩形吗?”
@dani_avila7 重点介绍了 Claude Design(4 个赞、1 个收藏、160 次浏览)发布了“交接到 Claude Code”功能,并支持导出到 Canva——这是一条从设计直达代码的桥梁,而 Codex 目前还没有。

讨论要点: 竞争框架已经从“哪个模型更聪明”转向“哪个工具更可靠、更完整”。Claude Code 的优势在于通过 Claude Design 打通设计到代码链路;Codex 的优势在于智能水平,但设计输出质量是其明确短板。值得注意的是,对 Claude Code“vibe coded”的辩护本身也很说明问题——它把 vibe coding 的质量标准重新定义为:只要迭代够快,就可以接受。
与前一天对比: 昨天讲的是 Codex 借助 111 个插件扩展为通用平台;今天则出现了反向叙事:可靠性顾虑让用户转向 Codex,但设计质量又把他们拉回 Claude 生态。
1.5 Vibe coding 同时赢得尊重与怀疑 🡒
@martin_casado(a16z 普通合伙人)反思了 vibe coding 游戏(46 个赞、10 条回复、2 条引用、1,544 次浏览)写道:“这让我深刻体会到传统游戏背后投入了多少时间和精力。很明显,大部分工作都花在数值微调、玩法、故事写作、关卡编辑、叙事创作等方面——也就是那条漫长的打磨尾巴。”@MatthewSchrager 回复说:“真正意识到第一版和专业作品相比有多糟,感觉非常打击人。”Casado 也表示认同:“我越是做 vibe coding,就越尊重专业游戏开发者。”
当被问到“那边到底发生了什么?”时,@Grady_Booch(UML 联合创始人、IBM Fellow)给出了一个一针见血的判断(18 个赞、4 条回复、510 次浏览)回答:“两个词。Vibe。Coding。”
@SenorScience 提出了反驳(1 个收藏、143 次浏览)写道:“Vibe coding 适合快速上线。但‘它会随着时间变得更好’这一前提,是得有人用真正的工程判断来决定该做什么、以及怎么做。”@SPYDA000 分享了一个现实提醒(4 个赞、58 次浏览)则表示:“我想做的东西确实比预期花的时间长得多……如果你真想交付严肃的东西,就必须慢下来,花时间打磨。”
讨论要点: 关于 vibe coding 的讨论,正在从二元判断(行/不行)走向更细腻的认识。Casado 的观点颇具代表性:vibe coding 已经足够好,好到能让人意识到代码生成从来都不是最难的部分;真正难的是打磨、设计、叙事和玩法平衡。这也把 vibe coding 重新定义为一种暴露“真正重要的工程工作”的工具。
与前一天对比: 昨天的重点是有组织的黑客松和“从零到构建者”的叙事;今天则是 Casado、Booch 等有影响力人物给出更克制的判断,把讨论从“vibe coding 就是未来”推向“vibe coding 让你看见什么才是真正困难的”。
1.6 智能体生成内容流水线开始落地 🡕
@zeke 详细介绍了一整套 deepfake 视频制作流程(13 个赞、10 个收藏、962 次浏览)展示了一条在单次 OpenCode 会话中、借助 Claude Opus 4.6 搭建完成的流水线,总成本 $95:Replicate 上的视频生成约 $53,OpenCode 约 $32,X API 访问约 $12。整条流程包括:抓取博客文章转为 markdown,通过 Chrome DevTools MCP 拉取员工账号,分析互动数据,撰写视频脚本,并行生成图片与语音克隆 TTS,用 ffmpeg 拼接成一段 4 分钟视频,再通过 Typefully API 起草推文串;全部在两小时内完成,并附有公开 GitHub 仓库记录整个过程。
@galileowilson 倡导系统级自动化(30 个赞、8 条回复、165 次浏览)写道:“打开 Claude,把你的整个运营流程带它走一遍。然后用 Claude Code 和智能体把重复任务自动化。花一个周末搭好,工作方式就能提升 10 倍。”
讨论要点: 这条深度伪造流水线的重要性不在于新奇,而在于透明:它给出了精确的成本拆解、模型选择和成本优化建议。用 $95 做出一段包含语音克隆和图像生成的 4 分钟视频,等于为智能体编排的多媒体生产划出了一条成本下限。
与前一天对比: 昨天讲的是 Codex 的非编程用途(报税、管理层简报);今天则把这一能力扩展到多媒体制作,并给出完整成本核算,使“由智能体编排的内容生产”成为一种有文档、可复现的工作流。
1.7 Google Antigravity 教学与免费组合方案 🡒
@JulianGoldieSEO 同时发布了一篇 4 小时(16 个赞、9 个收藏、644 次浏览)和一套 2 小时(13 个赞、8 个收藏、782 次浏览)Google Antigravity 完整课程。两者合计 17 个收藏,说明这个仍属新近的平台已经具备较高的资料参考价值。
@TheCryptoDaddi 介绍了一种零成本叠加模式(12 个赞、5 个收藏、1,853 次浏览)介绍了一套免费组合:免费使用 Google Stitch,再把 Stitch MCP 接入 Google Antigravity,就能零成本做出质量可比 Opus 4.7 的网站。在一篇 另一篇帖子(12 个赞、700 次浏览)中,他甚至认为这套组合会威胁传统建站工具:“大概可以放心做空 $WIX。”
@imnottanmay 批评了 Google 的执行力(2 个赞、1 个收藏、269 次浏览)则表示:“Gemini Pro 3.1 糟透了。Antigravity 没救了。”这与大量教学内容形成反差,说明平台布道者在持续产出课程,而开发者对模型质量的评价却明显分化。
讨论要点: Google Antigravity 处在一个独特位置:免费定价推动采用,但模型质量也招来批评。Stitch + Antigravity 的免费组合,构成了对付费 Claude/Codex 订阅的一种明确成本套利;而 Claude/Codex 平台的速率限制问题,恰恰让这种套利更具现实意义。
与前一天对比: 昨天提到的是第三方工具接入 Antigravity 的认证政策风险;今天焦点转向教学内容(6 小时课程)和免费组合策略,说明即便模型质量受到质疑,这个平台仍在继续获得采用。
1.8 OpenClaw 与 Codex 认证基础设施的摩擦 🡕
@levelsio(Pieter Levels)公开寻求帮助(19 个赞、18 条回复、5,027 次浏览)发帖求助,原因是 openai-codex 在 OpenClaw 中出现 OAuth 令牌刷新失败。该帖共引来 18 条回复,其中 @wayneb 提供了分步修复方案(2 个赞、2 个收藏、294 次浏览)给出的修复步骤是:列出已配置账户、通过浏览器流程重新认证、再重启网关。另一名用户则表示,自己因为需要访问 Raspberry Pi 的 shell,无法远程完成修复。
@buildbasekit 在回复中概括了更广泛的挫败感:“这就是现代开发体验。你调试的不是自己的代码,而是工具之间的认证。通常重新认证能解决,但真正该修的是更好的报错信息。很多时候你甚至不知道到底是哪一层坏了。”
讨论要点: 当一位高知名度构建者发出的求助帖获得 5,027 次浏览,却仍无法自行解决工具认证问题时,说明智能体基础设施已经复杂到足以成为一种独立故障模式。修复需要横跨两个系统执行三条 CLI 命令——这种摩擦程度正在削弱“让智能体自己工作”的承诺。
与前一天对比: 昨天 OAuth/认证基础设施还不是显性痛点;今天,它借由一位高知名度用户的问题浮出水面,暴露出多层认证链(OpenClaw 网关 + OpenAI Codex OAuth + 本地令牌)的脆弱性。
2. 什么让人感到沮丧
速率限制与定价模型崩塌 — 高
The Register 的调查给出了迄今最完整的解释:2026 年 3 月的令牌计数漏洞让新模型看起来比实际便宜。GitHub 修复后,限制值回弹至原先配置,结果就是 181 小时锁定和任务中途强杀智能体。GitHub 还已面向 Pro+ 用户下线 Opus 4.6 Fast,并暂停所有免费试用。@OwenGregorian 分享了全文(1,024 次浏览)。一名被引述的开发者表示,自己改用会自动选择更便宜模型的 Auto 模式后,“我的项目几乎没什么进展,Auto 模式选出来的模型质量很差,还经常不告诉我就抄近路。”这已经不是容量问题,而是定价模型失灵:固定费率订阅无法消化前沿模型的成本。
Opus 4.7 令牌成本膨胀 — 中
@edandersen 量化了影响(195 次浏览):Opus 4.7 的新分词器在相同文本上会产生多 35% 的令牌,在高分辨率图像上则会多出 3 倍令牌,而每令牌 API 成本并未变化。上下文窗口仍是 1M 令牌,但会更快被填满。这对所有 Opus 4.7 用户都构成了一次隐性涨价,也进一步加剧了 Copilot 的速率限制问题。
智能体认证基础设施脆弱性 — 中
@levelsio 无法使用 OpenClaw/Codex(5,027 次浏览)因 OAuth 令牌刷新失败而受阻。修复过程需要在两个系统中执行三条 CLI 命令。另一名用户则因无法 SSH 登录自己的 Raspberry Pi 完成重新认证而被卡住。用户调试的不是自己的代码,而是一层层认证基础设施。
更新做法不透明 — 低
@uncooloj 呼吁提供更新日志(3 个赞、150 次浏览)写道:“我每天都看到更新提示,但完全不知道会发生什么、有什么新东西、又改了什么。”在快速发布却缺少文档的情况下,用户信任会被持续侵蚀。
GitHub 正把用户引向 Copilot — 低
@_avdept 展示了一张截图(3 个赞、67 次浏览)展示了 GitHub 的冲突解决下拉菜单:由于“过于复杂”,“在网页上编辑”被置灰,而“使用 Copilot 修复”成了替代选项。该用户的抱怨是:“从什么时候开始,你们居然限制我在网页编辑器里解决冲突了?”

3. 人们希望出现什么
AI 编程智能体的设计质量
@weswinder 直接点明了这一差距(6 个赞、329 次浏览)写道:“如果 Codex 能做设计,我真的会拿它做所有事。这是最大的问题。”Claude Design 的“交接到 Claude Code”(由 @dani_avila7 展示)是首个试图弥合这一缺口的方案,但前提是留在 Anthropic 生态里。一个任何编程智能体都能调用、与模型无关的设计层,仍然缺位。
更好的智能体故障提示
@buildbasekit 在回复 levelsio 的 OAuth 问题时总结道:“真正该修的是更好的报错信息。很多时候你甚至不知道到底是哪一层坏了。”随着智能体栈不断加深(编排器 + 网关 + OAuth + 模型提供方),错误归因本身也成了一个工程问题。
变更日志与更新透明度
@uncooloj 请求 希望 Claude Code 和 Codex 能提供结构化变更日志。随着两款工具几乎每天都在更新,用户需要按版本划分的发布说明来理解行为变化,尤其是会影响智能体工作流的破坏性改动。
面向智能体的网站就绪标准
@celso 获得了满分 100/100 的 agent-readiness 评分(10 个赞、4 个收藏、505 次浏览)提到 Cloudflare 的“你的网站准备好迎接智能体了吗?”扫描器。它从可发现性(3/3)、内容(1/1)和机器人访问控制(2/2)三个维度为网站评分,并给出 Level 5“智能体原生”评级。这代表着一个正在形成的新标准,但相关采用工具和最佳实践仍然稀缺。

4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot / Copilot CLI | IDE + 终端智能体 | (-) | 对开源维护者/学生免费;Spring Boot workshop 生态;集成冲突解决 | 速率限制危机(181 小时锁定);令牌计数漏洞后遗症;数据训练需手动退出政策 |
| Claude Code | 终端编程智能体 | (+/-) | Opus 4.7 任务范围界定;Claude Design 交接;每日数百万用户 | 新分词器带来 35% 令牌膨胀;“vibe coded”质量争议;身份验证逐步推广 |
| Codex CLI / Desktop | 智能体平台 | (+/-) | 计算机控制;GPT-5.4 表现;高智能水平 | 设计输出质量短板;经 OpenClaw 接入时 OAuth 脆弱;速率限制 |
| Warp | 终端 | (+) | 带实时光标的远程会话共享;支持 LSP 的终端内 PR 式代码评审;多智能体支持 | 新功能尚未经过大规模验证 |
| OpenCode | 开源终端智能体 | (+) | 智能体就绪性测试;深度伪造流水线编排;模型无关 | 相比 Claude Code/Codex 生态较小 |
| ztk | 令牌压缩 CLI | (+) | 令牌削减 90.6%;260KB 二进制文件;56 个过滤器;SIMD 处理 | 新项目;基于 Zig;仅限 shell 层 |
| Headroom | 令牌压缩代理 | (+) | 节省 6.8M 个令牌;93.2% 缓存命中率;适用于任意智能体/提供方 | 会增加延迟(平均 10.56 秒);代理架构 |
| Google Antigravity | IDE | (+/-) | 免费;可通过 Stitch MCP 零成本做网站 | 模型质量受批评;与第三方工具配合时有认证政策风险 |
| OpenFang | 开源智能体框架 | (+) | v0.5.10:AWS Bedrock、Copilot OAuth 重写、armv7、Argon2id 认证、45 项 bug 修复 | 复杂;受众小众 |
| Clairvoyance | 多智能体桌面应用 | (+) | 具名智能体角色;支持手机远程访问;适合游戏开发场景 | 仍处早期;文档有限 |
| Hermes Agent | 本地智能体 | (+) | 高级用户忠诚度高;支持本地模型 | 搭建困难;社区较小 |
最值得注意的变化,是智能体与模型之间开始出现一层令牌压缩层。ztk 和 Headroom 都是在回应同一经济压力:Opus 4.7 的分词器膨胀与 Copilot 速率限制,让上下文效率从“优化项”变成“硬约束”。Warp 在同一天推出两项功能(远程控制 + 代码评审),则把自己定位成包裹所有智能体的终端层,不受底层提供方限制。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ztk | @ItsRoboki | 面向 AI 智能体的 CLI shell 输出压缩器 | 嘈杂命令输出造成的令牌浪费 | Zig、SIMD、Thompson NFA 正则 | v0.2.0,已发布 | 帖子, GitHub |
| Headroom | @pratikbin(贡献者) | 面向任意 LLM 智能体的代理式上下文压缩 | 工具调用、RAG、文件读取中的样板化膨胀 | Python、TypeScript、LiteLLM、Apache 2.0 | 已发布,PyPI + npm | 帖子, GitHub |
| Labrat | @poof_eth | 采用 bandit 式资源分配的并行研究运行器 | 智能体研究在单一路径上爬坡后陷入停滞 | CPU workers、基于评测的 frontier、实验族资源分配 | 已开源 | 帖子 |
| OpenFang v0.5.10 | @openfangg | 支持 15+ 适配器的多提供方智能体框架 | 提供方锁定、部署复杂度高 | Rust、TOML 配置、Docker、armv7 | v0.5.10 | 帖子 |
| Dr JSkill Workshop | @juliendubois | 9 章 Copilot CLI + Spring Boot workshop | Java 开发者需要结构化的智能体驱动学习 | Spring Boot 4、Copilot CLI、Agent Skills | 已发布 | 帖子, GitHub |
| SuperBased | @Santosh74038967 | 带令牌压缩功能的 AI 截图 + 语音听写应用 | 向智能体描述视觉上下文会浪费令牌 | 截图采集、类似 Wispr Flow 的语音、Claude Code/Codex 插件 | 开发中 | 帖子, 网站 |
| Agents Week Deepfake | @zeke | 通过单次智能体会话完成的端到端视频制作流水线 | 手工多媒体制作又慢又贵 | OpenCode、Claude Opus 4.6、Replicate、ffmpeg、X API、Typefully | 已完成(总成本 $95) | 帖子 |
| egaki | @__morse | 使用 Codex 订阅令牌的 CLI 图像生成器 | 在智能体内部生成图像的最低成本方式 | npx、Codex API | 已发布 | 帖子 |
| Vortex Chaser | @WatersChie | 为 VibeJam 2026 制作的龙卷风追逐游戏 | 展示 AI 生成游戏能力的 game jam 作品 | Bolt、Google Antigravity、90%+ AI 生成 | 已提交 | 帖子 |

令牌压缩项目群(ztk、Headroom、SuperBased)代表了当天最显著的构建模式。三个独立项目从不同层面切入同一个问题:shell 输出(ztk)、API 代理(Headroom)和视觉采集(SuperBased)。Labrat 对智能体研究的处理方式——并行运行多组实验家族,并依据评测结果分配资源——在架构上颇为新颖:它把研究本身视为资源调度问题,而不是顺序搜索问题。
6. 新动态与值得关注的内容
从 npm 包中绘制 Claude Code 内部结构图
@_vmlops 报道了(1 个赞、3 个收藏、90 次浏览)称,一名法国开发者从 Claude Code 的 npm 包中逆向还原出其完整源码:1,900 个文件、512,000 行 TypeScript。由此生成的微型网站梳理了智能体循环、50+ 个工具、多智能体编排,以及尚未发布的功能。这种级别的透明度——无论是否出于本意——都为开源社区提供了一份商业智能体架构的详细蓝图。
Claude 身份验证推广
@nicklaunches 报道了(7 个赞、71 次浏览)称,Anthropic 正在为 Claude 推出身份验证,要求提供有效证件(护照、驾照)并进行人脸识别扫描。r/LocalLLaMA 上题为“转向本地模型的更多理由”的帖子一夜之间获得 540 个赞。这很可能会加速注重隐私的开发者转向本地模型。
Copilot 交互数据训练政策
GitHub 宣布了 宣布,自 4 月 24 日起,Copilot Free、Pro 和 Pro+ 用户的交互数据将用于模型训练,除非用户主动退出。数据包括已接受输出、代码上下文、光标位置、导航模式和功能交互反馈。Microsoft 员工数据已经在使用中。Business 和 Enterprise 用户不在此列。(帖子)
Cloudflare 智能体就绪扫描器
@celso 获得了满分的 agent-readiness 评分(10 个赞、505 次浏览)使用了 Cloudflare 的“你的网站准备好迎接智能体了吗?”工具。该工具从可发现性、内容和机器人访问控制三个维度为网站打分,并采用 5 级评级体系。再结合 OpenCode 在 2 分钟内拿到该评分这一点,可以看出,面向 AI 智能体可访问性的 Web 标准正在形成。
GitHub 将冲突解决引向 Copilot
@_avdept 记录了(67 次浏览)称,GitHub 网页编辑器现在会把某些合并冲突标为“过于复杂,无法解决”,同时提供“使用 Copilot 修复”作为替代路径。这意味着 Copilot 正从可选助手,转向某些操作中的默认解决方案。
7. 机会在哪里
[+++] 令牌压缩与上下文优化 —— 同一天发布了两个独立工具(ztk:shell 层削减 90.6%;Headroom:代理层节省 6.8M 个令牌),再加上 SuperBased(截图到令牌转换)。需求驱动是结构性的:Opus 4.7 分词器带来 35% 的令牌膨胀,再叠加 Copilot 对速率限制的严格执行,形成了硬性的经济约束。任何能降低每次智能体会话令牌消耗的工具,都能直接延长可用时长。市场正按层分化(shell、代理、采集);若有一体化方案能同时覆盖三层,就有机会拿下整条技术栈。
[+++] 智能体会话评审与协作基础设施 —— Warp 在同一天发布了远程会话共享和终端内代码评审。Clairvoyance 则展示了具名角色的多智能体团队管理。背后的模式是:随着智能体运行时间变长、产出代码增多,人工评审会成为瓶颈。能够提供 PR 式评审工作流、协作光标和基于角色的智能体管理的工具,正在填补一个会随每次 Opus 4.7 长时会话而持续扩大的空白。
[++] 面向 AI 智能体的设计到代码流水线 —— Codex 的设计质量被点名为阻碍全面采用的“最大问题”。Claude Design 的“交接到 Claude Code”是首个集成方案,但会把用户锁定在单一生态。一个与模型无关的设计层——能根据智能体提示生成可用于生产的 UI/UX,并可供任意编程智能体调用——正好填补了今天数据里最常被提及的能力缺口。
[++] 智能体认证与基础设施调试 —— levelsio 的 OAuth 故障获得了 5,027 次浏览和 18 条回复。修复需要跨两个系统执行三条 CLI 命令。随着智能体栈加深(编排器 + 网关 + OAuth + 提供方),调试焦点正从“我的代码哪里错了”转向“哪一层认证坏了”。能够跨智能体基础设施层追踪故障、并提供清晰可归因错误信息的诊断工具,将解决一个会随每次新增集成而持续放大的痛点。
[+] 面向网站资产的智能体就绪优化 —— Cloudflare 的智能体就绪扫描器已经建立起一套评分框架(可发现性、内容、机器人访问控制)。随着 AI 智能体成为重要流量来源,网站也需要像过去为搜索引擎优化那样,为智能体可访问性做优化。能够审计并提升智能体就绪评分的工具——类似 SEO 工具——将在“你的网站准备好迎接智能体了吗?”这一标准逐步普及的过程中填补一个新兴细分市场。
8. 要点
-
Copilot 速率限制危机有其结构性解释。 The Register 的调查显示,2026 年 3 月的令牌计数漏洞让新模型看起来比实际便宜。漏洞修复后,限制值回弹,导致 181 小时锁定。这不是容量问题,而是定价模型失灵——固定费率订阅无法消化前沿模型成本。(帖子)
-
令牌压缩在一天之内成为一个新品类。 两个独立工具——ztk(shell 层削减 90.6%,260KB Zig 二进制文件)和 Headroom(API 代理层节省 6.8M 个令牌)——带着可量化结果发布。它们都是对 Opus 4.7 35% 分词器膨胀和速率限制收紧的直接回应。(帖子, 帖子)
-
Warp 正在构建多智能体终端层。 同一天推出的两项功能——带实时光标的远程会话共享,以及支持 LSP 的终端内 PR 式代码评审——让 Warp 成为不受提供方限制的编程智能体评审与协作界面。(帖子, 帖子)
-
设计质量是 AI 编程智能体最常被提及的缺口。 用户想要 Codex 的智能,却无法接受它的视觉输出。Claude Design 的“交接到 Claude Code”是首个集成式设计到代码桥梁,但会把用户锁定在单一生态。(帖子, 帖子)
-
GitHub 正从多个方面收紧 Copilot 生态。 速率限制、Opus 4.6 Fast 下线、免费试用暂停、交互数据训练退出机制(4 月 24 日生效),以及把冲突解决引向 Copilot,都表明该平台正在对开发者体验施加更多控制。(帖子, 帖子)