Twitter AI 编程 - 2026-04-18
1. 人们在讨论什么
1.1 Token 优化成为当天最核心的关注点 🡕
当天互动量最高的帖子来自 @DeRonin_,整理了 10 个 GitHub 仓库,用于在 Claude Code 中少花 60–90% 的 tokens(559 个赞、1,177 次收藏、60,532 次浏览)。这份清单覆盖了 Token 缩减链路的多个层面:RTK(Rust Token Killer)是一个 CLI 代理,会在终端输出进入上下文窗口前先行过滤,声称可将常见开发命令的输出减少 60%–90%。Context Mode 会把原始工具输出隔离到 SQLite 中,在 Playwright、GitHub 和日志数据上可实现 98% 的缩减。code-review-graph 使用 Tree-sitter 将代码库映射为本地知识图谱,在大型 monorepo 上可实现 49 倍的 Token 压缩。Token Savior 通过基于符号的导航、69 个工具以及零外部依赖,在代码导航场景中实现 97% 的缩减。帖子还列出了更轻量的方案:Caveman Claude 通过限制输出详略程度,将输出 Token 减少 65%–75%;claude-token-efficient 只需加入一个 CLAUDE.md 文件即可使用;Zilliz 的 claude-context 则采用混合 BM25 + 稠密向量搜索,实现约 40% 的缩减。

随附的基准测试表量化了 30 分钟 Claude Code 会话中的节省效果:cat/read 从 40,000 降至 12,000 个 Token(节省 70%),cargo test / npm test 从 25,000 降至 2,500(90%),git add/commit/push 从 1,600 降至 120(92%);总计从约 118,000 个 Token 降至约 23,900 个,整体减少 80%。@Hamid98927142 回复称:“在 opus 4.7 上,5 次 prompt 就把 token 用光了。”对此,DeRonin_ 建议把 Opus 4.7 留给“通用测试、通用路线图合规性、架构搭建”,日常任务则使用 Opus 4.6。
讨论洞察: 1,177 次收藏——远高于今天数据集中其他任何帖子——表明 Token 优化已经从小众议题变成了生存技能。DeRonin_ 的表述“多数人都在烧 token,却并不自知”,把上下文浪费定义为一种盲区,而不是主动选择。根据工作流类型(终端输出很重、代码库很大、MCP 服务器很多)叠加 2–3 个工具的建议,也说明优化面足够广,单一工具无法覆盖全部需求。
与前一天对比: 昨天,Token 压缩刚作为一个类别浮现,已有两个已发布工具(ztk 和 Headroom)。今天,这一话题迅速扩展为包含 10 个仓库、基准测试表和 6 万次浏览的完整工具版图,印证了昨天的信号只是更大浪潮的前沿。
1.2 Anthropic 订阅规则不透明,引发开发者反弹 🡕
@theo(T3 Stack 创作者)发布了一份详细的投诉(38 个赞、2,131 次浏览)发帖质疑 Claude Code 订阅条款缺乏明确说明:“几个月来我们一直在请求明确答复。结果得到的只是一次又一次‘我们正在处理’。”这条帖子源于有关 Anthropic 在未提前警告的情况下封禁 T3 Code 用户的报告。Theo 描述了影响:“有几十位非常出色的构建者想做出很棒的东西,但他们甚至不知道自己是否被允许这么做。”@mjtechguy 的回复则补充:“我个人都愿意每月给他们花几千美元,我只是想知道我到底被允许做什么。”
@GergelyOrosz(The Pragmatic Engineer)在两条帖子中把这一问题与其他供应商联系起来。在 一篇(99 个赞、9,852 次浏览)中,他称“在不给理由、也不给申诉渠道的情况下,封禁付费客户使用 AI 工具,是不可接受的”,并指出自己“Google 对 Antigravity 用户做同样的事时,我也公开批评过”。在 配套帖子(94 个赞、8,877 次浏览)中,他回忆 Google 曾封禁“给他们造成过高负载的 Antigravity 用户:没有沟通,也无法申诉”。他在自回复中披露:“我与 Anthropic 和 OpenAI 都没有任何关联。我两家都付费。”
@milan_milanovic 列出了连锁故障(2 个赞、61 次浏览):“Claude Code 基本每两次尝试就会失败一次。你在 Substack 里输入内容时,页面会刷新。ChatGPT 加载后 4–5 秒就会把你写的内容清空。”
讨论洞察: 这场反弹的核心并不是价格,而是互动规则。Theo 明确表示,只要有官方指引,他愿意遵守,甚至如果被要求,也愿意停止支持。真正的问题在于 Anthropic 没有发布针对第三方集成的明确使用政策,导致构建者无法放心投入。Gergely 把 Anthropic、Google 以及更早的 GitHub Copilot 限流问题放在一起讨论,说明这更像是行业性模式,而非单一厂商的问题。
与前一天对比: 昨天记录的是 The Register 对 Copilot 限流危机的调查,以及 Opus 4.7 的 Token 膨胀。今天,信任侵蚀直接延伸到了 Anthropic 本身,高知名度构建者(theo、Gergely)公开质疑其订阅规则不透明。供应商信任问题如今已覆盖三大主要提供方。
1.3 多工具工作流取代对单一智能体的忠诚 🡕
“一个工具统治一切”的叙事继续瓦解。@smartnakamoura 记录下了这种模式(3 个赞、2 次收藏、65 次浏览)写道:“Cursor、Claude Code 和 OpenAI Codex 已经不再彼此竞争。开发者现在会在同一个工作流中把三者一起跑。Cursor 负责界面,Claude Code 负责推理,Codex 负责代码生成。‘一个 AI 工具赢者通吃’的说法是错的。”
@jtlin 提出了一个具体的技术栈(1 个赞、1 次收藏、61 次浏览)写道:“Claude Opus 4.7 负责策略,OpenAI Codex + GPT 5.4 负责编码,本地 Qwen 3.6 35B A3B 负责其余一切。”@cblatts 更进一步(2 个赞、4 次收藏、475 次浏览)则把 Codex 集成进 Claude Code,“这样我就能拿到两份互相较劲的深度研究报告,或者让 Codex 作为外部批评者来审视 Claude 的计划、技能和代码。”
@BillydaAnalyst 介绍了一套双工具配置(1 次收藏、38 次浏览):“我在 2026 年的 AI 编程栈不是单一工具,而是 Google Antigravity + 在终端里同时运行的 Claude Code。这个组合替代了我整个工作流。”

@maskaravivek 分享了一个三步原型设计工作流(1 个赞、32 次浏览):先用 ChatGPT 头脑风暴,拿到详细 prompt,再用 GitHub Copilot 把它实现出来。他还称赞 Copilot 的定价模式:“按 PR 收费,不是固定月费。”
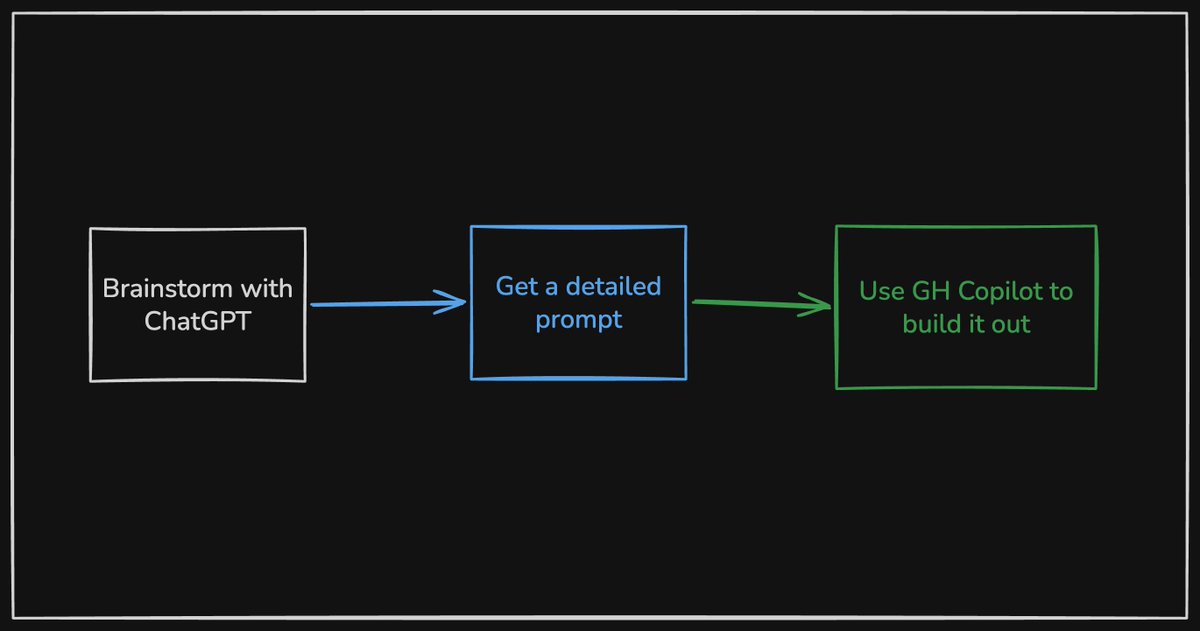
讨论洞察: 多工具模式已经不再是设想,而是现实操作方式。用户正在给不同工具分配明确角色(Cursor 做 UI,Claude 做推理,Codex 做生成,Qwen 处理本地任务)。这会让市场按能力维度而不是按品牌忠诚度发生分化。如今这种叠加仍需要手动编排,因此也催生了对自动在工具间路由的集成层的需求。
与前一天对比: 昨天的重点还是 Claude Code 与 Codex 之间的二选一争论。今天,这种二元框架已经瓦解,问题不再是“选哪一个”,而是“怎么组合、各自扮演什么角色”。
1.4 Google Antigravity 教学内容刷屏信息流 🡒
@JulianGoldieSEO 发布了多门 Antigravity 课程:一门 4 小时版本(17 个赞、10 次收藏、731 次浏览)、一门 2 小时版本(15 个赞、10 次收藏、828 次浏览)、另一篇 4 小时帖子(14 个赞、10 次收藏、535 次浏览)、一门 第二篇 2 小时帖子(7 个赞、7 次收藏、943 次浏览),以及题为“OpenAI Codex AI:全新的万用超级应用”的 Codex 视频(7 个赞、2 次收藏、324 次浏览)。Antigravity 相关帖子的总收藏数达到 37,说明用户对参考资料的需求很强。
与此同时,@xdadevelopers 发布了一份为期一个月的对比(10 个赞、5 次收藏、2,141 次浏览)对 Cursor、Google Antigravity 和 Windsurf 做了对比评测,并宣称“胜者已经很明显”。

@FyzureX 走了相反的方向(1 个赞、1 次收藏、213 次浏览):“正式放弃 Google Antigravity,转投 Windsurf!受够了 429 错误和 Gemini 锁定。Windsurf 带来了真正的稳定性和模型自由:可以用 Opus 4.7、GLM 5.1,或者免费的 Kimi 2.5。”
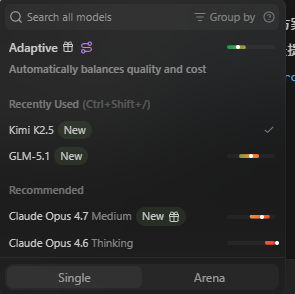
讨论洞察: Google Antigravity 处在一个矛盾位置:它产出了最多的教学内容(6+ 小时课程),却也因 429 错误和模型锁定把用户推向其他平台。XDA 的对比评测获得 2,141 次浏览,表明主流用户正在积极评估 IDE 格局。Windsurf 正成为 Antigravity 挫败感的受益者,尤其因为它提供了模型自由。
与前一天对比: 昨天对 Antigravity 的报道重点是免费叠加策略(用 Stitch MCP 做 $0 网站)和身份验证政策风险。今天,教学内容数量上升,同时出现了转投 Windsurf 的并行趋势,说明该平台一边吸引普通用户,一边流失重度用户。
1.5 Copilot 限流继续消磨付费用户体验 🡒
@mkurman88 报告了(15 个赞、1,393 次浏览):“几天前 GitHub Copilot 还是最好的选择,但他们做出了我见过最蠢的举动。我是按请求付费的,也就是额外 credits 我都还没买/没付,却还是被限流了 32 小时。”
@MelansonIndus 附带截图证据进行了抱怨(1 个赞、68 次浏览):“我们付 4 周的钱,却每周都被 GitHub Copilot 限流,为什么还一直往里加功能?太离谱了。我工作 2 小时就撞到限流。以前只是某个模型被限,现在是所有模型一起全局限流。”
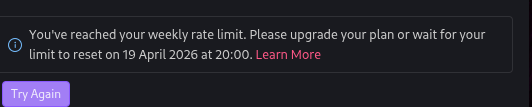
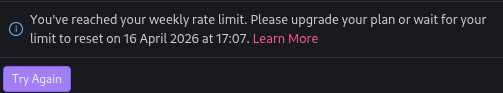
@chrisklumph 指出(1 个赞、34 次浏览):“即使 GitHub Copilot 里 4.7 的价格比 Opus 4.6 高出两倍多,我还是看不出它到底比 Opus 4.6 强在哪。”@789HZ 公开发声呼吁(2 个赞、23 次浏览)则表示,自己的订阅因共享支付方式而被暂停。
相比之下,@martinwoodward(GitHub)提供了内部视角(4 个赞、1 次收藏、123 次浏览)表示:“我们看到,高绩效团队会投入一些定制指令 / skills,好把效果调准,并在团队内部获得可复现的体验。也许人们从 greenfield 项目转向现有代码库时,缺的正是这一块?”
讨论洞察: 用户对限流的不满,已经从昨天的结构性解释,转变为今天的大量亲历报告。从按模型限流升级为全局限流(MelansonIndus),代表明显收紧。MartinWoodward 的回复表明,GitHub 认为解决方案是更好的上下文工程(定制指令/skills),而不是更高的限额;但这种框架并没有回应用户所描述的“工作 2 小时就被锁死”的体验。
与前一天对比: 昨天 The Register 给出了结构性分析(Token 计数 bug、定价模型崩塌)。今天,用户层面的证据持续累积:明明为 credits 付费却仍被锁 32 小时,全局限流取代按模型限流,以及因共享支付方式而被暂停订阅。
1.6 OpenCode 转向 Electron,Tauri 失宠 🡕
@TechieUltimatum 记录了 OpenCode 的切换(6 个赞、3 次收藏、21 次浏览)解释了从 Tauri 转向 Electron 的原因:“修复性能问题。跨平台体验更一致。崩溃更少(Windows + Linux)。用 Chromium 实现统一渲染。”帖子指出,OpenCode 拥有 140K stars 和 6.5M 用户。
@ibuildthecloud 也跟着这么做了(1 个赞、276 次浏览):“看来我要把 discobot 移植到 electron 了。我一直不太满意 tauri,不过老实说我就是照着 @opencode 做。他们用 tauri,我就也用了。我之前有两个项目试过 tauri,都不行。”
@LukeParkerDev 报告了持续存在的 Tauri 痛点(6 个赞、259 次浏览):“我的 opencode desktop WSL 分支已经变得特别大了,哈哈,没做到顺滑、真正好用之前我不会合并。还有很多很多小修复。WSL/windows 里坑太多了。”
讨论洞察: OpenCode 从 Tauri 迁移到 Electron 是一个重要信号:一个拥有 140K stars 的项目,选择了稳定性和跨平台一致性,而不是 Tauri 更轻的体量。连锁效应已经出现(ibuildthecloud 也因为“我就是照着 @opencode 做”而切换),这可能会让智能体桌面应用的默认选择从 Tauri 回摆到 Electron。
与前一天对比: 昨天 Tauri 和 Electron 还不是话题。今天,随着一个大型项目完成迁移,这一议题浮出水面,并把 Electron 确立为生产级智能体桌面应用的务实选择。
1.7 OpenAI Codex 黑客松与生态势头 🡒
@gabrielchua(OpenAI)宣布了(12 个赞、1,177 次浏览)表示,OpenAI Codex Hackathon Bengaluru 的申请者已收到 API credits:“可以搭配 Codex 一起用,Codex 在 ChatGPT Free 和 Go 中都可用。”@vipulgupta2048 称赞了组织团队(13 个赞、1,130 次浏览)。@Dev_Maqbool 分享了一张截图(2 个赞、12 次浏览)分享了 API credits 邮件截图,并表示虽然自己没被选中,仍然很感谢。
@freeCodeCamp 发布了一套完整课程(84 个赞、66 次收藏、3,484 次浏览)介绍了一门关于 OpenAI Codex 用于智能体式开发的课程,由 @andrewbrown 授课:“AI 编程工具正在从助手演化为能替你完成任务的完整智能体。”
@bradwmorris 对 Codex 的计算机使用功能作出反应(1 个赞、1,130 次浏览):“holy sh*t——他说得对。快去试试新的 codex computer use 功能。比 cowork + playwright 强太多了,而且看起来 token 效率很高。”
讨论洞察: OpenAI 正在投入社区建设(通过带 API credits 的黑客松),而 freeCodeCamp 的课程则表明其正在进入主流教育采用。bradwmorris 对 computer use 功能的认可,也说明 Codex 在智能体与计算机交互方面正在推进,而这是一个 token 效率格外重要的方向。
与前一天对比: 昨天报道的是 Codex 向通用平台扩展。今天,生态支持基础设施(黑客松、课程、社区 credits)以及对具体功能(computer use)的热情,进一步强化了这一势头。
2. 什么让人沮丧
Copilot 限流打到付费用户头上 — 高
@mkurman88 报告了 32 小时限流(1,393 次浏览)显示,用户即使支付了额外 credits,仍遭遇限流。@MelansonIndus 记录了 表示工作 2 小时后就撞上限流,截图还显示限制已从按模型升级为全局限流。@chrisklumph 指出 则认为 Opus 4.7“价格高出两倍多”,却看不到明显质量提升。如今让人不满的,已经不只是有限额,而是限额与付费模式本身相互矛盾。
Anthropic 订阅条款仍然不透明 — 高
@theo 详细说明了数月来无人回应的请求(2,131 次浏览)要求明确 Claude Code 订阅条款对第三方集成到底允许什么。还有报告称 T3 Code 用户在未收到警告的情况下被封禁。@GergelyOrosz 类比了不同提供商之间的相似之处(9,852 次浏览)则把这一情况与 Google 封禁 Antigravity 用户相提并论。规则不公开,构建者就无法放心投入。
Google Antigravity 稳定性问题 — 中
@FyzureX 切换到了 Windsurf 提到“429 错误和 Gemini 锁定”。@DynastyWillz 描述了(6 个赞、82 次浏览)描述了反复失败:“提示了那么多次,agent 还是会把设计搞乱,始终做不对。”@imnottanmay 称之为(2 个赞、280 次浏览)则称 Antigravity“已经没救了”。
AI 生成代码质量(“Slop”)— 中
@d4m1n 记录了(72 次浏览)使用 Claude Code 配合 claude -p,在 4 小时内对 68 个 spec 文件跑了 100 次迭代。结果生成了 65,000 行代码,却只是一个空应用,部署时因 Vercel 的“client-side exception”报错而崩溃。Git 提交历史显示,在 5–6 小时里,“danmindru and claude”做了约 15 次以“feat:”开头的提交,但最终产出的应用仍无法运行。

OpenCode 会话持久化 Bug — 低
@eren7262 报告了(55 次浏览)表示,关闭并重新打开终端后,本地目录会话会被清空,而全局会话仍然保留:“整个会话按本地目录维度被清掉了。”
3. 人们希望出现什么
AI 厂商给出明确的订阅与使用政策
@theo 明确表示:“给我们任何形式的明确说明……我们愿意遵守收到的任何官方指引。”构建者需要 Claude Code、Codex 和 Copilot 针对第三方集成发布公开且可执行的条款。当前这种规则不透明、执行又不可预测的状态,阻碍了生态投资。
自动化的多工具路由
多位用户提到,他们在手动分配工具角色:Cursor 负责 UI,Claude 负责推理,Codex 负责生成(smartnakamoura);或者 Opus 负责策略,GPT 5.4 负责编码,本地 Qwen 负责其他一切(jtlin)。如果有一个编排层,能根据任务类型、成本和可用性自动把任务路由到最合适的工具/模型,就能替代当前这种手动叠加。
在智能体会话中可见 Token 预算
@DeRonin_ 建议“在一个新会话里运行 /context,看看你一个字都还没打就已经没了多少”,这说明大多数用户其实看不到 Token 消耗情况。若在智能体会话中集成实时 Token 预算面板,用户就能据此做出更理性的优化决策。
面向非简单项目的可靠 AI 智能体输出
@d4m1n 在 4 小时 Claude Code 会话中生成了 65,000 行无法运行的代码,@DynastyWillz 则在 Antigravity 中反复出现设计失败。这些案例凸显了演示级输出与生产级输出之间的差距。长时间智能体运行中的质量闸门、增量验证以及人类介入检查点,仍是未解问题。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 终端编程智能体 | (+/-) | 深度推理;Token 优化生态(10+ 个工具);MCP 工具结果提升至 500K Token | 订阅规则不透明;无预警封禁用户;长时间运行会产出 65K 行 slop |
| GitHub Copilot / Copilot CLI | IDE + 终端智能体 | (+/-) | 自动模型选择正式 GA,且有 10% 折扣;按 PR 定价;CLI 可扩展 | 工作 2 小时后出现全局限流;付费用户被锁 32 小时;Opus 4.7 成本翻倍但收益不明 |
| OpenAI Codex | 智能体平台 | (+) | computer use 功能被称为“token 效率极高”;freeCodeCamp 课程;黑客松社区 | 拒绝 Playwright-stealth(dallas_on_ai);生态仍在成熟中 |
| Google Antigravity | IDE | (+/-) | 教学内容产量高(6+ 小时课程);免费层;XDA 对比评测 | 429 错误;Gemini 锁定;多次提示后仍会把设计搞乱 |
| Windsurf | IDE | (+) | 模型自由(Opus 4.7、GLM 5.1、Kimi 2.5);比 Antigravity 更稳定 | 社区较小;教学内容较少 |
| OpenCode | 开源终端智能体 | (+) | 140K stars、6.5M 用户;转向 Electron 提升稳定性 | WSL/Windows 容易踩坑;会话持久化 bug |
| CodexBar | 智能体仪表板 | (+) | v0.21:Abacus AI、Codex Pro $100、多提供方修复 | CPU 占用问题(现已缓解);需要做配置审计 |
| OpenFang | 智能体框架 | (+) | v0.5.10:AWS Bedrock、Copilot OAuth 重写、armv7、修复 45 个 bug | 配置复杂;受众偏小众 |
| Cursor | IDE | (+) | 在多工具栈中因界面质量受到好评 | 被定位为“UI 层”而不是完整方案 |
| Qwen 3.6 35B A3B | 本地模型 | (+) | ts-bench 成功率 100%;速度匹配 Sonnet 4.6 / Opus 4.6;可运行于消费级硬件 | 需要 32GB+ RAM 或 RTX 3090+ |
最显著的变化,是多工具工作流正在收敛成主流。用户不再争论“该用哪个工具”,而是在组装按角色分工的技术栈。Copilot CLI 的自动模型选择(附带 10% 折扣)与 Windsurf 的模型自由,回应的是同一个需求:用户想同时使用多个模型,但不想手动管理。围绕 Claude Code 形成的 Token 优化生态(10 个仓库、6 万次浏览),现在已经是数据中最大的单一主题集群。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| CodexBar v0.21 | @steipete,由 @RatulSarna 维护 | 面向编程智能体的多提供方成本仪表板和网关 | 跟踪 Claude、Codex、Antigravity、Ollama 的成本并管理提供方 | macOS、多提供方 API | 已发布 | 帖子 |
| OpenCode Obsidian Plugin | @tom_doerr(分享) | 将 OpenCode AI 助手直接嵌入 Obsidian | 用 AI 做笔记需要切换不同工具 | Obsidian 插件、OpenCode web view、Bun、Node.js | Beta(通过 BRAT) | 帖子、GitHub |
| wterm + agent-browser | @ctatedev | 用 HTML 渲染终端,并结合 a11y tree 自动化做智能体 e2e 测试 | 终端自动化与跨智能体编排 | HTML、a11y tree、浏览器自动化 | Demo | 帖子 |
| OpenFang v0.5.10 | @openfangg | 拥有 15+ 适配器的多提供方智能体框架 | 提供方锁定与部署复杂度 | Rust、TOML 配置、Docker、armv7 | v0.5.10,已发布 | 帖子 |
| Kodelyth ECC | @sifxprime | 面向开发者的 53 个 AI 智能体、185 个 skills 和 79 条命令 | 跨平台复用的智能体工具包 | MIT 许可证、多平台 | v1.1.0,已发布 | 帖子、GitHub |
| Agent-controlled video editor | @om_patel5(分享) | 由 Claude Code 和 Codex 控制的视频编辑器 | 手工视频剪辑过于繁琐 | macOS 桌面、本地处理、可导出至 DaVinci Resolve/Premiere Pro | Demo | 帖子 |
| peon-ping | @chenzeling4(分享) | 游戏主题语音通知,用于提醒 AI 智能体发出注意力请求 | 不必一直盯着终端等智能体完成/报错 | Warcraft/StarCraft/Portal/Zelda 语音包、跨平台 | v2.21.0,已发布 | 帖子、GitHub |
| OpenClaude | @chenzeling4(分享) | 支持 200+ 模型的开源编程智能体 CLI | 终端编程智能体的提供方锁定 | 终端优先、MCP、斜杠命令、提供方配置 | v0.4.0,已发布 | 帖子 |
| Emoji List Generator | @cassidoo | 将项目符号转换为带 Emoji 标注列表的 CLI 工具 | 手动挑选 Emoji 太慢 | @opentui/core、@github/copilot-sdk、clipboardy | 已发布 | 帖子、博客 |
| Claude x TradingView MCP | @AleiahLock(分享) | 把 Claude Code 连接到 TradingView,用于自动化交易分析 | TradingView 没有公开 API;手工分析太慢 | Claude Code、MCP、Node.js 18+、TradingView Desktop | 指南已发布 | 帖子 |
| Cloudflare Agent-Ready Skill | @fctelles | 将 Cloudflare API 集成到编程智能体中的 MCP skill | 手动操作 Cloudflare API | npx,兼容 GitHub Copilot/Claude/Kiro | 已发布 | 帖子 |

最值得注意的构建模式,是智能体生态基础设施正在成形:CodexBar 管理多提供方成本,OpenFang 提供多适配器框架,Kodelyth 打包了 53 个可复用智能体,而 peon-ping 解决的是一个琐碎但真实的问题——如何知道你的智能体何时需要你注意。由 Claude Code 和 Codex 控制的视频编辑器,则把 AI 编程智能体从代码扩展到了创意工作流。OpenClaude 在约 2 周内迅速涨到 20K+ stars,也说明市场对开源、提供方无关的终端智能体需求强烈。
6. 新动态与值得关注的事项
Copilot CLI 自动模型选择正式 GA
GitHub 推出了自动模型选择,面向所有套餐推出 Copilot CLI 自动模型选择。它会根据套餐和策略自动路由到 GPT-5.4、GPT-5.3-Codex、Sonnet 4.6 和 Haiku 4.5。使用自动模式时,用户可获得 10% 的高级请求折扣。该功能是动态的,可通过选择最高效的模型来缓解限流问题。(@GHchangelog、帖子,26 个赞、1,863 次浏览)
Qwen 3.6 35B A3B 在消费级硬件上匹敌云端模型
@TeksEdge 分享了基准测试结果(6 个赞、4 次收藏、308 次浏览)分享的结果显示,Qwen3.6-35B-A3B 在所有测试的智能体(opencode、vibe-local、GitHub Copilot、qwencode、Claude Code)上都取得了 100% 的 ts-bench 成功率;任务速度匹配 Claude Sonnet 4.6 和 Opus 4.6,推理速度则比 Qwen3.5-27B 快 3 倍。它可运行在配备 32GB+ RAM 的 Mac,或 RTX 3090/4090/5090 上。

Android CLI 发布,推进 AI 辅助移动开发
@geekyouup 分享了第一印象(1 个赞、2 次收藏、149 次浏览)提到新 Android CLI 于 4 月 17 日发布,并与 Google Antigravity 搭配使用。这将 AI 编程智能体扩展到了移动开发场景,并提供了专用命令行工具。
OpenClaw 衰退加速
@Param_eth 预测了 OpenClaw 的 demise(10 个赞、675 次浏览):“如果 OpenClaw 几个月后彻底死掉,也别惊讶。OpenAI 把 Peter Steinberger 拉进来推动 Codex。然后 OpenAI 让 OpenClaw 变得无关紧要。”帖子还引用了一条 Polymarket 帖子,显示 Google 上“OpenClaw”的搜索量已跌到接近基线。
GPT-Rosalind 与 Codex Life Sciences Plugin
@MSaintjour 报告了(3 个赞、209 次浏览)称,OpenAI 推出了 GPT-Rosalind——一款面向生命科学的前沿 AI 模型——同时还推出了 Codex Life Sciences Plugin,把 50+ 个科研数据库整合进统一的自然语言界面。这让 Codex 的适用范围从软件开发扩展到了科研。
Claude Code 更新:500K Token MCP 结果与原生可执行文件
@T_ok_AI 总结了(1 个赞)提到 Claude Code 的最新更新:MCP 工具结果上限提升至 500K Token;插件命令现在可以是原生可执行文件;CLI 中还可访问内置教程。
7. 机会在哪里
[+++] Token 优化工具与集成 — 当天最热的帖子(6,675 分、1,177 次收藏)汇总了 10 个独立的 Token 缩减工具。用户正根据工作流类型手动叠加 2–3 个工具。若有一种集成式方案,把 shell 层过滤(RTK)、API 层压缩和上下文感知代码导航统一进单一配置,就能覆盖完整的优化空间。需求驱动是结构性的,而且还在增强:限流收紧加上 Opus 4.7 的 Token 膨胀,使上下文效率成为每次会话都必须面对的硬性经济约束。
[+++] 多工具编排层 — 用户正在手动指定 Cursor 做 UI、Claude 做推理、Codex 做生成、本地模型负责成本优化。当前没有工具能自动把任务路由给最合适的模型/智能体。一个轻量编排层——识别任务类型(设计、推理、生成、本地可安全处理)并结合成本意识路由到最适配的工具——将能替代如今每个多工具用户都在独立进行的手动叠加。
[++] 提供方中立的订阅管理 — Anthropic 会无预警封禁,Google 会因负载过高而封禁,Copilot 会对已付费 credits 限流。构建者需要一款工具,能跨提供方监控订阅健康状态、在接近限额时告警、追踪执行动作,并自动故障切换到替代提供方。三大主要提供方的信任同时下滑,使这成为一项横跨全局的需求。
[++] Agent Run Quality Gates — @d4m1n 在一次 4 小时自主运行中产出了 65,000 行无法运行的代码,这说明长时间智能体会话中迫切需要增量验证。一种能够在执行过程中定期编译、测试和验证智能体输出,并在生成不可用代码时终止或改道运行的工具,可以避免“规模化 slop”这种失败模式。
[+] 面向编程智能体的本地模型部署 — Qwen 3.6 35B A3B 在消费级硬件上达到云端模型级表现(所有智能体上 ts-bench 均为 100%),使本地部署对许多任务都变得可行。若有工具能简化编程智能体的本地模型配置,并在本地资源不足时自动回退到云端,就能帮助用户降低云成本,并在日常任务中规避限流。
8. 要点总结
-
Token 优化如今是 AI 编程领域互动最高的话题。 一份整理 10 个 Token 缩减仓库的清单获得了 60,532 次浏览和 1,177 次收藏,收藏量超过第二名 10 倍以上。基准数据表明,在 30 分钟 Claude Code 会话中,整体可节省 80%。这是社区当前最优先关注的问题。(帖子)
-
供应商信任侵蚀如今已覆盖三大主要提供方。 Anthropic 在未警告的情况下封禁 T3 Code 用户,并拒绝公布订阅条款(@theo、帖子)。Google 因负载过高封禁 Antigravity 用户(@GergelyOrosz、帖子)。GitHub Copilot 则在 2 小时后就对已购买 credits 的用户实施限流(@mkurman88、帖子)。目前没有哪家主要 AI 编程提供方能给出可预测、透明的规则。
-
多工具叠加已取代对单一工具的忠诚。 开发者正在给不同工具分配明确角色——Cursor 负责界面,Claude 负责推理,Codex 负责生成,本地 Qwen 负责控制成本——并让它们同时运行。竞争问题已经从“谁会赢”转变为“怎么组合、如何编排”。(帖子、帖子)
-
本地模型如今已能在消费级硬件上匹敌云端编程性能。 Qwen 3.6 35B A3B 在所有测试的编程智能体上都实现了 100% 的 ts-bench 成功率,任务速度匹配 Claude Sonnet 4.6 和 Opus 4.6,同时可运行在 32GB+ 内存的 Mac 或 RTX 3090+ 上。这使本地优先开发对越来越多的任务变得可行。(帖子)
-
Copilot CLI 自动模型选择预示了具备成本意识的智能体路由未来。 GitHub 正式推出自动模型选择,可将请求路由到最高效的模型,并提供 10% 的高级请求折扣。这是厂商层面对用户手动构建的路由模式的首次实现,也验证了多模型编排的机会。(帖子)
-
AI 智能体在大规模运行下的输出质量仍未解决。 一次持续 4 小时的 Claude Code 自主会话生成了 65,000 行无法运行的代码,说明当前智能体在长时运行中仍缺乏自我验证能力。从演示级输出到生产级输出之间的差距,是 AI 进一步跨越 greenfield 项目、扩大采用的下一道主要门槛。(帖子)