Twitter AI 编程 - 2026-04-20
1. 人们正在讨论什么
1.1 GitHub Copilot 定价剧变:暂停注册、收紧限额、按 Token 计费 🡕
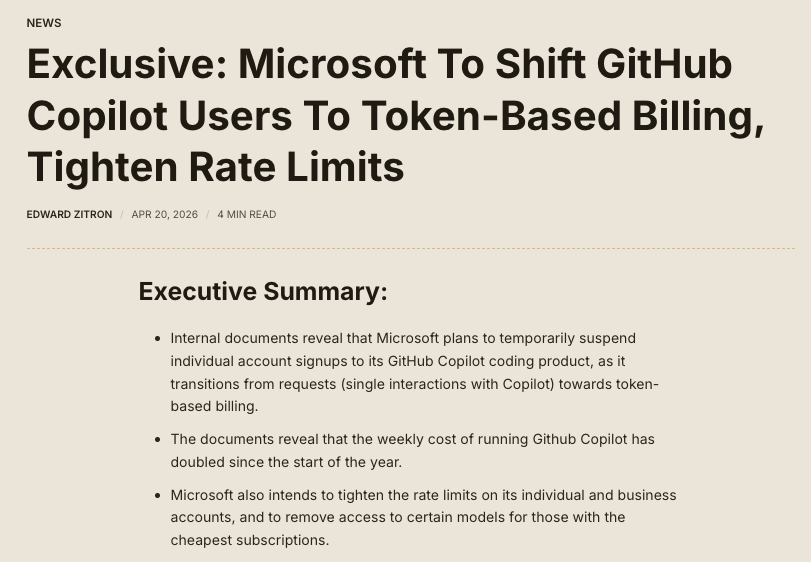
当天最重要的消息来自 @edzitron。该用户 报道称(143 个赞,8,989 次浏览)表示:“本周 GitHub Copilot 个人套餐的速率限制将有重大变化,Opus 模型将退出 20 美元套餐,甚至还可能改为按 Token 计费。”随后,他又发布了 独家文章(53 个赞,3,288 次浏览),援引微软内部文件称,自 1 月以来,运行 GitHub Copilot 的周成本已经翻倍,因此按 Token 计费已成为“最高优先级”。
数小时后,GitHub 证实了这些变化。@chribjel 分享了(10 个赞,894 次浏览)转发了官方 @GHchangelog 公告:为“保持现有用户的服务可靠性”,Copilot Pro、Pro+ 和 Student 套餐暂停新用户注册,同时收紧使用限额;Pro+ 的限额是 Pro 的 5 倍。

@Techmeme 汇总了(7 个赞,2,624 次浏览)补充了完整范围:Opus 模型已从 Pro 中移除,Opus 4.7 仅限 Pro+ 使用。@badlogicgames 补充了一则 PSA(38 个赞,3,612 次浏览)称:“通过 GitHub Copilot 使用 opus 4.7 只支持 medium thinking。”@cherry_mx_reds 的回复则称,7.5 倍积分成本简直是“明抢”。
@edandersen 曝光了另一个漏洞(33 个赞,5,030 次浏览)指出:“付费 Premium Request 预算只能在组织层面设置——你没法只给部分用户分配积分,用于某个特殊项目之类——这意味着一个普通开发者一天内就能花光整个公司的预算。”@ZakSMorris 报道称(4 个赞,168 次浏览)则表示,自己每月支付 39 英镑使用 Pro+,却在“毫无预警”的情况下“隔夜被降级”。
@thisisjonc 提出了不同看法。该用户 展示了(31 个赞,1,155 次浏览)称,在每月 100 美元的套餐中选择 Extra High effort 后,每周只消耗 10% 的使用量:“这完全合理。”

讨论洞察: edzitron 最初帖子的回复串很好地体现了这种张力。@mrnuu 指出,自 3 月中下旬以来,Opus 和 Anthropic 模型就一直没有出现在 Copilot 中,而基于请求次数、又搭配昂贵模型的定价方式本就不可持续。@GlennDubby 预测:“当企业看到真实价格,并把它与这种‘智能’实际带来的价值对比时,它们会大幅撤出对 LLM 的投入。”
与前一天对比: 昨天关于 Copilot 的故事还是 Ollama 让本地代理免费运行。今天叙事完全反转:微软正在收紧云端产品访问、移除模型,并暂停新用户注册。随着成本压力加速显现,昨天的本地优先方案如今看起来颇有先见之明。
1.2 Codex 桌面应用热度飙升,Chronicle 加入屏幕上下文记忆 🡕
当天得分最高、且遥遥领先的帖子来自 @0xSero 称赞了 Codex 桌面应用(546 个赞,20,128 次浏览,得分 1182.2)。该用户称,Codex 已经“从完全不能用,变成了现在‘agentic engineering’里的 #1 体验。UI 非常棒,computer use 完全不打扰人,而且很强大”。
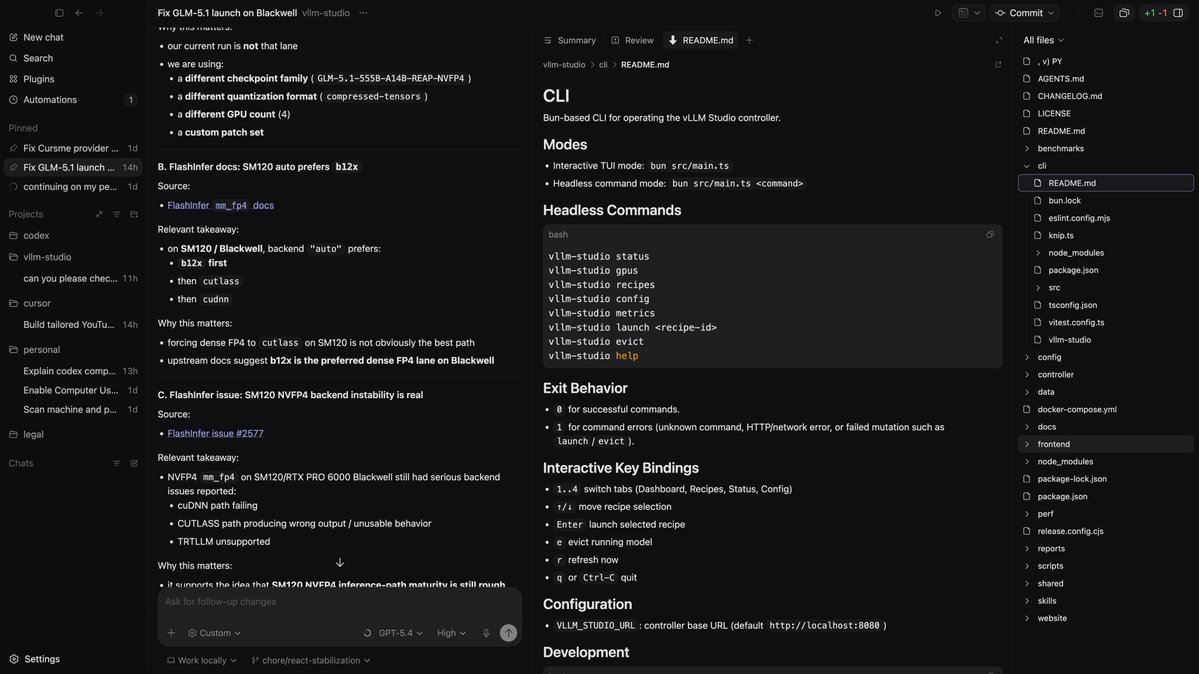
截图显示,Codex 正在一个 vllm-studio 项目中运行 GPT-5.4,为 Blackwell 架构调试 GPU 推理路径——这是真正的工程任务,而不是演示。@m13v_ 的回复解释了为什么 computer use 在 macOS 上效果很好:“AX tree 从 OS X 时代起就一直很稳定,而且每个原生应用都能干净地暴露它。Windows 上照搬 UIA 这套思路,几乎立刻就会遇到不一致问题。”
@rileybrown 发文称(276 个赞,8,568 次浏览)表示:“如果 OpenAI 发布一个设计能力和 Opus 4.7 一样好的模型,Codex App 会遥遥领先。”@Ixel111 的回复认为,GPT-5.4 加上 GPT-Image-2 或许能缩小差距:“假设这两个模型本周都发布,我们就看看。”这一设计质量差距也得到了 @haider1(18 个赞,1,397 次浏览)的呼应:“i really hope openai improves front-end quality in the next gpt-5.x version”,以及 @TeeDevh(3 个赞,131 次浏览)的提问:“Is there a way to get good UI out of Codex? It's great at logic, but not even close to Claude for design.”
与此同时,OpenAI 推出了 Chronicle。@embirico(OpenAI)宣布(90 个赞,4,124 次浏览)表示:“Codex 有记忆了,而且现在这些记忆还可以包含最近的桌面上下文——也就是你一直在做什么。”Chronicle 会定期截屏,为项目、错误和工作流建立记忆。该功能仅限 Pro、仅支持 macOS,而且“非常实验性”。

@TechieUltimatum 详细说明了(8 个赞,59 次浏览)介绍了其实现方式:记忆以 markdown 文件形式保存在本地,需要用户主动授权,并附带隐私警告。@Steffan0xd 在 @coinbureau 的 报道(19 个赞,5,504 次浏览)下回复,准确反映了这种隐私张力:“我显然还没准备好为了省一点时间,就让 AI 24/7 盯着我的屏幕。”
讨论洞察: @RatulSarna 询问 embirico 是否考虑过仓库级记忆,而不是只支持全局记忆,这表明企业对有范围边界的上下文确有需求。@robschaper 则称 Codex 是“我最建议人们学会利用来做工作的第一项人类技能,不管你做什么工作都是如此”。
与前一天对比: 昨天记录的是 Codex 在基础设施任务中的 computer use 能力(Raspberry Pi + Tailscale)。今天,桌面应用获得了迄今最高互动度(得分 1182.2),而 Chronicle 又增加了一项全新能力——来自屏幕截图的环境上下文。产品正在从“你来提示的工具”走向“会观察的助手”。
1.3 Google Antigravity:发布速度惊人,客户信任危机加深 🡖
@GergelyOrosz 记录了(113 个赞,7,380 次浏览)讲述了一则很伤品牌的客户案例:一名付费 Antigravity 用户想追踪使用量,由于 Antigravity 没有原生工具,便用了 CodexBar,结果被 Antigravity 封禁;随后尝试把 Gemini CLI 当作变通方案,也发现被封了——而且同样由 Antigravity 团队控制。客服告诉他,他们“无能为力”。在后续回复中,Gergely 还补充道:“现在还有人问,为什么 Google 在开发者群体里拿不到市场份额吗?Antigravity 悄悄封禁合法付费用户,已经是反复出现的模式。”
与此同时,@LyalinDotCom(Google)列出了八项产品发布(134 个赞,7,155 次浏览)带着明显的讽刺意味发帖:“除此之外,这里最近也没发生什么大事。”清单包括 Gemini 3.1 Flash TTS、Gemini Robotics-ER 1.6、Antigravity 更新、Gemini CLI 更新、AI Studio 更新、macOS 原生应用、Flash Live Thinking 和 Gemma4。LyalinDotCom 也 认可使用竞争对手工具(17 个赞,1,285 次浏览)配合 Google 的帖子表示——“如果你是 builder,就应该把所有工具都探索一遍”。
@Presidentlin 表达了希望(25 个赞,1,348 次浏览)呼吁在 Google I/O 前推出 Gemini 3.5 Pro,并指出 Google 有“太多入口”(CLI、Antigravity、Jules、AI Studio、API)。@cyburke 列出了他们的订阅组合(1 个赞,445 次浏览,3 个收藏)并表示:“我也有 Gemini Pro(免费 1 年),但 Google 搞出 Antigravity 封禁之后,我就没再用了。”
@JulianGoldieSEO 继续用 Antigravity 教学内容刷屏:一篇 4 小时课程(28 个赞,18 个收藏)、一篇 第二门 4 小时课程(3 个赞,10 个收藏),以及两篇 2 小时 课程。
讨论洞察: Antigravity 的悖论正在加深。Google 以极快的速度发功能(一周 8 个产品),也产出了数小时的教学内容,但信任问题——无解释、无申诉地封禁用户——正在直接破坏产品采用。GergelyOrosz 的帖子明确写出了后果:“开发者耸耸肩,回去用 Claude Code 和 Codex 了。”
与前一天对比: 昨天关于 Antigravity 的叙事还是“产出最多教学内容的同时,也把重度用户推向 Windsurf”。今天情况进一步升级:一位高知名度科技记者(113 个赞)记录了一名付费客户在两个看似无关的 Google 产品上都被封禁,而且毫无申诉渠道。信任赤字如今已成为有据可查的流失驱动因素。
1.4 OpenAI 全球故障:ChatGPT 与 Codex 同时宕机,状态页却一片安静 🡕
OpenAI 遭遇了一次重大故障,ChatGPT 和 Codex 同时受到影响。@paul_cal 记录了这种脱节(12 个赞,1,263 次浏览)表示:“ChatGPT & Codex is down. OpenAI status page says 100% no incidents for today. Twitter still the best downtime check app.”


@rehan_hyperion 询问道(16 个赞,1,764 次浏览)问道:“Chat GPT down for anyone else????”@CryptoNewsHntrs 确认了(7 个赞,589 次浏览)称这是一次影响 ChatGPT 网页端、应用、API 以及 Codex 的“MAJOR GLOBAL OUTAGE”。@HashNuke 展示了(0 个赞,48 次浏览)指出,故障同时影响了 Codex CLI(403 Forbidden)和桌面端(反复重连),其用量拆分图还标注了 OpenCode 与 Codex 的流量。

@altArtist7 批评了(1 个赞,22 次浏览)则批评沟通缺失:“ChatGPT 和 Codex 挂了,但 OpenAI 和 Sam Altman 却表现得像什么都没发生——连在 X 上发帖说明一下都没有?”
讨论洞察: 这次故障叠加了定价剧变带来的不满。对限额变化感到沮丧的用户,同时又被完全挡在服务之外。更糟的是,全球故障正在发生时,状态页却显示“无事故”,进一步削弱了用户对 OpenAI 运维透明度的信任。
与前一天对比: 4 月 19 日并无故障报告。今天的事件出现在一个尤其糟糕的时间点:同一天 GitHub 以可靠性为由宣布暂停 Copilot 注册,而 OpenAI 自家的服务也宕机了。这种观感进一步强化了 AI 基础设施正因需求而承压的叙事。
1.5 Anthropic 的 Claude Code 工作坊爆红 🡕
Anthropic 编程代理研究团队负责人一场 30 分钟的工作坊,引发了 4 条分别高分的帖子。@RoundtableSpace 发文称(28 个赞,27 个收藏,13,105 次浏览)称:“THIS 30-MIN WORKSHOP FROM THE CREATOR OF CLAUDE CODE WILL TEACH YOU MORE ABOUT VIBE-CODING THAN 100 YOUTUBE GUIDES.”@Ronycoder 附和称(6 个赞,6 个收藏,133 次浏览)称:“与其看一小时 Netflix,不如看这段 30 分钟的演讲。”@de1lymoon 称其为(10 个赞,9 个收藏,123 次浏览)称“比 100 门付费课还值钱。”@goyalshaliniuk 补充说(8 个赞,3 个收藏,79 次浏览)则称:“这段视频会彻底改变你使用 Claude 的方式。”
这些帖子的综合收藏率值得注意:总计 13,470 次浏览中获得 45 个收藏(0.33%)。仅 RoundtableSpace 那条帖子就获得 27 个收藏,收藏率为 0.21%,显示出很强的“留着以后参考”的意图。
讨论洞察: @themccodes 的一条回复很好地概括了这种情绪:“真正做出这东西的人讲 30 分钟,胜过 3 小时的‘hey guys welcome back to my channel’。”相比衍生型教程内容,用户更偏好权威的一手来源,这一信号反复出现。
与前一天对比: 昨天的教学内容还是 Ollama + Copilot CLI 的分步指南。今天模式发生了变化:仅仅一场出自工具创作者本人的 Anthropic 工作坊,获得的互动就超过了所有教程内容总和。来源权威性比制作质量更重要。
1.6 Vibe 编程反弹加剧,行业框架开始成形 🡕
对 Vibe 编程的反弹,已经从零散抱怨转向更有结构的行业回应。@nixcraft 对此不以为然(11 个赞,954 次浏览)表示:“vibe coding and almost all AI tools are garbage hype created. so i am not surprised people without any coding or engineering skills can't write code.”他引用的是 @CtrlAltDwayne 的观察:“The vibecoders are starting to give up because they're learning AI can't do everything for you.”
@thoughtworks 发布了(3 个赞,3 个收藏,214 次浏览)发布了《超越 Vibe 编程:AI 原生工程的五大构建模块》,主张 2026 年的生产级软件开发需要的是编排,而不是提示词。文章定义了五大支柱:结构化提示词、CI/CD 集成、测试驱动 AI、版本控制审计轨迹,以及人工监督。文中还将 BMAD Method 和 GitHub 的 SpecKit 作为开放式提示之外的具体替代方案。
@ThePracticalDev 分享了(1 个赞,2 个收藏,424 次浏览)分享了一位开发者使用 BMAD 的体验:“Vibe 编程是以牺牲理解为代价来优化产出。这位开发者发现,BMAD 让你始终是 orchestrator,而不是 passenger。”
@pxue 预测(2 个赞,46 次浏览)表示:“Vibe 编程会在夏天达到顶峰,然后悄无声息地死去。”
@Layton_Gott 给出了一个实用的修复方法(1 个赞,12 次浏览)表示:“别再用 Claude Code 调 bug 了。如果它两次都修不好,问题不在 bug,而在你的上下文。关掉这个会话,开一个新的。只贴出出错函数和报错信息。”
讨论洞察: 这场反弹正在分叉。一边是资深工程师彻底否定 vibe coding;另一边则是 BMAD 和 SpecKit 这类方法论,试图在保留 AI 辅助速度的同时加入工程纪律。共同点在于:单靠无结构提示,无法胜任生产工作。
与前一天对比: 昨天“vibe coding hangover”还只是一个新出现的反弹说法。今天,Thoughtworks 和 BMAD 社区已经提出了结构化替代方案。讨论正从“vibe coding 有问题”转向“什么将取而代之”。
1.7 本地与免费 AI 编程选项继续扩展 🡒
免费/本地编程的故事延续了昨天 Ollama + Copilot CLI 的突破。@python_spaces 分享了分步指南(13 个赞,8 个收藏,535 次浏览)介绍了如何用 Ollama 在本地运行 Copilot CLI:“No API costs. 100% local.”
@JulianGoldieSEO 推广 Gemma 4(10 个赞,4 个收藏,654 次浏览)将其称为“a free AI that beats GitHub Copilot”,并表示它“runs right on your own laptop”,通过 Ollama 和 Cursor 实现。他还另外 列出了三种免费的 Claude Code 使用路径(4 个赞,5 个收藏,108 次浏览):通过 Ollama cloud models 使用 GLM 5.1、本地运行 Gemma 4,并通过 OpenRouter 使用 Elephant Alpha。
@hampsonw 发布了 BenchLocal 结果(1 个赞,95 次浏览)展示了 Gemma-4-31b-it 在 6 项基准测试中的平均成绩为 90.17,超过 GPT-5.4(88.67)、GPT-5.4-mini(86.83)和 Qwen3.6-35B(85.67)。

@llmdevguy 提出异议(1 个赞,84 次浏览)反对昂贵订阅:“No, don't do that. $1000 per month is ridiculous. Instead use MiniMax 2.7 ($20/m, 180,000 requests/month) or Ollama Cloud (GLM-5.1, M2.7, $20/m).”
讨论洞察: 本地/免费内容在这个时间点出现并非偶然。GitHub 同日暂停注册并收紧限额,放大了市场对彻底摆脱订阅依赖的替代方案需求。BenchLocal 的数据表明,本地模型性能甚至优于 GPT-5.4,为“本地优先”提供了量化依据。
与前一天对比: 昨天 Ollama 刚发布 Copilot CLI 集成。今天,生态已经开始用指南、基准测试和替代模型推荐来跟进。本地优先正从“发布公告”走向“落地采用基础设施”。
2. 什么让人感到沮丧
GitHub Copilot 无预警降级——高
@ZakSMorris 报道称(4 个赞,168 次浏览)每月支付 39 英镑使用 Pro+,却发现自己“隔夜被降级。使用限额收紧,Opus 4.5 和 4.6 被移除。价格不变,没有预警,也没有任何调整”。@edandersen 指出了(33 个赞,5,030 次浏览)指出了组织级预算的缺陷。@prashant_hq 指出 在回复中表示:“在今天之前,你可以在 opencode 里把一个 100 项任务交给 opus,它会不断自动压缩上下文,连续工作好几个小时,而你只花 1 个请求。他们在 10 美元套餐里给了 300 个请求。”应对方式:转向本地模型,或叠加多个更便宜的订阅。
Google Antigravity 无申诉渠道地封禁付费客户——高
@GergelyOrosz 记录了(113 个赞,7,380 次浏览)讲述了一位付费 Antigravity 用户因使用 CodexBar(用量追踪工具)而被封禁,随后发现其 Gemini CLI 访问权限也被 Antigravity 团队撤销。客服称他们“无能为力”。这名用户最终放弃该平台,转回 Claude Code 和 Codex。@cyburke 确认了 表示,在“Google 搞出 Antigravity 封禁之后”停止使用 Antigravity。应对方式:彻底放弃该平台。
OpenAI 宕机且状态页沉默——中
@paul_cal 展示了(12 个赞,1,263 次浏览)称,ChatGPT 和 Codex 无法使用,而 OpenAI 状态页却显示“No incidents”。多名用户报告 CLI、桌面端和网页端都出现了 403 Forbidden 错误。@altArtist7 指出 表示:“OpenAI 和 Sam Altman 表现得像什么都没发生。”应对方式:把 Twitter 当作事实上的状态页。
Codex 前端质量差距——中
@rileybrown(276 个赞)、@haider1(18 个赞)和 @TeeDevh(3 个赞)都指出了同一个问题:Codex 处理后端逻辑很强,但做 UI 远不如 Claude。@haider1 指出 表示:“i am mostly sticking with 5.3 codex because gpt-5.4 is too token-intensive.”应对方式:前端工作切到 Claude/Opus,只用 Codex 处理逻辑。
Copilot 训练数据退出截止日期——低
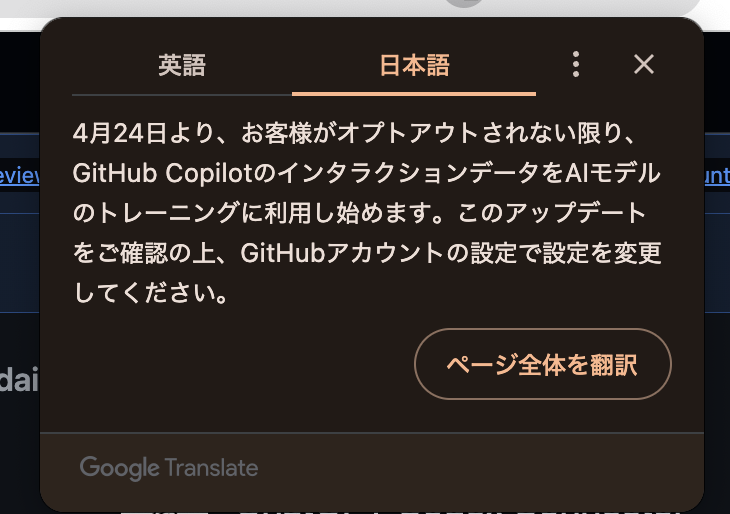
@zento_ai 曝光了(3 个赞,747 次浏览)展示了一则通知:从 4 月 24 日起,GitHub 将把 Copilot 交互数据用于 AI 模型训练,除非用户主动退出。截图为日文,这说明它可能是出现在本地化设置中的通知,而没有配套醒目的英文公告。
3. 人们希望存在什么
设计能力达到 Opus 4.7 水平的 Codex
@rileybrown 将这种差距表述为(276 个赞,8,568 次浏览)表示:“如果 OpenAI 发布一个设计能力和 Opus 4.7 一样好的模型,Codex App 会遥遥领先。”@TeeDevh 直接询问(3 个赞,131 次浏览)问道:“Is there a way to get good UI out of Codex?”@haider1 补充说(18 个赞,1,397 次浏览)表示:“i really hope openai improves front-end quality in the next gpt-5.x version, so i would not need to switch to other models.”需求信号很明确,而且量很大:后端能力已经很强,前端/设计仍是卡点。
Copilot Enterprise 的按项目预算控制
@edandersen 表示(33 个赞,5,030 次浏览)指出的问题是:“you cannot give a subset of users credits for a special project.”只能做组织级预算分配,意味着单个开发者就可能耗尽整个公司的 Premium Request 预算。5,030 次浏览和 4 个收藏表明,这一问题在企业买家中引发共鸣。
Codex 移动客户端
@gpsamson 开发了 Flodex(1 个赞,22 次浏览)指出原因在于“Codex 还不支持移动端控制”。这个应用通过 Tailscale 连接 Codex 服务器,并在移动端提供任务列表界面来管理线程。用户自己动手做了一个移动客户端,本身就说明需求尚未被满足。

Codex 的仓库级记忆
@RatulSarna 询问道 在 Chronicle 公告帖中问道:“Did you consider an option repo-level memories? Any particular reason you went with global only?”Chronicle 当前实现的是全局记忆;如果能按项目划分上下文,就能为不同代码库维护不同的记忆集。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| OpenAI Codex | 代理平台 | (+) | 桌面应用被誉为“#1 agentic engineering”体验(得分 1182.2);Chronicle 增加屏幕上下文记忆;在 100 美元套餐上的使用量被认为合理 | 与 Opus 相比存在前端/设计质量差距;4 月 20 日发生全球故障;GPT-5.4“太耗 Token” |
| GitHub Copilot | 云端 IDE 代理 | (+/-) | 需求极强(已暂停注册);Pro+ 限额是 Pro 的 5 倍;组织套餐仍可使用 | 暂停注册;Opus 从 Pro 中移除;Opus 4.7 只支持 medium thinking;组织预算不够细粒度;4 月 24 日前需退出训练数据使用 |
| Claude Code | 终端代理 | (+) | 创作者工作坊爆红(1.3 万+ 浏览);数据集中被提及 25 次;用于 AGI House 的算法发现 | 不支持移动端;订阅复杂性没有变化 |
| Google Antigravity | IDE | (-) | 一周内发布 8 个产品;已有 10+ 小时课程内容可用 | 付费客户被封且无申诉渠道;客服“无能为力”;通过 Gemini CLI 实施跨产品封禁 |
| OpenCode | 开源终端代理 | (+) | Cloudflare 用它构建了原生集成 CI 的代码审查器;主题配置已有文档 | 有用户称 K2.6 模型质量“dogshit”;/theme 命令损坏 |
| Ollama | 本地模型服务器 | (+) | 昨天发布的 Copilot CLI 集成还在持续传播;可零成本运行本地代理 | 仍在被更多人发现;需要教程引导 |
| Gemma 4 (31b-it) | 本地模型 | (+) | BenchLocal:平均 90.17,超过 GPT-5.4(88.67);可在笔记本本地运行 | 尚未在所有测试框架中验证;需要配置 Ollama |
| Cursor | IDE | (+) | 仍有用户把它作为日常主力,因为“愚蠢错误”更少 | 被视为“LLM wrapper”,独特差异有限 |
| BMAD Method | 规范驱动框架 | (+) | 获 Thoughtworks 背书;可避免“agent thrashing”;支持多角色编排 | 仍属新方法;采用深度未知 |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Chronicle | @embirico(OpenAI) | 通过定期截屏为 Codex 构建记忆 | 不必在每次会话中重复说明上下文 | macOS、Codex、GPT-5.4 | 研究预览(仅限 Pro) | 公告 |
| Flodex | @gpsamson | 通过 Tailscale 连接 Codex 的移动客户端 | 缺少原生的 Codex 移动控制 | iOS、Tailscale、Codex API | Alpha(自用) | 帖子 |
| Agent Arcade | @DanWahlin | 代理工作时运行的复古街机叠加层 | 等代理时的空档时间 | Tauri、Phaser、TypeScript、Copilot CLI | 已发布(开源) | 帖子, 仓库 |
| Mission Control v2.0 | @nyk_builderz | 具备可观测性、记忆图谱和安全能力的代理运维平台 | 协调多个 AI 代理 | OpenCode、Hermes、Claude、Codex | 已发布(4.2k stars,726 forks) | 帖子 |
| Plannotator 0.18.0 | @plannotator | 支持代理的批注/计划审查工具 | 与代理协作进行代码审查 | Cloudflare、OpenCode | 已发布 | 帖子 |
| Polymarket analytics | @RetroChainer | 用蒙特卡洛模拟分析 4 亿笔交易 | 发掘预测市场优势 | Mac Mini、Claude Code、XGBoost | 已发布(个人) | 帖子 |
| NBA betting model | @RetroChainer | 结合 nba_api、Polymarket、DraftKings 的 XGBoost 模型 | 从数据分歧中发现体育博彩优势 | Mac Mini、Claude Code、XGBoost | 已发布(个人) | 帖子 |
| CI-native code reviewer | @Cloudflare | 集成进 CI 流水线的 AI 代码审查器 | 人工代码审查瓶颈 | OpenCode | 已发布 | 帖子 |
| OmniSwap | @DefiHimanshu | 获取最佳兑换汇率的 DEX 聚合器 | DeFi 流动性碎片化 | Hackathon project | Alpha(黑客松获奖) | 帖子 |
| Local Hive | @TODIofBaltomore | Farm-to-table 配送应用 | UI/UX 设计师借助 AI 打通设计到开发 | Figma、Codex | 设计阶段 | 帖子 |
6. 新鲜且值得关注的动态
OpenAI Chronicle:面向 Codex 的屏幕上下文记忆
@embirico(OpenAI)发布了(90 个赞,4,124 次浏览)将 Chronicle 作为面向 macOS 上 Pro 订阅用户的研究预览功能发布。它会定期截屏,并构建基于 markdown 的记忆,让 Codex 无需用户反复重述上下文,就能帮助处理你一直在做的事情。@Techmeme 报道了此事(10 个赞,1,697 次浏览)。隐私机制仅在用户主动选择加入后启用,并配有明确警告。这是主流编程代理中首个重要的环境上下文功能。
GitHub 暂停所有个人 Copilot 注册
@GHchangelog 宣布 报道了 Pro、Pro+ 和 Student 新注册暂停、使用限额收紧,以及 Opus 模型从 Pro 层级移除。@edzitron 的 报道 还补充称,内部文件显示 Copilot 的周成本自 1 月以来已经翻倍,并计划在 2026 年晚些时候引入按 Token 计费。
Cloudflare 使用 OpenCode 构建原生集成 CI 的代码审查器
@Cloudflare 分享了(26 个赞,20 个收藏,2,079 次浏览)介绍了他们如何使用 OpenCode 构建一个原生集成到 CI 中的 AI 代码审查器,帮助工程师“发布更好、更安全的代码”。相对浏览量而言,20 个收藏意味着 0.96% 的收藏率,显示出实践者的强烈兴趣。这是首个有记录、且明确使用 OpenCode 的企业级 CI 集成案例。
BenchLocal:本地 Gemma-4 超过 GPT-5.4
@hampsonw 发布了(1 个赞,95 次浏览)展示了 BenchLocal 结果:Gemma-4-31b-it 在 6 项基准测试中的平均成绩为 90.17,超过 GPT-5.4 的 88.67。分项成绩显示,Gemma-4 与 GPT-5.4 在 bugfind(93 vs 95)、dataextract(90 vs 86)和 instructfollow(97 vs 99)等类别上各有高低。互动不高,但对本地优先可行性而言信号很强。
Copilot 交互数据训练将于 4 月 24 日开始
@zento_ai 曝光了(3 个赞,747 次浏览)展示了一则 GitHub 通知:从 4 月 24 日起,Copilot 交互数据将被用于 AI 模型训练,除非用户主动退出。该通知以日文本地化形式出现,说明它可能尚未在英文渠道获得醒目报道。
Claude Code 代理在算法发现上逼近业界最优
@0x_Asuka 报道称(8 个赞,70 次浏览)提到,在一次 AGI House 活动中,27 个 Claude Code 代理在 30 秒内产出了车辆路径问题算法,距离业界最优仅差 3%。@vidalthi 被称为“其领域排名第一的研究者”,据称在看到这些代理在约 4 小时内“重新梳理并重新发现了 30 年的 VRP 文献”后感到“amazed”。
7. 机会在哪里
[+++] Subscription Cost Optimization Layer — GitHub Copilot costs doubled since January (@edzitron、文章)。注册已暂停,按 Token 计费正在到来。@thisisjonc 展示了 表示每月 100 美元套餐每周只消耗 10% 用量。@llmdevguy 列出了 则给出了每月 20 美元的替代方案。随着补贴式定价结束,一款能够监控 Copilot、Claude、Codex 订阅实际 Token 消耗、推荐最优套餐分配,并自动把请求路由到最便宜且能力足够模型的工具,将能满足一个结构性且持续增长的需求。
[+++] Enterprise Budget Granularity for AI Coding — @edandersen 识别出(33 个赞,5,030 次浏览)指出,Copilot Premium Request 预算目前只能按组织统一设置,无法按用户或项目分配。随着按 Token 计费逼近,企业需要部门级、项目级和用户级预算控制,以及告警功能。GitHub 今天并不提供这些能力。面向 AI 编程工具的第三方预算治理层,将填补一个只会随着按量计费普及而继续扩大的空白。
[++] Ambient Context for Coding Agents — Chronicle (@embirico、帖子)目前仅限 Pro、仅支持 macOS,也仅适用于 Codex。一个跨平台、跨代理的环境上下文层——捕捉屏幕状态、终端输出和浏览器活动,并提供给 Claude Code、Codex 和 OpenCode——可以在不被单一厂商锁定的前提下,解决同样的“别再反复解释上下文”问题。@RatulSarna 关于仓库级记忆的提问,表明企业对有范围边界的上下文存在真实需求。
[++] Mobile-First Codex/Agent Client — @gpsamson 开发了 Flodex 把这做成了个人变通方案,因为 Codex 没有移动端支持。一个打磨完善的移动客户端,如果能跨 Codex、Claude Code 和 OpenCode 管理代理会话——查看进度、批准改动、管理队列——就能服务于越来越多离开工位后仍需监控长时任务的开发者。
**+] 规格驱动的 AI 开发工具** — Thoughtworks [已发布 提出了一套“AI-native engineering”框架,用结构化的 spec-to-code 流水线替代 vibe coding。BMAD Method 和 GitHub SpecKit 都被提及,但还处于早期。若有工具能让规范驱动的 AI 开发像 vibe coding 一样简单——自动从对话生成规范、维护规范与代码的可追溯性、标记漂移——就能抓住越来越多认为 vibe coding 不足以支撑生产工作的用户。
8. 核心结论
-
GitHub Copilot 的定价剧变是当天最关键的政策事件。 微软暂停了所有个人注册,收紧限额,把 Opus 从 Pro 中移除,并在 Copilot 周成本自 1 月翻倍后计划引入按 Token 计费。这是迄今为止最明确的信号:补贴式 AI 编程正在结束。(@edzitron, 独家;@GHchangelog via @chribjel, 帖子)
-
Codex 桌面应用在推出环境上下文能力的同时,获得了迄今最高赞誉。 在得分 1182.2、20,128 次浏览的情况下,@0xSero 的背书成为当天互动最高的帖子,领先第二名 3 倍。同时,Chronicle 增加了屏幕上下文记忆——这是主流编程代理中的首个环境上下文功能。产品正从“提示驱动工具”加速走向“会观察的助手”。(@0xSero, 帖子;@embirico, 帖子)
-
Google Antigravity 的客户信任问题,如今已成为有据可查的流失驱动因素。 一名付费客户在两个看似无关的 Google 产品上都被封禁,客服还承认自己“无能为力”。后果写得很明白:“开发者耸耸肩,回去用 Claude Code 和 Codex。”Google 一周发布 8 个产品的速度,无法抵消主动赶走付费用户的影响。(@GergelyOrosz, 帖子)
-
OpenAI 宕机在最糟糕的时刻暴露了状态页的不可靠性。 同一天里,GitHub 以可靠性为由暂停 Copilot 注册,而 ChatGPT 和 Codex 也在全球范围内宕机。OpenAI 状态页在故障仍在发生时却显示“No incidents”。微软和 OpenAI 的运营透明度信任在同一天同时受损。(@paul_cal, 帖子)
-
本地模型基准测试如今已展示出对云端模型的量化优势。 BenchLocal 结果显示,Gemma-4-31b-it(90.17)在 6 项编程基准测试中超过 GPT-5.4(88.67)。结合昨天的 Ollama + Copilot CLI 集成与今天的定价剧变,本地优先选项正从小众方案转变为具备结构性优势的路线。(@hampsonw, 帖子)
-
Vibe 编程反弹正从抱怨升级为替代框架之争。 Thoughtworks 发布了“AI-native engineering”的五大支柱框架,BMAD Method 也在获得更多背书。讨论已经从“vibe coding 有问题”走向“哪些结构化方案会取而代之”。这表明这一实践已经成熟到足以催生自己的反对文献。(@thoughtworks, 帖子;@ThePracticalDev, 帖子)
-
Anthropic 的内容策略之所以胜出,是因为它直达源头。 仅仅一场由 Claude Code 创作者主讲的 30 分钟工作坊,就带来了比数小时第三方教程更高的综合互动(13K+ 浏览、45 个收藏)。相比衍生式教程,用户显然更偏好权威的一手内容,而且这一模式在反复出现。(@RoundtableSpace, 帖子)