Twitter AI 编程 - 2026-04-24
1. 大家在讨论什么
1.1 GPT-5.5 上线次日的采用正在重塑工具偏好 🡕
GPT-5.5 发布后的第二天,讨论焦点就从基准测试转向了实际采用。@satyanadella 宣布(292 个赞、11,332 次浏览、32 个收藏)介绍了 GPT-5.5 在 GitHub Copilot、M365 Copilot、Copilot Studio 和 Foundry 中的部署情况:“凭借更深入的推理、更强的多步骤执行能力,以及在长周期复杂任务中的更佳表现,GPT-5.5 能帮助你以更少迭代、更快从想法走向执行。”在后续帖子中,Nadella 描述了 Copilot CLI 中的多模型工作流:“用更快的模型快速搭框架和探索。用更强的推理模型做规划。然后让 GPT-5.5 接手这份计划,把它变成可运行的代码。”他还提到了“Rubber Duck agent”——一种多模型反思循环:由 GPT-5.5 审查另一个模型的输出,或者反过来。
@code 确认(47 个赞、3,911 次浏览)提到 GPT-5.5 已可在 VS Code 中使用,并引用了 @github 的 公告:“我们的早期测试显示,它在复杂的智能体式编程任务上表现最强。”但用户对定价反应不一:@dbdnvikas 表示:“Opus 和 5.5 都是 7.5 倍?算了,我直接用 codex。”@alex_smmr 则说:“7.5 倍就是个笑话。”
@mckaywrigley 发布了一份详尽的从业者评估(12 个赞、709 次浏览、11 个收藏)准确捕捉到了格局变化:“编程方面,我在不到 3 个月里就从 80/20 的 claude/gpt 变成了 80/20 的 gpt/claude。”他称 GPT-5.5“不可思议”,还说“如果现在我只能留一个模型,那就会是它”。但他也指出,Opus 4.7“如果真有变化,也只是横向移动”,并表示“anthropic 必须得把算力问题解决掉。作为用户你能明显感觉到。”他给编程工具的分层是:Codex 和 Claude Code 属于第一梯队,Cursor 属于第二梯队;并表示自己这个月已经卸载了 Cursor,回到了 VS Code。
@Colewherld 捕捉到了新用户的兴奋感(25 个赞、225 次浏览):“兄弟,怎么没人早点告诉我 Codex?我刚开始用,感觉比 Claude Code 强了几个光年。Codex 里的新 5.5 模型太离谱了。”@zaheerain 回复问:“真有这么简单?”Colewherld 则补了一句:“AI 的水平只和使用它的人一样高。”
讨论洞察: Copilot 对 GPT-5.5 收取 7.5 倍 token 倍率,引发了多位用户反弹。按这个倍率算,20 美元的 Codex 套餐比通过 Copilot 使用 GPT-5.5 更划算,形成了有利于 Codex 采用的价格套利。@JakeKAllDay 指出:“gpt5.5 比 5.4mini high 更便宜(而且更快),所以即便是在 20 美元/月的套餐里,它的可用性也一下子高了很多。”
与前一天对比: 4 月 23 日,GPT-5.5 刚发布时,叙事核心还是基准测试成绩(Senior Engineer benchmark 为 62/100)。而今天,叙事已经转向从业者偏好数据:mckaywrigley 的 80/20 翻转、Colewherld 从 Claude Code 迁移,以及 Kappaemme1926 取消 Claude 订阅。这个模型已经不再只是被评估——它正在被采用。
1.2 DeepSeek V4 到来;OpenCode 成为默认测试场 🡕
@opencode 宣布(116 个赞、2,376 次浏览、22 个收藏)介绍了 DeepSeek V4 集成:“今天就在 OpenCode 里试试 DeepSeek V4。1. /connect DeepSeek provider。2. 从 platform.deepseek.com 获取你的密钥。3. 选择 DeepSeek-V4-Pro。”评论区立刻开始催 OpenCode Go 版本支持:@Shawnw3i 说:“不……我们需要它进 opencode go。”@noctus91 和 @alomorfYT 也表达了同样的诉求。
@rileybrown 提问(28 个赞、4,998 次浏览)问道:“测试新版 Deepseek 模型的最佳方式是什么?OpenCode?”14 条回复基本确认了 OpenCode 已成默认选择:@ZagZino 说:“说真的,直接装 opencode,他们最新更新里已经加了 v4 pro 和 flash。”@nishancodes 则表示:“最便宜的测试方式——Opencode / Openrouter。最好的方式——去 vast 或 Runpod 租块 GPU。”
@mehulmpt 做了一个四方对比(36 个赞、1,820 次浏览、8 个收藏):“我在一个真实代码库里,分别用 deepseek v4 pro(opencode)、kimi k2.6(opencode)、opus 4.7 max(Claude code)、gpt 5.5(codex)做了一个 25 分钟的任务。结果很有意思。视频稍后发布。”这是首次把 DeepSeek V4 与三款西方前沿模型放在同一场正面对比里。
@ivanfioravanti 演示了(13 个赞、504 次浏览)展示了用 EXO v1.0.71 在两台 M3 Ultra 512GB 机器上进行本地推理:“Qwen3.6-27B-8bit 30 tps,Kimi-K2.6 4bit 20 tps。”截图显示,两台 Mac Studio 通过 MLX RDMA 互连,并通过 EXO chat 和 OpenCode 运行模型。
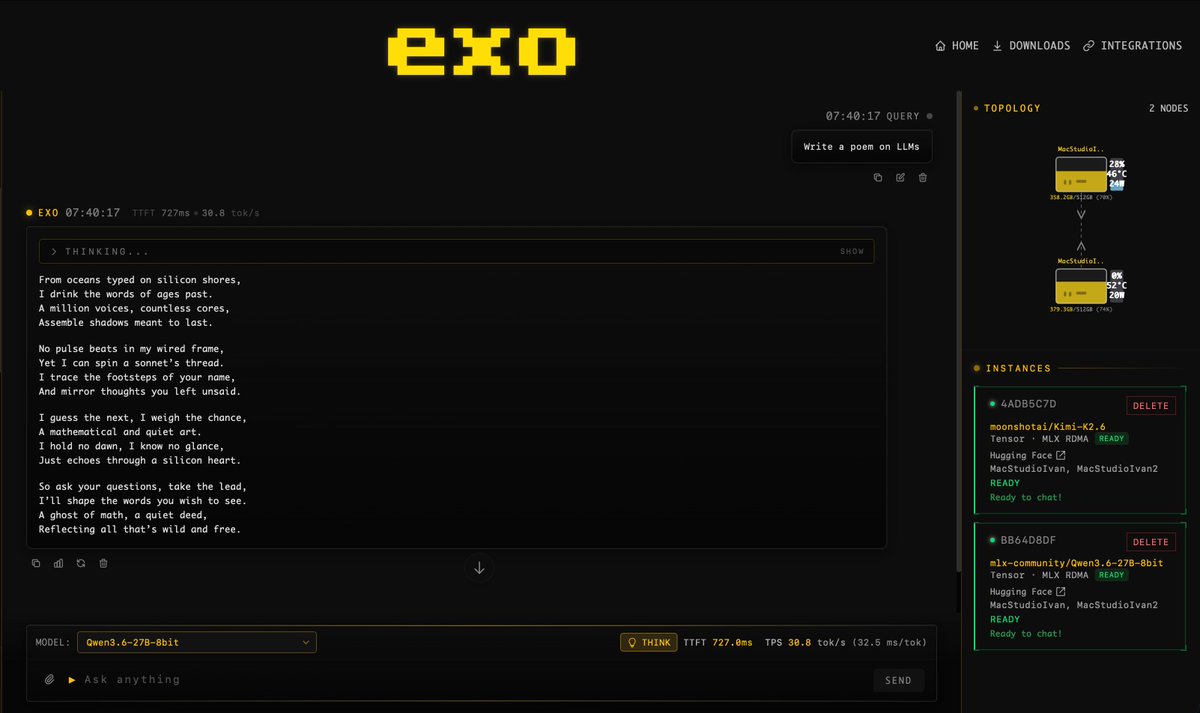
讨论洞察: OpenCode 已巩固其作为新模型中立测试场的地位。现在每当有新模型发布(DeepSeek V4、Kimi K2.6、Qwen 3.6),大家首先问的已经是“OpenCode 里有吗?”,而不是“哪个 IDE 支持它?”
与前一天对比: 4 月 23 日,OpenCode 还只是凭借每天 5–7 美元、承接从 Claude Code 迁移的用户而增长。到了今天,它新增了 DeepSeek V4 支持,社区也开始把它视为任何新模型发布后的默认评测载体。这个开源智能体层,正在成为 AI 编程工具里的“瑞士”。
1.3 20 美元怎么花:用户开始集体讨论哪款工具最值 🡒
@Bhavani_00007 提出了这个问题(42 个赞、1,987 次浏览)捕捉到了工具碎片化带来的焦虑:“我准备投入 20 美元,应该选哪个?Claude、Codex、Cursor、Antigravity、GitHub Copilot。现在到底哪个更值?”41 条回复反映出真实困惑。@molaerga 推荐 Cursor:“我用的是 20 美元套餐,每天都在做项目、做多个应用,从来没碰到上限。”@explorersofai 则反驳:“如果你真想认真做事,那就花 200,不是 20。”
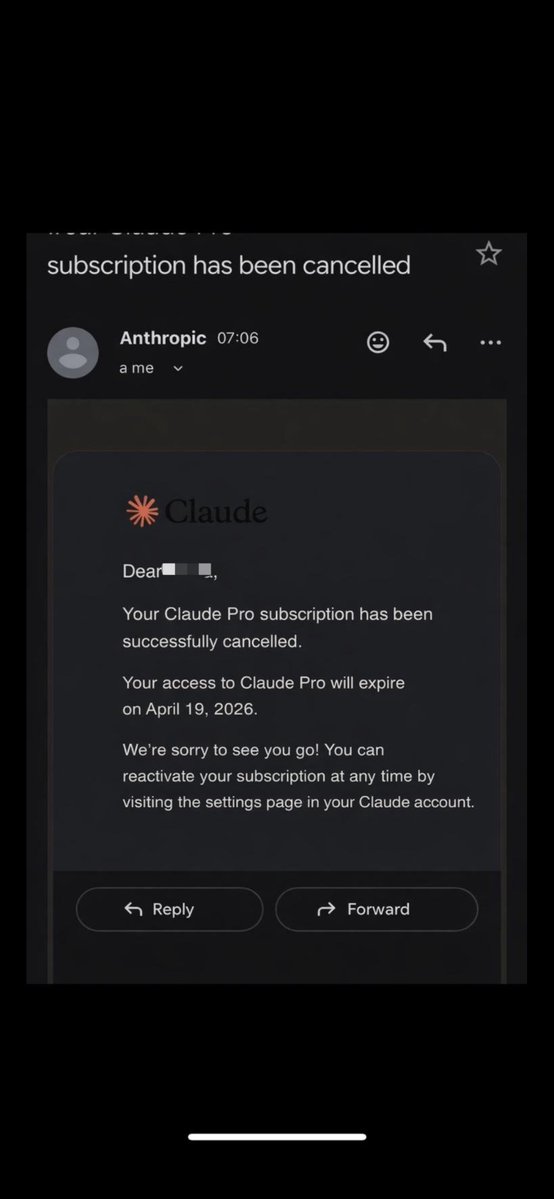
@Kappaemme1926 用行动回答了这个问题(48 个赞、2,577 次浏览):“我从没这么开心地取消过一个订阅。时间越久,我越觉得这是对的。谢谢你,OpenAI。Codex 完全是另一个级别。”配图是 Claude Pro 的取消订阅邮件。
@0xSero 给出了排名(33 个赞、2,022 次浏览):“Anthropic 这次的 UI 做得真不错,比上一版好太多了。它有竞争力,不过 Codex 还是更强。所以按应用来排:Codex、Cursor、Claude,Droid,以及并列的 Opencode 和 t3code。”@julythirt33n 的回复点出了其中的张力:“对,codex 现在把我拿捏住了,虽然我其实也想用 factory 或 opencode 这样的应用。”
@lunardragon420 询问具体的切换建议(4 个赞、467 次浏览):“我现在在用搭配 glm 模型的 claude code。你建议我换到 codex 吗?我听说 opencode 也很不错。你推荐哪个?”
讨论洞察: Bhavani_00007 这条帖子的 41 条回复并未形成共识。Cursor、Codex 和 Claude Code 都各有支持者。这反映出一个现实:在 20 美元价位上,没有哪款工具形成绝对优势,而切换成本又低到足以让用户每周在不同工具间来回流动。
与前一天对比: 4 月 23 日,工具比较主要由基准测试数据驱动(如 danshipper 给 GPT-5.5 打出 62/100)。到了今天,讨论已经转向消费者层面的预算决策和退订行为。受众也从高阶用户扩展到了正在评估性价比的主流采用者。
1.4 Vibe coding 到处都撞上速率限制 🡕
@notjazii 记录了这种挫败感(134 个赞、1,428 次浏览)定义了当天的算力主题:“昨天开始 vibe coding,结果现在就已经把 antigravity 的每周额度打满了。我有 google pro,先说清楚。他们说 antigravity 的额度比 Claude 更高,所以我才选这个。结果现在我要整整等 FIVE 天?”配图显示多个配额均已耗尽:Gemini 3.1 Pro 要 5 天 9 小时后刷新,Claude Sonnet 4.6 和 Opus 4.6 Thinking 要 6 天 2 小时后刷新,只有 Gemini 3 Flash 会在不到 5 小时后恢复。
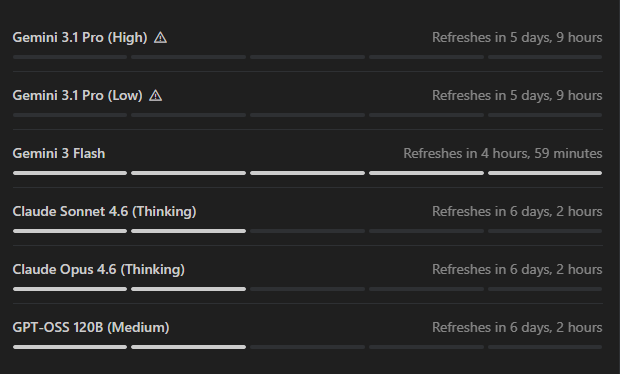
@vaultmkr 回复称:“Antigravity 很垃圾,别浪费时间。如果你想花 20 美元做 vibe coding,又不想老是感受到配额限制,就用 Codex。我基本感觉不到额度问题。”
@MilkRoadAI 将此与宏观图景联系起来(7 个赞、1,421 次浏览):“Anthropic 不得不下调 Claude 的思考深度,并对付费用户设置使用上限。开发者正在转向 OpenAI Codex。”帖子还详细写到,Anthropic 单季营收增长了三倍,达到 300 亿美元年化收入水平,但“单个开发者跑一个 AI 智能体,就可能在几分钟内耗掉整整一天的算力”。而 2026 年各大超大规模云厂商合计约 7000 亿美元的 AI 资本开支,“仍不足以满足需求”。
@edzitron 进行了背景说明(17 个赞、2,816 次浏览)出现在 Times Tech Report 节目中,讨论“GitHub Copilot 转向基于 token 的计费、Anthropic 被抬高的二级市场估值,以及补贴式 AI 时代正在走向终结”。
讨论洞察: notjazii 的帖子(数据集中回复数最高,共 90 条)展示了一位新用户在 36 小时的游戏开发后就耗尽了配额。这正是 vibe coding 的采用模式:满怀热情的新手,往往在第一个周末内就撞上硬性的算力天花板。
与前一天对比: 4 月 23 日,算力相关的新闻还只是 GitHub 暂停 Copilot Business 注册,以及 Codex 出现重连循环。到了今天,限制已经扩大到 Antigravity(多日刷新计时器)和 Anthropic(思考深度受限、峰值时段限额)。如今,每家主要提供商都在明显地配给算力。
1.5 对抗式多模型工作流开始成为一种实践 🡕
@0xLatencyZero 发布了一张工作流图(1 个赞、137 次浏览、2 个收藏)介绍了“对抗式审查”——先用 Claude Code 中的 Opus 4.7 起草实现,再用 Codex 插件里的 GPT-5.5 审查 diff:“两款前沿模型。训练不同,盲点不同,彼此独立审查。”流程是:开发者把意图发给 Claude Code,由它起草并构建;再把 diff 交给 Codex,由后者标记逻辑漏洞、回归问题和安全偏移;审查通过后代码再发布。
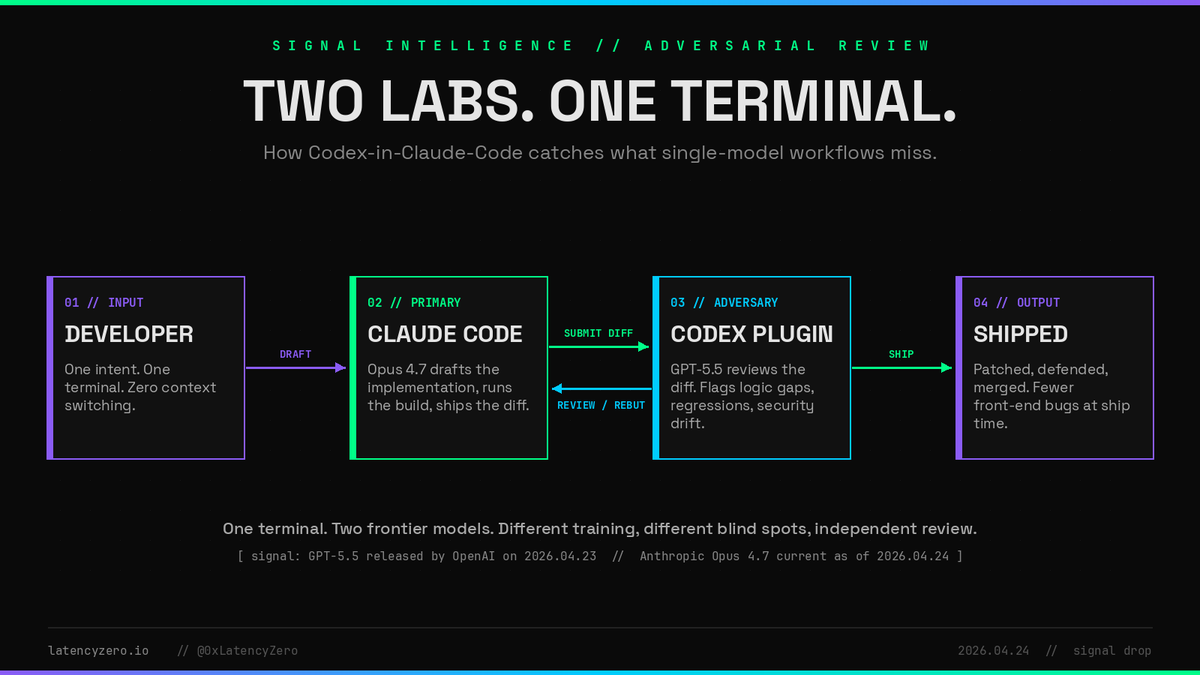
@mr_the_dooom 描述了类似的模式(0 个赞、27 次浏览):“让 Claude 纯粹担任经理、架构师和文档维护者,让 codex 当一个由 Claude 驱动的写码苦工。不知为何,这种搭配产出高得离谱,而且 token 用量很低。”
Nadella 的帖子也从平台层面印证了这一点。他描述了“Rubber Duck agent”:由“GPT-5.5 审查另一个模型的输出,或者反过来”。
讨论洞察: 对抗式多模型审查正同时从两个方向浮现:一是自上而下,由 Nadella 将其描述为平台功能;二是自下而上,由从业者自行摸索出来。共同认识是:不同实验室的模型有不同失效模式,因此跨实验室审查能抓到同模型自审容易漏掉的 bug。
与前一天对比: 4 月 23 日,人们注意到,评测框架质量比模型选择更重要(kylejeong 展示了同一模型也会产出不同结果)。而今天,这一模式进一步发展成有意设计的多模型流水线:由不同实验室的模型承担互补角色,一个负责起草,另一个负责审查。
1.6 Google Antigravity:课程内容刷屏,但心智份额停滞 🡒
@JulianGoldieSEO 一天内连发四条不同的 Antigravity 课程视频:包括一条 2 小时课程(11 个赞、506 次浏览、15 个收藏)、一条 4 小时课程(13 个赞、582 次浏览、8 个收藏),以及另外两条转发。@heyDhavall 增加了一个 4 小时版本(23 个赞、1,612 次浏览、14 个收藏)写道:“今晚别刷 Netflix,来看这套 4 小时完整版 Google Antigravity 课程。”@geeksforgeeks 推广了(9 个赞、344 次浏览)则宣传了一场免费工作坊:“带你了解 Antigravity 和 AI 智能体的工作方式。在指导下搭建你自己的 AI 智能体。再用免费额度把它部署到 Google Cloud 上。”
但从业者层面的信号依旧疲弱。@Fabiobuilds 评估了(6 个赞、1,094 次浏览):“Google 正在投入小模型/本地模型(Gemma、flash、flash lite),这方面做得很好。对 3.1 pro 的投入则非常有限(真的有人在 Antigravity 上写代码吗?)”@mckaywrigley 写道 则说:“gemini……?这好像已经是第 2、3 个了:模型发布时看起来很强,结果之后根本没人用。”
@crawler_gill 是个难得的正面例外(12 个赞、290 次浏览):“用 DataForSEO API + Google Antigravity 搭了一个迷你版 Ahrefs 风格仪表板——很难想象,一年前我连这件事都不敢想。不用写代码,但仍然能做出我真正需要的工具。”

讨论洞察: Antigravity 教学内容的密度之高(单个创作者一天发 6 条以上课程相关帖子),更像是一种 SEO 驱动的内容策略,而非自然涌现的从业者热情。真正的编程社区仍持怀疑态度:可获得教程与真实采用之间的鸿沟正在扩大。
与前一天对比: 4 月 23 日,Antigravity 的话题还是被植入木马的下载包,以及“你们还记得吗”式的怀旧帖。今天的叙事与之相近:海量教学内容与平淡的从业者采用并存。Crawler_gill 的 SEO 仪表板,是唯一一个新的 Antigravity 实操项目。
1.7 Copilot SDK v0.3.0 与 JetBrains Agent Mode 发布 🡕
@GHCopilotCLILog 宣布(24 个赞、1,231 次浏览)介绍了带来 40 项功能与增强的 Copilot SDK v0.3.0。关键能力包括:支持按会话进行 GitHub 身份验证,使不同会话可携带不同身份;通过 defaultAgent.excludedTools 实现按智能体控制工具可见性,从而支持带子智能体委派的编排模式;自定义智能体可通过声明 skills: string[] 注入特定技能;以及在消息增量事件中通过 agentId 标识子智能体流,以便进行更细粒度的 UI 过滤。会话默认不再在 30 分钟后超时,技能也改为严格的选择加入机制,以防止从父智能体意外继承。
@GHchangelog 已发布(12 个赞、1,235 次浏览)介绍了 JetBrains 面向公众预览的内联智能体模式,配合增强版 Next Edit Suggestions,以及“针对终端命令和文件编辑新增的全局与细粒度自动批准控制”。
讨论洞察: 这次 SDK 发布表明,Copilot 正在把自己的智能体平台推向接近最终 GA 的状态。按会话身份和子智能体委派等功能,使其具备了多智能体编排模式所需的能力,也与从业者社区里正在浮现的对抗式工作流形成呼应。
与前一天对比: 4 月 23 日,Copilot 的叙事还集中在暂停注册和转向基于 token 的计费。今天,平台基础设施本身在推进:SDK v0.3.0 和 JetBrains agent mode 表明,GitHub 一边限制新客户接入,一边继续建设智能体平台层。
2. 什么让人感到沮丧
各家平台的 Vibe coding 速率限制——高
@notjazii 触及每周上限(134 个赞、90 条回复)来自一位在 Antigravity 里做游戏 vibe coding 36 小时后就耗尽额度的用户,尽管他开通了 Google Pro。截图显示,Gemini 3.1 Pro、Claude Sonnet 4.6 和 Opus 4.6 的刷新计时器都要等 5–6 天。@vaultmkr 直言 Antigravity 做 vibe coding 的限制“很垃圾”。@MilkRoadAI 报告称 提到 Anthropic 下调了 Claude 的默认思考模式,并引入峰值时段限额。@nixxin 报告称 则表示:“我在 Codex 和 Claude Code 上都反复撞到速率限制。”这已经不再是某一家平台的问题;每个主要平台都在明显地配给算力。
GPT-5.5 的 token 倍率让 Copilot 变贵——中
@dbdnvikas objected 对 Copilot 中 GPT-5.5 的 7.5 倍倍率表示不满:“Opus 和 5.5 都是 7.5 倍?算了,我直接用 codex。”@alex_smmr 说:“7.5 倍就是个笑话。”@aias_0 警告:“版本升级解决不了上下文限制。先观察大仓库里的自动补全延迟。”这个倍率制造了明显的价格差:通过 Copilot 使用 GPT-5.5 会很快烧光月度 token 预算,而通过 20 美元/月的 Codex 套餐使用同一模型,限制则更宽松。
Codex CLI 会误标记安全研究人员——中
@offsec97 展示了(0 个赞、16 次浏览)展示了一张 Codex CLI 截图:“你的账户因可能存在高风险网络活动而被标记。在执行额外验证期间,请求速度可能会变慢。”这发生在一个已验证账户进行合法安全评估工作期间,说明安全过滤器仍需更精细,才能区分进攻性安全研究与恶意使用。

DeepSeek 的数据隐私担忧被斥为协同攻击——低
@KuittinenPetri 提出反驳(38 个赞、696 次浏览)为 DeepSeek 反驳批评:“今天 X 上对 DeepSeek 的仇视多得惊人。这是有组织、拿了钱的吗?你们觉得 Anthropic 会怎么处理 Claude Code 里的提示词和代码轨迹?Google 对 Antigravity 呢?OpenAI 对 Codex 呢?当然,我们也可以假装它们完全不会拿这些数据来训练。”
3. 大家希望出现什么
一个模型无关、额度充足的 20 美元套餐
@Bhavani_00007 的 讨论串(41 条回复)显示,用户根本无法判断哪一个 20 美元订阅最值。每种工具各擅胜场,限流方式也不同。市场真正需要的是一个统一订阅层:针对不同任务类型提供最合适的模型,并给出透明、可预测的速率限制,而不是逼用户去押注某一家提供商。
紧迫性:高。机会:[+++] —— 41 条回复仍无共识,说明市场存在结构性空缺。
OpenCode Go 在新模型发布当天就能支持
在 DeepSeek V4 公告下,@Shawnw3i、@noctus91 和 @alomorfYT 的回复都要求 OpenCode Go 支持,而不是只给 BYOK。用户希望新模型能第一时间进入托管订阅层,而不只是通过 API 密钥自行配置。
紧迫性:中。机会:[++] —— 多次模型发布中都出现了持续一致的需求。
具备安全上下文感知能力的编程智能体模式
@offsec97 的 标记 发生在合法安全评估期间,再加上 @0xSV1 的 Damn Vulnerable Startup 项目(一个故意带漏洞、讽刺 vibe coding 安全实践的应用),都指向同一个需求:需要具备安全上下文感知能力的智能体模式,既能区分进攻性研究与恶意用途,也能在 vibe coding 应用部署前标出安全问题。
紧迫性:中。机会:[++] —— 随着 vibe coding 扩散到缺乏安全意识的用户群体,这一需求正在上升。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| OpenAI Codex + GPT-5.5 | 智能体平台 | (+) | 上线次日即迎来采用潮;mckaywrigley 的编程首选;据 JakeKAllDay 称,比 GPT-5.4 Mini High 便宜 7.5 倍;浏览器自主 QA 已上线 | Copilot 中的 7.5 倍倍率会迅速烧光 token 预算;Codex CLI 会误标记安全研究人员 |
| GitHub Copilot | 云端 IDE 智能体 | (+/-) | 已支持 GPT-5.5;SDK v0.3.0 带来 40 项功能;JetBrains 内联智能体模式进入预览 | 前沿模型的 7.5 倍倍率偏高;向基于 token 的计费过渡仍在进行中 |
| Claude Code | 终端智能体 | (+/-) | 0xSero 称赞新版桌面 UI;mckaywrigley 给 Claude Design 打出 A+;更新后的应用被评价为“很棒” | 算力限流;峰值时段限额;用户正在取消 Pro 订阅 |
| OpenCode | 开源终端智能体 | (+) | 已加入 DeepSeek V4 Pro;成为新模型默认测试载体;Honcho 长期记忆插件已发布 | 新模型可用性上,OpenCode Go 落后于 BYOK |
| Google Antigravity | IDE | (-) | crawler_gill 做出了可用的 SEO 仪表板;教学内容非常丰富 | 速率限制刷新要等数天;mckaywrigley:“根本没人用它”;Fabiobuilds:“真的有人在 Antigravity 上写代码吗?” |
| Cursor | IDE 智能体 | (+/-) | molaerga:“20 美元套餐每天都在做项目,从没碰到上限” | mckaywrigley 已卸载;排在 Codex 和 Claude Code 之后,属第二梯队;xAI 收购后的不确定性仍在 |
| EXO | 本地推理 | (+) | 通过 MLX RDMA,在 M3 Ultra 上可让 Kimi K2.6 跑到 20 tps、Qwen3.6-27B 跑到 30 tps | 需要高端硬件(展示配置为双 M3 Ultra 512GB) |
| Copilot SDK v0.3.0 | 智能体框架 | (+) | 支持按会话身份验证、按智能体控制工具可见性、子智能体流式传输、技能选择加入 | 已接近最终 GA 状态;生态仍在成熟中 |
4 月 24 日的工具格局大致分成三层:Codex 和 Claude Code 是占主导地位的智能体平台,其中 Codex 正在上升;OpenCode 是开源、模型无关的中立层;其余工具则都在争夺相关性。Cursor 失去了最有力的支持者之一(mckaywrigley 已卸载它),而 Antigravity 的速率限制也削弱了其教学内容攻势。
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Honcho x OpenCode Plugin | @honchodotdev | 为 OpenCode 会话提供长期记忆 | 智能体跨会话会丢失上下文;缺少持久化记忆层 | OpenCode、Honcho、Bun | 已发布 | 公告 |
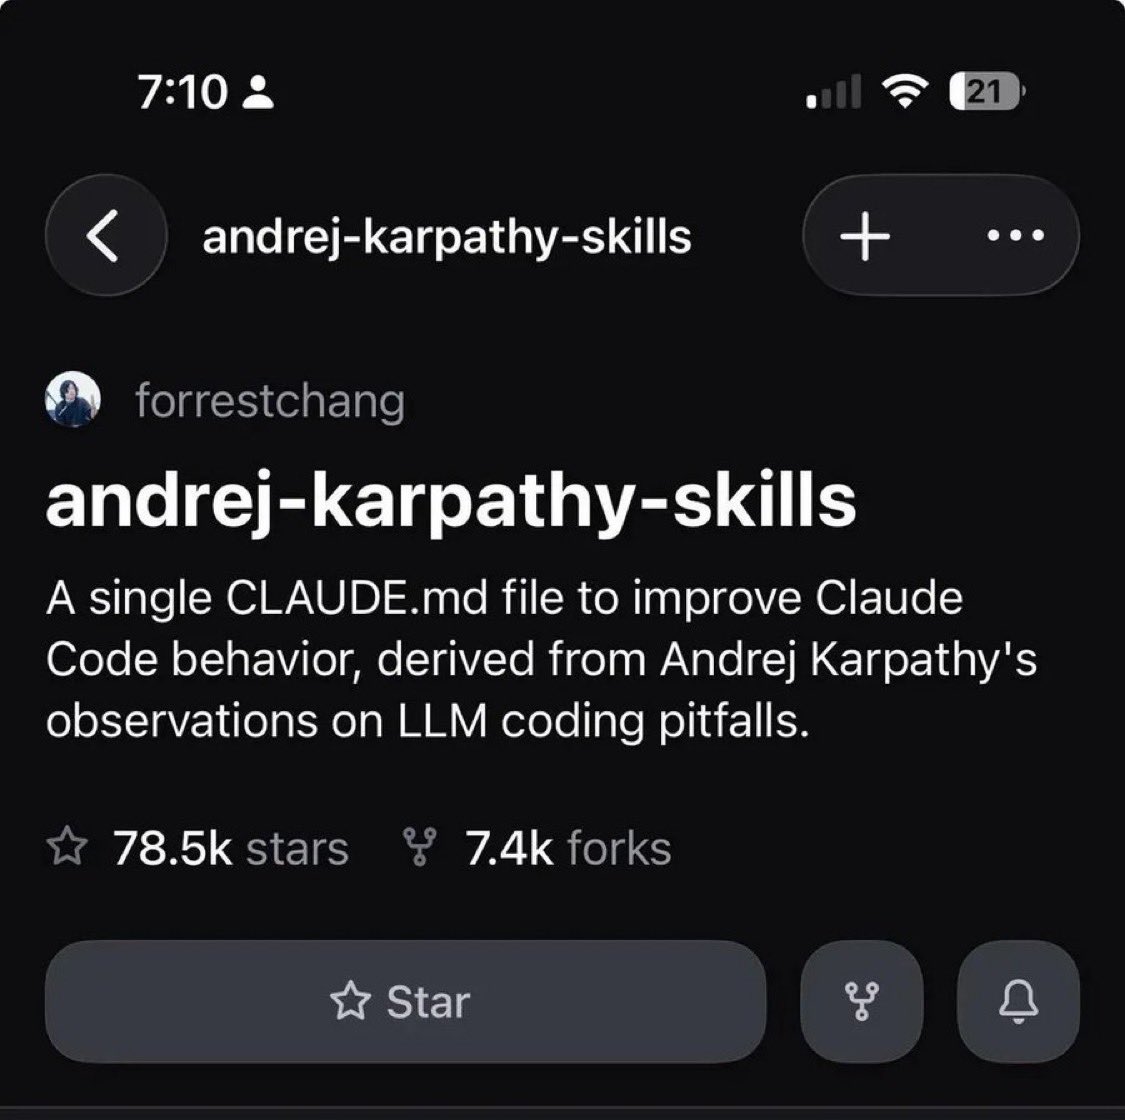
| andrej-karpathy-skills | forrestchang(GitHub) | 用单个 CLAUDE.md 根据 Karpathy 的编程观察改进 Claude Code 行为 | 没有指导时,LLM 会犯一些可预测的编程错误 | Claude Code、CLAUDE.md | 已发布(78.5k stars) | 推文 |
| Codex Browser Use | @JamesZmSun(OpenAI) | 在 Codex 中提供原生浏览器,用于自主前端 QA——构建 UI、点击操作、监控日志并修复 bug | 前端开发中的“构建并验证”闭环此前是断裂的 | Codex、Vision、Browser | 已发布 | 总结 |
| Damn Vulnerable Startup(DVS) | @0xSV1 | 一个受 vibe coding 文化启发、用于安全教育的故意脆弱应用 | 缺少用于保护 AI 生成应用的训练场 | Claude Code | Alpha | 帖子 |
| Adversarial Review Pipeline | @0xLatencyZero | Claude Code 负责起草,Codex 负责审查 diff,寻找逻辑漏洞和安全偏移 | 单模型审查会因共享训练偏差而漏掉 bug | Claude Code(Opus 4.7)、Codex(GPT-5.5) | 概念/演示 | 帖子 |
| SEO Dashboard | @crawler_gill | 使用 DataForSEO API 构建的迷你 Ahrefs 风格仪表板 | 非程序员无法自行构建定制化 SEO 分析工具 | Google Antigravity、DataForSEO API | 可运行原型 | 帖子 |
| DP Code v0.0.36 | @emanueledpt | 一款支持 GPT-5.5、以 OpenCode 为 provider、具备快速模型搜索、编辑消息和 LaTeX 渲染功能的 IDE | IDE 之间的模型接入过于碎片化 | OpenCode、GPT-5.5 | 已发布 | 帖子 |
| Polymarket Trading Bot | 上海交通大学学生,经由 @adiix_official | 自动套利机器人,追踪 50 多个 Polymarket 市场并与 Binance BTC 数据同步 | 手动跨市场套利速度太慢 | Claude Code、OpenClaw、Polymarket、Binance | 已在生产环境运行 | 帖子 |
| lambench-pro | @BitcoinBananaBY | 使用 Effect TS、opencode-swarm 和 GitHub Actions 的基准测试运行器 | 缺少针对编程模型的标准化实时基准 | Effect TS、OpenCode Swarm、GitHub Actions | Alpha | 帖子 |
andrej-karpathy-skills 仓库达到 78.5k stars 值得关注:一个源自 Andrej Karpathy 对 LLM 编程陷阱观察的单一 CLAUDE.md 文件,已经成为智能体编程领域获星最多的提示工程成果。@cgtwts 指出:“有人把 Andrej Karpathy 的编程洞察整理成一个 claude.md 文件,用来修正 claude 写代码的方式,现在已经有 78k stars 了。”
Codex 的浏览器使用功能代表了一项重要能力增强:@WesRoth 描述了 解释了 Codex“现在可以自主构建前端界面,然后像真人 QA 测试员一样行动。它会利用视觉能力真正‘看见’UI,像真实用户一样点击应用,并同时监控网络和控制台日志中的错误。”
6. 新动态与值得关注的变化
在野外发现 GPT-Codex-5.5 模型标识符
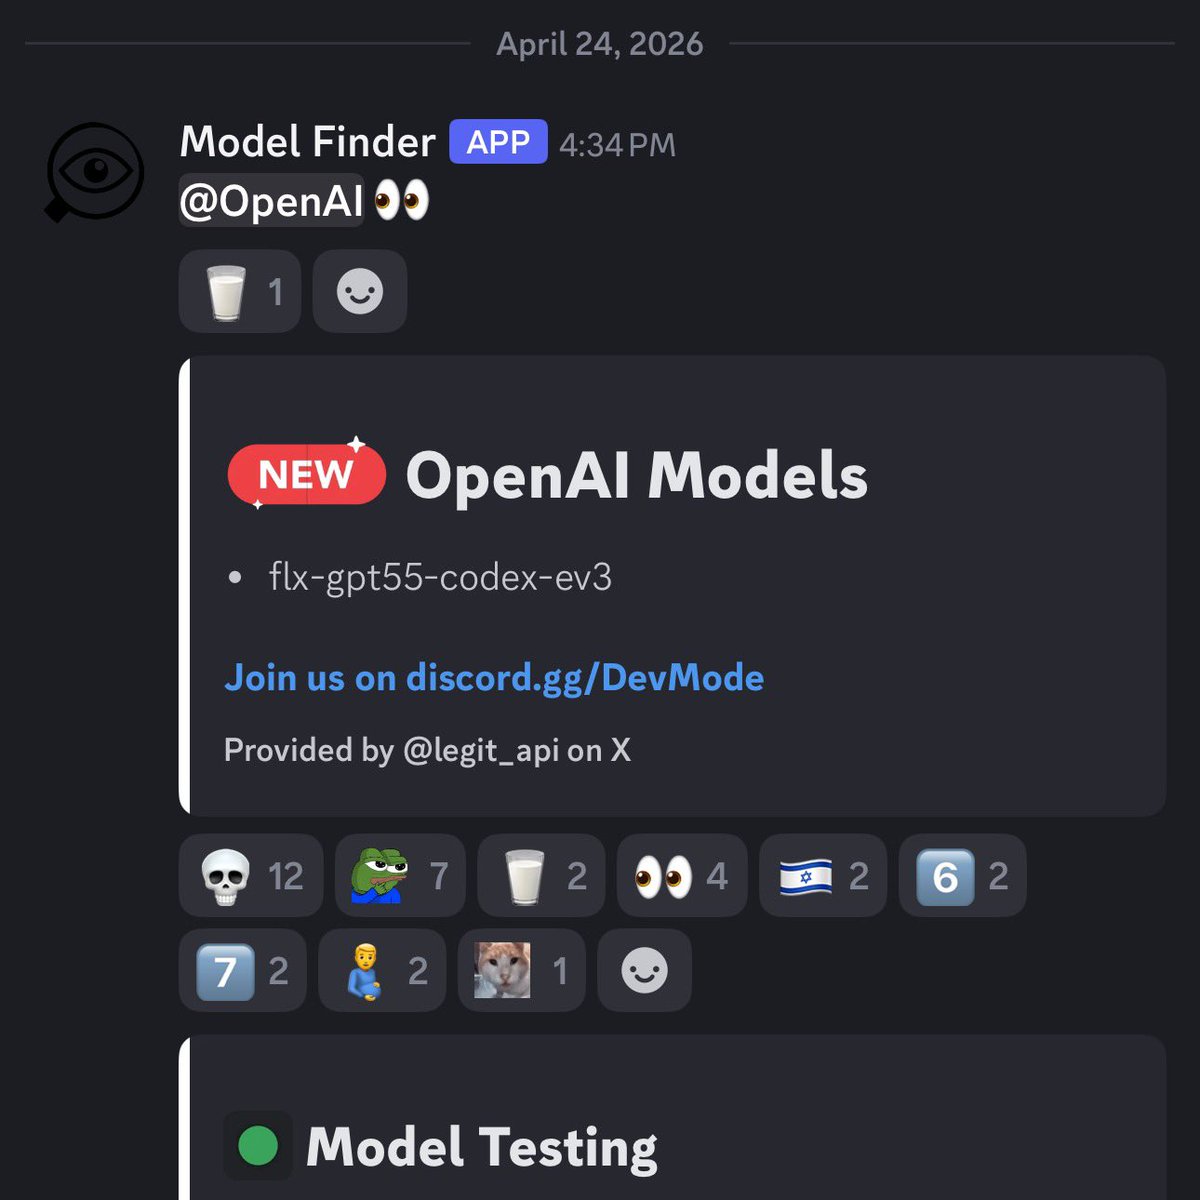
@testingcatalog 标记了(20 个赞、289 次浏览、2 条引用)提到,一个 Discord 模型发现机器人在 4 月 24 日检测到了新的模型标识符“flx-gpt55-codex-ev3”。这暗示 OpenAI 可能正在测试一个 Codex 专用的 GPT-5.5 变体,或许相较通用版 GPT-5.5,对智能体式编程任务做了进一步优化。
垂直 AI 整合正在加速
@kilocode 观察到(13 个赞、576 次浏览):“OpenAI 有 Codex。Anthropic 有 Claude Code。Google 有 Gemini Code Assist。现在 SpaceX 有 Cursor 和 xAI。当 AI 实验室试图把编程工具也掌握在自己手里时,允许你自由选择模型的独立层就越来越小了。”这种垂直整合趋势,使模型无关层(如 OpenCode、Kilo Code)在战略上更重要,但处境也更脆弱。
AI 可靠性故障开始接近周更节奏
@NeuronicxAI 记录了(1 个赞、6 次浏览)总结了 2026 年 4 月的故障模式:“4 月 15 日——Anthropic:API + Code 宕机 7 小时。4 月 20 日——OpenAI:ChatGPT + Codex 故障,3K+ 报告。4 月 24 日——Anthropic 再次出问题。”主要提供商近乎每周一次的大规模故障,进一步强化了市场对多提供商韧性的需求。
Copilot 数据训练截止日已到
@jordanicruz 指出 提醒,4 月 24 日起,除非用户主动选择退出,否则 GitHub 将开始使用 Copilot 交互数据训练 AI 模型。昨天的报告还把这件事列为即将发生,今天它已经正式生效。
Anthropic 产品团队的推进速度受到关注
@hrishikeshhh_ 分享了(2 个赞、11 次浏览)转述了 Anthropic Claude Code 产品负责人分享的观点:“产品周期从 6 个月缩短到 1 个月,有时甚至缩短到 1 天。不每周发布,就会被甩在后面。anthropic 招的是有产品品味的工程师,而不是纯粹的专才。”
7. 机会在哪里
[+++] Unified Model Routing at the $20 Price Point -- 41 replies on @Bhavani_00007 的 讨论串 并未就“20 美元该选哪款工具”形成任何共识。@mckaywrigley 描述了 显示,不同工具在不同任务上各有胜负。@Kappaemme1926 取消了 Claude 则为 Codex 背书。一个能以统一价格在多家提供商之间路由任务、自动选择最具性价比模型的服务——例如复杂重构用 GPT-5.5、脚手架搭建用开源模型、设计工作用 Claude——将直接回应这份数据集中最常见的问题。
[+++] Multi-Provider Resilience and Failover -- @NeuronicxAI 记录了 指出了各家提供商近乎每周一次的故障。@notjazii 触及上限 还显示多个 Antigravity 模型会同时触发限流。@MilkRoadAI 确认 则指出,即使合计 7000 亿美元的超大规模云资本开支也仍不足够。在故障和速率限制发生时,若能在提供商之间自动故障切换并保留会话上下文,就能解决所有用户群体共同面临的基础设施痛点。
[++] Adversarial Multi-Model Code Review -- @0xLatencyZero 演示了 展示了 Claude 起草、Codex 审查的流水线。@satyanadella 描述了 则提到了用于多模型反思的 Rubber Duck agent。@mr_the_dooom 报告称 还形容 Claude 当架构师、Codex 当写码者时能带来“惊人的产出,同时 token 用量很低”。如果能把这种跨实验室对抗式审查做成一键配置,而不是手动拼接流程,就能把一项新兴最佳实践正式产品化。
[++] Agent Memory and Context Persistence -- @honchodotdev 已发布(22 个赞、7 个收藏)介绍了 OpenCode 的长期记忆。Copilot SDK v0.3.0 也加入了可配置的会话空闲超时设置(此前固定为 30 分钟)。随着智能体会话延长到数小时的自主运行,跨会话、跨工具的持久化记忆会从“锦上添花”变成基础设施。
[+] Vibe Coding Security Education -- @0xSV1 构建了 提到了 Damn Vulnerable Startup——一个讽刺 vibe coding 的故意不安全应用:“100% AI-generated. 0% security review. Infinite deploys.”随着非技术用户开始通过 vibe coding 交付代码,专门面向 AI 生成代码库的安全培训与自动扫描工具,将成为日益增长的需求。
8. 要点
-
GPT-5.5 的采用正在带来真实的订阅迁移,而不只是基准测试热度。 @mckaywrigley 报告称 在不到三个月内从 80/20 的 Claude/GPT 变成了 80/20 的 GPT/Claude。@Kappaemme1926 贴出了 Claude 取消订阅邮件。@Colewherld 称 Codex 为 则称其“比 Claude Code 强了几个光年”。上线次日释放出的信号,是迁移,而不是继续观望。
-
速率限制已成为所有提供商共同面对的核心用户体验问题。 @notjazii 迅速耗尽了 在 36 小时内就耗尽了 Antigravity 配额(90 条回复,为数据集最高)。@MilkRoadAI 报告称 还提到 Anthropic 下调 Claude 的思考深度。2026 年超大规模云厂商合计 7000 亿美元的资本开支,依旧无法满足需求。算力短缺是结构性的,不是暂时性的。
-
OpenCode 已成为评估新模型的中立地带。 @rileybrown 提问 向 4,998 人提出了“测试新版 Deepseek 模型的最佳方式是什么?”而答案是 OpenCode。@mehulmpt 用了它 则用它做了一次四模型对比。@opencode 集成了 又在 DeepSeek V4 发布几小时内就完成了接入。随着各实验室持续垂直整合(Codex、Claude Code、Gemini Code Assist、Cursor/xAI),模型无关层会变得愈发关键。
-
对抗式多模型工作流正在演变为生产实践。 @0xLatencyZero 发布了 展示了 Claude 起草、Codex 审查的流水线。@satyanadella 描述了 则把多模型反思描述为平台功能。核心洞见在于:不同实验室的模型有互补盲点,因此跨实验室审查比单模型工作流更能抓出 bug。
-
20 美元 AI 编程工具市场没有明确赢家,用户困惑却达到最高点。 @Bhavani_00007 的 问题 收到 41 条回复,仍没有形成共识。Codex、Cursor 和 Claude Code 在不同使用场景中各有支持者。这种入门价位的碎片化,为聚合或路由型解决方案创造了空间。
-
Copilot 智能体平台的成熟速度,快于生态系统对它的关注。 SDK v0.3.0 带来了 40 项功能,包括按会话身份验证、子智能体委派和技能选择加入(@GHCopilotCLILog、发布)。JetBrains 内联智能体模式也进入了公开预览(@GHchangelog、公告)。当大多数注意力还停留在模型对比上时,多智能体编排所需的基础设施已经在持续落地。