Twitter AI 编程 - 2026-06-01
1. 人们在讨论什么
1.1 价格冲击取代了抽象的计费争论 🡕
6 月 1 日,按使用量计费从预期变成了可见的现实证据。最受关注的帖子不再是价格机制解读,而是真实额度消耗、套餐取消和重置界面的截图;这让支出不再像未来可能出现的政策变化,而更像从第一天起就必须面对的运营约束。共有四条保留内容支撑这一主题。
@edzitron 模拟了(124 次点赞,10 条回复,3,598 次浏览)通过分享四条 Reddit 投诉,谈到 GitHub Copilot 的 rollout:一位用户仅用一个提示词就烧掉了月度预算的 50%,另一位在第一天就用了 25%,第三位在一个持续 20-30 分钟的编排任务中消耗了 16%,第四位则因预估每月约需 $600 而取消了 Copilot Max。

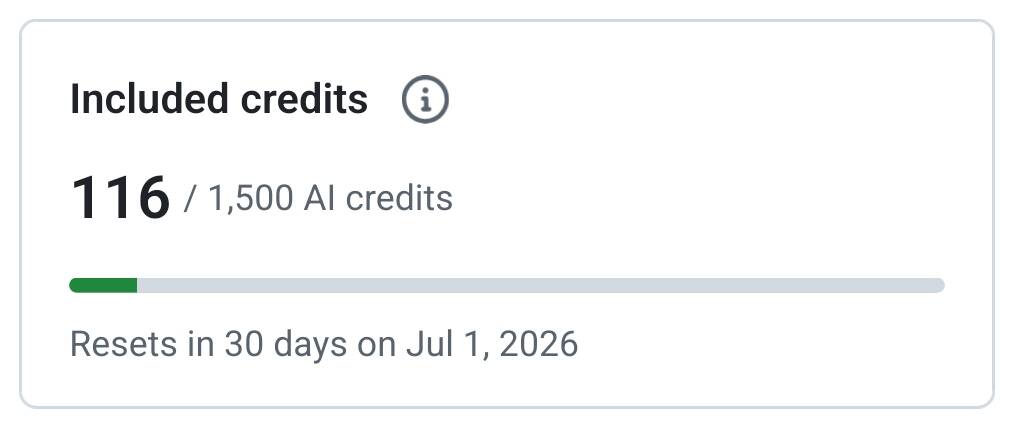
@nihui 报道称(19 次点赞,4 条回复,2,888 次浏览)称,一次 GitHub Copilot PR 审查就消耗了每月 1,500 积分中的 116 分,并认为这项新配额甚至不足以支持一位 OSS 维护者完成 13 次类似审查。
@TimJayas 显示(23 次点赞,11 条回复,1,068 次浏览)展示了一张 Codex /status 界面截图,其中每月可用余量已归零,并将这一变化描述为:即便免费账户也不再按周重置。回复区随即演变成一条迁移讨论串,有用户表示,随着 Codex 限额趋紧,Claude 现在看起来更合适了。

讨论洞察: 回复区讨论的不是 AI 编程有没有用,而是哪款工具的消耗率仍在可接受范围内;Cursor、Claude 和本地模型都开始作为备选方案出现。
与前一天对比: 5 月 22 日至 31 日的讨论已经出现了倍率预警和按使用量计费的解读;而 6 月 1 日新增的是第一天就看到额度在真实工作流中迅速消失的截图,让价格问题变得具体得多。
1.2 廉价挑战者抢下了基准测试关注度,但用户依然更相信生产环境测试 🡕
6 月 1 日的竞争讨论表明,低价模型只有在真实代码里经得起检验时,才会赢得认可。当天最强的基准测试帖和最有力的纠偏帖都来自同一个账号,这让分歧格外有参考价值。共有三条保留内容支撑这一主题。
@bridgemindai 认为(116 次点赞,10 条回复,5,187 次浏览,16 次收藏)称,MiniMax M3 凭借 59.0 的 SWE-Bench Pro 分数已经让人无法忽视,略高于 GPT-5.5 的 58.6,同时每 token 成本低得多。帖文也明确提醒,SWE-Bench Pro 存在污染问题,因此即便是为该基准结果背书的人,也只是将其视为趋势性信号,而非定论。
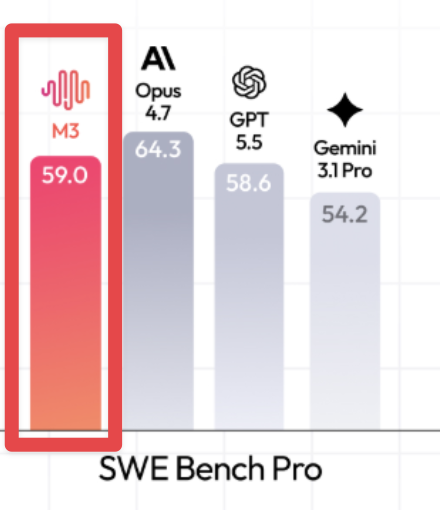
@bridgemindai 进一步跟进(56 次点赞,11 条回复,5,177 次浏览)随后在 OpenCode 中做了真实代码测试,并表示 MiniMax M3 弄坏了按键通话功能、导致游戏逻辑异常,也难以干净地渲染视频。这让原本“廉价前沿替代品”的判断,变成了“当预算是首要约束时它有价值,但并不意味着它天然适合生产工作”。
@Yuchenj_UW 将其描述为(100 次点赞,28 条回复,5,020 次浏览)将市场形容为一个“三体问题”:Anthropic 领先,Codex 正在追赶,而 Gemini 仍很可能缩小差距。回复则进一步收紧了这一判断,指出 Gemini 在工具调用上的弱点,并提出 xAI 加 Cursor 也可能是另一组强势组合。
讨论洞察: 人们已经不再追问“哪一个是最好的编程模型”,而是在问:哪些模型值得分配给昂贵任务,哪些足以胜任低成本任务,以及哪些基准测试结论经得起真实仓库检验。
与前一天对比: 5 月下旬的讨论已经把 Codex、Claude、OpenCode 和 Gemini/Antigravity 视为可灵活切换的选择;6 月 1 日则把这种路由逻辑说得更直白:把基准结果、成本和现实故障报告放在了一起看。
1.3 发布热度集中在控制平面、集成和垂直工作流套件上 🡕
最值得注意的发布并不是底层模型本身,而是封装层、集成层和领域套件:它们把现有模型放进了更清晰的操作界面。共有六条保留内容支撑这一主题。
@antigravity 宣布(1,003 次点赞,54 条回复,49,314 次浏览,308 次收藏)称,Google Antigravity 正在变成一个科学工作台,并推出了新的 Science Skills 仓库,可将代理连接到科学数据库和工作流,如 AlphaFold、OpenAlex、ClinVar 和 NCBI 资源。这与 5 月下旬的 Antigravity 教程所传达的产品主张不同:这次是一个附带公开代码的垂直工作流套件,而不只是通用的多代理 CLI。
@reach_vb 解释了(32 次点赞,5 条回复,1,146 次浏览)称,Codex 现在通过 model_provider = "amazon-bedrock" 支持 Amazon Bedrock,使本地 CLI、桌面端和 IDE 工作流可以借助 AWS 原生认证和 IAM 运行 OpenAI 模型。回复区一部分人认为 IAM 是那个“低调但关键”的解锁点,另一部分人则认为它是额外负担,这使治理能力本身也成了产品故事的一部分。
@emanueledpt 推出了(38 次点赞,12 条回复,1,101 次浏览)介绍了 Synara,这是一款图形界面,承诺可在同一工作区内运行 Codex、OpenCode 和 Cursor 等订阅服务,并提供聊天、项目、终端面板、git 和工作树。当天公开可见的证据主要是 UI 截图,而不是可验证的仓库,但这次发布依然符合“多个代理之上的控制平面”这一模式。

@WesRoth 流传开来(28 次点赞,6 条回复,1,503 次浏览)报道 Microsoft 正在打造一款 Copilot“超级应用”,把 GitHub Copilot、Copilot Chat、Copilot Cowork、Microsoft 365 Copilot 账户,以及一个名为 Autopilot 的内部代理式工作流层整合在一起;与此同时,@orinthomas 分享了(2 次点赞,379 次浏览,4 次收藏)介绍了公开的 Build CLI 仓库——一个 GitHub Copilot CLI 插件,可在终端中浏览 Build 会话目录。@pierceboggan 还重点提到了(12 次点赞,2 条回复,1,376 次浏览)则安排了面向 issue 分流的定时 Copilot-app 自动化,这进一步把 Copilot 推向周期性的代理工作,而不只是一次性的聊天。
讨论洞察: 发布日最强的差异化来自打包方式和集成能力:领域连接器、IAM/治理、订阅统一和定时自动化,而不是又一份通用模型排行榜。
与前一天对比: 5 月下旬的讨论已经偏向 Mission Control 和安全 MCP 工具这类仪表盘、隧道和适配层;6 月 1 日则延续了这一趋势,出现了更多面向企业和特定领域的操作界面。
2. 什么让人沮丧
额度消耗如今已是执行约束,不再只是定价脚注
严重程度:高。@edzitron 汇总了(124 次点赞,10 条回复,3,598 次浏览)展示了用户在一次任务或一天内烧掉 Copilot 月度预算 16-50% 的截图;@nihui 显示(19 次点赞,4 条回复,2,888 次浏览)称一次 PR 审查就消耗了 1,500 积分中的 116 分;@TimJayas 发布了(23 次点赞,11 条回复,1,068 次浏览)则展示了一个 Codex 状态界面,显示每月可用余量为 0%。公开讨论中的应对策略来得很快:迁移到消耗更低的工具、节省高端模型用量,或在常规工作中回退到本地模型。这已成为直接影响操作的痛点,因为它改变了人们愿不愿意把哪些任务交给代理去做。
基准测试赢了,依然不代表在仓库里就安全可用
严重程度:高。@bridgemindai 推广了(116 次点赞,10 条回复,5,187 次浏览,16 次收藏)把 MiniMax M3 描述为一款低成本模型,在 SWE-Bench Pro 上险胜 GPT-5.5;但随后 报道称(56 次点赞,11 条回复,5,177 次浏览)又指出,同一模型在真实项目中弄坏了按键通话功能、导致游戏逻辑异常,视频输出也依然粗糙。@xdadevelopers 分享了(18 次点赞,2,603 次浏览)引用的那篇 XDA 对比,也得出了同样务实的结论:基准测试标题和精美演示,并不能替代在真实仓库中做一次实际验证,然后再决定是否信任其输出。
多代理工作流仍缺少共享上下文与协作能力
严重程度:中。@TaylorPearsonMe 表示(2 次点赞,2 条回复,626 次浏览)称,他认识的每个人都在尝试把 Claude Code 和 Codex 接入团队协作工具,这看起来越来越像是在重造 Google Docs。当天的发布——Synara 的统一工作区、Microsoft 传闻中的 Copilot 超级应用,以及 Copilot app 自动化——都像是在试图补上同一个缺口,但从公开讨论中仍能明显看出这一需求尚未满足。让人沮丧的不只是模型质量,还有缺乏清晰可见的共享状态、交接机制与协同能力。
3. 人们希望存在什么
任务执行前的成本预测与自动模型路由
人们希望在按下 Enter 之前就知道一个任务要花多少钱。当天最有影响力的价格相关帖子,全部都是事后总结:额度烧光、套餐取消、月度限额归零。这说明市场上缺的是一种产品:既能预览预算,又有一层路由机制,把简单任务分配给更便宜的模型,把高端额度留给真正需要它的任务。这个需求务实而紧迫,不是空想。机会:直接。
面向团队的共享上下文,而不只是更强的单人代理
@TaylorPearsonMe 表示(2 次点赞,2 条回复,626 次浏览)称,当前的状态像是在围绕 Claude Code 和 Codex 重造 Google Docs;与此同时,Synara 和 Microsoft 的 Copilot 产品界面正试图统一线程、项目、自动化和交接。这指向一种非常实际的工作流需求:共享状态、可持续上下文,以及对团队友好的代理协作。机会:直接。
面向 AI 生成代码与代理的结构化验证
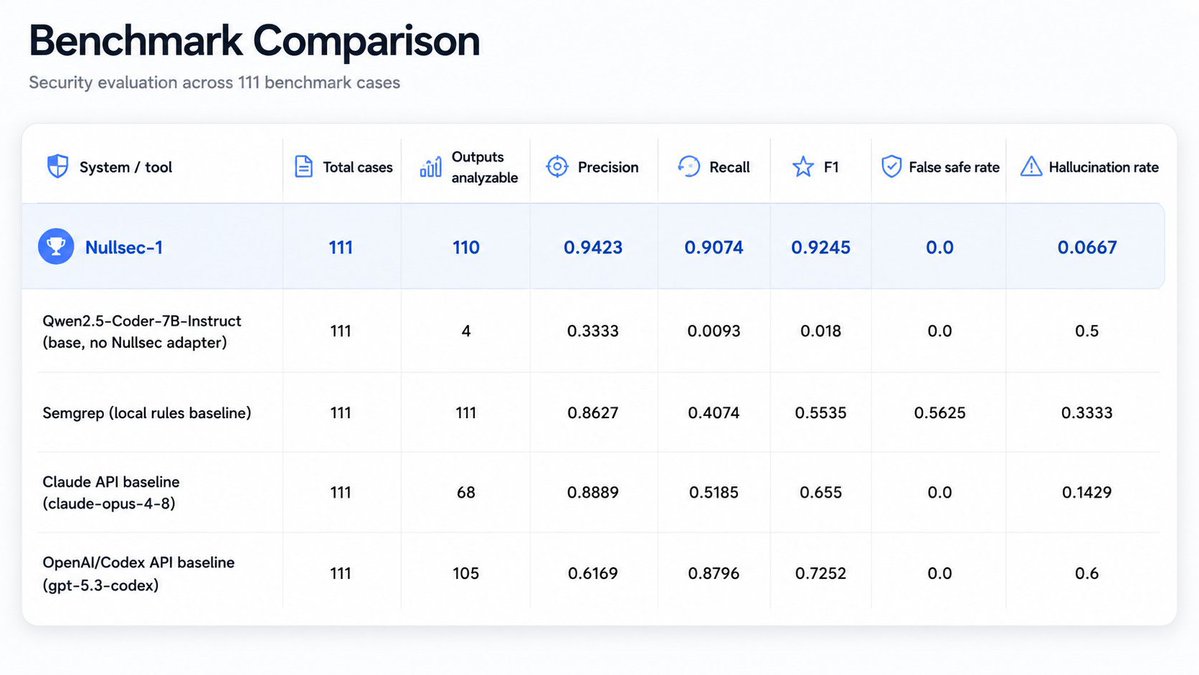
@trynullsec 推出了(41 次点赞,19 条回复,1,423 次浏览)介绍了 Nullsec S1,这是一种能返回结构化安全裁决的模型;而基准对比的后续讨论也清楚说明了它为何重要:人们希望输出结果能被扫描器、CI 流水线、PR 守卫和代理审查系统自动消费。这看起来是一个面向正在交付 AI 生成代码团队的现实需求,而不是可有可无的附加项。机会:竞争型。
把代理接入真实领域数据的垂直套件
Science Skills、CVForge、MM-Agent,甚至 MapleStory 的 MSU Space,都不是让用户从空白提示词开始,而是围绕某个领域数据集、专用工作流或品牌化资产池来打包 AI 编程能力。这说明,市场正在涌现对“带有明确立场的代理层”的需求:它们需要预先接好科学数据、金融数据、数学建模 schema,或游戏/IP 资产。机会:新兴。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot | 编程助手 / 平台 | (+/-) | 覆盖面广,横跨 PR 审查、应用自动化、CLI 插件和企业规划 | 第一天就出现的额度消耗让日常使用显得昂贵且难以预测 |
| OpenAI Codex | 编程代理 | (+/-) | 竞争力足以继续留在顶级讨论中,如今还能通过 Bedrock 路由 | 对月度重置的抱怨和更紧的使用余量让用户对价格更加敏感 |
| Claude Code | 编程代理 | (+) | 上下文处理能力强,在 XDA 网站对比中给出了最佳定性结果 | 团队仍需要围绕它构建协作层和共享状态工具 |
| Google Antigravity | 多代理 CLI / 工作流引擎 | (+/-) | 原型开发快,支持后台/子代理编排,如今又有面向领域工作流的 Science Skills | 公开讨论仍把真实发布与偏炒作式教程内容混在一起 |
| MiniMax M3 | LLM | (+/-) | 成本极低,且在基准测试上获得了强曝光 | 当天的真实世界测试对其在生产代码上的可靠性提出质疑 |
| Amazon Bedrock | 云模型提供商 | (+) | 提供 AWS 原生认证、账户控制和面向 OpenAI 模型工作流的治理能力 | 一些开发者仍认为 IAM 会给日常开发流程增加摩擦 |
| Nullsec S1 | 安全审计器 | (+) | 输出结构化 JSON 裁决,聚焦 AI 生成应用的安全,并提供公开材料 | 基准证据由作者自行给出,仍需外部验证 |
| Build CLI | Copilot CLI 插件 | (+) | 将 Build 会话目录拉入终端,并读取本地依赖来辅助发现内容 | 适用范围局限于 Microsoft 活动相关工作流,且需要实时网络访问 |
| Synara | 统一代理工作区 | (+/-) | 在一个 UI 中整合聊天、项目、终端、git 和多个编程订阅服务 | 当天无法验证其公开仓库,因此证据仍偏早期 |
| CVForge | 垂直应用构建器 | (+) | 利用 Claude Code 或 Codex,把自然语言提示转成实时期权分析仪表盘 | 闭源、聚焦金融领域,且依赖 BYOK |
整体情绪更偏务实,而非品牌忠诚。@xdadevelopers 分享了(18 次点赞,2,603 次浏览)是一篇动手对比,认为 Claude Code 在判断力上更优,而 Antigravity 在速度上更强;@bridgemindai 报道称(56 次点赞,11 条回复,5,177 次浏览)则表示,MiniMax M3 只有在预算比正确性更重要时才值得考虑。@reach_vb 解释了(32 次点赞,5 条回复,1,146 次浏览)把 Bedrock 支持视为一种方式,让 OpenAI 工作流继续停留在 AWS 原生认证和计费体系内。常见的变通办法包括模型路由、把工作分散到多个执行框架,以及优先使用领域封装层而不是裸聊天。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Science Skills | @antigravity / Google DeepMind | 为 Antigravity 增加科学研究工作流和数据库连接器 | 通用编程代理通常不自带科学领域工具或数据访问模式 | Antigravity skills、Python 辅助工具,以及 AlphaFold、OpenAlex、ClinVar 和 NCBI 资源等科学 API 与数据库 | 已发布 | 仓库 |
| Nullsec S1 | @trynullsec | 以结构化安全裁决审计 AI 生成的应用、代理和 MCP 工具 | 人工安全审查无法跟上 AI 生成代码的规模 | Qwen2.5-Coder-7B-Instruct 基座、PEFT/QLoRA 适配器、基准测试执行框架 | Beta | 仓库 / HF |
| MM-Agent | HKUST USAIL,由 @DanKornas 分享 | 从题目陈述一路跑通到代码和最终报告的数学建模工作流 | 数学建模工作往往从空白 notebook 和零散工具开始 | GPT-4o 或 DeepSeek-R1、Next.js、FastAPI、SQLite、E2B sandbox、HMML retrieval | Beta | 仓库 / 论文 |
| Build CLI | Microsoft,由 @orinthomas 分享 | 让 GitHub Copilot CLI 可以搜索 Build 会话目录并在终端中记录笔记 | 开发者希望在与代理相同的界面中完成活动/会话发现与规划 | Copilot CLI 插件、实时目录 API、Node.js 22+、Microsoft Learn MCP 回退机制 | 已发布 | 仓库 |
| CVForge | @ConvexValue | 使用 Claude Code 或 Codex,根据自然语言提示生成期权分析仪表盘 | 交易员希望获得定制分析,而不必手写每张图表和每条工作流 | 桌面应用、Claude Code 或 Codex BYOK、美国期权实时数据后端 | Beta | 网站 |
| MSU Space | @MaplestoryU / @Verse_Eight | 一个由提示词驱动的工作区,用于构建基于 MapleStory IP 的游戏 | 粉丝和创作者希望无需传统游戏开发配置也能原型化品牌游戏 | Prompt builder、MCP 连接、IP 模块/资产/框架 | Alpha | 推文 |
@antigravity 宣布(1,003 次点赞,54 条回复,49,314 次浏览,308 次收藏)把 Science Skills 描述为一个有仓库支撑的工作流套件,而不是又一个模型演示,因此它成了“围绕领域数据对代理工具进行垂直化”的最清晰案例之一。@trynullsec 推出了(41 次点赞,19 条回复,1,423 次浏览)则把 Nullsec S1 呈现为一个面向安全的模型,能输出其他系统可直接消费的结构化裁决,而配套的基准卡片也让这一定位变得清晰可见。
@DanKornas 分享了(5 次点赞,1 条回复,414 次浏览,8 次收藏)介绍了 MM-Agent 的开源演示技术栈:Next.js、FastAPI、SQLite 和 E2B;与此同时,@orinthomas 分享了(2 次点赞,379 次浏览,4 次收藏)则将 Build CLI 描述为覆盖在 Build 目录之上的一层轻量插件。@ConvexValue 提供了(3 次点赞,183 次浏览,2 次收藏)把 CVForge 呈现为一个具体的垂直应用,而 @MaplestoryU 预览了(55 次点赞,18 条回复,2,817 次浏览)则将 MSU Space 描述为一个基于 MCP、从提示词到游戏的 MapleStory IP 环境。反复出现的构建模式已经很明确:人们不只是发布助手,而是在围绕某个特定领域、数据集或工作流来打包助手。
6. 新内容与值得关注的内容
Bedrock 上的 Codex 让企业级路由逻辑变得明确
@dkundel 表示(27 次点赞,2 条回复,1,452 次浏览)称 OpenAI API 和 Codex 现已登陆 Amazon Bedrock;@reach_vb 翻译了(32 次点赞,5 条回复,1,146 次浏览)则把这件事具体落实为一套 model_provider = "amazon-bedrock" 配置,可用于本地 CLI、桌面端和 IDE 工作流。公开的 AWS 模型卡 证实了 OpenAI GPT-5.5 和 GPT-5.4 已在 Bedrock 上可用,这也解释了为什么这条消息会对已经身处 AWS 计费和 IAM 控制体系内的团队如此重要。

尽管定价反弹加剧,Copilot 仍在继续扩张为一个平台
@WesRoth 流传开来(28 次点赞,6 条回复,1,503 次浏览)报道了这款“超级应用”;与此同时,@pierceboggan 重点提到了(12 次点赞,2 条回复,1,376 次浏览)介绍了 GitHub Copilot 应用中的定时 issue 分流自动化。这种并置很关键:就在用户抱怨积分的同一天,Microsoft 的 Copilot 界面仍在向自动化、规划和平台整合继续扩展。
面向多个订阅服务的统一工作区成为一个清晰的子类别
@emanueledpt 推出了(38 次点赞,12 条回复,1,101 次浏览)把 Synara 描述为一个可覆盖多个编程订阅服务之上的工作区,而回复区立刻追问,xAI 等其他提供商是否也能接入。即便当天并未出现公开仓库,这个公开 UI 依然把该类别展示得很清楚:构建者希望有一个统一场所来管理线程、diff、终端会话和多个代理后端。
7. 机会在哪里
[+++] 感知支出的路由与配额模拟 —— 当天最强的证据来自额度烧光截图、套餐取消和月度重置抱怨。一个能预测任务成本、按模型层级执行策略,并在运行前提供回退路由的产品,将直接回应第 1 至第 3 节中最清晰的痛点。
[++] 面向代理团队的共享上下文与协作 —— Taylor Pearson 提出的“重造 Google Docs”抱怨、Synara 的统一工作区,以及围绕 Copilot 超级应用的讨论,都指向一个缺失的共享状态层,它需要跨会话、跨仓库、跨工具存在。
[++] AI 原生的安全与验证护栏 —— Nullsec S1 的结构化裁决,以及人们对基准测试标题普遍持怀疑态度,显示出市场需要一种审查系统:在 AI 生成代码发布之前,对其进行评分、解释并加以把关。
[+] 建立在通用助手之上的垂直工作流套件 —— Science Skills、CVForge、MM-Agent 和 MSU Space 表明,下一批有价值的产品,很可能是已经预先接好正确数据、提示词、连接器和护栏的领域专用封装层。
8. 要点
- 6 月 1 日,按使用量计费从理论变成了截图和流失。 围绕 Copilot 和 Codex 的抱怨,焦点集中在额度烧光、套餐取消和重置变化,而不是抽象的价格图表。(来源)
- 廉价模型的 headline 已经无法脱离仓库测试而成立。 MiniMax M3 因价格和基准分数受到关注,但同一天的公开生产测试称它破坏了真实工作流。(来源)
- 发布热度正聚集到封装层和集成层,而不只是底层模型。 Science Skills、Bedrock 支持、Build CLI 和 Copilot 自动化,都把现有模型包进了更具体的操作界面中。(来源)
- 最强的构建者信号来自领域专用封装层。 Nullsec S1、MM-Agent、CVForge 和 MSU Space 都是在围绕具体领域与工作流打包 AI 编程能力,而不是再做一个空白提示框。(来源)