Twitter AI 编程 - 2026-06-26
1. 人们在讨论什么
1.1 GitHub Copilot 发布 harness 基准数据——争论焦点从模型转向编排(🡕)
当天信号最强的一条,是 GitHub 发布了具体基准数据,主张 agent harness 的重要性不亚于模型本身。三条高互动内容共同支撑了这一主题:一条来自已认证 GitHub 产品负责人的原始公告、一条来自 GitHub 开发者社区副总裁的转发,以及相关讨论。
@pierceboggan 已发布(62 个赞、14 次转发、3 条引用、18 次收藏、2,952 次浏览)发布了 GitHub 公开的 博客文章 数据:Copilot CLI 在五项基准上与 Claude Code(对应 Sonnet 4.6 和 Opus 4.7)及 Codex CLI(对应 GPT-5.4 和 GPT-5.5)正面对比,分别是 SWE-bench Verified、SWE-bench Pro、SkillsBench、Win-Hill 和 TerminalBench2。方法上固定模型与任务,并控制上下文窗口、推理强度、工具选择和 MCP 服务器。任务完成率图表显示:在 Sonnet 4.6(SWE-bench Verified 高 3.1 个百分点、SWE-bench Pro 高 2.2 个百分点)和 Opus 4.7(SWE-bench Pro 高 1.4 个百分点、Win-Hill 高 7.1 个百分点)两组测试中,Copilot CLI 都在五项基准里的四项领先 Claude Code;而与 GPT 模型上的 Codex CLI 对比,则结果有胜有负。
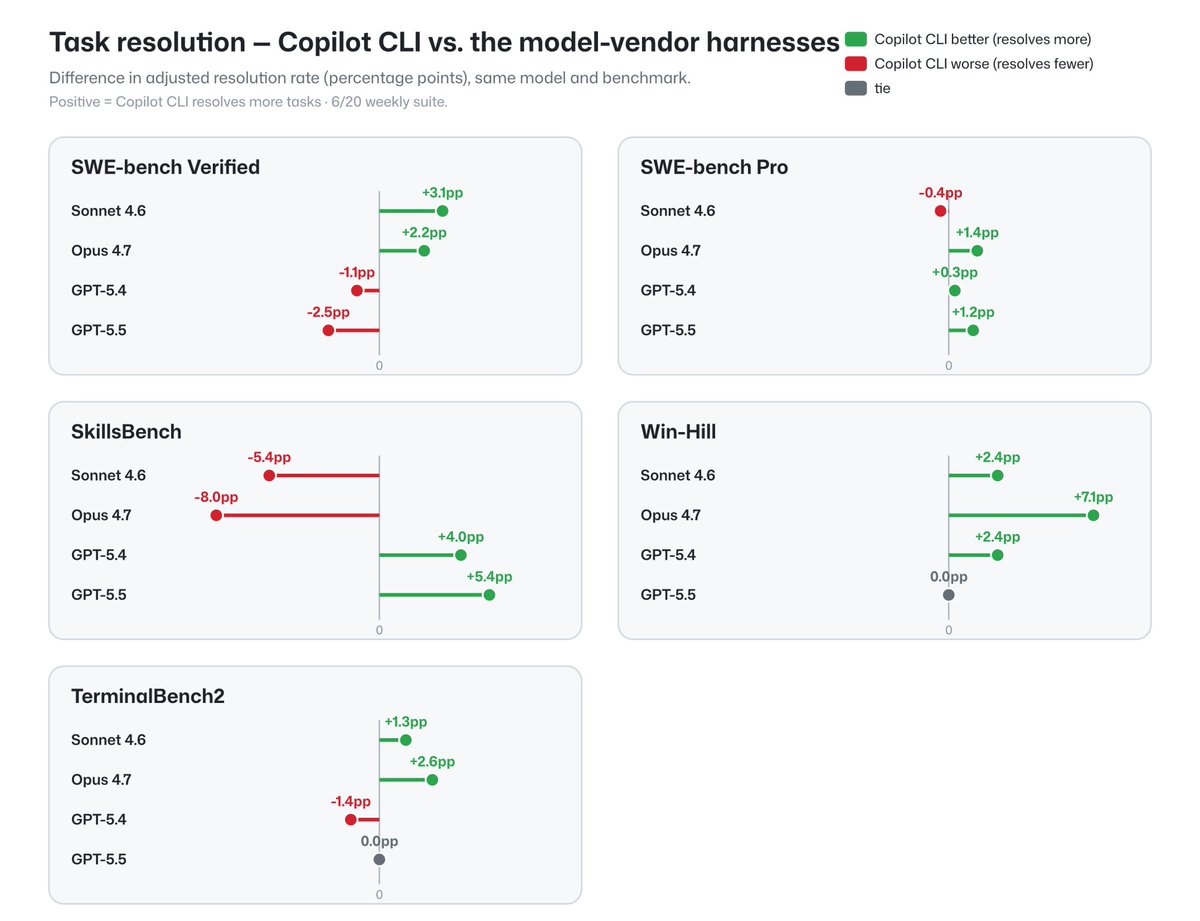
@martinwoodward 放大了(12 个赞、5 次转发、1 条引用、2 次收藏、1,656 次浏览)则强调了 token 效率,并附上另一张图表。图表显示,在运行相同 Claude 模型时,Copilot CLI 比 Claude Code 少用 31%–65% 的 token:Sonnet 4.6 在 SWE-bench Verified 上减少 65%,SWE-bench Pro 减少 46%,SkillsBench 减少 41%,Win-Hill 减少 38%,TerminalBench2 减少 31%。对 Opus 4.7,节省幅度在 38% 到 52% 之间。与 GPT 模型上的 Codex CLI 相比,Copilot CLI 的表现较为混合,但在大多数基准上仍是负值,也就是 token 用得更少。

博客文章指出,这套 harness 是 Copilot CLI、Copilot app、代码审查、VS Code 以及其他 GitHub/Microsoft 界面的统一共享组件——对 harness 的改进会同步传导到所有这些产品。@Thomas_Tao_1 的一条回复(25 次浏览)立刻质疑了这一叙事:“Token 效率是有用,但我老是被重试成本坑到。一个两次都没抓住上下文的 agent,就算基准说它更省,实际也很贵。”
讨论洞察: 这条质疑是整个讨论串里唯一有实质内容的反驳。对方没有拿出反向数据,只是提出一个基准未捕捉到的定性问题:重试行为。
与前一天对比: 6 月 25 日确立了 GitHub 的路线是做平台能力,而不是追逐模型。6 月 26 日则首次给出了公开的量化论据,说明 Copilot harness 相比厂商原生替代方案可能构成竞争优势。
1.2 Codex 在 OpenAI 内部接近全面采用,并开始表现得像个平台(🡕)
多条高信号内容都指向同一组关于 Codex 内部发展轨迹的公开数据。6 月 25 日还只是概括性说法,到了 6 月 26 日,公开信息已经补上了更具体的基线对比和产品演进信号。
@PeterDiamandis 表示(42 个赞、8 次转发、1 条引用、5 次收藏、3,137 次浏览)称,如今 OpenAI 有 98% 的员工在使用 Codex agents,研究场景的使用量在七个月内增长了 56 倍,8 小时任务请求增长了 10 倍。@Techmeme 指出(8 个赞、2,625 次浏览)则为同一组公开数据补上基线:2025 年 8 月 Codex 的使用率约为 40%,到 2026 年 6 月升至 97.9%;非开发者个人用户的使用量增长了 137 倍。结合起来看,这勾勒出一条为期 10 个月的采用曲线:从 40% 到内部近乎全民使用。
@subinium 分享了(4 个赞、2 条回复、224 次浏览)展示了一张 Codex 会话截图,其中出现“Subagents 638”——这说明现实中的 Codex 编排,已经能在单个任务里调度数百个并行 subagent。
@gudanglifehack 发现(4 个赞、2,782 次浏览)展示了 Codex UI 中出现的新入口:“Give the gift of Codex”横幅允许用户向他人赠送 Codex credits。截图把 credits 明确塑造成一种货币(“Send Codex credits to a friend to help them turn their ideas into reality”),同时还展示了 Slack、GitHub 和 Linear 的集成入口。

讨论洞察: 关于 Codex 采用率的数据在传播过程中几乎没有遇到实质性异议,也没人提出替代数字。PeterDiamandis 那条帖子里最显眼的回复是垃圾信息;真正有意义的回复基本都是正向放大。
与前一天对比: 6 月 25 日的 Codex 论文给出了分部门图表和增长百分比。6 月 26 日则新增了从 40% 到 98% 的基线曲线、638 个 subagent 的规模证据,以及 Codex credits 可作为礼物赠送的首个产品信号——这表明 OpenAI 正在把 Codex 当作消费级产品,而不只是内部工具。
1.3 Agent 会话记忆被视为一个已解决问题,同时释放出极强的采用信号(🡕)
当天最强的 builder 向内容,是一款持久化会话记忆工具:它既登上 GitHub Trending 榜首,也印证了回复中所说的“最大的生产力杀手”。
@VaibhavSisinty 推广了(24 个赞、6 次转发、19 次收藏、2,264 次浏览)介绍了 claude-mem,这是一款持久化记忆压缩 sidecar,可跨 Claude Code、Codex、Gemini CLI、Copilot、OpenCode 和 Hermes 使用。它会在后台静默运行,记录 agent 跨会话的操作,用 AI 压缩上下文,并在下一次会话开始时注入相关内容。安装只需一条 npx claude-mem install 命令。GitHub 仓库显示其拥有 84K+ stars,采用 Apache 2.0 许可证;README 截图还确认它是当天 GitHub Trending 第 1 名,并展示了自 2025 年 10 月起陡峭上升的 star 增长曲线。

讨论洞察: @JamesClawn 的回复(35 次浏览)补充了一个关键细节:“Claude Code 会忘事很烦,但 Claude Code 记错事更糟,除非恢复机制能展示它具体用了哪一组记忆。”另一条来自 @benja_maker 的回复(30 次浏览)则追问,市场上已经有多种 memory layer,是否存在针对它们的基准测试。痛点确实成立,但信任和调试问题也同样真实:压缩后再注入的上下文带来了一种新的故障模式——错误上下文往往比完全没有上下文更难追踪。
与前一天对比: 6 月 25 日展示的是开发者给 Obsidian 和邮箱套上 agentic memory 外壳(My Brain Is Full — Crew)。6 月 26 日则出现了达到规模的 memory-as-infrastructure 工具:84K stars、GitHub Trending 第 1,说明“记忆缺口”已经吸引到主流开源方案,而不再只是小众封装项目。
1.4 免费与本地推理获得了分发渠道和具体用例(🡕)
三条彼此独立的内容显示,不受配额或账单上限限制地运行 AI 编程 agent 的基础设施正在完善。
@dhruvtwt_ 宣布(34 个赞、24 次收藏、1,018 次浏览)介绍了 freeLLM.net:一个收录 224+ 免费 AI API 的目录,覆盖 25 家提供商,包括 Google、Groq、NVIDIA NIM、OpenRouter、Mistral、Cohere 等。它提供速率限制、上下文窗口、API key 链接,以及适用于 Claude Code、Cursor、Codex、OpenCode、Hermes 和任何 OpenAI 兼容客户端的一键配置片段。网站确认,目前有 127 个模型可免费在线使用。24 次收藏对应 1,018 次浏览,保存率很高,说明用户把它当成了实用资源。

@edandersen 分享了(26 个赞、7 次收藏、1,951 次浏览)展示了一段视频:Qwen-Coder-Next 在 GitHub Copilot 的 VS Code 中完全离线运行,在日本新干线旅途中,使用电池供电的 Ryzen AI MAX 395、128GB 笔记本,以每秒 40 个 token 的速度运行。发帖人将其称为“未来的一瞥”。
@RaidOwlTweets 指出(12 个赞、610 次浏览)则展示了某人在当月 GitHub Copilot credits 用完后的个人 AI 集群仪表板:五个计算节点,其中包括三个 GPU 利用率达 96% 的 DGX 集群、一台 32 核 Strix Halo,以及一台 Mac Mini;运行的服务包括 OpenWebUI、n8n、Ray 和 SearXNG。

讨论洞察: edandersen 的视频引来了关于其野心的回复,但没有遭遇技术层面的质疑。三条内容共同指向同一个结论:本地推理正变得越来越可行(高端消费级笔记本可离线跑到 40 tok/s),免费层 API 目录降低了没有本地硬件用户的门槛,而开发者也已经在用个人集群给账单问题兜底。
与前一天对比: 6 月 25 日重点还是非官方桥接方案(Windows Copilot API)和配额抱怨。6 月 26 日则展示了更成熟的基础设施:一个聚合免费层 API 的公开目录,以及在消费级硬件上演示的离线 agent 工作流。
1.5 生态集成扩展到 MCP 商店、安全技能与桌面 Git(🡒)
三条工具发布信息确认,编程 agent 生态正通过企业集成、安全能力和桌面工具持续扩张。
@gitlab 宣布(39 个赞、7 次转发、1 条引用、7 次收藏、5,810 次浏览)介绍了 GitLab Orbit 已上线 Google Antigravity MCP Store。Ultimate 和 Premium 用户可以直接在自己的编程平台中,让 agent 以受治理、结构化的方式访问 GitLab 实例。文中援引的内部测试称,相比标准 API 访问,响应速度快 11 倍、token 减少 4.5 倍、幻觉减少 45 倍。截图显示,Orbit 正在 IDE 中用于梳理项目关系并生成架构图。

@RituWithAI 重点介绍了(7 个赞、6 次转发、6 次收藏、118 次浏览)介绍了 Anthropic-Cybersecurity-Skills:一个开源技能库,为 AI 编程 agent 提供覆盖 29 个安全领域的 817 项结构化网络安全技能,并映射到六套框架:MITRE ATT&CK v19.1、NIST CSF 2.0、MITRE ATLAS、D3FEND、NIST AI RMF 和 MITRE F3。它可用于 Claude Code、GitHub Copilot、Codex CLI、Cursor、Gemini CLI,以及其他 20+ 平台。仓库显示拥有 21K stars 和 2.5K forks,采用 Apache 2.0 许可证。
@GHchangelog 宣布(12 个赞、2,160 次浏览)介绍了 GitHub Desktop 3.6。该版本将 Desktop 中的 Copilot 切换到 Copilot SDK,并为所有 Copilot 功能加入模型选择器和 BYOK 支持。提交信息生成功能现在会读取 copilot-instructions.md 和 AGENTS.md。新的合并冲突解决功能会用 AI 解释冲突并提出解决建议。Git worktree 支持则让用户可以同时管理多个分支,无需承受频繁切换分支的开销。
讨论洞察: GitLab 的公告是当天浏览量最高的生态类内容(5,810 次浏览)。“幻觉减少 45 倍”的说法非常醒目,但推文并未给出具体方法细节。
与前一天对比: 6 月 25 日还是以 GitHub 为中心(Agent Finder、LSP Setup、Copilot app 自动化)。6 月 26 日则扩展到通过 MCP 商店接入 GitLab,并把 BYOK 延伸到了桌面 Git 工具。
2. 什么让人沮丧
Codex 和 Copilot 的配额限制正在收紧,计费变化带来不可预测的成本
严重程度:高。最集中的不满,集中在多个工具的使用上限和账单不可预测性上。@CtrlAltDwayne 报道称(34 个赞、2 次转发、1,660 次浏览)称,过去几天 Codex 的使用限制明显收紧,即便是每月 200 美元的订阅也是如此;截图显示 5 小时额度剩余 34%,7 天额度剩余 39%,暗示消耗速度异常。回复 @Suolar_ 说“Dude codex is unusable now”,@kimkimbhhr 则表示“usage run out like over 10x on my end”。@Oblivious9021 指出(5 个赞、4 次转发、145 次浏览)称 GitHub Copilot 已从固定定价转向按 token 计费,一名开发者的账单从每月 29 美元涨到 750 美元。@RaidOwlTweets 确认(12 个赞、610 次浏览)则展示了 GitHub Copilot credits 已被完全耗尽,而当月还有两周才结束。大家的应对路径非常一致:退回到本地 AI 集群、免费层 API,或非官方桥接方案。这个方向值得做,因为失败模式并不抽象——而是在工作流进行到一半时直接撞上硬墙。

会话记忆丢失会打断 agent 在不同工作会话之间的连续性
严重程度:高。claude-mem 的 84K stars 和 GitHub Trending 第 1,本身就是一个证据信号:大量用户正在把会话上下文丢失视为反复发生的成本。@VaibhavSisinty 帖子(24 个赞、2,264 次浏览)下的回复把这种挫败感说得很具体:“我有一次光是重新解释它本来就知道的项目结构,就浪费了差不多 2 小时”(@hello_code_);另一条回复则指出了次生风险:“Claude Code 记错事更糟,除非恢复机制能展示它具体用了哪组记忆”(@JamesClawn)。人们会用上下文文件、CLAUDE.md 和 memory 插件来缓解;更有经验的用户则担心,压缩记忆注入制造出的故障模式,比完全没有记忆更难调试。
用本地推理替代云端 agent,比看上去更难
严重程度:中。@evilseyee 描述了(2 个赞、54 次浏览)讲述了自己从午夜开始安装 Ollama,试图把它作为 Claude Code 工作流的部分替代品,却遇到了模型兼容性问题、上下文处理差异,以及工具调用可靠性不足。帖子并没有顺利收束,最后以“famous last words”结束,而整个配置仍未完成。本地 AI 这条路是可行的(edandersen 当天就展示了 40 tok/s 的离线演示),但云端与本地之间的工具兼容性鸿沟仍然真实存在。
3. 人们希望有什么
不会因计费模式变化而失效的免费、透明使用量仪表板
人们想要的是清晰、提前可见的使用信号,而不是事后才被账单吓到。CtrlAltDwayne 的限额报告、Oblivious9021 那条从 29 美元到 750 美元的账单,以及 RaidOwlTweets 的 credits 耗尽经历,隐含提出的是同一个诉求:在 token 消耗越过阈值前,就有一层使用量可视化。freeLLM.net 和本地集群只是这一缺口的手工应对方案。机会:直接。
可检查、可纠正上下文注入的 agent 记忆
claude-mem 回复区里的细节表明,人们想要的不只是持久化记忆,而是可审计的记忆。@JamesClawn(35 次浏览)说得很直接:“Claude Code 记错事更糟,除非恢复机制能展示它具体用了哪组记忆。”@benja_maker(30 次浏览)则追问,是否存在衡量 memory layer 质量的基准,这也暗示市场上已经有多个选项,但缺少比较方法。尚未被满足的需求,是一种能展示“注入了什么、为什么注入”,并允许用户删除或修正的记忆系统。机会:直接。
可在笔记本级硬件上运行的离线 agent 工作流
@edandersen 演示了(26 个赞、1,951 次浏览)证明这在技术上已可实现(在新干线上靠电池供电跑到 40 tok/s),但前提是一台 128 GB 内存的高端 Ryzen AI MAX 395 笔记本,并在 Copilot 中运行定制本地模型。从“我的 Copilot credits 用完了”到“我现在可以离线跑同样的工作流”,还没有文档完备的一键路径。这个缺口确实存在,freeLLM.net 解决的是云端部分,而离线/本地推理仍然需要不小的配置成本。机会:竞争性。
用于 agent 演示的确定性或脚本化模式
@eliostruyf 构建了(2 个赞、2 次转发、251 次浏览)之所以会做出 copilot-mock-server,正是因为这个需求尚未被满足:它是一个拦截 Copilot Chat 流量并重放脚本化响应的代理,让演示可以完全确定。有人专门造了一个代理,而不是直接用厂商功能,这说明它不是边缘用例——而是所有需要演示 AI 编程工具、又承受不起现场幻觉的开发者的现实 workaround。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot CLI | 编程 agent harness | (+) | 已发布基准数据,显示在 Claude 模型上比 Claude Code 具备更高 token 效率;CLI、app、代码审查和 VS Code 共用同一套 harness | 与 GPT 模型上的 Codex CLI 对比结果较为混合;基准未捕捉重试成本 |
| Codex (OpenAI) | 编程 agent | (+/-) | 在 OpenAI 内部接近全面采用,生产中已出现 638+ subagents,credits 开始可赠送 | 有报告称使用限制趋紧,多名用户在每月 200 美元订阅下撞上上限 |
| Claude Code | 编程 agent | (+/-) | 生态吸引力最强(最多工具优先为其集成);claude-mem 和网络安全技能库都优先支持它 | 会话记忆丢失;在相同 Claude 模型下,token 成本高于 Copilot harness |
| claude-mem | agent memory layer | (+) | 84K stars、GitHub Trending 第 1、Apache 2.0、单命令安装,可跨 Claude Code、Codex、Gemini CLI、Copilot、OpenCode、Hermes 使用 | 存在注入错误压缩上下文的风险;尚无记忆质量基准 |
| freeLLM.net | 免费层 API 目录 | (+) | 来自 25 家提供商的 224+ 免费 AI API,为主流 agent 客户端提供一键配置,多数情况下无需信用卡 | 覆盖范围取决于提供商在线状态;免费层有速率限制 |
| GitHub Desktop 3.6 | 桌面 Git / Copilot 集成 | (+) | Copilot SDK、模型选择器、BYOK 支持、提交信息遵循仓库指令、AI 冲突解决、worktree | 刚刚发布,采用情况未知 |
| GitLab Orbit (in Antigravity MCP) | 企业源码集成 | (+) | 相比非结构化 API,响应快 11 倍、token 少 4.5 倍、幻觉少 45 倍;访问受治理 | 仅限 Ultimate 和 Premium;性能声明的方法细节未披露 |
| Qwen-Coder-Next (local) | 本地编程 LLM | (+) | 在 Ryzen AI MAX 395 上可电池供电跑到 40 tok/s;可在 Copilot VS Code 中离线运行 | 需要高端 NPU 笔记本和手动配置;并非即插即用 |
| Google Antigravity | 编程平台 / MCP 商店 | (+/-) | MCP 生态在增长(包括 GitLab Orbit 等);集成 Gemini | Gemini 3.5 Pro 延迟到 7 月;课程内容需求说明存在学习曲线 |
| Anthropic-Cybersecurity-Skills | 安全技能库 | (+) | 817 项技能、29 个领域、6 套框架映射、21K stars;可用于 26+ 平台;Apache 2.0 | 社区项目,并非 Anthropic 官方;攻击性技能仅限授权使用 |
6 月 26 日工具层面最明显的情绪变化,是人们对 Copilot CLI 的描述方式变了。基准帖子出现前,回复里通常把 Copilot 视为在模型选择和 UX 上竞争。帖子出现后,讨论转向把 harness 当作独立的质量维度——同一个模型,放在不同 harness 里,表现也可能不同。这个论点显然有利于 GitHub,也让 Anthropic 和 OpenAI 对“厂商原生 harness”的营销更难讲清楚。
本地推理路线依旧很乱。@evilseyee 没能在本地复现自己的云端 agent 配置,而 @edandersen 虽然成功了,却依赖特殊硬件条件。这两种体验之间的落差,正好概括了本地推理的现状:对资源充足的人来说已可行,但还算不上可靠的即插即用替代品。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| claude-mem | thedotmack | 面向 AI 编程 agent 的持久化记忆压缩 sidecar | agent 窗口一关,会话上下文就丢失 | Node.js、AI 压缩、CLAUDE.md 注入、跨 agent 支持 | 已发布 | 仓库 |
| Anthropic-Cybersecurity-Skills | mukul975 | 面向 AI 编程 agent 的 817 项网络安全技能库 | 不逐次提示时,agent 没有持久的安全知识 | SKILL.md 文件、6 套框架映射(MITRE ATT&CK、NIST CSF、ATLAS、D3FEND、AI RMF、F3) | 已发布 | 仓库 |
| copilot-mock-server | eliostruyf | 拦截 Copilot Chat 流量并重放脚本化响应的本地代理 | Copilot 响应不可预测,现场演示容易翻车 | 本地代理、流量拦截、确定性重放 | 已发布 | 帖子 |
| freeLLM.net | dhruvtwt_ | 提供 224+ 免费 AI API 及面向 agent 客户端一键配置片段的目录 | 开发者撞上配额墙后,缺少便捷的免费替代路径 | Web 目录、按模型生成配置 | 已发布 | 网站 |
claude-mem 是“需求信号成熟为基础设施”的最清晰证据。@VaibhavSisinty 描述了(24 个赞、2,264 次浏览)将它描述为一个静默的后台进程:压缩 agent 做过的事情,并在下一次会话开始时注入相关上下文。84K stars 和 GitHub Trending 第 1 说明它已经从小众工具跨进主流开源基础设施。单命令安装(npx claude-mem install)加上多 agent 兼容性,也说明构建者优先追求的是零摩擦采用,而不是高度可配置。
Anthropic-Cybersecurity-Skills 填补了信息流中暴露出的一个明确缺口:开发者正在构建会编写安全关键代码的 agents,但这些 agents 并没有常驻的安全知识。@RituWithAI 描述了(7 个赞、118 次浏览)把问题概括为:agents 默认并不知道 OWASP Top 10,也不会主动检查 SQL 注入。这个库的做法是预装 817 项结构化技能,并在任务相关时自动激活——做身份认证时触发 IAM 技能,审查 API 时触发 API 安全技能。21K stars 和 2.5K forks 表明,“安全技能缺口”是真问题,而结构化的 SKILL.md 格式正逐渐成为一种打包标准。
copilot-mock-server 和 freeLLM.net 规模都不大,但都填补了真实的实践空白。mock server 解决的是演示场景中特有的可靠性问题;freeLLM 目录则是一层原本不存在的协调层,并且一上线就达到了 2.4% 的收藏率(24 次收藏 / 1,018 次浏览)。
6. 新动态与值得关注的内容
GitHub 首次发布 harness 基准,建立了新的竞争框架
在 6 月 26 日之前,比较编程 agent 的主要维度是模型质量、用户体验和生态。pierceboggan 那条基准帖子引入了第三个维度:harness 效率。通过发布在相同模型下与 Claude Code 和 Codex CLI 的 token 消耗对比,GitHub 第一次让外界有条件把“模型表现”和“harness 表现”分开来看。那张 token 效率图表——显示使用 Claude 模型时,相比 Claude Code 可减少 31%–65% 的 token——提供了此前公开讨论中并不存在的明确成本论据。至于这些基准能否在多样化的生产负载中成立,仍然是开放问题,但这个比较框架已经出现,并且可以进入采购决策参考。
Codex 赠送 credits 预示着向消费端变现转向
Codex UI 现在出现了“Give the gift of Codex”界面,用于向其他用户赠送 credits。@gudanglifehack 发现(4 个赞、2,782 次浏览)展示了 Codex app 中的这一功能。让 credits 可赠送,意味着 Codex 正从纯订阅产品走向一种带有社交赠礼经济色彩的模式,这是完全不同的变现入口。截图还确认,除了 Slack 和 GitHub,UI 里也把 Linear 列为了集成端点,延续了前一天所展现的趋势:Codex 正作为跨工具的工作层存在。
Gemini 3.5 Pro 从 6 月推迟到 7 月
@WesRoth 报道称(49 个赞、3,847 次浏览)转发了一篇 Business Insider 文章,确认 Google 将 Gemini 3.5 Pro 的发布时间从 6 月推迟到 7 月,以便收集更多早期测试者反馈并调整模型。该模型曾在 5 月的 Google I/O 上预览,原本预期 6 月上线。有一条回复猜测,延期是因为它与 GLM 5.2 的对比不占优。
7. 机会在哪里
[+++] 透明、具备配额感知的 agent 基础设施 ——从 29 美元涨到 750 美元的账单、Codex 异常快速消耗的限额,以及 Copilot credits 耗尽,全部指向同一个缺口:开发者想在撞墙之前实时看见 token 消耗,而不是事后才知道。freeLLM.net、本地集群和非官方桥接方案都只是 workaround。最直接的机会,是做一层跨 agent 客户端的消费监控与故障转移:配额收紧时自动切到免费层 API 或本地推理,并提供可见的成本仪表板。这个需求在第 2、3、4 节都出现了。
[++] Agent memory with auditability, not just persistence — claude-mem at 84K stars confirms that memory persistence is now a commodity problem. The next gap is one layer up: @JamesClawn 直接说出了这一点:用户需要在被注入的上下文造成难以追踪的错误之前,看见它并纠正它。一个可审计的记忆层——记录注入了什么、为什么注入,并允许用户编辑或删除特定 memory bundle——会比当前这批静默压缩工具更有差异化。
[+] 面向 AI agents 的默认安全技能打包 ——Anthropic-Cybersecurity-Skills 已有 21K stars 和 2.5K forks,说明“技能库作为安全交付机制”已经具备牵引力。同样的模式也可以延伸到其他合规领域(隐私、无障碍、许可证),尤其适合那些在受监管代码上构建 agents 的团队。agentskills.io 开放标准提供了打包格式。机会在于,为特定垂直领域提供经过策展、持续维护、达到企业级标准的技能库。
[+] 面向企业采用的确定性、可测试 agent 模式 ——之所以会出现 copilot-mock-server,是因为高风险演示仍然无法承受 live 模式的不确定性。在受监管或面向客户的场景里,这种需求只会更强。机会在于,在 agent harness 中提供一种支持脚本化、确定性响应的模式或协议,用于测试、审计和演示,而不是让用户通过代理绕路解决。
8. 要点总结
- harness 的论点如今已有量化依据。 GitHub 发布的 token 效率数据显示,在相同任务、相同 Claude 模型下,Copilot CLI 比 Claude Code 少用 31%–65% 的 token。它是否能在生产环境中成立仍有争议,但这个基准框架已经出现,而且更有利于“harness 可独立于模型评估”的观点,而非厂商锁定。 (来源)
- Codex 已从 OpenAI 内部的多数采用跨入近乎全面采用,并开始加入消费级变现。 从 2025 年 8 月的 40% 到 2026 年 6 月的 97.9%,这是目前最完整的公开时间线之一,展示了企业 AI agent 如何从实验性工具变成标准操作方式。“赠送 credits”界面说明 OpenAI 正把这条轨迹向外延伸。 (来源)
- 记忆持久化是基础设施,不只是一个功能。 claude-mem 的 84K stars 和 GitHub Trending 第 1 说明,会话连续性如今已是预期能力,而非可选项。下一个尚未解决的问题,是记忆可审计性——知道注入了什么,并能在它引发后续错误前纠正它。 (来源)
- 免费层和本地推理正在成为一种结构化安全阀,而不只是临时变通。 freeLLM.net、离线 40 tok/s 的 Qwen-Coder-Next,以及作为 Copilot credits 后备的个人 GPU 集群,都说明了同一个趋势:账单天花板是真实存在的,绕开它的基础设施正在成熟,而开发者也在有意识地建设这条退路。 (来源)