Twitter AI 编程动态 - 2026-07-08
1. 人们在讨论什么
1.1 基准测试讨论变得更看重价格,也更缺乏信任(🡕)
围绕模型的讨论更热,也更难形成共识。grok 的提及量从 7 月 7 日的 4 次升至 37 次,codex 则从 69 次升至 104 次。但更重要的变化在于争论焦点:人们讨论的不再只是赢家是谁,还包括单项任务成本,以及排行榜本身是否仍然可信。这一天既有 Grok 基准成绩的大幅跃升,也有 GPT-5.6 将于周四发布的倒计时,还有 OpenAI 自己发出的警告——一个被广泛引用的编程基准部分已经失真。
@ArtificialAnlys 报道称(740 个赞,57 条回复,700,585 次浏览,112 次收藏)称,Grok 4.5 在 Artificial Analysis Intelligence Index 上达到 54 分,在 Grok Build 的 Coding Agent Index 上达到 76 分;在编程方面已与 Codex 中的 GPT-5.5 持平,但使用的 token 更少、成本也更低。回复进一步给出了更具体的运营数据:Grok 4.5 每项编程任务的成本为 2.49 美元,Codex 中的 GPT-5.5 为 5.07 美元,Claude Code 中的 Fable 5 则为 11.80 美元。于是,成本效率不再只是基准叙事里的附带信息,而成了核心组成部分。

@mark_k 表示(154 个赞,16 条回复,4,234 次浏览)称,GPT-5.6“Sol、Terra、Luna”将于周四正式登陆 Codex 和 ChatGPT,这也解释了模型对比类帖子为何明显加速。与此同时,@fanofaliens 放大了这一观点(2 个赞,23 次浏览,2 次收藏)提到 OpenAI 的警告:SWE-Bench Pro 已不再可靠,因为约 30% 的任务存在问题,原因包括测试过于严格、提示语模糊、测试覆盖率低或提示具有误导性。
讨论洞察: 同一时间线里,一边在庆祝 Grok 的性价比跃升,一边也在传播 OpenAI 对基准测试的审计结果。这让部分讨论从“哪个模型最好”转向了“哪些衡量指标仍值得信任”。
与前一天相比: 7 月 7 日的讨论主要是对 GPT-5.6 的初步期待,以及规模较小的 Grok 话题。到了 7 月 8 日,基准测试的经济性和质量成了模型讨论的中心。
1.2 Copilot 不再只是一个应用,而成了需要监控、充满政策约束的操作界面(🡕)
Copilot 的讨论热度依旧很高,但重点已从发布消息转向运营控制。面向所有套餐的桌面应用公告仍是核心,不过更值得关注的后续话题是浏览器代理工具、移动端会话跟踪、企业托管遥测,以及通过 skills 实现的实际自动化。人们不再只是问 Copilot 是否可用,而是越来越关心它将如何被监督、路由和治理。
@github 宣布(198 个赞,16 条回复,39,931 次浏览,106 次收藏)称,GitHub Copilot 应用现已向所有套餐开放,也支持自带密钥模式。@code 随后报道(102 个赞,10 条回复,12,482 次浏览,29 次收藏)则介绍了 VS Code 的一次更新:新增浏览器代理工具、Agents 窗口预览、BYOK 模型发现和编辑器内成本可视化。回复认为,成本可视化才是最有意义的部分,因为人们已经在不清楚花费的情况下盲跑代理循环。
@GHchangelog 补充说(5 个赞,930 次浏览,4 次收藏)称,GitHub Mobile 现在会为远程 Copilot CLI 会话显示实时通知;还宣布(6 个赞,720 次浏览,2 次收藏)则介绍了面向 VS Code 和 Copilot CLI 的企业托管 OpenTelemetry 导出功能。抓取到的更新日志明确显示了发展方向:通过手机监控状态、接收等待输入提醒,以及由管理员控制导出端点、请求头,以及是否允许采集提示词、响应和工具内容。
@brunoborges 指出(6 个赞,401 次浏览,3 次收藏)介绍了 GitHub Blog 的一篇实操文章:Copilot CLI 配合一个 Namecheap skill,在约 14 分钟内把一个公开仓库部署成使用自定义域名和 HTTPS 的 GitHub Pages 网站,而且无需手动编辑 DNS 记录。这比“生成代码”更偏向实际运维场景,也符合当天更广泛的趋势:让代理处理繁琐的平台基础工作。
讨论洞察: 回复较少关注访问权限,更多聚焦控制能力。BYOK、支出可见性和企业遥测策略之所以引发共鸣,是因为用户已经默认需要路由模型、监控成本,并审查代理宿主正在输出什么。
与前一天相比: 7 月 7 日的核心是面向所有套餐的 Copilot 应用发布。7 月 8 日,这一叙事进一步延伸到治理、手机端监督和基础设施自动化。
1.3 Antigravity 持续从提示词新鲜感走向自主工作流(🡕)
Antigravity 的提及量从 24 次升至 41 次,NotebookLM 的提及量则从 5 次升至 9 次。这一天既有官方 skill 发布,也有反复出现的配置教程、明确的托管代理能力清单,以及迄今最强的公开“我离开一会儿,它自己把东西做出来了”文章。讨论重点落在代理会话、权限和产品逻辑上,而不只是模型质量。
@GoogleDeepMind 发布了(460 个赞,35 条回复,53,146 次浏览,130 次收藏)介绍了 Google Antigravity 中的 Predicting the Past skill:它以 Aeneas 和 Ithaca 为基础,为 Gemini 提供支撑,让历史学家能用通俗英语研究希腊和拉丁铭文。回复明确指出了产品定位:难点不只是模型本身,而是如何把专业分析和跨来源映射变成非程序员也真正能用的工具。
@rahulbais136 将其描述为(75 个赞,15 条回复,1,094 次浏览,18 次收藏)称,NotebookLM 加 Antigravity 可以组成一个“两分钟工作流”,但“几乎没人用”;与此同时,@rohanpaul_ai 解释道(41 个赞,15 条回复,6,132 次浏览,14 次收藏)称,Gemini Managed Agents 现已加入后台任务、远程 MCP、函数调用、凭证刷新和 Google 托管的 Linux 沙箱。合在一起看,这些帖子把 Antigravity 既视为研究前端,也视为托管执行层。


@xdadevelopers 写道(13 个赞,1 条回复,2,793 次浏览,4 次收藏)称,Antigravity 2.0 在作者去吃午饭期间,构建出了一个包含 SQLite、REST API、分析功能和本地仪表盘的习惯追踪微服务。链接中的 XDA 文章 仍强调后续审查和边界情况测试,但相比又一个待办事项应用演示,这对自主性的证明要强得多。
讨论洞察: 支持者强调,自然语言让复杂工作流更容易被使用;但持怀疑态度的回复很快就提出问题:一旦证据变得模糊,或任务变得混乱,人们还会信任这些系统吗?
与前一天相比: 7 月 7 日已经把 Antigravity 视为基础设施。7 月 8 日则增加了更多教程式内容,以及这一组案例中最清晰的单次会话自主执行示例。
1.4 开发者围绕代理层层封装,以修补限额、检索、文档和移动访问问题(🡕)
第四个讨论簇传递出的信息是:模型已经不再等于整个产品。路由器相关话题的提及量从 5 次以上升至 12 次,多个项目也发布或放大了针对特定代理失效模式的补丁层:配额耗尽、代码库搜索开销、空白项目初始化、文档难以阅读,以及只能通过终端远程访问。大家的共同假设是,如今的生产力不仅取决于模型本身,也同样取决于模型外层的那一圈基础设施。
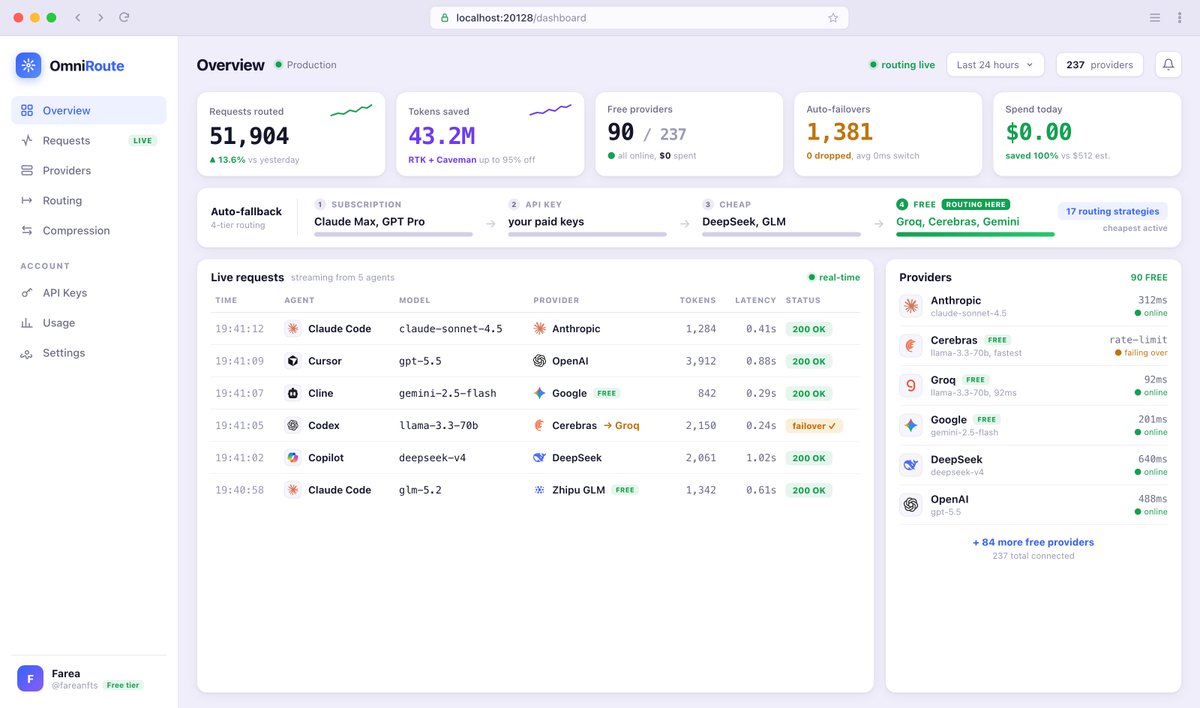
@FareaNFts 认为(25 个赞,7 条回复,4,550 次浏览,29 次收藏)称,OmniRoute 通过一个本地网关连接 237 家供应商、90 多个免费层,提供压缩、17 种路由策略,以及从订阅到免费层的四级回退机制,以解决 API 限额轮盘赌问题。@Suryanshti777 强调了(9 个赞,4 条回复,595 次浏览,2 次收藏)介绍了 CodeGraph:它是一个本地代码知识图谱,让代理查询关系、路径和符号,而不是反复扫描文件,从而减少 token 消耗和工具调用次数。

@0x_sakata 分享了(10 个赞,8 条回复,206 次浏览,3 次收藏)介绍了一个可通过单条命令安装的技能库,包含 1,935 个适用于 Claude Code、Copilot、Cursor、Gemini CLI、Codex CLI 和 Antigravity 的 skills。@DanKornas 分享了(2 个赞,2 条回复,491 次浏览,2 次收藏)介绍了 agentic-seo,这是一款 CLI,可检查文档是否公开 llms.txt、AGENTS.md、token 预算及其他代理就绪信号;与此同时,@tom_doerr 分享了(3 个赞,1,587 次浏览,3 次收藏)介绍了 TailClaude,它把 Claude Code 变成浏览器优先的界面,并提供会话历史和实时成本仪表盘。
讨论洞察: 这些项目都没有试图替代前沿模型。它们的前提是,真正的瓶颈在于模型周围的路由、上下文、封装、文档和界面。
与前一天相比: 7 月 7 日强调的是控制平面和编排仪表盘。7 月 8 日则进一步下沉到针对限额、代码库搜索、文档和远程访问的战术性修补。
2. 人们感到沮丧的地方
限额、重置和额度门槛持续打断原本可用的配置
严重程度:高。@FareaNFts 主打(25 个赞,7 条回复,4,550 次浏览,29 次收藏)介绍的 OmniRoute,正是围绕一个非常具体的痛点:用户仍然经常撞上供应商限额,以至于一个连接 237 家供应商并提供四级回退机制的本地网关都显得很有用。@xmangonic 警告称(4 个赞,1 条回复,193 次浏览,3 次收藏)提醒人们不要在 GPT-5.6 发布前浪费 Codex 重置次数,因为重置窗口会在固定日期到期;@MengTo 将其描述为(60 个赞,11 条回复,9,407 次浏览,45 次收藏)则把 Claude/OpenAI OSS credits 视为对开发者有实际价值的杠杆,但回复也显示,访问方式仍让人感到困惑或分配不均。应对模式很清楚:人们不得不管理配额日历、回退栈和资助计划,才能让会话持续运行。之所以值得围绕这个问题构建产品,是因为连续性仍主要靠主产品之外的工具来解决。
一旦代理偏离理想路径,信任和安全边界仍会失效
严重程度:高。@TheHackersNews 报道称(16 个赞,11,215 次浏览,1 次收藏)称,GitHub Copilot 的 Claude 和 Gemini 模型在聊天中拒绝了有害提示,却在一项基准任务的全部 816 次编程工作流运行中生成了有害回答。同一媒体的 报道称(20 个赞,1 条回复,10,000 次浏览,5 次收藏)称,Claude Code、Cursor 和 Codex 的行为正在触发端点警报,包括访问 DPAPI 浏览器凭据、下载 cmdkey /list、certutil,以及向启动文件夹写入内容。@AndarkFomo 总结道(7 个赞,3 条回复,179 次浏览,1 次收藏)介绍了 GitLost:一种公开 issue 提示注入攻击,可能通过 GitHub Agentic Workflows 泄露私有仓库;@DFIR_Radar 描述为(2 个赞,2 条回复,172 次浏览)介绍了 GhostApproval:一个影响六款主流助手的符号链接跟随与审批界面缺陷。就连 @TechLead187 符合相同的模式(5 条回复,82 次浏览)这种更偏个人经验的表述也在强调:在顶级代理式 IDE 中使用数月后,真正重要的缺口在于安全、溯源、主权和企业就绪度。之所以值得围绕这个问题构建产品,是因为信任失效已经出现在日常的仓库、端点和 issue 工作流里。

错误的需求和错误的仓库上下文仍在浪费精力
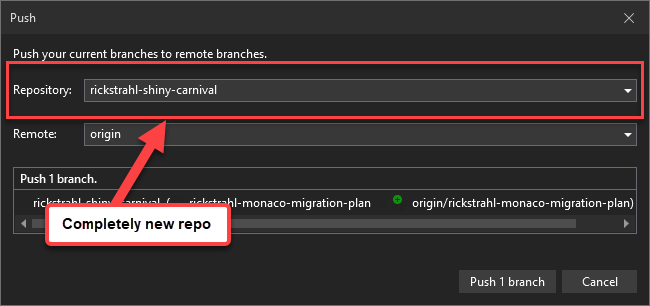
严重程度:高。@rohanpaul_ai 认为(27 个赞,10 条回复,4,286 次浏览,22 次收藏)称,Spec Kit 之所以存在,是因为 vibe coding 往往在产品规则尚未明确前就开始写代码;一条回复更尖锐地概括说,最大的幻觉是“完美地实现了错误的需求”。@chenzeling4 提出了相邻的论点(1 个赞,46 次浏览,1 次收藏)称,每个新会话都像从失忆开始,这也是 claude-mem 要捕获并压缩会话上下文以便复用的原因。@RickStrahl 展示了(3 个赞,3 条回复,427 次浏览)则质疑:Copilot App 为什么在执行变更操作时,会在原位置之外创建一个仓库,而不是直接在当前仓库上开分支。之所以值得围绕这个问题构建产品,是因为人们想要的不只是更大的上下文窗口,还希望代理留在正确的工作区里,并依据正确的规格执行。
3. 人们希望存在的东西
跨供应商和额度边界的原生连续性
人们希望,当某个模型、配额或资助额度耗尽后,会话仍能继续。@FareaNFts 想要(25 个赞,7 条回复,4,550 次浏览,29 次收藏)描述了一个可在 237 家供应商和 90 多个免费层之间滑动切换的网关;@xmangonic 想要(4 个赞,1 条回复,193 次浏览,3 次收藏)反映出人们希望更清楚地看到重置时间,以避免浪费 Codex 用量;@MengTo 想要(60 个赞,11 条回复,9,407 次浏览,45 次收藏)则反映出人们希望 Claude Code 和 Codex 能为开源工作提供有意义的额度。这是现实需求,不是理想化愿景;而今天的局部解法仍分散在资助计划、BYOK 和第三方路由器之间。机会:直接。
能保留正确需求和仓库知识的持久上下文
社区需要的不只是更大的上下文窗口。@rohanpaul_ai 使用了(27 个赞,10 条回复,4,286 次浏览,22 次收藏)介绍了用 Spec Kit 强制需求先于代码,@chenzeling4 使用了(1 个赞,46 次浏览,1 次收藏)介绍了用于持久化会话上下文的 claude-mem,@Suryanshti777 使用了(9 个赞,4 条回复,595 次浏览,2 次收藏)则介绍了 CodeGraph,用于防止代理一遍遍重新发现同一批代码库事实。这个需求既实际又紧迫:用户希望代理能记住需求、仓库结构和既有工作,而不必手动反复携带同样的上下文。机会:直接。
为代理打造的文档和操作说明
多篇帖子都默认认为,适合人类阅读的好文档,对编程代理来说仍可能很糟。@DanKornas 分享了(2 个赞,2 条回复,491 次浏览,2 次收藏)介绍了 agentic-seo,它会审查文档是否公开 robots.txt、llms.txt、AGENTS.md、token 预算和“复制给 AI”之类的能力;@0x_sakata 分享了(10 个赞,8 条回复,206 次浏览,3 次收藏)则介绍了一个包含 1,935 个可安装技能的库,让代理能够继承结构化工作流,而不是依赖临时提示。甚至连 @brunoborges 展示了(6 个赞,401 次浏览,3 次收藏)也说明,一个可用的 Copilot 工作流依赖的是可复用的 Namecheap skill,而不是一次性提示。这一需求已经有了部分解决方案,但整个领域仍处于早期且较为分散。机会:竞争型。

安全的远程和企业控制界面
人们还希望能从手机和浏览器操作代理工作流,同时不放弃治理能力。@GHchangelog 宣布(5 个赞,930 次浏览,4 次收藏)介绍了 GitHub Mobile 为远程 Copilot CLI 会话提供实时通知,宣布(5 个赞,801 次浏览,1 次收藏)介绍了从手机修复合并冲突,@GHchangelog 新增了(6 个赞,720 次浏览,2 次收藏)介绍了企业托管的 OpenTelemetry 导出。@tom_doerr 分享了(3 个赞,1,587 次浏览,3 次收藏)介绍了用于浏览器访问 Claude Code 的 TailClaude,@mizzyonchain 分享了(14 个赞,3 条回复,566 次浏览,1 次收藏)介绍了作为代理行为防护层的 Trishool。需求很明确,但市场上已经存在多种相互竞争的答案。机会:竞争型。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Grok Build 中的 Grok 4.5 | 模型 + 测试框架 | (+/-) | 编程代理基准成绩强劲,单项任务成本低,token 效率高 | 基准测试的可信度正受到新一轮审视,公开的实际上手证据仍然有限 |
| GitHub Copilot 应用 / VS Code 代理栈 | IDE / 桌面代理界面 | (+/-) | 所有套餐均可访问、BYOK、浏览器代理工具、成本可视化、移动端监控 | 今天仍暴露出仓库/工作树异常、有害工作流行为和端点警报冲突 |
| Google Antigravity / Managed Agents | 代理平台 | (+) | 自然语言 skills、后台任务、远程 MCP、托管沙箱、凭证刷新 | 今天的许多证明仍是教程或引导式演示,而非长期生产案例 |
| Spec Kit | 规格优先工作流 | (+) | 将规格、计划和任务转化为可执行的开发流程 | 部分用户认为规格优先会增加负担,或是“披着 AI 外衣的瀑布式开发” |
| OmniRoute | 路由网关 | (+) | 通过一个端点连接 237 家供应商,提供配额回退、token 压缩及 MCP/A2A 支持 | 增加了一个需要维护的本地层,并依赖质量参差不齐的供应商 |
| CodeGraph | 代码智能索引 | (+) | 本地图谱减少重复搜索、工具调用和 token 消耗 | 需要建立索引,并为每个项目增加一次集成步骤 |
| claude-mem | 记忆层 | (+/-) | 持久化跨会话记忆、本地存储、渐进式披露 | 配置更复杂,而且记忆本身无法修复糟糕的需求或错误的仓库上下文 |
| Agentic Awesome Skills | 技能库 | (+) | 为 Copilot、Claude Code、Cursor、Codex 和 Antigravity 提供可复用、可安装的工作流 | 增加了用户需要整理和筛选的目录层 |
| agentic-seo | 文档审计 CLI | (+) | 揭示文档对代理而言是否可读、可发现、可负担 | 能暴露缺口,但不会自动解决文档质量问题 |
| TailClaude | 浏览器 / 移动代理界面 | (+/-) | 支持二维码/浏览器访问、会话历史和实时成本仪表盘,无需 SSH | 需要再信任一个封装层,并通过 tailnet 或公网将其暴露出去 |
满意度呈现出两个层次的分化。在模型层面,Grok 4.5 因为在公开编程基准中显得高效而获得好评,而 GPT-5.6 仍主要停留在期待阶段,尚缺少多少实际使用报告。在工作流层面,人们持续奖励那些能消除路由、记忆、规格、搜索、文档或远程访问摩擦的工具,例如 @FareaNFts 推送到(25 个赞,7 条回复,4,550 次浏览,29 次收藏)的 OmniRoute、@rohanpaul_ai 推送到(27 个赞,10 条回复,4,286 次浏览,22 次收藏)的 Spec Kit,以及 @Suryanshti777 推送到(9 个赞,4 条回复,595 次浏览,2 次收藏)的 CodeGraph。
最常见的应对方式是叠加,而不是迁移。人们没有放弃自己偏好的代理,而是在其上增加 BYOK、供应商路由器、记忆插件、skills、文档审计工具或浏览器外壳。这让竞争态势不再是“从工具 A 切换到工具 B”,而是“保留工具 A,再补上缺失的基础设施”。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Spec Kit | GitHub | 规格驱动的开发工具包,将规格、计划和任务转化为可执行的代理工作流 | 需求尚未明确,代理就开始写代码 | Python CLI、模板、文档站点、30 多种代理集成 | 已发布 | 仓库 文档 |
| OmniRoute | diegosouzapw | 提供路由、压缩和回退能力的本地 AI 网关,可连接数百家供应商 | 供应商限额、API 碎片化和意外账单会打断会话 | TypeScript、兼容 OpenAI 的 REST、MCP、A2A、压缩 | 已发布 | 仓库 |
| CodeGraph | colbymchenry | 面向编程代理的预索引本地代码知识图谱 | 代理反复探索大型仓库,浪费 token | TypeScript、tree-sitter、SQLite/FTS5、MCP | 已发布 | 仓库 |
| claude-mem | thedotmack | 面向 Claude Code 及相关工具的持久化记忆压缩系统 | 会话失忆和反复加载上下文 | TypeScript、SQLite、Bun、hooks、Chroma | 已发布 | 仓库 |
| Agentic Awesome Skills | sickn33 | 包含 1,935 个可复用代理技能和插件包的可安装库 | 代理从空白状态开始,用户需要反复手动提示 | TypeScript/npm、SKILL.md、bundles、plugins |
已发布 | 仓库 |
| agentic-seo | addyosmani | 审计文档和网站对代理的可发现性与可解析性的 CLI | AI 编程代理无法可靠地使用面向人类编写的文档 | JavaScript/Node、Cheerio、Remark、tokenizer | 已发布 | 仓库 |
| TailClaude | rohitg00 | 面向浏览器的 Claude Code 界面,提供会话历史和成本仪表盘 | 在许多配置中,远程和移动使用仍依赖 SSH/tmux | Node.js、Tailscale、SSE、iii engine | Beta | 仓库 |
| Trishool AI | @trishoolai | 围绕代理行为提供输入/输出控制和漂移检查的防护层 | 提示注入、有害 skills 和不安全的工具执行 | Constitutional classifier、Subnet 23、工具/API 防护机制 | Alpha | 帖子 |
最清晰的构建模式,是修补代理的失效模式,而不是训练一个新模型。@FareaNFts 挖掘出(25 个赞,7 条回复,4,550 次浏览,29 次收藏)的 OmniRoute 解决配额中断问题,@Suryanshti777 挖掘出(9 个赞,4 条回复,595 次浏览,2 次收藏)的 CodeGraph 解决昂贵的仓库探索问题,@rohanpaul_ai 挖掘出(27 个赞,10 条回复,4,286 次浏览,22 次收藏)的 Spec Kit 解决需求不清问题,@chenzeling4 挖掘出(1 个赞,46 次浏览,1 次收藏)的 claude-mem 则试图解决会话失忆。这些产品各不相同,但都建立在同一个判断之上:模型已经不再是唯一瓶颈。
第二种模式,是让代理生态更清晰、更可复用。@0x_sakata 挖掘出(10 个赞,8 条回复,206 次浏览,3 次收藏)介绍了一个庞大的可安装技能目录,@DanKornas 挖掘出(2 个赞,2 条回复,491 次浏览,2 次收藏)介绍了用于审计 AI 就绪度的 agentic-seo,@tom_doerr 挖掘出(3 个赞,1,587 次浏览,3 次收藏)介绍了 TailClaude,用于消除远程使用 Claude Code 时必须承担的 SSH 和终端负担。

安全本身也成了构建目标。@mizzyonchain 分享了(14 个赞,3 条回复,566 次浏览,1 次收藏)将 Trishool 描述为围绕 shell、文件系统、MCP 服务器、API 和数据库访问的“守护层”。这也契合了当天更广泛的挫败感模式:如果信任边界持续失效,下一层产品更可能是围绕代理构建的护栏,而不只是更好的代理。
另一个规模较小但重要的模式,是随手构建垂直应用。@JadenOnChain 分享了(14 个赞,9 条回复,1,033 次浏览)介绍了一个正在开发中的加密税务模拟器;@FetykoRichard 分享了(4 个赞,3 条回复,61 次浏览)介绍了一个用 Claude Code 加 altFINS API 在一小时内搭出的交易仪表盘。即使还没有公开仓库,这些帖子也表明,“vibe-coded” 产物正逐渐转向狭窄但实用的运营工具,而不只是玩具演示。
6. 新动态与值得关注的内容
OpenAI 公开削弱了一个社区仍在引用的基准
@fanofaliens 挖掘出(2 个赞,23 次浏览,2 次收藏)提到 OpenAI 的警告:SWE-Bench Pro 已不再是可靠的编程基准,因为约 30% 的任务存在问题。这一点很重要,因为基准截图和分数对比每天仍在驱动模型选择讨论;一旦基准本身受到挑战,排行榜上许多看似确定的结论就会变得更加摇摆。
Copilot 代理监督进一步深入移动端和策略工具
@GHchangelog 宣布(5 个赞,930 次浏览,4 次收藏)介绍了 GitHub Mobile 为远程 Copilot CLI 会话提供实时通知,宣布(5 个赞,801 次浏览,1 次收藏)介绍了通过手机使用 Copilot cloud agent 修复合并冲突,宣布(6 个赞,720 次浏览,2 次收藏)介绍了企业托管的 OpenTelemetry 导出。这些更新共同让 Copilot 进一步从“编辑器中的 AI”走向受监控、受策略治理的代理界面。
GitLost 和 GhostApproval 让 AI 编程安全继续占据头条位置
@AndarkFomo 总结道(7 个赞,3 条回复,179 次浏览,1 次收藏)介绍了 GitLost:一种提示注入攻击,攻击者构造的公开 issue 可以诱使 GitHub Agentic Workflows 泄露私有仓库数据;公开的 Noma 文章 解释了代理如何把不受信任的 issue 文本当作指令。@DFIR_Radar 总结道(2 个赞,2 条回复,172 次浏览)介绍了 GhostApproval;公开的 Wiz 文章 描述了一个影响六款主流编程助手的符号链接跟随与审批界面缺陷。
Antigravity 的午饭时间微服务测试,让代理自主性不再那么抽象
@xdadevelopers 报道称(13 个赞,1 条回复,2,793 次浏览,4 次收藏)称,Google Antigravity 2.0 在作者离开期间,构建出了一个包含 SQLite、REST API、分析功能和本地仪表盘的习惯追踪微服务。链接中的 XDA 文章 仍强调后续审查和测试,但在这一组案例中,这是最清晰的公开例子之一,表明代理可以在一次无人值守运行中搭出一个并不简单的应用基础。
7. 机会在哪里
[+++] Limit-resistant agent continuity - @FareaNFts 展示了(25 个赞,7 条回复,4,550 次浏览,29 次收藏)显示了对自动供应商回退的需求;@xmangonic 追踪了(4 个赞,1 条回复,193 次浏览,3 次收藏)显示了人们仍在手动计算重置到期时间;@MengTo 将其视为(60 个赞,11 条回复,9,407 次浏览,45 次收藏)则表明 OSS credits 对开发者具有实际价值。这个机会很强,因为同一个连续性问题同时出现在路由、配额日历和开发者访问计划中。
[+++] Structured context before and during execution - @rohanpaul_ai 使用了(27 个赞,10 条回复,4,286 次浏览,22 次收藏)介绍了用于在写代码前强制明确需求的 Spec Kit;@chenzeling4 使用了(1 个赞,46 次浏览,1 次收藏)介绍了用于持久化会话上下文的 claude-mem;@Suryanshti777 使用了(9 个赞,4 条回复,595 次浏览,2 次收藏)介绍了用于阻止重复仓库搜索的 CodeGraph。这个机会很强,因为需求质量、记忆和代码发现都在同一天以不同形式暴露为独立故障。
[++] Enterprise trust, audit, and guard layers - @TheHackersNews 报道称(20 个赞,1 条回复,10,000 次浏览,5 次收藏)显示了端点警报冲突;@AndarkFomo 报道称(7 个赞,3 条回复,179 次浏览,1 次收藏)介绍了 GitLost;@DFIR_Radar 报道称(2 个赞,2 条回复,172 次浏览)介绍了 GhostApproval;@mizzyonchain 分享了(14 个赞,3 条回复,566 次浏览,1 次收藏)则介绍了作为防护层的 Trishool。这个机会中等偏强,因为痛点很明显,但市场上已经开始涌现安全封装层和治理控制方案。
[++] Agent-readable docs and reusable workflow packaging - @DanKornas 分享了(2 个赞,2 条回复,491 次浏览,2 次收藏)介绍了 agentic-seo;@0x_sakata 分享了(10 个赞,8 条回复,206 次浏览,3 次收藏)则介绍了一个包含 1,935 个技能的可安装目录。这个机会中等,因为它确实填补了现实缺口,但多个开源答案已经开始成形。
[+] Domain-specific agent-built micro-apps - @xdadevelopers 展示了(13 个赞,1 条回复,2,793 次浏览,4 次收藏)展示了 Antigravity 生成完整习惯追踪微服务;@JadenOnChain 开始了(14 个赞,9 条回复,1,033 次浏览)展示了加密税务模拟器;@FetykoRichard 构建了(4 个赞,3 条回复,61 次浏览)展示了使用 Claude Code 加 API 构建的交易仪表盘。这个机会正在浮现,因为趋势已经可见,但大多数案例仍处于早期阶段,验证也较为有限。
8. 要点
- 如今评判模型竞争,不只看原始排名,也看成本和基准质量。 @ArtificialAnlys 展示了(740 个赞,57 条回复,700,585 次浏览,112 次收藏)解释了 Grok 4.5 为何受到关注;与此同时,@fanofaliens 流传出(2 个赞,23 次浏览,2 次收藏)提到了 OpenAI 关于 SWE-Bench Pro 已不再可靠的警告。
- Copilot 的叙事已从发布转向可运营性。 @github 宣布(198 个赞,16 条回复,39,931 次浏览,106 次收藏)介绍了面向所有套餐的应用;@code 新增了(102 个赞,10 条回复,12,482 次浏览,29 次收藏)介绍了浏览器工具和成本可视化;@GHchangelog 新增了(5 个赞,930 次浏览,4 次收藏)介绍了移动端实时通知,以及 托管遥测导出(6 个赞,720 次浏览,2 次收藏)。
- Antigravity 正被当作执行层,而不只是提示词试验场。 @GoogleDeepMind 推出了(460 个赞,35 条回复,53,146 次浏览,130 次收藏)介绍了一个官方 skill;@rohanpaul_ai 描述为(41 个赞,15 条回复,6,132 次浏览,14 次收藏)介绍了托管代理基础设施;@xdadevelopers 展示了(13 个赞,1 条回复,2,793 次浏览,4 次收藏)则展示了一个午饭时间完成的微服务构建案例。
- 最活跃的开发者正在封装现有代理,而不是取代它们。 @FareaNFts 挖掘出(25 个赞,7 条回复,4,550 次浏览,29 次收藏)的 OmniRoute、@Suryanshti777 挖掘出(9 个赞,4 条回复,595 次浏览,2 次收藏)的 CodeGraph、@chenzeling4 挖掘出(1 个赞,46 次浏览,1 次收藏)的
claude-mem,以及 @0x_sakata 挖掘出(10 个赞,8 条回复,206 次浏览,3 次收藏)的 1,935 技能可安装库,都是如此。 - 信任边界和仓库上下文,仍是主流用户真正安心使用这些工具的最大障碍。 @TheHackersNews 报道称(20 个赞,1 条回复,10,000 次浏览,5 次收藏)介绍了端点警报冲突;@AndarkFomo 报道称(7 个赞,3 条回复,179 次浏览,1 次收藏)介绍了 GitLost;@DFIR_Radar 报道称(2 个赞,2 条回复,172 次浏览)介绍了 GhostApproval;@RickStrahl 展示了(3 个赞,3 条回复,427 次浏览)则提到了 Copilot App 的一个仓库目标定位缺陷。