Twitter AI 编程 - 2026-07-10
1. 人们在讨论什么
1.1 Agent harness 本身成了产品(🡕)
与 7 月 9 日以 GPT-5.6 发布为中心的讨论相比,7 月 10 日的关注点又往外移了一层,转向 Agent 周边的运行界面。最强势的帖子不再只是“新模型”发布,而是具体展示 Beta 版、自动化、验证闭环、桌面封装和编排器如何让长时运行的编程会话变得可管理。至少有六条保留内容都指向同一个变化:大家关注的重点正从原始能力转向可用工作流。
@thdxr 打开了(353 个赞、43 条回复、16,741 次浏览、103 个收藏)介绍了 OpenCode 2.0 beta,并罕见地明确列出了一长串注意事项:数据单独存储、数据可能被清空、部分功能损坏、v2 API 尚未定稿,以及内置技能。Beta 文档进一步说明,这是真正的过渡阶段,而不只是预告:目前安装要通过 @opencode-ai/cli@next,临时二进制文件是 opencode2,而且现阶段只支持包管理器安装。
@burkeholland 展示了(18 个赞、3 条回复、1,756 次浏览、6 个收藏)展示了 GitHub Copilot App 每天早上对 Gmail 进行分诊:置信度高于 95% 时自动执行操作,并根据反馈更新自身的 learnings.txt。这是本组内容里最清晰的“Agent 作为日常操作员”案例之一。

@JamesMontemagno 询问了(19 个赞、2,902 次浏览、6 个收藏)展示了 Copilot App 如何像真实用户一样走完整个 Copilot SDK 工作坊流程、创建 issue,并验证流程的每个环节;链接中的 仓库 则介绍了一个动手实践式 SDK 工作坊,以及基于 Playwright MCP 构建的无障碍报告。@GithubProjects 重点展示了(4 个赞、2,361 次浏览、1 个收藏、2 次转发)展示了 CodeNomad 作为围绕 OpenCode 的桌面控制台;其公开页面 仓库 将其定位为高级工作区,支持多实例会话、远程访问、git worktree 和 sidecar。
讨论洞察: OpenCode beta 帖子的回复并没有争论 Agent 原生终端有没有意义,而是立刻开始测试边界在哪里:临时文档、子 Agent 卡死,以及 v2 是否仅限 TUI。大家的兴趣是真实的,但也同样预期这些界面在公开测试中依然会出问题。
与前一天的对比: 7 月 9 日讨论的是 GPT-5.6 如何同时出现在 Microsoft、GitHub 和 ChatGPT Work 里。7 月 10 日讨论的则是发布页关闭之后人们真正要做什么:处理收件箱分诊、验证工作坊,或者协调多个会话。
1.2 Google 和 Meta 竞争的是整套技术栈,而不只是单个模型(🡕)
第二大讨论集群仍然围绕模型竞赛,但公开证据主要体现在产品封装、发布入口和互联生态。人们比较的是每一套技术栈到底有多完整:模型、IDE、Agent API、技能、额度和产品界面是否被一起打包。
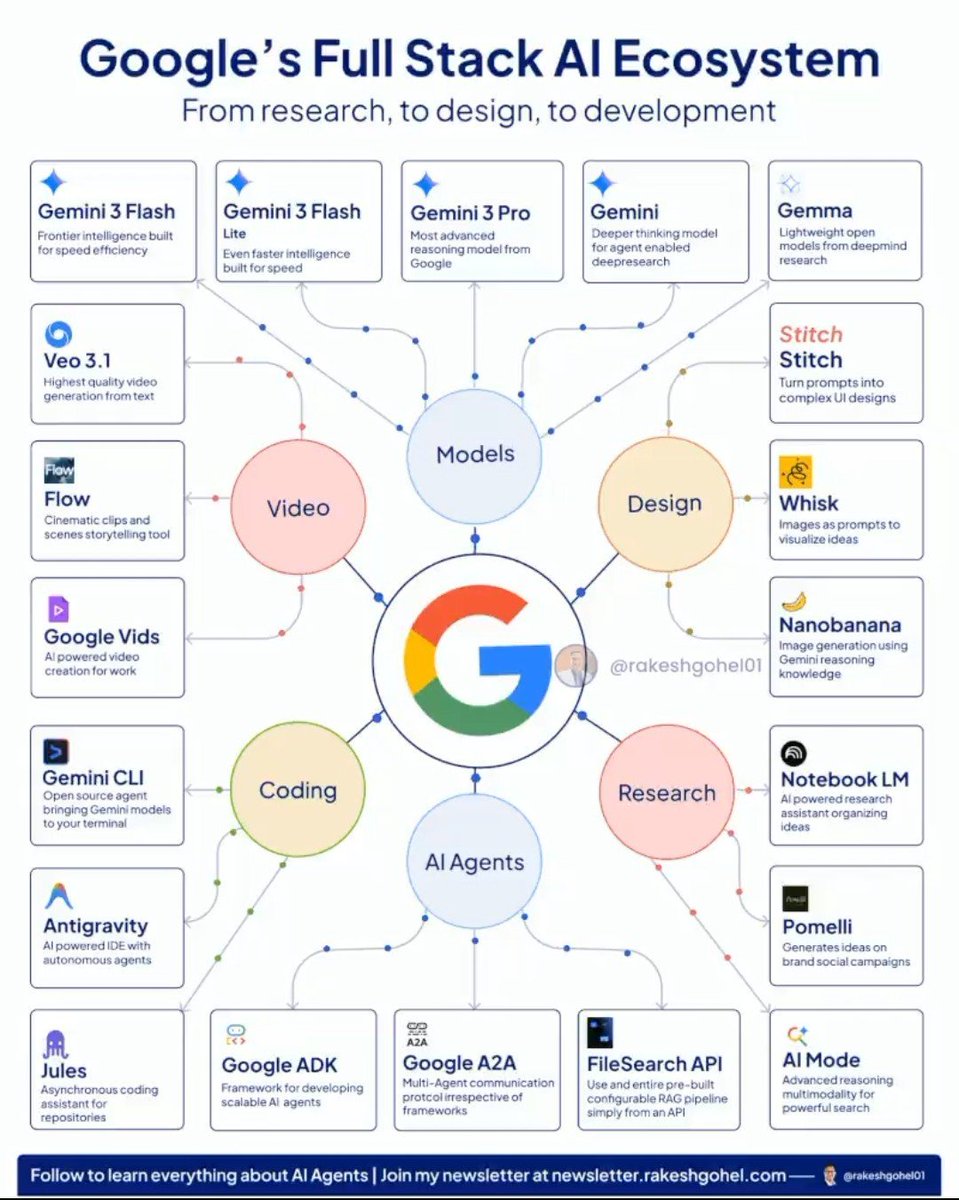
@RamSingh_369 认为(85 个赞、20 条回复、976 次浏览、17 个收藏)称,Google 正试图掌控“整个 AI Agent 生态系统”;随附的架构图则把 Gemini、Gemma、Veo、Stitch、NotebookLM、Gemini CLI、Antigravity、Jules、ADK、A2A 和 FileSearch API 归入同一套可视化堆栈,让这一说法变得具体。
@pamelafox 报道称(11 个赞、2 条回复、678 次浏览、2 个收藏)称,GPT-5.6 Sol、Terra 和 Luna 已经同时出现在 Microsoft Foundry 和 VS Code 里的 GitHub Copilot 中;她的截图既给出了发布落地的证据,也补充了 Sol 的定价与配置细节。Meta 这边,@Rakib_Web3 声称(7 个赞、3 条回复、184 次浏览、2 个收藏)称,Muse Spark 1.1 在 SWE-bench 和 Terminal-Bench 上大约达到 80%,而标价约为 Fable 5 或 GPT-5.5 的十分之一;与此同时,@StudentOffersHQ 分享了(4 个赞、1 条回复、265 次浏览、1 个收藏)称,Meta Model API 上线时将提供 20 美元免费开发者额度,用于试验 Muse Spark。

@Reuters 报道称(6 个赞、6 条回复、21,808 次浏览、3 个收藏)称,ChatGPT Work 正被定位为面向白领工作者的产品,让他们获得编程能力而不必承受同样的价格冲击。另一条信号较弱、但很能说明问题的配套帖子来自 @GamsGo_Global 表示(1 个赞、1 条回复、30 次浏览、1 个收藏),称更大的故事是 OpenAI 正把 AI 变成一个“完整的工作层”,并用一张卡片汇总插件、网站、定时任务和桌面应用封装。
讨论洞察: 最强的帖子并没有把“谁赢了”理解为某一条基准测试曲线,而是理解为生态是否完整:模型托管在哪里、有哪些额度、周围有什么 Agent 运行时,以及有多少相关工具已经讲同一种“语言”。
与前一天的对比: 7 月 9 日已经出现生态系统层面的讨论,尤其集中在 Microsoft 和 Google。7 月 10 日则把这件事从叙事推进到了凭证层面:真实的 Foundry 截图、真实的 API 额度,以及真实的架构图。
1.3 技能、数据集和 harness 套件不断变成一等产品(🡕)
另一个明显变化是,人们不再只是分享提示词或零散仓库,而是在交付可安装的技能包、harness“操作系统”和 Agent 轨迹数据集,把编程工作流本身当作产品。
@HowToPrompt__ 推广了(6 个赞、3 条回复、744 次浏览、8 个收藏)把 ECC 称为“AI Agent harness 的操作系统”;其公开页面 仓库 以 228,293 个 star 和覆盖多种编程客户端的工作流/记忆/安全堆栈支撑了这一定位。@chenzeling4 重点展示了(3 个赞、226 次浏览、5 个收藏、1 次转发)介绍了 Nature Skills;其公开页面 仓库 描述了一个包含 17 项技能的双语研究套件,覆盖文献检索、写作、评审模拟、绘图、引文审计和修订回复,可用于 Claude Code、Codex、OpenClaw、OpenCode 和 Hermes。

@aquiles_ai 介绍了(1 个赞、1 条回复、18 次浏览、1 个收藏)把 Alexander-Agentic 介绍为一个包含 10,852 个样本的 Agent 轨迹数据集,附带图表拆解了 harness 使用情况和模型分布。@WalrusProtocol 宣布了(13 个赞、2 条回复、4,146 次浏览、1 个收藏)展示了可直接安装的 Walrus Agent Skills;@apify 展示了(6 个赞、2 条回复、320 次浏览、2 个收藏)则从工具侧展示了同样的模式:把 Apify actors 接入 Antigravity。
讨论洞察: 这一集群表明,分发模式正在成熟。构建者越来越少对用户说“这是个很酷的模型”,而是越来越多地说“这是你今天就能安装的工作流包、技能库、数据集或 harness 层”。
与前一天的对比: 7 月 9 日已经有编排和记忆封装。7 月 10 日则把它扩展成更工业化的工作流分发:完整的 harness 操作系统、完整的仓库式技能库,以及面向未来调优的公开轨迹语料。
1.4 信任问题从模型质量转向配额、边界和隐藏控制项(🡒)
最后一个主要主题是运营层面的信任。很多抱怨并不是模型太笨,而是宿主产品施加了错误的限制、把关键控制项藏了起来,或忽略了预期的运行模式。
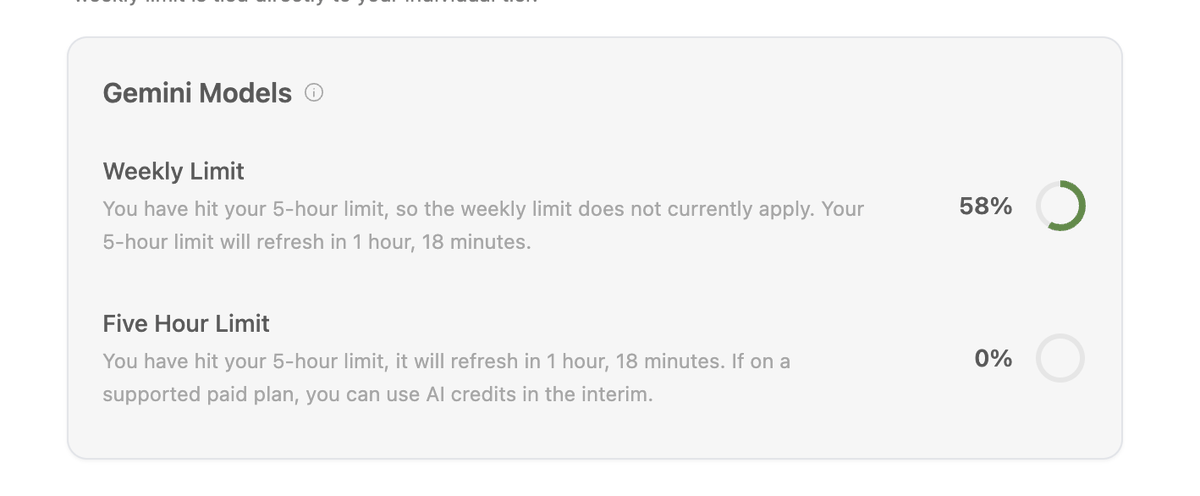
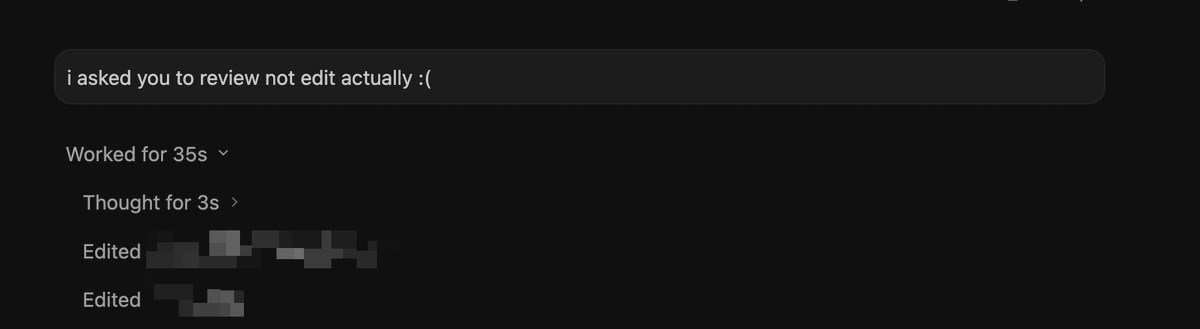
@ASalvadorini 展示了(4 个赞、2 条回复、252 次浏览、1 次引用)展示了一种 Antigravity/Gemini 状态:尽管每周配额还剩 58%,五小时上限却已经完全耗尽。@jc_coder1 抱怨(2 条回复、95 次浏览)称,Antigravity 在被要求“其实是审查,不要编辑”之后仍然改动了文件;@gavinpurcell 认为(3 个赞、2 条回复、257 次浏览)则称,相比 Codex,Claude 的使用情况标签页藏得太深。
@Geebonics 表示(4 个赞、2 条回复、390 次浏览)称,Codex 几乎从移动应用里“消失”了,直到他意识到它被移到了新的“Remote”标签下;@jfversluis 询问了(2 个赞、2 条回复、196 次浏览)则呼吁提供一个 Copilot 桌面视图,在一个地方显示所有仍然打开的 PR 会话及其最新状态。共同点并不是智能不足,而是缺少对 Agent 在做什么、处于什么状态、以及还剩多少空间的可见性。
讨论洞察: 社区一直在用不同的话要求同一件事:让控制平面可见。这意味着要展示配额、模式、审查状态、未解决线程,以及 Agent 究竟被允许执行操作还是只能查看。
与前一天的对比: 7 月 9 日的信任讨论更偏向安全故障和误导性批准。7 月 10 日仍然是在谈信任,但用的是日常操作员的语言:隐藏的使用面板、范围搞错的操作,以及难以检查的会话状态。
2. 什么让人感到沮丧
限制和使用可见性仍在打断真实工作
严重程度:高。@ASalvadorini 展示了(4 个赞、2 条回复、252 次浏览、1 次引用)称,即使每周配额还有余额,碰到 Antigravity 的五小时上限也会直接卡住工作;@LearnInvest2026 分享了(1 个赞、2 条回复、86 次浏览)则晒出了 GPT-5.6 Sol 的推理设置、剩余配额、额外重置次数和缓存命中收益,因为这些控制项已经成为他评估这次发布的核心依据。@gavinpurcell 认为(3 个赞、2 条回复、257 次浏览)称,Claude 的使用情况面板藏在头像菜单后面是个 UX 错误,原因就在于他“总是在看它”。人们的应对方式是手动盯配额、按可持续运行时间而不是按基准测试比较宿主,并优先选择把消费或重置状态明显展示出来的产品。这一点值得构建,因为会话连续性仍然受制于隐藏或错配的控制项。
仅审查、状态跟踪和模式边界仍然很容易失效
严重程度:高。@jc_coder1 抱怨(2 条回复、95 次浏览)称,Antigravity 里的 Gemini 在被明确要求只做审查后仍然编辑了文件,截图把这一失败展示得很具体,而不是停留在假设层面。@jfversluis 询问了(2 个赞、2 条回复、196 次浏览)呼吁提供一个 Copilot 桌面视图,把打开的 PR、最新状态和未解决的审查线程汇总起来;而 @JamesMontemagno 使用了(19 个赞、2,902 次浏览、6 个收藏)则让 Copilot App 走完整个工作坊并提交 issue,因为他仍然需要明确的外部验证,来确认 Agent 哪些地方出错或遗漏。
@ArghZero 提出了(2 条回复、15 次浏览)介绍了“PACU”——即暂停并检查理解——作为一种手动补救办法:强制 Agent 在开始任何工作前先复述任务。这一点值得构建,因为代价最高的失败不是语法错误,而是“模式错了、动作错了、状态错了”,用户往往是在时间已经花掉之后才意识到。
产品入口分散,边界依然难懂
严重程度:中。@Reuters 报道称(6 个赞、6 条回复、21,808 次浏览、3 个收藏)称,ChatGPT Work 的目标是把编程能力带进白领工作流,同时避免同样的价格冲击;@GamsGo_Global 总结了(1 个赞、1 条回复、30 次浏览、1 个收藏)则把同一变化概括为 OpenAI 正在成为一个由插件、网站、定时任务和桌面工具构成的“完整工作层”。然而,@Geebonics 表示(4 个赞、2 条回复、390 次浏览)表示,他一度以为 Codex 已经从移动端消失,后来才发现它其实被挪到了“Remote”下面;而在 @satyanadella 包括了(1,748 个赞、105 条回复、212,023 次浏览、290 个收藏)的回复里,也有人表示,相比继续强调更强的推理能力,先修好记忆和产品混乱更重要。这一点值得构建,因为用户仍然要花时间弄清 Agent 到底在哪、叫什么、以及哪个界面负责哪项工作。
3. 人们希望存在什么
一个统一管理会话、PR 和长时运行 Agent 工作的控制塔
最清晰、最实际的愿望并不是“再给我一个模型”,而是“把我已经委派出去的工作状态展示给我看”。@jfversluis 询问了(2 个赞、2 条回复、196 次浏览)呼吁提供一个 Copilot 桌面视图,把所有仍未关闭的 PR 会话及其最新状态集中到一起;与此同时,GitHub 自己的 更新日志 表示,最新 GitHub Mobile 版本刚刚加入了按活跃会话、状态、仓库、类型、Agent 以及“需要关注”排序的筛选功能。公开页面 CodeNomad 仓库,以及 @GithubProjects 帖子(4 个赞、2,361 次浏览、1 个收藏、2 次转发)之所以引发共鸣,原因也在这里:人们想要的是会话管理、远程访问,以及围绕长程编程任务的单一控制台。机会:直接。

更好的“先停下、先复述、再行动”保护机制
人们反复要求一种轻量工作流,在 Agent 接触文件前就防止代价高昂的误解发生。@ArghZero 提出了(2 条回复、15 次浏览)提出 PACU——暂停并检查理解——就是为了让 Agent 在开始一轮长时间编码前先复述任务;@jc_coder1 展示了(2 条回复、95 次浏览)则在 Antigravity 本应只做审查却改了文件之后,说明了它为什么重要。@JamesMontemagno 使用(19 个赞、2,902 次浏览、6 个收藏)让 Copilot App 验证工作坊并提交 issue,也是在用更操作化的方式表达同一个需求:先验证,再信任这次运行。机会:直接。
可复用的领域技能,而不是一次性提示
对可安装工作流包的需求已经非常明显。@WalrusProtocol 分享了(13 个赞、2 条回复、4,146 次浏览、1 个收藏)介绍了 Walrus Agent Skills,作为可直接用于多个编程 Agent 的即插即用包;@apify 展示了(6 个赞、2 条回复、320 次浏览、2 个收藏)展示了一个 Antigravity 获客流程;@chenzeling4 重点展示了(3 个赞、226 次浏览、5 个收藏、1 次转发)则介绍了包含 17 项技能的 Nature Skills 研究套件。人们要的不是抽象的“更好的 AI”,而是已经预先构建好的、可复用的工作流,知道某个领域的步骤、产物和审查节点。机会:竞争型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-5.6 Sol / Terra / Luna | 前沿模型家族 | (+/-) | 已出现在 Foundry 和 Copilot 中;宿主侧分层清晰;Sol 已开始吸引同事从 Opus 转用 | 用户仍然通过宿主限制、混乱的产品边界和隐藏的使用面板来评价它 |
| ChatGPT Work / Codex 界面 | 工作区 + Agent 界面 | (+/-) | 围绕插件、网站、定时任务、桌面端和远程执行形成了更完整的工作封装 | 用户仍然难以分清 Codex 的边界,以及 Work/Remote 从哪里开始 |
| Google Antigravity | Agent IDE / 平台 | (+/-) | 生态契合度强、规格优先工作流、Managed Agents API,以及清晰可见的集成势头 | 五小时配额痛点、审查模式失效,以及相比直接编辑更高的规划成本 |
| Muse Spark 1.1 / Meta Model API | 前沿模型 + API | (+/-) | 低成本试验叙事、公开预览 API 额度,以及偏基准导向的强营销 | 大多数证据仍处于早期,而且很大程度上通过宣传式对比来呈现 |
| GitHub Copilot App | Agent 工作区 / 自动化 | (+) | 具体自动化、画布、工作坊验证,以及移动端不断增强的会话管理能力 | 用户仍然想要更好的 PR 汇总、仓库定向和更清晰的会话状态可见性 |
| OpenCode 2.0 | 终端 Agent / TUI | (+/-) | 公测势头强、内置技能、UX 口碑高,并且在冷启动性能上有可量化改进 | Beta 限制写得很明确:可能清空数据、插件不兼容、API 未完成、文档仍是临时版本 |
| Claude Code | CLI 编程 Agent | (+/-) | 在直接对比中展现出较强的设计判断,大量命令能力,以及持续扩张的插件/技能生态 | 使用问题仍是常见抱怨,用户甚至开始自创 PACU 式保护流程来减少误解 |
| Agent Zero | 编排器 / 框架 | (+) | 不断扩展的编排器,可驱动多个编程客户端,并提供丰富的设置、插件和界面控制 | 配置面越大,产品的学习与管理复杂度也越高 |
| ECC | Harness 操作层 | (+) | 安装基础庞大,围绕技能、Agent 和命令有明确产品定义,并支持跨客户端工作流封装 | 体量大到更像一个系统,而不是轻量插件 |
| Nature Skills | 技能包 | (+) | 面向研究密集型编程与写作任务的专用套件,可用于多个 Agent 宿主 | 它本就是为特定场景设计,因此价值取决于是否匹配正确的科研工作流 |
总体来看,满意度区间仍然围绕“有用,但前提是宿主界面得对”。人们愿意尝试 GPT-5.6、Muse Spark 和 Antigravity,但衡量它们时,越来越看重的是配额行为、发布摩擦和工作流可见性,而不只是原始基准分数。最常见的补救方式包括明确的预算纪律(工作论文指南)、PACU 式复述检查(帖子),以及在核心 harness 外再套一层封装或仪表盘,而不是直接相信基础界面。
迁移模式也很务实。@pamelafox 表示(11 个赞、2 条回复、678 次浏览、2 个收藏)称,同事已经在 Microsoft 托管的界面里从 Opus 转向 Sol;与此同时,XDA 的对比在同一份网站需求上仍然更偏向 Claude Code,而不是 Codex 和 Antigravity。因此,竞争态势呈现分裂:模型仍在成本/性能上竞争,但真正决定产品胜负的故事,越来越取决于宿主是否给了用户足够的控制、可见性和可复用工作流结构。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| OpenCode 2.0 | @thdxr | 带内置技能和全新 v2 运行时的 Beta 终端 Agent | 早期 OpenCode 的插件/API 模式老化,以及工作流易用性不足 | TUI、内置技能、多供应商 LLM 连接 | Beta | 文档、帖子 |
| CodeNomad | NeuralNomadsAI | 围绕 OpenCode 的桌面控制台,支持会话管理、远程访问和 worktree 感知界面 | 仅靠原始终端很难监控长时间运行的 AI 编程会话 | TypeScript、OpenCode、git worktree、sidecar | Beta | 仓库、帖子 |
claude-video /watch |
bradautomates | 让编程 Agent 能直接检查视频帧和转录内容的插件/技能 | 只看转录的摘要会漏掉屏幕上真正发生了什么 | Python、yt-dlp、ffmpeg、字幕/Whisper 回退、Claude Code/Codex/Cursor/Copilot/Gemini CLI | 已发布 | 仓库、帖子 |
| BeaverMath | CharlesScottBradley | 终端数学渲染器,把 LaTeX 变成易读输出且不改动源文本 | 原始 ASCII 数学表达式在 Agent 终端里难以阅读 | Rust、终端渲染、LaTeX 解析 | Alpha | 仓库、帖子 |
| ECC | affaan-m | 带技能、Agent、记忆和安全模式的 Agent-harness 操作系统 | 临时拼接式 harness 搭建,以及不一致的 Agent 工作流 | JavaScript、shell、TypeScript、Python、Go、Java | 已发布 | 仓库、帖子 |
| Nature Skills | Yuan1z0825 | 包含 17 项技能的研究套件,覆盖文献检索、写作、绘图和评审工作流 | 学术与科研任务需要比通用编程提示更强的任务结构 | Python、markdown 技能、Claude Code/Codex/OpenClaw/OpenCode/Hermes | 已发布 | 仓库、帖子 |
| Agent Zero v2.4 | agent0ai | 可驱动多个编程客户端并提供更广控制面的编排器 | 团队希望在多个 harness 之上有一个统一编排器,而不是每个工作流一个 harness | Python、Linux 桌面环境、插件、MCP/A2A、多客户端编排 | 已发布 | 仓库、帖子 |
| Alexander-Agentic | @aquiles_ai | 面向 Agentic 模型训练的公开 10,852 条 Agent 轨迹数据集 | 前沿模型轨迹和 harness 分布通常不公开 | 数据集、Transformers 消息 schema、多 harness 轨迹 | 已发布 | 帖子 |
| managed-antigravity-gas | codeas | 由技能驱动的工作流,通过 Antigravity 和 Managed Agents API 构建并部署 Google Apps Script | 把一次性的 Workspace 自动化变成无服务器、可复用的 Agent 工作流 | Python、自定义技能、clasp、Gemini Managed Agents API、Google Apps Script |
Alpha | 文章、仓库、帖子 |
| Singularity Grid v1.7.6 | @x402_Layer | 兼容 OpenAI 的工具调用网格,支持 MCP 访问和部署钩子 | 构建者希望拥有超越单一托管助手的工具调用基础设施 | 工具调用、MCP、AI 部署、托管上下文窗口 | 已发布 | 帖子 |
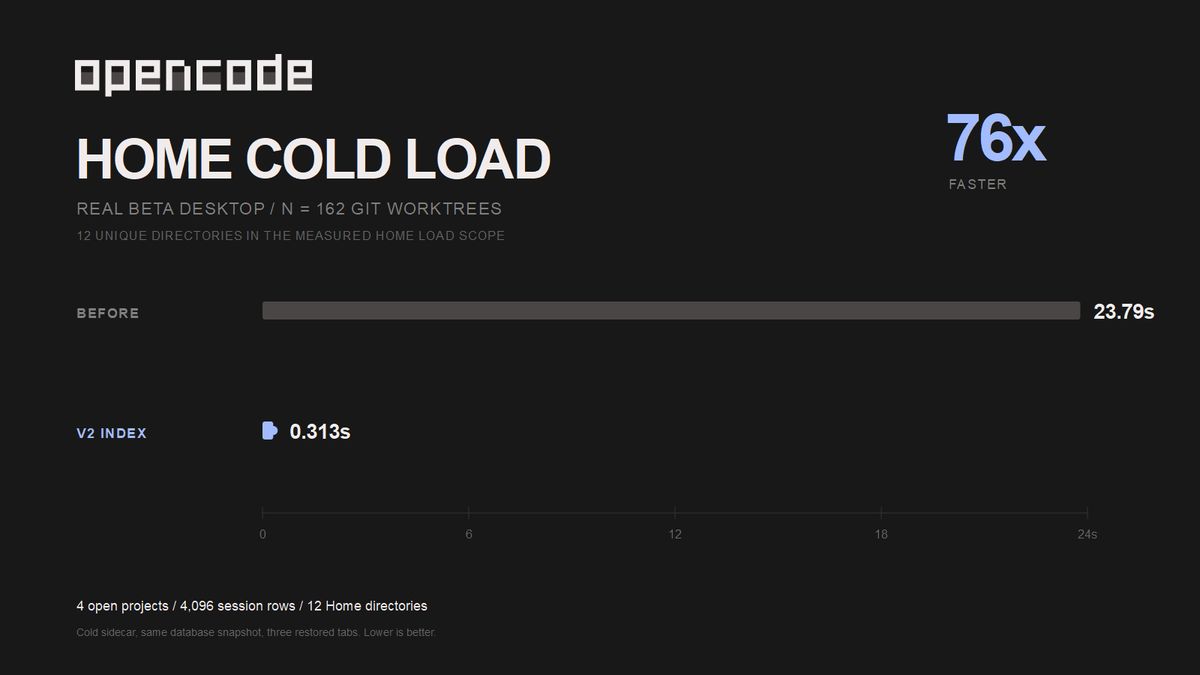
最大的构建集群,显然是围绕现有编程 Agent 的操作层。@thdxr 开启(353 个赞、43 条回复、16,741 次浏览、103 个收藏)的 OpenCode 2.0 beta、@GithubProjects 重点展示(4 个赞、2,361 次浏览、1 个收藏、2 次转发)的 CodeNomad、@Agent0ai 交付(5 个赞、1 条回复、288 次浏览、1 个收藏)的 Agent Zero v2.4,以及 @HowToPrompt__ 提升(6 个赞、3 条回复、744 次浏览、8 个收藏)的 ECC,都指向同一个模式:市场正在围绕 harness 变厚,而不只是围绕模型。就连 @LukeParkerDev 展示(15 个赞、4 条回复、1,157 次浏览、1 个收藏)披露的 OpenCode 性能更新——冷启动从 23.79 秒降到 0.313 秒——也符合这一主题:产品精力正被投入到让 Agent 运行得更顺滑。

另一组则是针对特定工作的工作流封装。@apify 展示了(6 个赞、2 条回复、320 次浏览、2 个收藏)展示了通过 Antigravity 和 MCP actors 做获客,@ivankutil 梳理了(2 个赞、121 次浏览、1 个收藏)展示了通过 Managed Agents API 走无服务器 Apps Script 路径,@WalrusProtocol 发布了(13 个赞、2 条回复、4,146 次浏览、1 个收藏)展示了一个技能分发页面,而 @chenzeling4 披露了(3 个赞、226 次浏览、5 个收藏、1 次转发)则展示了一个公开采用度很高的研究型技能包。公开证据表明,人们已经不再满足于一个通用大助手;他们想要的是可安装的领域工作流。

小而具体的实用工具也不断出现。@beaverd 构建了(43 个赞、5 条回复、3,203 次浏览、9 个收藏)介绍了 BeaverMath,让终端里的公式更易读;@_vmlops 分享了(1 个赞、1 条回复、144 次浏览、1 个收藏)则介绍了一位 VibeJam 获胜者:一名资深 iOS 工程师用 Claude Code 做了一款水豚外卖游戏,并搭配 Suno、ElevenLabs 和 Tripod3D。两类项目差异很大,但触发点相同:一旦 Agent 能承担更多工作,构建者就会开始补齐周边那些细小的易用性缺口。

更偏防御性的构建模式同样重要。@DarkWebInformer 链接了(44 个赞、7,607 次浏览、35 个收藏、8 次转发)介绍了 RemoveWindowsAI;其公开页面 仓库 显示,该项目已有 12,293 个 star,并将自己定位为用于禁用 Copilot、Recall、Input Insights 以及其他相关 Windows AI 组件。即便这是一个反 AI 脚本,它也属于构建者版图的一部分,因为它说明:今天最显眼的一些“AI 编程”项目,其实是围绕人们已经不想要的 AI 界面所构建的控制层或移除层。
6. 新变化与值得关注的内容
反思式记忆不再只是模糊愿景
@antigravity 指出(19 个赞、7,250 次浏览、19 个收藏、2 次转发)指向了一个反思式记忆构建系列,明确区分了“学习用户”“学习工作”以及“界定 Agent 与 harness 的边界”。值得注意的不只是“记忆很重要”——这早已不是新观点——而是实现层面的讨论已经足够结构化,能够被打包成架构和构建指南。
多 Agent 监督屏开始成为故事的一部分
@SPAC89 表示(3 个赞、1 条回复、918 次浏览、2 个收藏)称,连续使用 GPT-5.6 Sol Ultra 12 小时改变了他的工作流,而真正重要的是附带的仪表盘,而不是表述本身:它在同一块面板里展示了并行的审计者、裁判、执行者和流水线架构师。相同的“控制室”逻辑也出现在 GitHub 的 移动端更新日志 中,后者专门为不断增长的 Copilot 会话列表增加了筛选和排序。
OpenCode 的性能优化看起来是可量化的,而不是口号式的
@LukeParkerDev 报道称(15 个赞、4 条回复、1,157 次浏览、1 个收藏)称,OpenCode Desktop 2 的首页加载已经重做,随附的基准测试页量化了这一改进:在一个包含 162 个 git worktree 的桌面环境中,加载时间从 23.79 秒降到 0.313 秒。这再次提醒人们,Agent 工具的成败仍然取决于普通的延迟,而不只是推理基准。
7. 机会在哪里
** [+++] Session-control and review-state dashboards** — Evidence came from multiple directions: @jfversluis 希望 展示了合并后的 PR/会话状态视图,GitHub 的 移动端筛选器更新、抱怨使用入口埋得太深的 @gavinpurcell、对新 Remote 标签感到困惑的 @Geebonics,以及把多 Agent 控制面板做出来的 @SPAC89,都指向同一个缺口。这个机会很强,因为用户已经在委派工作,只是还无法足够清晰地检查它。
** +++] 领域专用技能与工作流包** — [@WalrusProtocol、@apify、@chenzeling4 和 @ivankutil 从不同角度展示了同一个需求:人们想要的是已经掌握领域步骤、工具和交接产物的工作流。这一机会很强,因为市场信号并不来自单一仓库或单一生态,而是在研究、存储、获客和 Google Workspace 自动化等多个方向反复出现。
** ++] 支出、配额与主机选择控制平面** — [@ASalvadorini 显示,即使每周仍有余额,五小时上限也会阻断工作;@LearnInvest2026 把重置和缓存指标纳入发布评估;而 @pamelafox 与 @StudentOffersHQ 则说明了发布范围和额度如何改变宿主选择。这个机会属于中等,因为许多工具已经暴露出其中一部分信息,但似乎很少有产品能把使用情况、重置、定价和模型路由整合得足够清楚。
** +] 智能体轨迹数据集与评估成果物** — [@aquiles_ai 发布 Alexander-Agentic,@zenorocha 展示了一个带有工具选择结果的 Fable 5 基准测试,而 XDA 的三方网站对比也共同指向同一个新需求:为这些系统的真实行为提供共享、公开的证据。这一方向仍然很早期,但信号在增强,因为构建者开始把轨迹、评分卡和对比材料本身当作产品来打包。
8. 要点
- ** 讨论焦点已从发布日的模型热度转向操作界面。** OpenCode 2.0 beta、Copilot 自动化、工作坊验证和 CodeNomad 获得的关注,都超过了又一条抽象的基准测试论断。(来源)
- ** Google 和 Meta 两边的全栈生态叙事都更强了。** 证据不只是口号;人们贴出了发布截图、架构图和 API 额度方案,让这种产品封装变得具体可见。(来源)
- ** 信任失灵主要出在控制平面,而不是原始智能。** 用户抱怨五小时上限、隐藏的使用面板、原本只该审查却变成编辑的运行,以及在移动端被重命名或埋藏起来的核心功能。(来源)
- ** 可复用工作流包正在成为围绕编程 Agent 的一个真实产品类别。** Nature Skills、ECC、Walrus Agent Skills、Apify MCP 流程,以及托管式 Antigravity/App Script 搭建,都把结构化工作流分发当作核心价值。(来源)
- ** 公开数据集和基准测试正开始成为基础设施,而不只是营销材料。** Alexander-Agentic 和新的 Fable 5 基准测试,都把 Agent 行为变成了可共享的产物,供他人检查、比较和继续构建。(来源)