Twitter AI 编程 - 2026-07-16
1. 人们在讨论什么
1.1 Google 的编程技术栈持续在公开场合扩张,但 Gemini 3.5 Pro 的消息却变得更不稳了(🡒)
Google 仍是讨论声量最高的单一厂商,但最扎实的证据并非来自已确认的旗舰模型发布,而是生态版图和工作流示例。四条不同线索共同指向同一个大方向:Google 现在已经形成了彼此联通的编程与智能体产品面,但用户依然无法稳定判断下一代旗舰模型究竟何时落地、已核实的规格又到底是什么。
@LuminaXspace 发文称 (214 个赞、13 条回复、13,942 次浏览、24 次收藏) 一份新的 Gemini 3.5 Pro 传闻清单,称目标日期为 7 月 17 日,底层基础已重构,传闻中的上下文窗口为 200 万 token,具备 Deep Think 推理能力,且在编程和长时程智能体表现上更强。同一讨论串里更关键的证据其实是反驳:有回复称 Google 早已否认了 200 万上下文窗口的说法,而且发布时间又一次延后。因此,这条内容体现的更多是关注度与不确定性,而非经过验证的产品细节。
@shubham_crazy08 认为 (85 个赞、8 条回复、3,570 次浏览、48 次收藏) 认为 NotebookLM 加 Antigravity 是一项被低估的杠杆。让这条帖子真正有价值的是他的回复串:他声称这一组合可以生成专门化的 NotebookLM 研究笔记本,基于本地 Markdown 上下文编码定制业务技能,利用 NotebookLM 知识构建具备上下文感知能力的应用,并自动触发音频或报告生成。
@yourtechgirl24 将其概括为 (22 个赞、16 条回复、23,023 次浏览、10 次收藏) 将 Google 描绘成一个端到端的 AI 智能体生态,而不是单纯参与单模型竞赛。随帖信息图是当天最清晰的材料,因为它把 Gemini、Gemma、Stitch、Whisk、NotebookLM、Gemini CLI、Antigravity、Jules、ADK、A2A 和 FileSearch API 放在了一页上;不过也有回复提醒,如果核心模型落后于竞争对手,整合能力也无法完全弥补。

@kenn_ronin 列出了 (67 个赞、34 条回复、9,206 次浏览、18 次收藏) 一套每月 40 美元的可交付技术栈:Claude Code、ChatGPT、可免费使用的 Google AI Pro(用于 Antigravity/Veo/Flow)、免费的 Grok Build/Imagine,以及 Groq 免费层密钥。这一点之所以重要,是因为它说明 Google 的智能体产品面正被当作一套实用多工具组合的一部分,而不只是传闻素材。
讨论洞察: 最明显的分歧并不是反 Google 情绪,而是可信度与层级问题。盯泄露消息的人在日期和规格上争论不休;主张生态价值的人则面对更结构性的质疑:技术栈铺得再广,也回答不了 Gemini 本身是否是最佳编程核心。
与前一天比较: 在 2026-07-15,讨论已经从单一的 Gemini 泄露消息扩展为更广泛的 Google 平台地图。到 2026-07-16,这张地图仍在延续,但证据进一步偏离了“即将发布”的确定性,转向生态定位和 Antigravity 的实际用例。
1.2 开发者更偏向评测闭环、技能和工单式分工,而不是通用智能体 SDK(🡕)
最具技术含量的帖子并不是又一款模型发布,而是如何让智能体更可靠:把评判与修复分开、把可复用能力打包成技能、把委派范围收窄到足够明确、可以像工单一样处理的任务。这比前一天“加固工作流”的主题更强,也更具体。
@Saboo_Shubham_ 分享了 (62 个赞、15 条回复、4,010 次浏览、69 次收藏) Google 面向编程智能体推出的新“质量飞轮”技能。Google 的 开发者博文 表示,该技能把智能体 QA 拆成五个阶段:基于轨迹或合成场景准备数据集、运行推理、用 AutoRaters 或自定义评分规则打分、分析失败、再进行有针对性的迭代修复;同一帖子还明确写道,优化器绝不会给自己的工作打分。
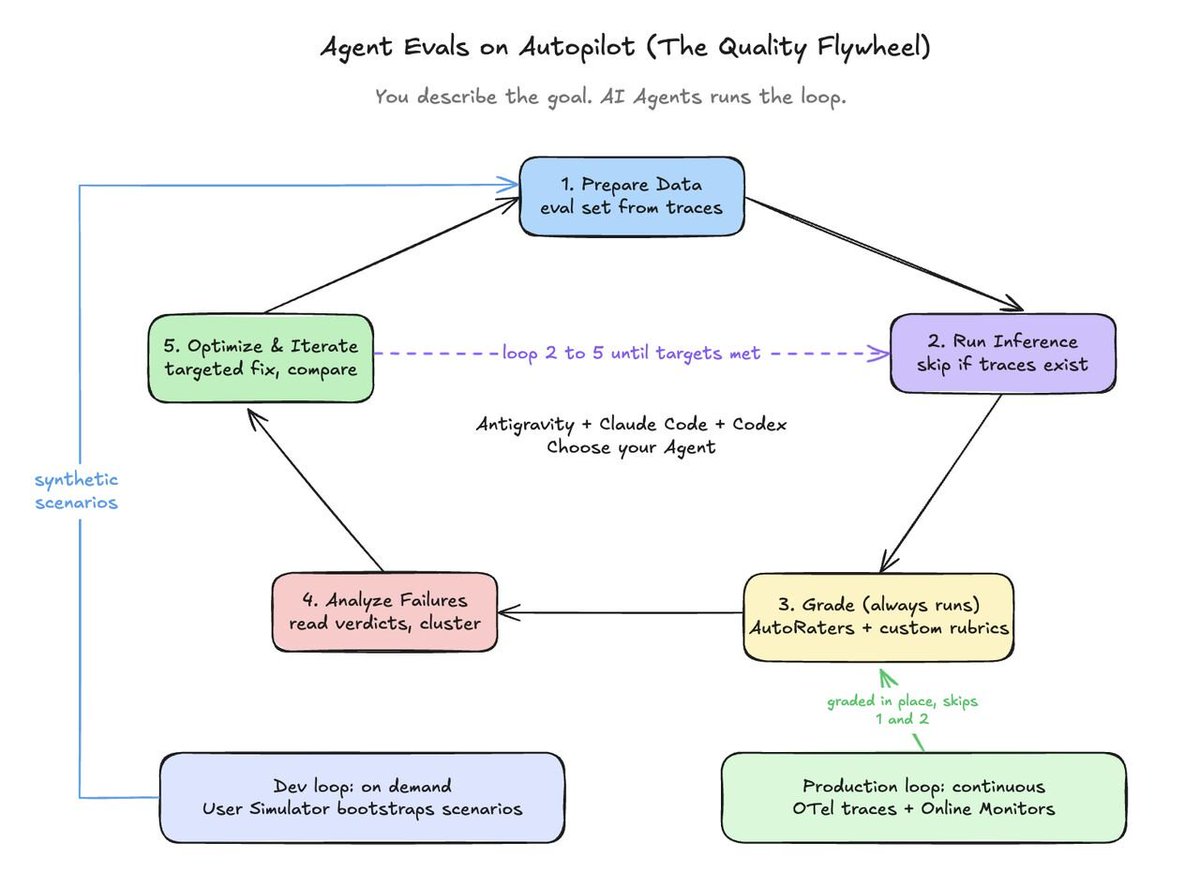
@gakonst 抱怨 (50 个赞、13 条回复、4,084 次浏览、25 次收藏) 认为大多数智能体 SDK 都落后于现实,并点名基于 RPC 的 Codex App Server 是唯一值得借鉴的开源模式。真正让这条抱怨具有参考价值的是回复区:一位回应者主张把沙箱、harness 和工作流存储拆成独立层;另一位则说,他们已经从手写系统迁移到 Pi ACP,再迁移到 Codex App Server,因为通用 SDK 依然无法满足跨线程、跨智能体通信的需求。
@boringmarketer 分享了 (3 个赞、5 条回复、746 次浏览、6 次收藏) 一项 kimi-first 技能:把规格冻结后的实现工单路由给 Kimi Code CLI,同时由 Claude 保留规格、架构、审查、测试和合并批准。该仓库 README 把这套原则说得很明确:Kimi 负责吞吐,Claude 保留判断权,连续失败后就停止委派。
@WebStormIDE 宣布 (52 个赞、3 条回复、2,145 次浏览) WebStorm 2026.2,JetBrains 的 发布公告 表示,这个 IDE 现在已原生集成 GitHub Copilot,并新增智能体技能管理器,可把可复用的技术栈知识带到不同项目中,甚至导入已为 Claude Code 或 Codex 配置好的技能。
讨论洞察: Saboo 的讨论串给出了最尖锐的提醒:实践者表示,证明修复有效这一步仍需要人工核查,因为智能体可能通过那些实质上由自己写出来的评测。更广泛的趋势是,人们要的是更有结构的委派,而不是更多通用封装代码。
与前一天比较: 在 2026-07-15,主要的“纪律化”信号还是 Spec Kit、MCP 工具暴露和 token 压缩技巧。到 2026-07-16,这一模式已经进化为可重复的产品和方法论:明确的评分闭环、可导入技能,以及专门化的实现通道。
1.3 智能体工作正进入 Jira、外部计算后端,甚至物理控制器(🡕)
第三个主题是智能体控制面的扩展。关键变化不只是智能体能在更多地方被监督,而是人们开始期待它们持续在工作流工具里工作、把任务派发到远程算力,甚至通过专用硬件进行操控。
@github 宣布 (162 个赞、14 条回复、37,643 次浏览、51 次收藏) 表示 GitHub Copilot for Jira 已正式可用。GitHub 的 GA 更新日志 说明,这次发布会把智能体进度流式写入 Jira 工单,支持在 Jira 聊天面板中针对同一个草稿拉取请求继续下达指令,并降低连接 GitHub 组织和仓库时的配置摩擦。
@ONcompute 宣布 (16 个赞、9 条回复、1,400 次浏览) 一个 MCP 端点,可让智能体发现算力提供商、编写算法、启动任务,并用自然语言管理存储。这里的配图很关键,因为它们展示了预期架构,以及一个具体的莎士比亚示例:先跑在免费 CPU 上,再切换到 8× H200。这样一来,“智能体可以使用算力”就不再只是笼统说法,而是成了具体执行模式。

@stufflistings 发文称 (25 个赞、9 条回复、2,559 次浏览) 表示 Codex Micro 是一款面向 Codex 智能体的 230 美元控制器。那组评测照片的价值不在装饰,而在信息量:它展示了专用设备本体,以及一份规格表,列出了 Bluetooth/USB-C、Mac/Windows 支持、RGB 灯光、13 个机械开关、触摸传感器、旋转编码器和平面摇杆。

讨论洞察: Jira 那条帖子引发了人们对工单垃圾和自动生成验收标准的质疑;而 Ocean 和 Codex Micro 的帖子则更偏向另一侧:它们卖的是更明确的控制、更强的执行触达,以及更少的应用切换。
与前一天比较: 在 2026-07-15,最有力的证据还集中在如何跨 Jira、移动端、桌面端和硬件观察智能体。到 2026-07-16,这种扩展已经更具操作性:Jira 让智能体留在工作项里,Ocean 把智能体推进远程算力,Codex Micro 则把智能体状态变成了一个物理控制问题。
2. 什么让人感到沮丧
证明智能体是否真的改进了,仍然得靠人工
严重程度:高。@Saboo_Shubham_ 分享了 (62 个赞、15 条回复、4,010 次浏览、69 次收藏) 一套承诺能发现智能体缺陷、修复缺陷并证明修复有效的工作流,但回复很快就把真正的痛点收窄了。一位实践者说,证明这一步仍需要人盯着,因为一个自己编写或塑造评测的智能体,依然可能通过这些评测;另一位则说,卡点在于判断这个修复到底是不是真的对。Google 的博客本身也强化了这一担忧,因为它明确把优化器与评估器分开。之所以值得为此构建工具,是因为当下的替代办法仍然是:让人类去审查那些最关键的前后对比结论。
通用封装和社区插件式胶水依然显得脆弱
严重程度:高。@gakonst 表示 (50 个赞、13 条回复、4,084 次浏览、25 次收藏) 认为大多数智能体 SDK “很烂”,而回复把问题说得更具体:用户想要的是彼此独立的沙箱、harness 和工作流存储层,以及标准化的跨线程、跨智能体通信,而不是浅层 API 包装。在另一条兼容性讨论中,@leerob 回应了 (11 个赞、4 条回复、2,738 次浏览、5 次收藏) 表示 Cursor 订阅可以通过 ACP 或社区插件在开放式 harness 中使用,但提问者回复说,考虑到当前对 npm 安全的担忧,他们不愿安装一个带有订阅访问权限的随机 npm 插件。当前可见的应对方式,是回退到厂商 CLI,或者转向立场更鲜明的 harness。之所以值得为此构建工具,是因为集成便利性目前正与信任直接冲突。
把智能体放进 Jira,会立刻引发对流程垃圾的担忧
严重程度:中。@github 宣布 (162 个赞、14 条回复、37,643 次浏览、51 次收藏) 表示 Copilot for Jira 现在可以流式同步进度,并在 Jira 聊天面板中接受后续指令,但最先出现的可见回应却是在拿“幻觉式验收标准”、自动生成的工单洪流,以及 AI 为停滞工作撰写借口开玩笑。更新日志显示它确实有工作流价值,但公众反应也清楚表明:除非智能体输出被严格概括和约束,否则用户预期管理界面的噪声增长速度会快过代码质量。之所以值得为此构建工具,前提是这些活动能保持可读,而不是不断制造工单杂乱。
当人们无法调试结果时,“vibe coding” 依然像赌博
严重程度:中。@kapilansh_twt 认为 (24 个赞、24 条回复、349 次浏览) 认为 vibe coding “只是另一种赌博”。回复并没有完全反对,更多是在细化这条批评:当人们在不理解如何调试失败的情况下就直接上线,或者 token 开销开始压过工程判断时,它就会变成赌博。这使得这种挫败感比纯粹的反 AI 立场更具可操作性。之所以值得为此构建工具,是因为人们给出的替代办法是流程纪律,而不是放弃这些工具。
3. 人们希望有什么
团队可以信任的独立智能体评分机制
Saboo 的讨论串和 Google 的质量飞轮帖子都指向一个直接、现实的需求:团队希望智能体改进能够被衡量,但又不希望由负责修复的那一方给自己的工作打分。@Saboo_Shubham_ 披露了 (62 个赞、15 条回复、4,010 次浏览、69 次收藏) 这套工作流里,Google 的帖子明确表示优化器和评估器必须解耦,但回复仍然指出,证明这一步往往还是需要人工判断。这不是一种愿景式需求,而是从“演示看起来更好了”到“生产环境确实改进了”之间缺失的信心层。机会:直接。
一张从旗舰模型到编程界面再到智能体基础设施的清晰全图
围绕 Google 的帖子显示,人们需要的是一套真正能推理得清的产品层级。@LuminaXspace 分享了 (214 个赞、13 条回复、13,942 次浏览、24 次收藏) 又一轮 Gemini 3.5 Pro 传闻爆发,@shubham_crazy08 展示了 (85 个赞、8 条回复、3,570 次浏览、48 次收藏) 一个具体的 NotebookLM 加 Antigravity 工作流,以及 @yourtechgirl24 梳理了 (22 个赞、16 条回复、23,023 次浏览、10 次收藏) 更完整的 Google 技术栈,都体现了这种需求。缺失的是一个稳定、公开的答案:到底哪个产品面负责哪项工作,哪些能力是预览性质、哪些是长期可依赖的,以及工作如何在模型、CLI、IDE、异步编程工具和智能体框架之间流转。机会:直接。
具备明确权限、减少信任跃迁的可复用技能
多条帖子都在暗示:技能正在成为智能体能力的基本单元,但还没成为信任的基本单元。@gakonst 批评了 (50 个赞、13 条回复、4,084 次浏览、25 次收藏) 讨论了通用 SDK,@leerob 确认了 (11 个赞、4 条回复、2,738 次浏览、5 次收藏) 表示开放式 harness 可以依赖社区插件,而提问者立刻就担心安装一个带有订阅访问权限、但并不受信任的 npm 包。与此同时,@WebStormIDE 宣布 (52 个赞、3 条回复、2,145 次浏览) 展示了一个把可复用知识当作一等产品界面的智能体技能管理器。人们需要的是在运行前就声明作用范围、来源和访问边界的技能。机会:竞争性。
能把成本、控制权和本地替代方案串起来的技术栈规划
当前可见的技术栈讨论仍是手工的、轶事式的。@kenn_ronin 分享了 (67 个赞、34 条回复、9,206 次浏览、18 次收藏) 一套每月 40 美元的 Claude Code、ChatGPT、Google AI Pro、Grok Build 和 Groq 密钥组合;而 @comma_ai 反驳称 (30 个赞、1 条回复、1,645 次浏览) 则表示,在本地使用 GLM 5.2 加 OpenCode 后,禁用 Anthropic 并未伤害他们的智能体编程。现实需求是一个控制平面,帮助团队在付费闭源工具、免费层级和本地/开源替代方案之间做选择,而不必从零散推文里重新拼出这些权衡。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Google agent-evals skill | 评测工作流 | (+/-) | 为数据集准备、推理、评分、失败分析和迭代提供五阶段闭环,可覆盖 Antigravity、Claude Code 和 Codex | 回复称证明步骤仍需人工判断,因为智能体可能钻自己编写评测的空子 |
| NotebookLM + Antigravity | 研究/编排工作流 | (+) | 据称可启动专门化笔记本、编码定制业务技能、基于笔记本上下文构建应用,并触发报告生成 | 证据仍只来自一位实践者的讨论串,尚未成为广泛验证的模式 |
| Codex App Server over RPC / Pi ACP | 智能体 harness / SDK 模式 | (+/-) | 实践者更偏好它而非通用 SDK 封装,因为它更贴近真实 harness 行为,并支持跨线程或跨智能体工作 | 周边 SDK 生态仍被描述为浅层编排胶水,落后于当前实践 |
| GitHub Copilot for Jira | 工作流集成 | (+/-) | 将智能体进度流式写入 Jira,支持围绕同一草稿拉取请求继续下达指令,并降低配置门槛 | 早期回复预测会出现工单垃圾、AI 撰写评论和幻觉式工作流噪声 |
| WebStorm 2026.2 | IDE | (+) | 提供 TypeScript 7 支持、原生 GitHub Copilot,以及可导入 Claude Code 或 Codex 技能的智能体技能管理器 | 技能仍局限于 JetBrains 环境内,管理器目前也主要围绕 Claude/Codex 工作流 |
| kimi-first | 多智能体委派方法 | (+) | 让 Claude 负责规格、审查、测试和合并批准,同时把规格冻结后的实现工作路由给 Kimi Code CLI | 仅适用于规格已冻结的阶段,且 README 写明连续失败后会停止委派 |
| Tabby | 自托管编程助手 | (+) | 以自包含服务器、OpenAPI 接口、仓库上下文和消费级 GPU 支持,提供 GitHub Copilot 的本地替代方案 | 团队仍需自行运维服务器,企业功能也需单独授权 |
| 40 美元混合 AI 方案 | 预算型技术栈方法 | (+/-) | 一位开发者称,Claude Code、ChatGPT、Google AI Pro、Grok 和 Groq 免费层已经足以交付 | 比较样本仍属个人经验,回复串也显示大家用的是各种定制组合,而非统一标准栈 |
工具组合依然是多元的,而且方法导向很强。@Saboo_Shubham_ 分享了 (62 个赞、15 条回复、4,010 次浏览、69 次收藏) 一套明确把评分与修复分开的工作流;而 @gakonst 认为 (50 个赞、13 条回复、4,084 次浏览、25 次收藏) 则指出,通用智能体 SDK 依然无法覆盖人们实际运行多线程智能体系统的方式。@WebStormIDE 宣布 (52 个赞、3 条回复、2,145 次浏览) 表明,技能复用如今已经成了 IDE 功能,这也契合更大的转向:人们正在从临时提示词走向可安装、可重复的操作规程。
预算与控制权的讨论同样显眼。@kenn_ronin 分享了 (67 个赞、34 条回复、9,206 次浏览、18 次收藏) 一套每月 40 美元的技术栈,@comma_ai 反驳称 (30 个赞、1 条回复、1,645 次浏览) 表示禁用 Anthropic 后,本地的 GLM 5.2 加 OpenCode 反而更好用,而 @DanKornas 将其定位为 (7 个赞、2 条回复、966 次浏览) 则把 Tabby 描述为一种自托管答案,适合那些想要代码补全和聊天能力、但不愿把整套工作流交给托管助手的团队。

5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GitHub Copilot for Jira | @github | 将编程智能体的进度流式写入 Jira 工单,并允许用户围绕同一个草稿拉取请求发送后续指令 | 让工单上下文与智能体执行留在同一工作流中,而不是分散到不同应用 | GitHub Copilot、Jira、草稿 PR 工作流、配置/引导改进 | 已发布 | 推文 · 更新日志 |
| Ocean MCP endpoint | @ONcompute | 将智能体连接到算力提供商,使其能够用自然语言编写算法、启动任务并管理存储 | 把编程智能体从代码编辑扩展到远程算力编排 | 托管式 MCP 端点、Ocean 算力提供商、任务与存储管理 | 已发布 | 推文 · 端点 |
| kimi-first | @boringmarketer | 一项 Claude Code 技能:把规格冻结后的实现工单发送给 Kimi Code CLI,同时由 Claude 保留审查、测试和合并批准 | 把判断工作与高吞吐的代码敲写分开 | Claude Code、Kimi Code CLI、Fable 5、基于技能的委派 | 已发布 | 仓库 · 推文 |
| FlyAI skill | Alibaba FlyAI | 面向 Claude Code 和 OpenClaw 的旅行搜索技能,可从 Fliggy 返回结构化、可预订的结果 | 让智能体无需离开终端就能回答实时旅行查询 | Node.js CLI、FlyAI skill、Fliggy 库存、Claude Code、OpenClaw | 已发布 | 仓库 · 推文 |
| WebStorm 2026.2 agent skills manager | @WebStormIDE | 让团队可以直接在 IDE 中安装或导入可复用的智能体技能 | 减少在不同会话和项目中反复重述技术栈约定 | WebStorm、TypeScript 7、GitHub Copilot、外部技能注册表 | 已发布 | 推文 · 发布说明 |
反复出现的构建模式,是收窄智能体的职责边界,而不是让一个模型包办一切。@boringmarketer 分享了 (3 个赞、5 条回复、746 次浏览、6 次收藏) 一个把“Kimi 负责敲代码,Claude 负责思考与验证”直接写进仓库规则的项目;README 表示,Claude 保留规格、架构、审查和合并批准,而 Kimi 只处理规格冻结后的实现工作。

@tom_doerr 展示了 (6 个赞、11 次收藏、1,558 次浏览) 则展示了另一种模式:通过领域专用技能,让智能体在软件编辑之外也变得有用。FlyAI 仓库 表示,它通过 8 个搜索命令和直接预订链接,把 Claude Code 和 OpenClaw 接入 Fliggy,让智能体会话变成结构化的旅行搜索界面,而不是浏览器宏。

更大的产品团队也在以更大范围交付同样的思路。@github 宣布 (162 个赞、14 条回复、37,643 次浏览、51 次收藏) 表示 Copilot 现在从进度流式同步到会话后的继续引导都留在 Jira 内,@ONcompute 宣布 (16 个赞、9 条回复、3 次引用、1,400 次浏览) 一个面向算力任务和存储的 MCP 产品面,以及 @WebStormIDE 宣布 (52 个赞、3 条回复、2,145 次浏览) 一个 IDE 原生技能管理器。其共同触发因素与报告其他部分一致:团队希望智能体在既有界面内工作,承担更窄的职责,并通过更清晰的交接协同。
6. 新鲜且值得关注
Kimi-K3 一度成为模型对比故事里的头条
@arena 报道称 (127 个赞、15 条回复、25 次引用、6,955 次浏览、8 次收藏) 表示 Kimi-K3 在 Frontend Code Arena 中拿到 1,679 分,高于 Claude Fable 5 的 1,631 分和 GPT-5.6 Sol 的 1,618 分。随帖排行榜把它从第 18 名跃升至第 1 名的变化具体化了,但最早出现的一条实质性回复认为,柱状长度在视觉上夸大了这 48 分的领先,因此,基准结果本身和它的呈现方式共同构成了这条新闻。

本地与开放式编程技术栈得到了更鲜明的公开辩护
@comma_ai 认为 (30 个赞、1 条回复、1,645 次浏览) 表示,禁用 Anthropic 并未伤害他们的智能体编程,因为他们在本地使用 GLM 5.2 搭配 OpenCode。这比泛泛的开源喝彩更具体,尤其因为它与 @kenn_ronin 分享 (67 个赞、34 条回复、9,206 次浏览、18 次收藏) 一套低价混合技术栈,以及 @DanKornas 主推 (7 个赞、2 条回复、966 次浏览) 一台自托管 Tabby 服务器同时出现。值得注意的变化并不是闭源工具消失了,而是本地和开放式替代方案开始被描述为可用于生产,而非意识形态表态。
仓库攻击演练正成为智能体时代运营的一部分
@BradGroux 报道称 (11 个赞、1 条回复、20,281 次浏览) 表示其赢得了 GitHub 的“Repository Under Attack”工作坊,并附上一份已做脱敏处理的事后报告。帖子附图展示了一整条攻击链,涵盖泄露的 PAT、仓库 SSH 密钥、恶意 npm 发布、workflow-dispatch 滥用以及暴露的机密信息,使当天的安全讨论呈现出一种具体的运营形态,而不再只是抽象的“AI 安全”话语。

7. 机会在哪里
[+++] 独立的智能体评分与审批层 — 数据集中最强烈的痛点不是模型能力不够,而是缺乏对“智能体是否真的改进了”的信任。Saboo 的 agent-evals 讨论、Google 的质量飞轮文章、gakonst 对 harness 的批评,以及 Jira 垃圾信息相关回复,都指向同一个缺口:需要一套独立系统来评估工作、暴露操作真正针对的目标,并且只在证据清晰可读时请求审批。
[++] 带来源与权限元数据的可复用技能注册表 — WebStorm 的新技能管理器、kimi-first、FlyAI,以及 Cursor/OpenCode 插件讨论,都表明技能正在成为能力的基本单元。缺失的一层是信任:团队希望可安装技能能声明自己可访问什么、由谁编写,以及何时应停止委派。
[++] 连接工单、算力和本地环境的智能体控制平面 — GitHub Copilot for Jira、Ocean MCP 端点和 Tabby 的自托管主张,都显示出这样一种需求:智能体能够在项目管理工具、远程算力和本地工作流之间切换,同时不丢失状态与可追溯性。机会在交接与监督层,而不只在模型本身。
[+] 面向多模型团队、兼顾预算的技术栈规划 — 那条每月 40 美元技术栈帖子,以及 comma.ai 关于 GLM 5.2 加 OpenCode 的说法,都显示团队已经在手动拼接付费、免费层和本地工具。一个能比较这些选项在成本、控制权和任务匹配度上的规划器,将能回答一个越来越常见的运营问题。
8. 要点
- 最明确的技术热情,集中在让智能体变得可衡量、可治理。 Google 的质量飞轮技能及其讨论,核心都在独立评分、失败分析和人工审批,而不是新的自主性宣称。(来源)
- 可复用技能正在成为智能体能力的一等封装层。 WebStorm 推出了 IDE 内技能管理器,kimi-first 把审查与实现分工正式化,FlyAI 则把旅行工作流做成了可安装的智能体技能。(来源)
- 竞争面正在超出编辑器本身。 Jira 进度流、通过 MCP 调用远程算力,以及 Codex 控制硬件,都表明智能体产品如今竞争的不只是模型输出,还有监督与执行界面。(来源)
- 团队正在积极维持单一厂商智能体栈之外的替代方案。 每月 40 美元的混合技术栈、comma.ai 的 GLM 5.2 加 OpenCode 配置,以及 Tabby 的自托管主张,都说明成本控制与本地掌控权已经是编程智能体讨论的组成部分,而非边缘话题。(来源)