Twitter AI 编程 - 2026-07-19
1. 人们在讨论什么
1.1 技能与规范正被视为围绕智能体的可复用层 🡕
最强烈的实务主题,是把可重复使用的工程判断打包起来,而不是每次都从零开始给模型写提示词。一条高互动帖子将 GitHub 的 Spec Kit 描述为一条六步路径:从项目章程一路走到规范、规划、任务和实施;另一条帖子则把 agent skills 视为可安装的能力库存。相关迹象也表明,发现并不能解决质量控制问题:skills-directory 的作者估计,目录里大约只有一半内容真正有用,并特别指出其中还有一个更小、但值得信赖的核心集合。
@DivyanshT91162 提出(124 次点赞,6 条回复,11,538 次浏览,262 次收藏)Spec Kit 被视为一种工作流,可将一个想法转化为一份可由多个编码智能体执行的动态规范。Spec Kit 仓库 介绍了同样的开源流程,并记录了其 constitution、specify、plan、tasks 和 implementation 各阶段;一条回复还补充了一个重要限制:如果规范本身发生漂移,智能体仍然会出错。
@undefinedKi 重点介绍(89 次点赞,20 条回复,8,833 次浏览,160 次收藏)skills.sh 被视为一个跨智能体的软件包管理器和目录。其附带的目录快照内容相当扎实:它将技能组织为 planning、TDD、debugging、documents、design 和 tooling,而不是把它们当作通用提示词来处理。

讨论洞见: 实际分歧不在于技能是否有帮助,而在于如何筛选。skills.sh 的作者表示,Anthropic、Vercel 和 Obra 的材料构成了可靠的核心,其余内容仍需进一步过滤。
与前一天相比: 7 月 18 日的讨论已经凸显了技能发现的重要性。到了 7 月 19 日,讨论又补上了一个更清晰的互补模式:技能负责打包可复用流程,而规范则约束这些流程要执行的工作。
1.2 长时运行的智能体正被框定为规划与验证问题 🡕
关于 loops、编排和多模型路由的帖子,强调的是执行纪律,而不是单一模型谁更强。具体建议包括:使用可验证的终态、审阅计划而非照单全收、分离创建者与验证者角色,并依据上下文、部署方式、权限和可靠性来路由工作。
@petergyang 分享(14 次点赞,3 条回复,1,435 次浏览,9 次收藏)这是一则对 Claude Code 团队成员的采访,讨论了 /loop、/goal 和工作流。配套的 文章 表示,/goal 需要一个可验证的完成终点,计划应由人工阅读,且将 creator 与 verifier 子智能体分开会很有帮助;其中还提到,Claude Code 的系统提示词已削减 80%。
@prasad_pilla 介绍(6 次点赞,4 条回复,245 次浏览)一种“软件工厂”式方法:Claude 和 GPT 可作为可互换的执行后端,用于规划、读取代码仓库、打补丁、评审、测试、调试和交接。Alan 网站 将模型无关性,以及 SaaS、hybrid、on-prem 和 air-gapped 部署,视为产品层面的选择,这与原帖对路由和运行可靠性的强调一致。
@Trion129 报道(3 次点赞,1 条回复,167 次浏览,4 次收藏)使用 oh-my-opencode-slim 可在保持质量尚可的同时降低用量。其 仓库 记录了专门化的后台智能体、多模型 council 运行、模型预设、内置验证技能以及可配置权限;至于“用量下降”这一说法,目前仍只是单个用户的经验。
讨论洞见: 最尖锐、也最反复出现的约束,并不只是模型质量本身。一条关于 Kimi CLI 的回复警告称,当智能体不再暴露不确定性时,加载更多代码仓库上下文反而可能让它更自信地出错。与前一天相比: 7 月 16 日的重点是独立评分、技能,以及狭窄的委派边界。7 月 19 日则延续了这一方向,并补充了更多操作层面的细节:可验证的目标、明确区分创建者与验证者、模型路由,以及具备权限感知的编排。
1.3 编码助手仍主要按界面能力和运行可靠性来评判 🡒
GitHub Copilot 计划中的 Markdown 提示词编写器、XDA 对三款工具的仪表盘对比,以及用户上报的 Codex 性能问题,让当天的讨论始终落在“实际使用代理的体验”这一层面。对比证据虽然范围有限,但相当具体:同一份仪表盘需求简报,Copilot 结果出得很快,但较为浅显;Claude Code 更完整,但 token 消耗更高;而作者最偏好的结果来自 Codex。
@basiclines 宣布(97 次点赞、7 条回复、20,012 次浏览、63 次收藏)提到 GitHub Copilot 应用正在面向内部员工进行 Markdown 提示词功能的早期预览。相关引用转发称,下一步原定上线一个更强大的提示词编写器;回复则追问,除了图片和附件之外,更丰富的提示方式到底能带来哪些实际好处。
@xdadevelopers 比较(10 次点赞、4,003 次浏览、2 次收藏)比较了 Claude Code、Codex 和 GitHub Copilot 处理同一份金融仪表盘简报的表现。链接中的 对比 表示,Copilot 速度最快,但停留在静态工作流;Claude Code 功能更深入,但更慢,而且接近使用上限;Codex 则是在打磨程度与完整性之间,最符合作者偏好的平衡。
@jun_song 转发并放大(54 次点赞、21 条回复、6,149 次浏览、19 次收藏)提到有关 Codex 导致 Mac 卡顿和 SSD 过度写入的报告。由于无法独立获取所链接的 Reddit 报告,这里只能将其视为用户上报的问题,而非已确认的缺陷;但其截图和回复清楚表明,用户希望得到解释,以及可靠的缓解方案。

2. 什么让人感到挫败
没有明确验证机制时,代理输出仍然很难信任
严重性:高。关于循环的讨论把这种失效模式说得很具体:人们可以让代理运行更久,但这并不能证明结果就是正确的。@petergyang 分享(14 次点赞、3 条回复、1,435 次浏览、9 次收藏)建议通过找出未知项来做规划,而不是对 AI 的计划一带而过;原文建议设定一个可验证的终态,并将创建者代理与验证者代理分开。对 @RituWithAI 认为(9 次点赞、4 条回复、243 次浏览、6 次收藏)的 Kimi CLI 回复则表示,更大的仓库上下文并没有让它的代理更敏锐,反而让它更自信地出错。眼下可见的应对方式,是人工审查再加一次独立评估流程;这值得投入构建,因为它反映的是一个直接的操作缺口,而不是对另一个模型的额外诉求。
技能过多,带来了筛选与信任问题
严重性:中。@undefinedKi 推广(89 次点赞、20 条回复、8,833 次浏览、160 次收藏)列出了超过 93 万项技能,但评论者立刻追问,其中到底有多少真正有用。作者自己的回答是,也许有一半有用,而真正可靠的核心只来自少数几个发布者,这也清楚说明了当前的应对方式:用户仍然需要自己筛库,或者让另一个代理替他们筛。这个方向值得做,因为分发已经存在,但质量、出处和任务适配性仍然要靠人工判断。
对可靠性的担忧,可能压过对编码助手能力的肯定
严重性:高,但尚未验证。@jun_song 报道(54 次点赞、21 条回复、6,149 次浏览、19 次收藏)中,用户声称 Codex 负载过高会导致 Mac 卡顿和 SSD 磨损;有一条回复还提到发热,并尝试过重装。由于所链接的报告无法独立审查,这些证据并不足以确立因果关系,但足以说明,用户真正想要的是清晰的诊断和安全的修复方案,而不是功能建议。因此,这一方向值得围绕透明的代理资源遥测和支持工具来构建。
3. 人们希望存在什么
一种值得信赖的代理技能选择与安装方式
skills.sh 这条讨论直接体现出,实际需求是“如何选择”,而不是“再做一个更大的目录”。@undefinedKi 描述(89 次点赞、20 条回复、8,833 次浏览、160 次收藏)展示了跨多种代理的类似包管理器式安装,但讨论很快将信任范围收缩到少数几个点名的发布者,并建议让 Claude 来筛目录。一个有用但缺失的中间层,应该能在安装前展示质量证据、发布者出处、兼容的代理、所需权限以及任务触发条件。机会:直接。
能让规格和长时间运行任务不跑偏的护栏
Spec Kit 的结构化阶段和 Claude Code 访谈指向的是同一种需求:代理执行的工作,应该从需求到验证都带着一个人能理解的完成边界。@DivyanshT91162 分享(124 次点赞、6 条回复、11,538 次浏览、262 次收藏)提倡“先规格、后执行”的工作流,但有回复提醒,规格漂移依然会导致错误;@petergyang 分享(14 次点赞、3 条回复、1,435 次浏览、9 次收藏)则给出了互补建议:设定可验证目标,并认真阅读计划。对于正在委派多步骤工作的用户来说,这一需求既实际又紧迫。机会:直接。
面向多模型、多环境执行的统一操作层@prasad_pilla 表示(6 个赞、4 条回复、245 次浏览)指出,生产环境中的差异更多体现在上下文、路由、本地/云端执行、身份验证、权限和运行时启动,而不只是代码生成质量。@Trion129 补充说(3 个赞、1 条回复、167 次浏览、4 次收藏)则是一份关于多模型委派后使用量更低的个人报告。真正需要的是一个控制界面,让跨代理的路由、成本、能力和审批选择清晰可见。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Spec Kit | 规格驱动开发 | (+/-) | 梳理出一套可复用的、从原则到实现的工作流,可适配不同的编码代理 | 有回复指出,规格可能会漂移,最终仍会导致代理出错 |
| skills.sh | 代理技能注册表/包管理器 | (+/-) | 可在多个代理之间安装、查找、列出、更新和移除技能 | 作者估计目录里大约只有一半内容有用;仍需人工筛选 |
Claude Code /goal、/loop 和工作流 |
代理执行方法 | (+) | 采用可验证端点、迭代式规划、并行任务,以及创建者/验证者分离 | 仍需要人工阅读计划,并定义一个确实可被验证的结果 |
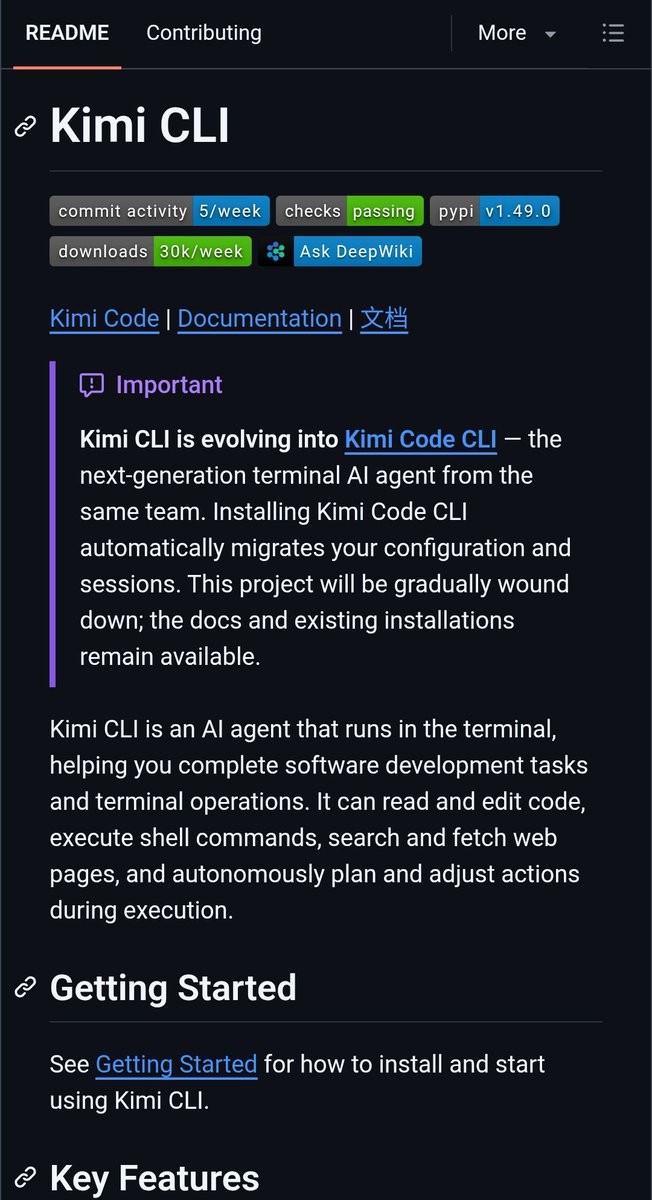
| Kimi CLI | 终端编码代理 | (+/-) | 支持终端文件编辑、shell 命令、网页抓取、MCP、ACP 和自主规划 | 该仓库正迁移到 Kimi Code CLI;还有回复质疑“更多上下文会改善结果”这一假设 |
| oh-my-opencode-slim | 多模型代理编排器 | (+) | 提供专门的后台代理、模型预设、多模型委员会和可配置权限 | 关于使用量更低的说法来自单个用户,而非受控对比 |
| GitHub Copilot 应用提示词编辑器 | 编码代理界面 | (+/-) | 在早期预览中加入 Markdown 提示,并计划推出能力更强的 composer | 有回复要求提供更清晰的证据,说明实际收益不只是输入格式更丰富 |
| Codex、Claude Code 和 GitHub Copilot 对比 | 编码代理对比 | (+/-) | 用同一份仪表盘需求说明,呈现速度、功能、设计和 token 使用之间的权衡 | 这只是单一作者针对一个应用的测试,不是通用基准 |
满意度光谱更偏向结构化、多阶段的工作方式,而不是对某一个模型的忠诚。Claude Code 的访谈建议移除过时指令,并将验证环节拆分出来;Alan 的实践者报告则表明,路由、权限、部署和运行时可靠性与模型选择同样重要。明显的迁移趋势是:把模型当作可互换的通道来使用;而主要的制衡因素,仍是持续需要人工审查、筛选和资源透明度。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Kimi CLI | @RituWithAI 分享的 MoonshotAI 项目 | 可编辑代码、运行命令、抓取页面、规划任务,并通过 MCP 和 ACP 连接的终端代理 | 提供一个原生终端式的编码代理选项,并具备互操作接口 | Python CLI、Kimi models、MCP、ACP、OpenAI-compatible APIs | 已发布 | 仓库 · 推文 |
| Flow Control | @thesherlocker | 通过原生 macOS 和 WebHID 接口配置一款受支持的 LoFree Flow Lite 84 键盘 | 在该键盘缺乏原生 VIA 支持的情况下,提供一条配置路径 | SwiftUI/AppKit、IOHID、WebHID、GPT-5.6 Sol/Codex Mode-assisted development | Alpha | 仓库 · 推文 |
| oh-my-opencode-slim | @Trion129 分享该项目 | 在专门化代理之间分配代码库探索、研究、审查、UI 工作和限定范围的实现任务 | 让用户能够在不同模型之间分配质量、速度和成本,而不是强迫单一模型承担所有任务 | OpenCode plugin、multi-model agents、skills、MCP、code-intelligence tooling | Beta | 仓库 · 推文 |
| Zeroprep | @ramsri_goutham 及其团队 | 在演讲者发言的同时生成带动画的演示文稿,并导出为 PDF 或 PowerPoint | 免去现场演讲前的预先准备 | GPT-Realtime 2.1, Gemini 3.1 Flash Lite Image, React, HTML,CSS | Alpha | 推文 |
Kimi CLI 值得关注,是因为它的 README 既确认了可用的终端代理交互界面,也说明该项目正过渡到 Kimi Code CLI。截图直观展示了这次迁移,以及该代理宣称具备的终端能力;而回复线程则提供了必要的提醒:长上下文需要经过压力测试,不能想当然地认为它会提升正确性。
Flow Control 则是一种边界更清晰的构建模式:它的 README 将支持范围限定为一种已观察到的键盘变体,要求使用有线连接,在写入前进行状态快照,验证回读结果,并且刻意排除了固件刷写和其他高风险恢复操作。这些项目反复呈现出的共同模式,并不是原始代码生成,而是将代理能力置于受约束的产品边界或委派边界之内。
6. 新的和值得关注的动态
Markdown 提示即将登陆 GitHub Copilot 应用
@basiclines 宣布(97 次点赞,7 条回复,5 次引用,20,012 次浏览,63 次收藏)表示,Markdown 提示已向员工开放早期预览,并将进入更广泛的 Copilot 应用。相关的 引用帖子(25 次点赞,1 条回复,3,115 次浏览)称,该应用正在获得一个更强大的提示编排器。这个信号之所以重要,是因为它把结构化提示从一种纯文本惯例,升级为一等公民的产品能力,尽管回复区尚未明确证明它会给用户带来哪些可见收益。
一次受控的三工具仪表盘测试暴露了不同取舍
@xdadevelopers 分享(10 次点赞,4,003 次浏览,2 次收藏)分享了一项测试,在相同的金融仪表盘需求下比较 Claude Code、Codex 和 GitHub Copilot。文章 让结果比一般的偏好投票更有实质内容:Copilot 速度最快,Claude Code 产出的工作流更深入,但消耗了更多时间和 token,而 Codex 在这位作者看来,在完成度和功能性之间取得了最佳平衡。这是一次范围有限的比较,但它评估的是实现深度,而不只是着陆页截图。
黑客松项目正在使用多模态实时技术栈
@ramsri_goutham 宣布(43 次点赞,9 条回复,1 次引用,1,680 次浏览,17 次收藏)介绍了获得第一名的 Codex 黑客松项目 Zeroprep。团队表示,它能够聆听演讲,使用 GPT-Realtime 2.1 控制视觉内容,通过 Gemini 3.1 Flash Lite Image 异步生成图像,渲染 React/HTML/CSS 场景,并导出结果。值得注意的信号在于:它把语音理解、图像生成和演示渲染结合进了一个实时工作流,而不是停留在独立的聊天交互中。
7. 机会在哪里
[+++] 委派式工程工作的验证与漂移控制 — Spec Kit 的分阶段流程、关于规范漂移的警告、Claude Code 关于使用可验证目标和人工审查计划的建议,以及 Kimi 回复中提到的“自信地出错”,都指向了同一个缺口。团队需要这样一层能力:能够显示当前工作是否仍与规范一致、哪些地方存在不确定性,以及有哪些证据支持任务已完成。
[++] 带有质量、来源和权限信号的技能注册表 — skills.sh 线程显示出对跨代理安装和大型技能库的需求,但其自身讨论也表明,用户不能假设其中大多数条目都有用。一个能够公开可信维护者、任务适用性、代理兼容性、访问范围和结果证据的注册表,可以减少当前人工筛选这一步。
[++] 带有运营护栏的多模型路由 — Alan 从业者的描述、oh-my-opencode-slim 的专用通道、Kimi 的互操作性,以及那次仪表盘比较,都说明模型选择正在超越单一排行榜。机会在于构建一个控制平面,用来记录任务匹配度、成本、上下文、部署、权限、检查项以及交接结果。
[+] 代理资源与可靠性的可观测性 — 围绕 Codex 相关 Mac 卡顿和 SSD 磨损的用户报告尚未得到独立证实,但它们表明,市场需要透明的进程、I/O、热、内存和后台任务遥测。一个能把资源行为关联到具体代理会话的诊断界面,或许能把模糊的安全担忧转化为可执行的证据。
8. 要点
- 最高信号的工作流主张是“规范优先”,而不是“提示优先”。 Spec Kit 清晰可见的六个阶段及其可观的互动数据,显示出市场对可复用项目约束的需求;而关于规范漂移的回复则说明,这些约束为何需要主动校验。(来源)
- 技能正逐渐成为代理行为的安装单元,但信任层仍不完整。 skills.sh 提供了类似包管理的跨代理分发方式,而它的作者自己也表示,用户仍需要从目录中筛选出更小、更有用的核心集合。(来源) 3.长时运行的智能体正通过可验证的目标和独立审查被投入实际运行。 Claude Code 团队的访谈更看重明确的结束标准、人工审查计划,以及创作者与核验者分离,而不是盲目延长智能体运行时长。 (来源)
- 现实中的编码助手选型,考量范围不止是代码生成质量。 一项基于相同任务说明的测试区分出了速度、工作流完整性、视觉完成度和 token 成本,而“软件工厂”的那则案例还补充了路由、权限和运行时可靠性。 (来源)
- 开发者正将智能体应用于边界明确的产品和编排系统。 Flow Control 将一款硬件配置器限制在文档明确说明的支持边界内,而 Kimi CLI 和 oh-my-opencode-slim 则提供了终端和多智能体执行入口。 (来源)