Twitter AI 编程 - 2026-07-21
1. 大家在讨论什么
1.1 Google 的技术栈仍是核心,但讨论已从发布热潮转向套装经济学与信任问题(🡒)
Google 仍是 AI 编程讨论的重心,但话题比之前更成熟了一层。人们不再只是庆祝 Antigravity 作为新编程代理亮相,而是开始详细拆解 NotebookLM 的具体工作流,盘算整套 Google 组合到底要花多少钱,并检验 Antigravity 是否具备足够的质量和产品能力,足以赢得真正的信任。最终呈现出一种分化叙事:好奇心很高,但还没有形成“Google 技术栈已经是 Codex 级默认选择”的明确共识。
@shubham_crazy08 认为 (260 个赞,9 条回复,19,692 次浏览,302 次收藏) 表示,NotebookLM 配合 Antigravity 可以运行深度研究代理,将业务专属技能编码化,构建具备上下文感知能力的仪表板,自动生成报告,甚至还能把经 Python 处理的数据导入笔记本。其特别之处不只是写代码更快,而在于 NotebookLM 成为有据可依的知识层,Antigravity 则成为执行层。
@ice_bearcute 将其表述为 (82 个赞,52 条回复,1,132 次浏览) 将 Google AI Pro 形容为一个每月 20 美元的套装,包含 Gemini、Nano Banana、Veo/Flow、Antigravity、Jules、NotebookLM、Chrome 自动浏览功能以及 5TB 存储空间。这条定价帖之所以重要,是因为它把竞争从“模型对模型”的比较,转向“现在哪家厂商能提供最可用的一体化全栈组合”。
@Presidentlin 指出 (8 个赞,541 次浏览) 指向更新后的 Antigravity 更新日志页面,展示了彼此独立的 Antigravity 2.0、CLI、SDK 和 IDE 产品面。尽管互动不高,这张截图仍是有价值的证据,表明 Google 正在把 Antigravity 打包成一个更广泛的平台能力,而不只是单一产品演示。
@kapilansh_twt 反驳 (77 个赞,66 条回复,3,172 次浏览) 认为 Antigravity 依然像“穷人版 Codex”。比起这句讽刺本身,更重要的是回复量:怀疑者反复回到信任、执行质量,以及如果输出仍需要大量手把手纠正,那么免费接入到底有没有意义。
讨论洞察: 这种怀疑是具体的,不是阵营之争。无论支持者还是批评者,都不断拿 Antigravity 与任务完成质量、调试耐力,以及它能否维持足够上下文、在最初惊艳演示之外仍然有用来比较。
与前一天相比: 7 月 20 日,Antigravity 成了头条。到了 7 月 21 日,它仍在焦点位置,但观察视角扩大到了套装定价、产品能力面的扩展,以及更尖锐的信任问题。
1.2 验证、审查与上下文支架,正逐渐固化为应对代理胡乱产出的默认答案(🡕)
最明显的实务变化,是从直接提示转向让代理工作可检查的系统。关于证明工具、学习路线图、审查分离、MCP 支撑的上下文,以及从 PRD 到任务拆解的帖子,都指向同一个结论:人们越来越默认,如果没有外围工作流加以约束,模型就会逐渐跑偏。
@_chenglou 介绍了 (207 个赞,7 条回复,13,443 次浏览,164 次收藏) 介绍了 Freerange:这是一款无需 API 的工具,可静态推导数值范围,从而证明 TS 布局满足尺寸约束、避免 NaNs 和 Infinity,并确保数组索引不越界。他在回复中还补充了具体例子,比如除零导致的进度条问题、移动端布局冲突,并称 Freerange 在接入 Midjourney 代码库的第一天就找出了 12 个 bug。
@iammukeshm 认为 (31 个赞,3 条回复,721 次浏览,18 次收藏) 认为,AI 最有帮助的前提,是开发者自己已经知道“好的结果”应该是什么样。他附上的 .NET 路线图把这一点落到了操作层面:先学基础、数据访问、API、身份验证、测试、DevOps,最后才是把 AI 驱动开发当作加速器,而不是判断力的替代品。

@Cris_DVM 展示了 (1 个赞,3 条回复,33 次浏览) 展示了这组数据里最清晰的审查模式之一:Claude Code 负责实现,来自另一家厂商的 Codex 在自己的克隆仓库中审查 diff,git 仍是审查通道,最后由人类裁决。这条帖子的传播范围不大,但对流程边界的划分异常明确。
@HashiCorp 表示 (3 个赞,1 条回复,1,038 次浏览) 表示,Terraform MCP 的作用机制,是让编程代理实时访问 Registry 文档、provider 文档、模块和策略,从而减少幻觉。@DanKornas 补充说 (526 次浏览) 表示,Taskmaster 会通过生成任务、依赖关系以及 MCP/CLI 访问,把 PRD 转化为有序、可检查的工作。讨论洞察: 面对糟糕输出,反复出现的答案几乎从来不是“换个更好的模型”,而是“改变闭环”:加强证明与验证、将创作者与审阅者分离、加入活文档,或强制把工作拆成可检验的任务。
与前一天对比: 7 月 19 日和 7 月 20 日已经把规格、技能和闭环的重要性抬了上来。到了 7 月 21 日,这又进一步落到了更具体的实物层面:静态证明工具、明确分离的审阅者、MCP 上下文注入,以及任务分解系统。
1.3 开放权重压力与多提供商框架从理论走向产品决策(🡕)
第三个主要主题是,模型选择正在迅速变得流动化。讨论不再把路由当作爱好者的小技巧,而是把低成本切换、开放权重带来的压力,以及提供商灵活性视为市场的自然走向。与此同时,也有多篇帖子提醒读者:这依然是个早期市场,实际用户基数远小于 Twitter 讨论给人的印象。
@EnoReyes 认为(80 个赞、10 条回复、6,532 次浏览、54 次收藏)指出,模型正变得像流动资产一样可替换,切换成本几乎为零,而持久价值正转向应用和基础设施。回复不是简单附和,而是进一步 sharpen 了这一论点:有人说,他的信息流里已经有一半人在 Claude Code 里接入 Kimi K3,完全不用改代码;另一个人则说,工作流记忆正在成为真正的切换成本。
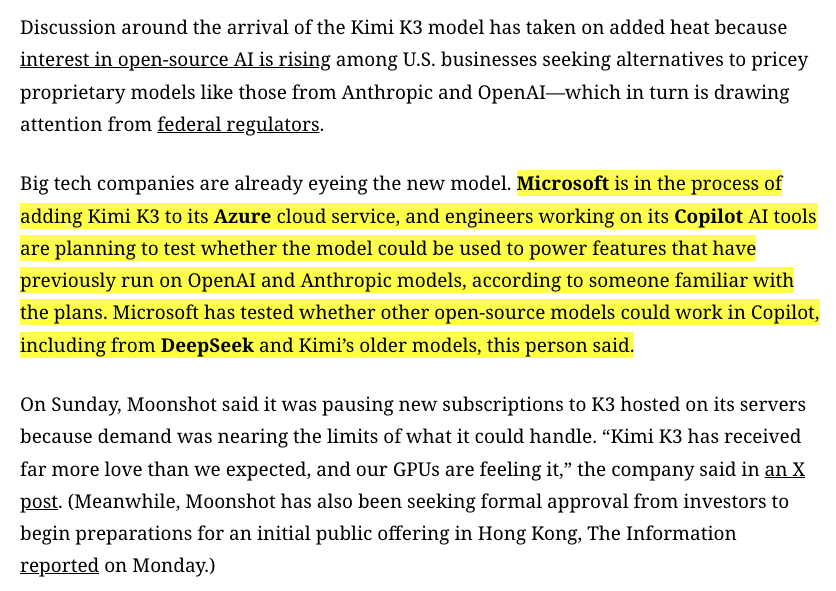
@EntelligenceAI 报道称(12 个赞、5 条回复、613 次浏览)称,Microsoft 工程师正在评估将 Kimi K3 用于 Copilot 工作负载;而一段被引用的文章摘录则称,Azure 也是这个故事的一部分。@arrakis_ai 报道称(13 个赞、4 条回复、1,280 次浏览、8 次收藏)称,OpenCodex 让 Codex 框架在不同提供商之间通用,而公开的 open-codex 仓库 确认其支持 OpenAI、Gemini、OpenRouter 和 Ollama。

@rohanpaul_ai 总结道(8 个赞、1,835 次浏览)附上证据称,在长期网络攻防靶场中,开放权重模型如今只比前沿系统落后 4 到 7 个月;与此同时,Kimi K3 也已强到足以同时带来成本压力和算力短缺。@okaythenfuture 补充说(323 次浏览)则提出了一个监管层面的变数:中国可能会继续开放海外服务访问,同时收紧模型权重的发布或转移。
讨论洞察: 经济层与政治层如今已经交织在一起。开发者一边在考虑成本更低的开放权重和更容易的路由,一边也在关注哪些模型真的能进入 Copilot、Azure 以及其他企业产品界面中。
与前一天对比: 7 月 20 日让路由和框架选择看起来像一种正在形成的工作流。到了 7 月 21 日,它更像一个产品和采购问题:企业采用、开放权重经济性以及地缘政治约束,全都进入了同一场讨论。
2. 什么让人感到挫败
如果输出质量依然脆弱,免费或低价的智能体访问就没有意义
严重程度:高。最典型的例子来自 @kapilansh_twt 称其为(77 个赞、66 条回复、3,172 次浏览):把 Antigravity 称作“穷人版 Codex”,从而让对产品的批评变成了对信任的质疑。来自 @ice_bearcute 展示了 的低价对照样本(82 个赞、52 条回复、1,132 次浏览)说明了这种挫败感为何重要:人们愿意积极试用定价激进的捆绑套餐,但最终评判整套技术栈的标准,仍是它能否把工作做好并做完。

@VedikaAPI 抱怨(21 次浏览)表示,Codex 的一次运行要花 8 到 30 小时,产出却“基本都是糟粕”,即便已经提供了追踪器和记忆上下文;相比之下,Claude 处理同类工作更快。@0x_kaize 警告(13 个赞、411 次浏览)指出,禁用子代理生成、将工具输出限制在 8KB 等常见的 token 节省技巧,之所以能省 token,往往只是因为砍掉了有用的编排能力并迫使系统重试。这个方向值得投入,因为痛点不只是价格本身;更在于人们觉得,廉价接入往往伴随着质量不稳定或代价脆弱的权衡。
代理要保持可信,仍需要明确上下文、审查环节和技术判断
严重程度:高。人们围绕这一问题搭建的解决方案,本身就说明了抱怨的严重性。@HashiCorp 表示(1 条回复、1,038 次浏览)表示,编码助手的表现只取决于它掌握了多少上下文,并将 Terraform MCP 视为修复基础设施代码幻觉问题的方案。@_chenglou 展示了(207 个赞、7 条回复、13,443 次浏览、164 次收藏)展示了 Freerange 如何捕捉普通代理输出遗漏的布局和边界错误;与此同时,@iammukeshm 认为(31 个赞、721 次浏览、18 次收藏)指出,只有当开发者能识别出失效的校验、认证和架构问题时,AI 才真正划算。
@Cris_DVM 回应(3 条回复、33 次浏览)提出了一个由人工裁决的双模型审查闭环;@DanKornas 指出(526 次浏览)则把 Taskmaster 当作一种方法,在代理开始写代码前,先强制将 PRD 拆成有序任务。这个方向值得投入,因为这种挫败感是结构性的:人们不断发明各种脚手架层,是因为他们不信任原始代理输出能够自行持续对齐。
明显的 AI 糟粕如今带来的已不只是代码质量成本,还有声誉成本
严重程度:中。@ghostiesdagger 抱怨(259 次浏览、4 次收藏)表示,发帖者连浏览某个同人标签时,都躲不开明显带有 AI 写作和“氛围式编程”指纹的内容。附带证据聚焦的是过度光滑、重复雷同的文风模式,而不是代码 bug;这也正是其重要性所在:糟糕的 AI 输出如今在面向公众的作品中,已经会被当作风格问题识别出来,而不只是技术问题。

这种反弹,与那些庆祝产出越来越快的增长帖并列出现时,显得颇为别扭。这个方向值得投入,因为对任何把 AI 生成的代码、内容或界面推向公众的人来说,保护声誉的审查、编辑和溯源层如今都很重要。
3. 人们希望出现什么
能持续积累、而不是每次会话都归零的记忆
这是一种实际需求,而不是抽象诉求。@undefinedKi 描述了(13 个赞、6 条回复、133 次浏览、5 次收藏)介绍了一套基于 Obsidian 的代码库记忆系统,每 12 小时审查一次重复项、过时依赖和未使用工具,让 Claude Code 不再忘记各个代码库为什么重要。在同一方向上,@habibicode 分享了(13 次浏览)codekeel:它维护一份决策台账,将架构选择注入后续的 Claude Code 会话,并可在语义层面执行这些选择。
@Cris_DVM 展示了(3 条回复,33 次浏览)表示,即便是经过人工审查的双模型配置,也依赖一个供两个 AI 共同读取的 Obsidian 库。需求很直接:人们想要的不是更多聊天记录,而是持久的项目记忆,以及能跨越工具和会话边界长期保留的决策。
在明确边界内运行的自主性
这一需求也表现为安全与治理问题。@realjohnny5i 分享了(25 次浏览)TaskFence AI,其公开项目页面也明确写出了动机:用户可围绕资金、范围、商户、截止日期和操作限制设定机器可检查的边界,而智能体可以提出建议,却不能自行授权。@DanKornas 指出(526 次浏览)则把 Taskmaster 视为同一冲动在技术栈更上游的一种体现:在智能体开始编辑之前,先把 PRD 转成按顺序排列的任务,以此约束工作范围。
@HashiCorp 补充说(1 条回复,1,038 次浏览)表示,即使是基础设施代码,也需要扎实的上下文,而不只是更强的模型。这里的机会很明确,因为证据指向的是控制平面、审批轨道和策略执行,而不是市场对另一个通用聊天框的需求。
在同一工作流中低成本切换模型
这是数据集中最明确的实际诉求之一。@EnoReyes 认为(80 次点赞,10 条回复,6,532 次浏览,54 次收藏)认为,模型是流动的,随着利润率压缩,智能能力的购买方将获得更大议价权。@arrakis_ai 报道称(13 次点赞,4 条回复,1,280 次浏览,8 次收藏)提到,OpenCodex 允许在同一个 Codex 风格的工具框架中按任务切换不同提供方;与此同时,@MetisL2 展示了(7 次点赞,2,079 次浏览)则讨论了如何在 ClawUp 智能体中复用 ChatGPT 订阅。
面向低预算用户的 Google 路线也指向同一个方向:@ice_bearcute 构建了框架(82 次点赞,52 条回复,1,132 次浏览)将 Google Pro 视为一次付费覆盖多个智能体入口的方案。机会判断:竞争型。市场需要的不是一个永久赢家,而是一个稳定的工具框架,能够根据具体任务,在成本最低、速度最快或效果最好的模型之间路由。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Google Antigravity / NotebookLM | 智能体平台 | (+/-) | 将研究笔记本转化为执行工作流;Google 套件覆盖面广;CLI/SDK/IDE 生态持续扩展 | 外界对质量的怀疑依然强烈;在许多回复中,信任度仍落后于宣传热度 |
| Claude Code | 智能体 CLI | (+/-) | 终端工作流强,支持可复用剧本、人工审查通道和领域专用操作包 | 仍然高度依赖上下文、审查纪律,以及外部记忆与治理层 |
| OpenCodex / open-codex | 多提供方编码框架 | (+) | 保留 Codex 风格的终端工作流,同时可在 OpenAI、Gemini、OpenRouter 和 Ollama 之间切换 | 社区分支仍在积极开发中;稳定性和安全性仍取决于操作者的选择 |
| GitHub Copilot | 智能体平台 | (+/-) | 仍出现在学习路线图和前端工作流中;也是新 GH-600 角色定位的核心 | 当前讨论仍在要求更清晰的基准证据,以便与 Claude Code、Cursor 和 Codex 对比 |
| Kimi K3 | 开放权重编码模型 | (+/-) | 围绕成本效益的讨论热度较高;已开始被讨论用于 Azure/Copilot 场景 | 监管不确定性和供应约束仍是现实问题 |
| Taskmaster | 任务编排 | (+) | 可将 PRD 解析为带依赖关系的有序任务,并提供 MCP/CLI 访问 | 需要前期结构化整理,并增加一层工作流纪律 |
| codekeel | 记忆 / 治理 | (+) | 提供决策台账、语义执行和跨会话连续性,且无需托管服务 | 在公开讨论中的早期存在感仍然较弱 |
| Terraform MCP Server | MCP / 领域上下文 | (+) | 增加实时文档、模块和策略上下文,以减少基础设施幻觉 | 重点仍局限于 Terraform 及其相邻的基础设施工作流 |
| ClawUp | 智能体平台 / 订阅中继 | (+/-) | 可在智能体工作流中复用现有 ChatGPT 订阅,避免单独支付 token 费用 | 配置依赖凭据复用,并将成本转移到计算和存储 |
| Octen AI Search | 智能体基础设施 | (+) | 已公布的智能体搜索循环延迟低得多;单次调用报价也更低 | 现有证据仍主要停留在基准测试阶段,而非广泛的生产采用 |

当工具是在模型周围增加结构,而不是要求模型生硬地包办一切时,满意度的差异最为明显。@G38Suzy 梳理了(73 次浏览)介绍了一种前端技术栈:AI 编程被嵌入设计、评审、验证、部署和可观测性等环节之中,而不是取代这些环节。@MarcelVelica 发布了(125 次浏览)分享了 32 条 Claude Code 工作流技巧;@shushant_l 打包了(459 次浏览)展示了如何将 Codex 作为一个覆盖构建、调试、测试、评审和部署全流程的代理;还打包了(14 个赞、706 次浏览、6 次收藏)则把 vibe coding 变成了一个带有安全检查和防漂移规则的引导式闭环。
与模型市场同样显眼的,还有“变通方案”市场。@CDGalpha 重点介绍了(15 个赞、172 次浏览)将 LibreChat、HyperFrames 和 Open Generative AI 作为付费工具套件的自托管或低成本替代方案;@MetisL2 展示了(7 个赞、2,079 次浏览)展示了人们如何把现有订阅接入新的智能体入口。@ashen_one 添加了(3 个赞、681 次浏览、3 次收藏)则从搜索基础设施的角度,给出了 Octen 面向智能体循环的低延迟基准测试。显现出的迁移趋势,并不是从一个模型转向另一个新赢家,而是转向分层工作流:包含路由、记忆、验证,以及明确的任务结构。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Freerange | @_chenglou | 静态推导数值范围,从而证明 UI 代码可避免布局错误、越界以及 Infinity/NaN 故障 | 在运行前捕捉代理遗漏的 UI 和数值类 bug | 面向 TypeScript 风格布局的零 API 静态分析;具体实现技术栈未公开文档说明 | Alpha | 推文 |
| Taskmaster | Eyal Toledano / RalphEcom | 将 PRD 转换为有先后顺序、具备依赖感知的 AI 驱动开发任务 | 为代理提供结构化的执行计划,而不是一整块原始需求描述 | MCP server、CLI、PRD 解析、任务扩展、依赖关系、标签 | 已发布 | 仓库 · 推文 |
| codekeel | HabibiCodeCH | 为 Claude Code 会话增加决策台账和执行约束层 | 减少跨会话的上下文漂移,以及相互矛盾的架构决策 | 本地 CLI、hooks、slash commands、YAML 台账,以及通过 Anthropic API 提供的可选语义检查 | 已发布 | 仓库 · 推文 |
| open-codex | ymichael 和开源贡献者 | 将 Codex 风格的终端 harness 扩展到多个提供方 | 让同一工作流可以在 OpenAI、Gemini、OpenRouter 和 Ollama 之间切换,而无需针对每个模型重新改造 | Node CLI、沙箱终端智能体、多模态输入、多提供方 chat-completions 后端 | Beta | 仓库 · 推文 |
| GreaterMalaysia + pengu.fun | @AaronTeng | 推出一系列范围明确的在线产品,从马来西亚公共数据工具到实时代币持有者地图 | 让个人创始人无需开发团队,也能验证并上线真正有用的产品 | AI 辅助 Web 应用;具体实现技术栈未公开说明 | Shipped | GreaterMalaysia · pengu.fun · 推文 |
| Claude Fable 5 Meta Ads System | @HamptonAc_ | 将 Claude Fable 5 连接到 Meta Ads MCP,用于广告活动诊断、搭建、优化和扩量决策 | 用一套可重复使用的 AI 操作员方案取代人工媒体投手工作流 | Claude Fable 5、Meta Ads MCP、提示词、技能、操作手册、复制粘贴式配置 | Shipped | 推文 |

Freerange 的特别之处在于,它直指 vibe coding 最大的失败模式之一:UI 代码在数学上看似合理,实际上却是错的。补充检索期间没有发现公开代码仓库,因此目前公开证据仍仅限于那条推文串本身;但其中的例子已经足够具体,值得重视。
TaskFence AI 和 codekeel 在不同层面上呈现出同一种构建模式。TaskFence 约束智能体在外部世界中能做什么,codekeel 则约束智能体在代码库内部可以做出什么决定。两者背后反复出现的痛点,不是“怎样获得更多输出”,而是“怎样阻止有用的输出漂移并越过边界”。

GreaterMalaysia 和 pengu.fun 则体现了相反的模式:最快取得可见成果的,并不是宏大平台,而是范围明确、已上线且具体的产品。Aaron Teng 声称,一个凌晨 2 点冒出的想法,到早上 7 点就能面向马来西亚全部 16 个州上线;这一说法强烈表明,AI 编程已经在改变小型实用产品的经济账。
6. 新近且值得关注
GitHub 的 GH-600 角色框定,正把智能体运营变成一门需要资质认证的专业
@cyrilXBT 报道称(69 个赞、18 条回复、6,610 次浏览、21 次收藏)表示,GitHub 推出了 “Agentic AI Developer” 的测试版认证。比起围绕它的营销文案,随附的认证截图更值得关注,因为它将这份工作的定义落在:在生产环境的 SDLC 工作流中部署、运营、集成和治理 AI 智能体。

回复区也补充了一个重要提醒:有几个人认为,这一角色还很早期,真正的工作仍然是编写退出条件、捕捉工具错误,以及监督不稳定的流水线。即便如此,这项认证本身仍是一个值得注意的信号,说明智能体运营正在被命名并打包为一种正式角色。
Anthropic 的免费课程潮,正把 AI 编程教育变成结构化课程目录
@david_marco45 分享了(3 个赞、4 条回复、111 次浏览)发布了一张信息图,展示 Anthropic 的免费课程,涵盖 Claude Code、Claude API、MCP 和 AI fluency。公开的 Claude 101 页面 证实,这套课程至少有一部分确实存在,结构完整,并附带证书。
值得注意的并不是今天某一门课程占据主导,而是学习覆盖面正从一次性的教程扩展为一整套课程目录,涵盖编码工作流、API、协议工具,以及按角色划分的熟练度培养。
Codex Micro 让编码代理的硬件边界变得具体可感
@kimocode 指出(4 个赞,223 次浏览)认为,OpenAI 售价 230 美元的 Codex Micro macropad 应被视为一种界面产物,而非噱头。无论这一论点是否成立,这张图片至少让一件事变得具体:编码代理工作流如今也在硬件边界上被探索。

Claude Code 也开始渗入调试和调查工作流
@n15647931 报道称(13 次浏览)展示了有人在调查一个暴露的 Redis 数据库时使用 “Cowboy Claude Code”。传播范围虽小,但这张截图仍值得注意,因为它显示 Claude Code 被用于实时检查流程,而不是常规的功能开发循环。

7. 机会在哪里
[+++] 面向代理工作的记忆、治理与审查控制平面 — Freerange、Taskmaster、codekeel、TaskFence AI、Terraform MCP,以及 Cris_DVM 将创建者与审查者拆分开的工作流,都在填补同一个缺口:有用的代理仍然需要明确的记忆、策略、上下文和审查边界。这是最强的机会点,因为它同时出现在核心话题讨论、表达挫败感的帖子和开发者活动中。
[+++] 配备成本与上下文遥测的跨提供商编排框架 — EnoReyes “模型是流动的”这一论点、围绕 Kimi K3 / Copilot 的讨论、OpenCodex、ClawUp 的订阅复用、Google 的捆绑定价,以及 Octen 关于延迟的说法,都指向同一个方向:买家希望拥有稳定的工作流,同时能够在底层替换模型。最可能胜出的层,将是那个能让成本、延迟、策略和记忆后果变得清晰可见的控制界面。
[++] 面向 AI 构建应用与工作流的生产级加固 — .NET 路线图、HashiCorp 对 MCP 的定位、vibe-coding 安全清单,以及 Aaron Teng 的实时微型产品都表明,更快交付已不再是唯一问题。在 AI 产出首稿之后,市场仍有空间容纳那些能进行验证、测试、安全防护、部署、观测和修复的工具。
[+] 面向代理操作人员的课程、认证与入职培训 — GH-600 和 Anthropic 的课程目录表明,围绕代理运营的教育正在变得可以产品化。市场信号仍处于早期,但这一角色显然已经开始被命名、教授和打包。
8. 要点
- Google 吸引了注意力,但并未赢得毫无疑问的信任。 NotebookLM 加上 Antigravity 引发了当天最强的工作流热度,但同一场讨论里也出现了高回复量的反弹声音,认为 Antigravity 相比 Codex 仍显得不够成熟。(来源 1, 来源 2)
- 应对 AI 编码失败的务实答案,是在模型周围增加更多结构,而不是对模型投入更多信任。 Freerange、Terraform MCP、Taskmaster,以及将实现者与审查者拆分开的工作流之所以存在,都是因为人们希望在信任输出之前,先看到证据、上下文和明确的审查通道。(来源 1, 来源 2, 来源 3) 3.模型选择正迅速演变为接入编排与采购问题。 OpenCodex、围绕 Copilot 的 Kimi K3 讨论,以及 EnoReyes 的流动性论点,都指向同一个市场趋势:开发者希望能在不重写其余工作流的情况下切换模型。(来源 1、来源 2、来源 3)
- 最有说服力的构建者动向,正出现在狭窄的控制层和专门化的实用产品中。 TaskFence AI、codekeel、Taskmaster 以及 Aaron Teng 的微型网站,解决的都是边界清晰的具体问题,而不是承诺打造一个通用的自主工程师。(来源 1、来源 2、来源 3)
- 在市场尚未完全成熟之前,智能体操作员这一角色就已开始走向正规化。 GH-600 和 Anthropic 的免费课程目录表明,认证与课程体系方面确实正在推进;但与此同时,采用数据仍显示,与广义 AI 用户相比,使用编程智能体的用户仍只占很小一部分。(来源 1、来源 2、来源 3)