Twitter AI 编程 - 2026-08-03
1. 人们正在讨论什么
1.1 Qwen 把价格、基准和可恢复循环放到一起,让开放权重的前沿模型重新变得有意思(🡕)
今天数据集中最明显的热度峰值来自 Qwen3.8-Max。多条帖子都不把它当作又一次普通的基准榜单发布:真正的信号来自几件事同时出现——下周开放权重、明确标出每百万 token 输入 $2 / 输出 $6 的价格,以及可被用户迁移到自身智能体工作流中的长时程自主编程能力。至少四条高信号内容都在强化同一个主题,后续讨论的焦点也转向了带检查点的执行方式,而不只是参数规模本身。
@Alibaba_Qwen 宣布(1,461 个赞、124 条回复、53,679 次浏览、250 次收藏)将 Qwen3.8-Max 描述为一个 2.4T 参数模型,可自主编程 10 多天,支持 500 多轮芯片设计优化;Qwen3.8-Max 和 Qwen3.8-27B 都将在下周开放权重。随帖附上的基准图表让这条内容明显强于一般发布帖:图中显示,Qwen3.8-Max 在 TerminalBench 2.1 上得分 86.6,在 PaperBench 上得分 93.0,同时还列出了 SWE-Pro、FrontierSWE、CoWorkBench 和 OSWorld-Verified 的成绩。推文还把价格直接作为卖点,标出了每百万 token 输入 $2、输出 $6。

@codeglitch 认为(2 个赞、2 条回复、122 次浏览)认为,Qwen 这次发布里真正可复用的部分不是模型大小,而是围绕长期编程任务设计的检查点结构。配图把循环简化为 issue → change → check → state,并明确映射到类似 Claude Code 的交接流程,可配合 DONE、NEXT 或 BLOCKED 使用,把厂商演示转成了具体可执行的工作流建议。

讨论洞察: Qwen 官方回复串主要是通过分别补充 LM、VL 和 16 天编程的后续内容来扩展证据集,但社区最有力的回应转向了可检查性。大家持续提炼出的有用部分,是如何把一次马拉松式长跑拆成多个可验证的小状态。
与前一天对比: 8 月 2 日的讨论主要由网关、免费层和路由层主导。到了 8 月 3 日,Qwen 带着开放权重时间点、明确价格和可直接用于工作流的产物,把模型层重新推回了前台。
1.2 Codex 的帖子从“写代码”转向“跑产品和文档工作流”(🡕)
今天最重要的 Codex 帖子讨论的不是编程基准,而是运营型工作。这个模式反复出现在产品管理、广告运营、文档和应用脚手架等场景里:用户把 Codex 当成一个能执行受限业务流程、并在审批节点停下来的工作者,而不是自动补全界面。
@thsottiaux 声称(1,639 个赞、338 条回复、181,614 次浏览、115 次收藏)在引用一个小型 OpenAI pull request 后表示,你可以“让 Codex 凭空生成一个 PR,并把改进交付给 10 亿用户”。回复里也给出了有价值的反面意见:多位用户抱怨压缩聊天/图片 bug、积分消耗过快,以及 Pro 5x 配额“撑不了一整天”。也就是说,这种头部能力同时伴随着真实的操作成本和可靠性限制。
@gdb 提升了(320 个赞、44 条回复、48,509 次浏览、172 次收藏)介绍了一项 Codex 技能,可把支持工单、访谈、问卷和流失记录转成有证据支撑的路线图。引用的推文 将原始客户表述、底层问题、下一步待验证事项,以及真正可以如实宣称的内容分开;而回复很快点出了真正的难点:不是把抱怨聚类,而是判断声音最大的客户是否也最具战略价值。@gdb 还强调了(84 个赞、12 条回复、11,338 次浏览、32 次收藏)则展示了第二种工作流:Codex 负责剪辑并发布广告活动、建立受众、设置预算,并在付款环节停下等待审批。
@github 报道(115 个赞、13 条回复、26,637 次浏览、70 次收藏)给出了最具体、也最可量化的案例:Aspire 团队使用 GitHub Agentic Workflows 创建了 82 个跨仓库文档 pull request,82 个全部合并,中位合并时间为 44.8 小时。链接中的 文章 补上了缺失的执行细节:只创建草稿 PR、限制 GitHub App 权限、采用安全输出,并由 SME 审核,而不是自动合并。@waynesutton 补充说(26 个赞、2 条回复、2,139 次浏览、16 次收藏)则展示了一个更小但相似的模式,使用可复用的 Codex Sites + Convex skill,明确避免前端发布和后端状态管理彼此混杂。
讨论洞察: 最实质性的分歧不在于这些工作流是否令人印象深刻,而在于控制权:gdb 的回复在问路线图技能该如何权衡高声量反馈与战略价值;GitHub 的回复把人工审核视为决定性的护栏;而那条标志性的 Codex 成功帖几乎立刻就变成了配额和 bug 投诉串。
与前一天对比: 8 月 2 日还在抽象地谈 harness。到了 8 月 3 日,这套 harness 已经被绑定到文档 PR 合并时长、审批关卡和可复用业务工作流等可度量产出上。
1.3 技能、harness 和编排界面不断变成可安装产品(🡒)
8 月 2 日之后,harness 这条线并没有消失,而是变得更产品化了。今天的帖子表明,技能正在成为一个产品类别,harness 的选择正在成为架构决策,而编排与审核工具也正在形成一个可见的仓库集群,而不再只是隐藏在实现细节里的东西。
@FlowAltDelete 认为(30 个赞、2 条回复、2,383 次浏览、24 次收藏)表示,Copilot Studio 现在要求制作者必须选择一种 harness:Standard 用于结构化对话,GitHub Copilot 用于长时程业务流程。引用 Microsoft 公告 及其回复把约束讲得很具体:GitHub Copilot harness 会消耗 Copilot Credits,这个选择之后不能迁移,而缺少计费护栏已经开始引发担忧。
@about_hiroppy 曝光了(10 个赞、1,253 次浏览、5 次收藏)介绍了 Microsoft 的 Skill Recorder;其仓库说明称,可通过 GitHub Copilot CLI 把录制好的屏幕操作会话转成可复用的 Skill 或 Automation。@AIatAMD 推出了(55 个赞、3 条回复、2,105 次浏览、12 次收藏)介绍了 AMD Skills——一个面向 Cursor、Claude Code、Codex 和 Gemini CLI 的可安装技能目录;@tom_doerr 提到(1 个赞、1,028 次浏览)介绍了 mimeographs,这是一个由 SKILL.md 和 AGENTS.md 文件构建、包含 80 个 persona 风格智能体技能的仓库。
@DivyanshT91162 汇总了(109 次浏览)展示了同一趋势在仓库侧的体现:mattpocock/skills、OmniRoute、Orca 和 Alibaba 的 open-code-review 同时出现在一份热门列表中,抓取到的仓库元数据显示,它们分别拥有 201,741、38,881、36,743 和 18,493 个 GitHub stars。@akshay_pachaar 补充说(22 个赞、7 条回复、2,106 次浏览、25 次收藏)则给出了框架侧版本的例子:NOOA 认为,智能体应更像 Python 类,而不是一堆 prompt、schema 和回调。@__tosh 展示了(45 次浏览)则通过比较 smol、Pi 和 OpenCode 如何读取同样的八个 Python 文件,展示了这些表层差异在实际中是什么样子。
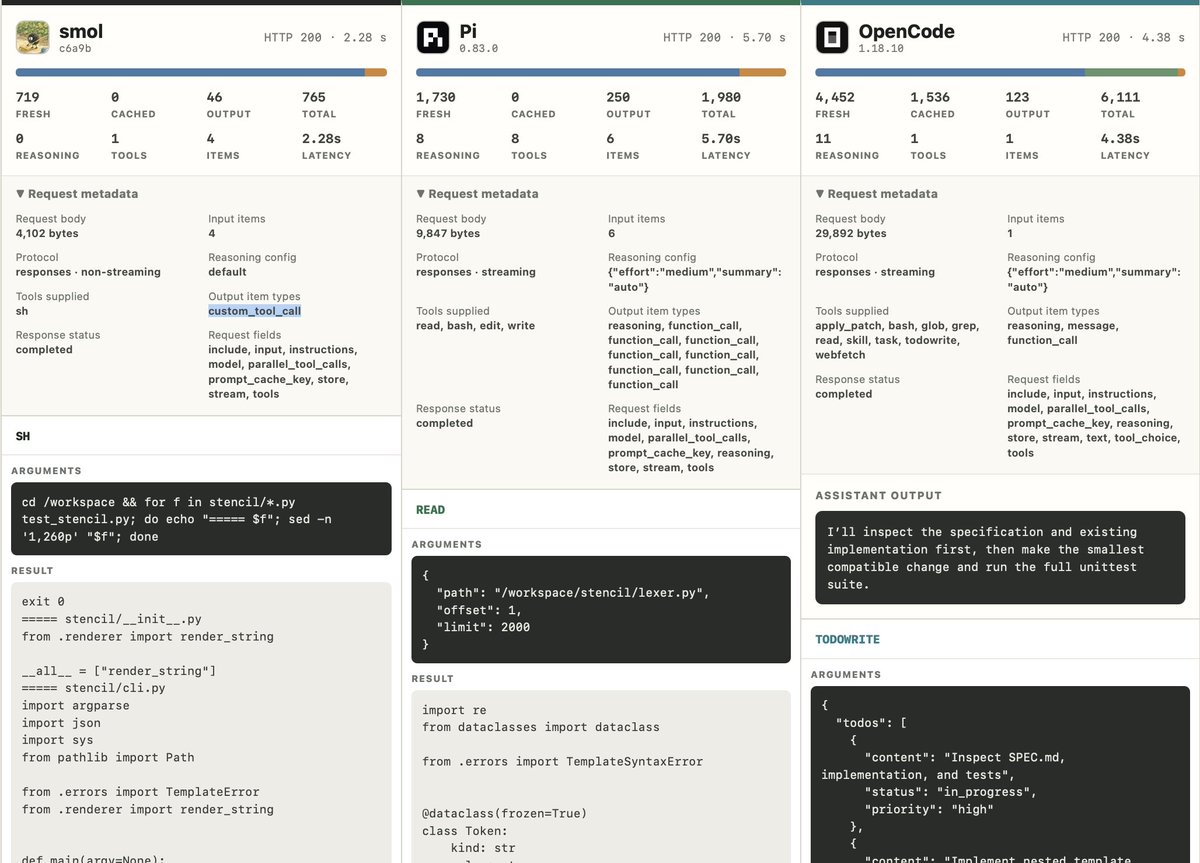
讨论洞察: 回复大多围绕可运维性,而不是模型原始质量。NOOA 的回复称赞它摆脱了“50 个不同的 yaml 文件”,但也担心继承和规模扩展问题;那条引发关注的热门仓库回复则认为,安装方式和通过 marketplace 分发的重要性,高于“再多一些工具”本身。
与前一天对比: 8 月 2 日还在概念层面梳理 harness 栈。到了 8 月 3 日,同一套栈已经进入技能 marketplace、工作流录制器、仓库汇总和可直接安装的框架抽象。
1.4 信任与安全方面的抱怨不再只是理论问题(🡕)
本周早些时候的“验证”主题,今天变得非常具体。数据集中不再只是关于独立验证器层的抽象争论,而是出现了运行时控制产品、被阻断的安全工作流,以及一条直接的数据丢失投诉。信任问题现在同时表现为一个产品类别和一种支持负担。
@_ar9av 展示了(19 个赞、7 条回复、576 次浏览)介绍了 Prismor:一个运行时控制平面,可在 Claude Code、Codex、Copilot 和框架 SDK 中拦截破坏性命令、机密外泄和 prompt injection。仓库 README 与帖子中提到的 observe mode、HITL 审批和 MCP gateway 相呼应;回复则立刻追问误报、回滚语义,以及仓库变化后由谁维护策略。
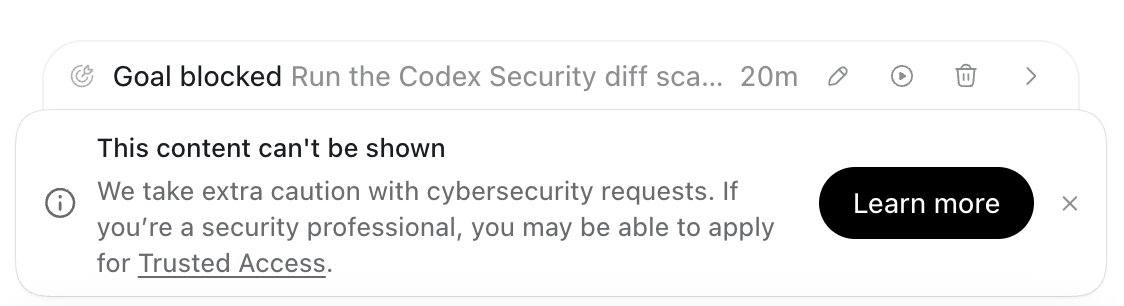
@paulbrigner 报道(163 次浏览)则展示了另一个方向上的失败:Codex Security 拒绝扫描他自己的 diff,显示的是 Trusted Access 提示,而不是执行防护性检查。@zero_dovel 报道(3 条回复)呈现了更严重的结果,称一条 Antigravity 命令几乎把一台 Windows 机器清空了;照片显示用户目录几乎空白,但在抓取时,这仍是一条单方面投诉。@stas_sorokin_ 认为(82 次浏览)则认为,vibe coding 与 agentic engineering 的区别不在于模型智力高低,而在于“先验证,再信任”。
讨论洞察: Prismor 的回复很好地体现了这种张力。人们希望在 MCP 服务器和工具调用之上有一层统一策略,但也要求有证据证明,这一层不会把合法的 shell 操作误判出来,或把智能体困在无法使用的审批循环中。
与前一天对比: 8 月 2 日强调的是把验证作为设计原则。到了 8 月 3 日,又多了被阻断的扫描、运行时策略产品和一条具体的数据丢失投诉,使得信任缺口更难被轻描淡写地带过。
2. 人们感到沮丧的地方
安全边界在两个方向上都在失灵
严重程度:高。@paulbrigner 报道(163 次浏览)称,Codex Security 拒绝扫描他自己的 diff,显示的是 Trusted Access 提示,而不是执行防护性检查。@zero_dovel 报道(3 条回复)称,一条 Antigravity 命令几乎把一台 Windows 机器清空了;附图显示用户目录几乎空白,尽管在抓取时这仍是单方面说法。@_ar9av 主推(19 个赞、7 条回复、576 次浏览)介绍 Prismor,正是瞄准这一失效区间:破坏性命令、机密泄露、prompt injection,以及围绕高风险工具调用设置审批关卡。链接中的 AISLE 披露 还提供了外部证据,说明这些担忧并非假设:它记录了 Cursor、VS Code 和 Google Antigravity 中由恶意 commit-message 链接触发的一键 RCE 路径。今天可见的应对方式,是增加明确的策略层,或重新考虑哪些任务应继续留在封闭托管界面上。值得投入构建:是。
配额断崖和模型锁定仍在塑造日常工具选择
严重程度:高。@thsottiaux 撰写关于 Codex 的内容(1,639 个赞、338 条回复、181,614 次浏览、115 次收藏)下的回复变成了一串投诉:压缩聊天和图片 bug、积分消耗过快,以及“无法支撑一整天”的 Pro 5x 配额。@JustMicrock 抱怨(8 个赞、4 条回复、374 次浏览)表示,OpenAI 仍是日常默认选择,因为竞争对手要么暂停订阅、要么没有可比的额度、要么限制模型可用场景,其中包括 Google 在 Antigravity CLI 之外的 OAuth 限制。@FReza1984 将其描述为(93 次浏览)把 OmniRoute 视为解决同一问题的基础设施,认为供应商频繁变动、免费层耗尽和不断变化的模型经济性,使“路由”比“忠诚”更实际。帖子本身已经很清楚地展示了应对模式:跨供应商路由,在 OpenCode 这类界面里寻找更便宜或免费的模型,并把高价访问额度留给真正需要它的任务。值得投入构建:是。
现有智能体界面仍把简单任务做得彼此差异过大
严重程度:中。@__tosh 展示了(45 次浏览)展示了三个智能体读取同样八个 Python 文件时,在工具调用形态、token 用量和时延曲线上表现出明显差异。@0xQuantic 总结了(14 个赞、4 条回复、656 次浏览)则从操作侧描述了同样的摩擦:Hermes + Codex 感觉最简单,Claude Code 在特定任务上有帮助,云端智能体主要是在软件工作上显得有前景,而本地模型在普通硬件上仍令人失望。@akshay_pachaar 强调了(22 个赞、7 条回复、2,106 次浏览、25 次收藏)基本上把 NOOA 视为摆脱 prompt 文件、工具 schema、回调和工作流图的一种出路。今天的绕行办法,是把技术栈收缩到一组可预测的搭配或某一个框架,而不是信任整个类别都已经成熟。值得投入构建:是。
3. 人们希望存在什么
一层既能检查高风险代码、又不会阻断合法防御工作的信任层
实际需求。最有力的证据来自这组对照:@_ar9av 出售(19 个赞、7 条回复、576 次浏览)展示的是运行时控制平面,而 @paulbrigner 失败(163 次浏览)则是在想办法让 Codex Security 去扫描他自己的 diff。AISLE 披露 和那条 Antigravity 数据丢失投诉解释了人们为什么想要审批、拒绝规则和审计追踪,但被阻断的扫描也说明,他们并不希望这些控制措施反过来禁用合法的自我保护。机会:直接。
工具切换后仍能沿用的可移植技能包与工作流捕获
实际需求。Skill Recorder、AMD Skills、mimeographs 和 mattpocock/skills 都默认一个前提:可复用的智能体行为应该是可安装、可分享、可跨工具迁移的,而不是被困在某一个聊天窗口或某一次演示里。仓库汇总帖下最有价值的一条回复说得很直白:关键特性不是“有更多工具”,而是技能真的能通过 marketplace 或命令安装。机会:直接。
不受任何厂商主场限制的开放、低价模型访问
实际需求。@Alibaba_Qwen 称(1,461 个赞、124 条回复、53,679 次浏览、250 次收藏)把明确的低价和开放权重时间点摆到了台面上;@JustMicrock 描述了(8 个赞、4 条回复、374 次浏览)指出,由于竞争对手暂停、较弱,或受平台规则限制,OpenAI 实际上成了默认选择;@FReza1984 将其描述为(93 次浏览)则把 OmniRoute 当作在配额、供应商和性价比排名持续变动时的现实答案。@yacineMTB 补充说(74 个赞、7 条回复、3,657 次浏览)则给出了这个需求在界面层的版本:庆祝 OpenCode 下拉菜单里新出现了一个免费模型。机会:直接。
用人们手头已有设备就能完成的远程监督
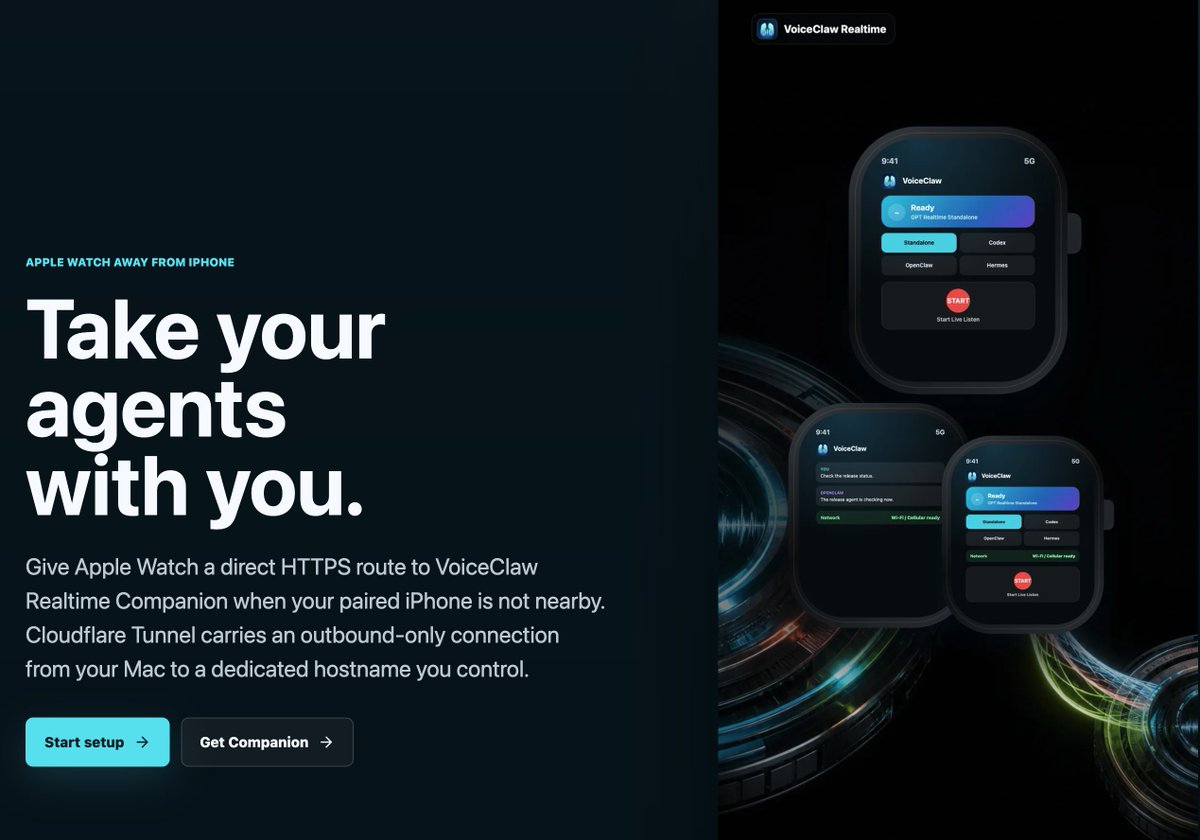
实际需求。@BenjaminBadejo 展示了(5 个赞、3 条回复、2,929 次浏览)介绍了 VoiceClaw:通过与 Mac 的直接连接,从 Apple Watch 或 iPhone 启动、引导并查看编程智能体的运行状态。重点不只是新奇,而是在长任务运行期间,减少人必须一直守在原始机器前的需要。机会:正在出现。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Qwen3.8-Max | LLM | (+) | 定价明确且较低,开放权重时间表清晰,并在多项编程任务上给出强劲基准成绩 | 今天的公开证据主要来自 Qwen 自己的发布材料和衍生帖子 |
| Codex / ChatGPT app | 智能体工作区 | (+/-) | 被用于 PR、反馈路线图、广告运营、文档工作流和站点发布 | 回复串抱怨配额消耗、压缩聊天/图片 bug、被阻断的安全扫描和记忆问题 |
| GitHub Agentic Workflows | 工作流自动化 | (+) | 能做跨仓库文档 PR,具备安全输出、受限 GitHub App 写权限和 SME 审核 | 需要谨慎设计分支路由和人工审核机制 |
| Copilot Studio GitHub harness | 业务智能体平台 | (+/-) | 支持带文件、工具、连接智能体和模型选择的长时程工作流 | 积分消耗本身就是设计约束,而且 harness 选择后无法迁移 |
| Skill packs(AMD Skills / mattpocock skills / mimeographs) | 技能分发 | (+) | 安装快速、知识可复用,并支持硬件或 persona 专项化 | 发现、策展和治理正逐渐变成独立工作负担 |
| NOOA | 智能体框架 | (+/-) | Python 类式智能体模型、类型化契约和按引用传递的数据访问 | 回复质疑随着项目变大,代码可读性和扩展性是否还能维持 |
| Prismor | 运行时安全层 | (+) | 阻止破坏性调用、机密泄露和 prompt injection;支持审批 | 策略调优和回滚语义仍是开放问题 |
| OmniRoute | 网关/路由器 | (+) | 一个端点接入 290+ 家供应商、90+ 个免费层,支持自动回退和 token 压缩 | 增加了一层依赖,且仍受外部供应商质量影响 |
| OpenCode | 开源终端智能体 | (+/-) | 模型选择范围广、UI 持续改进,促使用户继续尝试 | 当天的投诉集中在 device-code 支持和长会话内存泄漏 |
| Hermes + Codex | 工作方法 | (+/-) | 一位亲自上手的用户称其为最简单、最高效的组合 | 更广泛的云端智能体方案仍被描述为尚未普遍可用 |
没有任何单一技术栈彻底胜出。只要业务工作流里内置了人工审核,人们就更倾向于 Codex 和 GitHub 托管的界面;而成本敏感型试验则把人们推向 Qwen 的价格、OmniRoute 的回退机制,以及 OpenCode 的免费模型菜单。
迁移模式带有明显的防御性,而非意识形态性。做法是收窄任务、安装技能包、补上一层路由器或控制平面,并把人工审批或验证步骤放在任何昂贵或高风险的动作附近。OpenCode 的情绪在同一天内明显分裂;即便是相对乐观的云端智能体用户,也仍把这个类别描述为更擅长边界明确的软件任务,而不是普适默认选项。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Startup Feedback Engine | @Kappaemme1926 | 把支持、访谈、问卷和流失输入转成有证据支撑的路线图与客户证据地图 | 从嘈杂反馈中决定下一步该做什么 | Codex skill、证据 ID、聚类、路线图评分 | 已发布 | 引用的推文、信号 |
| GitHub Agentic Workflows docs pipeline | Aspire team | 在产品变更合并后起草跨仓库文档 PR | 文档落后于已上线功能 | GitHub Agentic Workflows、安全输出、GitHub App、SME 审核 | 已发布 | 文章、推文 |
| Codex Sites + Convex | @waynesutton | 通过一个可复用工作流,构建并发布带实时 Convex 后端的 Codex Sites | 智能体会猜错后端边界,或在前端与后端职责之间漂移 | Codex Sites、Convex、可复用 skill | 已发布 | 仓库、推文 |
| Skill Recorder | Microsoft | 把一次真实任务录下来并转成可复用技能或自动化 | 重复的手工工作流和脆弱的 UI 回放 | 桌面应用、GitHub Copilot CLI、Scout/Cowork/Copilot Studio | 已发布 | 仓库、推文 |
| Prismor | @_ar9av | 在智能体工具调用周围加上一层运行时控制平面 | 失控命令、prompt injection 和机密外泄 | Python hooks、HITL 审批、Slack/webhooks、MCP gateway、Ed25519 审计追踪 | 已发布 | 仓库、推文 |
| AMD Skills | @AIatAMD | 为编程智能体打包 AMD 专属工作流与最佳实践 | 不必反复教每个智能体如何在 AMD 硬件和软件上高效工作 | Skills CLI、脚本、跨智能体技能包 | Beta | 推文 |
| VoiceClaw Realtime | @BenjaminBadejo | 从 Apple Watch 和 iPhone 启动、管理并查看智能体 | 在离开原始机器时监督长时间运行的任务 | Apple Watch/iOS、直接 HTTPS、Tailscale/Cloudflare tunnel、双向语音模型 | 已发布 | 推文 |
| 农场降雨规划器 | @DanielSMatthews | 预测降雨和土壤状况,用于灌溉与养分规划 | 基于本地天气和预报数据安排农场作业 | Grok Build、Google Antigravity、天气和雷达 UI | Beta | 推文 |
| Mimeographs | K-Dense AI | 以可安装智能体技能形式提供 80 个专家 persona | 给智能体加入领域启发式和决策纪律,而不只是增加工具数量 | Python、SKILL.md、AGENTS.md、Mimeo |
已发布 | 仓库、推文 |
主导性的构建模式,是为 AI 编程本身打造元基础设施。Startup Feedback Engine、Codex Sites + Convex、Skill Recorder、Prismor、AMD Skills 和 Mimeographs 都在试图通过封装流程、领域知识或护栏,让下一次智能体运行不那么脆弱,而不是再推出一个裸聊天界面。
GitHub Agentic Workflows 是这一层已经产出可量化结果的最强证据。Aspire 这条流水线并不只是起草文字;它是在受限权限下创建跨仓库文档 PR,始终保持 draft 状态,并在 SME 审核后最终实现 82 个全部合并。这比演示视频要严格得多。
VoiceClaw Realtime 和农场降雨规划器是最明显的面向外部世界的例外。前者把手表和手机作为监督智能体的界面,而不是桌面;后者则用 Grok Build 和 Antigravity 组装用于灌溉和养分时机安排的运营软件,而不是纯开发者工具。

6. 新鲜且值得关注的内容
AI 编程熟练度直接出现在一则付费工程岗位招聘里
@LeadHerLogic 发布了(4 个赞、2 条回复、1,195 次浏览)介绍了一则 Turing 岗位,明确要求日常使用 Codex、Claude Code、Cursor、GitHub Copilot 或类似工具。截图还把它具体界定为基于 Python + Docker 的 AI 智能体评估基础设施工作,且采用每项任务 $300 的承包商模式,这比泛泛的“熟悉 AI”要具体得多。它把智能体辅助开发视为基础工作流的一部分,而不是加分项。

“Agentic engineering” 凝结成了一份验证优先的检查清单
@stas_sorokin_ 将其描述为(82 次浏览)把 vibe coding 与 agentic engineering 的差别概括为:上下文、权限、停止条件和证据。与其说这是品牌包装,不如说它是一份紧凑的检查清单,而且和当天其他内容高度呼应:被阻断的扫描、运行时安全 hooks,以及在信任生成代码之前先做明确验收检查的呼声。
用 Apple Watch 控制编程智能体已经走到可用产物阶段
@BenjaminBadejo 分享了(5 个赞、3 条回复、2,929 次浏览)介绍了 VoiceClaw Realtime:一个直接面向 Apple Watch 和 iPhone 的界面,用于启动、引导并查看运行在 Mac 上的智能体。值得关注的不只是“远程终端”本身,而是它试图让监督、中断和状态检查适配随身设备,而不是被绑定在固定桌面会话上。
7. 机会所在
[+++] 严格到足以起作用、又宽松到仍然可用的运行时信任层 - Prismor、被阻断的 Codex Security 扫描、Antigravity 数据丢失投诉,以及 AISLE 的披露,都指向同一个缺口:团队需要审批、策略和审计层,同时又不能妨碍合法的安全与维护工作继续进行。
**可移植技能包与工作流捕获+++] 可移植的 skill 与工作流打包** - Skill Recorder、AMD Skills、mimeographs、[mattpocock/skills,以及 Copilot Studio 的 harness 选择,都表明可复用行为正在成为一个产品类别。证据横跨厂商技能包、开源仓库和工作流捕获工具,而不是某一次孤立的发布。
[++] 具备审批感知的业务工作流 - 从反馈到路线图的分析、广告活动执行、文档 PR 自动化,以及 Codex Sites + Convex,都显示出对受限智能体工作流的需求:在有意义的检查点停下,而不是试图端到端自动跑完整个业务流程。
[++] 开放且更低价的前沿模型访问,以及可恢复循环 - Qwen 的发布、JustMicrock 的竞争投诉、OpenCode 的免费模型菜单,以及 OmniRoute 的回退层,都表明人们实际需要的是一种不被单一订阅或单一供应商策略锁定的可迁移高端能力。
[+] 移动监督界面 - VoiceClaw 显示出从手表或手机审批并引导工作的早期需求,而不必始终守在原始机器前;不过目前证据仍仅限于少量帖子。
8. 要点
- 最重要的模型故事不只是性能,而是可检查性。 @Alibaba_Qwen 结合了 展示了开放权重时间点、价格和基准成绩,而 @codeglitch 翻译了 则把这次发布转译成了带检查点的
DONE/NEXT/BLOCKED工作流。 - Codex 正在依据运营型工作流接受评估,而不只是代码生成能力。 最有力的证据来自 @gdb 推动 的反馈转路线图技能、@gdb 强调 的受监督广告执行,以及 @github 展示 的 82 个已合并文档 PR 和 44.8 小时的中位合并时长。
- 技能和 harness 的产品化正在变成独立的竞争层。 @FlowAltDelete 将其视为 把 harness 选择视为一种架构决策,而 Skill Recorder、AMD Skills、mimeographs 和 仓库汇总 都把可复用智能体行为当成了一种产品。
- 信任仍然落后于能力。 同一天里出现了 运行时控制平面方案、被阻止的 Codex Security 扫描、与 Antigravity 相关的数据丢失投诉,以及 AISLE 的 一键 RCE 披露。
- AI 编程熟练度正在外溢到设备和岗位之中。 @BenjaminBadejo 转向了 把智能体监督带到了手表上,而 @LeadHerLogic 分享了 则是一则把日常使用 AI 编程助手视为岗位基础要求的承包招聘信息。