Twitter AI 编程 - 2026-08-04
1. 人们在讨论什么
1.1 编程代理正在成为工作流承载层,而不只是代码生成器(🡕)
最突出的主题是:代理开始吸收代码之外的整套流程,包括规格定义、可复用步骤、事件触发器和审批关卡。至少有五条实质性内容体现了这种转变,代表性的包括 Antigravity 的引导式构建流程、Microsoft 的 Skill Recorder、由 GitHub 评论触发的自动化、Career Ops,以及 Lettertrace。
@antigravity 演示了(520 个赞、26 条回复、32,623 次浏览、257 次收藏)展示了一个 Chrome 标签页整理器和一个后台桌面文件标记器,它们借助 /grill-me 的设计提问、语音提示和内联产物评论构建而成。真正有用的细节在于顺序:先让代理质疑设计,再开始构建,然后直接在生成的产物上发表评论。一条回复称赞这种机制能避免“把错误的东西做出来”;另一条回复则称,Antigravity 已经连续七天卡在“working...”循环中。
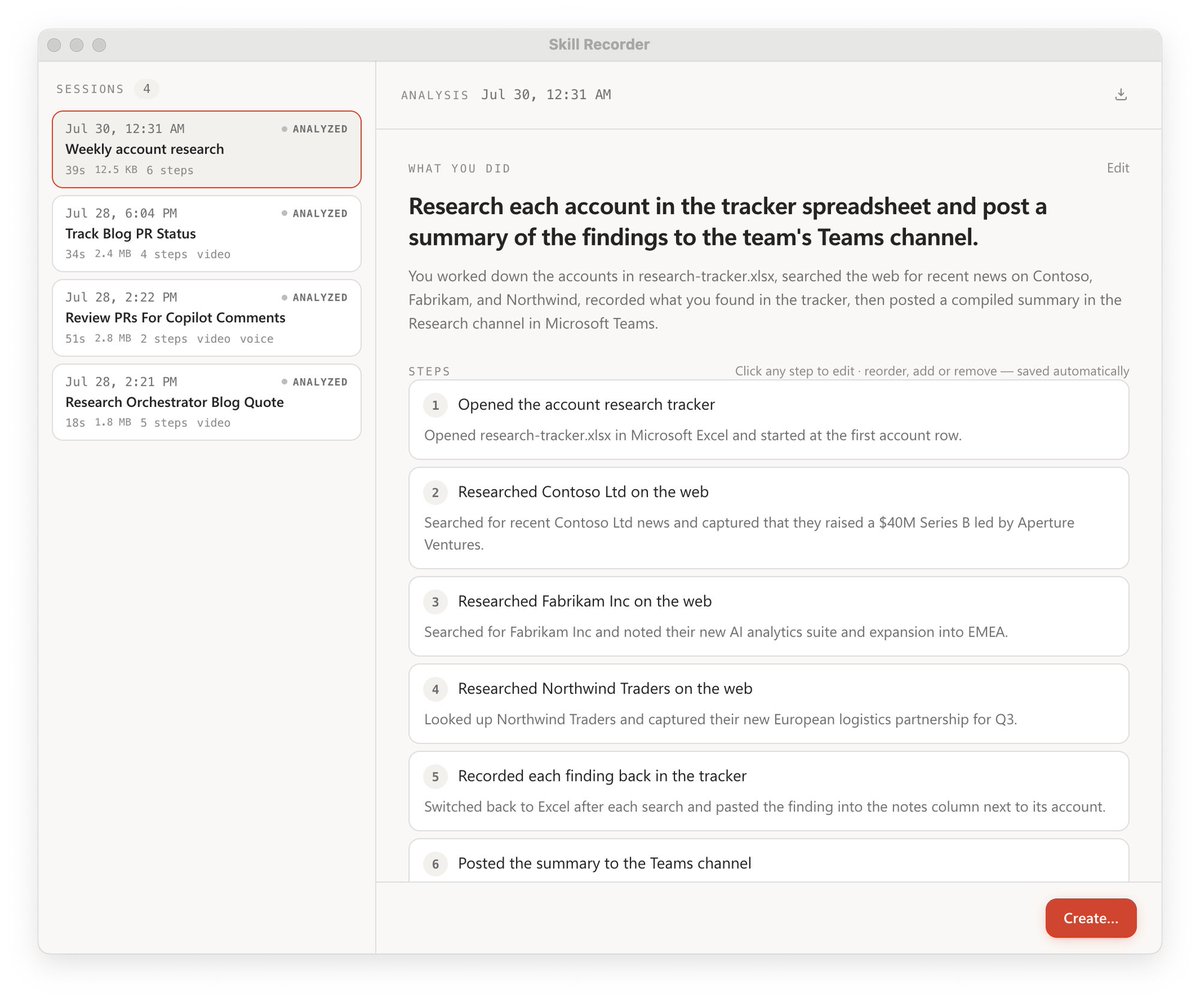
@0x_sakata 披露了(45 个赞、24 条回复、1,166 次浏览)介绍了 Microsoft 的 Skill Recorder:它记录一次屏幕工作流,并使用 Copilot CLI 将其意图和有序步骤重建为可复用的 SKILL.md 或 Automation。该仓库还补充了一个重要限定:录制保留在本地,但如果选择 Analyze,事件元数据、选定的屏幕图像和旁白文本会被发送到 GitHub 云端。
@GHchangelog 宣布了(16 个赞、1,885 次浏览、6 次收藏)称,Copilot 自动化现在可以由 issue 或 pull request 评论触发。GitHub 的 更新日志 列出了三类边界明确的用途:生成文档、调查错误,以及在出现配置好的评论文本时创建后续 issue。
讨论洞察: 最强的实现都保留了人的控制权。Career Ops 会筛选并起草,但提交仍由用户完成;Skill Recorder 要求用户审核重建出的步骤;GitHub 的评论触发器则让触发事件本身清晰可见。薄弱点不在于代理能否执行步骤,而在于工作流是否暴露了足够的控制点和隐私边界。
与前一天相比: 8 月 3 日的重点是可安装技能和可量化的 GitHub 文档工作流。到 8 月 4 日,讨论又向外扩了一层:人们开始从桌面录制工作流、从仓库评论触发工作流,并把它们用于求职和可见性遥测。
1.2 价格、容量和延迟对模型选择的影响,超过了基准排名(🡕)
四条高信号内容把模型经济学变成了实际运营问题。OpenCode 报告了 DeepSeek 的容量约束;一位开发者因额度消耗过快而放弃 Qwen;一位 Cerebras 用户把速度视为防止上下文切换的保障;而关于云端代理的争论,则在追问更多算力是否真能解决瓶颈。
@thdxr 表示(374 个赞、36 条回复、14,132 次浏览)称,OpenCode Go 用户每天在 DeepSeek 上花费 $130,000,而在 API 反复故障期间,DeepSeek 曾限制 OpenCode 的流量。在回复中,他表示 OpenCode 采用零数据保留安排,并正逐步将更多流量迁移到自有服务系统;这些数字仍是归因明确的说法,而非经过独立审计的数据。
@MystiqueMide 报道了(11 个赞、4 条回复、564 次浏览)称,在 OpenCode Go 中,仅仅几项产品任务就耗尽了 Qwen3.8-Max 的额度,因此转而使用 DeepSeek V4 Flash。附带的使用量视图让这条抱怨更具体,但并未控制任务难度或 token 数量等变量。

@kelxyz_ 认为(65 个赞、11 条回复、5,042 次浏览、28 次收藏)称,Cerebras 推理速度据称约为每秒 750 tokens,这会改变编程代理的使用体验,因为响应会在注意力转移之前就返回。一条回复质疑服务容量能否支撑这种增长逻辑,使容量成为与延迟相对的关键约束。
讨论洞察: 更快和更便宜并没有自然收敛到单一赢家。DeepSeek 的吸引力强到足以导致过载;Qwen 收到了额度消耗过快的直接抱怨;Cerebras 因响应迅速受到欢迎,但也伴随着容量方面的质疑。实际做法是路由流量、自建并承接越来越多的服务份额,或切换模型,而不是押注单一供应商。
与前一天相比: 8 月 3 日聚焦于 Qwen 的开放权重发布时间表和较低的公开 token 价格。8 月 4 日则给出了运营侧的修正:如果配额、服务容量和端到端延迟无法在真实代理负载下维持,标价再低也没有太大意义。
1.3 上下文与 harness 基础设施,正在成为持久的竞争层(🡕)
至少有五条内容指向同一种反复出现的成本:代理和工具会不断丢失项目知识、工作流经验或共享能力。给出的答案包括可读代码图谱、跨代理 MCP、多代理学习配置、共享账本,以及以证据为边界的 harness 评估。
@QCXINT_ 推出了(5 个赞、2 条回复、101 次浏览、5 次收藏)介绍了 Graft:它把代码库表示为一个链接式 Markdown 图谱,让代理无需在每次会话里重新发现 import 和 API,就能复用代码库上下文。Graft 基于项目自身的 162 次运行对比报告称,在正确率同为 93% 的情况下,未缓存输入 token 减少 42%,工具调用减少 46%,延迟降低 60%;其单独进行的 8 个实例 SWE-bench 对比则显示,使用 Graft 解决了 6/8 个问题,而不使用时为 4/8。附带基准总结的是受控测试结果,而非独立验证。

@heynavtoor 介绍了(29 个赞、11 条回复、3,011 次浏览、14 次收藏)介绍了 OpenWork:这是一款免费的开源桌面应用,并提供一个 MCP 端点,用于在 Codex、Claude Code、Cursor 和 OpenCode 之间复用技能、插件和已连接服务。一条回复把“本地优先”的诉求说得很具体:无论许可证价格如何,财务记录都应该保留在自托管代理上。
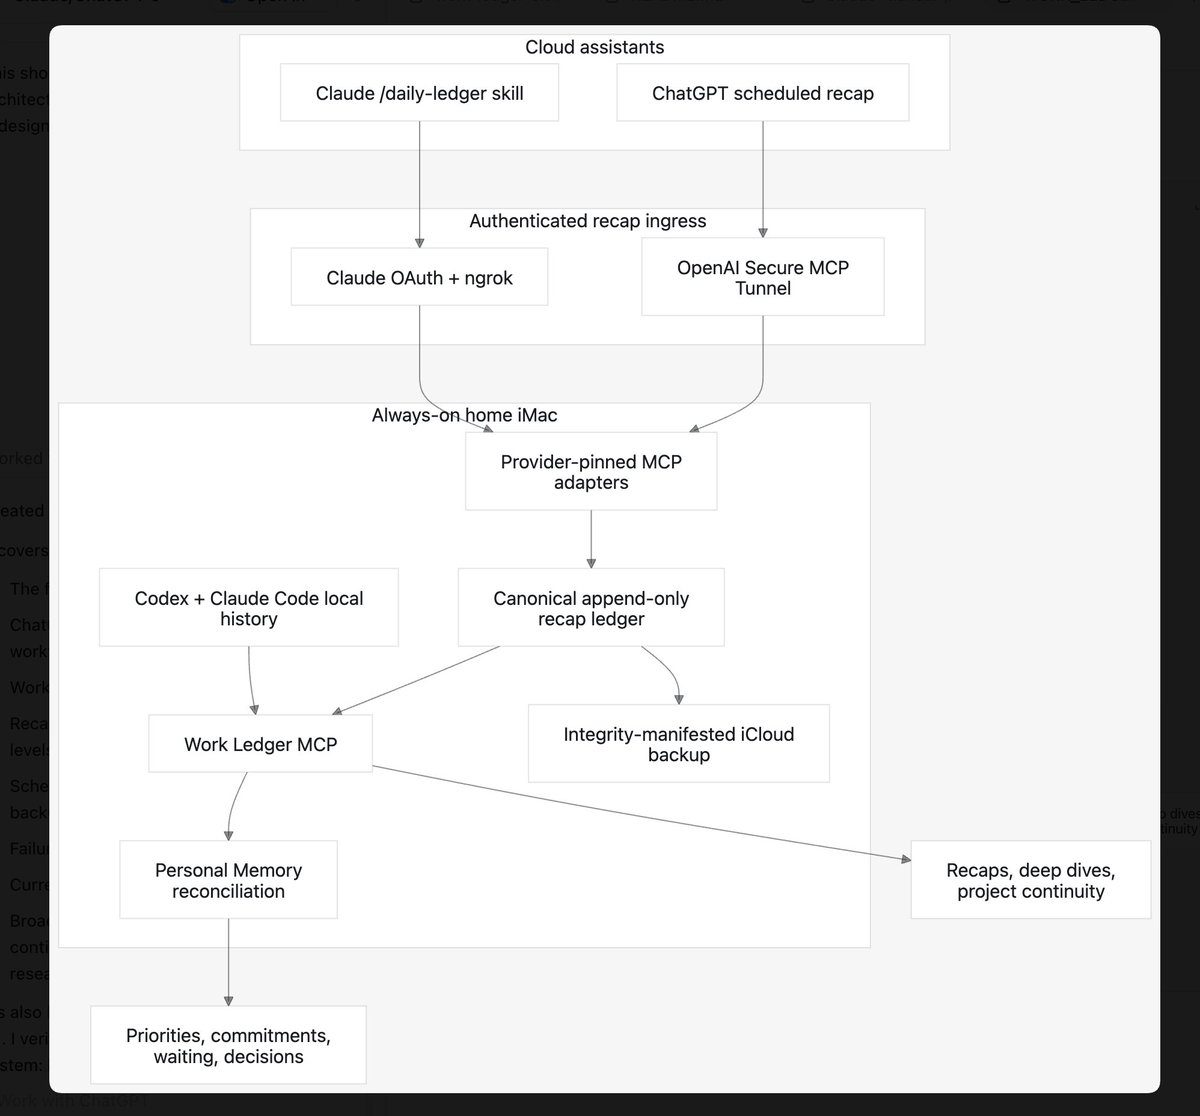
@yoheinakajima 分享了(6 个赞、3 条回复、1,330 次浏览)介绍了一种个人记忆架构:将本地 Codex 与 Claude Code 的历史记录,与每晚生成的 ChatGPT 和 Claude 摘要结合起来。由供应商绑定的 MCP 适配器把内容写入追加式账本,进行对账,并生成带完整性清单的 iCloud 备份;作者仍担心错误写入或意外删除记忆。
@qoder_ai_ide 报道了(10 个赞、1 条回复、748 次浏览、8 次收藏)称,Better Harness 在上线第一周就从四个宿主适配器扩展到了十个。其仓库评估任务理解、受控执行、验证、可靠交付和学习捕获,并明确标出缺失证据,而不是凭空编造分数。
讨论洞察: 可信的上下文产品并没有承诺“魔法记忆”。Graft 把自己的基准边界展示得很清楚,Better Harness 明确保留了未观察到的证据,共享记忆设计则加入了对账与备份。一条 Graft 回复建议更进一步,使用包含 repo SHA、文件集、图谱版本、新鲜度、已回答查询和失效规则的“代码库收据”。
与前一天相比: 8 月 3 日关注的是把技能和 harness 打包成可安装组件。到 8 月 4 日,焦点变成了安装之后还能留住什么:代码库知识、工作流证据、可移植连接,以及跨代理的记忆完整性。
1.4 安全性从警示措辞转向了具体控制(🡕)
这波安全讨论包含了一项直接的产品诉求、一项已记录且已修复的漏洞、本地沙箱文档,以及一种“停止前验证”模式。共同关注点是新鲜证据与受限执行,而不是泛泛一句“请小心”。
@ForwardEditor 询问了(66 个赞、20 条回复、6,730 次浏览)质问,为什么 Codex 默认没有提供钩子,来防止误删整台电脑。一条回复把这个产品缺口扩展到了可编辑的共享文档,认为代理 harness 仍然更像公开实验,而不是完整产品。
@github 指出了(29 个赞、7 条回复、9,954 次浏览、12 次收藏)介绍了其 Copilot CLI 本地沙箱文档。这个公开预览功能默认给予当前工作区写权限,将 home 和 system 位置设为只读,阻止访问其他磁盘位置,并要求命令离开沙箱前必须获得批准。
@AISecHub 链接到(6 个赞、541 次浏览、5 次收藏)提到了 AISLE 的 一键式 RCE 漏洞披露。AISLE 表示,恶意提交信息中的链接可能在未经确认的情况下执行任意命令;但也表示 Cursor、Google 和 Microsoft 已修复该问题。可执行的结论是:运行最新版本。
@julientalbot974 描述了(6 个赞、1 条回复、74 次浏览)介绍了 Hermes Agent 的“verify-on-stop”:如果当前任务上下文里没有生成测试或构建结果,代理就不能把工作标记为完成;如果证据过时或缺失,它就会被推回循环。由于数据集中没有外部变更日志,这仍属于有明确归属的报道。
讨论洞察: 控制措施如果只是“存在”,并不等于有效。沙箱需要明确的越界批准;测试必须是当前的,而不是沿用早先运行的结果;记忆系统则需要完整性校验,以防删除或错误写入。
与前一天相比: 8 月 3 日展示了运行时安全产品、一次被阻止的安全扫描,以及一条数据丢失抱怨。到 8 月 4 日,则补上了原始文档和一个具体的完成条件不变量:没有当前验证证据,就不存在“完成”状态。
2. 人们为什么感到挫败
容量故障和额度限制,总是在工作完成前先到来
严重程度:高。@thdxr 报道了(374 个赞、36 条回复、14,132 次浏览)称,前所未有的 DeepSeek Flash 需求导致 OpenCode Go 出现错误和流量限制;同时,@MystiqueMide 表示(11 个赞、4 条回复、564 次浏览)提到,Qwen3.8-Max 在仅完成几项产品任务后就耗尽了额度。应对方式很直接:把流量转到 OpenCode 可控的基础设施、切换到 DeepSeek V4 Flash,或同时保留多个供应商。值得投入建设:是,因为这类故障影响的是正在进行的会话,而不只是月度预算。
代理反复重建本该持久保留的上下文
严重程度:高。@QCXINT_ 描述了(5 个赞、2 条回复、101 次浏览、5 次收藏)提到,代理会反复 grep 文件、追踪 import,而这些内容在先前会话里明明已经探索过。@yoheinakajima 构建了(6 个赞、3 条回复、1,330 次浏览)提出了一个跨四个助手的共享记忆账本,但作者仍担心错误写入或删除会破坏它。Graft 和这套账本架构都属于具体的缓解方案;但二者都没有消除对新鲜度、来源和回滚机制的需求。值得投入建设:是。
安全控制不是默认开启,就是不够可见
严重程度:高。@ForwardEditor 询问了(66 个赞、20 条回复、6,730 次浏览)追问,为什么 Codex 默认不内置破坏性命令钩子。AISLE 的 已修复的 RCE 漏洞披露 则展示了更广泛的暴露面:在受影响的编辑器版本中,嵌入提交信息的链接可能在没有提示的情况下执行任意命令。GitHub 的 本地沙箱 与 Hermes 风格的停止前验证,是当天最清晰的应对机制。值得投入建设:是。
产品打磨和可靠性,落后于能力本身
严重程度:中。@kimmonismus 更倾向于(107 个赞、23 条回复、5,272 次浏览)表示,相比 Claude 的 iOS 界面,Codex 因为更整洁、组织更清晰而胜出。当天最大产品演示下,一条关于 Antigravity 的回复报告了持续七天的“working...”循环;而在 Codex 钩子诉求下的另一条回复则追问,为什么用户不能在共享界面上编辑代理生成的文档。这些都不是模型质量问题,而是导航、可恢复性和协作问题。值得投入建设:是,尤其是在长时间运行的工作横跨桌面和移动端时。
3. 人们希望存在什么
与供应商无关、可自动故障转移且兼顾隐私的容量
实际需求。OpenCode 事件把错误、供应商施加的流量限制、零数据保留问题,以及向自有服务逐步迁移但尚未完成的现实,全都集中到了同一条讨论里。@thdxr 确认了(374 个赞、36 条回复、14,132 次浏览)同时提到了 ZDR 安排,以及逐步把流量迁移到 OpenCode 可控基础设施的过程。像 OmniRoute 这样的路由器,能够部分解决回退问题,但容量归属和隐私保证仍会随链路跳点而变化。机会:直接且竞争激烈。
可移植、保持新鲜、可归因且可逆的记忆
实际需求。@yoheinakajima 展示了(6 个赞、3 条回复、1,330 次浏览)表明,借助本地历史记录、定时摘要、MCP 适配器、追加式账本和对账机制,跨助手记忆是可行的。他后续又提出,需要防止记忆失真或被删除;而一条 Graft 回复则建议明确记录 repo SHA、图谱版本、stale_at、查询历史和失效规则。机会:直接。
默认开启、并要求新鲜证据的防护机制
实际且紧迫的需求。@ForwardEditor 询问了(66 个赞、20 条回复、6,730 次浏览)呼吁为 Codex 提供能让破坏性删除不可能发生的钩子;而 @julientalbot974 描述了(6 个赞、1 条回复、74 次浏览)则提出了更强的完成规则:没有新鲜且通过的测试或构建,就不能标记为“完成”。GitHub 的本地沙箱部分覆盖了文件系统范围问题,但它仍是一个需要用户手动开启的公开预览功能。机会:直接。
能转化为优先级审计的遥测
实际需求。@mathewpregasen 发布了(43 个赞、14 条回复、133,017 次浏览)介绍了 Lettertrace,用于衡量 LLM 品牌提及、声量份额、情绪和竞争对手。一条回复指出,代理机构真正缺的是另一层:固定条件、证据采集、优先级排序,以及一份把事实与假设分开的报告,并给出下一步建议。机会:直接,但与刚发布的免费追踪器相邻。
一个横跨代理与设备、可共同编辑的工作界面
实际需求。Codex 安全钩子讨论下的一条回复质问,为什么代理生成的文档不能协作编辑;而 @kimmonismus 表示(107 个赞、23 条回复、5,272 次浏览)则表明,Codex 在桌面和 iOS 上因组织性更强而胜出。OpenWork 提供了共享能力层,但现有证据仍显示,人们需要的是一个公共产物界面:支持编辑、状态和恢复,并且在切换代理后仍能延续。机会:竞争性机会。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Google Antigravity | 代理 IDE | (+/-) | /grill-me、语音提示、内联产物评论,以及可见的端到端构建流程 |
一条回复称其持续七天卡在 working 循环中;另一条回复希望提供更新的模型选择 |
| Codex | 编程代理 / 应用 | (+/-) | 因界面整洁和 iOS 体验受到称赞;可作为技能和 MCP 的宿主 | 用户要求默认提供破坏性命令钩子,以及可编辑的共享产物 |
| OpenCode Go | 代理订阅 / 网关 | (-) | 通过一个编程界面提供多个模型,并展示滚动使用量 | DeepSeek 容量错误和 Qwen 额度消耗过快打断了正在进行的工作 |
| DeepSeek V4 Flash | 编程模型 | (+/-) | 一位开发者认为其价格和可用输出优于 Qwen | OpenCode 报告其需求前所未有,并出现错误和供应商流量限制 |
| Qwen3.8-Max | 编程模型 | (-) | 可通过 OpenCode Go 使用,能力足以吸引产品测试 | 一位开发者称其额度消耗激进,随后切换离开 |
| Cerebras | 推理平台 | (+/-) | 据称响应极快,能减少注意力切换 | 每秒 750 tokens 的说法来自用户报告;回复中有人质疑其容量 |
| OpenWork | 桌面工作区 / MCP | (+) | 可在多个代理之间复用技能、插件和已连接服务;提供本地桌面选项 | 远程 MCP 和云连接能力仍需明确选择数据边界 |
| Skill Recorder | 工作流录制 | (+/-) | 可把录制的任务转换为经审核的步骤、Skill 或 Automation | Analyze 会把选定的录制数据发送到 GitHub 云端;敏感信息必须避开录制内容 |
| Graft | 代码库上下文图谱 | (+) | 可读的 Markdown 图谱;项目基准报告称 token、调用次数和延迟均有所下降 | 基准证据由项目方提供;新鲜度与失效机制仍然重要 |
| Better Harness | Harness 评估 | (+) | 通过跨宿主适配器,在五个工作流维度上给出以证据为边界的发现 | 配置存在,并不等于它实际被执行,或确实改善了结果 |
| Copilot CLI 本地沙箱 | 运行时隔离 | (+/-) | 仅限工作区写入、home/system 路径只读、其他磁盘位置被阻止 | 仍处于公开预览、属实验性功能,且更广泛的命令访问依然可以被批准 |
| Hermes verify-on-stop | 验证方法 | (+) | 在完成前要求提供当前任务生成的测试或构建证据 | 证据来自一条有归属的推文,评审材料中没有外部变更日志 |
| Agent Browser | 浏览器自动化 CLI | (+) | 原生 Rust CLI、无障碍快照、语义查找器、选择器和提取能力 | 仍需要可运行的本地浏览器,并且必须明确处理被遮挡的控件 |
整体满意度沿着运营层面分化。Codex 因界面组织受到称赞,Antigravity 因规格定义和产物交互受到认可,Cerebras 则因响应速度获得好评;而一旦额度或服务容量打断构建,模型接入就会引发最尖锐的负面反馈。
常见的应对方式是可组合化:保留不止一个模型,在能力与当前代理之间加入路由器或 MCP,把上下文持久化到聊天之外,再叠加沙箱和新鲜验证关卡。迁移证据具体但范围有限:一位 OpenCode Go 用户从 Qwen3.8-Max 转到了 DeepSeek V4 Flash;另一位跨工具用户则把新工作从 Claude 转向了 Codex。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Antigravity 引导式构建流程 | @antigravity | 通过设计质询、语音提示和内联评论来构建并打磨产物 | 代理执行规格不充分的想法 | Antigravity 2.0、/grill-me、语音、产物评论 |
已发布 | 演示(520 个赞、32,623 次浏览) |
| Skill Recorder | Microsoft | 把一次录制的桌面工作流转化为经审核的步骤,以及可复用的技能或自动化 | 重复性流程,以及手动编写操作说明 | Electron、GitHub Copilot CLI、SKILL.md |
已发布 | 代码库、推文(45 个赞、24 条回复) |
| OpenWork | different-ai | 在兼容代理之间共享技能、插件、MCP 和已连接服务 | 能力重复建设和代理锁定 | 桌面应用、远程 MCP、OAuth、Google Workspace、Microsoft 365 | 已发布 | 代码库、推文(29 个赞、3,011 次浏览) |
| Career Ops | santifer | 筛选职位、核验真实性、定制申请材料、准备面试并审阅 offer | 高数量、低信号的求职过程 | 代理技能、Node.js、Markdown、Playwright;多个编程 CLI | 已发布 | 代码库、推文(21 个赞、16 次收藏) |
| Lettertrace | @mathewpregasen | 跟踪 LLM 提示中的品牌提及、声量份额、情绪和竞争对手 | AI 可见性遥测过于昂贵或难以获得 | CLI、Anthropic/OpenAI/Google API 或模型路由器 | 已发布 | 网站、推文(43 个赞、133,017 次浏览) |
| Better Harness | QoderAI | 审计代理工作循环,并提出与证据挂钩的改进建议 | 最终差异审查遗漏的工作流弱点 | 跨宿主适配器、Markdown/HTML 报告、代理技能 | Beta | 代码库、推文(10 个赞、8 次收藏) |
| Graft | NanoNets | 构建一个可读的代码库链接式 Markdown 图谱,供编程代理复用 | 代码库被反复重新发现 | TypeScript CLI、tree-sitter、Markdown 图谱、可选 LLM 摘要 | 已发布 | 代码库、推文(5 个赞、5 次收藏) |
| OpenCode 学习配置 | joelhooks | 分解工作、运行并行 worker、记录结果,并提升或淘汰模式 | 代理在跨会话中重复失败策略 | OpenCode、swarmtools、CASS、Ollama、nomic-embed-text |
Beta | 代码库、推文(4 个赞、1,162 次浏览) |
| Agent Browser | Vercel Labs | 为代理提供浏览器交互所需的原生 CLI 和可读页面状态 | 每个代理项目都要重复搭建浏览器自动化 | Rust CLI、Chrome for Testing、无障碍树 | 已发布 | 代码库、推文(5 个赞、4 次收藏) |
| Unity AI Gateway | @databricks | 在代理和应用之间集中管理模型接入、成本归属、可观测性和策略 | 企业 AI 支出与工具访问失控 | Databricks Unity AI Gateway、供应商与代理遥测 | 已发布 | 推文(10 个赞、424 次浏览) |
Career Ops 是“编程 harness 变成软件交付之外的运营系统”的最清晰例子。其 README 报告称,已评估 740+ 个职位、生成 100+ 份个性化简历,并成功拿下一份工作;其架构会有意拒绝低于阈值的岗位,而且绝不会点击 Send。这里的区别很重要:代理负责压缩搜索空间,而真正产生后果的动作仍由人来完成。

Skill Recorder、OpenWork、Better Harness、Graft 和 OpenCode 配置,构建的都是围绕“下一次运行”的基础设施,而不是又一个模型。它们捕获流程、暴露能力、评估证据、保留代码库结构,或从结果中学习。反复出现的触发因素,是信息和控制权在不同会话之间、或不同代理产品之间不断流失。
Unity AI Gateway 则代表了同一模式的企业版本。@databricks 声称(10 个赞、424 次浏览)提到其已正式可用、拥有数千家客户,并在上一年处理了超过一千万亿个 tokens;这些规模数据由供应商自行报告。其附带图表更具体,按组织和编程代理身份分别展示了每日支出。

6. 新内容与值得关注的动向
Better Harness 一周内扩展到十个宿主适配器
@qoder_ai_ide 报道了(10 个赞、1 条回复、748 次浏览、8 次收藏)称,在社区新增 Qwen Code、GitHub Copilot、Pi、Grok、Kimi Code 等宿主支持后,四个第一方适配器扩展到了十个。代码仓库 进一步确认,安装方式和输出格式仍然因宿主而异,并没有假装所有代理都能共用一种通用集成方式。

本地执行与云端执行,成为明确的架构选择
@haider1 解读为(119 个赞、13 条回复、6,911 次浏览)给出了一种判断:“下一代模型需要的不只是你的笔记本电脑”,暗示行业正转向更强的云端代理。一条回复提供了有价值的反面观点:对那位实践者来说,真正的瓶颈仍是上下文和判断,而不是算力。同一天,OpenWork 强调本地执行,GitHub 则记录了本地沙箱,因此释放出的信号是“选择与边界设定”,而不是已经尘埃落定的云迁移。
延迟被描述成注意力基础设施
@kelxyz_ 描述了(65 个赞、11 条回复、5,042 次浏览、28 次收藏)把 Cerebras 的快速推理描述为有价值,因为它能在答案返回前防止发生上下文切换。这与基准准确率是不同的评估目标:响应时间之所以重要,是因为它能保住人的任务状态。不过这条讨论里仍有对容量的怀疑,因此这更像一种正在形成的 UX 指标,而不是某个服务平台已经胜出的证明。
7. 机会在哪里
[+++] 具备可执行隐私保证的容量感知路由 - OpenCode 的 DeepSeek 事件、部分转向自建服务、ZDR 问题,以及从 Qwen 切到 DeepSeek 的案例,都指向同一种需求:在会话失败前完成故障转移,同时清楚展示由谁提供服务、数据是否保留,以及每条路由的成本。
[+++] 面向本地编程代理、可验证且默认开启的安全机制 - 对破坏性命令钩子的诉求、GitHub 的可选本地沙箱、AISLE 记录并已修复的一键 RCE,以及 Hermes 风格的停止前验证,覆盖了预防、隔离与证明。强产品应把范围受限的执行和新鲜验证做成默认值,而不是专家配置项。
[+++] 以来源为先的共享记忆与代码库上下文 - Graft、四助手账本、Better Harness,以及提出的代码库收据,分别从不同方向收敛到同一件事:持久上下文必须带着来源、版本、新鲜度和失效机制。机会不在于“更多记忆”,而在于可审计、可对账、可回滚的记忆。
[++] 可移植的工作流与能力层 - Skill Recorder 把观察到的工作转化为可复用流程,OpenWork 通过单一 MCP 暴露能力,GitHub 评论则能触发边界明确的自动化。现有证据支持这样一类产品:在不悄然扩大权限的前提下,让同一个经审核的工作流跨代理宿主延续。
[++] 构建在代理遥测之上的行动层 - Lettertrace 衡量可见性,Unity AI Gateway 归因支出,但 Lettertrace 的回复要求的是固定条件、证据采集、优先级排序,以及一份区分事实与假设的报告。仪表板已经有了;值得信任的下一步行动系统仍是明显缺口。
[+] 保持注意力连续性的推理与界面 - 对 Cerebras 的热情,把延迟与减少上下文切换联系在一起;对 Codex 的赞赏,则把工具选择与桌面和 iOS 上的整洁组织联系在一起。这一信号值得关注,但目前仍建立在少量实践者报告之上。
8. 要点
- 工作流设计传递出的信号,超过了原始代码生成本身。 @antigravity 展示了(520 个赞、26 条回复、32,623 次浏览、257 次收藏)体现为规格提问和产物评论;Skill Recorder 以及 GitHub 的 评论自动化 则把流程变成可复用或事件驱动的工作。
- 人们体验到的模型经济学,是会话被打断,而不是抽象的价格表。 @thdxr 报道了(374 个赞、36 条回复、14,132 次浏览)体现为 DeepSeek 的容量限制;@MystiqueMide 报道了(11 个赞、4 条回复、564 次浏览)则体现为 Qwen 因额度消耗过快而被弃用。
- 只有当来源与新鲜度可见时,持久上下文才真正有用。 Graft 发布了项目方提供的 token、延迟和正确率对比;@yoheinakajima 新增了(6 个赞、3 条回复、1,330 次浏览)则展示了追加式账本、对账和备份,同时仍提醒记忆可能失真或被删除。
- 安全证据变得更具体了。 @github 记录了(29 个赞、7 条回复、9,954 次浏览、12 次收藏)记录了本地 OS 沙箱;AISLE 记录了 已修复的一键式 RCE;@julientalbot974 描述了(6 个赞、1 条回复、74 次浏览)则把新鲜验证设为“完成”的前提。
- 跨代理可移植性正成为产品要求。 @heynavtoor 介绍了(29 个赞、11 条回复、3,011 次浏览、14 次收藏)展示了 OpenWork 的共享 MCP 层;@qoder_ai_ide 报道了(10 个赞、1 条回复、748 次浏览、8 次收藏)则展示了 Better Harness 适配器在社区推动下从四个增长到十个。
- 最强的构建者,都保留了会产生后果的人类决策。 Career Ops 会拒绝匹配度低的岗位并起草材料,但绝不代为提交;而 Skill Recorder 会在创建可复用工作流前,先要求用户审核重建出的步骤。