Twitter AI 编程 - 2026-08-05
1. 人们在讨论什么
1.1 Agent 工作区新增了语音、持久化指令和设备控制(🡕)
最集中的讨论围绕 Agent 的操作界面本身展开。至少有五条较为实质的内容,都不再把编程 Agent 视为聊天窗口,而是把它看作具备持久化设置、语音输入、实时画布和可见产物控制能力的工作区。
@antigravity 演示了(626 个赞、31 条回复、42,642 次浏览、307 次收藏)介绍了一个 Chrome 标签页整理器和桌面文件标记工具。该工具使用 /grill-me 构建,支持语音提示和内联产物评论。真正有价值的细节不只是 Agent 能生成代码,而是操作者可以在开始构建前先质疑规格,之后还可以直接对结果发表评论。回复一部分赞赏这种规格确认步骤,另一部分则提出了一个具体的可靠性问题:系统连续七天停留在“working...”循环中。
@OpenAIDevs 展示了(85 个赞、20 条回复、11,074 次浏览、23 次收藏)讨论了 Codex 中的语音功能,把它作为管理界面来用:先口述想法,等想法具体后再启动新的 Codex 会话,其他线程则稍后再查看。他们后续给出的示例表明,这种模式已经超越听写,延伸到功能规划、验证、拉取请求、创建工单和研究流程。
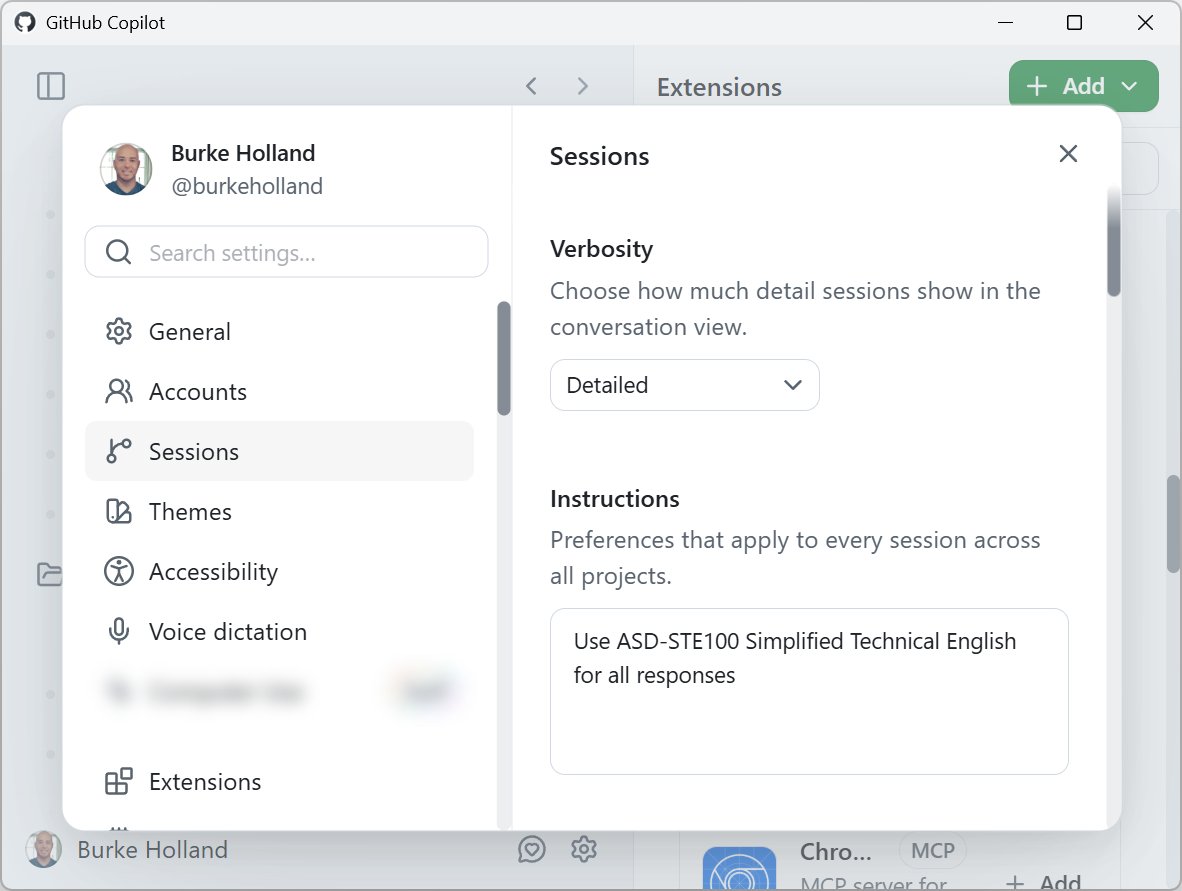
@burkeholland 披露了(21 个赞、1,490 次浏览、17 次收藏)展示了 GitHub Copilot 应用的设置页面,其中包括全局指令和会话详略程度设置,让团队规范成为产品中的一等控制项,而不必再反复粘贴提示词。
@JamesMontemagno 强调了(11 个赞、1,419 次浏览、18 次收藏)介绍了 mobile-canvas-ghcp。其 README 称,Copilot 插件可以在画布中暴露本地 iOS 模拟器和 Android 模拟器,同时通过 24 个 MCP 工具镜像相同操作。这让应用从规划代码进一步走向在同一工作区中操控运行中的设备。
讨论洞察: 反复出现的改进并不是孤立意义上的“生成得更好”,而是让操作者能看到更多状态:持久化指令、从语音交接到会话,以及明确的设备控制。即便是最热情的帖子,也是在通过让工作区更容易操控来保留人的参与,而不是把系统做成完全不透明的黑箱。
与前一天对比: 8 月 4 日讨论的是工作流如何变得可复用、可触发。8 月 5 日则进一步转向交互界面本身:Agent 内部的语音、持久化设置和设备画布。
1.2 Meta 的 Muse 发布,既是竞争动作,也是一次自我认知测试(🡕)
Muse Code 是当天最明确的新入局者。公众反应同时包含发布带来的兴奋、基准测试分享,以及对产品是否连自身身份都理解清楚的即时审视。
@Meta 宣布了(14 个赞、7,229 次浏览)称,Meta 已以 beta 形式发布 Muse Code。这是一款由 Muse Spark 1.2 驱动的终端编程 Agent,Mark Zuckerberg 的引文描述了其在大型代码库上进行规划、编写代码和验证的能力。社区总结很快将其定位为 Claude Code 和 Codex 的直接竞争者。
@Jeremybtc 声称(46 个赞、43 条回复、3,851 次浏览)称,Meta 先推出的是较小的首个模型,后续还会有更大的模型,同时将价格和基准测试数据归因于 Meta 自身材料。这条推文之所以重要,是因为它把发布消息转化成了操作者比较不同工具时真正关心的问题:编程分数、价格,以及 Meta 是否打算持续发布。
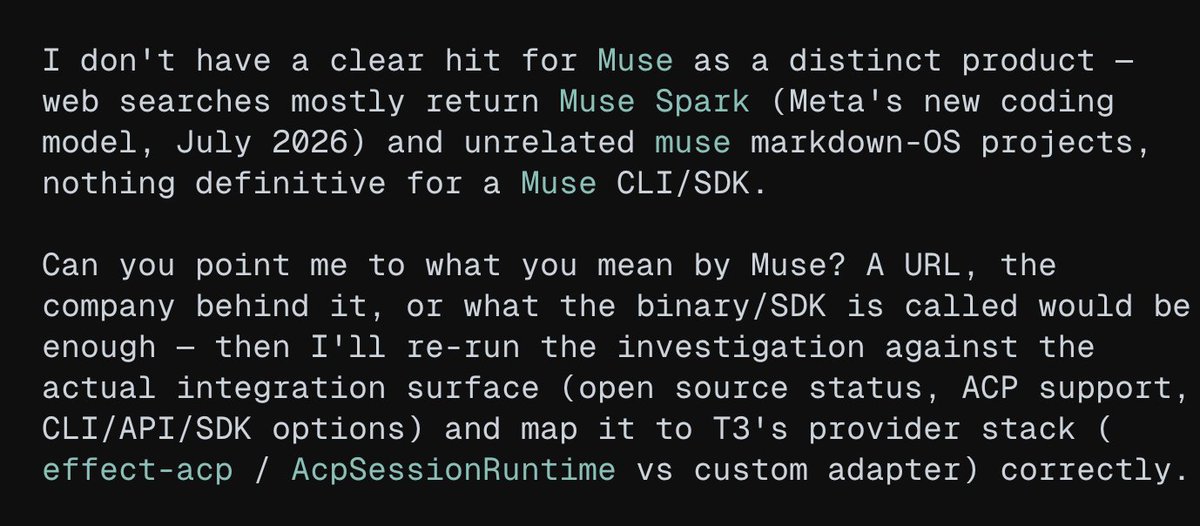
@theo 调侃了(181 个赞、21 条回复、18,325 次浏览)批评 Muse 对 Muse 本身“完全没有认知”。附带截图成为当天最具体的发布打磨不足反例:Agent 表示,网页搜索结果大多返回 Muse Spark 或无关的“muse”项目,并要求提供实际的公司名或二进制文件名,之后才能调查集成选项。
@dkundel 提醒了(27 个赞、2,719 次浏览)提醒大家,Codex CLI 是开源项目。一条回复立即把这点转化为对 Muse 的对比,抱怨 Muse 本身并不开源。
讨论洞察: 市场并没有停留在“新竞争者发布了产品”这一层。最迅速的后续测试是:产品能否描述自己,发布材料是否足够具体,以及其开放模式是否符合用户如今对编程 Agent 工具的预期。
与前一天对比: 8 月 4 日的数据集中没有可比的 Muse 讨论。8 月 5 日则出现了一个有明确名称的新终端 Agent 竞争者,同时也立刻遭遇了公众对其可发现性的批评。
1.3 最有效的上下文模式,是更小、更结构化,并按需加载(🡕)
几项最有用的成果都在反对超大提示词。共同思路是提炼、压缩或分阶段组织知识,让 Agent 在启动时读取更少内容,只在任务需要时调入相关信息。
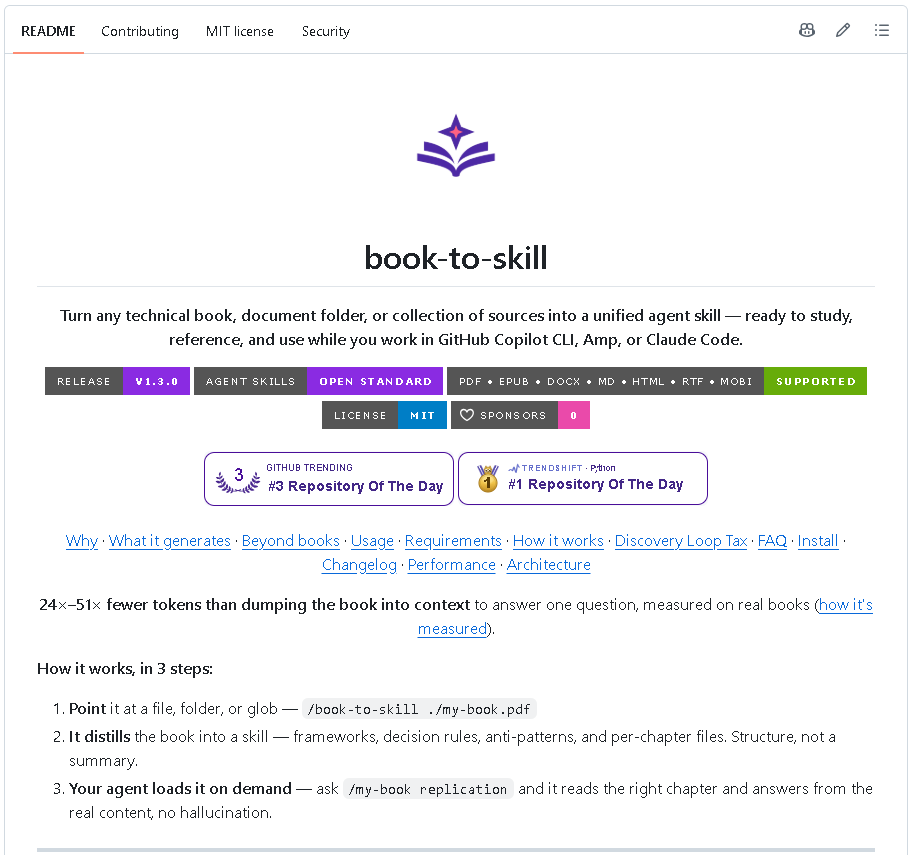
@alex_verem 认为(10 个赞、1,799 次浏览、16 次收藏)认为,不应在每次会话中重新摄取整本技术书籍。链接中的 book-to-skill README 将这一主张具体化:一次性转换 PDF 或 EPUB,生成一个 SKILL.md 和按章节拆分的文件,之后再从正确章节回答问题。据称,与把整本书塞进上下文相比,这种方式可少用 24 倍至 51 倍 token。
@HelloVyom 提到了(6 个赞、252 次浏览)介绍了 Headroom。其代码库描述了一个本地代理、包装器和 MCP 服务器,可在日志、文件、工具输出和 RAG 片段送达模型前进行压缩。公开 README 将节省幅度限定为:JSON 密集型数据减少 60% 至 95% 的 token,编程 Agent 减少 15% 至 20% 的 token;其中一次演示将 10,144 个 token 压缩至 1,260 个,同时找到了同一个致命错误。
@noclipepe 总结了(6 个赞、88 次浏览、5 次收藏)用一句话总结了 Codex 的教训:“问题不在于上下文不够,而在于删得不够。”具体说法是,一个巨大的 AGENTS.md 让 Codex 表现变差,因此 OpenAI 将其替换为一张简短地图,仅在需要时再加载其余内容。
@NainsiDwiv50980 强调了(3 个赞、358 次浏览)介绍了 mattpocock/skills。该代码库 README 从另一个方向强化了相同模式:针对对齐、TDD、调试和代码审查提供小型、可安装的工作流,而不是把所有内容塞进一个单体流程块。
讨论洞察: 这些帖子最终都指向渐进式披露。压缩日志,把书拆成章节,保持根指令地图简短,并在任务确实需要时再加载详细材料。
与前一天对比: 8 月 4 日强调的是持久化上下文图和记忆账本。8 月 5 日则把讨论推向了更低成本、更有纪律的上下文封装和提示词删减。
1.4 路由、配额管理和本地优先的兜底方案仍是运营核心(🡒)
模型选择的讨论依旧务实。最详细的帖子并不是庆祝基准测试成绩,而是在讨论如何应对配额、绕开供应商问题,以及把部分工作迁移到本地或离线系统。
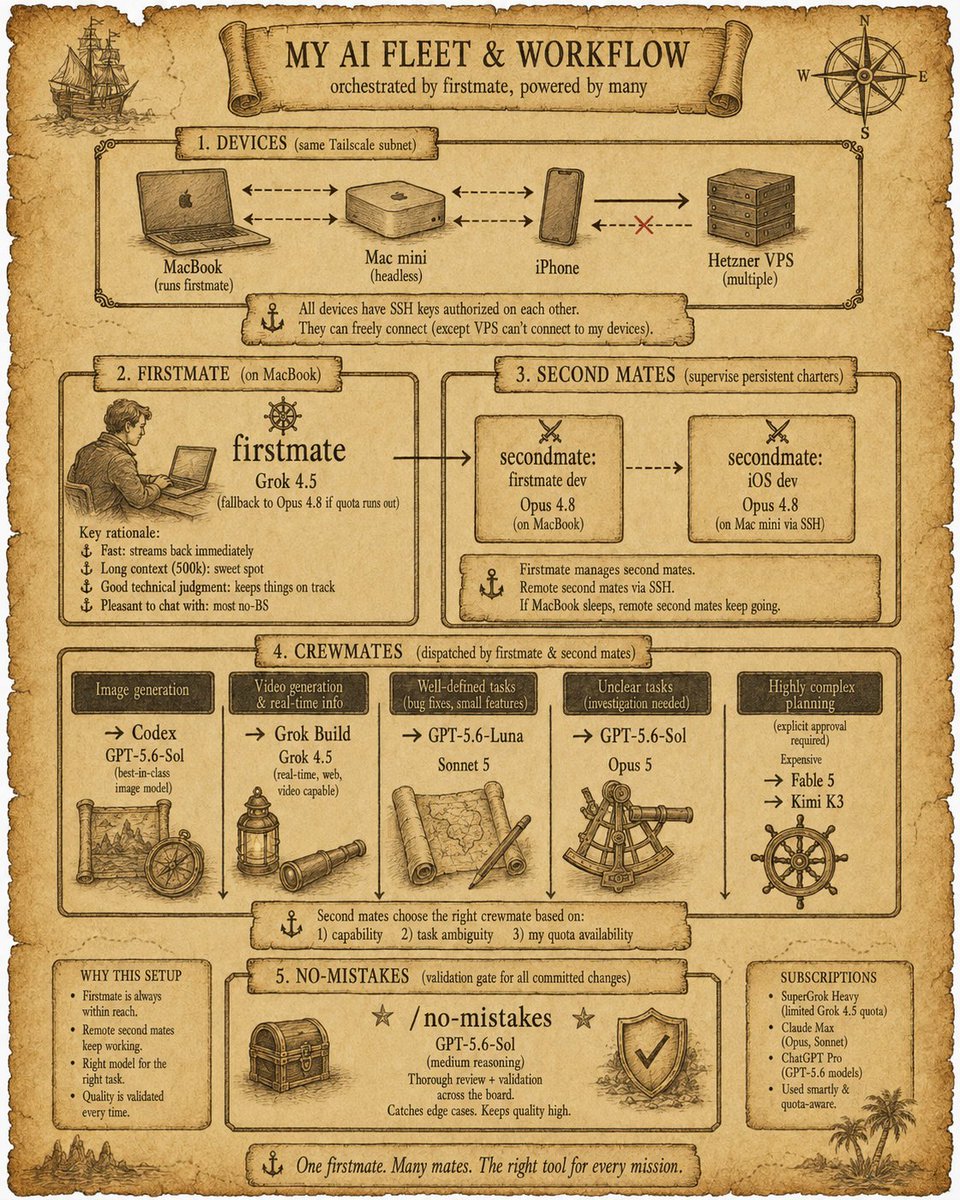
@kunchenguid 详细讲解了(28 个赞、12 条回复、1,214 次浏览、34 次收藏)介绍了一个多机器“firstmate”设置,根据能力、模糊程度和配额分配任务。配图明确展示了运行模式:在配额耗尽前由 Grok 4.5 充当协调器,Opus 4.8 作为远程第二副手,Codex 处理图像任务,Grok Build 负责网页和视频工作,并通过独立的 /no-mistakes 在 GPT-5.6-Sol 上进行验证。
@thdxr 更新了(166 个赞、18 条回复、7,480 次浏览)提醒用户 OpenCode 的 503 问题已经解决;被引用的早期帖子则将故障归因于异常的 DeepSeek 需求和供应商流量限制。@yacineMTB 报道称(65 个赞、21 条回复、4,611 次浏览)讨论了同一类 503 流式超时,回复中有人具体抱怨 token 被白白烧掉,另一位用户则表示直接使用 DeepSeek API 可以避开这个问题。
@kushbhuwalka 推出了(10 个赞、324 次浏览)介绍了 pattystack,这是一个面向多个 Codex 订阅的小型路由器,可让所有账户保持登录,并把任务发送给剩余配额最多的账户。@He1s_Sammy 描述了(23 个赞、9 条回复、360 次浏览)则展示了 APIMart 等产品背后更广泛的供应商接入痛点:只要项目使用多个供应商,就得分别管理账户、密钥、速率限制和账单。
@antigravity 介绍了(260 个赞、11 条回复、11,802 次浏览、71 次收藏)展示了 Gemma Translator 对同一可靠性问题的另一种回答:一台完全离线的设备。其线程和 公开仓库 表示,该项目通过 LiteRT-LM 在 Raspberry Pi 硬件上运行 Gemma 4,并使用 Moonshine/Kokoro 语音模型;完成设置后无需联网。
讨论洞察: 共同模式并不是忠于某一家模型供应商,而是进行编排:按配额和任务类型路由,保留供应商选择,并在云端路径脆弱或成本过高时,把部分任务迁移到本地或离线系统。
与前一天对比: 8 月 4 日关注服务限制和性价比。8 月 5 日则展示了位于这些问题之上的操作者应对层:路由器、订阅配额分流和离线设备。
2. 人们感到沮丧的地方
容量限制和配额波动会打断工作流
这是一个高严重度问题,因为它会让用户在会话中途被迫停下。@thdxr 表示,OpenCode 的 503 事故已经解决,但同时称那天看起来像是“疯狂消耗 token 的一天”;被引用的早期帖子则将中断归因于 DeepSeek 的流量限制。@yacineMTB 报告了同样的 503 流式超时,并得到多条佐证回复,其中一人称包装器在失败前烧掉了约 10 美元的 token,另一人则表示直接调用 DeepSeek API 可以避开该问题。
这种挫败感还延伸到了订阅政策。@jturntdev 抱怨未使用的 Codex 重置次数会直接消失,而不是被结转,并发布了剩余重置次数和到期日的截图。开发者已经开始通过 pattystack 这样的路由器,或在多个供应商和账户之间分散流量来应对。这类需求值得投入,因为人们已经开始在编程工具之上构建明确的配额管理层。
上下文过多仍会让 Agent 变差
这是一个中高程度的挫败点,因为即使模型仍然可用,质量也会下降。@noclipepe 表示,巨大的 AGENTS.md 让 Codex 表现更差,而简短的指令地图加按需加载效果更好。@alex_verem 和链接中的 book-to-skill 代码库则把同一抱怨转化为具体解决方案:把书拆成按章节划分的技能文件,而不是每次都整本重发。
最尖锐的例子来自 Muse 发布后的反应。@theo 发布了一张截图,显示 Muse 在没有更多背景信息的情况下无法识别 Muse 是一款产品。这让“上下文质量”不再只是抽象的提示工程争论,而变成了可见的产品失败模式:用户要的不是更大的上下文窗口,而是更好的起始知识和更清晰的任务边界。
推荐和发现层仍然抓不住真正的任务
这是一个中等程度的挫败点,但例子异常具体。@shannholmberg 展示了 Codex 插件选择器推荐无关的消费级工具,置顶回复认为这个列表看起来只是按字母排序,并没有真正经过策展筛选。在 Muse 线程中,问题有所不同但相关:系统甚至无法在尝试提供帮助前,先把产品名称对应到正确对象。
这些案例指向同一个缺口。周边界面在推荐工具、供应商或下一步操作前,仍然无法很好地理解用户意图。因此,发现过程显得嘈杂,而这恰恰发生在用户期待 Agent 技术栈应当具备个性化能力的时刻。
生成速度快过了信心建立速度
这是一个高严重度的战略性问题,因为它质疑单纯提升生成速度是否还有意义。@ATechAjay 认为,“快速写出代码 != 快速建立信心”,配图则将真正的瓶颈描述为检查路由、表单、边界情况、移动端布局和真实用户路径。@kunchenguid 也独立强化了这一观点:在模型路由之后增加了一个独立的 /no-mistakes 验证阶段。
这种应对方式很能说明问题:人们并没有要求模型更长时间地自由运行,而是在增加明确的验证环节、审批关卡和更安全的路由逻辑。这表明,相比再获得一点点速度提升,验证基础设施更值得建设。
3. 人们希望存在什么
原生集成、而不是后贴上去的配额感知路由
人们已经在自行构建这类系统,因为现在就需要它。@kunchenguid 描述了如何根据能力、模糊程度和剩余配额,在 Grok、Opus、GPT-5.6 和 Kimi 之间进行路由;@kushbhuwalka 则构建了 pattystack,在多个 Codex 订阅之间自动选择。@He1s_Sammy 明确说明了背后的痛点:多个账户、密钥、速率限制和账单如今已成为日常开销。
人们想要的似乎不是另一个模型选择器,而是一个默认就理解配额、供应商健康状况、任务类型和订阅经济性的路由层。机会评级:直接。
无需塞满提示词,就能加载正确知识的上下文系统
这里的需求很务实,而不是空泛愿景。@noclipepe 希望有一张更小的指令地图,之后再加载细节;@alex_verem 链接了一个能将长篇书籍转换为可按章节访问技能的工具;@HelloVyom 则指向一个用于压缩庞大日志和 JSON 的中间层。
未满足的需求,是一个位于原始材料与模型之间的可靠中间层:它能够决定哪些内容该纳入、哪些内容该压缩,以及哪些内容该延后加载。机会评级:直接。
具备明确边界和审批机制的更安全企业工作区
这里最有力的证据来自那些围绕问题构建产品的人,而不是抽象地抱怨。@codeglitch 强调 Cloudflare OS 是一个内置治理和边界控制的 Agent 工作区,Cloudflare 公告 则聚焦安全的内部连接和零信任默认设置。@kunchenguid 也在高成本规划路径上保留了明确审批机制。
这说明市场需要这样的系统:内部访问、升级权限和审批关卡都清晰可见,并由策略提供支持,而不是隐藏在提示词里。机会评级:竞争性。
更强的自我认知和工作流感知发现能力
围绕 Muse 和 Codex 的挫败暴露了一个更基础的产品缺口。@theo 展示了 Muse 无法确定自身产品身份,@shannholmberg 则展示了 Codex 推荐与实际任务不匹配的插件。这两种情况都表明,用户希望系统知道自己是什么、拥有哪些工具,以及当前任务适合使用哪个界面。
这既是元数据问题,也是用户体验问题,但需求很明确:发现过程应当是情境化的,而不是泛泛而谈。机会评级:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Antigravity | 编程 Agent 工作区 | (+/-) | 语音提示、/grill-me、内联产物评论、离线 Gemma 项目示例 |
有用户报告持续出现“working...”循环;产品更名/发现机制仍在磨合 |
| Codex / Codex CLI | 编程 Agent + CLI | (+/-) | 语音工作流、开源本地 CLI、在路由设置中有较强的图像任务口碑 | 有关订阅重置的抱怨,插件推荐显得无关,部分上下文设置会降低质量 |
| GitHub Copilot app | Agent 工作区 | (+) | 持久化会话指令、可调详略程度、面向丰富界面的画布插件 | 效果取决于插件及周边 MCP/画布集成 |
| firstmate | 编排方法 | (+) | 多机器控制、模型专门化、配额感知调度、明确的验证阶段 | 需要自行搭建,并持续管理配额 |
| OpenCode + DeepSeek path | 编程 Agent + 推理供应商 | (+/-) | 高使用量和有吸引力的经济性推动了大量采用 | 503 超时、流量限制,以及故障期间的 token 消耗 |
| Muse Code | 终端编程 Agent | (+/-) | 面向大型代码库的 beta 定位,迅速获得市场关注,并引发基准测试和定价讨论 | 发布当天出现自我认知混乱,并面临开源对比压力 |
| book-to-skill | 上下文封装 | (+) | 按章节加载、可复用技能输出、大幅节省 token 的主张 | 使用前需要预处理源材料 |
| Headroom | 上下文压缩层 | (+) | 本地可逆压缩、代理/包装器/MCP 模式、对 JSON 的节省效果显著 | 为技术栈增加一层,处理结构化数据时最有吸引力 |
| pattystack | 配额路由器 | (+) | 将请求路由至剩余配额最多的 Codex 账户 | 是应对订阅限制的权宜方案,而非完整平台 |
| Cloudflare OS | 企业 Agent 工作区 | (+) | 将治理、内部系统访问和零信任框架内置于工作区 | 仍处于早期产品阶段,定位偏企业市场 |
总体情绪是:能力层面偏正面,运营层面偏负面。用户喜欢语音控制、更丰富的工作区和可复用的上下文层,却通过自行增加路由器、审批阶段、压缩层和离线兜底方案来绕过故障与上限。最明确的迁移趋势是远离对单一供应商的依赖,转向混合技术栈:一个 Agent 负责编排,另一个负责执行,单独的验证器负责检查,同时保留本地或离线选项以增强韧性。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Gemma Translator | @antigravity | 手持式离线翻译设备 | 消除语音翻译对云端的依赖,并展示设备端 Agent 工作流 | Gemma 4、LiteRT-LM、Moonshine、Kokoro、React、Python、Raspberry Pi 5 | Alpha | 帖子、仓库 |
| mobile-canvas-ghcp | @JamesMontemagno / Redth | 一个用于实时移动模拟器的 GitHub Copilot 画布加 MCP | 让 Agent 能在 Copilot 应用内检查和控制 iOS 和 Android 设备 | GitHub Copilot 插件、画布、MCP、iOS Simulator、Android Emulator | Beta | 帖子、仓库 |
| book-to-skill | @alex_verem / virgiliojr94 | 将书籍和文档转换为可复用的 Agent 技能,并支持按章节加载 | 在反复需要长篇参考资料时,减少重复 token 消耗 | Agent Skills 格式、Markdown 输出、PDF/EPUB 摄取 | Beta | 帖子、仓库 |
| Headroom | @HelloVyom | 在结构化上下文到达模型前进行压缩 | 降低日志、JSON、RAG 片段和编程 Agent 流量的 token 成本与提示词膨胀 | 本地代理、包装器 CLI、MCP 服务器、可逆压缩 | Beta | 帖子、仓库 |
| pattystack | @kushbhuwalka | 通过一个端点在多个 Codex 订阅之间路由请求 | 避免某个付费账户过早达到上限后出现空闲等待 | OpenAI 兼容 API 端点、多账户 Codex 路由 | Alpha | 帖子 |
| Cloudflare OS | @codeglitch / Cloudflare | 围绕安全内部访问和治理构建的 Agent 工作区 | 为企业提供一个具备边界、审批和浏览器访问能力的 Agent 运行环境 | Cloudflare 工作区、浏览器界面、内部连接器、零信任控制 | Beta | 帖子、公告 |
| skills | @NainsiDwiv50980 / Matt Pocock | 可安装的编程 Agent 工作流代码库 | 用可复用的任务专用流程取代反复手动提示 | Markdown skills、GitHub 代码库、工单追踪器集成 | Shipped | 帖子、仓库 |
Gemma Translator 的突出之处在于,它不只是一条演示帖子。代码库详细说明了离线设备的软硬件路径:在 LiteRT-LM 上运行 Gemma,使用 Moonshine/Kokoro 处理语音,前端采用 React,硬件则是 Raspberry Pi。这让本地优先的 Agent 行为更像一种构建模式,而不只是一句口号。
mobile-canvas-ghcp 和 Cloudflare OS 指向不同方向,却在解决同一个更广泛的问题:Agent 工作需要更好的容器。前者通过在 Copilot 中嵌入运行中的设备界面,为开发者提供更丰富的容器;后者则通过在工作区中嵌入治理和内部访问控制,为企业提供更安全的容器。
反复出现的构建模式是“在现有模型之上增加一层薄薄的中间层”。book-to-skill、Headroom、pattystack 和 Matt Pocock 的 skills 代码库都位于原始模型与用户工作流之间,通过增加路由、压缩、封装或流程来解决问题,而不是试图取代基础模型本身。
6. 新鲜且值得关注的动态
Antigravity 成为 Google 编程 Agent 功能的显性入口
@buildwithhassan 发布了 展示了一个 Google 登录流程,该流程会将 Gemini CLI 用户重定向至 Antigravity;Antigravity 网站 目前则宣传子 Agent、钩子、计划任务、Agent 管理和语音功能。这一点很重要,因为它把一组松散的编程 Agent 能力整合成了更明确的产品界面和名称。
Cloudflare OS 将企业 Agent 边界变成了一个产品类别
@codeglitch 称 Cloudflare OS 是“首个围绕企业实际工作方式构建的 AI 工作区”,链接中的 新闻稿 则聚焦内部系统访问、治理和零信任默认设置。其突出之处不仅是又一个 Agent 外壳,而是试图直接定义用于 Agent 工作的安全企业容器。
Muse Code 让 Meta 明确加入终端 Agent 竞赛
@Meta 正式介绍了 beta 版 Muse Code,社区随即从价格、开放程度和编程表现等方面将其与 Claude Code、Codex 对比。即使质量尚未形成共识,这款产品仍然值得关注,因为它为一个此前主要由 Anthropic 和 OpenAI 在公开市场引领的类别,带来了新的大型实验室入局者。
7. 机会在哪里
[+++] 原生的配额与可靠性编排 —— 证据来自故障报告、消失的重置次数、firstmate 明确的路由规则、pattystack 的多订阅分流,以及 APIMart 暴露的多供应商账户痛点。最强的机会在于,让供应商健康状况、配额余量和任务感知路由自动运行,而不是迫使每个重度用户都自行构建路由器。
[+++] 上下文整形与选择性加载 —— book-to-skill、Headroom、Matt Pocock 的 skills 代码库,以及 Codex“删减上下文,而不只是增加上下文”的教训,都指向同一个方向。一个能够决定压缩什么、拆分什么、按需加载什么的产品,已经同时获得了来自痛点和活跃解决方案的直接证据。
[++] 验证与信心基础设施 —— Ajay 的“快速写出代码 != 快速建立信心”帖子,以及 kunchenguid 的专用 /no-mistakes 关卡,都表明生成速度正在超过信任建立速度。市场需要能够持续测试、检查并解释 Agent 输出是否适合发布的产品。
[++] 面向内部系统的安全 Agent 工作区 —— Cloudflare OS 和强调审批的 firstmate 设置都指向对策略驱动执行容器的需求。机会属中等,因为企业信任领域竞争激烈,但证据充分表明,团队希望边界成为产品功能,而不是提示词文本。
[+] 工作流感知的发现与自我认知 —— Muse 的自我认知截图和 Codex 插件选择器的抱怨,展示了一个规模较小但重要的缺口。在推荐层真正变得有用之前,Agent 仍需要更好地了解自身、拥有的工具,以及用户当前的目标。
8. 要点
- Agent 界面正在变成工作区,而不只是聊天框。 Codex 中的语音交接、GitHub Copilot 应用中的全局指令,以及实时设备画布,都让控制界面更贴近实际工作。(来源)
- 新的终端 Agent 竞争者出现了,但可发现性立刻变得和基准测试同样重要。 Meta 的 Muse Code beta 很快吸引了关注,而最尖锐的公众反应是一张截图,显示 Muse 无法确定自身身份。(来源)
- 上下文纪律胜过上下文最大化。 今天最有实质内容的成果,都围绕将书籍拆分为技能、压缩日志和 JSON,以及用简短地图加按需加载替代巨大的指令文件。(来源)
- 配额痛点如今已经在定义产品。 OpenCode 的故障报告、Codex 重置次数抱怨,以及 pattystack 这类订阅路由器都表明,使用限制正在像模型质量一样影响工作流设计。(来源)
- 开发者正在模型之上自行增加可靠性层。 firstmate 的路由与验证图、Headroom 的压缩层,以及 APIMart 的供应商抽象,都符合相同模式:围绕现有模型构建轻量的运营中间件。(来源)
- 下一条差异化前沿是信任。 Cloudflare OS 强调治理,Ajay 强调验证,多项工作流示例增加了明确的审批或验证步骤,这表明更安全的执行正成为竞争优势。(来源)