Twitter AI 编程 - 2026-08-06
1. 大家在讨论什么
1.1 Antigravity 从演示界面扩展为可用的智能体平台 (🡕)
至少有五条内容扎实的帖子,让 Antigravity 成为当天最明确、归属 Google 的 AI 编程入口,但相关证据在已发布成果与传闻流量之间明显分化。最有力的内容是开源构建、命令界面和子智能体方法;互动最高的一簇仍是尚未证实的 Gemini 猜测。
@antigravity 展示了(697 次点赞、22 条回复、33,039 次浏览、231 次收藏)Gemma Translator:一款基于 Antigravity 打造的离线翻译设备。帖子回复给出了具体架构:Raspberry Pi 5 硬件、在设备端运行 Gemma 4 的 LiteRT-LM、Moonshine 语音识别、Kokoro 文本转语音,以及 React UI。链接中的 gemma-translator README 与这些细节一致,并补充了部署脚本,因此这不是预告式展示,而是一种可复现的构建模式。
@googlegemma 放大了(675 次点赞、28 条回复、47,612 次浏览、219 次收藏)展示了同一设备,并补充说明代码和 STL 文件已经开源。这一点很关键,因为它让该项目从一条令人印象深刻的帖子,变成了其他开发者可以审查并复现、且与 Google 生态相关的成果。
@googleaidevs 分享了(87 次点赞、5 条回复、6,903 次浏览、68 次收藏)展示了一组用于导航、后台任务、实用工具和研究子智能体的 Antigravity 命令。虽然这里无法公开阅读其链接的 X 文章,但公开的 Antigravity CLI 页面 证实了同样以终端为先的界面:斜杠命令、子智能体和可配置工具。
@GoogleCloudTech 重点介绍了(3 次点赞、300 次浏览)提到 “Swarm Coding” 作为 Antigravity 2.0 中的一种子智能体模式,而被引用的文章将临时性专家描述为一种避免记忆稀释、拆解复杂任务的方法。这是一个较小的信号,但它进一步强化了同样的转向:从单一大型智能体会话转向受管理的专业化工作单元。
@Mr_Salio 传播了(297 次点赞、66 条回复、35,650 次浏览、29 次收藏)声称 Gemini 3.5 Pro 已经以另一名称通过 Antigravity 提供。与上述项目不同,配图只是一个品牌标题卡,且有一条回复直接表示该发布不会在当天发生,因此这一簇更像是围绕平台的炒作,而非具体产品证据。
讨论洞察: 具体的 Antigravity 帖子讨论的是如何运行智能体:本地硬件、可复用命令,以及子智能体协同。最嘈杂的反例并不是另一项构建成果,而是传闻驱动的模型讨论,这反而让平台本身显得比周边猜测更成熟。
与前一天对比: 8 月 5 日,Antigravity 已经成为 Google 编码智能体功能的可见入口。到 8 月 6 日,它进一步从产品界面延伸成可复现的构建模式,体现为开源硬件、子智能体技巧和更深入的运行细节。
1.2 治理、配额与安全进入了产品界面 (🡕)
至少有六条内容扎实的帖子将 AI 编程视为一种如今需要定价旋钮、策略层、审查阈值和审计工具的产品,而不只是更好的补全质量。当天最强的运营层证据来自截图、文档和架构图,而不是宽泛观点。
@OpenAIDevs 发布了(489 次点赞、35 条回复、27,010 次浏览、178 次收藏)提到了研究预览版 Codex Security Review。公开的 安全审查文档 表示,它增加了仓库上下文分析、威胁模型支持、严重级别阈值和 PR 调用命令,这比泛泛而谈的“AI 安全扫描器”说法具体得多。
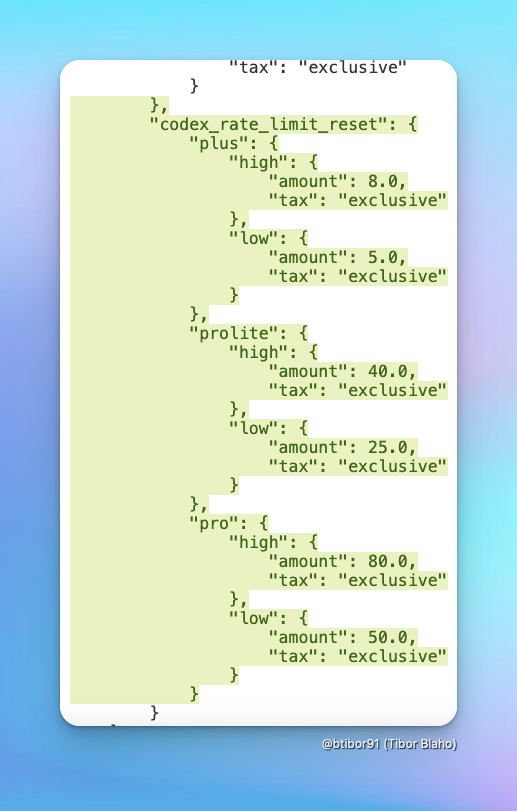
@btibor91 报告了(342 次点赞、51 条回复、25,021 次浏览、34 次收藏)展示了 Codex 似乎用于付费重置速率限制的底层逻辑。审阅过的截图显示 plus、prolite 和 pro 套餐有分级重置额度,把人们对配额的焦虑变成了一个明确的变现产物。
@wieslawsoltes 抱怨道(27 次点赞、9 条回复、2,064 次浏览)称,在 GPT-5.6 Luna 上进行轻量工作,一天就消耗掉了大半个月度 GitHub Copilot 积分。这张截图之所以重要,是因为它展示了真实的使用页面:1,500 积分中已用 1,020,距离重置还有 26 天。

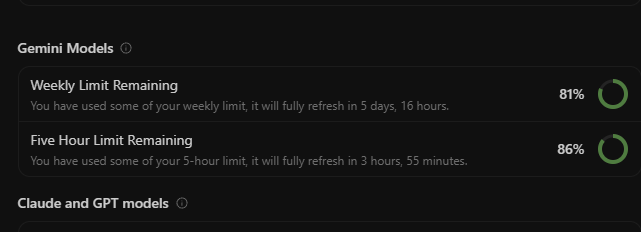
@evandromoisinho 表示(4 次点赞、2 条回复、273 次浏览)称,一次运行在 Antigravity 上的 Gemini 故障循环烧掉了 19% 的配额。审阅过的截图显示,在那次失败会话之后,周限额和 5 小时限额都已部分耗尽,因此这成了 OpenAI 和 GitHub 之外第二个具体的配额损失案例。
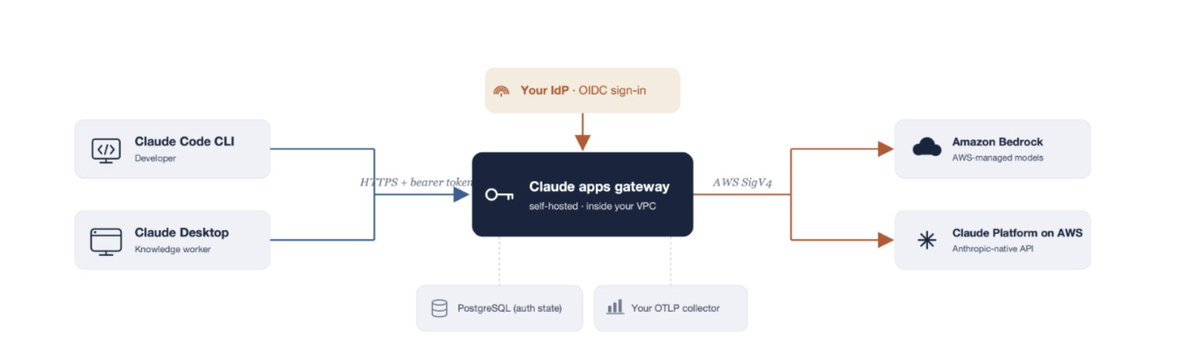
@sagar_batchu 认为(13 次点赞、3 条回复、51 次浏览)称,AWS 为 Claude Code 提供控制平面,证明智能体如今已经是一个支出与权限管理界面。AWS 官方的 Claude apps gateway 文章印证了这一解读,其中包括 SSO、集中式策略、按用户或用户组设置支出上限、OTLP 遥测、OIDC,以及以 PostgreSQL 为后端的认证状态。
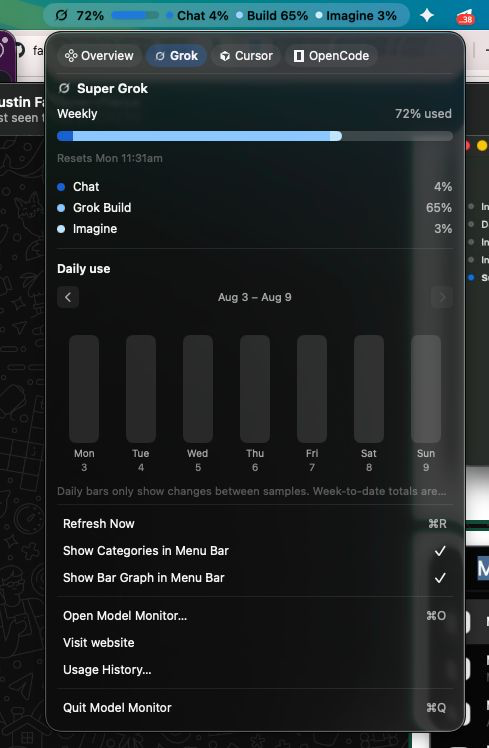
@gubatron 推荐了(3 次点赞、2 条回复、41 次浏览)提到 ModelMonitor,它是 Grok、Cursor 和 OpenCode 的实时配额计量器。它的存在本身就是证据:用户已经开始自己构建使用可视化层,因为厂商套餐仍然令人难以理解。
讨论洞察: 回复模式非常明确。只有当评论者相信仓库上下文能减少噪音时,Codex Security Review 才会引发兴趣;而有关 AWS 控制平面的讨论也立刻越过支出上限,转向要求提供能证明智能体实际改了什么的持久凭证。人们并不是反对治理,而是在强调治理必须可审计。
与前一天对比: 8 月 5 日的焦点是故障、路由和消失的重置机制。8 月 6 日则进一步进入产品化控制:付费重置入口、实时积分消耗截图、面向安全的专用审查流程、监控工具,以及官方网关架构。
1.3 长尾项目仍在持续发布模型之上的轻量层 (🡕)
至少八个较小的开发者帖子收敛到同一个想法:不要替换底层模型,而是用更好的上下文封装、检索、可移植性或监督层包裹它。低互动长尾中,异常密集地出现了各自解决某一工作流问题的具体仓库。
@sulekhat95 展示了(9 次点赞、393 次浏览)提到了 book-to-skill,其 README 和审阅过的图片都声称,通过把书籍或文档集转换成可复用技能并按需加载章节,可以把 token 消耗降低 24x-51x。这是对这一话题中已广泛流传的提示词膨胀抱怨的非常直接的回应。
@aiedge_ 介绍了(16 次点赞、3 条回复、2,476 次浏览、23 次收藏)提到 Prime Agent:一个持久化编程框架,拥有长生命周期的 Python 环境、内置子智能体,以及一个 /refine 命令,可在会话中重写提示词、记忆和技能。真正有价值的细节来自回复:人们立刻质疑这种会话级优化是否算真正的自我改进,这让讨论比单纯的发布文案更严谨。
@alindnbrg 发布了(2 条回复、30 次浏览)提到 AI Engineer Coach,随后 补充跟进了(2 条回复、19 次浏览)结合 CocoIndex Code,以及 再次(2 条回复、27 次浏览)结合 asm。按顺序看,这三条帖子勾勒出一套实用栈:在会话结束后指导智能体、在生成前只检索正确代码、并在多个框架之间保持技能同步。
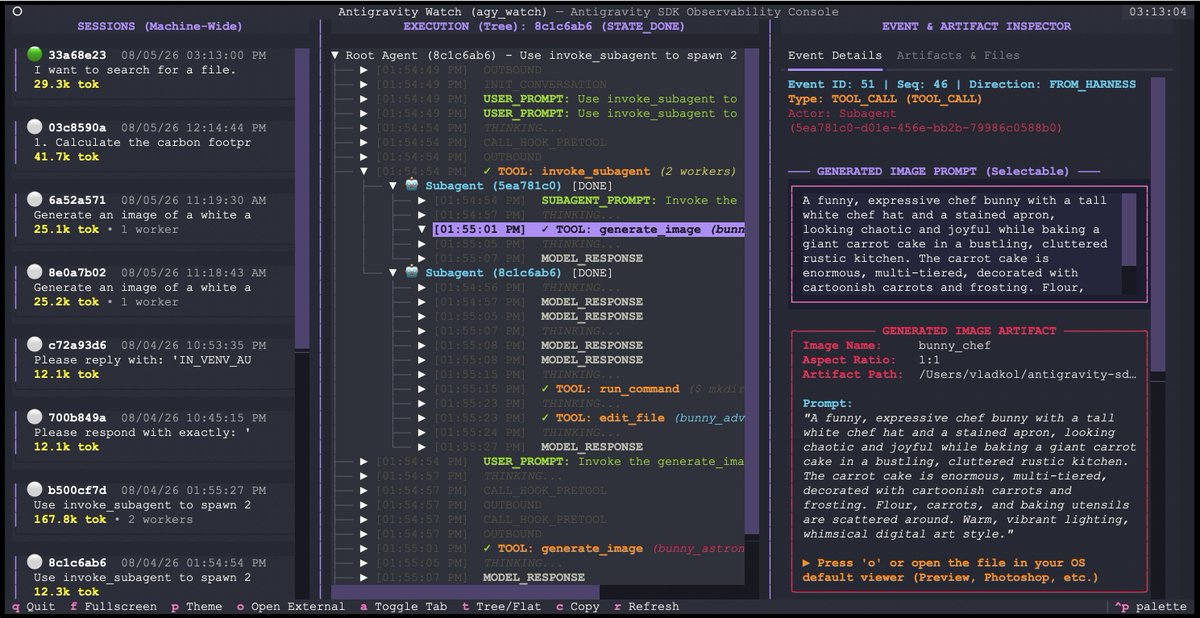
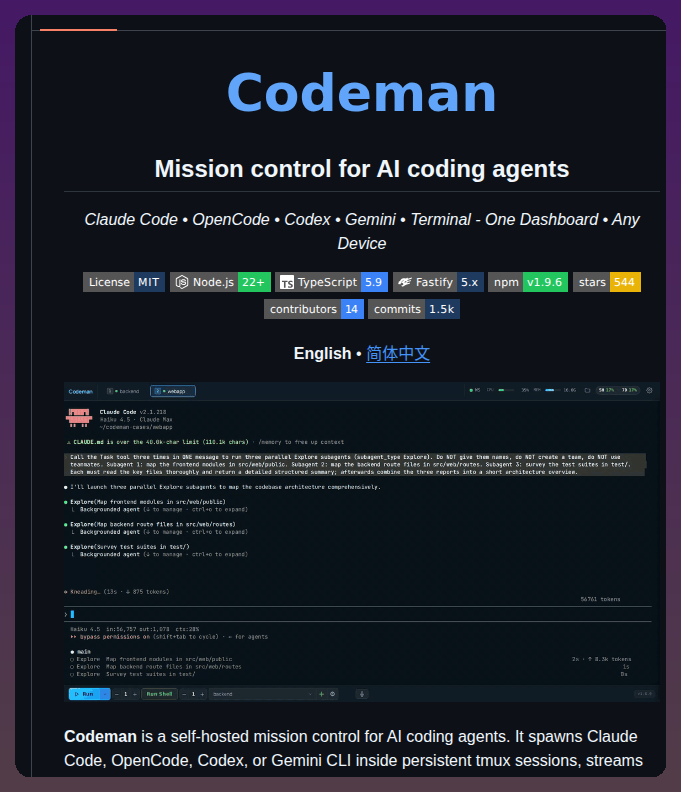
@DanKornas 总结了(1 次点赞、2 条回复、686 次浏览)提到 Agentic Plugin Marketplace:一个 Markdown 源文件,可生成适配六种环境的框架原生制品;与此同时,@vladkol 展示了(5 次点赞、1 条回复、381 次浏览)提到 agy_watch,而 @tom_doerr 展示了(2 次点赞、1,356 次浏览、7 次收藏)提到 Codeman,用于在这些智能体上线后对其进行观测与运维。反复出现的模式,不是又一个“底层模型更强”的说法,而是围绕工作流的基础设施。
讨论洞察: 这些开发者解决的是不同问题,但共同动作是结构性的:一次封装知识、精准检索代码、跨工具分发技能,并在发布后增加任务控制层。就连 Prime Agent 那条帖子,讨论也很快从基准测试的兴奋转向一个更狭义的问题:持久性改进到底该如何定义。
与前一天对比: 8 月 5 日聚焦于上下文压缩和可复用技能。到 8 月 6 日,这一主题进一步扩展到代码检索、技能可移植性、智能体可观测性,以及持久化的多框架控制。
2. 什么让人沮丧
配额消耗与不透明的套餐经济
这是一个高严重度痛点,因为它会直接中断会话,让用户在思考代码之前先思考积分。@btibor91 曝出了 Codex 似乎提供付费重置入口,@wieslawsoltes 显示 GitHub Copilot 在轻量使用 GPT-5.6 Luna 的情况下烧掉了每月 1,500 积分中的 1,020,@evandromoisinho 则称一次运行在 Antigravity 上的 Gemini 故障循环就耗掉了 19% 的配额。应对方式要么是接受类似超额计费的定价,要么减少使用,要么安装像 ModelMonitor 这样的可视化层。这个方向看起来值得投入,因为抱怨横跨 OpenAI、GitHub 和 Google,而不是某一次孤立故障。
安全审查只有在足够安静且可证明时才有意义
这是一个中高严重度痛点,因为评论者把误报视为会毁掉产品的缺陷,而不是小麻烦。@OpenAIDevs 发布了 Codex Security Review,但有一条回复警告说,如果它“漏掉一个真实漏洞,或者制造大量噪音,团队一周内就会关掉它”;另一条回复表示,只有具备仓库上下文的版本才有意义,第三条则指出了依赖链盲点。@sagar_batchu 则把 AWS 的 Claude apps gateway 视为证据,证明身份、策略和支出控制现在已是刚需,但仍有回复要求在智能体写入之后提供回读和持久凭证。人们愿意加入治理层,但不愿在没有证据链的情况下信任它。
技能、插件和会话仍在不同框架之间割裂
这是一个中等严重度痛点,但解决方案异常具体。@alindnbrg 描述了技能在 Claude Code、Codex、Cursor 和 Windsurf 之间四散分裂,直到 asm 出现;@DanKornas 则描述了一个市场,它仍然需要从一个 Markdown 源文件为六种环境生成原生制品。@tom_doerr 和 @vladkol 又在这些 CLI 之上增加了任务控制和可观测层,这本身就说明碎片化并非暂时现象。这个方向值得投入,因为开发者已经开始接受多框架并存的现实,而不是等待厂商自行收敛。
智能体在真正帮上忙之前仍需要人工校准
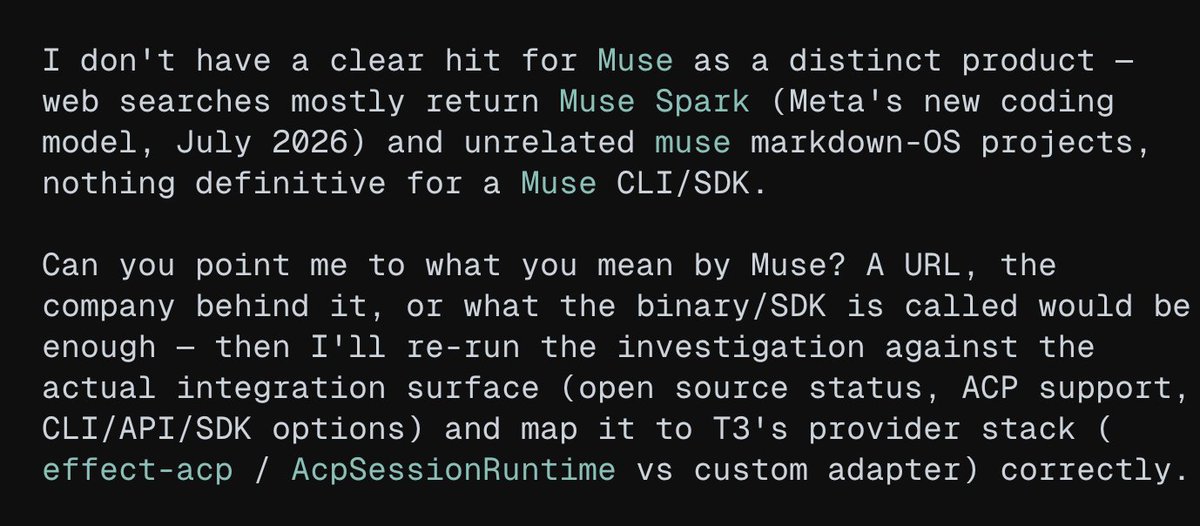
这是一个中等严重度痛点,但象征意义被放大。@theo 展示了 Muse 在没有 URL、公司名或二进制引用时,甚至无法识别 Muse 是一个产品;这张截图也成了人们批评发布质量的缩影。当前的实际应对方式仍然是手工操作:贴链接、重述产品名称,或者先提供精确的界面名称,智能体才能开始工作。这使得自我认知和面向工作流的发现能力,不再只是锦上添花,而更像是基本门槛。
3. 大家希望出现什么
原生的配额、支出和策略控制,并带有凭证
这个需求既现实又紧迫。@btibor91、@wieslawsoltes 和 @evandromoisinho 都从不同产品暴露出同一种痛点:用户能在事后看到消耗,却无法在事前获得足够的策略控制或预测能力。AWS 的 Claude apps gateway 通过 SSO、支出上限和遥测部分解决了这个问题,ModelMonitor 通过本地监控也部分缓解了它,但两者都没有闭环到“为某一次成本证明智能体到底改了什么”。机会评级:直接。
技能、插件与命令的统一可移植事实来源
这个需求同样很实际,而且开发者已经在尝试满足它。asm 的存在,是因为技能散落在各家提供商的专有格式中;Agentic Plugin Marketplace 的存在,则是因为一个环境中的插件必须在下一个环境中重新表达。这些工具部分解决了问题,但它们本身的存在就说明,用户仍然想要一种在切换工具时也能存活的标准工作流格式。机会评级:直接。
在 token 消耗前运行的检索与上下文塑形
当天的上下文工具都暗示了同一个未满足需求:在模型开始扫描或反复重读一切之前,先决定它应该看到什么。book-to-skill 把长参考资料变成按章节寻址的技能,CocoIndex Code 构建了一个 AST 感知的本地索引,让智能体只抓取相关代码,而附着在 @GoogleCloudTech 上的 Swarm Coding 文章则把子智能体描述为避免记忆稀释的一种方式。这些都是有力的局部答案,但反复出现的需求是:把默认的上下文治理器内置进工作流。机会评级:直接。
面向工作流的自我认知与智能体监督
这个需求同时包含实际痛点和声誉风险。@theo 展示了一个新编程智能体连自家产品界面都认不出来会有多难看,而 @cyrilXBT 则通过 GitHub 的 GH-600 认证,把 “Agentic AI Developer” 框定为一种正式的操作岗位。在工具侧,AI Engineer Coach、agy_watch 和 Codeman 都部分回应了监督需求,但发现能力、自我描述和事后动作审查仍分散在不同产品里。机会评级:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Antigravity | 编程智能体工作区 | (+/-) | 以终端为先的工作流、子智能体、后台任务,以及 Google 自有智能体功能的清晰入口 | 配额消耗抱怨和传闻过多的模型讨论仍让体验变得混杂 |
| Codex Security Review | 安全审查服务 | (+/-) | 仓库上下文审查、威胁模型文件、严重级别阈值、PR 原生工作流 | 能否被信任取决于低噪音;回复质疑其对依赖链盲点的处理 |
| GitHub Copilot | 编程助手/工作区 | (+/-) | 广泛的生态覆盖、正式操作员认证势头、开发者熟悉的界面 | 积分消耗抱怨让套餐经济显得难以自圆其说 |
| Claude apps gateway for AWS | 智能体控制平面 | (+) | SSO、集中式策略、支出上限、OTLP 遥测、无需长期存放在笔记本上的凭证 | 治理能力强于对变更后正确性的证明能力 |
| ModelMonitor | 使用监控器 | (+) | 实时上限跟踪,以及覆盖 Grok、Cursor 和 OpenCode 的历史记录 | 用户仍需外部监控器,因为服务商默认暴露的信息不够 |
| book-to-skill | 上下文封装 | (+) | 声称可降低 24x-51x token 消耗、支持章节级加载、跨工具兼容 | 需要前期文档转换和持续维护 |
| Prime Agent | 持久化编程框架 | (+/-) | 长生命周期 Python 环境、内置子智能体、/refine、模型无关连接器 |
“自我改进” 的说法在回复中遭到怀疑 |
| AI Engineer Coach | 使用分析 | (+) | 本地日志分析、反模式检测、上下文评分、从提示词到技能的建议 | 目前仍是互动较少的早期长尾项目 |
| CocoIndex Code | 检索/搜索 | (+) | AST 感知的本地语义索引、声称可节省 token、支持 skill/MCP 集成 | 需要先完成本地索引配置,价值才会显现 |
| asm | 技能管理器 | (+) | 面向 19 家提供商的统一 CLI/TUI、GitHub 安装、JSON 输出、安全审计 | 它之所以存在,正因为不同框架的技能格式依然碎片化 |
| Agentic Plugin Marketplace | 插件/技能分发 | (+) | 从一个 Markdown 源文件生成适配六种环境的框架原生制品 | 需要维护另一层抽象,底下仍是各框架特定的生成器 |
| agy_watch | 智能体可观测性 | (+) | 零代码追踪、多智能体树、文件预览、策略审计界面 | 仅适用于 Antigravity SDK 工作流 |
| Codeman | 任务控制 | (+) | 持久化 tmux 会话、浏览器串流、定时任务、多 CLI 管理 | 自托管带来额外运维负担 |
| VoiceClaw Realtime | 语音控制界面 | (+) | 用 Apple Watch 和手机控制 OpenClaw 或 OpenAI Realtime 会话 | 需要配套应用和 tunnel 配置,因此仍是小众界面 |
整体情绪对轻量工作流层偏正面,对核心付费界面则偏混合。人们喜欢那些能节省 token、改善检索或暴露更多状态的工具,但对不透明的配额、脆弱的信任模型和厂商特定锁定明显没那么满意。
当前主导性的应对模式,是在模型外面增加结构:用章节化技能替代超长提示词,用 AST 索引替代盲目扫文件,用外部配额计量器替代被动等待产品仪表盘,用浏览器或终端控制平面替代单个短暂 CLI 窗口。最清晰的迁移趋势,是从单框架假设转向可移植技能、持久化会话和多智能体监督。竞争态势如今看起来同样关乎经济模型与治理,而不只是模型质量。
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Gemma Translator | google-gemma / @antigravity | 一款离线翻译设备,展示设备端智能体工作流 | 消除多语言语音交互对云的依赖,并证明 Antigravity 能驱动真实硬件构建 | Gemma 4、LiteRT-LM、Moonshine、Kokoro、React、Python、Raspberry Pi 5 | Alpha | 帖子, 仓库 |
| VoiceClaw Realtime | Benjamin Badejo | 面向 OpenClaw 和 OpenAI Realtime 会话的 Apple Watch 语音界面 | 让用户在远离笔记本时也能委派和监控智能体工作 | watchOS、iPhone 配套应用、OpenClaw、OpenAI Realtime/Live、tunnel relay | 已发布 | 帖子, 网站 |
| book-to-skill | virgiliojr94 | 将书籍和文档转换为可复用技能,并支持章节级加载 | 避免每次会话都为重读长参考资料付费 | Markdown 技能、PDF/EPUB/DOCX 导入 | 已发布 | 帖子, 仓库 |
| Prime Agent | Prime Intellect | 一个带有 /refine 和内置子智能体的持久化编程框架 |
让状态在任务之间持续存在,并允许框架更新自己的工作指令 | Python 运行时、模型连接器、子智能体、框架记忆 | Beta | 帖子, 仓库 |
| AI Engineer Coach | Microsoft | 读取本地编程智能体日志并标记反模式 | 帮助团队识别坏习惯、上下文问题,以及值得转化为技能的提示词 | 本地日志分析、GitHub Copilot/Claude/Codex 日志、仪表盘 | Beta | 帖子, 仓库 |
| CocoIndex Code | cocoindex-io | 为智能体构建 AST 感知的语义代码索引 | 在大范围文件扫描前先检索正确函数,降低 token 消耗 | Tree-sitter、本地语义索引、Skills/MCP 集成 | Beta | 帖子, 仓库 |
| asm | luongnv89 | 面向多家提供商发现和安装智能体技能的统一 CLI/TUI | 修复跨框架技能碎片化问题 | CLI/TUI、提供商适配器、JSON 输出、安全审计 | 已发布 | 帖子, 仓库 |
| Agentic Plugin Marketplace | wshobson | 从单一源生成框架原生插件、智能体、技能和命令 | 避免在不同工具间重复定义工作流 | Markdown 源、生成器、plugin-eval、多框架制品 | 已发布 | 帖子, 仓库 |
| agy_watch | vladkol | 面向 Antigravity 智能体的零埋点可观测控制台 | 提供实时执行树、制品预览和策略可审计性 | CLI/TUI、Antigravity SDK hooks、SQLite、CAS | Beta | 帖子, 仓库 |
| ModelMonitor | Faulkner Pearce | 面向 Grok、Cursor 和 OpenCode 的原生使用跟踪器 | 让剩余配额实时可见 | 原生 macOS 应用、本地历史导出、提供商使用适配器 | Beta | 帖子, 仓库 |
| Codeman | Ark0N | 面向持久化编程智能体会话的浏览器任务控制台 | 让多个 CLI 智能体持续运行、可查看、可调度 | tmux、浏览器串流、定时任务、多 CLI 编排 | 已发布 | 帖子, 仓库 |
Gemma Translator 和 VoiceClaw Realtime 表明,控制界面正在突破笔记本边界。Gemma Translator 之所以重要,是因为仓库和帖子完整记录了基于 Raspberry Pi 硬件的离线全栈;而 VoiceClaw 之所以重要,是因为审阅过的图片展示了在 Apple Watch 上进行真实的语音任务委派和进度跟踪,而不只是概念视频。


book-to-skill、CocoIndex Code 和 Prime Agent 构成了最清晰的上下文与状态集群。一个把书籍封装成可复用技能,一个在智能体盲目打开文件之前先检索正确代码,一个让持久化工作环境在子智能体和多轮优化之间保持存活。它们共享的模式,是减少无效上下文、保留有用状态,而不是要求底层模型每次都从零开始。


可移植性与监督集群同样强劲。AI Engineer Coach、asm、Agentic Plugin Marketplace、agy_watch、ModelMonitor 和 Codeman 都建立在同一个前提上:智能体在生成之后仍需要辅导、可移植性、可观测性或任务控制。多个开发者独立发布这一监督层,比一条大型发布帖更有说服力,因为这说明来自不同方向的需求在重复出现。


6. 新动向与重点内容
GH-600 让智能体操作成为一种正式资质
@cyrilXBT 将其描述为(63 次点赞、12 条回复、6,341 次浏览、32 次收藏)将 GitHub 的 GH-600 认证视为首个正式信号,表明 “Agentic AI Developer” 正在成为一个有名字的岗位。公开的 Microsoft Learn 页面 证实,该认证涵盖在生产软件工作流中部署、集成、操作和治理 AI 智能体,因此这不只是社交媒体上的职业讨论。

Muse 的“自我认知失误”成了衡量发布质量的标杆
@theo 调侃了(386 次点赞、28 条回复、43,907 次浏览、22 次收藏)批评 Muse 连 Muse 是什么都没弄明白。它之所以重要,不只是因为有喜剧效果:截图显示,这个编程智能体因为无法锚定自己的产品界面,而要求提供 URL、公司名或二进制信息,这让“自我认知”变成了公开的发布标准。
Codex Security Review 试图把安全专用审查变成常规 PR 步骤
@OpenAIDevs 介绍了(489 次点赞、35 条回复、27,010 次浏览、178 次收藏)描述了一种仅用于安全的审查模式,它会在 pull request 审查中使用仓库上下文和威胁模型文件。这一点值得注意,因为它把 AI 安全审查从独立扫描概念推向了常规工作流界面,尽管回复已经明确表明,团队会以准确性而不是新奇性来评判它。
7. 机会在哪里
[+++] 带有支出、身份和凭证的智能体控制平面 — 证据来自 Copilot 积分消耗、Codex 重置变现迹象、Gemini 配额损失、ModelMonitor,以及 AWS 官方网关架构。这个方向很强,因为痛点和局部解法都出现在多个厂商身上,而尚未解决的缺口在各处都相同:谁花了什么钱、智能体动了什么,以及最终返回了什么证明。
[+++] 跨框架工作流可移植性 — asm、Agentic Plugin Marketplace、Codeman 和 VoiceClaw 的存在,都是因为命令、技能和会话在不同工具间发生了碎片化。这个方向很强,因为独立开发者已经在投入时间做胶水层,而不是等待某一家厂商成为标准。
[+++] 检索与上下文塑形中间件 — book-to-skill、CocoIndex Code、Swarm Coding 和 Prime Agent 都在尝试在 token 消耗或状态漂移接管之前,先收窄上下文。这个方向很强,因为信号同时出现在抱怨和已发布项目里:人们希望智能体少读一些、检索更准、状态更干净。
[++] 仓库感知的安全验证 — Codex Security Review 及其回复串表明,确实存在真实需求,但在误报、依赖深度和证据质量上,门槛也异常高。这个方向属中等强度,因为买方显然想要它,但也很可能迅速停用弱实现。
[+] 边缘端与可穿戴控制界面 — Gemma Translator 和 VoiceClaw 展示了桌面之外对智能体接入的实际兴趣。这个方向正在兴起,因为这些构建都是真实的、视觉说服力很强,但受众仍较小,工作流也仍较为专门化。
8. 要点总结
- Antigravity 最有说服力的时候,是和真实成果绑定在一起,而不是和泄露传闻绑定。 Gemma Translator 提供了开源代码、硬件细节和可复现的离线栈,而互动最高的 Gemini 传闻簇所提供的证据则弱得多。(来源)
- 治理正在成为 AI 编程产品内部的一部分。 AWS 的 Claude apps gateway 和 Codex Security Review 都把策略、审查阈值和可审计性视为一等界面,而不是后台事务。(来源)
- 配额痛点如今已跨越厂商,而且证据具体。 同一天里同时出现了 Codex 重置变现、GitHub Copilot 积分消耗和 Gemini 配额损失的证据,这意味着使用经济正在塑造不同技术栈上的工作流设计。(来源)
- 最活跃的开发者正在模型之上发布中间件。 book-to-skill、CocoIndex Code、Prime Agent 及相关项目都在尝试封装上下文、减少检索范围,或保留更好的状态,而不是在原始模型质量上竞争。(来源)
- 跨框架碎片化已不再只是理论问题。 asm、Agentic Plugin Marketplace、Codeman 和 VoiceClaw 同时出现在一天的数据集中,说明人们越来越期待工作流能够在多个智能体外壳之间迁移存活。(来源)
- 围绕智能体的操作员角色,正在固化为一门被认可的专业。 GH-600 的公开认证表述与更大的数据集相吻合:人们现在正在为监督智能体的人类构建监控器、网关、审查层和辅导工具。(来源)