Twitter AI 编程 - 2026-08-10
1. 大家在讨论什么
1.1 可安装的智能体操作系统正在取代一次性的提示词打磨(🡕)
至少有六条内容明确将 AI 编程的核心问题视为工作流纪律,而非模型原始智力。它们的共同做法,是把规划、测试、评审、记忆和审批从转瞬即逝的聊天上下文中抽离出来,使其能够跨越交接并支撑长时运行。相比 8 月 9 日——当时工作流工程刚成为一个清晰可见的框架——8 月 10 日则把这一思路进一步推进为可安装的套件、固定流程和明确的验证闭环。
@ForwardEditor 分享了(316 个赞、10 条回复、16,830 次浏览、511 次收藏)展示了一种围绕 define-goal 构建的 Codex 微型模式:先让一个更高投入的强模型重写任务,再把执行交给更便宜的工作线程,最后由强模型回头充当裁判。关键信号不在于具体用了什么提示词技巧,而在于用户如今开始把编程工作描述为分阶段路由的流程,包含角色分工与验收检查。
@heyrimsha 指向了(15 个赞、14 条回复、994 次浏览、8 次收藏)ECC,它将 plan → test → implement → review → verify → remember → improve 封装为一个跨框架的统一操作层。推文和所链接的代码仓库对问题的界定完全一致:智能体可以写代码,但其上方仍需要一个持久的工程系统。
@DanKornas 介绍了(9 个赞、3 条回复、1,258 次浏览、8 次收藏)将 AG Kit 呈现为 Google Antigravity 一侧的同类思路:一个 .agents/ 工作区契约,包含专家角色、工作流、持久记忆、MCP 指导,以及一个范围很窄的 PreToolUse 安全闸门。这张图之所以有价值,是因为它把规则、编排、记忆、打包和验证都呈现为产品的一等功能界面,而不是可有可无的提示词习惯。
@traversymedia 展示了(12 个赞、1,170 次浏览、3 次收藏)展示了一套 AI Blueprint 工作流,围绕清晰可见的 PLAN、BUILD 和 PROVE 阶段展开:实现前先做规格评审,验证后归档历史记录。公开证据再次指向同一个结论:人们希望整个闭环是可检查的。
讨论洞察: 回复者并不是说提示词已经不重要了,而是认为真正的收益来自让计划、修复前测试、验收规则和记忆回写能够跨会话持续保留,而不是每次都重新解释一遍。
与前一天的比较: 8 月 9 日把工作流工程界定为前沿方向。到了 8 月 10 日,这一思路已经开始被做成可安装的操作层和可重复的构建流程。
1.2 可移植打包已成现实;现在人们争论的是信任、安装与权限边界(🡕)
至少有五条保留条目都默认:技能和 MCP 的可移植性已不再只是一个假设。讨论上升到了更高一层:谁可以安装一个包、它会获得哪些权限、实际工作如何经由它被委派,以及权限边界究竟应该设在哪里。这比 8 月 9 日围绕打包的讨论更进一步,因为这一天同时出现了官方规范和可运行的实际案例。
@_vmlops 报道了(17 个赞、5 条回复、1,194 次浏览、8 个书签)提到,Google 已加入 Agent Plugins,成为核心维护者之一,并围绕 plugin.json、skills/ 和 mcp.json 总结了可移植目录约定。Google 自己的 发布文章 也确认了同样的结构,并明确指出:安装流程、权限、沙箱、信任和来源溯源被刻意排除在 v1 之外。

@sabir_huss50540 指向了(5 个赞、1 条回复、859 次浏览、4 个书签)google/skills,仓库将其描述为 Google 编写的技能包,以及为 Claude Code、Codex 和 Antigravity 捆绑提供的插件。这让“可移植”真正具备了可操作性:用户不再只是争论该如何打包,而是在安装当下可用的云端流程,让智能体不必再对着过时文档瞎猜。
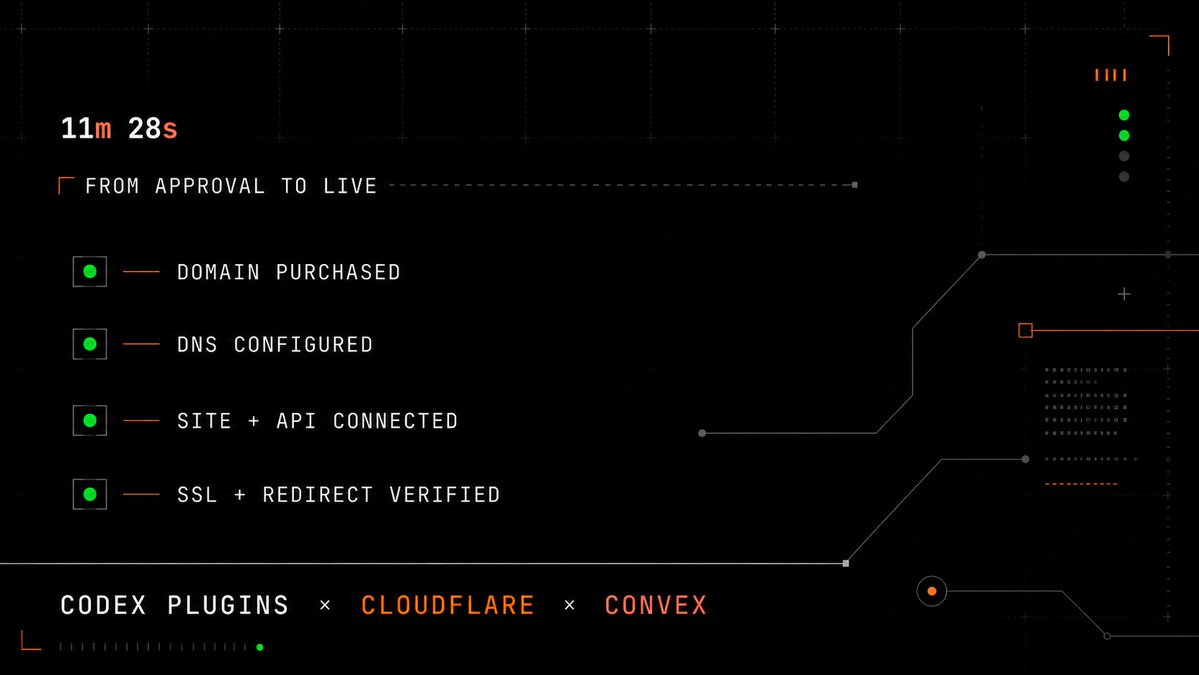
@waynesutton 报道了(20 个赞、7 条回复、1,461 次浏览、4 个书签)称,在 Codex 中安装 Cloudflare 和 Convex 插件后,只需一个提示词,就完成了域名购买、DNS、网站与 API 连接、SSL 和重定向。那张截图的信息量很大,因为它把这一说法压缩成了一份可见的检查清单和完成耗时。
@frantzfries 总结道(15 个赞、1,163 次浏览、12 个书签)则从另一侧展示了现实中的复杂性:API、OpenAPI、MCP、App、Skills、Plugin 和 marketplace 这些层次与语义本就已经足够复杂,以至于即便是有经验的用户,也仍在梳理每一层到底负责什么。
讨论洞察: 最尖锐的回复聚焦在能力清单、套接字权限和撤销机制,而不是文件布局。分发的标准化,正在比权限控制更快推进。
与前一天对比: 8 月 9 日让可移植插件看起来具备了可信度;8 月 10 日则展示了它们已经能做实事,也让缺失的信任层变得更难忽视。
1.3 共享记忆正成为产品层,而不只是权宜之计(🡕)
最强的一批开发者信号,关注点已不再是选出最聪明的模型,而是如何让服务上下文、偏好和项目历史在跨会话、跨工具、跨智能体之间持续保留。这比 8 月 9 日“同一界面,不同后端”的表现又向前迈了一步:今天的产品,正把“可被记住的上下文”当作主要差异化卖点来出售。
@SpotifyEng 发布了(14 个赞、4 条回复、1,210 次浏览、11 个书签)Xirp,将其定位为面向 Claude Code、Gemini CLI 和 Codex 的中立厂商智能体开发环境。Xirp 的公开网站称,缺失的知识是一个检索问题,而不是文档问题:智能体在技术上可以答得没错,但在实际操作中仍会出错,因为所有权、依赖关系和架构决策往往散落在 Slack 讨论串里,或者只存在于人们脑中。
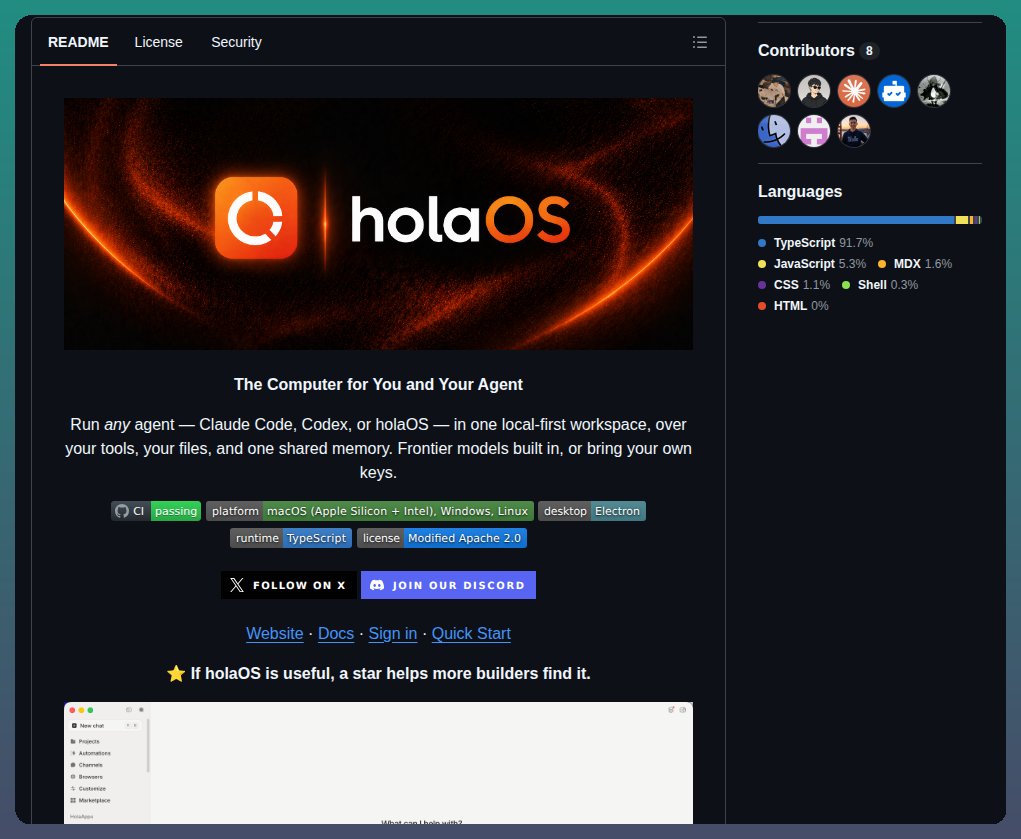
@tom_doerr 分享了(6 个赞、8 条回复、1,373 次浏览、8 个书签)holaOS,其仓库将其描述为一个本地优先的工作区,让 Claude Code、Codex 或 holaOS 都运行在同一套文件、工具和共享记忆之上。README 的关键之处在于,它把这一承诺说得很具体:这些记忆保留在本地、可读、可在不同智能体之间复用,而不是被困在某一家厂商的对话记录里。
 @DanKornas 重点介绍了(1 个赞、1 条回复、552 次浏览、2 个收藏)OpenCode Memory,以及 @PrajwalTomar_ 介绍了(3 个赞、2 条回复、269 次浏览)都描述了一个早上 6:37 的例行流程:Claude Code 自动启动,将隔夜的 18 个候选项筛选到只剩 1 个,并把最终保留的摘要发送到他的手机上。两者的关键差异都不在于某一次会话里给出了更好的答案,而在于被记住的上下文,加上一个之后还能恢复并分发工作的系统。
讨论洞察: 最强烈的正面评价,指向的是可检查、且保存在本地的记忆能力,而不是幕后拼接起来的隐藏上下文。
与前一天的对比: 8 月 9 日展示的是用户在更换后端的同时稳定界面。8 月 10 日则让持久记忆和检索成为一个明确的产品类别。
2. 让人们沮丧的是什么
如果不由用户事后自行补上记忆机制,Agent 还是会忘记项目
这是一个高严重度问题,因为它存在于多个原本看似无关的构建场景之下。@heyrimsha 表示(15 个赞、14 条回复、994 次浏览、8 个收藏)指出,每次会话依然都得被告知先做规划、修复前先测试、审查自己的工作,并记住自己学到了什么。@SpotifyEng 发布了(14 个赞、4 条回复、1,210 次浏览、11 个收藏)也围绕同一个痛点展开,其产品网站称,真正的失效模式不是缺少文档,而是无法检索到关于所有权、依赖关系和架构的上下文。@DanKornas 重点介绍了(1 个赞、1 条回复、552 次浏览、2 个收藏)OpenCode Memory 则给出了一个直接修复方案:在会话空闲时捕获持久的技术上下文,之后再重新注入。
这值得被直接作为产品方向来建设,因为人们的应对方式已经很明确。大家正在添加记忆库、本地向量存储、工作区契约和检索层,以免每天都要重复提示同样的决策。
用量、权益和支出仍然过于不透明
这同样属于高严重度问题,因为它会直接改变人们到底还能用什么工具。@csharpfritz 表示(17 个赞、9 条回复、1,776 次浏览)指出,如果你的 Copilot 账户绑定在企业方案下,就没有个人使用方案可供回退;在触及 GitHub 限额后,他改用了 Codex、Claude 和 Antigravity。@lippebsd 询问了(2 条回复、19 次浏览)则希望看到一个简单的 Codex 上下文用量视图,按单次会话和按天拆分消息、MCP 工具、技能以及系统提示词权重的占用情况,让用户避免意外撞上限额。@pengsonal 提出了(65 个赞、5 条回复、3,278 次浏览、68 个收藏)则明确把 ZCode 每天免费提供的 3M GLM-5.2 tokens,当作 Cursor、Claude Code 和 GitHub Copilot 成本的替代方案。
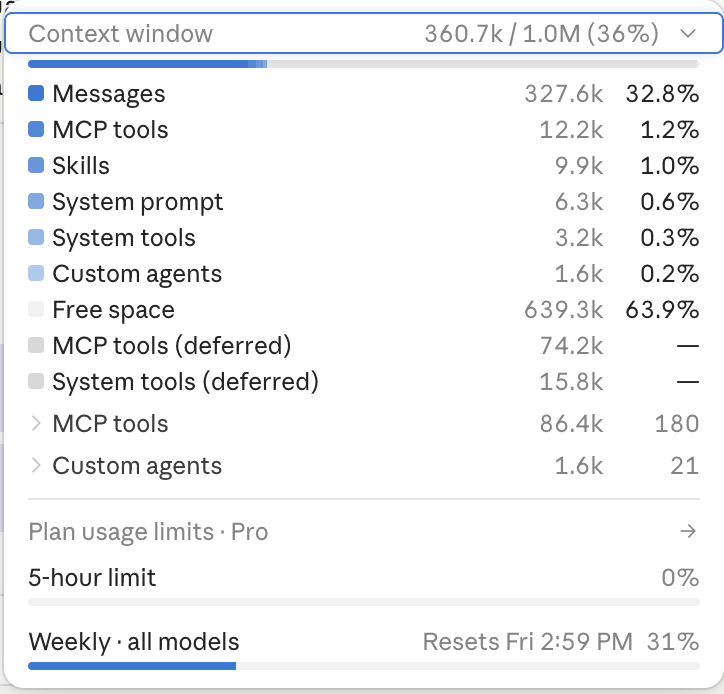
这也值得被直接作为产品方向来建设。证据不只是人们在抱怨价格,而是他们在索要用量账本;一旦账本缺失,他们就会切换服务商。
一旦技能、插件或后台 Agent 能自行行动,信任依然很薄弱
这一问题的严重度介于中等和高之间。@_vmlops 报道了(17 个赞、5 条回复、1,194 次浏览、8 次收藏)提到一种打包标准,它有意将权限和来源信息留给各个客户端自行处理;而回复里很快就有人要求加入能力清单、撤销机制和共享的合规测试夹具。@deepfates 反对称(17 个赞、3 条回复、593 次浏览)则谈到那些他无法关闭的隐形 Claude Code 技能。@vasuman 认为(107 个赞、14 条回复、14,499 次浏览、135 次收藏)支持后台代理,但其中一条最有力的回复提出了反对意见:尚未解决的核心问题,仍然是如何信任 AI 去处理那些需要人类判断的复杂多步骤工作流。另有 @elshayib_ 表示(18 个赞、4 条回复、852 次浏览)指出,Antigravity 作为开发者支撑框架,基本上仍然不可用。
这值得去做,但产品门槛高于“更多自动化”。用户想要的是清晰的权限边界、可选择退出的机制,以及能证明支撑框架本身不会悄悄做错事的证据。
3. 人们希望存在的东西
可持久、可检索、可检查的记忆,而不是靠猜
最明确的实际需求,并不是抽象意义上的“更多上下文”,而是能跨会话保留下来、始终可见、并可在不同工具之间共享的上下文。@SpotifyEng 将其定义为(14 个赞、4 条回复、1,210 次浏览、11 次收藏)围绕一个问题展开:如何检索那些明明已经存在、却难以在恰当时刻浮现出来的服务知识;@tom_doerr 展示了(6 个赞、8 条回复、1,373 次浏览、8 次收藏)则谈到一个本地优先的工作区,让多个代理复用同一个记忆存储。@DanKornas 补充说(1 个赞、1 条回复、552 次浏览、2 次收藏)给出了最直接的实例——OpenCode Memory,它将项目记忆和用户资料数据存储在由向量支持的本地分片中。机会:明确。

由规范驱动的构建循环,带有可见的闸门、审查和证据
人们反复表达的是同一种诉求:不要让我去相信一个黑箱。@traversymedia 显示(12 个赞、1,170 次浏览、3 次收藏)将 AI Blueprint 描述为一个可见的、由规范驱动的循环;@DanKornas 描述(9 个赞、3 条回复、1,258 次浏览、8 次收藏)将 AG Kit 描述为可重复的工作流加上一道安全闸门;@PrajwalTomar_ 描述(3 个赞、2 条回复、269 次浏览)则描述了一套流程:由简报、负责人、评审组、记忆和闸门组成的结构,可以在他睡觉时继续运行。这里的需求是务实的,而不是理想化的:用户想看到代理当前处于循环的哪个环节、自己可以在哪一步介入,以及有哪些证据能证明工作已经完成。机会:明确。


面向技能和插件的权限、来源与使用台账
打包层的到来速度,快于其上层控制层的成熟速度。Google 的 Agent Plugins 文章 表示,v1 有意把安装机制、权限模型、沙箱隔离和信任验证留给各客户端自行处理。在该讨论串中,@_vmlops 提出(17 个赞、5 条回复、1,194 次浏览、8 次收藏)回帖主张加入能力清单和撤销机制;@deepfates 反对(17 个赞、3 条回复、593 次浏览)提到一些自己无法禁用的隐藏技能;@lippebsd 要求(2 条回复、19 次浏览)则要求给出具体的用量拆分,别再让上下文开销处于不可见状态。用户关心的已不只是插件能不能用;他们还想知道它能做什么、成本是多少,以及该如何关闭。机会:直接。
携带最新流程或领域知识的垂直技能包
两条不同的信息指向了同一个产品需求:在快速变化的领域里,基础模型自带的知识还不够。@sabir_huss50540 提出(5 个赞、1 条回复、859 次浏览、4 次收藏)将 google/skills 介绍为面向 Claude Code、Codex 和 Antigravity 的云端维护型流程包;而 @DanKornas 强调(1 个赞、2 条回复、727 次浏览、2 次收藏)则提到 SciAgent-Skills,其公开基准声称,借助生命科学技能库,BixBench-Verified-50 的成绩可从 65.3% 的基线提升到 92.0%。在流程变化很快、或领域方法比通用代码生成更重要的场景中,这确实是一个真实需求。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Agent Plugins | 标准 | (+/-) | 为技能和 MCP 提供可移植封装;各组件可独立失效 | v1 将安装、权限、沙箱、信任和来源验证留给各客户端处理 |
| Google Skills | 技能库 | (+) | 由 Google 编写、覆盖最新流程;可安装到 Claude Code、Codex 和 Antigravity | 范围偏 Google 生态;仓库仍在积极开发中 |
| ECC | 运行层 | (+) | 可在多种 harness 中复用规划/测试/审查/记忆系统 | 覆盖面很大;价值取决于是否真正执行这套闭环 |
| AG Kit | 工作区契约 | (+/-) | 面向 Antigravity 原生的 .agents/ 契约、安全钩子和支持回滚的更新 |
生产级保障主要围绕 Antigravity;还多了一层需要维护 |
| OpenAI Codex | 编码代理 / 插件宿主 | (+/-) | 目标定义工作流、基于插件的操作、强劲的生态势头 | 共享用量池、关于隐藏技能的投诉,以及不清晰的用量拆分 |
| Xirp | ADE / 工作区 | (+) | 通过 Portal 将会话与服务上下文绑定,同时保持厂商中立 | 仍处于公开测试早期;关于局限性的外部证据仍然较少 |
| holaOS | 本地优先工作区 | (+) | 在 Claude Code、Codex 和内置代理之间共享本地记忆 | 桌面端或自托管部署有额外开销;采用修改版 Apache 2.0 许可证 |
| OpenCode Memory | 记忆插件 | (+) | 本地向量记忆、自动捕获、画像学习、Web UI | 增加了插件和配置层复杂度;关于检索质量的证据仍较早期 |
| ZCode / Z.ai | IDE / 模型套装 | (+/-) | 每天提供 3M 免费 GLM-5.2 tokens、Goal Mode、子代理和 BYOK | 相关说法大多带有宣传色彩;成熟度和治理情况尚不明确 |
| GitHub Copilot | 编码代理界面 | (+/-) | 熟悉的 IDE 界面、企业治理栈,以及对插件生态的支持 | 个人版与企业版套餐分化明显,且有用户抱怨用量可见性有限 |
| Google Antigravity | 编码工作区 | (-) | 丰富的 Google 邻近生态,以及 AG Kit 等工具包的原生支持 | 仍有从业者称其不可用;对免费请求的抱怨依然存在 |
当天的情况并没有显示出一个赢家通吃的技术栈,而是表明人们正在用记忆、规则和路由层去包裹代理界面,从而在更换后端的同时保留工作流。@ForwardEditor 使用了(316 个赞、10 条回复、16,830 次浏览、511 次收藏)将 Codex 描述为一个分阶段的目标重写加裁判循环,@waynesutton 使用了(20 个赞、7 条回复、1,461 次浏览、4 次收藏)提到用于域名和 DNS 操作的 Codex 插件;以及 @tom_doerr 使用了(6 个赞、8 条回复、1,373 次浏览、8 次收藏)提到让多个代理共享同一记忆层的 holaOS。
最强烈的正面情绪集中在那些能保留上下文或封装当前流程的工具上;最强烈的负面情绪则集中在不透明性和配额状态上。@csharpfritz 达到(17 个赞、9 条回复、1,776 次浏览)提到 Copilot 的额度限制且没有个人套餐兜底;@lippebsd 要求(2 条回复、19 次浏览)提到用量台账;@elshayib_ 称为(18 个赞、4 条回复、852 次浏览)则称 Antigravity 基本无法使用。
迁移倾向也很明确。@pengsonal 推介(65 个赞、5 条回复、3,278 次浏览、68 次收藏)将 ZCode 视为 Cursor、Claude Code 和 Copilot 的价格驱动型替代方案;而 @deliprao 认为(7 个赞、1 条回复、1,255 次浏览、6 次收藏)指出,编排器的质量仍与模型选择紧密耦合:Pi 最适合模型无关的使用场景,而 Codex 在围绕 OpenAI 模型使用时表现最佳。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Xirp | Spotify | 与供应商无关的 ADE,用于管理带服务上下文的 Claude Code、Gemini CLI 和 Codex 会话 | 代理在缺少所有权和依赖关系上下文时,技术上可能正确,但在运营层面可能出错 | 会话管理器、Portal 集成、检索层 | Beta | 网站 |
| ECC | affaan-m | 跨编排器的运行层,提供技能、记忆、钩子和安全扫描 | 跨会话反复提示,以及工作流逐渐漂移 | JavaScript、Shell、TypeScript、Python、Go、Java、markdown 技能 | 已发布 | 仓库 · 网站 |
| AG Kit | vudovn | 以 Antigravity 为先的 .agents/ 工作区契约,包含工作流、记忆和安全钩子 |
在 Google 的编码工作区中提供持久上下文,并防止破坏性命令 | TypeScript、Node.js、Python、Antigravity 钩子/插件 | Beta | 仓库 |
| holaOS | holaboss-ai | 本地优先的工作区,Claude Code、Codex 或 holaOS 可共享同一工具界面和记忆存储 | 切换代理时无需重置上下文 | TypeScript、Electron、本地记忆、集成, | MCP | Beta |
| Google Skills | Google 编写的技能包和打包插件,用于云端流程 | 在快速变化的平台上,云端知识容易过时,还会产生臆造命令 | Python 仓库、Markdown 技能、插件包 | 已发布 | 仓库 | |
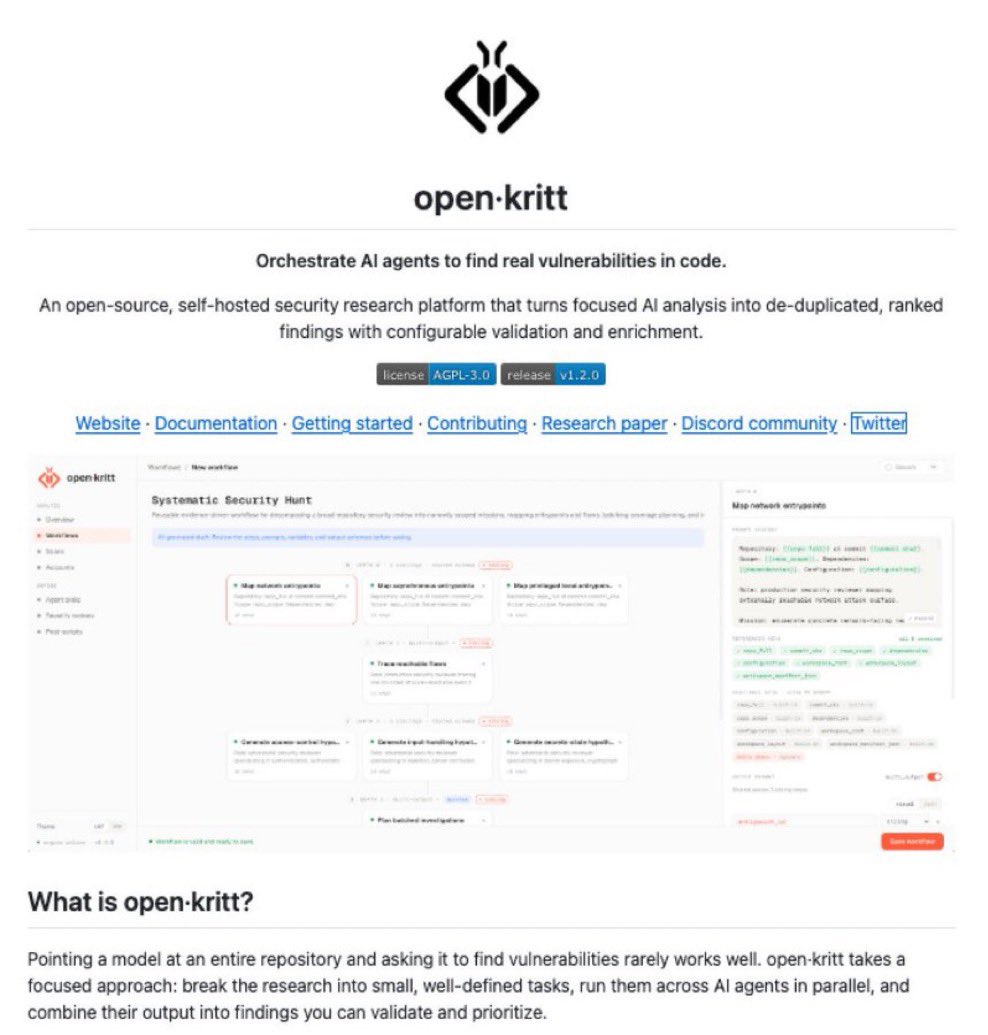
| open-kritt | Kritt-ai | 支持验证与排序的自托管多智能体漏洞研究平台 | 单靠一条“找漏洞”的大型提示词,往往无法验证问题是否真的可利用 | JavaScript、Docker Compose、Codex / Claude Code / OpenRouter | Beta | 仓库 · 网站 |
| Council of High Intelligence | 0xNyk | 在多个编码智能体之间调度不同分析角色进行协商的框架 | 复杂决策和无人值守流程需要分歧机制与明确的裁决结构 | Shell、Markdown 智能体/技能、多提供商路由 | 已发布 | 仓库 |
| SciAgent-Skills | jaechang-hits | 199 项科学技能,可提升编码智能体在生物信息学任务中的表现 | 基础智能体缺乏领域方法、参数设置和故障排查指导 | Markdown 技能、registry.yaml、Claude Code/Codex/Cursor 集成 | 已发布 | 仓库 · 网站 |
最重要的构建模式不是“新模型”,而是“围绕模型构建新的操作层”。@SpotifyEng 发布了(14 个赞、4 条回复、1,210 次浏览、11 次收藏)围绕这样一个观点展开:缺失的关键在于对服务知识的检索;而 @tom_doerr 展示了(6 个赞、8 条回复、1,373 次浏览、8 次收藏)则将 holaOS 设想为一个本地优先的统一工作空间,即使智能体更换,记忆、工具和应用也保持不变。
@heyrimsha 指向了(15 个赞、14 条回复、994 次浏览、8 次收藏)ECC 和 @DanKornas 介绍了(9 个赞、3 条回复、1,258 次浏览、8 次收藏)AG Kit 是同一论点的两个版本:把工作流一次性打包好,把各道关卡明确下来,不要再在每个提示词里从零重建工程循环。@traversymedia 展示了(12 个赞、1,170 次浏览、3 次收藏)则以更轻量的形式体现了同样的思路:在 AI Blueprint 中,规格、构建和验证阶段始终对用户可见。
 第二种构建模式是“把领域知识变成可安装的杠杆”。@sabir_huss50540 展示了(5 个赞、1 条回复、859 次浏览、4 个收藏)将 Google Skills 视为适用于智能体 shell 的现成云端作业手册;而 @DanKornas 重点介绍了(1 个赞、2 条回复、727 次浏览、2 个收藏)SciAgent-Skills 的公开基准则宣称,在不微调的情况下,BixBench-Verified-50 的成绩可从 65.3% 提升至 92.0%。两者虽然面向不同领域,但表达的是同一件事:如果方法更新的速度快于模型训练,就应把方法作为技能交付。


信息流里最具体的多智能体安全项目是 @He1s_Sammy 指向(24 个赞、7 条回复、699 次浏览)的 open-kritt。该项目的公开仓库称,它会把漏洞研究拆解为若干聚焦任务,交由多个智能体并行执行,验证发现结果,并按严重性排序。这仍然是同一种运行层模式,只不过应用对象从通用开发换成了安全研究。
6. 新消息与值得关注的内容
Claude 输出水印成为明确的产品政策
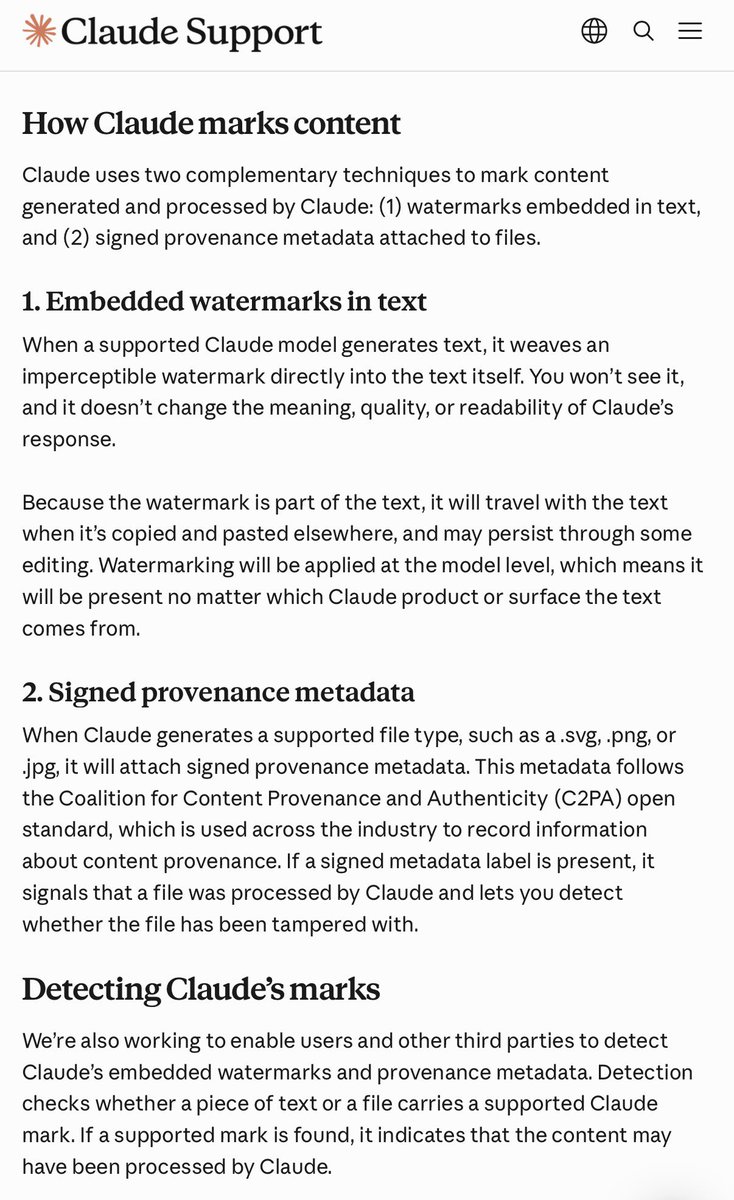
@dr_cintas 指向了(5 个赞、2 条回复、710 次浏览、5 个收藏)提到 Anthropic 新发布的一篇支持文章,说明 Claude 如何标记 AI 生成内容;其链接到的 帮助页面 则表示,Claude 现在采用两种机制:嵌入式文本水印,以及面向受支持文件类型的签名溯源元数据。这条推文之所以与 AI 编程相关,是因为它明确写道,该政策适用于 Claude 的各个入口,包括 Claude Code。
面向编程智能体的企业控制平面正被梳理为独立技术栈
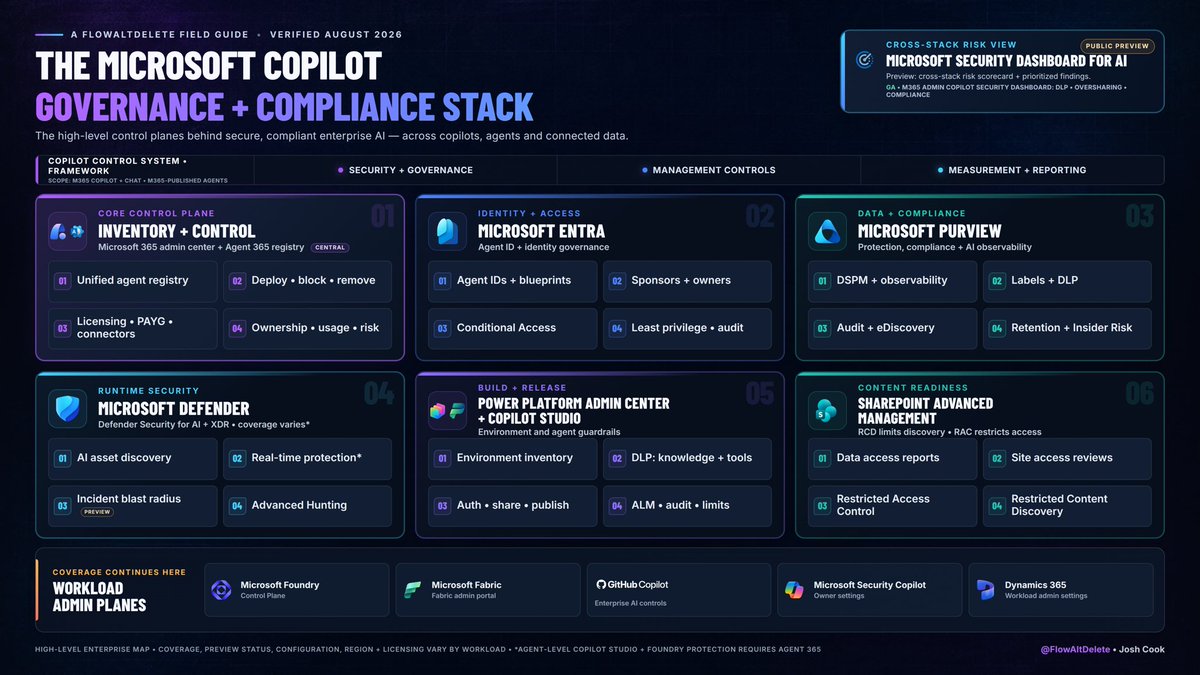
@FlowAltDelete 梳理了(45 个赞、5 条回复、2,632 次浏览、48 个收藏)展示了一套横跨 Entra、Purview、Defender、Power Platform、SharePoint、Foundry、Fabric、GitHub Copilot、Security Copilot 和 Dynamics 365 的 Microsoft Copilot 治理与合规技术栈。这张图的特别之处在于,它把编程智能体治理视为一个多平面控制问题,而不是单一产品里的某项设置。
7. 机会在哪里
[+++] 面向编程工作的跨会话记忆与检索层 — 第 1、2、3 和 5 节都指向这里:Xirp 把上下文缺失定义为检索问题,holaOS 将共享本地记忆作为核心功能,OpenCode Memory 把自动捕获做成了产品,而多个工作流工具包存在的主要意义,就是防止智能体遗忘。这一方向之所以有力,是因为这个痛点同时出现在企业产品、本地优先产品和个人开发者产品中,而不只是某个细分领域。
[+++] 位于插件与技能之上的信任、权限与使用控制平面 — Agent Plugins 在标准化打包上的推进速度,快于权限、溯源、撤销和使用记账等能力的建设。Google 的博客、_vmlops 讨论串、lippebsd 的使用视图请求,以及 deepfates 对“不可见技能”的抱怨,都指向同一个缺失层。这一方向之所以有力,是因为生态已经具备足够的可移植性,从而把控制层的缺口暴露了出来。[++] 带有可见验真关卡的规范驱动构建循环 —— ECC、AG Kit、AI Blueprint 和 agent-council 例程都把规划、评审、验证这套结构打包好了,而不是让用户自己去记。之所以评为中等,是因为这类需求既明确又反复出现,但已有数个可信的开源方案。
[++] 面向重度智能体工作流的配额与权益优化 —— 关于 Copilot 账号分层的抱怨、对 Codex 使用可见性的需求,以及 ZCode 这类激进的免费 token 替代方案,都说明成本和权益状态仍在左右工具选择。之所以评为中等,是因为用户已经因此更换工具,但围绕额度、路由和捆绑套餐的竞争也正变得拥挤。
[+] 无需重新训练、却能胜过基础智能体的领域专用技能包 —— Google Skills 和 SciAgent-Skills 都表明,现有流程和深度领域方法可以作为可安装技能交付。这仍处于新兴阶段,而非普遍趋势,因为最有力的证据主要来自云运维和生物信息学;不过,公开基准和流程包示例都很具体。
8. 要点
- AI 编程领域最重要的讨论,是如何打包工作流,而不是如何改进提示词。 ECC、AG Kit、AI Blueprint 和 define-goal 循环都把规划、测试、评审和记忆当作可复用的系统层。(来源)
- 可移植插件如今已足够成形,未解决的首要问题转而变成了信任与权限。 Agent Plugins 的公开发布,以及围绕能力清单的回应,都明确显示了这一转变。(来源)
- 持久化记忆正成为编程工作空间中的一级产品类别。 Xirp、holaOS 和 OpenCode Memory 都把检索与跨会话回忆作为核心价值主张。(来源)
- 配额设计和使用不透明仍在推动用户更换工具。 用户要求提供按会话划分的上下文台账,并在碰到共享套餐限制后转离 Copilot。(来源)
- 领域专用技能包,是无需重新训练模型就能改善结果的最明确路径之一。 Google Skills 聚焦当前的云端流程,而 SciAgent-Skills 则公布了其在生物信息学工作中的明确基准提升。(来源)