Twitter AI 编程动态 - 2026-08-17
1. 大家在讨论什么
1.1 引发最强 Codex 讨论的,是完整的智能体产品,而不是孤立模型(🡕)
当天最大的讨论集群,不再把 AI 编程工具当作抽象的模型排名来谈,而是把它们视为完整产品,关注在线率、记忆能力、远程控制入口、价格,以及“租用还是拥有”的取舍。至少有四项不同内容共同推动了这种转变:一条高互动的 Codex 清单帖把重点放在可靠性和重置机制上;一条长对比帖从持久计算机体验的角度比较了 Grok Bot、Hermes 和 ChatGPT Work;Codex Remote for iOS 提供了一个具体的移动端控制案例;Rakazo 则把同一类产品做成了可自托管的构建方案。
@thsottiaux 加框强调(4,539 个赞、615 条回复、247,224 次浏览、228 次收藏)将 Codex 形容为“几乎 100% 可靠”“偶尔会重置”“开源”,并称“将拥有 Astra”。真正让这条帖文引发共鸣的,是附带的在线率面板:它显示 Codex Web 在线率为 99.98%,API、CLI 和 VS Code 扩展则都是 100%。回复很快让这场庆祝变得复杂起来,具体抱怨包括付费套餐额度很快耗尽、用户消耗 Sol 的速度比 Opus 还快,以及希望有一种重置产品,不要把下一次每周额度重置再往后推整整 7 天。

@petergyang 比较了(160 个赞、27 条回复、24,766 次浏览、110 次收藏)从如今用户最在意的产品维度来比较 Grok Bot、Hermes 和 ChatGPT Work:智能体是否拥有一台持久存在的计算机、需要多少前期配置、以及 UI 用起来有多痛苦。附带的对比卡片提供了非常密集的证据:Hermes 开放且可定制,但需要自己动手搭建;ChatGPT Work 在浏览器使用和语音方面得分最高,但“在 Chat、Work 和 Codex 之间令人困惑”;Grok Bot 最像一台持久运行的云端计算机,但起价是每月 200 美元。

@viticci 认为(6 个赞、2 条回复、363 次浏览)认为 Codex Remote for iOS 的独特优势在于,它可以直接从手机发起,而不需要先转交给 Mac。他的截图比单纯的说法更重要:一张展示了 iPhone 上的多线程远程 UI,另一张展示了 Codex 执行一段硬件控制流程。帖文最后也不只是吹捧,而是列出了具体缺失项,包括小组件、iOS 框架集成,以及“文件”App 访问能力。
@Granite0x 重点提到(53 个赞、8 条回复、4,056 次浏览、88 次收藏)将 Rakazo 定位为开源版的 Grok Bot 替代方案,而公开的 Rakazo repo 补充了关键细节:每个 bot 对应一个线程和一台计算机;提供 Web、桌面和移动客户端;支持生成 bot;模型由用户自带;并可选择 Docker/E2B/桌面沙箱。仓库 README 也明确写出了取舍:项目仍处于早期 beta 阶段,依然要求 Docker、Postgres,以及愿意自托管的操作者。
讨论洞察: 回复关注的并不主要是基准测试胜负,而是重置政策、“租用还是拥有”的取舍、一台持久计算机是否值每月 200 美元,以及远程控制入口是否真的能让工作从手机上继续。
与前一天相比: 2026-08-16 的 Codex 讨论,重点还在 1M 上下文、隐藏模型切换和配额边界。到了 2026-08-17,同一个产品更像是在被当作完整操作环境来评判:在线率、远程访问、记忆、UI 清晰度,以及底层计算机的所有权。
1.2 Antigravity 和 Gemini 3.7 Flash 回到了更靠近讨论中心的位置,但质疑变得更偏运营层面(🡕)
Antigravity 再次形成了比前一天更强的讨论集群,这次的讨论把官方演示、定价、工作流指导和功能对等性抱怨混在了一起。至少有五项内容强化了同一种模式:Google 推出了一条单提示词生成落地页的演示;一条定价帖把 Gemini 3.7 Flash 定位为生产环境主力;一份开发者指南把这种能力翻译成了具体操作建议;一位实践者表示,经过长时间测试后自己已经回不去 3.6 Flash;另一位用户则质问,为什么 Antigravity 里 Gemini 支持语音输入,Claude 却不支持。
@Google 展示了(629 个赞、38 条回复、118,902 次浏览、333 次收藏)展示了 Gemini 3.7 Flash 搭配 Nano Banana 和 Omni,只用一条提示词就在 Antigravity 中生成一个交互式落地页,包含文案、图片和视频。真正让这条帖变得更有价值的,是回复而不是演示本身:几位回复者表示,真正的测试在于页面在第一次“把这个挪一下”之后是否还能继续编辑、首稿文案质量是否过关,以及生成的组件能否撑住 A/B 测试和评估。
@0xerfa 总结了(158 个赞、61 条回复、4,460 次浏览)介绍了公开的 Gemini 3.7 Flash 价格卡:到 2026 年底之前,输入价格为每百万 token 0.75 美元,输出为每百万 token 3.75 美元,之后价格翻倍;并将覆盖 Gemini API、Antigravity、AI Studio、Android Studio、Gemini Enterprise 和 Gemini Spark。回复的分歧足够大,因而值得关注:有人认为这个发布价对生产级智能体来说很激进,也有人仍然认为它贵到必须精细路由。
@JackWoth98 分享了(195 个赞、8 条回复、27,581 次浏览、120 次收藏)给出了当天最清晰的 Gemini 3.7 Flash 操作指南:按任务调整思考级别、给模型提供截图或连接设计工具,并在 Antigravity 中配合 model: flash 使用子智能体。这是一个虽小但重要的信号,说明讨论正从“看它能做什么”转向“你到底该怎么实际驱动它”。
@thtbee_ 报道称(49 个赞、7 条回复、3,798 次浏览、14 次收藏)表示,经过几天测试后,他们已经回不去 3.6 Flash,同时也承诺会进一步拆解哪些地方表现好、哪些地方出了问题。即使不看所链接的长文,这条推文本身也提供了一种来自一线、非官方的验证:3.7 Flash 在日常使用中确实让人感觉有实质性差异。
@ash_twtz 提问(43 个赞、36 条回复、2,448 次浏览)质问为什么 Antigravity 给 Gemini 开放了语音输入,却没有给 Claude 开放。这条抱怨之所以重要,是因为它把一个模型发布故事,变成了一个产品入口对等性的故事:用户比较的不只是输出质量,也在比较哪个模型得到了更好的产品待遇。
讨论洞察: 围绕 Antigravity 的质疑,已经不再是“它能不能做出炫目的东西”,而是“它能不能继续编辑、文案能不能站得住、这个价格在规模化时意味着什么,以及为什么有些模型拿到的产品入口比别的更好”。
与前一天相比: 在 2026-08-15 和 2026-08-16,Antigravity 最强的案例还是登录界面、流水线、文档和专业化工作流。到了 2026-08-17,这个讨论集群变得更广、更商业化:落地页、首发定价、官方使用指导,以及产品入口对等性问题。
1.3 围绕智能体输出洪流的审查、可观测性与控制层还在持续增长(🡕)
第三个讨论集群,关注点已经不那么是“生成代码”,而是团队如何承受如今不断落到自己头上的海量智能体工作。共同模式是明确的控制入口:审查深度设置、会话仪表板、共享技能管理器、把回复转成图表的画布,以及解释为什么审查问题正变得更难的数据。这是前一周最清晰的延续趋势之一,但重点比起单纯安装工具,更偏向检查和分流。
@github 宣布(204 个赞、17 条回复、47,704 次浏览、58 次收藏)介绍了 Copilot 代码审查中的 Balanced 与 Lite 深度选项,以及组织级和仓库级默认设置。回复马上把这个抽象又往前推了一步:有人说审查深度应该跟随变更风险,而不是文件数量。这使得该功能看起来像是官方第一次试图以合理方式配给智能体注意力。
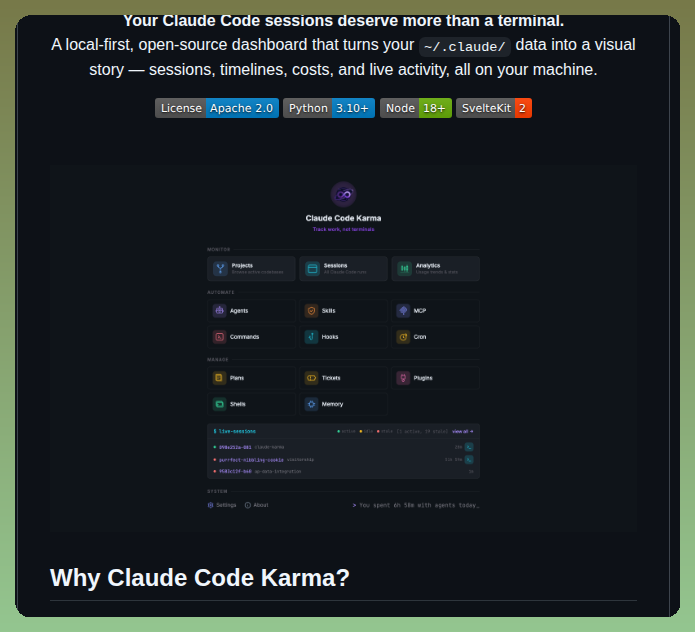
@tom_doerr 指向了(7 个赞、2 条回复、1,485 次浏览、5 次收藏)介绍了 Claude Code Karma,而公开的 repo 则解释了它为什么吸引人:这是一个覆盖 ~/.claude/ 会话数据的本地优先仪表板,能呈现时间线、成本、工具调用、shell、skills、hooks 和 tickets。这正是重度智能体用户不断自己造出来的那种“让不可见工作变得可读”的一层。
@DanWahlin 展示了(10 个赞、1 条回复、673 次浏览)介绍了 GitHub Copilot 应用里的“Visualize It”画布:它能把冗长的智能体回答转成架构图、流程图、时序图或时间线,然后再让 Copilot 继续细化。帖文传播不大,但它正面击中了一个纯摘要解决不了的痛点:很多时候,人们必须先看见结构,才能审查变更。
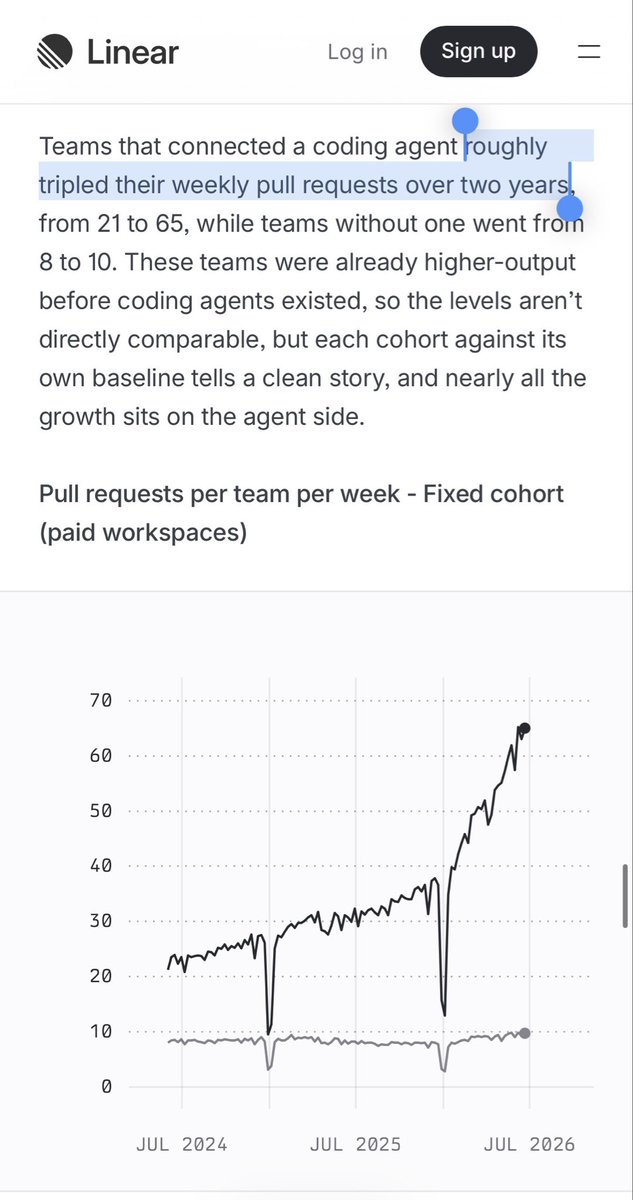
@GergelyOrosz 警告(14 个赞、2 条回复、2,454 次浏览、4 次收藏)指出,代码审查在很多创业公司里可能快撑不住了,而所链接的 Linear report 给出了这批数据里最有力的数字来说明为什么:按 workspace 计算,新增 pull request 相比 2024 年 6 月基线增长了 111%;使用编程智能体的团队,每周 pull request 数量大致从 21 增长到 65,而传统团队则从 8 增长到 10。
讨论洞察: 人们要的并不只是“更好的 AI”,而是更好的方式来给审查定规模、检查会话、跨客户端复用技能,以及把高密度输出转成便于人快速核验的形式。
与前一天相比: 在 2026-08-15 和 2026-08-16,skills 和可观测性就已经很重要。到了 2026-08-17,同一层能力更明显地倾向于审查容量与可解释性:更合适的审查规模、PR 量数据、会话分析,以及图表视图。
2. 什么让人感到沮丧
不同账户与产品入口之间的访问、定价和功能对等性,依然显得不一致
这是一个高严重度痛点,因为它同时出现在大帖和小帖里,而且问题非常具体,不是理论担忧。当天互动量最高的 Codex 线程下,依然有人回复说,两天就把付费额度烧完了,并希望有一个重置选项,不要在 @thsottiaux 帖子(4,539 个赞、615 条回复、247,224 次浏览、228 次收藏)这样的使用情境下,把下一次每周重置再往后推 7 天。Gemini 这边,@0xerfa 曝出(158 个赞、61 条回复、4,460 次浏览)则讨论了 Gemini 3.7 Flash 的临时首发价:有些回复认为这个价格对生产级智能体来说很激进,也有人仍然觉得它贵。
更伤人的证据在于,甚至在定价问题开始之前,访问规则和产品入口本身似乎就不一致。@ash_twtz 提问(43 个赞、36 条回复、2,448 次浏览)质问为什么 Antigravity 的语音输入对 Gemini 可用、对 Claude 却不可用;@GundiThore 抱怨(4 个赞、4 条回复、196 次浏览)则表示,付费 Gemini 账户反而进不了 Antigravity,免费的 Google 账户却还能用。这看起来很值得直接为之构建。痛点不只是“模型要花钱”,而是“我无法预测到底哪个账户、哪个模型、哪个产品入口能让我把工作做完”。
审查负担的上升速度,已经超过团队能够轻松检查的程度
这也是一个高严重度痛点,而且证据横跨产品发布、公开数据和安全事故。@github 介绍了(204 个赞、17 条回复、47,704 次浏览、58 次收藏)推出了 Balanced 与 Lite 审查深度,因为并不是每个 pull request 都值得同样多的智能体注意力。@GergelyOrosz 警告(14 个赞、2 条回复、2,454 次浏览、4 次收藏)指出,代码审查在创业公司里可能快要撑不住了,而 Linear 的公开报告则用数字支撑了这一警告:pull request 数量相较 2024 年 6 月增长了 111%,使用编程智能体的团队则从每团队每周 21 个 pull request 上升到 65 个。
最具体的失败案例来自 @galnagli 报道(37 个赞、1 条回复、2,279 次浏览、9 次收藏):在“Copilot Autofix powered by AI”引入一个有漏洞的改动之后,一名 AI 攻击者通过精心构造的 GitHub issue 标题进入了 Snowflake 的内部 Jira。即便这条线程是在转述别人的研究,公开材料仍然足够精确:抱怨并不是“AI 代码感觉有风险”,而是一个 AI 生成的修复移除了安全版本,随后另一个 AI 系统利用了这个结果。

这很值得直接为之构建,因为应对方式已经清楚可见:更合适的审查模式、图表、仪表板,以及更明确的验证层。这个痛点一再出现,很实际,而且已经贴近生产风险。
持久化与远程智能体工作流依然很有吸引力,但“拥有”起来仍然别扭
这里的需求很明显,缺口也同样明显。在 @petergyang 对比(160 个赞、27 条回复、24,766 次浏览、110 次收藏)中,Grok Bot 提供了最顺滑的持久计算机体验,但起价就是每月 200 美元;Hermes 依然开放、可定制,但需要自己动手搭;ChatGPT Work 则依旧存在令人困惑的产品边界,而且还无法登录用户最喜欢的应用。@viticci 很喜欢 展示了独特的 iPhone 优先 Codex Remote 流程,但同时也继续提出了对小组件、iOS 框架集成和“文件”App 访问的需求。
@Granite0x 主推(53 个赞、8 条回复、4,056 次浏览、88 次收藏)把 Rakazo 视作对这些取舍的回答,但公开仓库依然把它标为 beta,并要求 Docker、Postgres 和操作者投入。这看起来很值得作为竞争方向来做。严重度:中高。需求已经很清楚,但用户目前仍然只能在租用成本、搭建痛苦和缺失集成之间做选择。
对托管助手的依赖,仍然是一种运营风险
这里的证据更薄一些,但很直接。@githubstatus 报道称(13 个赞、11 条回复、2,638 次浏览)提到了 Copilot 可用性下降;@FredTerzi 表示(14 个赞、2 条回复、215 次浏览、3 次收藏)则显示,影响之所以较小,只是因为他已经在本地跑 Qwen。这是个有用的区别:有些用户现在不再靠耐心解决宕机,而是靠备用栈来解决。
如果某个产品能把故障切换、本地兜底或降级模式路由自动化,这个方向就值得投入。严重度:中。
3. 人们希望存在什么
一个覆盖多家提供方的访问、支出与入口对等性控制平面
人们反复在要的,不是又一个旗舰模型,而是一种能在会话开始前就判断:到底哪个账户、哪个模型、哪个产品入口会配合工作的方式。@0xerfa 发布了 提到了 Gemini 3.7 Flash 的定价和上线细节,@ash_twtz 指出 指向 Antigravity 里 Gemini 与 Claude 之间的语音输入差距,@GundiThore 描述了 则反映出付费账户的访问表现反而比免费账户更差,而 @thsottiaux 帖子串 下的回复还要求更清晰的重置成本机制。
这不是理想化诉求,而是实用需求。人们已经在手动绕过混乱的访问规则来安排工作。机会:直接。
不是更多文字,而是便于审查的智能体工作表示形式
今天最强烈的愿望,不是要更多输出,而是要能让人快速检查的输出。@github 补充说 提出了 Balanced 和 Lite 审查深度,因为一刀切的审查已经撑不住了。@DanWahlin 构建了 提到一个能把回答转成图表的 Copilot 画布,@tom_doerr 分享了 则提到 Claude Code Karma,因为终端日志和 JSONL 文件在规模化后太难推理。
Linear 的公开数字让这种紧迫性非常明确:根据报告 @GergelyOrosz 引用了,使用编程智能体的团队每周 pull request 数量大致翻了三倍,从 21 增长到 65。这几乎就是由工作流数据支撑的“愿望表达”。机会:直接。
既不受封闭定价约束、也不必承受 DIY 痛苦的可移植持久计算机
@petergyang 阐述了 很清楚地展示了当前取舍:Grok Bot 有内置的持久计算机,但每月 200 美元;Hermes 可定制,但需要自己搭;ChatGPT Work 则依然有产品边界和认证摩擦。@viticci 展示了 展示了移动端理想终局的样子——完整的手机优先远程控制,加上语音;@Granite0x 曝出 则把 Rakazo 作为瞄准这一缺口的开放式构建方案。
这里的愿望很明确:保留持久计算机、记忆和远程控制的便利,但去掉封闭定价,或者去掉操作者负担。机会:直接到竞争性。
跨客户端和跨智能体共享的技能生命周期
@DanKornas 认为 指出,编程智能体技能不应该需要在每个客户端里分别维护,而公开的 Skills Manager repo 则写明了用户想要的产品形态:Library → Collection → Mount、多智能体安装、发现,以及本地生命周期控制。这是以产品形态出现的“愿望语言”。用户想要的是一套可复用的技能库存,而不是同一份指令在不同工具专属文件夹里散落五份。
现在已经有一些局部答案,但仍然按客户端碎片化。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Codex / Codex Remote | 编程智能体 / 远程工作流 | (+/-) | 围绕在线率、开源走向、iOS 优先远程控制和语音驱动线程分派,形成了很强的产品认知 | 付费套餐额度耗尽、重置抱怨,以及围绕“Astra”和产品清晰度的未决问题 |
| Gemini 3.7 Flash | LLM / 编程模型 | (+/-) | 强到足以让用户明确表达从 3.6 升级的意愿;官方指导现已覆盖思考级别、截图和子智能体用法 | 首发定价仍引发分化反应,用户也还在等待长期生产价值的验证 |
| Antigravity | 智能体外壳 | (+/-) | 一次生成的演示能力强,并已广泛铺到 Google 各个入口;支持 Gemini 语音输入和子智能体工作流 | 用户质疑第一次修改请求后结果是否还能编辑,并抱怨不同模型之间的入口功能差距 |
| ChatGPT Work | 持久化工作界面 | (+/-) | 在当天的对比中,浏览器使用和语音能力表现最佳;对部分重度用户来说仍是日常主力 | Chat、Work 和 Codex 之间划分令人困惑;浏览器还无法登录最常用的应用 |
| Grok Bot | 持久化云计算机 | (+) | 在对比中最有“智能体拥有自己计算机”的产品感;UX 简单且聚焦 | 200 美元/月的起价,以及多线程工作流灵活性较低 |
| Hermes | 自托管智能体运行时 | (+/-) | 开源且高度可定制 | 即使回复里有人认为搭建越来越容易,DIY 负担依然是主要抱怨 |
| Rakazo | 自托管持久化运行时 | (+) | 把持久 bot 计算机、模型选择和沙箱选择带进了一个可检查的自托管产品 | 仍处于 beta 阶段,需要 Docker、Postgres 和操作者投入 |
| GitHub Copilot 审查深度 | 审查控制入口 | (+) | 让团队能把智能体投入与变更复杂度匹配,并在组织/仓库级设置默认值 | 仍然只是较粗的控制;回复希望审查针对高风险代码路径调节,而不只是调节深度 |
| Skills Manager | 技能生命周期管理 | (+) | 可复用的 Library → Collection → Mount 模型、多智能体安装、发现,以及本地优先控制 | 仅支持 macOS,而且团队仍需有意识地采用这一额外层 |
| Claude Code Karma | 可观测性 | (+) | 无需云依赖,就能把本地会话数据变成时间线、成本、工具调用历史和实时活动 | 更适合已经深度使用 Claude Code 工作流的人,而不是普通智能体用户 |
满意度最高的,往往是那些掌控了完整工作流边界的工具:持久计算机、手机优先远程控制、明确的审查深度、共享技能库,或者本地可观测性。摩擦则出现在用户仍需猜测哪个账户能用、一次运行要花多少钱、或者智能体真实状态到底存放在哪里的时候。
最常见的应对方式是:当托管产品变贵或不可用时,转向自托管或本地运行;把可复用技能打包,而不是在不同工具之间反复复制;以及把长篇文字变成仪表板或图表。迁移压力正在从通用聊天界面转向持久化智能体计算机,也正在从按客户端分别配置转向共享控制平面。
竞争态势看起来已经不太像“哪个前沿模型赢了”,而更像“哪个产品能让模型在真实约束下变得可用”。Codex、Antigravity、Grok Bot、ChatGPT Work、Rakazo、Skills Manager 和 Copilot 之所以获得关注,是因为它们改变了模型周围的操作界面,而不是因为它们带来了新的基准成绩。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Rakazo | elie222 | 开源版 Grok Bot 替代方案,每个 bot 对应一个线程和一台计算机 | 让团队拥有持久化智能体计算机,而不必租用封闭控制平面 | TypeScript、React 19、Electron、Expo、Hono、Postgres、Prisma、Better Auth、Graphile Worker、Docker/E2B/桌面沙箱 | Beta | 帖子 · repo |
| Claude Code Karma | JayantDevkar | 面向 Claude Code 会话、时间线、成本、工具、shell、hooks 和 tickets 的本地优先仪表板 | 把埋在 ~/.claude/ 会话数据里的内容,变成人能检查和搜索的东西 |
Python、Node、SvelteKit、本地 ~/.claude/ 数据 |
已发布 | 帖子 · repo |
| Skills Manager | yibie | 用于在编程智能体之间发现、分组、挂载和更新 skills 的原生 macOS 应用 | 去掉 Codex、Cursor、Copilot、Gemini CLI 和其他客户端里的重复技能维护 | SwiftUI、Swift 6、SwiftData、本地 Library → Collection → Mount 工作流 | 已发布 | 帖子 · repo |
| Visualize It | @DanWahlin | 把智能体回答转成图表并允许 Copilot 继续细化的 GitHub Copilot 画布 | 让冗长、抽象的智能体回答更容易审查和讨论 | GitHub Copilot 应用、图表画布、架构图/流程图/时序图/时间线视图 | Alpha | 帖子 |
Rakazo 是这组项目里结构野心最大的一项构建。公开 README 对它的定位说明得异常清楚:一个 bot 对应一个线程和一台计算机;用户自带模型和沙箱;产品可以在没有 Rakazo 自营控制平面的情况下运行。这使它不像一个“提示词封装器”,而更像是在直接尝试把持久化智能体计算机从封闭供应商产品中拆分出来。
Claude Code Karma 和 Visualize It 瞄准的是另一个瓶颈:理解智能体已经做过什么。Karma 把本地会话日志变成时间线、成本视图、工具历史和 ticket 链接;Visualize It 则试图把一长段 Copilot 回答变成可供审查的图表,而不是另一堵文字墙。
Skills Manager 是最清晰的“控制平面的控制平面”式构建。其公开 README 表示,核心模型是 Library → Collection → Mount,也就是说技能只存一份,按工作流分组,然后按需挂载到一个或多个智能体上,而不是分别复制进每个客户端。

Visualize It 的传播范围较小,但方向很重要。重点不是再加一个模型功能,而是在智能体的自然语言回答过长、过于抽象、难以高效审查时,产出一种人能快速追问和盘查的工件。

反复出现的构建模式已经很清楚:构建者主要在做的是智能体周围的操作层,而不是发布新的基础模型。他们在做持久化、可观测性、生命周期管理和表示工具,让现有智能体更值得信任、更便于复用,或更容易检查。
6. 新的与值得注意的内容
Linear 用硬数字托住了“PR 太多”的担忧
@GergelyOrosz 帖子(14 个赞、2 条回复、2,454 次浏览、4 次收藏)值得注意的地方,不只是警告本身,而是所链接的 Linear report 给出了足够强的公开工作流数字来支撑这种警告:每个 workspace 的 pull request 数量相较 2024 年 6 月基线增长了 111%,使用编程智能体的团队每团队每周 pull request 数量从 21 上升到 65,而 AI 现在撰写了 Linear 中所有新建 issue 的略低于一半。这让“审查过载”不再只是感觉,而成了可衡量的工作流变化。
Snowflake/Jira 漏洞利用把一整条 AI 对 AI 的失败链公开化了
第二个值得注意的信号,是 Snowflake 那条线程具体到了什么程度。@galnagli 表示(37 个赞、1 条回复、2,279 次浏览、9 次收藏)称,一名 AI 攻击者通过精心构造的公开 GitHub issue 标题进入了 Snowflake 的内部 Jira,而此前存在漏洞的变更是由“Copilot Autofix powered by AI”引入的;@wiz_io 放大传播了(7 个赞、2 条回复、727 次浏览)也提到了同样的说法。这之所以重要,是因为这个失败并不是以“普遍粗心”来描述的,而是被描述成一条链:一个 AI 系统引入了 bug,另一个 AI 审查层漏掉了它,接着又被另一个 AI 系统利用。
7. 机会在哪里
[+++] 面向智能体输出的审查、审计与可视化层 — 第 1 至第 6 节的证据都指向同一个方向:Copilot 审查深度、Claude Code Karma、Visualize It、Linear 的 PR 增长数据,以及 Snowflake Autofix 失败案例,都说明团队需要的不只是更多生成能力,而是更快检查、定规模、画结构图和验证智能体既有产出的方式。
[++] 可移植的持久化智能体计算机 — Peterg Yang 对 Grok Bot/Hermes/ChatGPT Work 的比较、Viticci 的 iPhone 优先 Codex Remote 工作流,以及 Rakazo 的自托管运行时,都表明市场对能保留状态、维持登录并跨会话继续工作的智能体有很强需求。机会强度属于中等,因为需求非常明显,但当前答案仍然分裂在昂贵的托管产品和操作者负担很重的自托管之间。
[+] 跨智能体的技能、访问与路由控制平面 — Skills Manager、Gemini 入口对等性抱怨、付费与免费账户访问不一致,以及首发定价争论,都说明仍有空间容纳这样一层:它既决定任务该在哪儿运行,也决定共享技能如何跟着任务走。这个信号还在形成中,尚未占据主导,但痛点已经足够具体,足以支撑聚焦型产品。
8. 要点总结
- 最强的 AI 编程帖文讨论的是产品形态,而不是模型智商。 最大的 Codex 和持久计算机相关线程,关注的是在线率、重置、远程控制、记忆,以及谁拥有那台计算机,而不是基准炫耀。(来源)
- Antigravity 重新获得势头,但人群现在用可编辑性、定价和对等性来检验它。 Google 的单提示词落地页演示确实吸引了注意力,但真正有用的回复立刻在问:页面能不能撑住后续编辑、文案质量是否过关,以及为什么 Gemini 比 Claude 拿到了更好的语音入口。(来源)
- 审查瓶颈已经变得足够可量化,以至于产品控制开始跟着出现。 GitHub 在同一天推出了可调节的审查深度,而 Linear 的公开数据和 Gergely 的总结则进一步强调,使用编程智能体的团队 PR 数量正在多快地上升。(来源)
- 构建者正在把更多精力投入智能体周围的操作层,而不是新模型。 Rakazo、Claude Code Karma、Skills Manager 和 Visualize It 都在试图让现有智能体更易拥有、更易检查、更易复用,或者更易理解。(来源)