Twitter AI 编程 - 2026-08-27
1. 人们正在讨论什么
1.1 Antigravity 让智能体工作变得更可视、更具协作性(🡕)
当天最集中的讨论,围绕 Google Antigravity 如何让智能体工作更易于查看、检查和协调展开。三个独立信号共同支撑了这一主题:交互式工件的发布、面向长期任务的多智能体研究模式,以及一次可靠性更新——后者表明,这些更重型的工作流已经开始给真实环境带来压力。
@antigravity 介绍(811 个赞、40 条回复、38,617 次浏览、261 次收藏)介绍了交互式生成式 UI 工件,让智能体生成的不再只是 Markdown、静态图片或 Mermaid 图表。相关的 Antigravity 博文 进一步明确了范围:智能体可以生成交互式 HTML/CSS/JS 组件、实时图表、图示以及零依赖可视化内容,这些内容可在本地渲染,也可以导出后离线使用。其独特之处在于,解释和检查如今都发生在工件面板内,而不是另一个仪表盘或浏览器标签页中。(文章链接)
@antigravity 表示(261 个赞、10 条回复、10,901 次浏览、99 次收藏)称,Google Research 和 Google DeepMind 团队已经在使用 Antigravity 中的 Teamwork,开展理论计算机科学、研究数学和系统工程工作。相关的 Teamwork 文章 将其进一步具体化为一个真实的产品界面:/teamwork-preview 可选择 Iterative Coding、Distributed Coding、Long Proof、Self-Verification 和 Document Review 等模式,帖子声称其成果包括解决七个开放问题,以及构建出可启动操作系统、周期精确的 RISC-V 模拟器。推文自身的限定同样重要:Antigravity 表示,该模式会消耗大量 token,对日常任务来说属于“杀鸡用牛刀”,这让它的定位比泛泛的“多智能体”炒作更具体。(文章链接)

@shengzheyao 报道称(87 个赞、14 条回复、3,638 次浏览)称,Antigravity CLI 1.1.22 降低了 CPU 占用,减少了运行中断,并改善了 Windows 上的表现。按互动量看,这是一条较小的帖子,但它清楚提醒了实践者:更炫的编排和工件功能,仍然依赖底层运行时的基本稳定性。(文章链接)
讨论洞察: 回复并没有把这些发布视为可以互相替代的功能。Teamwork 讨论串下的一条回复称“那是一支舰队,不是多开几个标签页的聊天”,另一条则询问预览版与正式版之间的边界是否已经真正落地。大家关心的是证据留存、版本管理和运营成本,而不是多智能体工作流听起来是否令人兴奋。
与前一天的比较: 上一周,Antigravity 和 Copilot 的势头主要集中在 Xcode、WSL、Azure DevOps 以及共享聊天会话等新界面上。到了 2026-08-27,关注重心转向智能体如何呈现工作,以及多个智能体如何在更长时间跨度内协同完成工作。
1.2 GitHub Copilot 继续把设备测试与组织级控制纳入同一智能体层(🡕)
第二个主题,是 GitHub 自有智能体界面的范围不断扩大。这些帖子覆盖的尺度不同,但方向一致:Copilot 正被向下推进到模拟器级测试,向上延伸到组织级协同,而不再停留在源文件层面。
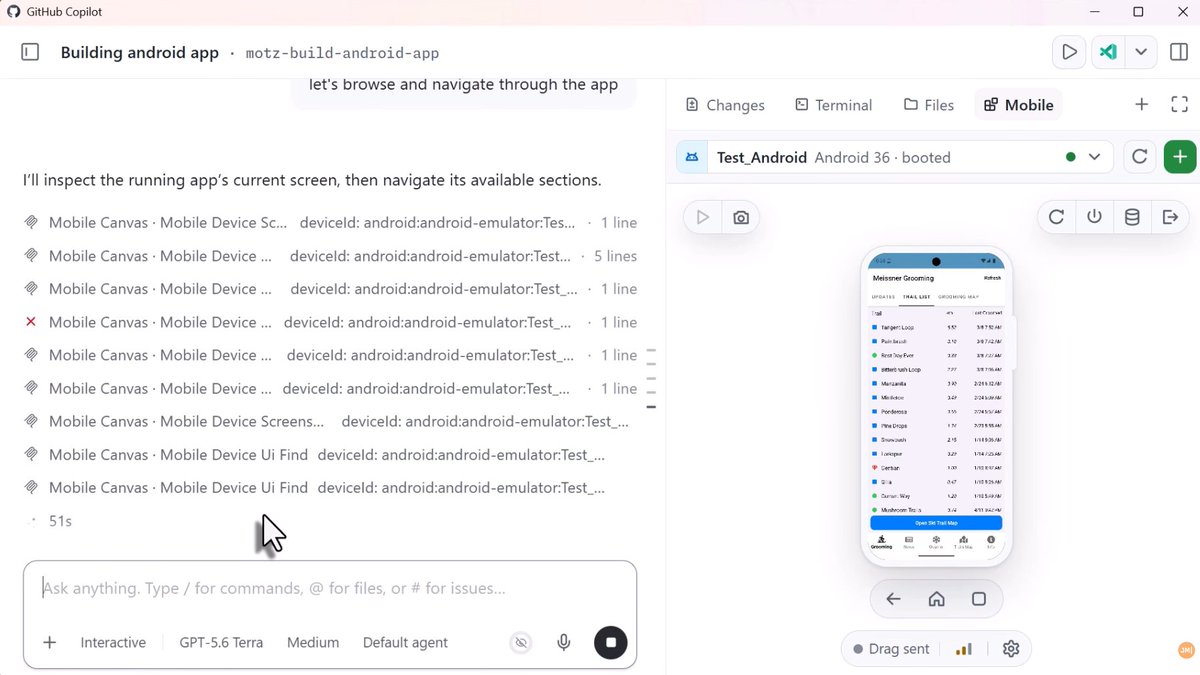
@pierceboggan 宣布(53 个赞、2 条回复、2,189 次浏览、14 次收藏)称,用户现在可以直接在 GitHub Copilot 应用中构建和测试 iOS 与 Android 应用。截图是最有信息量的证据:其中展示了 Mobile 标签页、Android 36 模拟器、设备屏幕检查,以及同一工作区内连续执行的移动测试和导航操作。这让该功能看起来不再像远程触发器,而更像真正内置于界面中的设备工作流。(文章链接)
@GitHubNext 将其定位为(9 个赞、1 条回复、1,547 次浏览、5 次收藏)介绍了 GitHub Agentic Workflows,将其定位为一个企业级控制平面,用于推行组织范围的变更、评估数百个仓库的代码质量、同步依赖更新、传播策略变更以及追踪 AI token 成本。附带的幻灯片提供了最有用的细节,包括安全回滚、共享治理,以及对 GitHub Enterprise Server 和 GitHub Enterprise Cloud 的支持。它与移动测试帖子的共同点在于:GitHub 正试图让更多执行与审查环节留在一个受管理的界面中。(文章链接)

讨论洞察: 这一组讨论中最简短的回复,也是最能说明问题的一条:有人在移动测试帖下只回复了“闭环”。这比任何标题都更准确地概括了现有证据所呈现的整体方向。用户正在奖励那些能够消除编码、测试、审查与治理之间交接环节的功能。
与前一天的比较: 前一天 GitHub 最强的信号来自 Azure DevOps 审查工作、WSL 支持以及 Slack/Teams 共享会话。2026-08-27,范围扩大到基于模拟器的移动测试,以及明确面向多仓库的企业级控制平面。
1.3 自主智能体正在获得支撑层,而不只是更多提示词(🡕)
第三个主题是:人们不仅要求智能体工作更久,也在围绕智能体循环,将搜索、安全和自主性封装成明确的模块。最有价值的证据结合了高曝光度的 Codex 自主性传闻、具体的搜索服务定价,以及一个互动量不高但表述异常明确的安全子智能体案例。
@kimmonismus 报道称(146 个赞、26 条回复、11,581 次浏览、31 次收藏)称,OpenAI 正在测试 Codex 的“Persistent mode”,允许智能体持续工作,直到被置于休眠状态;它可以为自己创建后续任务、跨会话保留上下文,有时还会先主动给用户发消息。附带的摘录图片让这一说法比单独的推文更具体,因为它将该功能与 Codex 的推理强度菜单,以及“持续工作直到被置于休眠状态”的明确措辞联系起来。回复立即追问了发布内容没有回答的实际问题:当智能体决定继续运行时,计算费用由谁承担。(文章链接)

@ariskaa_ai 描述了(3 个赞、2 条回复、139 次浏览、3 次收藏)介绍了 Keenable,这是一个面向智能体的网页搜索层,覆盖 API、MCP 和 CLI 界面。对于一条互动量很小的帖子而言,其证据密度异常高;截图证实了具体运行细节:登录后每月可免费请求 100,000 次,之后每 1,000 次请求收费 $4,速率限制为每秒 10 次。重要之处不在于抽象意义上的“免费搜索”,而在于搜索和页面抓取被封装成可复用的智能体基础能力,并提供简洁的 Markdown 输出和适合工具调用的接口。(文章链接)
@ntaylormullen 展示了(3 个赞、1 条回复、156 次浏览、1 次收藏)介绍了一个拥有独立私有漏洞扫描工具的安全审查子智能体。截图很重要,因为它让代码中的边界清晰可见:一个名为 security_reviewer 的子智能体、其自身的工具列表,以及一个私有的 scan_vulnerabilities 函数。这比笼统地承诺“智能体可以协助安全工作”更能体现治理信号。(文章链接)
讨论洞察: 即使是支持自主性的观点,也都伴随着运营层面的限定。Persistent mode 的回复集中讨论无上限账单,Keenable 的宣传明确区分了搜索额度与模型额度,而安全案例之所以可信,正是因为特殊工具的边界清晰可见。
与前一天的比较: 上一周已经出现了对封装层、配额和可移植性的持续兴趣。到了 2026-08-27,这场讨论变得更加具体:持续执行、搜索即基础设施,以及安全专家子智能体,都以明确的产品或代码界面呈现出来。
1.4 团队开始把记忆与跨领域工作流系统化,而不是临时拼凑(🡕)
另一个强烈的讨论方向是形式化。人们不再把记忆和工作流视为临时凑出来的提示词技巧,而是越来越多地描述明确的架构、可复用组件,甚至是借鉴同类智能体模式的非编码工作流。
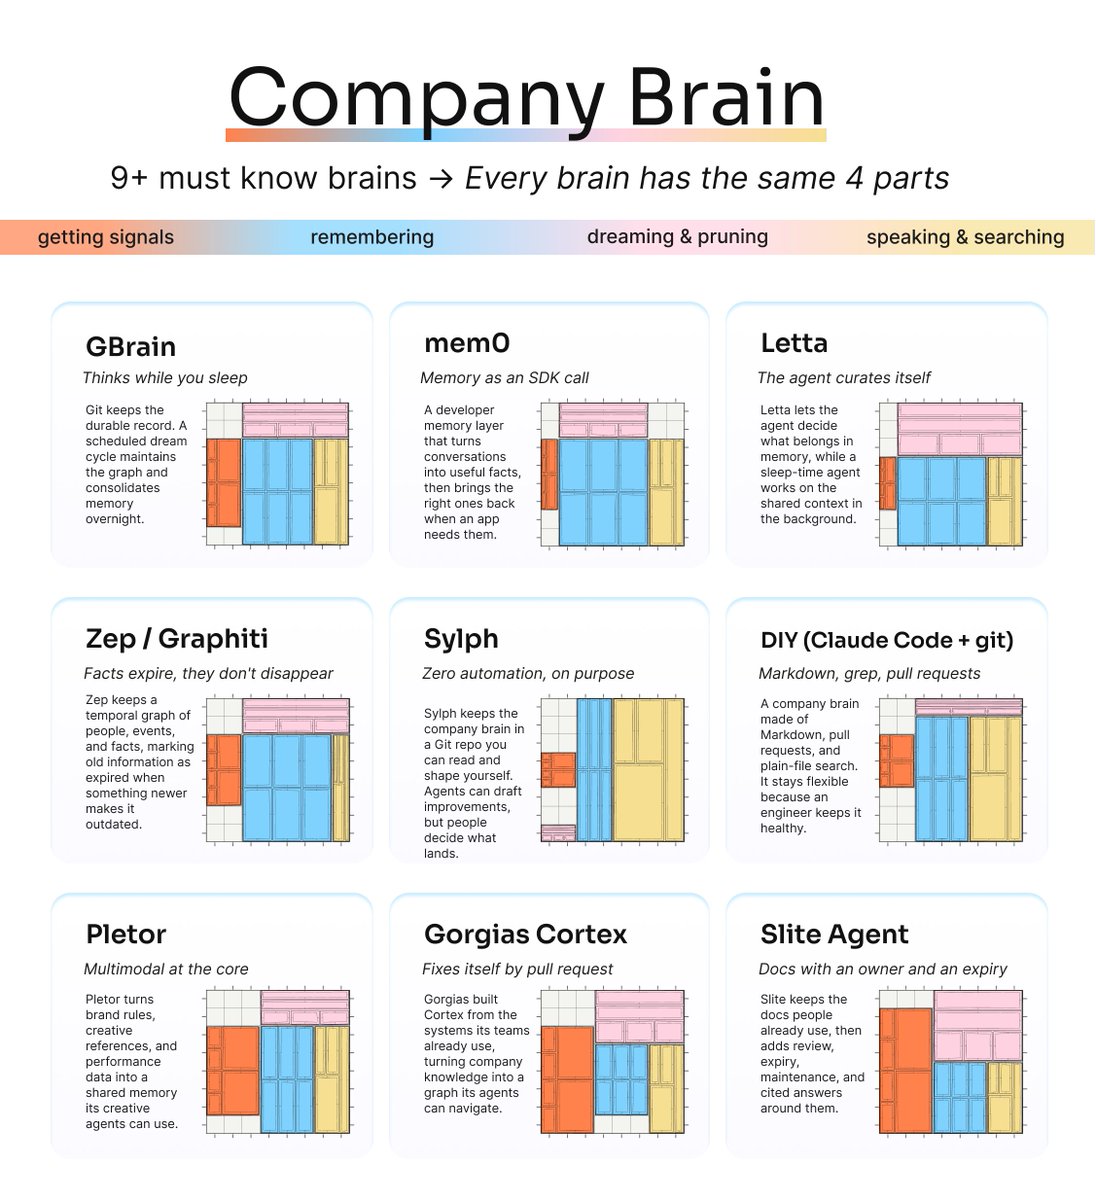
@femke_plantinga 认为(12 个赞、2 条回复、304 次浏览、13 次收藏)称,九种不同的“公司大脑”系统最终都可以归结为四个部分:获取信号、记忆、发散/修剪,以及表达/搜索。附图通过将这些部分映射到 GBrain、mem0、Letta、Zep/Graphiti、DIY Claude Code + git、Gorgias Cortex、Pletor 和 Slite Agent,为这一说法提供了清晰结构。最有用的回复补充了一个实践层面的警告:修剪比记忆更重要,因为过时的笔记看起来可能与新鲜信息一样自信。(文章链接)
@alex_verem 分享了(11 个赞、4 条回复、2,408 次浏览、15 次收藏)介绍了 OpenMontage,这是一个将 Claude Code 变成完整视频制作工作室的开源系统。公开的 OpenMontage 仓库 明确了范围:12 条制作流水线、100 多种工具、参考视频分析,以及从研究、写脚本、选择素材、配音、字幕到最终渲染的端到端流程,其中包括制作成本仅 $1.33 的动画短片等明确的低成本示例。重要信号在于,智能体技术栈如今正被视为相邻生产工作的编排基础设施,而不只是代码编辑工具。(文章链接)
讨论洞察: 记忆和构建工具相关帖子最终指向了同一个教训:难点不只是生成更多输出,还在于决定保留什么、验证什么,以及如何在不让系统逐渐漂移的情况下延续流程。
与前一天的比较: 本周早些时候的报告已经强调了技能、运行手册和控制平面。2026-08-27,这些概念以更具体的形式出现:四部分记忆分类法,以及一个远离日常编程、已经交付的智能体工作流软件包。
2. 什么让人感到挫败
可靠性工作仍然是前置工作
这一点属于高严重性问题,因为即使是在发布日的兴奋情绪中,人们仍不断把话题拉回运行时稳定性。@shengzheyao 报道称(87 个赞、14 条回复、3,638 次浏览)称,Antigravity CLI 1.1.22 需要更少 CPU、运行中断更少,并且在 Windows 上表现更好,这意味着这些仍是日常使用中的现实痛点,而不是已经解决的旧问题。@antigravity 承认(261 个赞、10 条回复、10,901 次浏览、99 次收藏)称 Teamwork 消耗大量 token,而且“对日常任务来说属于杀鸡用牛刀”;与此同时,@pierceboggan 展示了 展示了在 Copilot 内运行移动应用构建和测试,这进一步提高了对模拟器、设备和工作流可靠性的要求。数据中可见的应对策略是:一边庆祝雄心勃勃的新界面,一边继续奖励那些改善 CPU、Windows 兼容性和运行中断问题的团队。值得直接围绕这一点构建产品,因为最先进的工作流往往会在运行时嘈杂不稳定时最先失败。
没有人就长期记忆该如何存储、修剪或审查达成一致
这同样属于高严重性问题,因为分歧涉及核心架构,而非个人偏好。@femke_plantinga 表示(12 个赞、2 条回复、304 次浏览、13 次收藏)称,每个“公司大脑”都有相同的四个部分,但图中的示例仍从仓库本地 Markdown 和拉取请求,延伸到记忆 SDK、时间图谱、文档监听器和自我整理型智能体。讨论中最有力的细节来自一条回复:过时的笔记可能比缺失的笔记更糟,因为它们与新鲜笔记一样,会以自信的口吻呈现。因此,修剪比简单累积更重要。团队正在通过让人类保留在审批环节、以 PR 作为审查边界,以及明确标注新鲜度来应对。这显然值得围绕其构建产品。
更高的自主性意味着更模糊的预算与护栏
这一点属于中高严重性问题,且证据异常具体。@kimmonismus 报道称 介绍了 Codex 的 Persistent mode,但回复立即追问:当智能体“无限期继续运行”时,谁来买单。@ariskaa_ai 描述了 介绍了一个拥有共享公共池、登录后额度和明确超额付费价格的搜索层,而 @ntaylormullen 做出了 展示了代码中可见的私有安全审查工具边界。共同的应对办法,是为智能体增加更明确的脚手架:独立额度池、命名工具和清晰的审批边界。因此,这种挫败感既是运营问题,也是一种产品机会。
3. 人们希望存在什么
更丰富的内联工件,在不强制切换上下文的情况下解释工作
最明确的实际需求,是让智能体以比纯文本更易检查的形式展示工作。@antigravity 推出了(811 个赞、40 条回复、38,617 次浏览、261 次收藏)介绍了交互式生成式 UI 工件;相关博客描述了在同一工作区中生成本地交互式组件、图表、图示并导出为离线内容。@pierceboggan 展示 中展示的 Copilot 在原地检查 Android 模拟器的移动测试截图,也印证了同一底层需求:人们希望证据和答案一样,都留在同一个界面中。机会:直接。
能保持新鲜、不会变成陈旧传闻的持久公司记忆
人们显然希望拥有长期记忆,但不希望记忆层在无人察觉的情况下逐渐腐化。@femke_plantinga 梳理了 展示了 mem0、Letta、Zep/Graphiti、Slite Agent,以及 DIY git + markdown 等系统;其中最有力的回复称,旧笔记应该先“证明自己值得保留”,否则就应被丢弃。这个需求是实际的,而非理想化的:团队希望在同一架构中实现信号获取、记忆、修剪和搜索,并配备可审查的新鲜度规则。机会:竞争性。
面向自主智能体的可插拔支撑层:搜索、安全与预算控制
数据还显示,人们需要的是围绕智能体循环构建的可复用基础设施,而不只是更聪明的基础模型。@ariskaa_ai 描述了 介绍了一个覆盖 MCP、CLI 和 API 的智能体搜索层,并提供公共额度和登录后额度;@ntaylormullen 展示了 介绍了一个带私有工具的安全审查子智能体;@kimmonismus 披露了 则展示了没有相应预算答案的持续执行能力。这是一个直接的机会,因为缺失的组成部分已经非常清晰:可搜索的网络上下文、受治理的专业工具,以及更明确的支出边界。
一个能够从编码一路延伸到测试,再到组织级推广的智能体循环
另一个较为安静但很强的需求,是跨尺度的连续性。@pierceboggan 转向了 将 Copilot 推进到设备测试,@GitHubNext 将其定义为 则围绕策略传播、依赖协调和多仓库回滚,展示了 GitHub Agentic Workflows。实际需求并不是“更多功能”,而是一条可审查的统一循环:当工作从本地应用界面转向大规模自动化时,仍能持续保留上下文。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Antigravity | 智能体工作区 | (+) | 交互式工件、本地可视化、工件面板审查,以及从解释到检查的更短路径 | 更重型的工作流仍依赖运行时稳定性,对于日常任务可能过于复杂 |
| Teamwork in Antigravity | 多智能体编排 | (+/-) | 通过基于模式的协调,支持编码、证明、验证和文档审查;明确面向长期任务 | 消耗大量 token,并且公开承认不适合日常工作 |
| GitHub Copilot app | 智能体工作区 / 移动测试 | (+) | 在应用内完成 iOS/Android 构建测试、设备检查,并统一工作区上下文 | 除发布截图外,目前来自草根用户的证据有限 |
| GitHub Agentic Workflows | 企业自动化 | (+) | 多仓库协调、治理、回滚、成本追踪和策略传播 | 面向企业,本样本中的实践者细节较少 |
| Codex Persistent mode | 智能体模式 | (+/-) | 长时间运行的后续工作、跨会话连续性,以及主动创建任务 | 没有发布日期,预算控制不明确,并立即引发了失控支出的担忧 |
| Keenable | 搜索基础设施 | (+) | 支持 API、MCP 和 CLI;提供简洁的 Markdown 抓取结果;免费层和超出免费额度后的定价明确 | 存在创始人发布项目的局限、共享公共池限制,并且不包含模型额度 |
| mem0 / Letta / Zep/Graphiti / git-plus-PR memory | 记忆技术栈 / 方法 | (+/-) | 让记忆架构明确化;支持新鲜度、时序历史或仓库本地审查 | 陈旧、修剪和审查边界仍未解决 |
| OpenMontage | 智能体工作流软件包 | (+) | 将编码助手变成从研究到渲染的完整视频制作流水线,支持参考内容分析并提供具体成本示例 | 比普通编码工作流更广、更复杂;依赖庞大的工具栈 |
当工具消除了明确的协作成本时,满意度最高。@antigravity 做出了 把丰富的内联工件真正落到了实处,@pierceboggan 展示了 让 Copilot 一路跟进工作直至模拟器,而 OpenMontage 仓库 则把编码助手变成了一条完整的生产流水线,而不是另一个聊天外壳。
当支撑脚手架仍然隐含不明时,满意度就会下降。@kimmonismus 披露了 展示了缺少明确账单边界的持久智能体模式,@shengzheyao 特别指出 展示了 CPU、运行中断和 Windows 修复,而 @femke_plantinga 展示了 则表明团队仍未就记忆该如何存储和修剪达成一致。因此,最主流的应对方式是建立明确结构:仓库本地文档、拉取请求、命名子智能体、速率限制,以及围绕智能体提供的可安装服务。

5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Antigravity Generative UI Artifacts | @antigravity | 让智能体在界面内生成交互式工件、图表、图示和本地可视化组件 | Markdown 和静态图示往往不足以解释架构、数据和工作流 | Antigravity、本地 HTML/CSS/JS 渲染、工件预览/导出 | 已发布 | 推文、博客 |
| Teamwork in Antigravity | @antigravity | 让多智能体模式运行数小时或数天,完成编码、证明、验证和文档审查 | 单智能体循环难以处理长期、开放式的研究与工程任务 | Antigravity、Gemini 模型、基于模式的编排、/teamwork-preview |
Beta | 推文、博客 |
| GitHub Copilot mobile build/test | @pierceboggan | 在 Copilot 应用内构建和测试 iOS 与 Android 应用 | 将设备测试和应用导航留在同一个智能体工作区,而不是交给另一款工具 | GitHub Copilot app、Mobile 标签页、Android 模拟器、移动画布 | 已发布 | 推文 |
| OpenMontage | calesthio/OpenMontage | 将编码助手变成完整的视频制作系统 | 研究、脚本、素材选择、配音、字幕和渲染通常分散在多种工具中 | 12 条流水线、100 多种工具、700 多个技能文件、支持本地/云端模型 | 已发布 | 仓库、推文 |
| GitHub Agentic Workflows | @GitHubNext | 协调依赖同步、策略传播和减少待办积压等重复性多仓库工作 | 为组织在仓库集群规模上开展受治理的智能体工作提供控制平面 | GitHub 平台、审计、成本控制、GitHub Enterprise Server/Cloud | Beta | 推文 |
这些项目值得关注,是因为它们都试图掌握协作层,而不只是再提供一个模型端点。Antigravity 的两次发布分别聚焦于如何呈现工作,以及多个智能体如何协作。GitHub 的发布则从另一端推动同一方向:减少仓库上下文、设备测试和受治理的组织级推广之间的交接。
OpenMontage 是最清晰的跨领域构建信号。仓库 将智能体定义为一支制作团队:它可以分析参考视频、选择流水线、组装素材,并根据明确的成本示例渲染结果。这一模式意义重大,因为它表明智能体工作流技术栈正在被复用于相邻的创意生产流程,而不是困在代码审查和漏洞修复之中。
6. 新动向与值得关注之处
面向智能体的搜索定价变得异常明确
@ariskaa_ai 描述了(3 个赞、2 条回复、139 次浏览、3 次收藏)介绍了 Keenable,这是一个面向智能体的搜索层,提供 API、MCP 和 CLI 界面。但真正值得关注的是截图中可见的运行细节:登录后每月免费请求 100,000 次,之后每 1,000 次请求收费 $4,速率为每秒 10 次。这一点很重要,因为搜索和页面抓取通常被视为不可见的底层管道;在这里,它们被像智能体技术栈的一等组成部分一样封装和定价。
专业安全子智能体以代码形式出现,而不只是产品文案
@ntaylormullen 展示了(3 个赞、1 条回复、156 次浏览、1 次收藏)介绍了一个连接私有漏洞扫描器的安全审查子智能体。截图之所以重要,是因为其中明确展示了边界:一个命名子智能体、独立的工具列表,以及限定的安全用途。相比笼统的“AI for security”表述,这是更强的信号,因为它展示了专业化智能体角色可能如何在实际中被约束。

7. 机会在哪里
**+++] 可审查的长周期编排**——Teamwork、Codex Persistent mode、Copilot 移动测试和 GitHub Agentic Workflows 都指向同一个缺口:代理被要求在更长时间内完成更多工作,但用户仍需要可让这些工作接受审查的产物、预算和回滚控制。([来源、1、2、3)
**++] 更丰富的内联解释界面**——交互式工件和设备级 Copilot 截图都展示了让证据紧邻工作内容的价值。这一中等强度信号并非关乎更美观的 UI,而是关乎在保留可检查性的同时减少上下文切换。([来源、1)
**++] 面向搜索、安全和策略的代理支持服务**——Keenable 的搜索层、安全审查员子代理示例以及 GitHub 的企业工作流定位,都表明代理周边服务正在形成一个增长中的市场,团队无需替换整个客户端即可安装这些服务。([来源、1、2)
8. 关键结论
- Antigravity 的差异化重点,已经从“智能体在哪里运行”转向“智能体能展示和协调什么”。 交互式工件、Teamwork 模式和可靠性更新共同表明,这个平台正在围绕解释与编排成熟,而不只是再提供一个聊天界面。(来源)
- GitHub 的智能体叙事继续同时向本地测试和组织级控制扩展。 移动应用构建/测试工作流和 GitHub Agentic Workflows 幻灯片指向同一个目标:让更多执行、验证和上线推广环节留在受管理的智能体界面内。(来源)
- 自主性正在与支撑基础设施一同到来。 持续执行、可复用搜索层和受限范围的安全子智能体都表明,运行时间更长的智能体需要周围配套明确的服务,而不只是更好的基础模型。(来源)
- 记忆架构正在成为独立的产品类别。 “公司大脑”帖子让其中的权衡变得清晰:承诺记忆很容易,但新鲜度、修剪和审批边界,才决定系统能否持续有用。(来源)
- 构建者的热情正从软件交付扩展到相邻的生产系统。 OpenMontage 是当天最清晰的例子:它将编码助手技术栈重新用于构建一条可审计、可通过提示词驱动的视频制作流水线。(来源)