Twitter AI 编码 - 2026-08-29
1. 大家在讨论什么
1.1 GitHub Copilot 的关注点已从协作功能扩展到获客与培训入口(🡕)
当天 GitHub/Copilot 最大的信号,并不是基准测试或模型对比串帖,而是分发、上手引导和入口扩展的组合:面向学生的免费使用、GitHub 自己发布的 Copilot 更新串帖,以及把 Copilot 打包进面向 agent 的 Java 工作流教程内容。多条帖子共同印证了这一趋势,其中原始互动量最高的不是新的编码功能,而是学生礼包访问权限。
@alannnfx 表示(211 个赞,25 条回复,28,145 次浏览,361 次收藏)称,GitHub 正通过 Student Developer Pack 向学生提供两年 Copilot Pro 和 100+ 工具,配图截图也展示了具体礼包内容:Copilot Pro、免费域名和云额度。回复区关注的不是怀疑,而是实操问题——大家都在问如何激活 .edu 流程,这让整条帖子看起来更像一次分发动作,而不是常规产品宣传。(帖子链接)

@github 表示(174 个赞,14 条回复,55,459 次浏览,40 次收藏)表示,近期它已为 Copilot 发布了“5 个功能”,而回复链条补全了具体内容:共享 Slack 和 Teams 会话、Customize 标签页、更多已正式可用的模型,以及 Copilot CLI 中的 Sessions 侧边栏。公开的 Customize 标签页更新日志 进一步明确了这种打包方式:它把 MCP servers、plugins、skills 和 canvases 统一放进一个发现入口,而不是分散在不同文档和安装器里。(帖子串)
@github 展示了(24 个赞,3 条回复,3,696 次浏览)展示了 Copilot 在共享聊天线程中运行,截图显示,一个代码频道从对话中直接打开,生成的图表也返回到了同一个线程。这很重要,因为协作叙事已不再只是“编辑器里的 Copilot”,而是 agent 在团队现有沟通界面中完成共享工作,并留下可见产物。(帖子链接)

@code 表示(55 个赞,2 条回复,10,417 次浏览,16 次收藏)称,其最新的 VS Code Learn: Java 系列会带用户从 Spring Boot 应用一路走到 MCP 工具和 Playwright 测试,并让 Copilot 参与其中。尽管目标链接最终指向的是公开 YouTube 播放列表,但这条推文本身才是更重要的信号:GitHub 和 VS Code 正把面向 agent 的工作流当作一整套课程来教,而不只是零散地发布功能。(帖子链接)
讨论洞察: 当天 Copilot 最强的互动集中在覆盖范围和易用性上。Student Pack 相关回复都在问怎么拿到资格,而 GitHub 自己的发布帖则重点强调 Copilot 能在哪里用、如何定制,以及如何在团队聊天中保持可见。
与前一天对比: 在 2026-08-28,GitHub Copilot 已经呈现出协作控制平面的样子。到了 2026-08-29,这个故事进一步扩展到获客与培训:面向学生的免费入口、成体系的学习内容,以及更多把用户带入该工作流的使用入口。
1.2 构建者持续把 AI 编码纪律打包成可复用技能、工作流引擎和仓库策略文件(🡕)
最明显的构建者变化,是从“更好的提示词”转向可迁移的流程层。当天最有价值的三项内容,都在描述可复用的技能包、共享的仓库指令,以及可安装的工作流系统,这些都可以跨 Copilot、Claude Code、Cursor、Codex 和其他 agent 客户端使用。重点已经不是在单次会话里再榨出一个技巧,而是让良好行为能够反复复现。
@DivyanshT91162 表示(59 个赞,2 条回复,3,244 次浏览,69 次收藏)称,K-Dense 的 Scientific Agent Skills 为 agents 提供了 163 个即用型研究技能、100+ 科学数据库,并支持广泛的客户端兼容性。公开的 Scientific Agent Skills 仓库 进一步确认了其可迁移性定位:该套件围绕开放的 Agent Skills 和 Agent Plugins 标准构建,同时还链接了一个由同一技能库驱动、支持本地 BYOK 的桌面科学助手。(帖子链接)

@stretchcloud 认为(7 个赞,2 条回复,642 次浏览,8 次收藏)称,AGENTS.md 已成为 agents 的共享配置层,该格式如今由 Agentic AI Foundation 托管,周边还形成了 SKILL.md、REVIEW.md 和 MEMORY.md 等相关 markdown 文件。公开的 AAIF 项目文档 以及同一生态中链接的 Linux Foundation 报道,让这一治理主张变得可核实;而这条推文真正独特的贡献,在于它给出了一个实用分类,说明如今哪些 markdown 文件正承载编码 agents 的策略、流程和记忆。(帖子链接)

@DanKornas 表示(8 个赞,2 条回复,435 次浏览,2 次收藏)称,Gem Team 的存在,是为了把 AI 编码变成一套结构化工程工作流,涵盖路由、规划、实现、验证、学习以及模型层级选择。公开的 Gem Team 仓库 也印证了这一点:它包含一套 route-plan-build-verify-learn 循环、基于风险的质量闸门,以及可部署到 Copilot、Claude、Cursor、Codex、Gemini、OpenCode 和 Windsurf 的 APM 安装方式。(帖子链接)
讨论洞察: 这些帖子竞争的并不是模型原始性能,而是结构:可复用技能、仓库级规则、模型路由,以及能跨工具和会话延续下来的验证闸门。
与前一天对比: 在 2026-08-28,构建者已经开始暴露 planner、evaluator 和循环结构。到 2026-08-29,这种倾向进一步被打包成标准和可安装的工作流套件,能够从一个 agent 客户端迁移到另一个。
1.3 可靠性工作持续下沉到配额、截断和浏览器落地校验(🡕)
证据最密集的可靠性帖子,讨论的都是 agent 撞上现实世界时会发生什么:配额池、过大的工具响应,以及理论上正确、但在真实 DOM 上失效的选择器。多条帖子共同支撑了这一主题,而最强的几条都用具体仪表、图示或测量结果替代了泛泛建议。
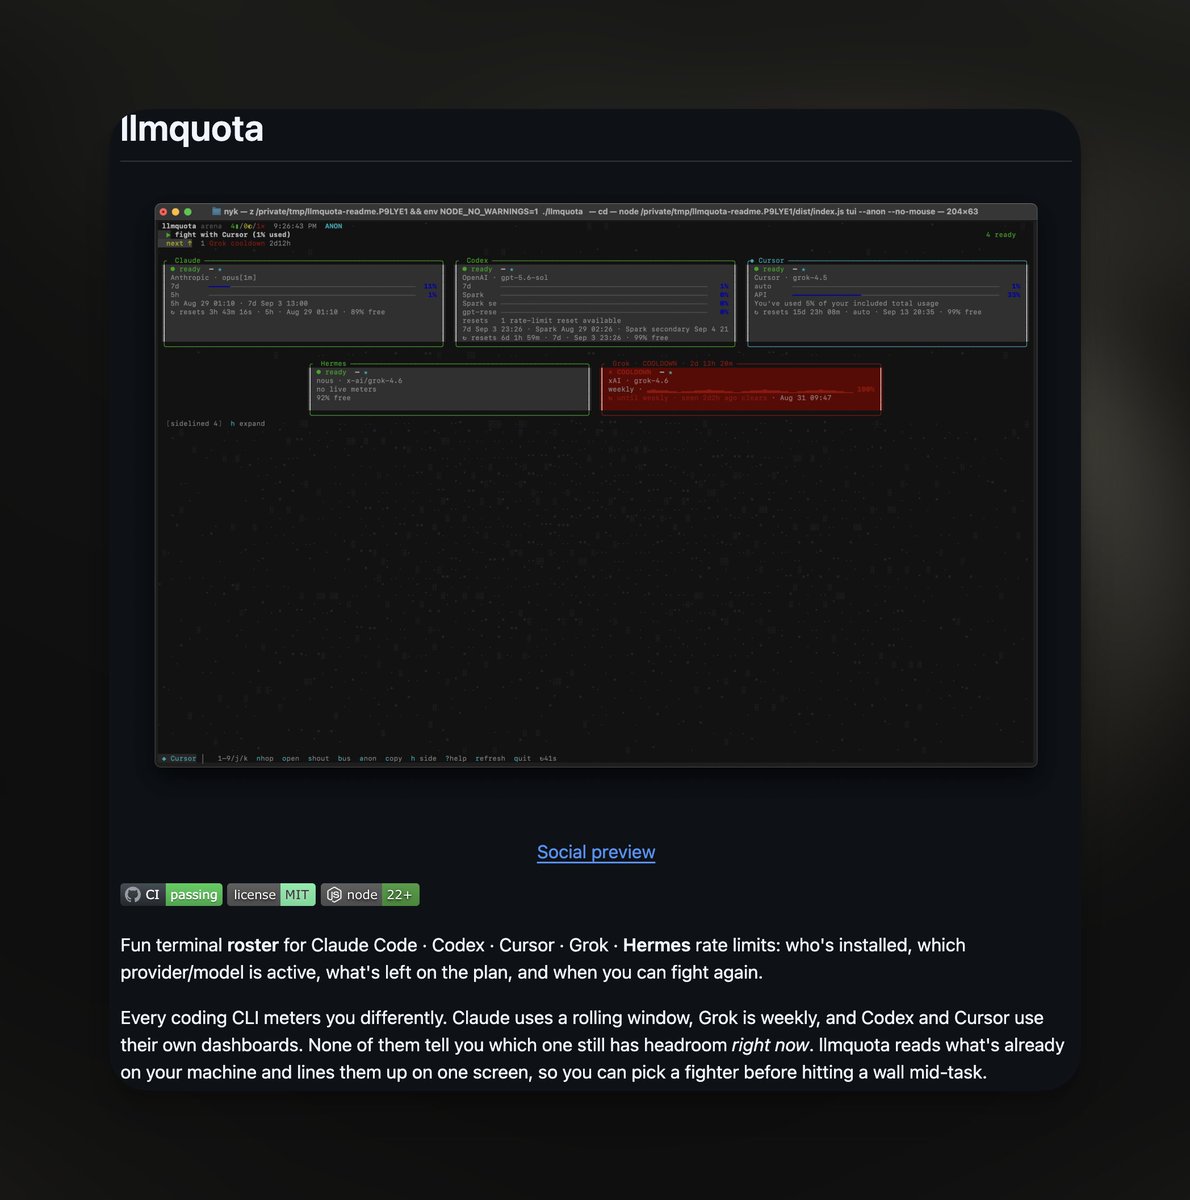
@nykdotdev 表示(16 个赞,1 条回复,811 次浏览,19 次收藏)称,同时运行多个编码 agent 会带来两个协同问题:哪个 agent 还有配额,以及其他会话已经在做什么。公开的 llmquota 仓库 详细展示了一个拟议答案:一个本地 arena,用于查看 Claude、Codex、Cursor、Grok 和 Hermes 的实时用量;再加上一个具备 repo 感知能力的总线,用于直接消息、任务交接和可恢复工作,且无需托管协调器。(帖子链接)
@shivam74689 报道称(13 个赞,7 条回复,356 次浏览,6 次收藏)展示了一个基于浏览器的价格提取工作流,它把规划、执行、提取和验证拆成不同层。真正发挥作用的是图示:一张图从目标一路铺陈到 PricingExtractor;另一张图则表明,即便一个针对 GitHub Copilot 定价页面的选择器在概念上是正确的,它依然会失败,因为预期元素在实际渲染后的 DOM 中并不存在,最终导致 30 秒超时。(帖子链接)


@simplifyinAI 表示(13 个赞,1 条回复,1,568 次浏览,7 次收藏)称,University of Luxembourg 的研究者发现,一旦工具响应被截断,编码 agents 实际上几乎从不请求第二页结果。arXiv 上链接的公开论文标题与截图一致,而对从业者来说,这条推文中量化后的总结才是关键信息:在生产遥测中,37% 的 get_epics 调用和 28% 的 get_merge_request_diffs 调用都超出了预算,但后续分页请求的观测次数仍然为零。(帖子链接)
讨论洞察: 这里的可靠性工作,重点不在于选择更好的前沿模型,而在于把控制力放到真正发生故障的地方:配额仪表盘、工具响应选择、DOM 验证、确定性提取和显式交接状态。
与前一天对比: 在 2026-08-28,人们还在逆向分析隐藏的路由和上下文行为。到了 2026-08-29,构建者则用本地计量器、公开故障图示,以及把截断视为正确性问题而不只是成本问题的研究作出回应。
1.4 提供商可移植性和配额结构仍处于关键路径上(🡒)
提供商层面的讨论依然强劲,但语气已从抽象争论转向具体运维细节:重置、专用池和合同条款。真正引发关注的内容,都明确说明了什么发生了变化,以及用户仍然有哪些地方看不清。
@DanDr1s 表示(62 个赞,5 条回复,2,967 次浏览,4 次收藏)称,OpenAI 已重置付费 Codex 和 ChatGPT Work 用户的使用量,并表示限制现在应该能多撑 10% 到 50%。其中引用的 @thsottiaux 的公开帖子之所以重要,是因为它点名了浪费来源:compaction、残留的 memory workers、失控目标、过于频繁的自动化、意外的 subagent 升级、重复的 computer-history summaries、滚动任务摘要,以及双重编码的 MCP 结果。(帖子链接)
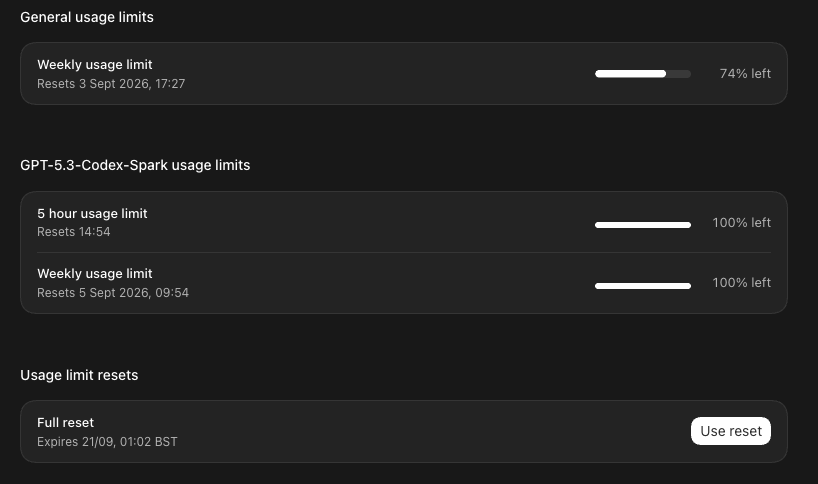
@LuminaBench 表示(20 个赞,1 条回复,1,179 次浏览,1 次收藏)称,OpenAI 应该提供一个专用的 Luna 池,而不是 Spark;这一诉求围绕的是价格和实用性,而非品牌忠诚。配图截图清楚展示了池结构:一个通用的周配额条、一个单独的 Codex Spark 配额,以及一个重置控件——这正是人们在公开场合争论的那类界面。(帖子链接)
@shashib 报道称(5 个赞,2 条回复,358 次浏览,1 次收藏)称,在 SpaceX 收购 Anysphere 后,OpenAI 提议于 11 月 12 日终止 Cursor 的直接模型访问;但帖文同时认为,该产品仍能继续发布,因为菜单中本就已有 Claude、Gemini 和 Grok,而 OpenAI 仅承载了约 5% 的 Cursor 流量。其独特视角不是愤怒,而是架构:如果模型供应商退出,编码产品能否存活,取决于多提供商路由是否早已真实存在。(帖子链接)
讨论洞察: 这些帖子把配额和提供商都视为产品界面的一部分。用户不只是在问哪个模型最好;他们还在问任务会消耗哪个池、重置如何运作,以及当某个供应商退出后,一个编码工具还能保留多少可用能力。
与前一天对比: 前一天的核心已经是隐藏配置和经济性。今天的讨论延续了同一主题,但证据更硬:有明确命名的 bug 修复、可见的池边界,以及一个模型提供商关系的明确截止日期。
2. 什么让人沮丧
对多 agent 工作而言,配额状态依然过于不透明
这一项是高严重度,因为抱怨并不是泛泛的价格牢骚,而是活跃工作越来越难以路由和预测。@nykdotdev 表示(16 个赞,1 条回复,811 次浏览,19 次收藏)称,缺失的控制平面在于:既不知道哪个 CLI 还有余量,也不知道其他会话正在做什么,而公开的 llmquota 仓库 正是为了把这些视图拼接起来。@DanDr1s 表示(62 个赞,5 条回复,2,967 次浏览,4 次收藏)提到,OpenAI 不得不重置使用量并修复那些可能吞掉每周额度 15% 到 70% 的浪费来源;@LuminaBench 补充说(20 个赞,1 条回复,1,179 次浏览,1 次收藏)则是直接要求用更便宜的 Luna 池替代 Spark。人们现在的应对方式,是同时跟踪多个工具、等待重置,或自行搭建本地配额仪表盘。这个问题值得直接去做产品,因为它是运维层面的、反复出现的,而且已经催生出自己的一层工具生态。
Agents 在模型推理与真实工具或浏览器状态的边界上仍然频繁失效
这同样属于高严重度,而且证据异常具体。@shivam74689 展示了(13 个赞,7 条回复,356 次浏览,6 次收藏)表明,一个浏览器 agent 即便能推理到 a[href='/copilot/pricing'],仍然可能在 30 秒 Playwright 超时后失败,因为预期元素在真实 DOM 中并不存在。@simplifyinAI 表示(13 个赞,1 条回复,1,568 次浏览,7 次收藏)则显示,在 Luxembourg 研究中,生产环境编码 agents 在截断发生后从未请求第二页结果,哪怕 37% 的 get_epics 调用和 28% 的 get_merge_request_diffs 调用都超出了 token 预算。可见的应对策略,是在模型周围增加确定性提取、验证、排序和交接规则,而不是信任原始生成。这个问题值得直接去做产品,因为这些失败模式是可测量的,而且出现在正常工作流中,而非边缘案例。
低信号的 AI slop 和纯提示词工作流正在消耗审阅者注意力
这一项是中等严重度,但情绪很强。@0xbeans 表示(138 个赞,87 条回复,2,290 次浏览)表示,他们已经被“ai slop”私信淹没,附图显示还有 597 条其他消息请求待处理。@DanKornas 表示(8 个赞,2 条回复,435 次浏览,2 次收藏)认为,AI 编码需要的是流程,而不是“另一堆提示词”;@GohilHardy 认为(10 个赞,11 条回复,170 次浏览,1 次收藏)则称,vibe coding 尤其适合 web 和 app 工作,但并不适用于所有软件开发。这里的应对模式,是更严格的过滤和更明确的工作流闸门。这个方向值得以竞争性方式投入,因为痛点不只是技术失败,更是低信息量输出和失控迭代在浪费人的时间。
3. 人们希望存在什么
一个真正的配额与跨 agent 协同控制平面
最明确、最务实的需求,是有一个统一位置来查看跨工具的容量和会话状态。@nykdotdev 表示(16 个赞,1 条回复,811 次浏览,19 次收藏)认为,agents 应该知道哪里还剩容量、工作停在了哪里,并用 llmquota 中的 who、hop 和 bus handoff 示例来支撑这一点。这是现实需求,不是愿景型需求,因为这个问题只会在人们已经并行使用多个编码 agents 之后出现。机会:直接型。
面向仓库指令、可复用技能和可安装工作流包的共享标准
今天所有偏流程的帖子,实际上都在暗示同一个需求:需要一种可迁移方式,把策略和流程带到 Copilot、Claude Code、Cursor、Codex 以及相邻工具之间。@stretchcloud 表示(7 个赞,2 条回复,642 次浏览,8 次收藏)称,AGENTS.md 现在已位于更广泛的一组 markdown 控制文件之中;@DivyanshT91162 展示了(59 个赞,2 条回复,3,244 次浏览,69 次收藏)则提到,一个可跨多个 agent 客户端运行的研究技能库;公开的 Gem Team 仓库 还把 route-plan-build-verify-learn 打包成可复用安装项。这个需求之所以务实,是因为人们手里已经有部分答案,但整个生态仍在靠手工把它们缝起来。机会:竞争型。
能在行动前证明自己已完成落地校验的浏览器与工具链路
浏览器提取和分页相关帖子都指向同一种缺失能力:agents 需要更好的方式,在继续执行之前验证自己使用的页面、选择器或首段内容是否正确。@shivam74689 展示了(13 个赞,7 条回复,356 次浏览,6 次收藏)指出了概念正确性与真实 DOM 落地之间的落差;@simplifyinAI 报道称(13 个赞,1 条回复,1,568 次浏览,7 次收藏)则显示,在 Luxembourg 研究中,生产 agents 实际上从未为缺失的第二段内容进行分页请求。这是一个紧迫且务实的需求,因为两类失败都发生在日常任务执行中,而不是只出现在高级研究 demo 里。机会:直接型。
为无法长期使用高级计划的人提供更便宜、更清晰的访问池
当天最强的访问相关信号来自两个方向。@LuminaBench 表示(20 个赞,1 条回复,1,179 次浏览,1 次收藏)称,OpenAI 应该开放一个专门的 Luna 池而不是 Spark,这种表述本身就是对更便宜、更易理解配额结构的明确愿望。与此同时,@alannnfx 表示(211 个赞,25 条回复,28,145 次浏览,361 次收藏)提到,Student Developer Pack 这一路径可解锁两年 Copilot Pro,而公开的 Student Offers 目录 说明其中包含 589+ 个已验证优惠和 83 个开发工具。两者结合表明,这个需求既现实也紧迫:人们正在积极追逐特殊配额池、额度和资格路径,以获得可用的 AI 编码访问权限。机会:直接型。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot 应用和共享聊天集成 | Agent 工作空间 / 协作界面 | (+) | 在应用和 CLI 界面间提供 Slack/Teams 共享会话、模型可用性、定制能力和会话管理 | 价值取决于计划访问权限、预算、审批流程,以及团队启用了哪些集成 |
| Scientific Agent Skills | 技能库 / 领域工作流包 | (+) | 163 个研究技能、100+ 数据库,并通过 Agent Skills 和 Agent Plugins 标准实现可移植性 | 最适合专门的科学工作;相比简单编码助手,配置和范围都更重 |
| Gem Team | 工作流编排包 | (+) | route-plan-build-verify-learn 循环、基于风险的质量闸门,以及跨多个编码客户端的模型层级路由 | 会增加流程和安装开销;最适合希望采用纪律化工作流、而非临时聊天的团队 |
| llmquota | 配额路由器 / 本地控制平面 | (+) | 统一多个编码 CLI 的实时余量,并在无托管协调器的情况下加入具备 repo 感知能力的交接消息 | 解决的是可观测性和协同,不是底层提供商限制或定价问题 |
| Playwright + deterministic extractor + Pydantic | 浏览器 agent 方法 | (+) | 将浏览、提取和验证分离;能在最终输出前捕获计划名称和 schema 错误 | 当真实 DOM 与模型的概念选择器不匹配时,仍然脆弱 |
| AGENTS.md | 仓库指令标准 | (+/-) | 为 agents 提供共享的 markdown 控制层,用于 repo 规则、流程、评审标准和记忆约定 | 生态约定仍在形成中,存在多个相邻文件和不同作用域模式 |
| Codex / ChatGPT Work | 托管式编码 agent 服务 | (+/-) | 采用度足够高,以至于 OpenAI 正公开发布详细的使用修复说明和重置行为 | 池结构、隐藏浪费和重置语义仍然制造混乱与挫败感 |
| Cursor 的多模型栈 | 多提供商编码界面 | (+/-) | 可在 Claude、Gemini、Grok 和 OpenAI 之间持续运行,而不是依赖单一供应商 | 合同变更仍可能一夜之间移除某条模型路径,暴露平台依赖 |
当工具能把流程或状态表达得更明确时,满意度最高。@DivyanshT91162 提到了(59 个赞,2 条回复,3,244 次浏览,69 次收藏)把 Scientific Agent Skills 带入讨论,作为一层可移植技能;@DanKornas 将其定义为(8 个赞,2 条回复,435 次浏览,2 次收藏)把 Gem Team 作为可重复的工程循环;@nykdotdev 展示了(16 个赞,1 条回复,811 次浏览,19 次收藏)则把 llmquota 作为容量与交接的本地控制平面。
当系统状态仍然隐藏或脆弱时,满意度就会下降。@DanDr1s 总结称(62 个赞,5 条回复,2,967 次浏览,4 次收藏)提到 Codex 和 ChatGPT Work 内部的使用浪费,@shivam74689 记录了(13 个赞,7 条回复,356 次浏览,6 次收藏)提到浏览器自动化中的真实 DOM 选择器失效,而 @shashib 使用了(5 个赞,2 条回复,358 次浏览,1 次收藏)则用 Cursor/OpenAI 的分裂来强调多提供商路由为何重要。因此,可见的迁移趋势是:从单一界面的助手,转向结合配额、技能、工作流包、仓库策略文件和提供商冗余的跨工具栈。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GitHub Copilot Customize 标签页 | @github | 在 Copilot 应用内集中发现和安装 MCP servers、plugins、skills 和 canvases | Copilot 的定制入口原本分散在不同文档和安装路径中,导致工具发现更困难 | GitHub Copilot 应用、MCP、plugins、skills、canvases | 已发布 | 推文, 更新日志 |
| 共享聊天线程中的 GitHub Copilot | @github | 让团队能直接从 Slack 和 Teams 对话中发起并审阅 agent 工作 | 团队希望 agent 工作、diff 和输出能留在原本就进行协同的地方可见 | GitHub Copilot、Slack、Teams、共享 agent 会话 | Beta | 推文, 帖子串 |
| Scientific Agent Skills | K-Dense / @DivyanshT91162 | 通过 163 个技能、100+ 数据库和科学集成,把通用 agent 变成研究助手 | 通用编码 agents 缺少面向研究密集型科学任务的显式工作流 | Agent Skills 标准、Agent Plugins、Python scientific packages、K-Dense BYOK | Beta | 推文, 仓库 |
| llmquota | @nykdotdev | 增加一个用于配额路由的本地 TUI,并提供跨编码 CLI 的 repo-aware 消息与交接 | 当用户既看不到剩余容量,也无法协调未完成会话时,多 agent 工作就会失效 | Node 22+、本地 CLI 状态、repo-aware bus、多 CLI 配额探针 | Beta | 推文, 仓库 |
| 基于浏览器的价格提取工作流 | @shivam74689 | 规划浏览器任务,通过 Playwright 执行,提取结构化价格数据,并验证结果 | 仅靠 LLM 的浏览器自动化对于可靠的结构化提取来说过于脆弱 | Planner、PlanRunner、BrowserAgent、Playwright、deterministic extractor、Pydantic | Alpha | 推文 |
| Gem Team | @DanKornas | 安装一套跨工具工作流,完成路由、规划、构建、验证与学习,并采用基于风险的质量闸门 | 一次性提示词会导致质量不稳定、token 浪费,也无法形成持久工程流程 | APM、模型路由、orchestrator/specialist agents、适配 Copilot/Claude/Cursor/Codex/Gemini/OpenCode/Windsurf 的 harness 安装 | Beta | 推文, 仓库 |
当天最强的构建模式,是把流程打包成产品。GitHub 把协作和定制打包进 Copilot 的各个界面;K-Dense 把研究工作流打包成可移植技能;llmquota 把配额可见性和交接消息打包进一个本地终端;Gem Team 则把工作流纪律打包成可安装的跨工具系统。
共同触发因素是隐藏状态。llmquota 的存在,是因为容量和会话上下文是碎片化的;浏览器价格工作流的出现,是因为选择器和提取会在运行时失败;Gem Team 的存在,则是因为临时式提示词无法保留质量闸门或学习过程。因此,多位构建者收敛到同一结构:显式分层、共享规则、可复用流程和可见检查点。
6. 新鲜且值得关注的内容
OpenAI 公开解释 Codex 和 Work 使用浪费的细节,远比以往更充分
@DanDr1s 表示(62 个赞,5 条回复,2,967 次浏览,4 次收藏)称,OpenAI 已为付费 Codex 和 ChatGPT Work 用户重置使用量,且限制应能多持续 10% 到 50%。其中引用的 @thsottiaux 公开更新之所以重要,在于它公开点名了具体浪费来源:compaction bugs、后台 memory workers、失控目标、过于频繁的自动化、意外的 subagent 升级、重复的 computer-history summaries、滚动任务摘要,以及 MCP 编码问题。这一点之所以值得关注,是因为关于使用量的抱怨,已经从模糊的不满转变为一次明确的工程复盘。(来源)
AGENTS.md 正越来越像共享 agent 基础设施,而不只是个人习惯
@stretchcloud 认为(7 个赞,2 条回复,642 次浏览,8 次收藏)称,AGENTS.md 现在已成为更广泛 markdown 栈中的全局规则层,围绕它的是技能、记忆、评审标准和作用域规则。公开的 AAIF 文档 以及该生态关联的 Linux Foundation 报道,使其托管主张可以被验证。这一点之所以值得关注,是因为仓库 markdown 正越来越被当作 agent 的运行时配置,而不再只是给人看的文档。(来源)
提供商冗余成为编码产品在供应商分手后仍能生存的现实理由
@shashib 报道称(5 个赞,2 条回复,358 次浏览,1 次收藏)称,在 SpaceX 收购之后,OpenAI 计划于 11 月 12 日终止对 Cursor 的直接模型访问;随后又借助该产品现有的 Claude、Gemini 和 Grok 支持,论证 Cursor 仍可继续发布。这一点之所以值得关注,是因为它把“多模型支持”从营销卖点转化成了一个具备真实截止日期和真实合同触发条件的韧性故事。(来源)
Luxembourg 分页论文把无声的工具截断变成了一种被命名的编码 agent 失败模式
@simplifyinAI 表示(13 个赞,1 条回复,1,568 次浏览,7 次收藏)称,在底层遥测研究中,生产环境编码 agents 在响应被截断后从未请求第二页结果。arXiv 上的公开论文标题确认了这一结果空间,而推文中的具体数字也让从业者很容易理解其影响。这一点之所以值得关注,是因为它给构建者提供了一个比“上下文限制很烦人”更清晰的目标:首段内容实际上决定了 agent 能看到什么。(来源)
7. 机会在哪里
**+++] 统一的多代理控制平面** — llmquota、关于 OpenAI 重置的帖子串,以及对 Luna-pool 的请求,都指向同一个缺口:人们需要一个统一的位置,用来查看多个编程代理的剩余额度空间、池边界、重置时间以及会话交接。这一方向很强,因为这种挫败感发生在运营层面,而且已经严重到促使开发者自行构建本地协调层。([来源, 1, 2)
**+++] 面向 AI 编程的可移植流程包** — Scientific Agent Skills、AGENTS.md 和 Gem Team 都将可重复执行的流程视为真正的产品。这个机会很强,因为多个独立开发者正在收敛到同一组基础要素:技能、仓库规则、工作流深度、验证关卡以及跨工具安装。([来源, 1, 2)
**+++] 面向浏览器和超大工具输出的锚定执行层** — 浏览器定价工作流和 Luxembourg 分页结果都表明,当代理无法证明自己正在操作哪个页面元素或工具片段时,依然会出错。这一方向很强,因为这些失败模式具体、反复出现,并且与日常任务执行直接相关。([来源, 1)
**++] 可跨供应商迁移的编程产品** — Cursor/OpenAI 的分裂说明了在合同变化后,多模型支持为何重要;而 GitHub 的 Copilot 帖子串则展示了另一种竞争策略:在单一产品内扩展可用模型和交互界面。这是一个中等机会,因为有些平台已经具备冗余能力,但对供应商的依赖仍然是一个明显风险。([来源, 1)
**++] 面向成本敏感用户的官方访问与引导漏斗** — Student Developer Pack 帖子、Student Offers 目录以及 VS Code Learn Java 系列都因通过免费访问、捆绑方案或引导式工作流来降低入门门槛而受到关注。这个机会属于中等,因为需求非常明显,但当下大量流量仍然通过资格漏洞、仅限学生的路径或第三方目录导流,而不是通用的入门方案。([来源, 1, 2)
8. 要点
- Copilot 的关注点已扩展到分发与上手,而不只是产品能力。 最强的 Copilot 互动集中在学生访问权限,而 GitHub 和 VS Code 则在推动共享聊天工作流、定制能力和教程式打包。(来源)
- 可复用流程,而不是一次性提示词,成为当天构建者最主要的本能。 Scientific Agent Skills、AGENTS.md 和 Gem Team 都把技能、规则和验证视为围绕模型构建的可移植基础设施。(来源)
- 可靠性工作聚焦于真实执行边界:配额池、被截断的工具输出和浏览器落地校验。 llmquota、Luxembourg 的分页研究结果,以及浏览器价格工作流,都暴露了模型开始行动之后才会发生的失败。(来源)
- 配额策略和供应商依赖仍是 AI 编码体验中可见的一部分。 OpenAI 的重置与修复帖子、Luna 池请求,以及 Cursor 截止事件,都说明提供商配置仍在塑造日常可用性。(来源)
- 整个生态继续收敛到显式控制平面。 无论是 Copilot 的应用、llmquota 的终端 arena,还是仓库中的 AGENTS.md,共同趋势都是让状态、策略和交接比原始提示词更可见。(来源)