Twitter AI 编程 - 2026-09-02
1. 人们在讨论什么
1.1 Antigravity 的讨论重心已从整体势头转向 Gemini 3.8 的具体上线信号(🡕)
Twitter 上最强的一组讨论,已经不再是对 Google 编程技术栈的泛泛称赞,而是围绕 Gemini 3.8 Flash 发布当天,Antigravity 内部究竟发生了哪些变化展开的具体取证:模型选择器里少了哪些模型、二进制文件中出现了哪些额外模型的引用、用户一线感受到的限制是否变松,以及 Google 官方发布的定价与可用性说明。至少有四条彼此独立的信息支撑了这一主题。
@thtbee_ 报道(109 个赞、11 条回复、7,983 次浏览、5 次收藏)称,Gemini 3.5 Flash 已从 Antigravity 的模型选择器中消失,并将此视为 Gemini 3.8 Flash 上线的信号。回复很快把讨论从基准测试转向产品成熟度:一名用户表示不会怀念 3.5,另一名用户则立刻要求更强的 Pro 档位。

@mrfanduu 报道(389 个赞、31 条回复、21,629 次浏览、31 次收藏、8 次引用)称,在 antigravity-cli 1.1.24 中发现了 glm-5.2-fp8 的引用。这张图之所以重要,是因为它通过二进制审计,把传闻落实到了具体界面、提供方和显示名称上;而回复则立刻转向争论 Google 究竟该上线 GLM 5.2 还是 5.3。

@SalenoXP 表示(302 个赞、35 条回复、17,219 次浏览、26 次收藏、3 次引用)称,Antigravity 的使用体验突然像是“被加强了”,以至于要么是 Google 提高了限制,要么是 Gemini 3.8 Flash 相比此前承担类似负载的模型,效率明显更高。这是当天最清晰的实践者帖子之一,因为它不是用基准分数,而是用配额表现来评估产品。
@Google 宣布(58 个赞、4 条回复、12,907 次浏览)称,Gemini 3.8 Flash 当天已在 Antigravity、Google AI Studio、Android Studio、Gemini Enterprise、Google AI Pro 和 Ultra、搜索中的 AI Mode,以及 Google Sheets 中的 Gemini 上线;首发价格为每 1M tokens 输入 $0.75、输出 $3.75。
讨论洞察: 用户已经开始像过去看发布说明那样,去解读模型选择器、二进制文件和配额变化。回复显示,上线当天的情绪不只是“Google 回来了”,而是“哪个界面变了、哪个层级缺了、这又暗示着下一步会发布什么?”
与前一天对比: 2026-09-01,Antigravity 相关讨论主要集中在 /boost、3.7 Flash 的展示案例,以及有关研究级结果的公开说法。到了 2026-09-02,这股热度转向了围绕 Gemini 3.8 Flash 及其周边模型界面的具体上线追踪。
1.2 GitHub Copilot 成了模型发布与真实世界评估相交汇的分发层(🡕)
GitHub Copilot 出现的方式,与其说是一个编程助手品牌,不如说更像是模型切换、推理成本控制和长时运行智能体能力的承载层。至少有五条高信号信息支撑这一点:GitHub 推出 Claude Fable 5.1、Copilot 内部产品界面的确认、一次公开的单提示游戏演示、SOMA 在 Copilot 上的压缩层,以及围绕可审查性与治理展开的回复串。
@github 宣布(153 个赞、23 条回复、21,087 次浏览、14 次收藏、3 次引用)称,Claude Fable 5.1 已在 GitHub Copilot 中正式可用,可用于长时间运行的编程任务、深度代码库研究和复杂的智能体工作流。回复补充了关键的企业级限制:与 Copilot 中其他 Claude 模型不同,Fable 5.1 默认要求为 Anthropic 的安全分类器保留数据;只有符合条件的企业客户,才能在限时例外政策下使用零保留模式。另有一条来自 @enhansai 的回复指出,长时任务与短任务的失败方式不同,因为它可能在“往前三步、往后错三步”的情况下,最终结果仍然能编译。
@code 呼应(157 个赞、13 条回复、18,603 次浏览、13 次收藏)从产品账号确认了这次发布,截图显示 Fable 5.1 已可在 Copilot Agent 模式中选择。最有价值的回复不是欢呼,而是在追问:模型能否从错误路径中恢复、能否避免凭空捏造辅助文件、以及在真实代码库中是否仍具备可审查性。
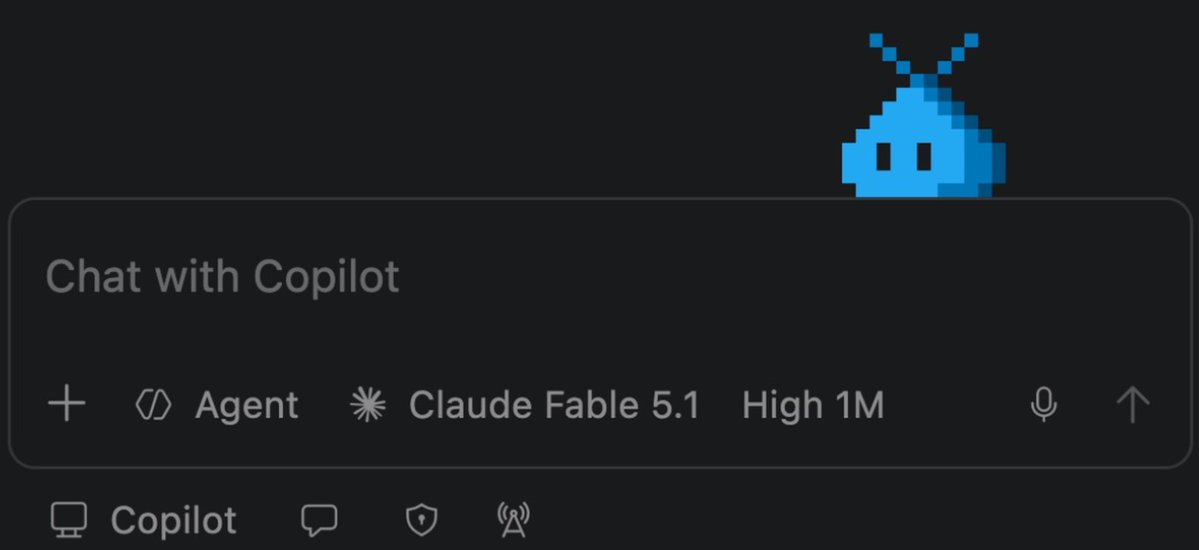
@burkeholland 发布(67 个赞、17 条回复、5,169 次浏览、26 次收藏)展示了一个在线浏览器游戏:他只给 Copilot 一个提示,让它构建一款第一人称多人游戏,内容是一只小鸟在乡间探索。之后他补充说,首次生成后自己加了一些小细节,但镜头控制、环境、天气、建筑、生物和交互性,基本都来自那次单次生成;他还把结果发布到了 fledglinggame.com,同时提醒说它部署在最便宜的托管档位上,未做过负载测试。
@LisaFlorentina8 总结(11 个赞、12 条回复、395 次浏览)介绍了 SOMA for GitHub Copilot:在上下文送入模型前压缩重复的智能体上下文后,DeepSeek V4 Pro 会话可节省约 10% 的 token;早期访问阶段提供 $5 额度,且不收平台费。这里重要的不是价格,而是架构定位:SOMA 被定位为智能体与模型之间的一层,而不是模型替代品。

讨论洞察: 社区反应已经超越了“新品上线”的新鲜感。Copilot 相关讨论反复回到治理门槛、默认数据保留、错误路径恢复能力,以及节省层或更强模型是否真的足以改善日常体验、从而值得信任。
与前一天对比: 2026-09-01,Copilot 更多被视为现代化和代码审查界面。到了 2026-09-02,它更像是一个企业级分发层:新模型与新基础设施都在这里接受实战检验。
1.3 规范、技能和市场正在取代自由式提示,成为新的控制层(🡕)
应对 AI 编程“水活”的办法,依然不是“换个更聪明的模型”,而是“增加结构、封装判断,并把它分发出去”。有四条信息尤其清楚地说明了这一点:围绕 Spec Kit 的规范优先工作流主张、一张庞大的智能体商店与注册表地图、Obsidian vault 技能,以及市场中的记忆插件。
@txbrraa 认为(56 个赞、18 条回复、790 次浏览、11 次收藏)称,GitHub 的 Spec Kit 通过强制先写规范、再做实现,解决了 vibe coding 最大的问题。链接中的 仓库 描述了一套可复用流程,围绕 /speckit-constitution、/speckit-specify、/speckit-plan、/speckit-tasks、/speckit-implement 和 /speckit-converge 展开;最有分量的回复指出,真正的考验不在于最初演示有多整洁,而在于经历第三次变更请求后,规范是否仍与代码保持一致。
@illyism 声称(14 个赞、7 条回复、4,413 次浏览、79 次收藏)称,“传统 SEO 已死”,因为 AI 智能体、插件和技能如今需要在第一方商店、权威注册表、托管 MCP 目录和社区目录中分发。该讨论串点名了 ChatGPT apps 和 GPTs、Claude Marketplace、Claude Code catalogs、Cursor Marketplace、GitHub Copilot plugins、官方 MCP Registry、Smithery、Glama、PulseMCP,以及 Vercel marketplace 等入口,这让“发现”本身看起来像是一个新的品类问题。
@RoundtableSpace 强调(37 个赞、12 条回复、24,962 次浏览、4 次收藏)介绍了 obsidian-skills:一组跨工具技能,让 Claude Code、Codex 和 OpenCode 能读取、写入、整理并控制 Obsidian vault。截图之所以有用,是因为它展示了 marketplace 命令、npx skills,以及本地 Claude/Codex/OpenCode 目录中的实际安装路径;回复则分成两派:一派对记忆持久化感到兴奋,另一派担心笔记级提示注入。

@DhravyaShah 宣布(11 个赞、3 条回复、837 次浏览)称,supermemory 已上线 Cursor marketplace,并可接入 Cursor、Claude Code、Codex、Amp、Google Antigravity、Grok Bot、Grok Build、Pi、Hermes 和 OpenCode。这也让当天的叙事从静态技能,进一步扩展到可移植的记忆层与 MCP 风格插件。

讨论洞察: 这一讨论集群中的回复明显更偏操作层面。人们不再问如何写出更好的提示,而是在问:封装后的规则如何跨会话持续生效、应该在哪里分发、以及如何避免本地知识库变成新的攻击面。
与前一天对比: 2026-09-01,可复用规则和技能已经是一个活跃主题。到了 2026-09-02,重心进一步从“写更好的规则”转向“把它们封装起来、列出来,并让它们能跨工具携带”。
1.4 本地优先与编排层持续包裹既有智能体,而非取而代之(🡕)
另一个相关主题,是一批基础设施在保留熟悉智能体工作流的同时,替换底层后端、搜索层或控制平面。四条内容尤为突出:让现有智能体接到本地模型上的 Unsloth、位于 vLLM 前方的服务端编排层 Agentic API、本地优先检索工具 zg,以及用于并行 worktree 编排的 Orca。
@starmexxx 表示(24 个赞、12 条回复、1,026 次浏览、13 次收藏)称,Unsloth 让付费订阅变得“可选”,因为用户可以在本地运行开源模型,并将其挂到 Claude Code、Codex 和 OpenCode 背后。链接中的 仓库 确认其支持本地 GGUF 和 MLX 模型、兼容 OpenAI 和 Anthropic 的 API,以及 unsloth start claude 和 unsloth start codex 等直接命令。
@techNmak 描述(14 个赞、1 条回复、734 次浏览、14 次收藏)介绍了 Agentic API:它位于 vLLM 前方,作为有状态层负责对话状态、工具调用循环、续跑、持久化,以及兼容 OpenAI 的 Responses 行为。仓库 把它的定位说得很明确:客户端只发起一次调用,而网关负责状态注入、服务端工具、流式传输与续跑。

@QwenDevs 分享(11 个赞、2 条回复、415 次浏览、6 次收藏)介绍了 zg:一款本地优先的搜索工具,在同一界面中结合语义搜索、BM25、混合检索和 rg,供开发者和智能体共同使用。该仓库将其定位为减少大范围扫描、重复工具调用和上下文膨胀的方法。
@DanKornas 提到(2 个赞、3 条回复、402 次浏览)介绍了 Orca:一个编排环境,可让 Codex、Claude Code、OpenCode 或 Pi 在各自独立的 worktree 中并行运行,在一个工作区里统一跟踪,并配有用于通知和后续处理的移动端伴随应用。回复串进一步点明了核心价值主张:只要每个智能体各有一条独立的 git 轨道,并行智能体就能被有效管理。
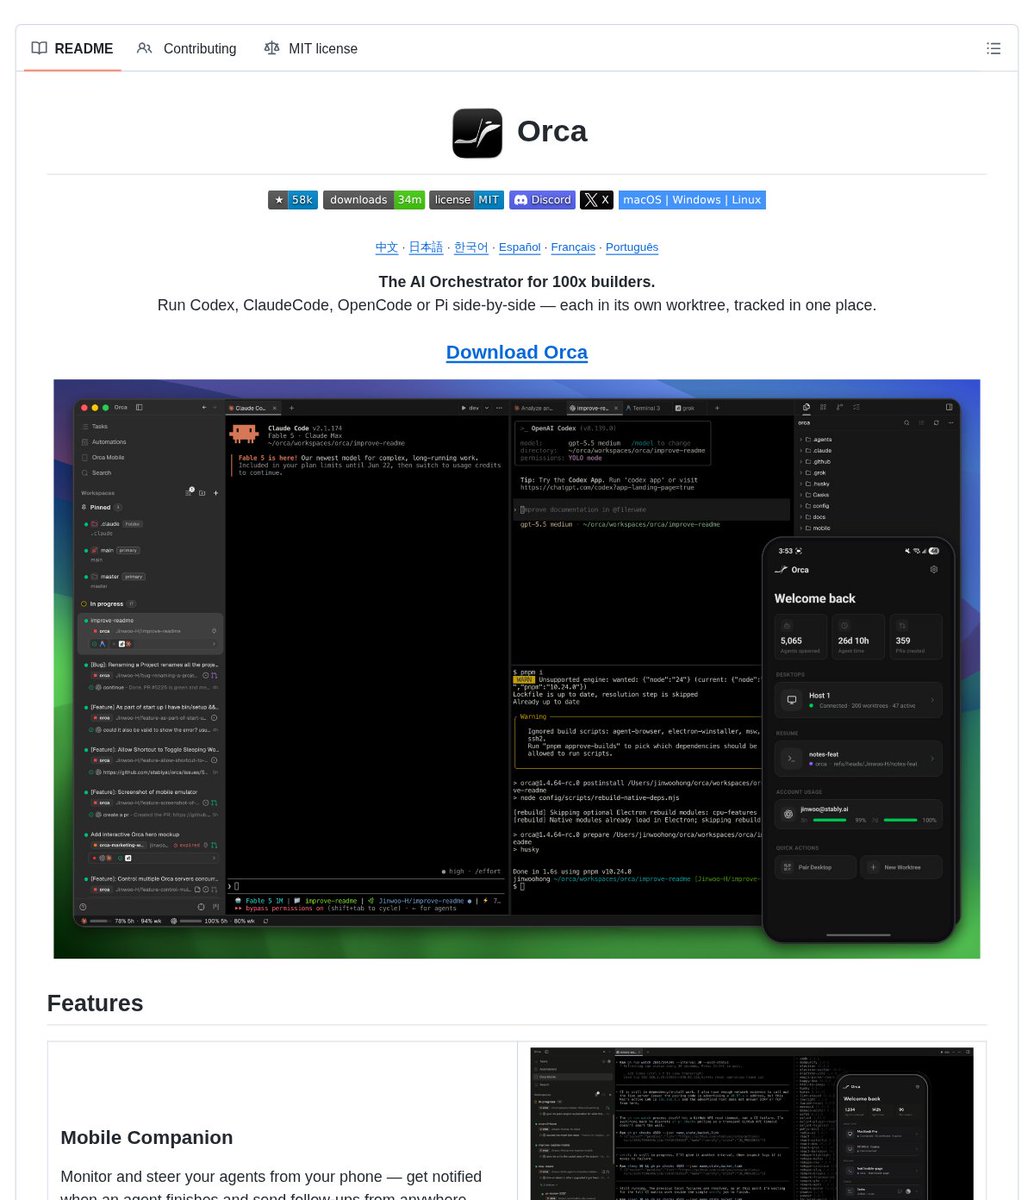
讨论洞察: 这一集群反复出现的承诺是“连续性”。用户希望保留自己已经熟悉的工具和习惯,同时在底层改变成本、隐私、状态管理、检索质量或并行能力。
与前一天对比: 2026-09-01,围绕成本控制的讨论主要集中在压缩和本地 API 之类的变通方案。到了 2026-09-02,这层“变通层”看起来更产品化了:搜索、编排、有状态网关和本地运行时,都开始拥有各自清晰的产品叙事。
2. 什么让人沮丧
即便推理看起来很强,长时运行智能体仍会在执行和审查上出问题
最尖锐的挫败感在于,强模型的发布仍然无法解决长时任务在实际运转中的混乱。在 Fable 5.1 的发布讨论串中,@enhansai 回复 称,长任务可能在最终输出依然能编译的情况下,“三步之前就已经走错了”;而 @phicerhq 补充 则指出,团队真正会据此评判的,是错误路径恢复、上下文保持、可审查性和可靠性。@SnorkelAI 补充 还给出了更具体的基准说法:在 Terminal-Bench+ 中,Fable 5.1 的错误主要集中在终止、工具使用和输出格式,而不是推理本身,尽管它每次成功运行所用 token 少了 58%。严重程度:高。这值得投入建设,因为人们需要的是更好的执行轨迹、更好的恢复节点,以及更清晰的审查产物,而不只是更好的文字表达。
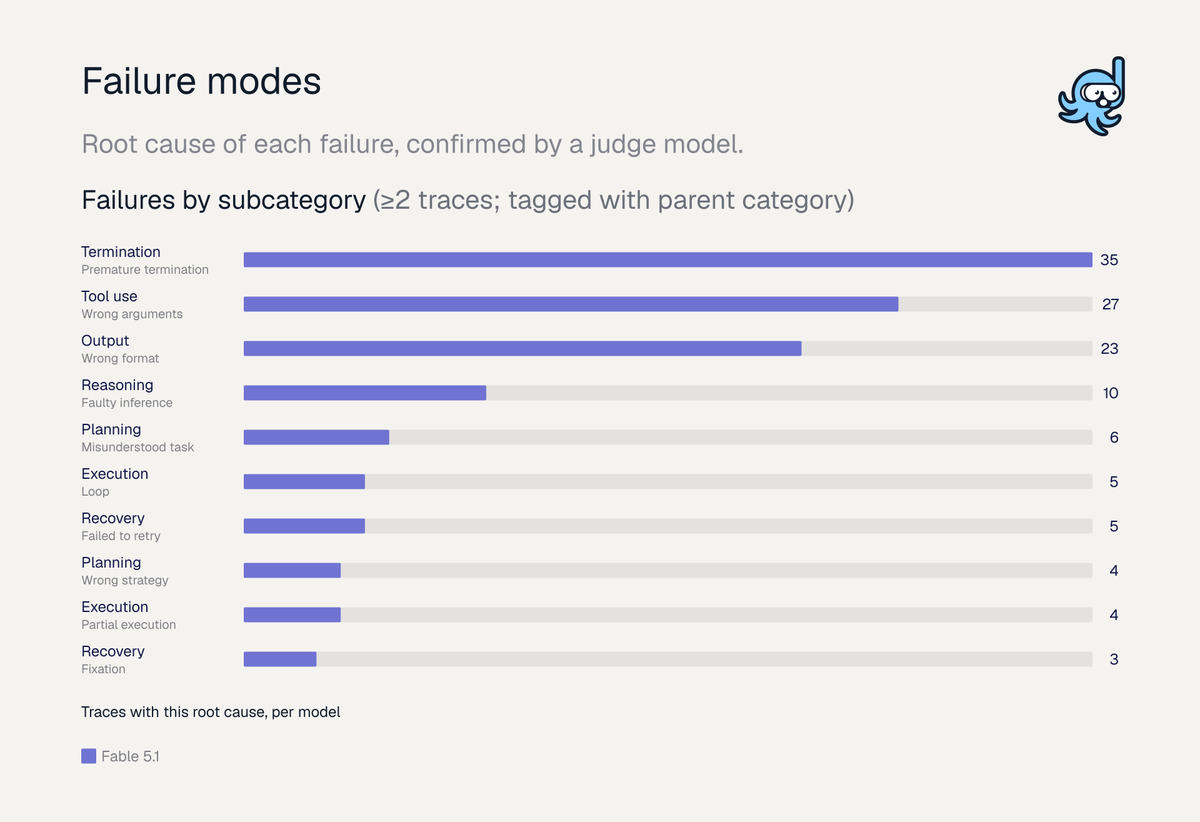
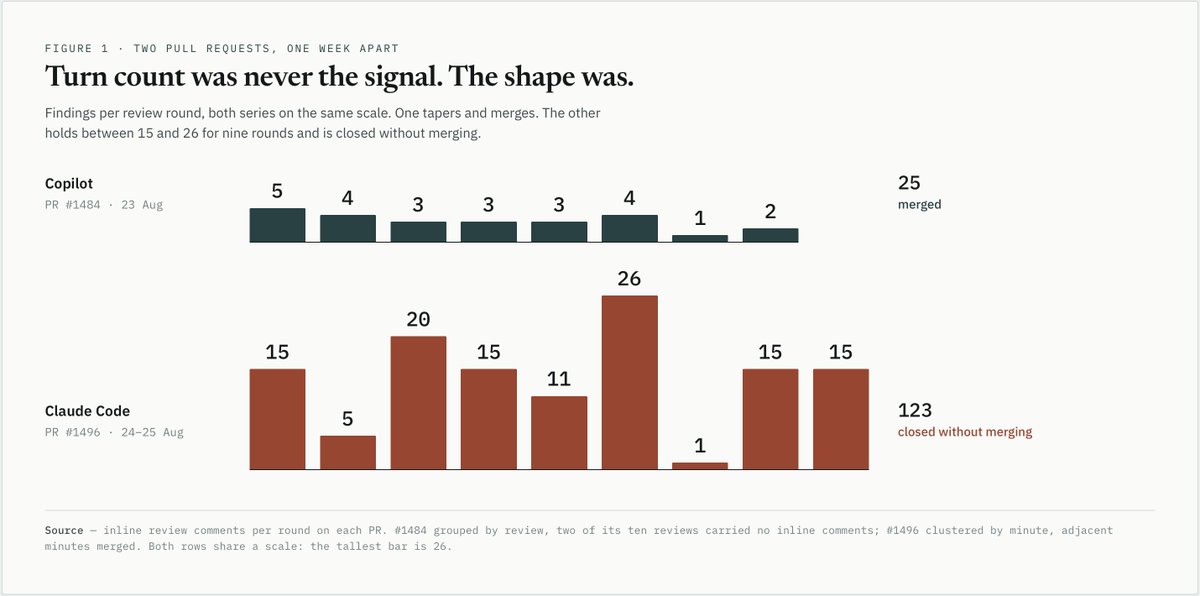
@kimburgaard 描述 则在 PR 审查里给出了同一问题的第一手版本。他说,Copilot 对某个 PR 的审查发现数从 5、4、3、3、3、4、1、2 逐步下降并最终合并;而 Claude Code 对一个缓存 token 计费 PR 的审查尝试跑了九轮,仍然产出 123 条行内发现,最后他直接关闭而未合并。他的应对方式不是放弃 AI 审查,而是构建公开的审查分流技能:除非推测性或潜在问题指向高风险的生产损害,否则就压低这类发现。

这批数据中最好的应对模式,是坚持要求明确证据。@rseroter 指出 指向了一段 Antigravity Teamwork 演示,其截图显示 758 项测试通过、247 项 E2E 测试通过、类型检查通过、生产构建通过,之后才宣布任务完成。这正是那些较弱的上线日说法里所缺少的证据。
隐性路由、配额表现和成本控制层正在扭曲产品评估
人们显然对此感到沮丧:他们往往不是通过清晰的更新日志,而是通过限制变化、模型消失或压缩提示条幅,才知道产品到底变了什么。@SalenoXP 表示 称 Antigravity 突然显得更“大方”了;@thtbee_ 追踪 提到了模型选择器中的移除;@mrfanduu 追踪 则提到了隐藏在二进制中的引用。在 Copilot 这边,@LisaFlorentina8 将其表述为 将 SOMA 描述为一种在不改变可见工作流的前提下收回约 10% token 成本的方法;而 @github 不得不解释 则在回复中指出,Fable 5.1 在 Copilot 中还带有默认数据保留。严重程度:中高。这看起来值得投入建设,因为用户需要透明的配额核算、可见的模型路由,以及可检查的成本控制机制。
这种挫败感在用户试图从营销话术转向实际使用时表现得最明显。@SimonasLTU1 表示 称,通过 OpenRouter 试用 Fable 5.1 很快就烧光了一小笔余额,截图还记录了额度耗尽时的具体错误弹窗。@starmexxx 回答 则给出了一个本地优先的替代方案:前端仍使用 Claude Code 或 Codex,但通过 Unsloth 把它们接到自己机器上的开源模型。
移动端与后续跟进界面在真实编程工作流中仍然容易失灵
当天最薄弱的部分,不是桌面端智能体的能力,而是用户离开主工作站之后会发生什么。@heitor_lessa 表示 称,ChatGPT Work 加上移动端 Codex 的变通方案仍显得很不成熟,以至于他可能下个月就会取消订阅;截图也说明了原因:在处理与 PR 相关的工作流时,流式输出被打断,并出现未知错误。严重程度:中。这值得投入建设,因为长时运行的智能体工作流越来越需要在手机上完成升级处理、后续跟进和审查,而当前界面恰恰在这些交接时刻掉链子。
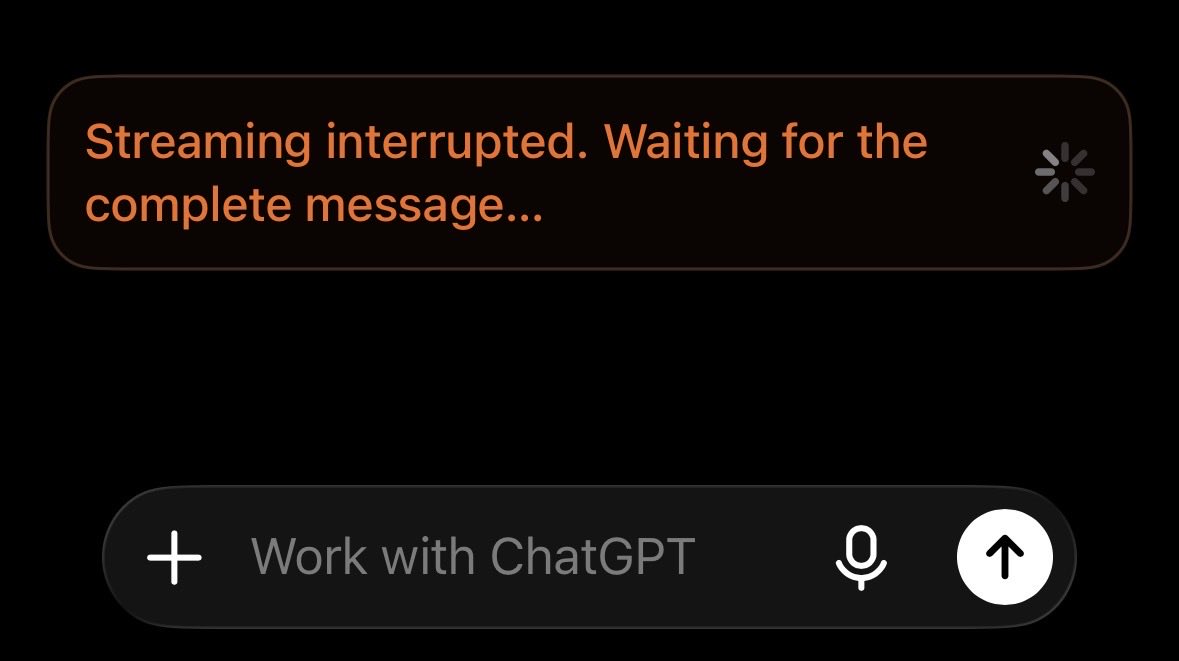
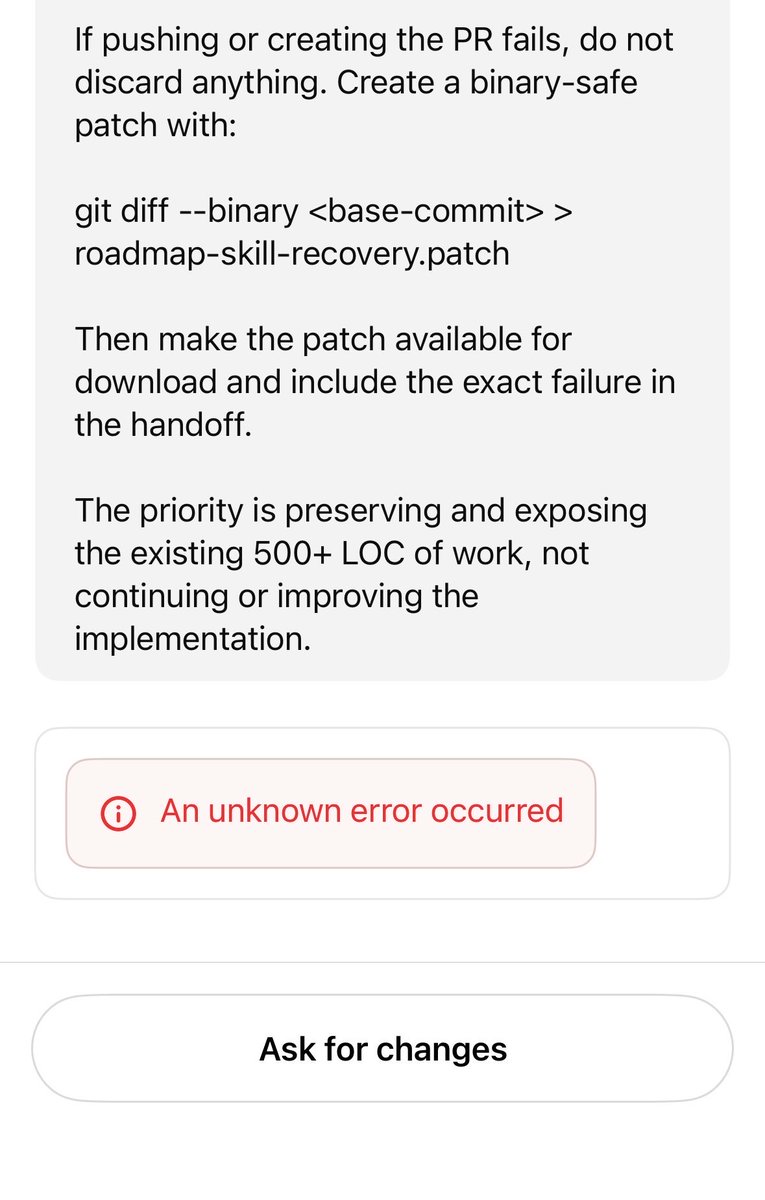
相比之下,@DanKornas 提到 之所以选择 Orca,部分原因就在于它带有用于通知和后续处理的移动端伴随应用;而 @kimburgaard 显示 则展示了当 AI 审查循环开始转起来之后,会积累多少分流工作。这个对比说明,尚未被满足的需求并不是抽象的“手机上的 AI”,而是一个可靠的未完成智能体工作控制界面。
3. 人们希望存在什么
带有明确检查点、且可验证的长时运行工作流
人们最想要的不是另一个自治模式,而是一种足以信任自治模式的方法。GitHub 发布 Fable 5.1 后的回复不断要求支持错误路径恢复、上下文保持和可审查性;@rseroter 指向了一套用测试和构建结果来证明完成情况的 Teamwork 流程;@kimburgaard 则最终干脆构建了审查分流技能,只为阻止 PR 审查不断反复出问题。这是一个现实而紧迫的需求,因为用户已经拥有长时运行智能体;他们缺的是一层标准化的证明机制。机会:直接。
能跨智能体宿主使用的可移植技能、记忆与知识层
人们显然在寻求能够跨工具边界存活的工作流智能。@RoundtableSpace 展示了可在 Claude Code、Codex 和 OpenCode 之间复用的 Obsidian 技能;@DhravyaShah 展示了 supermemory 已覆盖 Cursor 及一长串其他宿主;@illyism 则勾勒出了一整层发现体系——这些软件包如今在商店、注册表和目录中竞争。这个需求既实际也具有战略性:人们想要持久的行为与记忆,但不想为每个工具框架都重写一遍。机会:竞争性。
在可见工作流不变的前提下,提供更便宜、且可检查的底层基础设施
当天相当大一部分构建者精力,都花在替换隐藏的底层管线,而不是替换前端。@LisaFlorentina8 将 SOMA 描述为 Copilot 下方的压缩层;@starmexxx 将 Unsloth 描述为一种既保留 Claude Code 或 Codex、又能运行本地模型的方法;@techNmak 将 Agentic API 描述为位于 vLLM 前方的服务端状态与工具层;@QwenDevs 则把 zg 定位成同时面向开发者和智能体的本地优先检索层。这个需求非常实际,而且人们已经在试验。机会:竞争性。
对未完成智能体工作的可靠远程控制
Burke Holland 的游戏演示、Orca 的移动端伴随应用,以及 Heitor Lessa 对移动端 ChatGPT Work 的抱怨,都指向同一个需求:一旦任务超出单次桌面会话的生命周期,人们就想要一种可靠的方法,能从别处监控、解除阻塞、批准或停止它。当天的证据表明,这一需求在情绪层面的核心是“控制感”,而不是“便利性”。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Gemini 3.8 Flash | LLM | (+) | 已正式在 Antigravity 及其他 Google 界面上线;用户报告称,在真实负载下的有效限制更强 | 在明确产品说明出现之前,用户只能从选择器变化和配额表现中倒推发生了什么 |
| GitHub Copilot with Claude Fable 5.1 | IDE 与智能体承载框架 | (+/-) | 对长时任务和深度研究有强势公开主张;Fledgling Game 这样的现场演示让上限变得可感知 | 默认数据保留、执行失败、辅助文件漂移,以及可审查性仍让实践者担忧 |
| Spec Kit | 工作流方法 | (+) | 在代码改动开始前,为智能体提供明确的规范、计划、任务与收敛循环 | 用户仍在质疑,经历几轮后续变更请求后,规范是否还与代码保持一致 |
| Antigravity Teamwork | 多智能体工作流 | (+) | 公开演示强调了规范、子智能体、跟踪、审计,以及完成前必须通过测试 | 能否建立信任,取决于这些验证产物是否真正向操作者开放 |
| SOMA | 压缩与路由层 | (+/-) | 在 Copilot 中配合 DeepSeek V4 Pro 可节省约 10% token,并声称能在不改变可见工作流的情况下延长会话 | 首发仅支持 DeepSeek V4 Pro,用户仍需要证据证明这种节省能覆盖更广的负载 |
| Unsloth | 本地模型运行时 | (+) | 通过兼容 API,让 Claude Code、Codex 及其他智能体接入本地开源模型 | 需要本地硬件、配置成本,以及自行运维运行时的意愿 |
| Agentic API | 网关与运行时层 | (+) | 将状态注入、工具循环、流式传输和持久化移到服务端,为开源模型后端提供支持 | 相比托管产品,这仍是较早期的基础设施,安装与集成开销更高 |
| zg | 搜索与检索 | (+) | 在一个本地优先界面中结合语义搜索、BM25、混合检索和 rg,供人类与智能体使用 |
这是较新的工作方式,在见效前仍需建立索引并改变使用习惯 |
| Orca | 编排 IDE | (+) | 为每个 CLI 智能体提供独立 worktree,并支持移动端监控和差异注释 | 主要适用于团队已经同时调度多个智能体和 worktree 的场景 |
| obsidian-skills 和 supermemory | 技能与记忆 | (+/-) | 在 vault、市场和多个智能体宿主之间提供可移植的知识访问与记忆 | 隐藏指令、vault 卫生,以及记忆持久化的安全性会形成新的风险面 |
总体情绪是对能力持乐观态度,但对运营层面保持谨慎。人们喜欢更强的模型、规范优先工作流、本地后端和更好的检索,但当天的讨论反复表明,缺失的仍是审查闭环、治理和产品透明度。主要迁移路径包括:从自由式提示转向规范优先方法;从纯托管 API 转向本地或开源模型后端;以及从单次会话智能体转向带有记忆和移动端后续处理层的编排式 worktree。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Fledgling Game | Burke Holland | 基于浏览器的实时第一人称多人游戏,一只小鸟在乡间探索 | 展示长时运行的 Copilot 会话在只给一个提示的情况下,能走多远才需要人工润色 | GitHub Copilot、浏览器部署 | Beta | 推文、网站 |
| Spec Kit | GitHub | 开源的规范驱动开发工具包,包含 constitution、specify、plan、tasks、implement 和 converge 阶段 | 减少模糊提示带来的偏移,并在代码改动前强制进行结构化规划 | specify-cli、工作流命令、GitHub 维护的仓库 |
已发布 | 仓库、推文 |
| obsidian-skills | kepano | 跨工具技能,让 Claude Code、Codex 和 OpenCode 操作 Obsidian vault | 为智能体提供本地知识库和可重复执行的 vault 操作,而不是每次都从空白会话开始 | Agent Skills 规范、Obsidian、Claude Code、Codex、OpenCode | 已发布 | 仓库、推文 |
| SOMA for GitHub Copilot | SomaSubnet | 位于 Copilot 下方的压缩层,在上下文送入 DeepSeek V4 Pro 前减少重复内容 | 在不改变前端工作流的情况下削减 token 成本并延长会话寿命 | 上下文压缩、GitHub Copilot、DeepSeek V4 Pro | Beta | 推文 |
| Agentic API | vLLM project | 原生 Rust 网关,为开源模型后端提供有状态 Responses API 语义、服务端工具和持久化 | 无需每个客户端都重复构建对话状态与工具编排 | Rust、vLLM、SQLite、兼容 OpenAI 的 Responses API | Alpha | 仓库、推文 |
| zg | Zvec team | 面向开发者与智能体的本地优先搜索工具,结合语义、BM25、混合和 rg 检索 |
减少代码搜索中的大范围扫描、重复工具调用和上下文膨胀 | Node.js CLI、本地索引、语义与词法检索 | 已发布 | 仓库、推文 |
| Orca | stablyai | 桌面与移动端编排环境,可在隔离 worktree 中并行运行多个 CLI 智能体 | 防止并行智能体相互踩踏同一份 git 状态,并提供远程后续处理控制 | 独立 git worktree、桌面工作区、移动端伴随应用 | 已发布 | 仓库、推文 |
| Supermemory Cursor plugin | Supermemory team | 市场插件,为 Cursor 及大量其他智能体宿主提供持久化记忆 | 让上下文与记忆能在不同智能体界面之间迁移,而不是被困在单一宿主中 | Cursor marketplace 插件、MCP 风格工具与资源 | 已发布 | 推文、市场 |
Fledgling Game 是当天最清晰的“少说多看”式成果。@burkeholland 不只是发了一段视频;他把游戏真正发布到了 fledglinggame.com,并表示可见世界中的很大一部分都来自最初那次单提示生成,同时也坦承托管很便宜、未经压力测试。公开成品再加上限制说明,这种组合比单独一段精修过的演示视频更有说服力。
第二种构建模式,是保留熟悉的界面,同时替换下面那一层。SOMA 位于 Copilot 和模型之间,用于压缩上下文;Agentic API 位于客户端与 vLLM 之间,负责状态和工具循环;zg 位于用户与代码库之间,把搜索工作压缩成排序更优的证据。它们都不要求用户放弃周边工作流。
第三种反复出现的模式,是把记忆与协作外置。obsidian-skills 和 supermemory 把上下文推到可复用的软件包或插件中;Orca 则把多智能体工作变成一个明确的 worktree 加移动端控制问题,而不是一堆彼此重叠的会话。这些构建背后的共同触发因素,并不是模型原始能力不足,而是让智能体工作保持可检查、可重复、可移植时的运营摩擦。
6. 新动态与亮点
Qwen3.8-Max-0902 登顶公开 WebDev 排行榜
@Alibaba_Qwen 表示(91 个赞、7 条回复、5,530 次浏览、7 次收藏、7 次引用)称,Qwen3.8-Max-0902 以 1691 分登上 Code Arena: WebDev 第一名。被引用的 @arena 基准帖称,这一成绩比 Claude Opus 5 高 3 分、比 Kimi K3 高 17 分、比此前的 Qwen3.8-Max 高 22 分,同时还宣称其在价格上处于很强的帕累托位置。这一点之所以重要,是因为它为当天提供了一个明确的、既非 Google 也非 GitHub 的模型对比信号。
基准测试正被用来推销“任务委派”,尤其是面向较新的开发者
@Gyome1_ 认为(5 个赞、108 次浏览)称,一项基于 GitHub 的研究发现,当开发者把任务交给 AI 智能体后,平均产出提升了 26%,且增益最大的正是初级开发者。配图中关于采用 Claude 后“每月使用的不同语言数量”的图表,正是让这条帖子值得关注的原因:它把讨论从“智能体更快”推进到了“智能体可能拓宽经验较少开发者愿意尝试的范围”。

公开基准讨论也开始更具体地说明强模型是如何失败的
@SnorkelAI 报道(3 个赞、64 次浏览)称,在 Terminal-Bench+ 评测中,Fable 5.1 在调试和游戏任务上击败了 Opus 5,同时每次成功运行使用的 token 更少;但它也强调,失败根源主要集中在执行层面,而非推理层面。这种表述之所以值得注意,是因为它和发布回复中实践者的抱怨完全一致:模型进步是真实存在的,但剩余的失败模式正越来越偏向运营问题。
7. 机会在哪里
[+++] 长时运行智能体工作的验证与分流层 — 证据横跨 GitHub 的 Fable 5.1 发布回复、SnorkelAI 对执行类失败的拆解、R. Seroter 的 Teamwork 验证截图,以及 kimburgaard 那个产生 123 条 PR 发现的故事。这个机会很强,因为团队已经足够信任智能体去跑长任务,但仍缺少一种标准化方式来设置检查点、归类发现并证明任务完成。
[++] 在不改变前端的情况下替换成本、状态或检索的可插拔基础设施 — SOMA、Unsloth、Agentic API 和 zg 从不同角度押注的是同一件事:用户想继续使用 Copilot、Claude Code、Codex 或 OpenCode,同时替换底层昂贵或不透明的那一层。这个机会中等偏强,因为这一模式同时出现在成本控制、自托管、有状态编排和搜索等多个方向上。
[+] 面向可移植技能、记忆和智能体附加组件的封装与分发 — illyism 的注册表地图、obsidian-skills 和 supermemory 都指向同一个新兴界面层:技能和插件如今需要在多个宿主之间具备发现、安装、兼容性与信任信号。这一机会真实存在,但相较验证层或基础设施层,也更拥挤、更竞争激烈。
8. 要点
- Google 的编程技术栈叙事已经沉淀为产品界面的具体证据。 讨论已从前一天对 3.7 Flash 的整体热情,转向更具体的 Gemini 3.5 选择器移除、Gemini 3.8 Flash 的公开发布,甚至 Antigravity 工具中经二进制审计发现的 GLM 引用。(thtbee_、Google、mrfanduu)
- Copilot 的价值主张正在扩张,但围绕它的审查负担也在增加。 GitHub 借 Copilot 发布了 Claude Fable 5.1,用户也产出了 Fledgling Game 这样的高野心成果;但最有实质内容的回复关注的并不是模型智力本身,而是数据保留、错误路径恢复,以及 PR 审查反复拉扯的问题。(GitHub、Burke Holland、kimburgaard)
- 如今,修复 AI 编程“水活”的首选办法是结构,而不是更多提示。 Spec Kit、Obsidian 技能、supermemory 和注册表地图都指向同一种运营直觉:把工作流固化下来、封装起来,并让它能跨宿主迁移。(txbrraa、RoundtableSpace、DhravyaShah、illyism)
- 构建者越来越多地是在熟悉的智能体之下替换基础设施,而不是替换智能体本身。 SOMA 在 Copilot 下方压缩上下文,Unsloth 在 Claude Code 和 Codex 背后接入本地模型,Agentic API 在 vLLM 前方承接编排,而 zg 则把搜索工作压缩成排序更优的证据。(LisaFlorentina8、starmexxx、techNmak、QwenDevs)