Twitter AI 编程 - 2026-09-06
1. 人们在讨论什么
1.1 控制面、共享记忆与证明层,盖过了“单一模型谁更强”的讨论(🡕)
最强的一组讨论,已经不再是“哪个前沿模型最好”,而是“当会话变长之后,如何让智能体的工作保持可见、可恢复、可审查?”至少有 7 个彼此独立的项目支撑了这一转向,涵盖 GitHub 对 canvases 的官方推进、原生于代码库的规划契约、对话记录取证、实时代码库地图,以及带验证门槛的多智能体插件。
@github 表示 (115 个赞,12 条回复,33,169 次浏览,70 次收藏) 认为,canvases 能为智能体工作流提供一个持久的共享界面,用来追踪哪些步骤执行过、哪些内容已更改、哪些仍待审查。链接的 GitHub 帖子比推文更具体:它将 canvases 建立在明确的工作流状态、持久化草稿和具名的人类审批节点之上,并以 Java 现代化改造和网站内容工作流为例,说明一旦智能体开始长时间执行真实工作,单靠聊天记录就不够了。
@DanKornas 介绍了 (4 个赞,3 条回复,460 次浏览,3 次收藏) 将 OpenCode Swarm 描述为:在同一个 OpenCode 会话中,由架构师主导、由多个内部编码角色组成的团队。链接的 README 进一步说明,这些角色都要经过审查者和测试批准,由可恢复的 .swarm/ state 支持,并辅以独立的只读自动审查流程。它之所以重要,在于它把验证本身当作产品,而不是代码生成后的补充环节。

@DanKornas 还表示 (4 个赞,2 条回复,512 次浏览,1 次收藏) 认为,manifest-dev 把项目方向、下一项任务和完成定义都保存在代码库里。公开 README 也印证了这一点:其工作流围绕 3 类工件展开——North Star、Ticket 和每次运行的 Manifest——再配合 /figure-out、/define 和 /do 命令,把模糊请求转成验收标准与有证据支撑的完成结果。

@noisemakerjon 分享了 (5 个赞,2 条回复,280 次浏览,2 次收藏) 介绍了 shell-forensics,这是一项能读取 Codex、Claude Code、OpenCode 和 Cursor 对话记录,并把 shell 行为整理成报告的技能。README 里的示例发现很具体:874 个会话共执行了 38,176 条命令;当模型把 POSIX 语法写进 PowerShell 时,失败率达到 30%;而用 heredoc 传入 Python 时,失败率则远低于使用 python -c 单行命令的情况。
@stretchcloud 认为 (7 个赞,3 条回复,352 次浏览,2 次收藏) 认为,真正的扩展瓶颈不是模型质量,而是共享上下文:智能体会反复重读代码库、忘记先前决策,也看不到彼此的工作。同一帖子还借 Campfire 主张共享语义记忆、可重放会话与 worktree 隔离;与此同时,@Piyuzz713 介绍了 (3 个赞,2 条回复,28 次浏览) 介绍了 Map Room,把它定位成一个能实时查看智能体实际检查过哪些文件的界面。
讨论洞察: 回复者想要的不是更流畅的输出,而是可追溯性。在 GitHub 关于 canvases 的帖子下,一条回复说,每次状态变更都应该能追溯到生成它的确切智能体运行记录和工件;另一条则追问,canvases 到底是只追加的历史,还是可编辑的摘要。同样这种“让我看到实际发生了什么”的冲动,也推动了 shell-forensics、Map Room 和 Swarm 的独立审查步骤。
与前一天的比较: 9 月 5 日,编排与监督已经借由元级 harness、浏览器工具和路由层开始升温。到了 9 月 6 日,这一思路变得更具体:讨论转向持久化界面、原生于代码库的契约、对话记录审计,以及能证明工作结果而不只是组织工作的显式门槛。
1.2 Token 纪律和本地兜底方案,成为应对前沿模型高价的现实回应(🡕)
第二大讨论集群围绕长时间运行的智能体循环如何控成本展开。相比泛泛的能力排名,人们更关心的是重复上下文、配额消耗、价格上涨,以及哪些基础设施能在不承担前沿模型账单的情况下维持有用的编码吞吐。至少有 6 个项目支撑了这一主题。
@0x_Kalista 认为 (10 个赞,11 条回复,286 次浏览) 认为,真正重要的问题不是模型原始质量,而是会话历史和重复的工具输出被一遍遍重新发回模型。被引用的 SOMA 发布信息和附带的 Copilot 图示,把这一点说得更具体:该层声称会在文件、工具轨迹和过时状态进入 GitHub Copilot 中的 DeepSeek V4 Pro 之前先做压缩,在保留同样智能体工作流的前提下,起步大约可节省 10% 的 token。

@StefanoGPT 发布了 (42 个赞,11 条回复,21,340 次浏览,69 次收藏) 分享了一份面向 Codex 用户的长篇社区诊断提示词,针对那些怀疑自己额度消耗异常快的人,内容包括环境检查、可逆的本地修复,以及一套 75 分钟的空闲观察流程。这比单纯抱怨的推文更有力,因为它表明社区已经开始围绕使用不透明性,打包可复现的调试工作流;回复也补充了细节,Stefano 明确表示,有些用户看到的可能是正常行为,原因尚未得到证实。
@robinebers 表示 (16 个赞,8 条回复,1,754 次浏览) 认为,Astra 更高的 token 效率仍不足以抵消反复涨价,并列出了转向 Astra 后的价格:每百万输入 token 10 美元、每百万输出 token 50 美元。与之对应,@Joelc_eth 反驳称 (15 个赞,1 条回复,402 次浏览,1 次收藏) 提到了 GitHub 的 HydraFusion 研究预览;链接帖子确认,其反向论点在于编排:GitHub 称,单路、级联和评审工作流相较于 Claude Opus 5,可将 TerminalBench 2.1 的预计成本降低 67%,同时让经验证的质量提升 4.9 个百分点。
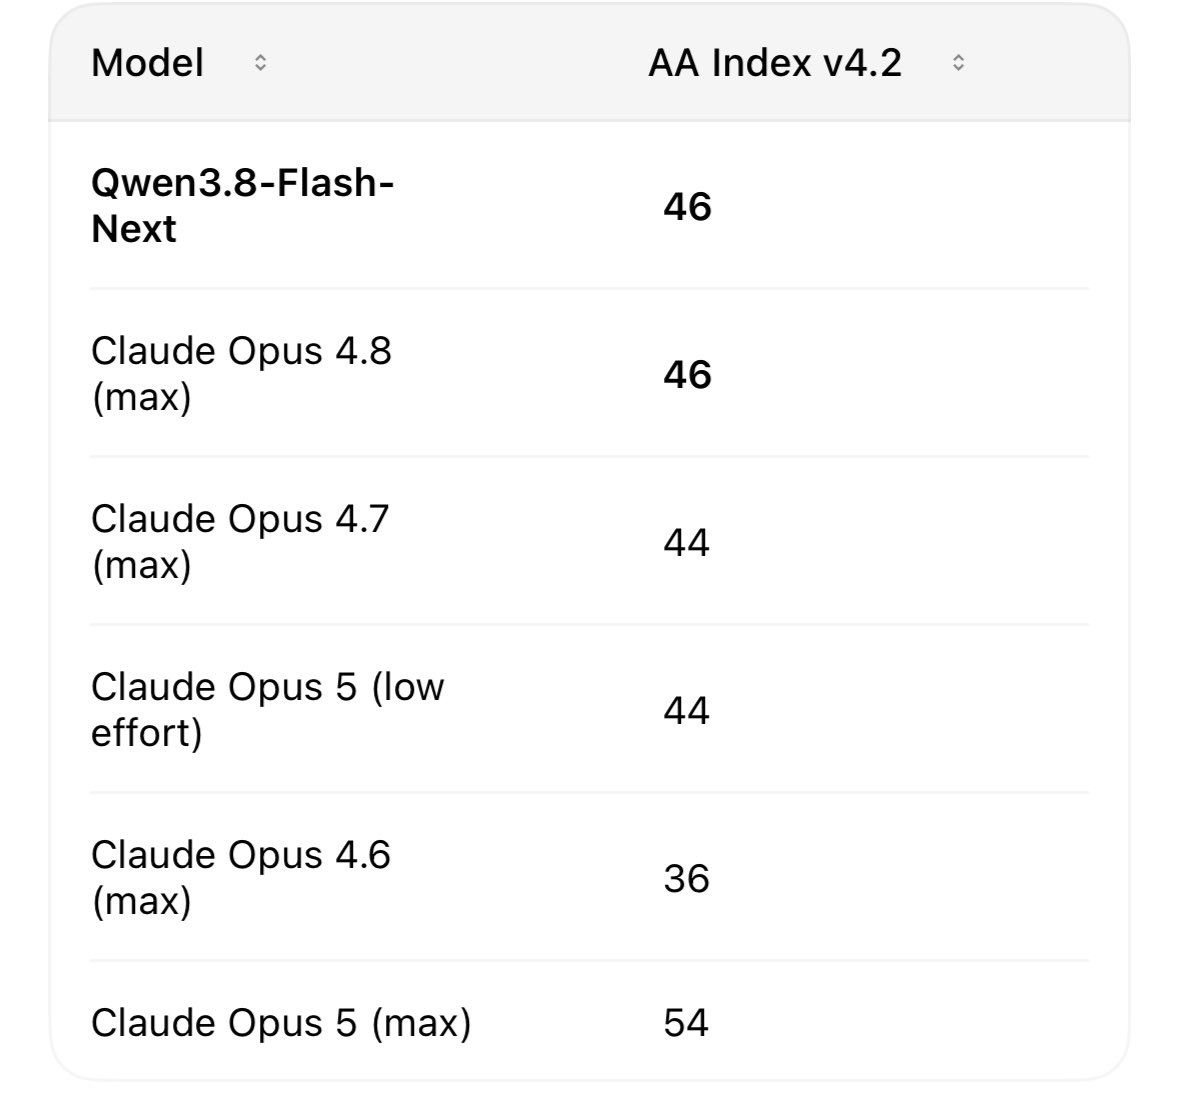
@0x0SojalSec 报道了 (10 个赞,3 条回复,1,402 次浏览,20 次收藏) 认为,Qwen3.8-27B 可以在免费的 Kaggle TPU 上以完整 BF16 运行,解码速度约 130 tok/s,prefill 速度约 10k tok/s,原生支持 262k 上下文,并为 Claude Code、Codex 和 OpenCode 提供 OpenAI 兼容端点。第二个本地经济性案例来自 @ItsCuthulhu 称 (1 个赞,2 条回复,292 次浏览):他们在单台 DGX Spark 上运行 Qwen3.8-Flash-Next,并取消了大多数订阅;链接 README 和附图补充了运行细节,如 99 GB 的 checkpoint、原生 262k 上下文,以及在 8 路并发下最高 162.9 aggregate tok/s 的实测解码速度。
讨论洞察: 这种怀疑是出于现实考量,而不是意识形态。Kaggle TPU 帖子下的回复追问,OpenAI 兼容端点在真实的多轮工具调用循环里是否真的撑得住;Codex 使用情况讨论则始终在区分真正的后台消耗、延迟上报和本地配置问题。
与前一天的比较: 9 月 5 日更多精力花在 Astra 的发布界面、价格卡和类似基准测试的速度宣传上。到 9 月 6 日,问题收窄成了“怎样让长会话智能体保持可负担”,答案则落在压缩、诊断、更聪明的路由,以及把部分工作负载迁移到免费或本地基础设施上。
1.3 厂商继续把智能体工作打包成受治理的生态与角色组合(🡒)
大型平台的叙事依旧强势,但重点已从单纯的模型发布,转向受治理的打包方案:合规封装、官方培训系列、完整技术栈示意图,以及可直接使用的角色包。至少有 5 个项目支撑了这一主题。
@GoogleCloudTech 表示 (232 个赞,6 条回复,25,842 次浏览,33 次收藏) 表示,Gemini Enterprise 订阅现在把 Antigravity 纳入 Google Cloud 的标准安全与合规保护之下。回复进一步凸显了真正的价值主张:一条回复说,合规保护伞就是产品能否通过采购的分界线;另一条则认为,关键不在模型,而在于委派权限、按任务限定的工具访问范围,以及逐任务撤销能力。
@googlecloud 推广了 (99 个赞,3 条回复,6,830 次浏览,48 次收藏) 介绍了一个由 4 部分组成的 Gemini Enterprise Agent Platform 与 Antigravity 直播技术系列,内容涵盖 ADK 逻辑、长期状态和安全部署。@AiswaryaVenkit1 将其描述为 (37 个赞,3 条回复,692 次浏览,12 次收藏) 则通过 Azure AI Foundry 展现了同样的平台化倾向;附带的生态图在同一张栈图中列出了模型提供方、智能体工具链组件、监控系统和信任与安全服务。

@codeby_jack 表示 (10 个赞,6 条回复,44 次浏览,1 次收藏) 表示,Anthropic 为 Claude 发布了 10 个金融智能体,覆盖研究、建模、估值、会计和 KYC 工作流。附图之所以重要,是因为它显示这些是与真实数据和办公系统绑定的角色组合,而不只是提示词模板。

@itsPaulAi 提醒 (15 个赞,6 条回复,3,182 次浏览,12 次收藏) 表示,学生可以获得 Google AI Pro 或 AI Plus 套餐,其中包括更高的 Gemini 和 Antigravity 使用上限、NotebookLM、5 TB Drive 存储,以及其他 Google 产品入口。这个帖子的重要性在于,它表明分发策略和使用额度,已经和底层模型一起成为产品叙事的一部分。
讨论洞察: 回复始终聚焦治理。在 Google Cloud 合规公告下,回应者不断回到采购、影响半径、访问范围和撤销机制等话题;这种语气不同于面向消费者的模型炒作,更接近标准企业软件的采购标准。
与前一天的比较: 9 月 5 日的重点是 Antigravity 不断扩大的产品面和面向创作者的演示。到 9 月 6 日,Google 仍处在讨论中心,但重点已转向企业控制、官方赋能项目,以及 Google、Azure 与 Anthropic 生态中的基于角色的智能体打包。
2. 什么让人感到沮丧
工作还没出问题,成本可见性先失效了
最强烈的挫败感,并不只是前沿编码模型要花钱,而是人们觉得,在一个长任务仍在进行时,自己无法足够清楚地看到支出。@StefanoGPT 发布了 (42 个赞,11 条回复,21,340 次浏览,69 次收藏) 分享了一整套 Codex 额度消耗诊断流程,包括环境检查、可逆修复和空闲观察协议。相比一句抱怨,这更有分量,因为它表明用户已经需要一套操作手册,才能判断自己的使用是否正常。@robinebers 认为 (16 个赞,8 条回复,1,754 次浏览) 表示,Astra 的效率提升依然抵不过反复涨价;而 @0x_Kalista 主推了 (10 个赞,11 条回复,286 次浏览) 则主打上下文压缩,正因为重复的文件和工具历史已经成了一条可计费的成本线。
一个较小但很直观的例子来自 @Mr_Chartist 展示了 (3 个赞,1 条回复,3,226 次浏览,1 次收藏):30 天带宽使用量达到 798.41 GB,其中 Node 占 253.03 GB,ChatGPT 占 172.82 GB,Claude 占 86.16 GB。这并不直接衡量 token 成本,但它强化了同一种运营感受:开发者还没见到账单,智能体式构建本身就已经非常耗资源。严重程度:高。这个方向值得做,因为公开场合里已经能看到用户在用诊断、压缩、路由和本地模型兜底。
智能体仍在冷启动、重复扫描和缺乏持久状态上浪费大量精力
下一个挫败点是反复重建上下文。GitHub 的 canvases 文章,由 @github 的 帖子 (115 个赞,12 条回复,33,169 次浏览,70 次收藏) 链接出来,文中明确指出:纯聊天工作流会把计划、决策点、验证结果和审批时刻埋进滚动记录里,每当有人要重建事情经过,就会产生额外的协作成本。@stretchcloud 介绍了 (7 个赞,3 条回复,352 次浏览,2 次收藏) 更直白地说出了同一个问题:智能体会打开几十个文件只为找一个函数,然后到下一次会话就把结果忘掉。@Piyuzz713 构建了 (3 个赞,2 条回复,28 次浏览) 介绍 Map Room,用来实时展示逐文件的探索路径;而这种工具之所以成立,前提就是“看不见搜索路径”已经很痛。
来自 @siddontang 指向了 (11 个赞,2 条回复,407 次浏览,6 次收藏) 的 Google Spanner 迁移博客企业案例,则展示了团队如今如何应对:先写 spec,再生成代码,然后编译、测试、修复、重复,并配合明确的 parity 检查。严重程度:高。凡是能跨会话保留状态、在多个智能体之间共享状态,并暴露出哪些上下文真正起作用的产品,都值得投入。
验证与工具信任,仍然落后于生成速度
当天几个最具体的项目之所以存在,就是因为人们不相信“模型说它做完了”足以成为完成信号。@DanKornas 将其描述为 (4 个赞,3 条回复,460 次浏览,3 次收藏) 把 OpenCode Swarm 建立在强制审查者和测试门槛之上;@DanKornas 将其描述为 (4 个赞,2 条回复,512 次浏览,1 次收藏) 则把 manifest-dev 建立在明确验收标准和有证据支撑的完成状态之上。@noisemakerjon 使用了 (5 个赞,2 条回复,280 次浏览,2 次收藏) 介绍了 shell-forensics,用于检查编码智能体在 shell 里到底做了什么;@HadjKamara 构建了 (6 个赞,3 条回复,196 次浏览) 介绍了 mcpvet,因为 MCP 服务器可能会在开发者仔细审查配置之前,就以开发者权限自动运行。
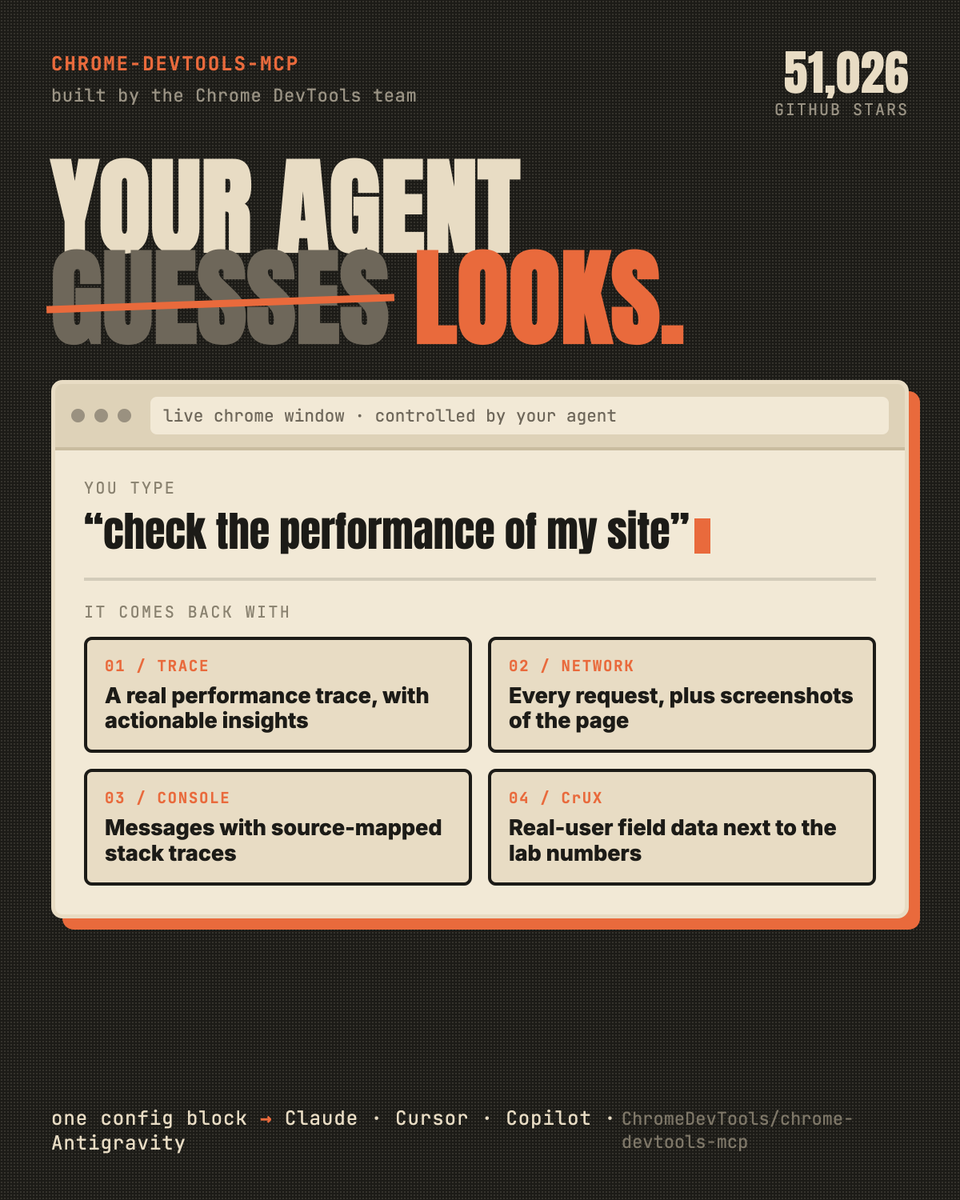
基于浏览器的工具,是对同一信任问题的另一种应对。@DuncanRogoff 重点介绍了 (3 个赞,3 条回复,390 次浏览,1 次收藏) 介绍了 chrome-devtools-mcp,因为它能让智能体直接检查线上站点、记录真实 trace,并读取真实的网络和控制台输出,而不是根据截图和文字去猜。严重程度:高。这个方向值得做,因为用户已经在手工拼装多步骤验证栈。
3. 人们希望有什么
一个让状态、来源与审查始终可见的共享控制平面
最明确的需求,不是再来一个聊天窗口,而是一个持久化空间,让多个智能体和人类无需从滚动记录里重建会话,就能看到工作流状态、证据和审批节点。GitHub 的 canvases 帖子,由 @github 的 推文 (115 个赞,12 条回复,33,169 次浏览,70 次收藏) 链接,明确是在主张这样的界面;@stretchcloud 征求 (7 个赞,3 条回复,352 次浏览,2 次收藏) 指向跨智能体的共享记忆和可重放会话;@Piyuzz713 构建了 (3 个赞,2 条回复,28 次浏览) 指向 Map Room,因为用户想看到智能体实际检查了什么。这是一个有重复证据支撑的现实需求。机会:直接。
一个真正的 token 驾驶舱:能做路由、压缩,并在支出失控前发出预警
人们实际上是在要求一个控制面板:告诉他们某个任务何时正在大量烧上下文、这种消耗是否符合预期,以及还有哪些更便宜的执行路径可选。@StefanoGPT 写道 (42 个赞,11 条回复,21,340 次浏览,69 次收藏) 之所以会出现诊断提示词,就是因为这种驾驶舱并不存在;@0x_Kalista 销售了 (10 个赞,11 条回复,286 次浏览) 提出了上下文压缩作为直接答案;@Joelc_eth 指出了 (15 个赞,1 条回复,402 次浏览,1 次收藏) 则用 HydraFusion 的级联和评审路由,提供了另一种只在关键处花高价推理成本的方式。这是一个现实且紧迫的需求。机会:直接。
能跨 harness 切换而继续存活的可移植技能与领域工作流
讨论持续在奖励可复用流程,而不是一次性提示词。@DanKornas 展示了 (4 个赞,2 条回复,512 次浏览,1 次收藏) 把 manifest-dev 视为适用于任何智能体编码 CLI 的原生代码库契约;@noisemakerjon 发布了 (5 个赞,2 条回复,280 次浏览,2 次收藏) 把 shell-forensics 视为可复用的对话记录阅读技能;@codeby_jack 披露了 (10 个赞,6 条回复,44 次浏览,1 次收藏) 则把 Anthropic 的金融智能体包视为预构建的领域工作流。三者底下的实际诉求是一样的:即便首选模型或客户端换了,工作流资产也不要丢。机会:具有竞争性。
在自主智能体发起第一次调用之前,提供更安全的 MCP 与外部工具执行机制
MCP 的采用,显然正在拉动对更好信任层和审计层的需求。@HadjKamara 构建了 (6 个赞,3 条回复,196 次浏览) 介绍了 mcpvet,用于在合并前扫描高风险配置;@DuncanRogoff 重点介绍了 (3 个赞,3 条回复,390 次浏览,1 次收藏) 介绍了 chrome-devtools-mcp;@CapFrameX 补充说 (8 个赞,3 条回复,154 次浏览,2 次收藏) 则介绍了一个连接到性能分析应用的 MCP 服务器。人们想要工具落地型智能体带来的好处,但也想要来源检查、权限边界,以及更清楚地审视这些工具到底能做什么。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot Canvases | 工作流界面 | (+) | 让工作流状态、草稿和审批变得持久,而不是被埋进聊天记录 | GitHub 自己的博客也说,想把 canvases 打磨好需要前期投入,可能消耗数千个 AI credits |
| HydraFusion | 模型编排 | (+) | 通过单路、级联和评审模式,在运行时权衡成本与经验证质量 | GitHub 将其称为研究预览,并表示目前最适合首轮、单提示词任务 |
| SOMA | 上下文压缩 | (+/-) | 重点压缩重复文件、工具轨迹和陈旧状态;早期用户提到约 10% 的 token 节省 | 仍处于早期访问阶段,首个 Copilot 集成对象是 DeepSeek V4 Pro,而且当前节省幅度仍然有限 |
| Gemini Enterprise Agent Platform / Antigravity | 智能体平台 | (+/-) | 增加了企业合规叙事、ADK 工作流、长期状态和安全部署信息 | 目前公开证据主要还是高层包装与培训宣传,而非可量化的运营结果 |
| Azure AI Foundry | 企业技术栈 | (+) | 在一张平台图中整合广泛模型访问、智能体工具链集成、监控与信任控制 | 被引用的证据是一张生态图,而不是上手后的性能证据 |
| Gentle-AI | Harness 配置器 | (+) | 为多种编码智能体补上记忆、技能、护栏、路由和多运行时支持 | 它配置的是现有智能体,而不是替代它们,因此团队仍会继承底层运行时行为 |
| Qwen 本地方案 | 本地/开放模型技术栈 | (+/-) | 原生 262k 上下文、OpenAI 兼容端点,以及在 TPU 或 DGX Spark 上替代前沿订阅的方案 | 免费 TPU 时长有限,而 DGX 方案仍需要 99 GB checkpoint 和较重硬件 |
| chrome-devtools-mcp | 浏览器 MCP | (+) | 给智能体提供实时浏览器、trace、截图、控制台输出、Puppeteer 控制和 CrUX 数据 | 智能体使用前仍需先完成 MCP 配置并获得浏览器访问权限 |
| mcpvet | MCP 安全扫描器 | (+) | 可审计主流智能体 IDE 的 MCP 配置、检查来源,并能在 CI 中阻止高风险变更 | README 明确说明,v1 只覆盖静态配置,不处理运行时工具描述投毒 |
| OpenCode Swarm | 多智能体治理 | (+) | 具备架构师主导的专业化智能体、审查与测试门槛、独立自动审查和可恢复状态 | 增加了流程与插件复杂度,而且只适用于 OpenCode |
| manifest-dev | 原生代码库规划 | (+) | 在代码库内保存项目方向、下一项任务和完成标准,并以证据支撑完成 | README 说明,相比直接提示,它前期需要更多 token 和工作量 |
| shell-forensics | 智能体可观测性 | (+) | 从 Codex、Claude Code、OpenCode 和 Cursor 对话记录中提取真实 shell 行为与失败模式 | 它是诊断型、事后型工具,而不是预防型工具 |
| CapFrameX MCP | 垂直 MCP 应用 | (+) | 无需额外安装,就能通过 MCP 客户端暴露录制结果、统计、诊断和实时系统数据 | 更偏 Windows 与游戏性能场景,而不是通用编码工具 |
总体满意度偏正面,前提通常不是工具“又加了一个强模型”,而是它降低了不确定性。@github 将其定位为 (115 个赞,12 条回复,33,169 次浏览,70 次收藏) 把 Canvases 看作避免工作流状态在聊天中丢失的方式;@Joelc_eth 将其定位为 (15 个赞,1 条回复,402 次浏览,1 次收藏) 把 HydraFusion 看作避免任务每一段都支付前沿模型价格的方式;@DuncanRogoff 将其定位为 (3 个赞,3 条回复,390 次浏览,1 次收藏) 则把 chrome-devtools-mcp 看作用直接浏览器证据替代猜测的方式。
共同的应对模式,是把一个巨大而不透明的循环,拆成分层执行:先上更轻的模型,只在必要时升级,保留持久记忆,并加入独立审查。迁移行为同时朝两个方向发生:一部分用户尝试通过压缩和路由降低开销,另一部分则转向本地或免费开放替代方案,例如 Kaggle TPU 或 DGX Spark 上的 Qwen。因此,竞争压力与其说是“模型 A 对模型 B”,不如说是“哪一套栈能给我更好的可见性、可控成本和可信验证”。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| OpenCode Swarm | @DanKornas | 把一个 OpenCode 会话变成由架构师主导、带门槛的专业化编码智能体团队 | “模型说做完了”不足以建立生产级信任 | OpenCode 插件、Bun/Node、.swarm/ state、只读审查会话 |
已发布 | 仓库 |
| manifest-dev | @DanKornas | 把项目方向、任务定义和完成标准保存在代码库中 | 模糊的智能体请求会漂移,完成声明也难以验证 | Markdown 技能、CLI 插件、原生于代码库的 manifests | 已发布 | 仓库 |
| shell-forensics | @noisemakerjon | 读取编码智能体对话记录,并报告 shell 命令模式与失败情况 | 团队难以检查智能体到底做了什么,或命令为何失败 | Python、对话记录解析器、HTML 报告输出 | 已发布 | 仓库 |
| mcpvet | @HadjKamara | 扫描 MCP 配置中的高风险命令、机密访问、来源问题和已知攻击模式 | 自动执行的 MCP 服务器会在合并前制造安全审查缺口 | npm CLI、模式库、GitHub Action | 已发布 | 仓库 |
| Map Room | @Piyuzz713 | 实时可视化编码智能体对代码库的逐文件探索 | 很难看出智能体在浏览代码库时实际用了哪些上下文 | Web 应用、SpacetimeDB | Alpha | 网站 |
| Safe Trade Copilot | @Snipermemecoin | 基于 Binance MCP 数据,把交易工作流拆成分析师与风险官角色 | AI 交易聊天可能过快地从分析跳到执行 | Binance Agent OS MCP、提示词角色、审计日志 | Alpha | 仓库 · 演示 |
| CapFrameX MCP | @CapFrameX | 通过 MCP 暴露性能捕获、统计和实时系统诊断 | 在性能工作流中,智能体无法直接检查 frametime 和传感器数据 | .NET 10、PresentMon、localhost MCP 服务器 | 已发布 | 发布 · 设置 |
| Gentle-AI | @G_Programming | 为现有编码智能体配置记忆、技能、护栏与确定性工作流 | 不同智能体运行时会冷启动,且在不同任务上的表现不一致 | Go CLI、Engram memory、技能、可选 MCP 工具 | 已发布 | 仓库 |
| Who Is Building What? | @1997harkirat | 展示 Bangalore 构建者与项目的动态地图 | 构建者需要更快发现协作者和本地有意思的项目 | Web 应用、Codex 辅助构建的 buildathon 项目 | Beta | 网站 |
最常见的构建模式,并不是“再包一层模型”,而是围绕智能体工作增加可观测性和治理。@DanKornas 展示了 (4 个赞,3 条回复,460 次浏览,3 次收藏) 把 OpenCode Swarm 做成单一会话中的验证门槛团队;同一作者还用 展示了 (4 个赞,2 条回复,512 次浏览,1 次收藏) 介绍了 manifest-dev,把方向与验收标准钉在代码库本身。这两个项目在解决同一个信任问题的不同部分:一个治理执行过程,另一个治理“这项工作被允许意味着什么”。
@noisemakerjon 分享了 (5 个赞,2 条回复,280 次浏览,2 次收藏) 介绍了 shell-forensics,@Piyuzz713 分享了 (3 个赞,2 条回复,28 次浏览) 介绍了 Map Room;两者都指向同一个底层挫败感:智能体已经制造出大量活动,但操作者仍难以看清到底跑了哪些命令、又实际查看了哪些文件。两个独立构建者分别从 shell 层可观测性和代码库路径可见性切入,这一事实本身就是强信号,说明“检查”正在成为一个产品类别。
安全与受限执行,是第二个反复出现的模式。@HadjKamara 构建了 (6 个赞,3 条回复,196 次浏览) 介绍了 mcpvet,用于在合并前拦截高风险 MCP 配置;@Snipermemecoin 构建了 (1 个赞,35 次浏览,2 次收藏) 介绍了 Safe Trade Copilot,围绕明确限制、独立风险角色和强制人工确认来设计。即使离开编码场景,构建模式也没变:先把分析和权限分开,再留下审计轨迹。
第三个模式,是把现有软件变成智能体入口,而不是从零构建全新的智能体。@CapFrameX 补充了 (8 个赞,3 条回复,154 次浏览,2 次收藏) 为一款 Windows 性能分析工具加入了 MCP 支持;@1997harkirat 构建了 (25 个赞,6 条回复,212 次浏览,1 次收藏) 则展示了一个在 Codex 支持的 buildathon 期间做出的构建者发现地图。共同动作是:把智能体工具作为现有工作流或社区关系图之上的一层,而不是一个独立的新奇应用。
6. 新近且值得关注的动态
基于浏览器的调试,从小众技巧跨入了主流智能体原语
@DuncanRogoff 重点介绍了 (3 个赞,3 条回复,390 次浏览,1 次收藏) 介绍了来自 Chrome DevTools 团队的 chrome-devtools-mcp。这是一个拥有 51,026 个 star 的项目,允许智能体打开实时 Chrome 窗口、记录性能 trace、检查网络请求、读取 source map 还原后的控制台消息、驱动 Puppeteer 操作,并查询 CrUX 数据。它之所以重要,在于它把浏览器访问变成了直接证据,而不是路线图里的愿景。
Google 的 Spanner 迁移帖子,给出了当天最清晰的企业工作流案例
@siddontang 指出了 (11 个赞,2 条回复,407 次浏览,6 次收藏) 介绍了一个 Google Cloud 案例研究:一条无头 Antigravity CLI 流水线,帮助自动化完成了跨 30 多个 DAO 的双写迁移。链接帖子并没有抽象地兜售“AI 会写代码”,而是描述了一个受约束的循环:spec、生成、编译、测试、修复和 parity 验证。这比一般工作流帖要具体得多。
本地与免费开放部署方案持续增强
@0x0SojalSec 报道了 (10 个赞,3 条回复,1,402 次浏览,20 次收藏) 介绍了在免费 Kaggle TPU 上运行 Qwen3.8-27B,具备原生 262k 上下文和 OpenAI 兼容端点;与此同时,@ItsCuthulhu 报道了 (1 个赞,2 条回复,292 次浏览) 介绍了单台 DGX-Spark 上的 Qwen3.8-Flash-Next 配置,目标是替代持续性订阅。两篇帖子之所以重要,在于它们把本地/开放路线从“爱好者热情”推进到了有实测吞吐、部署方案和主流编码智能体客户端兼容性的阶段。
7. 机会在哪里
[+++] Token-aware agent operations - Evidence came from multiple directions: @StefanoGPT 构建中 (42 个赞,11 条回复,21,340 次浏览,69 次收藏) 分享了 Codex 使用情况诊断工作流;@0x_Kalista 销售中 (10 个赞,11 条回复,286 次浏览) 介绍了上下文压缩;@Joelc_eth 呈现 (15 个赞,1 条回复,402 次浏览,1 次收藏) 介绍了运行时编排;而本地 Qwen 相关帖子则提供了摆脱订阅成本的兜底路径。这个机会之所以强,是因为痛点已经足够具体、反复出现,而且直接影响运营。
[+++] 自主编码的证明层 - GitHub canvases、OpenCode Swarm、manifest-dev、shell-forensics、Map Room 和 chrome-devtools-mcp 都指向同一个需求:保留一份持久记录,说明智能体看到了什么、做了什么判断、改了什么、验证了什么,以及哪些地方仍需要人工裁决。这个机会之所以强,是因为多个独立构建者都在从相邻方向填补同一个信任缺口。
[++] 可移植技能与打包工作流 - manifest-dev、shell-forensics、Gentle-AI 和 Anthropic 的金融智能体包,都说明可复用流程正在变得比一次性提示词更有价值。这是一个中等机会,因为需求已经明确,但来自厂商、开源插件和跨运行时技能库的竞争也在迅速升温。
[++] 安全的 MCP 操作 - mcpvet、chrome-devtools-mcp、CapFrameX MCP 和 Safe Trade Copilot 共同表明,工具落地型智能体正在同时变得更有用,也更危险。这个机会是中等强度,因为问题已经真实存在,但买家可能会分流到扫描器、权限层、托管网关和垂直 MCP 应用等不同方案上。
[+] 面向现有软件与社区的智能体界面 - CapFrameX MCP、Who Is Building What? 以及前文提到的内部知识库模式,说明为本就拥有有价值数据、用户和决策的工作流增加智能体访问能力,是一个规模较小但可信的机会。这个信号还在形成中,尚未成为主流,但每当有人能接入真实系统而不是再造一个独立智能体应用时,它就会再次出现。
8. 要点
- 讨论已经从模型层上移到工作流控制层。 GitHub 对 canvases 的推进、OpenCode Swarm、manifest-dev、shell-forensics 和 Map Room,都在关注如何保留状态、暴露证据或证明完成,而不是再争一个模型基准。 (来源)
- 如今的成本控制,关乎会话机制,而不只是模型定价。 SOMA 面向 Copilot 的压缩方案、HydraFusion 的级联与评审路由,以及 Codex 使用情况诊断工作流,都把重复上下文和不必要的高价推理视作真正需要解决的支出问题。 (来源)
- 企业级打包方案,正在用治理语言来销售。 Google Cloud 相关讨论中最有力的官方回复,集中在合规保护伞、委派权限和撤销范围;而 Azure AI Foundry 与 Anthropic 的金融智能体,则被包装成完整技术栈或基于角色的运行环境。 (来源)
- 构建者正在竞相为智能体加上观测与约束,而不只是放任它们自行运行。 mcpvet、Safe Trade Copilot、chrome-devtools-mcp 和 CapFrameX MCP,都在围绕智能体行为增加检查机制、权限边界或真实系统证据。 (来源)
- 本地和免费开放替代方案,已经足够实用,开始影响用户行为。 Kaggle TPU 和 DGX Spark 上的 Qwen,都被呈现为既能保持较强编码吞吐、又能降低订阅依赖的可行方案,而且两者都给出了具体的上下文与吞吐数据,而非泛泛而谈的开源热情。 (来源)