Twitter AI 编程 - 2026-09-12
1. 人们在讨论什么
1.1 代理工作的可观测性正从“可有可无”走向产品核心界面(🡕)
9 月 12 日最明显的变化,是讨论重点从泛泛的“AI 会写代码”的兴奋,转向那些能解释代理做了什么、改动了代码库哪些地方,以及团队如何审查或约束这些工作的工具。OpenAI、GitHub 和独立开发者从不同角度都指向了同一种需求:归因、审计轨迹,以及有证据支撑的审查,正在成为一等产品功能。
@thsottiaux 宣布(1,976 个赞、364 条回复、156 次收藏、176,186 次浏览)称,OpenAI 正在吸纳 Git AI 团队,并将其开源工具描述为帮助开发者理解编程代理如何为其代码库做出贡献。之所以引发共鸣,是因为它点出了许多人这几天一直在围绕的那个缺失层:人们要的不是更好的自动补全,而是对代理编写工作的更清晰归因。
@GHchangelog 链接到(9 个赞、1 次收藏、1,257 次浏览)介绍了 GitHub 的 Copilot 代码审查更新:现在它会自动解决已处理的评论,为已应用的修复生成更智能的提交信息,并调用更广泛的 Shell 工具做更深入的验证。在配套的 GitHub 更新日志 中,GitHub 表示,Lite 审查现在采用多代理集成方案;对于高严重性发现,已处理评论增加了 47%,中严重性增加了 31%,低严重性增加了 11%,同时审查成本下降了约 8%。
独立开发者也在大平台之外解决同一个问题。@DanKornas 推出了(11 个赞、4 条回复、4 次收藏、861 次浏览)介绍了 Hive:它会在 GitHub issue 和 PR 上的任何 LLM 工作之前,设置确定性过滤器和合并门禁。@agenticgirl 分享了(2 条回复、43 次浏览)介绍了 Agent Beacon,这是一个开源遥测层,可在 21+ 个运行时之间统一提示词、工具调用、文件变更、审批和 token 使用情况。合在一起看,这些帖子让“可观测性”不再像是合规附加项,而更像严肃代理工作流的核心组成部分。
讨论洞察: 大家的共同诉求不是“让模型更聪明”,而是“告诉我发生了什么,让写入过程可观测,并留下以后可以审计的证据”。
与前一天相比: 9 月 11 日强调的是围绕代理的护栏和评估器;到 9 月 12 日,讨论进一步贴近实际工作界面本身:贡献归因、基于 Shell 的审查,以及跨运行时遥测。
1.2 Antigravity 仍在持续发版,但真正的讨论依然围绕干预与限制展开(🡒)
Antigravity 依旧是声量最高的产品话题之一,但讨论重心已经从发布时的新鲜感转向操作者控制。官方叙事强调的是更丰富的工作流界面;用户真正关心的,则是当你想介入、调整优先级,或者让系统在现实限制下持续运行时,会发生什么。
@googledevs 总结了(323 个赞、32 条回复、77 次收藏、45,555 次浏览)汇总了一组 Antigravity 更新:/boost 用于专注的多代理推理、改进后的 /teamwork-preview、内联生成式产物,以及更新后的 Git 和终端控制。最有价值的回复并不在于这些功能是否存在,而在于如何信任它们:既要让规划保持并行,又要让代码库写入保持串行且可观测;同时还希望围绕常规命令提供更安全的权限行为。
@rodydavis 发布了(163 个赞、38 条回复、33 次收藏、13,244 次浏览)介绍了 v2.13.0 版本,但回复区给出了更持久的信号。用户要求在侧边栏中固定项目并调整顺序,也有人希望看到模型思考过程,“就像 Codex 一样”。Rody 的回应之所以重要,是因为它们显示了当前边界所在:排序和筛选已经有了,也可以启用详细思考,但用户仍然觉得需要更直接的干预工具。
@ai_for_success 报道了(193 个赞、16 条回复、38 次收藏、9,357 次浏览)表示,Teamwork Preview 在复杂项目上效果很好,因为多个代理加上验证优于单一循环;但在高强度设置下,同样的配置可能在 30 到 40 分钟内耗尽 Pro 五小时限额。这反而让赞誉显得更可信:这正是人们在某个功能有用到足以撞上真实天花板时才会发出的抱怨。
更广泛的易用性批评来自 @xdadevelopers,其 文章导语(23 个赞、10 次收藏、8,094 次浏览)链接到一篇 XDA 对比,文中认为 Antigravity 的队列和定时任务很有吸引力,但手动干预仍然需要跳到另一个 IDE 里。这也进一步凸显了当天的底层主题:委托能力在变强,但人类与系统混合接管的能力,仍是产品之间真正拉开差距的地方。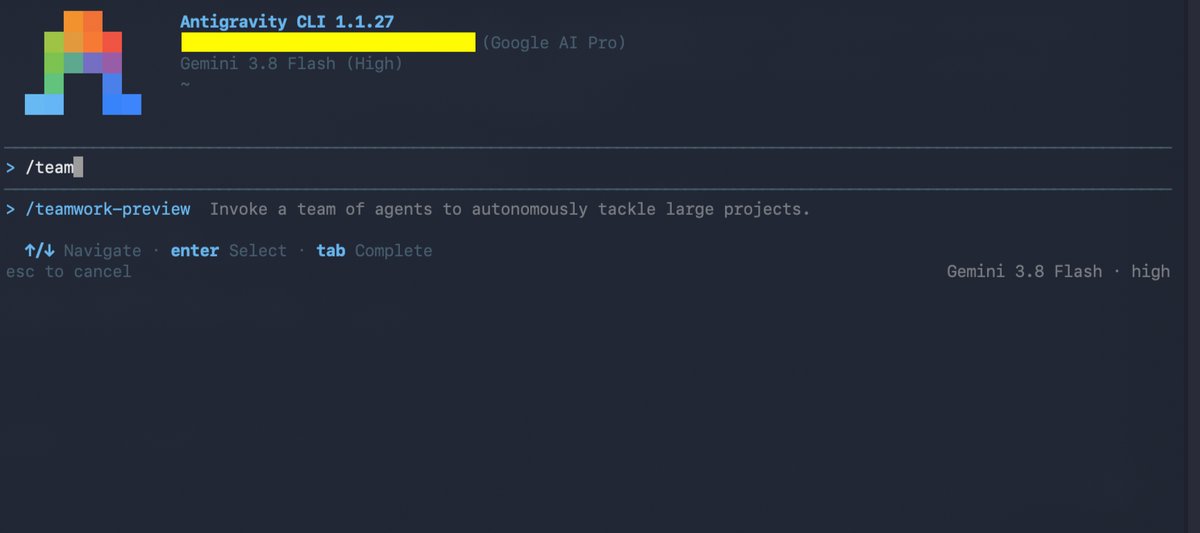
讨论洞察: 人们越来越接受排队和委派。现在剩下的主要摩擦点,是如何把控制权交还给人类:重排这个项目、置顶这个工作区、展示推理过程,并让我能在不打断上下文的情况下介入。
与前一天的对比: 9 月 11 日更多是在讨论 Antigravity 新近显露出的产品界面。到了 9 月 12 日,这些界面仍在视野之内,但讨论变得更偏运营层面:干预、人体工学,以及协作模式一旦真正有用之后会撞上的速率限制天花板。
1.3 路由、选择权与定价逻辑如今已成为产品本身的一部分(🡕)
第三个主题是,模型选择已不再只是能力之争。人们越来越多地根据编程工具是否保留供应商选择权、是否公开真实经济账,以及能否在一次昂贵运行开始前就把套餐逻辑讲清楚,来评估这类产品。
@GergelyOrosz 强调了(33 个赞、13 条回复、9 次收藏、5,357 次浏览)谈到他所说的 Claude Code 与 Codex 之间的巨大差异:Codex 允许用户选择任意模型,并保持其执行框架开源;而 Claude Code 仍是闭源,并与特定模型绑定。被引用的 Tibo 那段解释之所以重要,是因为它把产品逻辑说得很明白:如果更换模型提供商只需要改几行代码,那么强迫用户分叉就是不必要的额外负担,而公司希望这种选择权能被保留下来。
@thdxr 表示(148 个赞、14 条回复、2,659 次浏览)表示 OpenCode Go 已连续两周实现盈亏平衡,并将其视为一个里程碑,因为这一品类里太多产品不是在烧钱,就是在暗中依赖数据转售。回复则把成本可见性本身变成了一项功能:一位用户称赞 OpenCode Go 直接在主页展示预计用量区间,thdxr 则表示,随着他们部署自有 GPU,这些经济性还会进一步改善。
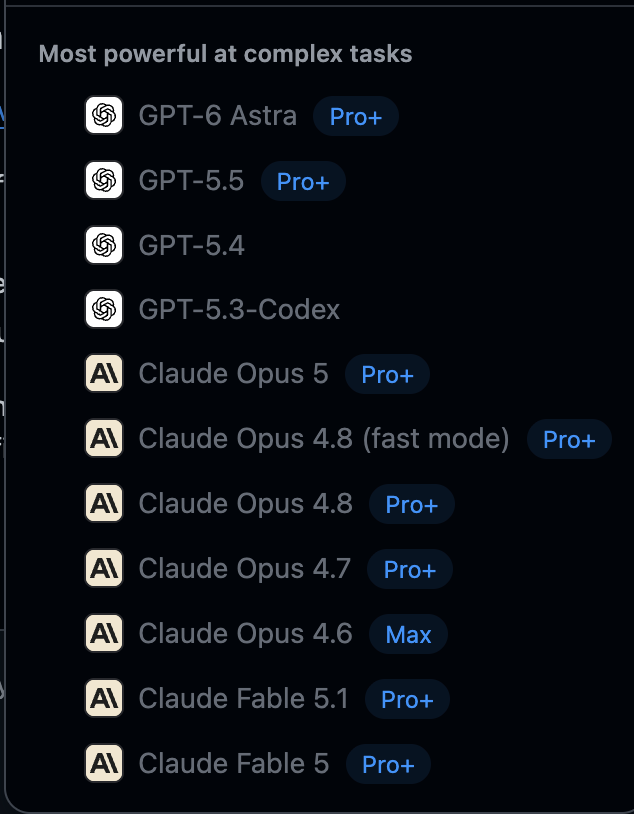
托管版的定价混乱也同样明显。@ex0t1clol 嘲讽了(14 个赞、1 次收藏、1,274 次浏览)展示了 GitHub Copilot 的模型选择器:Claude Opus 4.6 被放在 Max 套餐,而 Astra、GPT-5.5 和多个 Claude 变体则归在 Pro+。@0x_rody 警告称(7 个赞、1 条回复、2 次收藏、180 次浏览)指出,GPT-6 Astra 已被默认自动启用,并附上了最可能让团队意外的费率细节:输入 token 超过 272K 后会进入更高价档,另外还单独收取缓存写入费用。
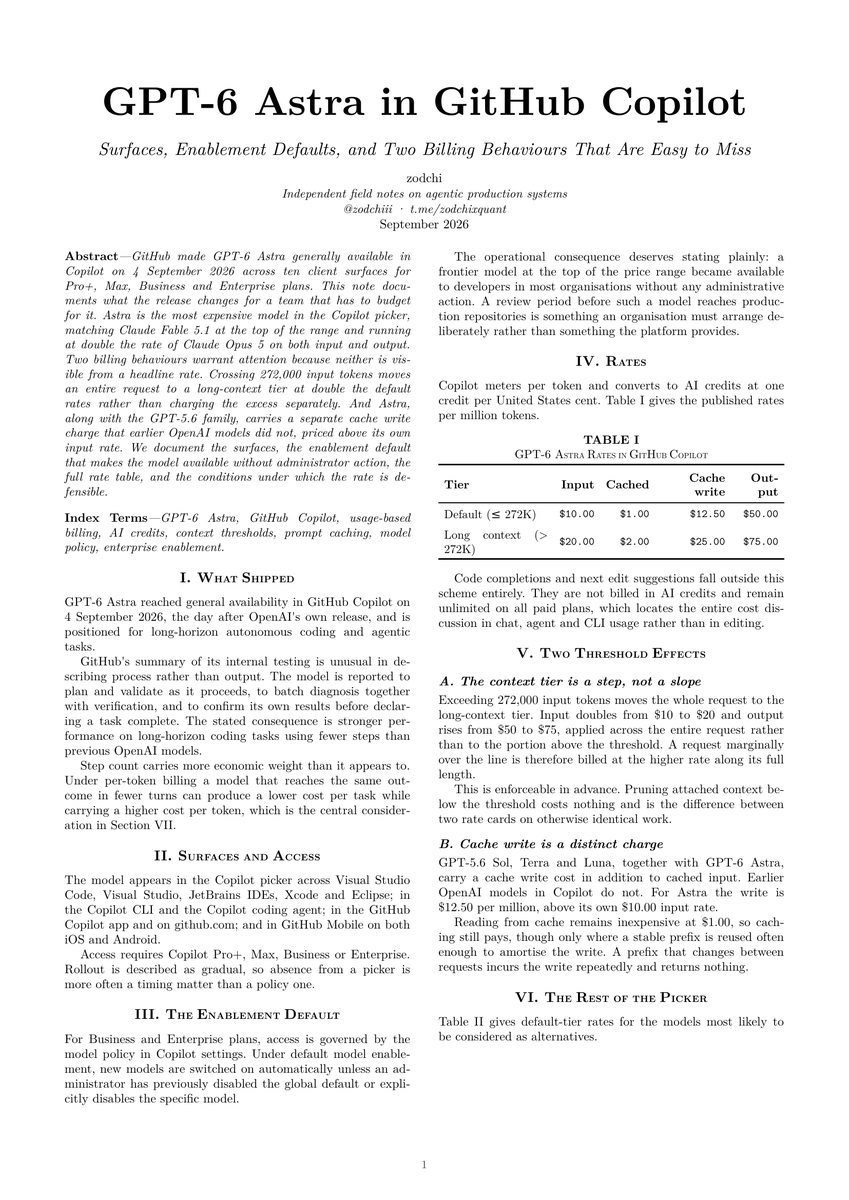
这条纠偏帖来自 @shantanugoel 指出(1 条回复、3 次收藏、129 次浏览),针对的是 Quesma 的 RTK 成本分析。他们的结论很直接:减少终端里看得见的输出,并不等于降低实际开销;在他们的基准测试中,DeepSeek 任务的平均成本反而上升了约 17%。这也很贴合当天整体的讨论脉络。用户奖励的是那些把成本结构揭示出来的产品,而不只是那些承诺“感觉更便宜”的产品。
讨论洞察: 路由越来越像基础设施一样被评判,而不是 UX 层面的装饰。人们想要的是选择权、偿付能力、可预测的配额,以及能在一次全仓运行开始前就讲清楚的定价。
与前一天的对比: 9 月 11 日让 Copilot 看起来像一层路由与定价层。到 9 月 12 日,这套逻辑已经扩展到 Copilot 之外:开放的执行框架、实现盈亏平衡的经济模型,以及清晰的用量展示界面,如今都像是更持久的差异化因素。
1.4 本地优先的记忆、开放后端与上下文约束正在汇合(🡕)
第四个主题是,越来越多有意思的工作发生在模型周边,而不是模型内部。持久化的本地记忆、可复用的工作区状态、API 兼容的开放后端,以及更好的上下文整理,开始一起构成同一套正在形成中的技术栈。
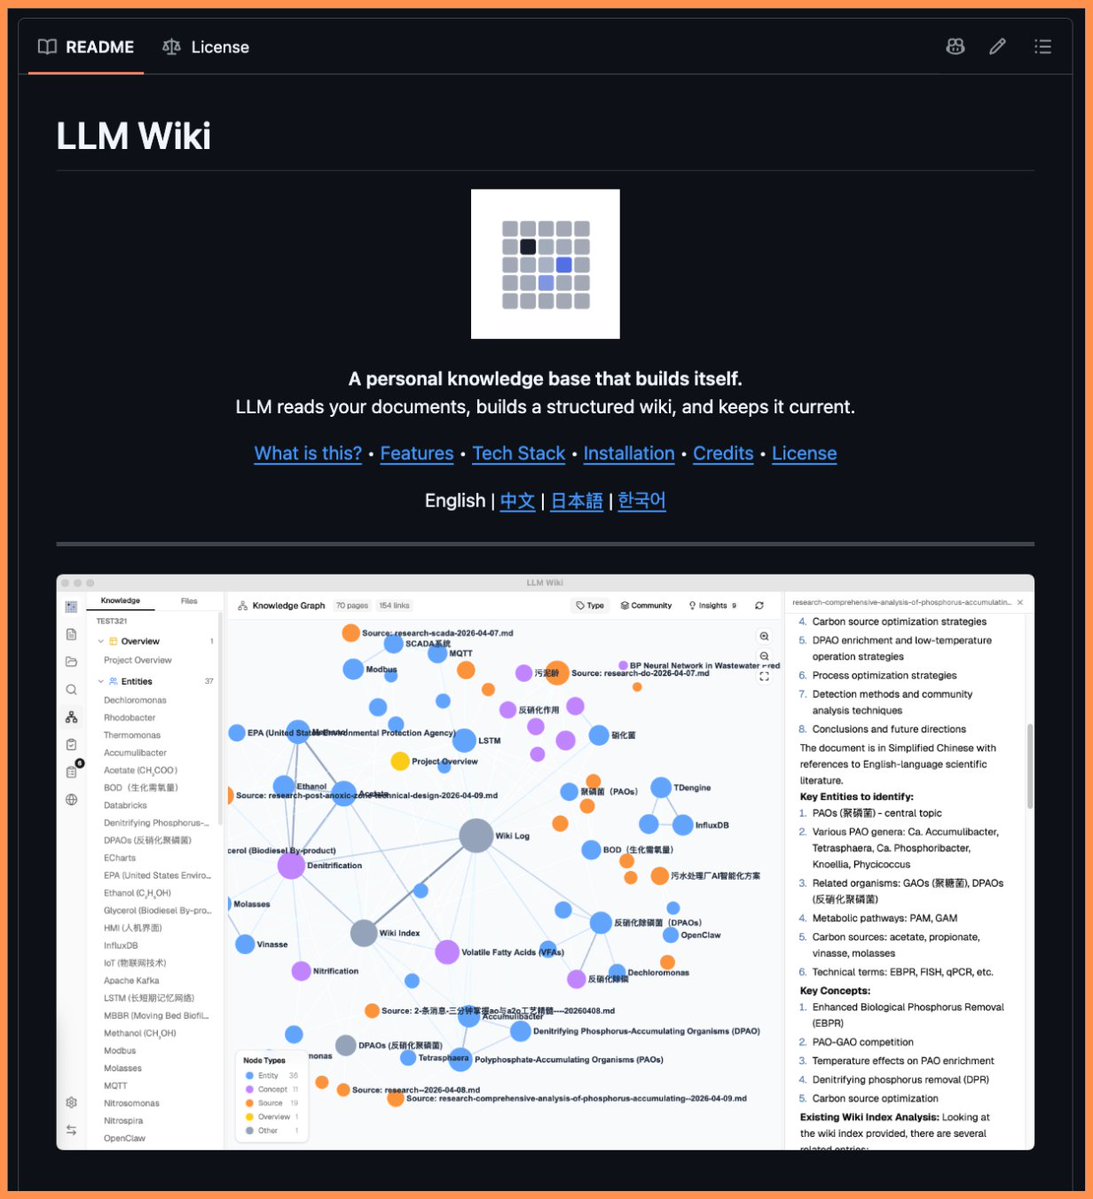
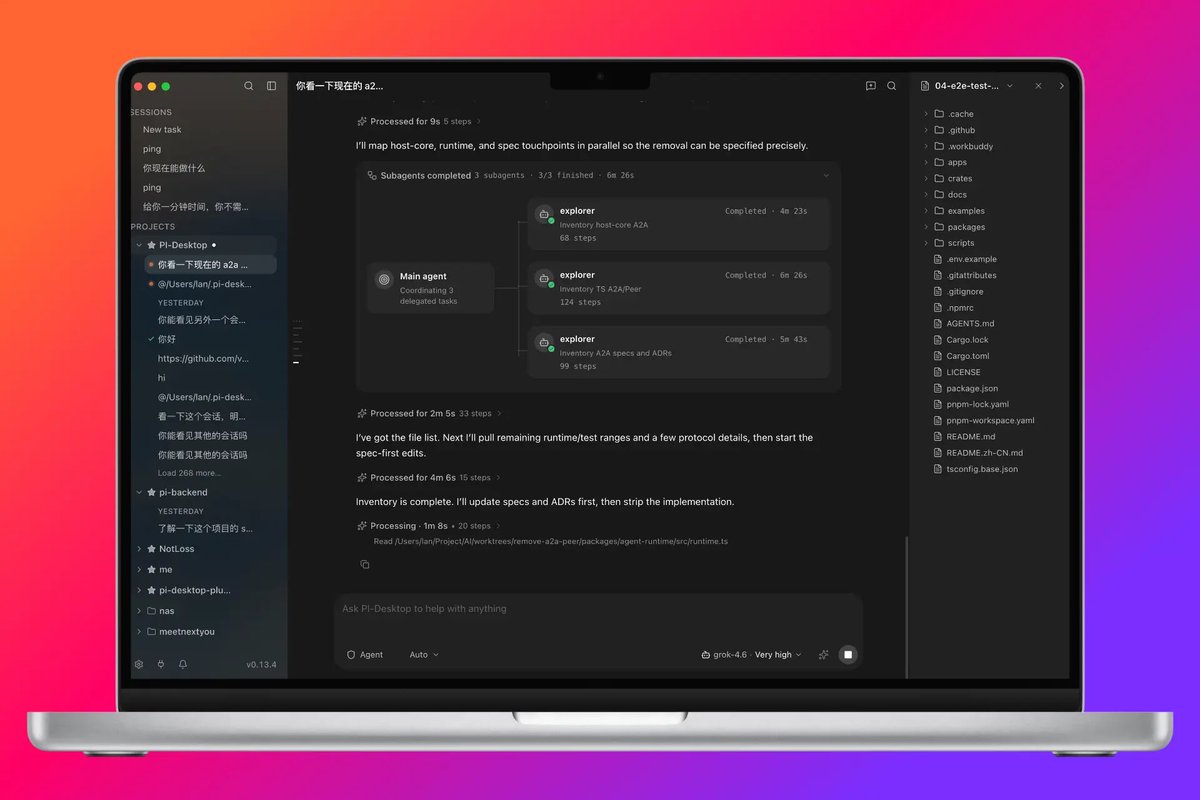
@hasantoxr 曝光了(27 个赞、6 条回复、25 次收藏、3,837 次浏览)介绍了 LLM Wiki:这是一款本地桌面应用,会从文档中逐步构建 wiki 和知识图谱,可作为 Obsidian vault 使用,并暴露一个 MCP 服务器,让 Claude Code 和 Codex 可以查询其中内容。@tonysimons_ 标出了(5 个赞,4 次收藏,527 次浏览)将 PI-Desktop 描述为一个本地优先的编码代理指挥中心:它能导入 Codex、Claude Code 和 OpenCode 的会话,同时支持 MCP、技能、子代理和插件。这两个项目都把长期上下文视为工作区问题,而不只是提示词问题。
同样的模式也出现在指令规范上。@Voxyz_ai 警告称(5 个赞,4 次收藏,412 次浏览)指出,适用于 Sol 或 Luna 的指令,可能会对 Astra 形成过度约束,因此切换模型时应审查 AGENTS 式规则和技能。@heyrimsha 翻译了(3 个赞,2 条回复,2 次收藏,230 次浏览)则把 Anthropic 的观点说得更直白:如果错误的文档、工具输出和历史记录都在争夺注意力,更大的上下文窗口也无法解决“上下文老化”问题。
开放后端进一步强化了这一趋势。@Oluwaphilemon1 认为(4 个赞,2 条回复,2 次收藏,252 次浏览)指出,在免费的 Kaggle TPU 算力上以 BF16 运行、并通过兼容 OpenAI 的 API 提供服务的 Qwen3.8-27B,可能会成为熟悉编码客户端的实用即插即用后端。问题不再只是“哪个前沿模型更强”,而是“在更换底层引擎时,我还能保留多少熟悉的代理用户体验?”
@iammukeshm 让(22 个赞,2 条回复,12 次收藏,578 次浏览)则从人的角度说明了同一论点:如果 AI 给了你 60 行可运行代码,而你却无法判断其中的身份验证是否安全,那么模型并没有消除工程判断的必要性,反而让周边工作流变得更重要。
讨论洞察: 竞争优势正转向记忆形态、工作区持久化、指令加载和后端灵活性——也就是代理外围的操作系统,而不是某一个最优模型。
与前一天的比较: 9 月 11 日已经显露出记忆整理和护栏的重要性。到了 9 月 12 日,这一点通过本地优先产品、开放模型后端,以及对模型特定指令漂移的直接警告,变得更加具体。
2. 什么最让人沮丧
不透明的配额、套餐层级逻辑,以及只有运行开始后才看得清的成本表述
最明显的挫败感,并不只是好模型要花钱,而是用户往往无法判断一项任务究竟会花多少钱、哪个套餐层级能解锁哪个模型,或者某项号称的优化是否真的降低了账单。@ai_for_success 展示了(193 个赞,16 条回复,38 次收藏,9,357 次浏览)展示了这个问题在实际使用中的表现:Teamwork Preview 好用到足以让用户在 30 到 40 分钟内就碰到 Pro 的五小时上限。@ex0t1clol 抱怨了(14 个赞,1 次收藏,1,274 次浏览)指出,Copilot 的模型选择器让套餐分级逻辑显得很随意;@0x_rody 附上了(7 个赞,1 条回复,2 次收藏,180 次浏览)则给出了一张具体的 Astra 费率表,显示了 272K 上下文的价格跃升,以及单独收取的缓存写入费用。
最尖锐的纠偏来自 @shantanugoel,后者通过 链接到(1 条回复,3 次收藏,129 次浏览)引用 Quesma 的 RTK 基准测试,论证“可见输出更少”并不等于“实际开支更低”。最正面的反例则是 @thdxr 庆祝(148 个赞,14 条回复,2,659 次浏览)提到的 OpenCode Go 盈亏平衡点,以及回复中清晰可见的 15 至 60 美元用量区间。严重程度:高。常见的应对模式是留在更便宜或更开放的后端上、手动盯用量,或采用第三方追踪工具,因为产品原生界面仍然遮蔽了太多计费机制信息。
委派能力更强了,但人工介入依旧别扭,权限边界也依然薄弱
第二个令人沮丧的问题是,代理工具在提升自主工作能力方面的进展,快于它们改进人工接管体验的进展。@rodydavis 整理了(163 个赞、38 条回复、33 次收藏、13,244 次浏览)直接提出了项目置顶、重新排序和推理可见性的需求。@xdadevelopers 链接到(23 个赞、10 次收藏、8,094 次浏览)则做了一个为期一个月的对比:虽然称赞了 Antigravity 的队列和定时任务,但仍批评用户需要跳到单独的 IDE 里手动干预。
同样的挫败感在安全层面也有体现。@dextns 认为(1 个赞、2 条回复、20 次浏览)指出,“读取”和“删除”权限仍然过于频繁地被绑定在一起,因此最安全的模式,是给代理提供数据副本、将观察与修改分离,并把每一次操作都记录在事后可供人工回查的地方。Hive 和 Agent Beacon 都说明,构建者也看到了这个缺口:团队想要的是串行写入、更清晰的审批机制和持久化日志,而不是一个无所不能的单一会话。严重程度:中高。当前主要的应对方式,是在代理之外额外加流程,而不是信任默认边界。
当人、提示词或默认设置出错时,生成的代码仍会悄然失败
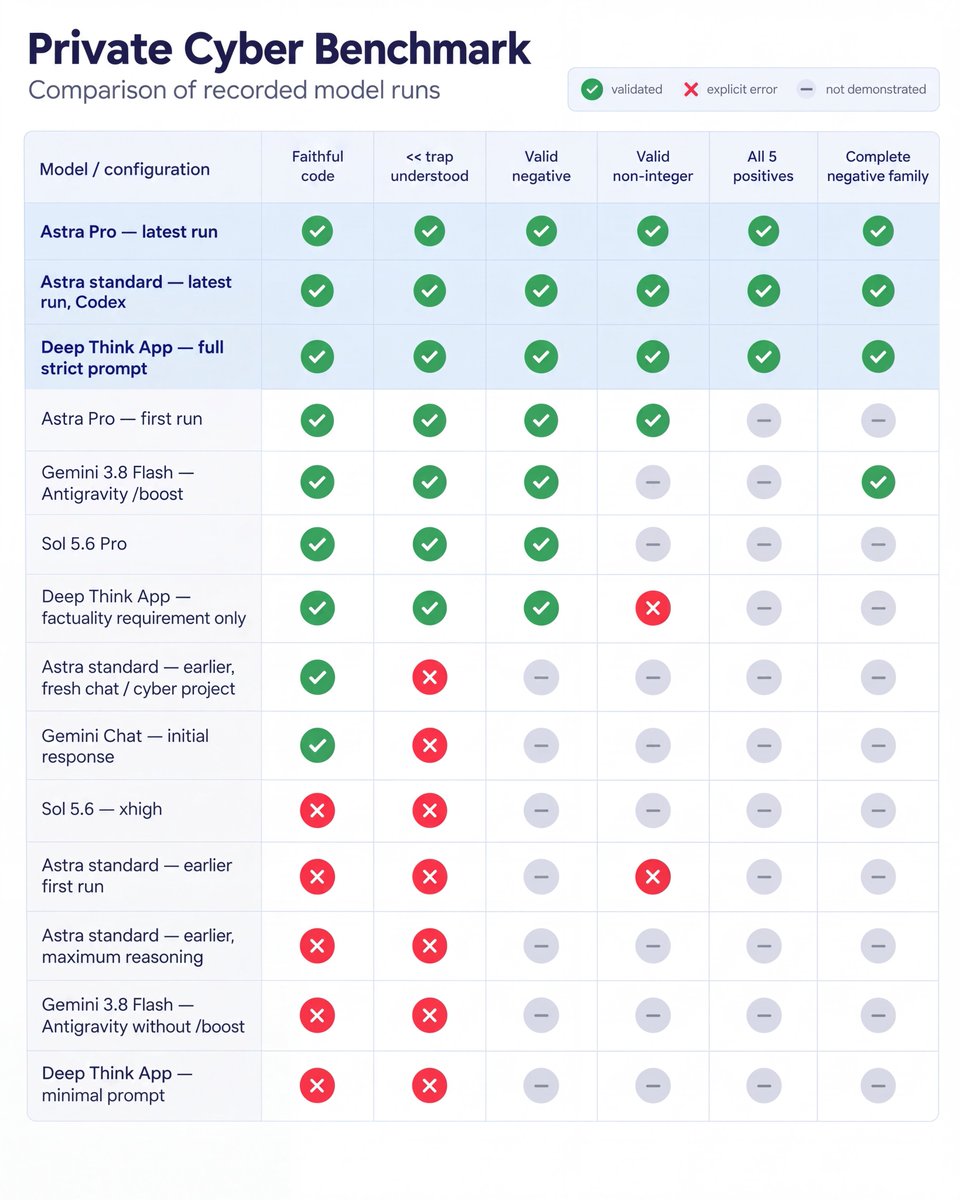
第三种挫败感没那么显眼,但可能更重要:模型可以产出看起来能用的结果,却依然会在判断上失手。@iammukeshm 把这件事说清楚了(22 个赞、2 条回复、12 次收藏、578 次浏览)举了个例子:AI 交给你 60 行看似可用的代码,但你仍无法判断认证是否安全,或者是否缺少验证。@Soso_fun_yt 分享了(7 个赞、2 次收藏、268 次浏览)则提到一个小型私有网络安全基准测试:同样的底层能力,会因为 /boost、提示词的严格程度以及明确要求的不同,而呈现出截然不同的表现。
@Voxyz_ai 补充说(5 个赞、4 次收藏、412 次浏览)指出了这个问题在模型切换时的另一种表现:对 Sol 或 Luna 有帮助的指导,可能会对 Astra 形成过度约束;而为某个模型精简提示词时,也可能删掉另一个模型仍然需要的测试命令或验收标准。

严重程度:对生产环境工作而言属于高,即便相关抱怨的数量少于配额讨论。应对办法是更严格的验收标准、更小的上下文、更多审查,以及更有经验的人类参与——这也正是为什么上下文工程、审计工具和工作流封装今天如此显眼。
3. 人们希望存在什么
能理解代理拓扑、而不只统计总 token 数的预算视图
成本讨论其实指向了一类相当具体的缺失产品。人们想要的不只是月度计量器,而是一个任务感知的预算视图,能显示究竟是哪个模型、子代理或长上下文决策即将让这次运行变贵。@ai_for_success 让 让 Teamwork Preview 中额度快速消耗的痛点变得具体可感,@0x_rody 曝光了 揭示了 Astra 隐藏的阈值,而 @thdxr 展示了 则说明了为什么可见的用量区间会受到欢迎。Bot Tracker 算是部分答案,但更广泛的需求仍然悬而未决。机会:直接。
将查看与变更分开的权限模型
@dextns 描述了 描绘了最清晰的理想形态:让代理以一种方式查看、以另一种方式变更;默认不要把它指向真实数据;并保留一条可供日后审查的操作轨迹。Git AI、Hive 和 Agent Beacon 关于可观测性的帖子,也从不同方向强化了同一个产品缺口。团队并不想要全有或全无的自主权;他们想要的是与真实工作流风险相匹配的权限边界。机会:直接。
面向特定模型的指令与上下文路由器@Voxyz_ai 警告说 和 @heyrimsha 展示了 表明,一个长期未被充分满足的需求依然存在:规则、技能和背景上下文,应随着当前使用的模型和工作所处步骤的不同,以不同方式加载。市场缺的不是另一个庞大的提示词模板,而是一个可靠的路由器,能为指令、示例、工具和文件分发到位,从而让工作流在从 Astra 切换到 Sol 再切换到开放模型时,不会悄然退化。机会:竞争激烈。
面向长时运行代理会话的混合工作区
Antigravity 的回复和 XDA 的对比显示,人们仍然需要更顺畅的人工接管界面:重排项目列表、置顶重要工作、检查推理过程、审阅差异,并且能在不来回切换多个彼此割裂界面的情况下介入。PI-Desktop 是目前最清晰浮现出的答案,但今天的讨论表明,这种需求并不只属于某一个产品。市场需要的是这样一种工作区:长时运行的会话、权限、文件和手动编辑都能留在同一个地方。机会:竞争激烈。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
Google Antigravity /teamwork-preview 和 /boost |
代理运行框架 | (+/-) | 多代理协作,外加验证、队列、定时任务、内联工件,以及改进后的 Git/终端界面 | 专业版用户称很快就会触及五小时限制,而且人工介入仍然分散在不同界面中 |
| Codex 开放框架 | 代理运行框架 | (+) | 支持任意模型,保持框架开源,并保留厂商可选性 | 经济性和治理表现仍取决于外围产品与运营者的选择 |
| GitHub Copilot + GPT-6 Astra | 托管式多模型层 | (+/-) | 覆盖面广、可用前沿模型,并提供更深入、由 Shell 支撑的代码审查 | 套餐层级混乱、默认启用、272K 上下文带来的价格跳档,以及缓存写入费用单独计费 |
| OpenCode Go | 开放模型订阅 | (+/-) | 用量区间可见,严守盈亏平衡,并明确披露经济性 | 长期可持续性和自托管 GPU 的经济账仍有待验证 |
| RTK | 输出压缩层 | (+/-) | 可减少可见冗余输出,并缩短部分循环 | Quesma 的基准测试显示,节省幅度微乎其微,实际成本甚至可能上升 |
| LLM Wiki | 记忆系统 | (+) | 持久化本地 Wiki、知识图谱、基于来源的页面、Obsidian 兼容性和 MCP 访问 | 在核心编码客户端之外增加了搭建和整理成本 |
| PI-Desktop | 本地优先工作区 | (+) | 将会话、文件、差异、权限、模型切换、插件和导入集中在一个地方 | 仍处于早期预览阶段,界面和 API 还在演进 |
| Hive | LLM 前置编排器 | (+) | 提供确定性闸门、面向队列的节奏控制、合并控制和多后端支持 | 分类器的边界情况仍需要人工判断和运维配置 |
| Agent Beacon | 遥测层 | (+) | 统一的跨运行时日志、本地 JSONL、SIEM 转发和持久活动轨迹 | 又增加了一层需要部署和维护的运行层 |
| 开放权重本地后端(Qwen3.8-27B、DeepSeek V4.1 Flash) | 推理后端 | (+) | API 兼容、算力更便宜或更易获得、预填充/吞吐快,且可接入熟悉的客户端 | 许多亮眼数字仍是发布时的宣称,而非独立审计;部署配置仍需投入 |
| 上下文工程与需求优先提示 | 方法 | (+) | 提高验证深度,减少上下文腐化,并让模型行为更易理解 | 容易对单一模型过度拟合,或用过多流程性指引把代理淹没 |
当天,用户对工具的满意度最高,往往出现在那些把真实运行情况展示出来、而不是藏起来的产品上。这也是为什么 Codex 的可选性、OpenCode Go 的可见用量区间、Hive 的确定性 LLM 前置流水线,以及 Agent Beacon 的标准化遥测,都被视为有意义的差异化,而不只是附带功能。
从方法论上看,讨论持续远离“提示词越大、模型越大越好”这种思路。@heyrimsha 翻译了(3 个赞、2 条回复、2 次收藏、230 次浏览)把 Anthropic 的上下文工程指导提炼成一条具体规则:在恰当的时刻加载恰当的文档、工具、记忆和消息历史,而不是一次性全都塞进去。@Soso_fun_yt 展示了(7 个赞、2 次收藏、268 次浏览)则从另一个角度印证了同一原则:在一项基准测试中,/boost 和更严格的需求,对结果的影响超过了单纯提高模型档位。

后端层面的变化同样重要。@MrAhmadAwais 声称(18 个赞、5 条回复、370 次浏览)称,Command Code 在该模型上线后的头 24 小时内提供了 3.1 万亿个付费 DeepSeek V4.1 Flash token;与此同时,@Oluwaphilemon1 认为(4 个赞、2 条回复、2 次收藏、252 次浏览)称,在免费的 Kaggle TPU 算力上运行 Qwen3.8-27B,并配合 OpenAI 兼容 API,可以更容易地把开放后端接入熟悉的代理客户端。即便对这些数字持谨慎态度,迁移趋势也已经很清楚:开发者想保留框架,同时替换引擎。

5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Hive | Hive Commons,由 @DanKornas 介绍 | 对 GitHub issue 和 PR 进行分流,然后通过确定性闸门把选中的工作派发给代理 | 在 LLM 介入之前,开源维护队列就已经变得混乱 | Go 二进制、Shell 闸门、Docker Compose/Podman、Claude/Copilot/Gemini/Goose 后端 | 已发布 | 推文(11 个赞、4 条回复、4 次收藏、861 次浏览)· 仓库 |
| Agent Beacon | Asymptote Labs,由 @agenticgirl 介绍 | 将不同运行时中的提示词、工具调用、文件变更、审批、错误和 token 用量统一归一 | 团队缺少一条可审计的统一时间线,来覆盖本地、浏览器、CI 和云端代理工作 | Endpoint 二进制、TypeScript SDK、OpenTelemetry schema、JSONL、SIEM 导出 | 已发布 | 推文(2 条回复、1 次收藏、43 次浏览)· 仓库 |
| LLM Wiki | nashsu,由 @hasantoxr 发现 | 基于源文档构建持久化的本地 wiki 和知识图谱 | RAG 会反复重读源材料,而不是维护持久、可导航的上下文 | 桌面应用、本地 HTTP API、Obsidian vault、MCP 服务器、agent skill、兼容多家提供商的模型端点 | 已发布 | 推文(27 个赞、6 条回复、25 次收藏、3,837 次浏览)· 仓库 |
| PI-Desktop | vastsa 贡献者,由 @tonysimons_ 发现 | 为编程智能体提供一个本地优先的工作空间,用于管理会话、文件、差异、审查和权限 | 智能体工作分散在终端、编辑器和托管标签页之间 | Electron、Rust 宿主核心、pi Agent Harness、插件、MCP/Skills/Subagents | 测试版 | 推文(5 个赞、4 次收藏、527 次浏览)· 仓库 |
| gstack | Garry Tan,由 @thegreatest_sv 发现 | 将 Claude Code 变成一支按角色分工的虚拟工程团队 | 单一通用智能体缺少可复用的专业化工作流 | 斜杠命令、Markdown、Bun、Node、Claude Code 角色与技能 | 已发布 | 推文(13 个赞、5 条回复、6 次收藏、140 次浏览)· 仓库 |
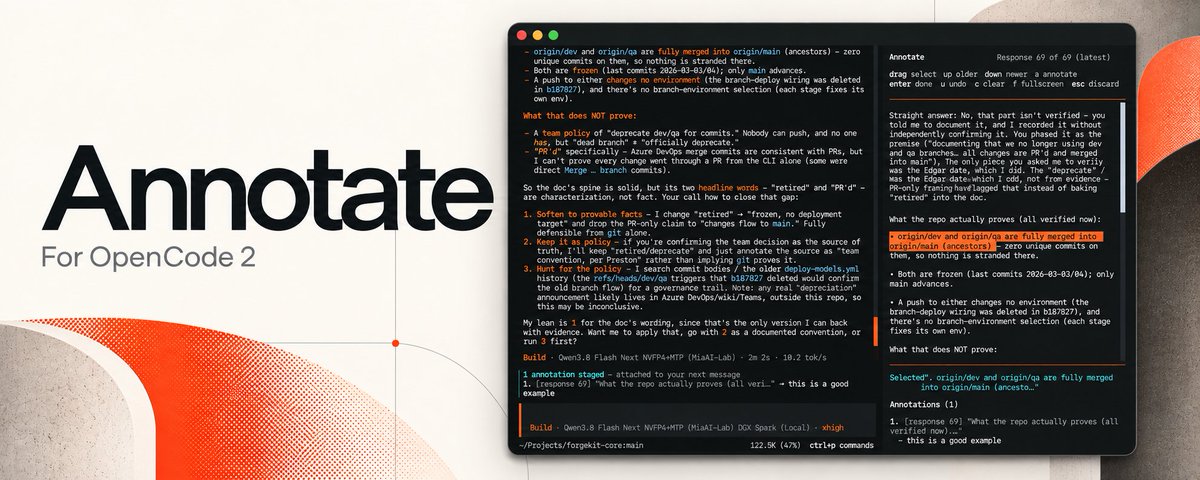
| Annotate for OpenCode 2 | @iamprestonlogan | 为助手先前回复中选定的文本片段附加评论 | 想通过一个新的自由格式提示词来纠正长对话内容时,容易丢失精确性 | OpenCode 2 插件;未说明具体实现技术栈 | 测试版 | 推文(2 条回复、15 次浏览) |
| Bot Tracker | @HumanPerson | 跟踪包括 Copilot 在内的 AI/API 提供商的用量、额度和重置时间 | 原生用量界面要么让人困惑,要么信息不完整 | iOS 应用和小组件;未说明具体实现技术栈 | 测试版 | 推文(1 个赞、1 条回复、1 次收藏、91 次浏览) |
| Lilydrift | @NickHirras | 一款小型涟漪配对游戏,在一个下午内就从规格说明走到部署上线 | 用来测试单个构建者是否能借助多个模型角色完成完整的产品闭环 | Claude、Claude Code、Gemini、Flutter、Flame、确定性回放测试、wasm、Cloudflare Pages、GitHub CI/CD | 已发布 | 推文(1 个赞、2 条回复、20 次浏览) |
工作流封装得最清晰的项目是 gstack。尽管它是通过一篇汇总帖进入视野的,但其底层仓库把这一点讲得很具体:专业角色、审查流程、QA 和发布步骤,正被开源成围绕现有智能体的一套可复用行为,而不再只是私有的提示词技巧。
LLM Wiki 和 PI-Desktop 则体现出第二个、而且更强的趋势:构建者正在把长期存在的本地状态产品化。前者把私有文档变成带引用的记忆,供智能体查询;后者则为会话、差异、权限和模型切换提供了专用工作空间,而不是让这些内容散落在终端窗格和托管标签页里。
Hive、Agent Beacon 和 Bot Tracker 分别从三个不同方向切入信任缺口。Hive 在智能体行动前对其工作施加约束。Agent Beacon 记录智能体跨运行时执行了什么。Bot Tracker 则把不透明的配额转换成便于人理解的计量方式。这个组合之所以值得注意,是因为它表明,构建者正在围绕智能体补上可观测性、策略和成本可见性,而不是试图取代智能体本身。


那些体量较小的产品案例同样很有启发。@NickHirras 描述了(1 个赞、2 条回复、20 次浏览)讲的是:用 Claude 编写游戏规格,用 Claude Code 实现,用 Gemini 生成图标,并在晚饭前通过 GitHub CI/CD 和 Cloudflare Pages 完成发布。@iamprestonlogan 已发布(2 条回复、15 次浏览)则是 Annotate for OpenCode 2,它解决了一个更小但真实存在的工作流问题:如何针对智能体长篇回复中的某个特定片段提出批注,而不必在下一轮把所有背景重新解释一遍。
6. 新鲜事与值得关注的动态
OpenAI 发布了迄今最清晰的公开衡量之一,展示从聊天转向智能体集群的变化
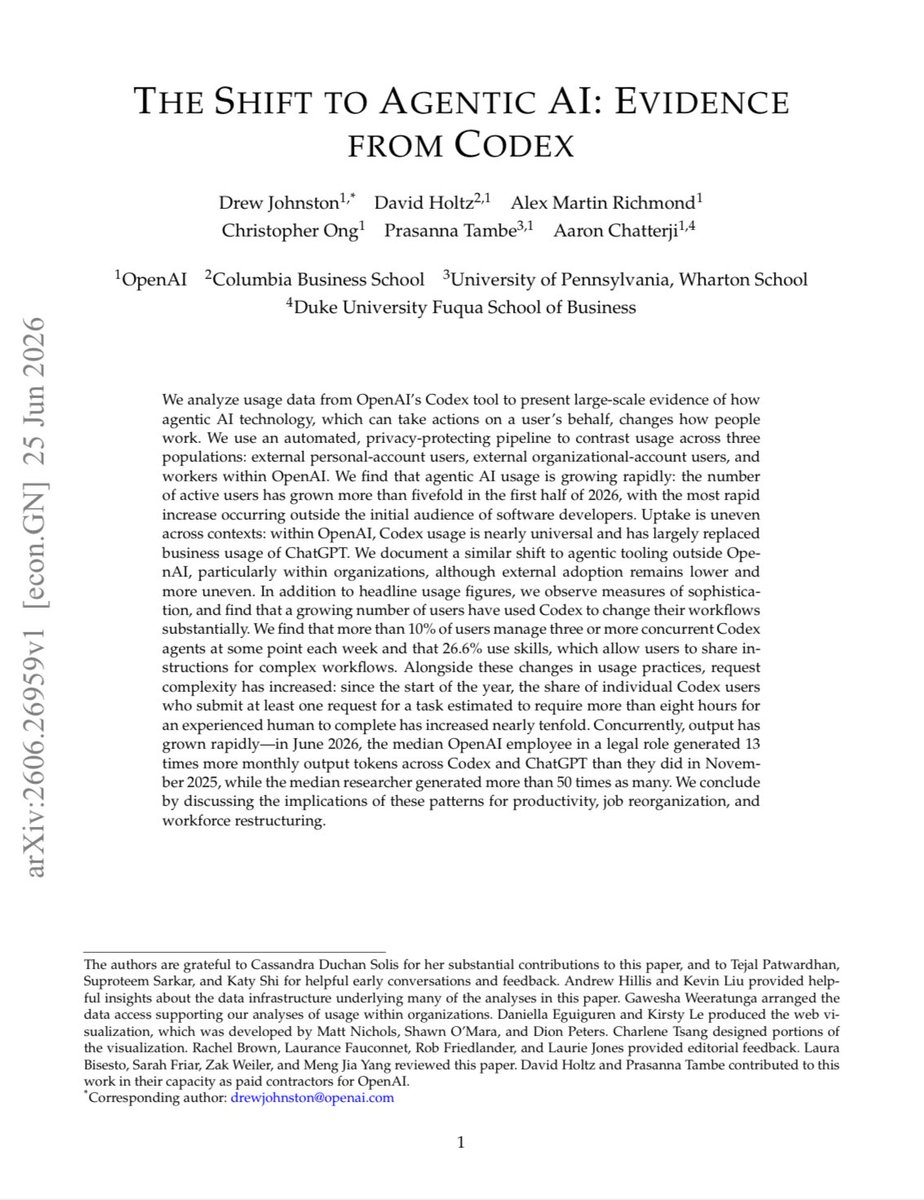
@beamnxw 强调了(13 个赞、6 条回复、8 次收藏、252 次浏览)OpenAI 的 论文《向智能体式 AI 转变:来自 Codex 的证据》。随附的第一页让核心结论可以直接核验:2026 年上半年,Codex 用户对智能体式 AI 的使用增长了 5 倍以上;超过 10% 的用户同时管理 3 个或更多并发智能体;26.6% 的用户使用 skills 在不同工作流之间共享指令。摘要还称,与 2025 年末相比,法律工作的产出中位数增长了 13 倍,研究工作的产出中位数增长了 50 倍以上。
GitHub 的托管式审查层在幕后变得更智能体化了
@GHchangelog 报道称(9 个赞、1 次收藏、1,257 次浏览)称,Copilot 代码审查现在会自动解决已处理的评论,并使用更多 shell 工具进行更深入的分析。抓取到的 GitHub 更新日志补充了一个更重要的细节:Lite 审查现在采用的是智能体组合,而不是单个智能体独立工作。这一点很重要,因为它表明,主流托管式审查正在转向独立开发者一直公开探索的同类模式:多智能体协作,以及有证据支撑的审查流程。
Google 与 Mechanize 的交易表明,护城河正在向聊天 UI 的上游迁移
@wallstengine 报道称(276 个赞、22 条回复、43 次收藏、31,750 次浏览)称,Google 已完成一笔超过 $1.5B 的人才与技术交易,相关招聘将加入 DeepMind 的 midtraining 工作。与其把这看成财务八卦,不如把它视为产品信号:如果资金流向的是 midtraining、编码能力改进和评估人才,而不是另一个表层封装,那么竞争优势就正在向上游迁移,进入那些在用户打开工具之前就决定智能体质量的系统。
7. 机会在哪里
[+++] 可观测的贡献与审计层 — Git AI 的公告、Copilot 更深入且由 shell 支撑的审查、Hive 的确定性门禁,以及 Agent Beacon 的遥测,都指向同一个缺口:团队想要一份持久记录,说明智能体改了什么、如何验证结果,以及人工批准的边界落在何处。这一信号很强,因为同一天里,前沿实验室、平台厂商和小型开发者都发出了同样的需求信号。
[+++] 成本感知型智能体运营 — Antigravity 配额消耗过快、Copilot 令人困惑的分层逻辑、Astra 隐藏的阈值、OpenCode Go 可见的用量区间、Bot Tracker 的小组件,以及 Quesma 的 RTK 基准测试,都反复显示出对运行前预算预估和按工作流查看成本的需求。这一机会很强,因为痛点具体、反复出现,而且已经催生出各种变通型产品。
[+++] 面向特定模型的指令与上下文路由器 — Voxyz 对 Astra 的警告、Anthropic 关于上下文工程的指导,以及 Soso 基准测试,都表明默认设置和提示词组织方式可能主导结果质量。这一机会很强,因为即便是高级用户,也在发现质量断崖往往来自指令残留、上下文衰减或缺少验收标准,而不是模型原始能力不足。
[++] 按权限拆分、支持审查的自主执行 — dextns、Hive 和 Agent Beacon 共同勾勒出一种真实的产品形态:将读取权限与写入/删除权限分开,默认关闭实时数据,并记录每一步操作以供事后审查。需求明确且务实,但产品采用看起来仍处于早期。
[++] 本地优先的工作区与持久化记忆 — LLM Wiki、PI-Desktop,以及围绕 Qwen 和 DeepSeek 的开放后端讨论,都表明这类产品仍有空间:既保留本地状态、可移植会话和后端灵活性,又不放弃现代智能体体验。这个信号中等偏强,因为多种不同方案已经开始浮现,但使用证据仍然偏早期。
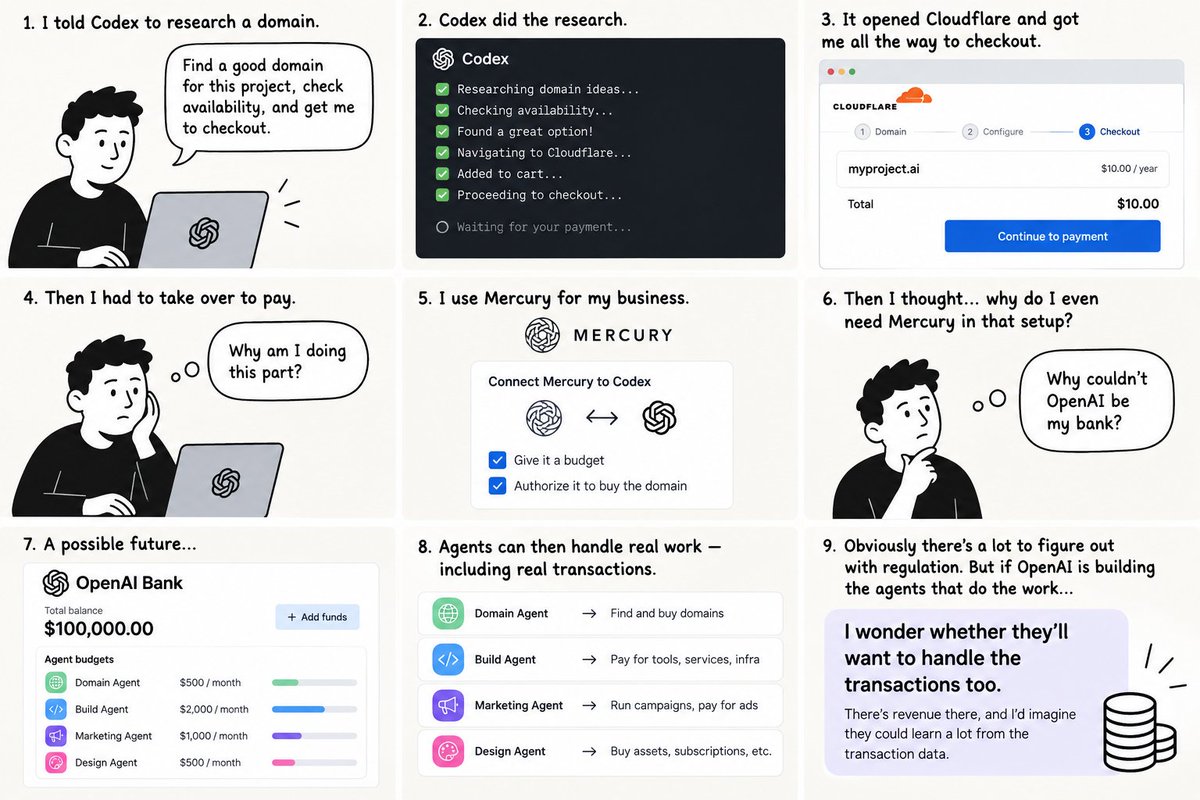
[+] Budgeted transactions and agent commerce — @reeder1865 设想了(3 个赞、1 条回复、2 次收藏、60 次浏览)提出了一个“OpenAI Bank”:此前 Codex 已经进入 Cloudflare 结账页面,而在这种设想里,不同智能体会分别获得用于不同领域、构建工具和账单的独立预算。这仍属推测,但它异常具体地展示了:如果智能体继续承担真实的运营工作,委托式支出控制可能会如何演进。
8. 要点
1.讨论已经超越了单纯的代码生成,进入可观测性层面。 Git AI 招聘、Copilot 依托 shell 的代码审查改动、Hive 和 Agent Beacon,都把归因、可审计性和证据视为产品功能,而不是可有可无的治理层。(来源;来源;来源) 2. 实用的多智能体工作流,如今触及运营天花板的速度,已经快于触及能力天花板的速度。 对 Teamwork Preview 的称赞伴随着对五小时限制的抱怨;而围绕 Copilot 套餐的困惑、Astra 的定价细节以及对 RTK 的质疑,则表明成本透明度如今已是产品质量的核心组成部分。(来源;来源;来源;来源) 3. 开放式运行框架和可替换后端获得了真正的可信度。 Codex 的可选性、OpenCode Go 对盈亏平衡的推进、PI-Desktop 与提供商无关的工作区,以及围绕 Qwen TPU 的讨论,都指向这样一个未来:开发者保留工作流,同时更换其底层模型。(来源;来源;来源;来源) 4. 提示工程正在演变为运营级的上下文设计。 今天最重要的质量经验,集中在上下文路由、验收标准以及针对不同模型保持指令规范,而不只是选择一个更聪明的模型。(来源;来源;来源) 5. 构建者正在填补模型周边的空白,而 Codex 论文表明这是一种结构性趋势。 LLM Wiki、PI-Desktop、Hive、Bot Tracker、Annotate 和 Lilydrift,都位于原始模型体验之上或其周边;与此同时,OpenAI 的 Codex 论文显示,多智能体和技能的使用增长速度已经快到足以支撑这一新工具层的合理性。(来源; 来源; 来源; 来源; 来源; 来源)