Twitter AI 编程 - 2026-09-13
1. 人们在讨论什么
1.1 Harness 正在成为产品载体(🡕)
最高信号的讨论又进一步偏离了“哪个基础模型最好”,转向负责循环、路由、约束和修复智能体工作的那一层。5 条彼此独立的高信号内容都将 harness,而不是模型,视为更持久的资产:它是工具、记忆、审批、上下文压缩和可重复工作的控制平面。
@gregisenberg 认为 (59 个赞、10 条回复、97 个收藏、3,489 次浏览) 表示:“智能体 harness 正在成为新的 GPT 封装层。”其对 harness 的定义是:让模型能够一步步持续工作的那一层,为它提供工具、管理长期记忆,并决定何时必须停下并向人类求助。回复没有停留在泛泛认同,而是补充了具体实现细节:@ragzoi 将 harness 称为工具 ACL、记忆写入、停止规则、模型路由和纠错循环的“控制平面”;@leononrails 则表示,真正的核心在于“停下并向人类求助”,而不只是跨模型路由。

@Trylions 表述为 (3 个赞、2 条回复、221 次浏览) 将 OpenAI 的 Agents API 称为“作为产品的 Codex harness”,并列出托管会话、编排、上下文压缩、工具搜索、子智能体、故障恢复和环境选择,认为这些才是真正的产品价值。附图通过把系统拆分为应用层、托管的 Agents API 会话层,以及实际执行命令和操作文件的沙箱,让这种产品化封装变得一目了然。
@arkyyang 翻译了 (2 个赞、2 条回复、33 次浏览) 将全新的 Ecdysis 论文 转化为面向产品构建者的建议:只修补那些跨任务反复出现的故障;将诊断与编辑分离;用更便宜的模型来演进共享脚手架。论文附带的基准表格之所以重要,是因为它是当天少数几个明确旨在改进运行时 harness 本身、而非基础模型的具体研究成果之一。
讨论洞察: 关于 harness 的讨论始终停留在操作层面。人们点名需要改进的是权限、记忆写入、停止条件、故障诊断和恢复行为,这与泛泛而谈“更好的编程 AI”有明显不同。
与前一天相比: 9 月 12 日的重点是围绕智能体的可观测性、归因和代码审查深度。到 9 月 13 日,讨论又深入了一层:harness 本身开始成为被销售、被打包,甚至被训练的产品。
1.2 工作空间正在为多智能体执行而重构(🡕)
第二个主题是,团队已不再把编辑器窗口视为全部环境。浏览器工作空间、任务级 worktree、Kubernetes 工作负载,甚至面向智能体的操作系统,都在回答同一个问题:如何让多个智能体同时推进,而不丧失可审查性,也不污染代码库?
@bridgemindai 表示 (111 个赞、40 条回复、22 个收藏、4,500 次浏览) 表示,尝试 Omarchy——一个“为 AI 智能体和 vibe coding 打造”的 Linux 发行版——可能会改变他在一辈子使用 Mac 之后的开发方式。兴趣确实存在,但回复也更尖锐:点赞最高的质疑是,如果 Codex 缺乏 Linux 电脑操作能力,而 Claude 在 Linux 上的应用支持也有限,那么所谓“为 AI 智能体打造”的 Linux 究竟能做到什么程度?
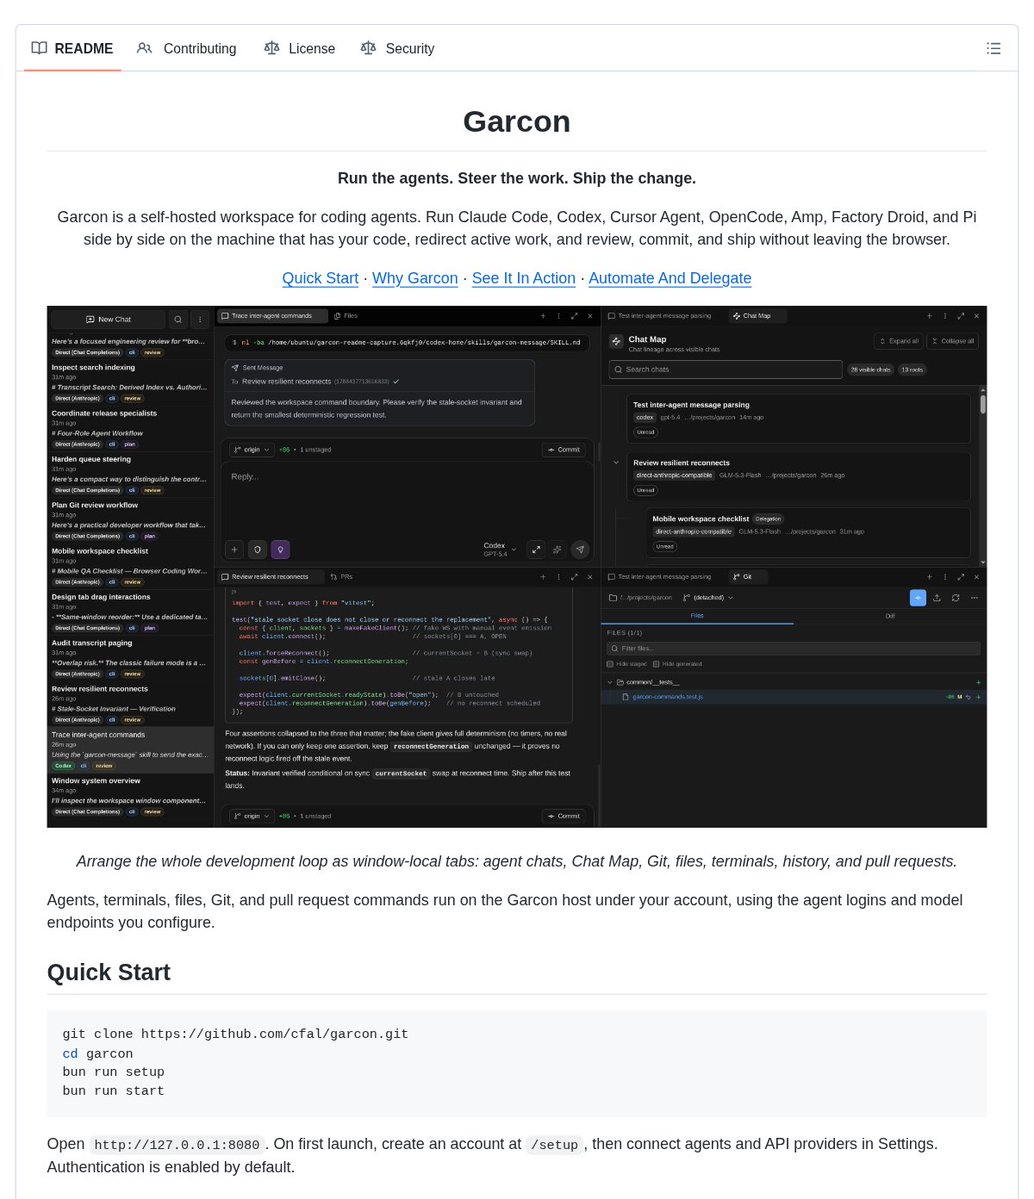
@DanKornas 介绍了 (8 个赞、4 条回复、664 次浏览) 介绍了 Garcon:一个自托管的浏览器工作空间,可让 Claude Code、Codex、Cursor Agent、OpenCode、Amp、Factory Droid 和 Pi 与终端、文件、Git 以及拉取请求控制并排运行。在公开的 Garcon 仓库 中,它被描述为一个 TypeScript/Bun 工作空间,把委派结果、聊天谱系、文件、终端和 Git 集中展示,而不是分散在不同工具之间。
@undefinedKi 总结道 (4 个赞、2 条回复、4 个收藏、119 次浏览) 展示了一套 Conductor 工作流:每项任务都有自己的 worktree,审查留在 PR 评论里,而不是通过临时改动完成;合约或接口则被标记为由人类负责。附带的一页纸说明相当具体:每个任务一个 worktree,同时打开 4 个 PR,并划出一块受保护区域,智能体可以提议修改,但在合并前仍由人类逐行审查。

同样的运行问题在基础设施层也出现了。@DanKornas 还介绍了 (2 个赞、2 条回复、456 次浏览) 介绍了 Kelos;公开的 Kelos 仓库 将其描述为一个 Kubernetes 原生框架,把智能体变成 Tasks、Sessions、Workspaces 和 AgentConfig 资源,而不是让它们继续跑在开发者笔记本上。
讨论洞察: 一致的诉求并不是抽象意义上的更高自主性,而是可操控性:隔离任务、保留谱系、让审查留在 diff 和 PR 里,并且清楚知道哪段对话触及了哪处改动。
与前一天相比: 9 月 12 日的讨论集中在现有产品里的人工介入和工作流限制。到 9 月 13 日,更多由构建者提出的答案开始浮现:新的工作空间、新的编排层,甚至面向智能体的新运行环境。
1.3 配额和计费摩擦仍是一线阻碍(🡒)
最持续的负面信号与本周早些时候相同:人们相信有能力很强的工具存在,但他们并不信任围绕这些工具的配额、重置和计费界面。9 月 13 日的 3 条独立投诉,从不同层面展示了同一个问题:配额耗尽、重置后体感变差,以及支付失败后的恢复问题。
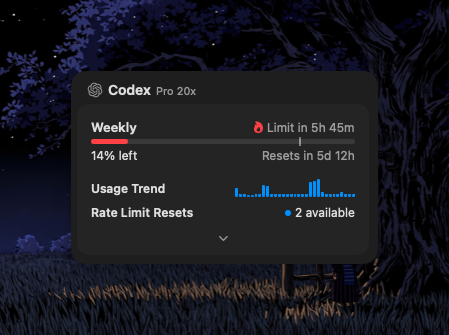
@bil0090 提到 (61 个赞、16 条回复、2,285 次浏览) 表示,最近一次重置后,同样的 Codex 工作流现在运行更慢,而且使用量消耗速度比之前快得多。附带截图让这一投诉更有依据:Codex Pro 20x 的周配额条只剩下 7%。
@buildwithrajath 询问 (38 个赞、18 条回复、1,412 次浏览) 询问 OpenAI 是否“又把 Codex 削弱了”,称 Astra 的限制已经非常严苛,而 Sol 现在在只完成几项真正严肃的任务后也像是被迅速耗空。@therealmc92 补充道 (1 条回复、145 次浏览) 则从计费运营角度描述了同一个问题:一次信用卡交易失败后,账户似乎直接失去了 20x ChatGPT Pro 套餐,而且没有任何宽限期来处理扣款。
@melvindvivas 关联到 (54 个赞、10 条回复、84 个收藏、4,171 次浏览) 把配额问题直接与其他开发者正在使用的产出联系起来,表示自己现在很大一部分 Codex 时间都用在维护开源智能体工具上,并询问 OpenAI 是否能帮助支持这项工作。这条投诉之所以引发共鸣,是因为它附带了具体的公开仓库,而不是笼统地表达不满。
讨论洞察: 人们的不满并不只是“AI 太贵”。他们反对的是不可预测性:重置后体感比以前更差、支付问题会让套餐直接消失,以及使用上限让持续性的维护工作越来越难以 justify。
与前一天相比: 9 月 12 日已经出现了对模型分层和速率上限的担忧。到 9 月 13 日,成本问题变得更偏操作层面:维护工作、账户恢复以及重复性工作流的可靠性,都浮现为阻碍。
1.4 有用的上下文正越来越多地被打包成地图、技能和套件(🡕)
关于上下文的讨论继续从“写一个更好的提示词”转向交付可复用结构,以压缩搜索、工具发现和平台知识。共享代码图谱、技能注册表和可安装云套件都指向同一种模式:重要的不只是更多上下文,而是被更好打包的上下文。
@kv1nsiii 推荐 (20 个赞、7 条回复、16 个收藏、566 次浏览) 介绍了一个“地图、方法和目录”栈:CodeGraph 用于共享本地索引,HumanLayer 用于上下文工程工作流,Clawhub 用于打包技能和插件。公开的 CodeGraph 仓库 将其描述为一个 100% 本地的图谱,可接入 Claude Code、Codex CLI、Gemini CLI、Antigravity、Cursor 和 GitHub Copilot,在文件变更时自动同步,并提供浏览器 UI;回复很快聚焦到过期符号如何处理,以及图谱检索是否真能减少来回翻文件。
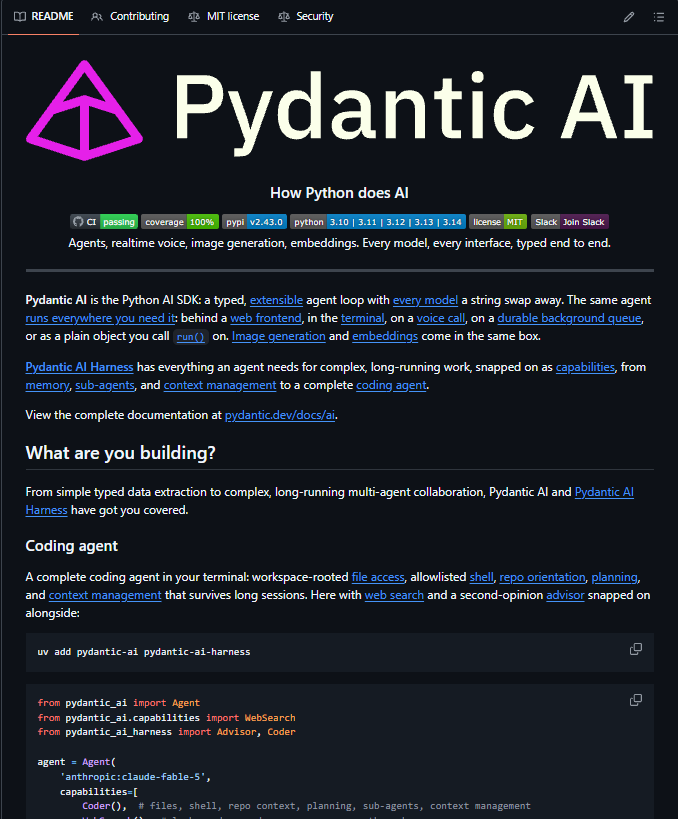
@Shruti_0810 整理了 (34 个赞、16 条回复、42 个收藏、2,344 次浏览) 将一套更广泛的开源技术栈——Browser Use、OpenHands、OpenClaw、Computer Use、Codex、Pydantic AI、LangGraph、MCP 服务器、Letta 和 CrewAI——称为让智能体“真正有用”的那些仓库。附带截图让这一点更具体:它展示了 Pydantic AI 的类型化智能体接口,以及 Codex CLI 的本地智能体定位,而不是又一张抽象清单。
@DivyanshT91162 认为 (12 个赞、4 条回复、11 个收藏、1,243 次浏览) 表示,Google Cloud 新推出的开发者插件给智能体提供的是整套能力包,而不是一堆松散的文档和工具。在公开的 Google Cloud 公告 中,Google 表示,google-cloud-developer 插件遵循开放的 Agent Plugins 规范,将认证、授权、项目管理、gcloud 护栏,以及基于官方文档的 Developer Knowledge MCP grounding 打包在一起。
讨论洞察: 仅仅打包还不够。回复不断补充相同的限定条件:重试、审批步骤、清晰的失败路径和安全执行,仍然决定了一项打包能力是否够得上生产可用。
与前一天相比: 9 月 12 日更多讨论的是上下文纪律和针对特定模型的指令卫生。到 9 月 13 日,重点变成了分发:可跨工具复用的索引、注册表和可安装的能力套件。
2. 什么让人沮丧
配额重置、套餐断崖和计费恢复让人难以信任
最强烈的挫败感来自操作层面,而不是概念层面。用户并没有争论 Codex 或 Astra 能不能做有用的工作;他们是在说,同样的工作流如今更难持续,因为配额消耗更快、重置后体感更差,而计费失败又没有安全的恢复窗口。@bil0090 提到 (61 个赞、16 条回复、2,285 次浏览) 表示,过去能维持 3 到 4 天的同一套 Codex 工作流,如今在重置后会快得多地烧掉额度;与此同时,@buildwithrajath 询问 (38 个赞、18 条回复、1,412 次浏览) 询问 Astra 和 Sol 是否都实际上被削弱了。@therealmc92 补充道 (1 条回复、145 次浏览) 则表示,一次信用卡交易失败似乎让他们的企业账户直接掉出了 20x ChatGPT Pro 套餐,而且没有宽限期来处理扣款。
这之所以严重,是因为它打击的是那些在做可重复、接近生产环境工作的用户,而不是只做一次性演示的人。@melvindvivas 明确关联到 (54 个赞、10 条回复、84 个收藏、4,171 次浏览) 将使用上限与维护其他开发者依赖的开源基础设施直接挂钩。数据中可见的主要应对方式包括:在不同套餐和模型之间切换、更多依赖开源或本地工具,以及对严肃任务配给式使用。值得投入建设:高,因为这里抱怨的不是单纯价格敏感,而是成本可见性、账户状态恢复,以及对持续使用的信心。
如果没有隔离、来源追踪和重定向控制,多智能体协作仍会失序
第二个挫败点是,并行智能体很容易启动,但一旦开始触碰同一个代码库,就很难保持清晰可读。@undefinedKi 总结道 (4 个赞、2 条回复、4 个收藏、119 次浏览) 介绍了一套以“每项任务一个 worktree、仅通过 PR 审查、保留人类负责区域”为核心的流程,原因正是“两个智能体共用一个工作目录”会让冲突从那里开始。@DanKornas 将其定位为 (8 个赞、4 条回复、664 次浏览) 围绕 Garcon 的表述也指向同样的痛点:如果不能在运行过程中重定向任务、查看委派谱系,并且不离开工作空间就完成 diff 审查,那么平铺聊天窗口本身并不够。甚至那条积极尝试 Omarchy 的帖子——@bridgemindai 绘制了 (111 个赞、40 条回复、22 个收藏、4,500 次浏览)——也立刻收到回复,质疑 Linux 智能体工作流是否已经具备合适的电脑操作支持。
人们的应对方式,是在模型之外增加明确流程:隔离分支、让每项任务都走 PR、保护由人类负责的文件,并把编排移入 Garcon 或 Kelos 之类的工具。这本身就很能说明问题。需求并不是更高的裸自主性,而是更安全的并发。值得投入建设:高,因为多条彼此独立的帖子都收敛到同一个缺失的控制界面。
在“简单”任务上,默认行为仍然过于脆弱
第三个挫败点是,模型和智能体看起来可能很能干,但只要提示词、路由或检索层定义不足,它们仍会悄无声息地失败。@Soso_fun_yt 分享了 (8 个赞、315 次浏览) 展示了一个简洁的网络安全基准:Antigravity 中的 Gemini 3.8 Flash 在没有 /boost 的情况下错过了核心难点,而更严格的提示词和验证要求则显著改变了 Deep Think、Astra 和 Sol 的结果。@kv1nsiii 做出了 (20 个赞、7 条回复、16 个收藏、566 次浏览) 则给出了代码库版本的同类抱怨:如果没有先提供地图、方法和目录,智能体仍会为了回答一个问题去打开“40 个文件”。对 @Shruti_0810 补充道 (34 个赞、16 条回复、42 个收藏、2,344 次浏览) 的回复则指出,权限、重试和清晰的失败路径,才是演示级技术栈与可靠技术栈之间的分水岭。
可见的缓解模式非常一致:预先为代码库建立索引、收紧验收标准、加入结构化技能或插件,并在诊断与编辑之间保留人工审查环节。值得投入建设:中高。需求真实存在,但这个领域已经相当拥挤,因为 CodeGraph、Pydantic AI、Browser Use 以及各种打包技能系统,都已经在试图解决其中的一部分。
3. 人们希望存在什么
具备预算意识的智能体控制平面
最响亮的实际需求并不是抽象地“让它更便宜”,而是“在我提交运行之前,让成本界面变得可理解”。@bil0090 展示了 (61 个赞、16 条回复、2,285 次浏览) 描述的是一次重置后再也无法保留同样工作余量的情况;@buildwithrajath 询问 (38 个赞、18 条回复、1,412 次浏览) 询问配额是不是被“核平”了;@therealmc92 想要 (1 条回复、145 次浏览) 则提出了一个最基础的诉求:支付受阻后至少该有宽限期。这是一项实际而紧迫的需求。本地/开源工具和模型切换方案提供了部分答案,但真正缺失的产品是一张实时预算地图:在工作开始前就能理解长会话、子智能体、重置以及计费状态。机会:直接。
一种可审查地同时运行多个智能体的方法
第二个愿望,是让多智能体工作在真实负载下仍保持可理解。@undefinedKi 推荐 (4 个赞、2 条回复、4 个收藏、119 次浏览) 提出了独立 worktree、仅通过 PR 审查,以及由人类负责的代码区域;@DanKornas 构建了 (8 个赞、4 条回复、664 次浏览) 围绕 Garcon 讨论的是可见协同和运行中操控;@DanKornas 将其定位为 (2 个赞、2 条回复、456 次浏览) 则把 Kelos 视为那些不希望智能体驻留在笔记本上的人的基础设施答案。这是一项实际需求,紧迫性为中高:工作已经在发生,但运行界面仍高度依赖临时拼装。Garcon、Kelos 和 Conductor 式工作流今天都只能部分解决它。机会:直接。
即插即用的能力套件,而不是手工拼装的配置
多条帖子都暗示,人们希望智能体在交付时就已经把正确的地图、工具和文档连接好。@kv1nsiii 表示 (20 个赞、7 条回复、16 个收藏、566 次浏览) 表示,智能体需要“地图、方法和目录”;@DivyanshT91162 强调了 (12 个赞、4 条回复、11 个收藏、1,243 次浏览) 则将 Google 的 google-cloud-developer 插件描述为一个可安装的单一套件,涵盖认证、项目管理、gcloud 操作和官方文档。这更多是实际需求,而非情绪诉求;紧迫性为中等,因为 CodeGraph、Browser Use、MCP 服务器和 Google 的插件系统已经提供了可行的部分解法。机会:竞争性。
在看似很小的任务上提供更好的默认推理
@Soso_fun_yt 展示了 (8 个赞、315 次浏览) 的基准测试讨论提出了一个更微妙的愿望:用户不希望直到加上 /boost、刚性的“REQUIREMENTS”或更严格的验证标准之后,才发现模型会展现出更深层的推理能力。这是一个实际需求,但也带有情绪上的刺痛,因为它会削弱用户对“短提示词是否会被认真对待”的信任。当前已有一些部分解法,比如更严格的提示模板、类型化智能体框架和人工审查,但数据中没有任何迹象表明,普通默认设置能可靠地解决这个问题。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Codex | 编程智能体 | (+/-) | 具备仓库感知的任务执行能力;出现在开源维护、本地智能体工作流和多智能体编排场景中(melvindvivas (54 个赞、10 条回复、4,171 次浏览);Shruti_0810 (34 个赞、16 条回复、2,344 次浏览)) | 持续出现关于额度变差、运行变慢以及套餐恢复机制脆弱的投诉(bil0090 (61 个赞、16 条回复、2,285 次浏览);buildwithrajath (38 个赞、18 条回复、1,412 次浏览);therealmc92 (1 条回复、145 次浏览)) |
| GPT-6 Astra | 模型 / 编排器 | (+/-) | 在 Astra+Luna 方案中承担强编排角色;最近一次 Astra Pro 运行在 Soso 的基准测试中满足了全部标准,而且速度很快(melvindvivas (54 个赞、10 条回复、4,171 次浏览);Soso_fun_yt (8 个赞、315 次浏览)) | 配额压力“极其严苛”,并且对任务表述或套餐限制很敏感(buildwithrajath (38 个赞、18 条回复、1,412 次浏览);Soso_fun_yt (8 个赞、315 次浏览)) |
| GPT-5.6 Luna | 模型 / 子智能体 | (+) | 在 melvindvivas 公开的 Codex 编排方案中被用作默认执行模型,说明用户信任它承担 worker/子智能体任务(codex-astra-luna-orchestrator) | 仍处在同一个 Codex 使用额度框架里,而开发者表示这一额度很难长期维持(melvindvivas (54 个赞、10 条回复、4,171 次浏览)) |
| Claude Code | 编程智能体 | (+/-) | 常被视为应当与共享索引、浏览器工具、工作空间以及基于 worktree 的审查流协同工作的基准智能体(kv1nsiii (20 个赞、7 条回复、566 次浏览);DanKornas (8 个赞、4 条回复、664 次浏览)) | 并行使用仍会把人们推向外部结构,例如任务级 worktree、仅通过 PR 审查以及受保护的人类负责区域(undefinedKi (4 个赞、2 条回复、119 次浏览)) |
| Google Antigravity | 编程智能体 / 工作空间 | (+/-) | 既是严肃基准测试中的智能体工作平台,也是可安装云能力套件的兼容目标(Soso_fun_yt (8 个赞、315 次浏览);DivyanshT91162 (12 个赞、4 条回复、1,243 次浏览)) | 如果没有更强的提示词或 /boost,它在看似简单的任务上可能会过早收手(Soso_fun_yt (8 个赞、315 次浏览)) |
| Omarchy | 操作系统 / 环境 | (+/-) | 被定位为“agentic Linux”环境,足以吸引一位终身 Mac 用户开始为 AI 工作流测试它(bridgemindai (111 个赞、40 条回复、4,500 次浏览)) | 回复立刻质疑 Linux 上的智能体支持是否真的已经足够成熟,尤其是在电脑操作方面(bridgemindai (111 个赞、40 条回复、4,500 次浏览)) |
| CodeGraph | 代码智能 / 索引 | (+) | 共享本地代码图谱、文件变更自动同步、浏览器 UI,以及对 Codex、Claude Code、Gemini、Cursor、Antigravity 和 GitHub Copilot 的智能体集成(kv1nsiii (20 个赞、7 条回复、566 次浏览);CodeGraph 仓库) | 回复询问,在大规模重构和生成代码频繁变动的情况下,图谱是否还能保持准确(kv1nsiii (20 个赞、7 条回复、566 次浏览)) |
| Browser Use | 浏览器智能体 / 自动化 | (+/-) | 开源浏览器智能体,并提供 CLI 和托管 API;被列为有用的开源智能体栈的一部分,而且明确支持现有智能体(Shruti_0810 (34 个赞、16 条回复、2,344 次浏览);Browser Use README) | 回复指出,真正的难点在于模态处理、DOM 变化,以及任务进行过程中保持会话稳定(Shruti_0810 (34 个赞、16 条回复、2,344 次浏览)) |
| Google Cloud Developer Plugin | 插件 / 云操作 | (+) | 在开放标准之下,通过 MCP 将认证、项目管理、gcloud 操作、最佳实践和官方文档打包为一个可安装包(DivyanshT91162 (12 个赞、4 条回复、1,243 次浏览);Google Cloud 公告) | 回复希望在执行前能准确看到智能体将触发哪项 gcloud 操作,以及会触碰哪个目标资源(DivyanshT91162 (12 个赞、4 条回复、1,243 次浏览)) |
| Garcon | 工作空间 / 编排 | (+) | 浏览器工作空间,可并排运行多个智能体,支持运行中操控、带来源标记的消息、diff 审查和 PR 控制(DanKornas (8 个赞、4 条回复、664 次浏览);Garcon 仓库) | 即便是支持者也表示,真正的考验在于重定向后的聊天是否仍能证明每一段代码到底来自哪个智能体(DanKornas (8 个赞、4 条回复、664 次浏览)) |
| Kelos | 基础设施 / 编排 | (+) | 将编程智能体迁入 Kubernetes Tasks、Sessions 和流水线,并提供可复用配置、触发器和隔离工作负载(DanKornas (2 个赞、2 条回复、456 次浏览);Kelos 仓库) | 公开文档要求 Kubernetes 1.28+ 集群和 cert-manager,因此运维门槛远高于笔记本原生方案(Kelos README) |
总体情绪是:对专用控制层偏正面,对主要付费智能体本身则褒贬不一。只要工具能减少折腾或让工作可审查,人们就更满意:共享索引、可见工作空间、打包好的云技能,以及隔离式编排,都比泛泛而谈“AI 能做 X”的帖子更受欢迎。常见应对方式包括:用替代工具绕开配额、把智能体迁入 worktree 或浏览器/Kubernetes 控制平面,以及用图谱或技能预先打包上下文。最明显的迁移趋势,是从单会话笔记本使用转向托管式或分层系统:Astra 路由 Luna,Codex 暴露出 harness API,Garcon 把聊天变成可见工作空间,Kelos 则把它们变成工作负载。现在最清晰的竞争压力已经落在模型周围的控制平面,而不只是模型本身。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Codex Astra Orchestrator + Luna Subagents | @melvindvivas | 配置 Codex,由 Astra 负责统筹和审查,Luna 负责执行型子智能体 | 为团队提供一套公开、明确偏好的多智能体 Codex 模型路由方案,而不是临时选角色 | Python、TOML、Codex CLI 配置、安装脚本 | 已发布 | 仓库 |
| AI Backends | @melvindvivas | 在本地和云端提供商之间运行常见 AI 任务,以及可多轮使用工具的智能体 | 为本地模型、托管提供商和简单智能体场景提供统一 API 界面 | Node/HTTP API、Ollama、LM Studio、OpenRouter、OpenAI、Anthropic、Google AI Studio | 已发布 | 仓库, 网站 |
| Local Evals | @melvindvivas | 面向 document-to-JSON、text-to-JSON 和 tool-call proposals 的本地优先评估应用 | 让团队无需先把工作流送到托管评估器,也能检查评估输入、输出、分数和日志 | TypeScript、本地存储、兼容 OpenAI 的 API | 已发布 | 仓库 |
| CodeGraph | @kv1nsiii 重点介绍了 @getcodegraph | 构建本地代码图谱,并接入多种编程智能体 | 降低智能体在大型代码库中导航时的文件来回翻找和 token 浪费 | Rust 驱动的 CLI/MCP、浏览器 UI、本地索引 | 已发布 | 仓库 |
| Garcon | @DanKornas / cfal | 自托管浏览器工作空间,可让多个编程智能体与 Git 和 PR 审查并排运行 | 让多智能体工作保持可操控、可审查,而不是把聊天、终端和 diff 散落在多个工具中 | TypeScript、Bun、浏览器 UI、主机侧 Git/PR 操作 | 已发布 | 仓库, 网站 |
| Kelos | @DanKornas / kelos-dev | 将编程智能体作为 Kubernetes Tasks、Sessions 和流水线来运行 | 把智能体执行从笔记本迁出,放入可复用、隔离的工作负载中,并提供触发器和共享配置 | Go、Kubernetes、cert-manager、webhooks、GitHub/Jira/Linear triggers | 已发布 | 仓库 |
| Inkwake | @sarthakguptadev | 一款带 AI 对手、加速、迷你地图和移动端控制的浏览器赛艇游戏 | 展示 GitHub Copilot 已经被用来交付可玩的终端用户产品,而不只是智能体基础设施 | 浏览器/Web 游戏栈(公开信息未说明) | 已发布 | 网站 |
最强的构建者模式不是“再做一个代码助手”,而是为助手外围交付控制层。@melvindvivas 展示了 (54 个赞、10 条回复、84 个收藏、4,171 次浏览) 这一点体现得非常清楚:它分别链接了一个编排仓库、一个提供商抽象仓库和一个本地评估仓库,同时也表示,维护这些项目如今已经占去了他 Codex 使用量中的很大一部分。
Garcon、Kelos 和 CodeGraph 从不同方向切入了同一个瓶颈。@DanKornas 介绍了 (8 个赞、4 条回复、664 次浏览) 将 Garcon 定位为可见的工作空间层,而 再次提到 (2 个赞、2 条回复、456 次浏览) 则将 Kelos 定位为基础设施层。@kv1nsiii 认为 (20 个赞、7 条回复、16 个收藏、566 次浏览) 表示,CodeGraph 这类工具之所以存在,是因为即便模型更聪明,如果没有先拿到更好的地图,它们仍会从 ls 开始。
Inkwake 是那个值得保留的异类。@sarthakguptadev 表示 (4 个赞、1 条回复、426 次浏览) 表示,GitHub Copilot 帮助构建了一款带 AI 对手和移动端控制的实时浏览器竞速游戏。这一点很重要,因为它表明,当天关于编程智能体的讨论仍然包含终端用户产品交付,尽管更高信号的构建者精力大多已经转向智能体如何工作的外围基础设施。
6. 新动态与值得关注的内容
Harness 训练进入研究主流
@arkyyang 提到了 (2 个赞、2 条回复、33 次浏览) 介绍了全新的 Ecdysis 论文,这项工作明确针对运行时 harness 的改进,而不是基础模型调优。帖子摘要和附带的基准表格强调了 3 项具体主张:在修补共享脚手架之前,应先跨任务归并重复故障;诊断应与编辑分离;harness 的演进可以跨模型迁移,同时降低迭代成本。这一点之所以值得关注,是因为它把一个非常 Twitter 原生的观点——“harness 比提示词更重要”——转化成了带测量结果的研究结论,报告称平均准确率最高可提升 59.33%,训练速度最高可提升 1.84 倍。

“后 AI 数据栈”正在围绕智能体 harness 与反馈回路被描绘出来
@iandmacomber 表示 (8 个赞、3 个收藏、159 次浏览) 表示,这就是如今在 Ramp 工作的感受:路由器、数据层、工具和 agentic 产品体验,都被构建出来,用于围绕 token 成本回报率、工具供应商和工作流信号进行推理。附带的架构图是这里最有辨识度的部分。图中标出了一个位于数据存储与界面之间的“Data Agent Harness”,公司上下文为工具、模型和技能提供输入,而由产物、分析、决策、使用情况和评估组成的反馈回路则流回系统之中。

7. 机会在哪里
[+++] Spend-aware agent operations — Evidence appears across sections 1, 2, and 3. @bil0090 提到 (61 个赞、16 条回复、2,285 次浏览) 描述了重置后配额消耗更快;@buildwithrajath 询问 (38 个赞、18 条回复、1,412 次浏览) 询问 Astra 和 Sol 是否实际上已被削弱;@therealmc92 表示 (1 条回复、145 次浏览) 则表示一次支付失败让一家企业失去了自己的 20x 套餐,且没有宽限期。@melvindvivas 补充道 (54 个赞、10 条回复、84 个收藏、4,171 次浏览) 则给出了构建者侧版本:把使用限制直接与开源维护工作挂钩。真正强烈的机会并不是再做一个仪表盘,而是提供一层运营系统:能预测成本、在不同模型或环境之间路由工作,并能处理计费边缘状态,而不至于在工作流中途把团队踢出套餐。
[++] Reviewable multi-agent workspaces — Evidence spans sections 1, 2, and 5. @DanKornas 介绍了 (8 个赞、4 条回复、664 次浏览) 介绍了 Garcon,再次提到 (2 个赞、2 条回复、456 次浏览) 介绍了 Kelos,@undefinedKi 总结道 (4 个赞、2 条回复、4 个收藏、119 次浏览) 则介绍了“一任务一 worktree”的流程。三者共同指向同一个缺失界面:可见谱系、运行中操控、仅通过 PR 审查,以及存在于聊天之外的持久状态。这个机会是中等而非最大,因为已经有多个构建者在这里交付产品,但需求具体而且反复出现。
[++] Packaged context and capability layers — @kv1nsiii 推荐 (20 个赞、7 条回复、16 个收藏、566 次浏览) 介绍了地图/方法/目录栈,@Shruti_0810 整理了 (34 个赞、16 条回复、42 个收藏、2,344 次浏览) 介绍了那些让智能体“真正有用”的开源仓库,而 Google 公开的 云插件公告 则表明,即便是平台厂商也开始以这种方式打包能力。这是一个竞争性机会,因为可信的部分解法已经存在,但生态仍然被平台、工具链和安全模型切得很碎。
[+] Harness evaluation and self-improvement — @arkyyang 提到了 (2 个赞、2 条回复、33 次浏览) 将 Ecdysis 作为一篇 harness 改进论文提出,@Soso_fun_yt 展示了 (8 个赞、315 次浏览) 则展示了编排和更严格要求如何实质性改变基准结果。这个信号比工作空间或预算主题出现得更早,但它是当天研究与产品实践最清晰的交汇点之一。
8. 要点
- 讨论持续从模型转向控制平面。 @gregisenberg 认为 (59 个赞、10 条回复、97 个收藏、3,489 次浏览) 表示,如今工具、记忆、停止规则和可复用作业逻辑所在之处,是 harness,而不是封装层。
- 构建者交付编程智能体外围缺失层的速度,快于他们交付新的终端用户 AI 编程体验。 @melvindvivas 链接到 (54 个赞、10 条回复、84 个收藏、4,171 次浏览) 在一条帖子里同时展示了编排、提供商抽象和本地评估工具,而 @DanKornas 补充道 (8 个赞、4 条回复、664 次浏览) 展示了工作空间层,再次提到 (2 个赞、2 条回复、456 次浏览) 则展示了基础设施层。
- 配额和计费摩擦仍在削弱人们对原本有用工具的信任。 @bil0090 展示了 (61 个赞、16 条回复、2,285 次浏览) 表示重置后 Codex 周配额只剩 7%,@buildwithrajath 询问 (38 个赞、18 条回复、1,412 次浏览) 询问 Astra 和 Sol 是否已被削弱,而 @therealmc92 表示 (1 条回复、145 次浏览) 则表示一次支付失败让他们失去了 20x 套餐。
- 可复用的地图、技能和插件正在成为打包上下文的首选方式。 @kv1nsiii 推荐 (20 个赞、7 条回复、16 个收藏、566 次浏览) 介绍了地图/方法/目录栈,而 @DivyanshT91162 指出 (12 个赞、4 条回复、11 个收藏、1,243 次浏览) 则指向 Google Cloud 的打包式插件模式。
- 研究和实践工作流正在收敛到同一条经验:在修补 harness 之前,先诊断失败。 Ecdysis 论文 和 @undefinedKi 总结 (4 个赞、2 条回复、4 个收藏、119 次浏览) 都强调了明确的审查阶段、有边界的修改,以及把智能体编辑限制在更受控的流程之内。