Twitter AI 编程 - 2026-09-24
1. 人们在讨论什么
1.1 本地与混合执行已从代码编辑扩展到周边系统(🡕)
本地代理仍是最强势的主题,但讨论已不再局限于“Gemma 可离线运行”,而是扩展到设备控制、机器人编排,以及同一套框架里“缺少某些模型”引发的挫败感。至少有五条内容支撑这一主题:Google Gemma 的本地 LiteRT 公告、Google Devs 对混合多代理的表述、一条明确抱怨 Antigravity 仍只提供 Opus 4.6 而非 5.5 的帖子、Google 的 Home MCP 操作演示,以及一个基于 Antigravity 的机器人集群演示仓库。
@googlegemma 宣布(538 次点赞、20 条回复、23,926 次浏览、343 次收藏)称,Antigravity SDK 现已可通过 LiteRT 在本地运行 Gemma 4,也支持 Ollama、llama.cpp 和 vLLM 等兼容 OpenAI 的端点。链接中的 Google Developers 博文 表示,当前方案针对 Gemma 4 26B A4B 做了优化,建议配备超过 24GB 的 VRAM 或统一内存,并展示了一种混合审计工作流:由 Gemini 3.8 Flash 根据文件名进行规划,而 97.2% 的 token 仍留在本地。这让“离线代理”不再只是隐私口号,而成了一种被明确描述的运行模式:需要时由云端负责规划,绝大部分工作由本地执行。
@googledevs 随后补充说明(585 次点赞、32 条回复、38,693 次浏览、224 次收藏)则更明确地提出:本地或混合多代理工作流可以在设备端审计、修补并测试代码,且零 API 费用。回复区与其说是在庆祝,不如说更偏向操作层面:有人询问笔记本级别的延迟数据;有人认为混合模式才是务实的默认选项,因为本地方案仍更擅长处理日常工作,而不是最困难的案例;还有人表示,在信任构建结果之前,真正稀缺的能力是说清楚“到底哪些东西已经通过”。
@heyorvian 表示(6 次点赞、431 次浏览、2 次收藏)称,Google 的早期访问版 Home MCP 服务器可以把 Google Home 设备接入 Claude Cowork、OpenClaw 或 Antigravity,但会屏蔽门锁解锁等敏感操作。这张截图之所以重要,是因为它在同一流程中同时展示了设置过程和安全护栏:代理可以读取设备状态和事件历史,但 Google 仍在提醒用户先从非敏感设备开始,并验证其行为。
@GoogleCloud_IN 分享了(5 次点赞、817 次浏览、1 次收藏)则是另一个突破边界的例子:Cyrus Wong 使用 Antigravity 以高层意图编排六台人形机器人,并附上了链接 agy-humanroid-agents repo。这仍然只是一个信号较弱的演示,但它将 Antigravity 在人们心中的使用场景,从编码助手扩展到了通用编排层。
@Ananth7e 认为(50 次点赞、10 条回复、1,957 次浏览)称,Antigravity 应该加入 Opus 5.5,因为它仍停留在 Opus 4.6。附带的截图之所以关键,是因为它把抱怨变成了可见的产品状态证据,而不只是一个模糊的请求。
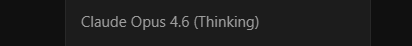
讨论洞察: 回复不断把“本地代理”的叙事收束为操作者关心的几个问题:旗舰方案到底需要多少内存、在普通笔记本上的速度如何、工具调用循环是否真的留在本地,以及这套框架是否提供了人们现在真正想要的前沿模型。
与前一天相比: 9 月 23 日确认了离线 Gemma 4 工作流已经开始落地。到了 9 月 24 日,这一趋势已进一步扩展到家庭、机器人,以及围绕本地运行时之上模型目录的日常抱怨。
1.2 GitHub 与 Copilot 的讨论进一步深入到审查操作与并行代理管理(🡕)
第二个强势主题是,GitHub 和 Copilot 相关帖子谈论的已不再是自动补全有多神奇,而是如何在不失控的前提下监督多个代理和大规模审查界面。至少有五条内容支撑这一主题:GitHub 关于超大 pull request 渲染的讨论串、其 Dependabot 审查自动化、新的统一内联建议模型、Pamela Fox 关于并行工作的幻灯片,以及她关于 MCP 加 skills 的工作坊。
@github 展示了(81 次点赞、14 条回复、38,679 次浏览、17 次收藏)展示了 Copilot 应用渲染一个包含 2,200 个文件、超过 100 万行变更、以及 400 多条内联评论的 pull request。链接中的 工程博文 表示,团队将确定性的代码几何结构与动态评论几何结构分离,然后只在接近视口时懒加载式测量评论,从而避免评论重排不断重建代码布局。这不是模型质量的故事,而是审查界面架构的故事。
@github 还发布了(47 次点赞、11 条回复、12,433 次浏览、19 次收藏)介绍了一项 Copilot 应用自动化流程:在工作日开始前审查所有打开的 Dependabot pull request,按风险分组,检查 CI 状态,并准备一份简短摘要。最犀利的一条回复并未否定这个想法,而是指出:“低风险”这一类别只有在有人衡量它出错频率时才有意义。
@code 写道(39 次点赞、4 条回复、6,402 次浏览、13 次收藏)称,GitHub Copilot 的新内联建议模型现在已用一个模型同时处理补全、Next Edit Suggestions 和更长距离的编辑。链接中的 VS Code 工程博文 表示,真正更大的收益不只是减少了模型调用次数,还在于能根据当下情况选择合适的编辑行为,以及一项客户端改动:在测试中,它将放弃率从上升 15.9% 扭转为下降 10.1%。
@pamelafox 分享了(8 次点赞,479 次浏览,8 次收藏),这是一场 WeAreDevs 演讲,将开发者定位为“agents 的工程经理”,并将环境、时机和所有权视为并行化的三个维度。在幻灯片中,worktrees、隔离端口、独立的预发布环境以及边界明确的监控,都被视为并行 agent 工作的前提,而非可有可无的打磨项。
@pamelafox 随后又分享了(6 次点赞,266 次浏览,4 次收藏),这是第二场聚焦 GitHub Copilot 中 MCP servers 和 agent skills 的工作坊。幻灯片把一个实用层面的区分讲得很明确:何时应将知识封装为 skill,何时应通过 MCP 暴露工具,以及当 server 位于私有网络、采用密钥认证或基于浏览器时,认证模式有何不同。

讨论洞察: 真正有意思的问题都关乎运维和可审计性:风险分组是否有误差预算,agents 如何避免 worktree 和端口冲突,企业认证如何处理,以及哪些可复用的设置应放进 skill 而不是 prompt。
与前一日对比: 9 月 23 日的 GitHub 讨论聚焦于沙箱化和超大 pull request 的性能。9 月 24 日则延续了对评审面的关注,同时加入了定时评审自动化,以及并行 agent 运行的明确操作手册。
1.3 套餐经济性与模型可用性再次成为打断工作流的担忧(🡕)
在前一天本地执行成为焦点之后,定价和套餐设计重新回到核心话题。至少有四条内容支撑了这一主题:对 OpenAI 常规 Chat 额度的称赞、对高价套餐会挤压低价套餐体验的担忧、对 GPT-5.6 Sol 可能从 Codex 消失的顾虑,以及一则基于截图流传的 500 美元“Pro Max”套餐传闻。
@TokenGremlin 表示(234 次点赞,34 条回复,7,863 次浏览,23 次收藏)表示,他们继续订阅的主要原因是 OpenAI Chat 的常规消息额度,而不是 Work 或 Codex;按其估算,自己每周大约会发送接近 3,000 条 GPT-5.6 Sol 消息,甚至用了 1,500 条后也从未碰到上限。回复让这种称赞变得更复杂:一人说,Mac Studio 正在取代每月 200 美元但有额度上限的用法;另一人则表示,他们的 20x Pro 套餐现在只发出一条 prompt 就会触发“消息过多”。
随后气氛发生逆转:@TokenGremlin 警告(167 次点赞,34 条回复,3,030 次浏览,6 次收藏)表示,如果 OpenAI 推出昂贵的新套餐、进一步恶化低价套餐的额度,并把 Chat 并入 Work 或 Codex,他们就会取消订阅。该帖子的回复认为,Opus 5.5 现在已经显得更划算,而定价压力如今正直接影响用户对模型的忠诚度。
@GalinaLyamina 认为(58 次点赞,4 条回复,1,558 次浏览,8 次收藏)表示,Codex 不应移除 GPT-5.6 Sol,因为 GPT-6 Sol 在“创意和技术上”都感觉更差。被引用的基准测试帖子之所以重要,在于它让这种抱怨有了可操作的轮廓:在一个包含 105 个隐藏 bug 的任务中,GPT-6 Sol 虽然是最便宜的选项,但得分低于 Astra、GPT-5.6 Sol 和 Opus 5.5。随后回复点明了真正的重点:如果用户不得不额外花时间去检查,那么更便宜的模型也就不再便宜。
@dev_majd 发布了(8 次点赞,2 条回复,894 次浏览,2 次收藏)发布了一张截图,包含一个值为 500.0 的 promax.month.amount,这也正是“Pro Max”传闻得以扩散的原因。证据目前仍然只是截图,而不是公开定价页,但这张截图本身已经足以加剧当天对套餐层级不断上探的焦虑。
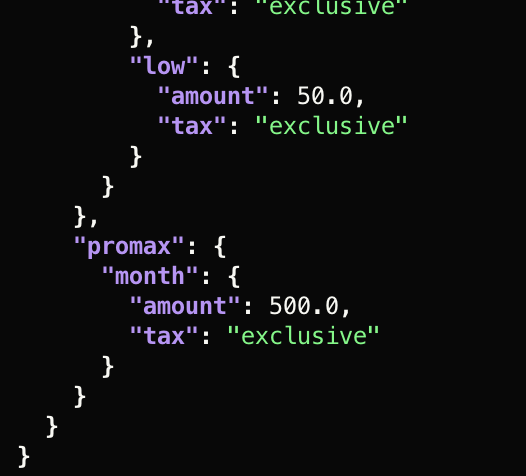
讨论洞察: 用户谈论套餐限制时,并不是把它当作抽象的定价谈资。他们会把这些限制转化为具体动作:保留更便宜的 Chat 套餐、购买本地硬件、继续使用仍然感觉可靠的模型,或者在熟悉的模型消失时切换工具。与前一天相比: 9 月 22 日的讨论主要围绕发布当天的定价计算和重置时机。到 9 月 24 日,话题扩展到了订阅层面的博弈:人们担心被迫升级、担心熟悉的模型消失,也更愿意明确表示要改用别的工具。
1.4 Flash 级执行模型引发关注,但大多仍只被当作便宜的首轮执行器,且需要人工盯着 (🡕)
第四个主题是一波围绕超高速编程模型的亲手实测。人们愿意把这类模型当作执行器使用,但还不信任它们能独立完成最后收尾。至少有三条内容支撑了这一主题,而且都围绕匿名 OpenCode 模型 “Space Bunny”。
@hqmank 报道(21 个赞、6 条回复、1,447 次浏览、5 次收藏)表示,Space Bunny 按照一张参考图重建了一个 3D 地球仪仪表盘,但前后花了十几轮交互。真正有价值的细节来自回复区:其中大约一半时间都花在把地球纹理调对上。这使得这个结果更像是一个“速度 + 监督”的样本点,而不只是泛泛地炫耀一句“它能做出来”。
@superalesha 表示(10 个赞、4 条回复、579 次浏览、2 次收藏)表示,同一个模型“非常、非常快”,但在构建一只背着城市的体素乌龟时不够精确。有条回复立刻提出了一个很实用的工作流拆分方式:让这个快速模型负责执行,再固定用一个更慢的模型完成最后一轮收尾。
@dhruvtwt_ 补充道(13 个赞、3 条回复、507 次浏览)则提供了一条量化说明:他们的运行大约用了 88K 上下文,速度达到约 75 tokens per second,运行所用模型则宣称支持 1M 上下文。即便如此,这条帖子最后仍以“waiting for proper benchmarks”作结,这也很好地概括了整个主题:好奇心是真实存在的,但信任仍只是暂时性的。
讨论洞察: 社区似乎愿意在模型便宜、速度快、而且容易重跑的前提下,容忍更低的精度。他们正在测试的权衡,并不是“整体最好的模型”,而是“在工作流某个狭窄环节里足够好用的执行器”。
与前一天相比: 9 月 23 日的实验更侧重本地后端和协议层。到 9 月 24 日,则明显出现了一波关于 Flash 级执行器的亲手实测报告:它们快到足以诱使人们尝试新的路由策略。
2. 什么让人沮丧
定价分层和模型更替如今让人觉得是产品风险,而不只是计费细节
最强烈的非技术性不满在于,套餐设计如今已经让人觉得与工作流可靠性密不可分。@TokenGremlin 称赞(234 个赞、34 条回复、7,863 次浏览、23 次收藏)称赞 OpenAI 的常规 Chat 配额,因为它对每周重度使用来说仍显得足够宽裕;但回复区立刻把这变成了与设有上限的 200 美元套餐,以及转向本地硬件这一“逃生舱”方案之间的比较。几小时后,同一个账号 表示(167 个赞、34 条回复、3,030 次浏览、6 次收藏)表示,如果更贵的档位会让更便宜的档位变差,或者把 Chat 并入 Work 或 Codex,他们就会取消订阅。
同样的焦虑也体现在对模型目录变化的担忧上。@GalinaLyamina 认为(58 个赞、4 条回复、1,558 次浏览、8 次收藏)表示,Codex 不应该移除 GPT-5.6 Sol,因为对她的工作流来说,它仍然比 GPT-6 Sol 更好;而被引用的基准测试帖子则让这一抱怨变得更具体:在一个包含 105 个隐藏 bug 的任务上,GPT-6 Sol 虽然是最便宜的选项,却不是最好的。@dev_majd 补充道(8 个赞、2 条回复、894 次浏览、2 次收藏)发了一张截图,其中包含一个 promax.month.amount,内容是 500.0;与此同时,@Ananth7e 展示了(50 个赞、10 条回复、1,957 次浏览)表示,Antigravity 当前显示的仍是 Opus 4.6,而不是 Opus 5.5。
人们的应对方式包括把使用量拆分到不同产品上、购买本地算力,或者在自己信任的模型消失时威胁改用别的工具。这已经不是单纯的定价偏好,而是在为工作流做对冲。严重程度:高。值得构建:高。
仅靠提示词的护栏,对真正的智能体工作来说仍然太弱
第二个主要挫败点是,太多智能体配置仍然依赖提示词文本,而人们真正想要的是硬边界。@DanKornas 推出了(6 个赞、12 条回复、613 次浏览、2 次收藏)将 Stop That Shit 视为一种“技能 + 护栏”,用来防止范围蔓延、无谓的反复折腾、违背意图和任务来回切换;而回复里立刻有人要求更完善的交接报告,以及不要再盯着看似一片绿色的容器,而是要对第一次真实的依赖调用设置检查。@tweetpraveen 总结道(5 个赞、16 条回复、436 次浏览)则更直白地表达了同样的本能反应:“docker run 不是 AI agent 沙箱。”随后列出的方案包括 microVM 或 gVisor、外置密钥、阻断 npm 或 MCP 出站流量、会话预算、只读 CI 或测试、按活跃 CPU 计费,以及外部审计日志。
@DanKornas 还强调了(6 个赞、2 条回复、437 次浏览、1 次收藏)提到 nono,将其定位为一个遵循最小权限原则的沙箱,具备可编辑配置、工具级子沙箱和凭证控制;而 @hackerlogs 报道(1 个赞、2 条回复、31 次浏览)则提到 Darktrace 的研究,称客户端会话历史可能被重写,从而让 agent 把伪造的既有授权当成真实授权。就连 Google 的 Home MCP 演示也明确展示了限制:@heyorvian 指出,门锁解锁仍然被阻止。

这些变通方案全都是外置控制:技能护栏、最小权限配置、受限的设备范围,以及把 agent 的会话数据库视为安全敏感状态。这种行为说明,人们仍然不相信仅靠 prompt 就能界定权限。严重性:高。值得构建:高。
廉价执行器可以省钱,但仍然会浪费时间
第三类挫败感更微妙:快速、廉价的代码模型确实有吸引力,但前提是纠错成本仍在可接受范围内。@hqmank 表示(21 个赞、6 条回复、1,447 次浏览、5 次收藏)中,Space Bunny 做出了一个接近参考图的 3D 地球仪仪表盘,但前后折腾了十几轮,其中大约一半的精力都耗在修复地球纹理上。@superalesha 称之为(10 个赞、4 条回复、579 次浏览、2 次收藏)则称同一个模型“非常、非常快”,同时也表示它精度不足,塑造一个体素场景花了四个小时;有条回复建议,最后的收尾阶段应该交给更慢的模型处理。
@dhruvtwt_ 补充道(13 个赞、3 条回复、507 次浏览)表示,他们自己运行 Space Bunny 时,在大约 88K 上下文下速度达到每秒约 75 tokens,但他们仍在等待正式基准测试。这句话正好概括了这种挫败:速度很容易察觉,可靠性却需要更长时间才能证明。
人们的应对方式,是把这类模型分配给草稿、狭义执行角色或偏玩乐性质的原型,再把较慢或更贵的模型留给最终把关。这种做法确实有效,但也意味着廉价模型实际上并没有消除人工审查这一环。严重性:中。值得构建:中高。
3. 人们希望看到什么
不只是本地运行时,而是支持当前模型的本地运行时
最强烈的现实需求并不只是“本地运行”,而是“本地运行,同时不会被困在昨天的模型菜单里”。@googlegemma 宣布(538 个赞、20 条回复、23,926 次浏览、343 次收藏)提到用 LiteRT 和兼容 OpenAI 的端点在本地运行 Gemma 4,而 Google 博文 则描述了一种混合工作流,其中 97.2% 的 tokens 都留在设备端。但 @Ananth7e 立刻追问(50 个赞、10 条回复、1,957 次浏览)则是在 Antigravity 里请求支持 Opus 5.5,配图显示该 harness 仍停留在 Opus 4.6;与此同时,Gemma 发布帖下的回复则希望看到真实的笔记本延迟数据,以及更清晰的硬件指引。
这是一种现实需求,不是愿景。人们已经想把代码留在本地、通过 Home MCP 控制设备,或者运行云端加本地的混合工作流。他们不希望为隐私付出的代价,是只能在过时的模型选项里做选择。机会:直接。
即使经过工具调用、重写和伪造历史后仍然有效的硬边界
人们已经明确表示,prompt 远远不够。@tweetpraveen 撰写(5 个赞、16 条回复、436 次浏览)表示,“docker run 不是 AI 代理沙箱”,随后列出了七项位于代理之外的生产控制。@DanKornas 已打包(6 个赞、12 条回复、613 次浏览、2 次收藏)把同样的思路写进了 Stop That Shit,而他随后发布的 nono 文章(6 个赞、2 条回复、437 次浏览、1 次收藏)则将最小权限配置、工具沙箱和凭证代理视为一等运行时特性。
当 @hackerlogs 报道(1 个赞、2 条回复、31 次浏览)提到 Darktrace 的研究时,这一需求变得更加迫切:伪造的客户端侧历史记录,可能把一次过去的拒绝转换成貌似已获授权。今天虽然已有一些局部解法,但它们分散在提示词、封装层、配置文件和操作纪律之中。机会:直接型。
不把开发者变成人肉消息总线的并行代理协同
当天最明确的一句话来自 @rcdexta,他在 推介(5 个赞、1 条回复、1,343 次浏览、2 次收藏)中介绍 AX 时写道:“别再充当你的编码代理之间的对讲机了。” 同样的底层需求也出现在 @pamelafox 关于 worktree 和子代理的演示文稿、她的 MCP 与 skills 研讨会,以及 GitHub 的 Dependabot 自动化 中;后者把一个重复性的收件箱问题,变成了一份边界清晰的晨间产物,而不是又一场实时对话。
这是一个竞争性需求。已经有多人在构建它的不同部分——消息中继、worktree 操作手册、定时自动化和模型路由插件——但日常证据表明,对于普通开发团队来说,协同开销仍然过于依赖人工处理。机会:竞争型。
知道哪些步骤值得使用昂贵模型的成本感知路由
当天有大量证据表明,用户想要的是路由逻辑,而不只是更多模型。@TokenGremlin 保持 取消了一项订阅,因为常规 Chat 限额已经够用;而 @GalinaLyamina 则希望保留 GPT-5.6 Sol,因为更便宜的 GPT-6 Sol 路径仍会带来额外的核查工作。@superalesha 将 Space Bunny 描述为执行速度很快、但精度仍然不足的执行器,而 @DanKornas 则明确把 Fable Orchestrator 定位为一种方式:让高价推理集中用于规划、架构和验证,而不是“每一次 grep”。
这是一个背后有明确购买行为支撑的直接需求。用户已经在按路由分层思考——便宜模型负责批量,昂贵模型负责判断——但大多数产品仍然让他们手动编排这种切分。机会:直接型。
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Antigravity SDK | 代理运行时 | (+) | 离线与混合编排、本地 OpenAI 兼容端点、清晰的隐私主张 | 旗舰本地方案需要高内存机器,且仍有人抱怨模型目录问题 |
| Gemma 4 26B + LiteRT | 本地模型 / 运行时 | (+) | 无 API 费用、设备端私有执行、混合式构建模式 | Google 建议使用超过 24GB 的 VRAM 或统一内存,用户仍希望看到更明确的延迟指引 |
| GitHub Copilot app | 代理 IDE / 审查界面 | (+/-) | 超大 PR 渲染、Dependabot 自动化、不断扩展的审查设置界面 | 低风险摘要仍需测量效果,而且设置越多,需要管理的状态也越多 |
| GitHub Copilot Inline Suggestions 3-in-1 model | 编辑器模型 | (+) | 一个模型同时处理补全、下一步编辑和更长距离编辑;减少人为制造的工具边界 | 提升高度依赖客户端编排、缓存和渲染策略 |
| Git worktrees + agent skills | 工作流方法 | (+) | 为并行代理提供清晰隔离、可复用的环境配置、显式的认证或端口规则 | 需要围绕端口、暂存和被忽略的本地状态做额外设置 |
| GPT-5.6 Sol / GPT-6 Sol | LLM / 编码模型 | (+/-) | 覆盖面广,且 GPT-6 Sol 名义价格更低 | 用户对 GPT-6 Sol 的质量存在争议,也担心 GPT-5.6 Sol 会从可信工作流中消失 |
| Space Bunny | Flash 级编码模型 | (+/-) | 执行极快、长上下文实验、多模态输入 | 精度低、需要多轮纠正,而且尚无足够有力的公开基准来建立信心 |
| Jev | 决策 / 路由层 | (+) | 快速、廉价的类型化决策,可驱动有状态应用 | 公开证据目前仍以演示、清单和工作笔记图为主 |
| Stop That Shit | 技能 / 防护层 | (+) | 点出常见代理失效模式,支持只读模式,并强制实施文件或依赖限制 | 仍需要良好的验收检查和周密的交接报告 |
| nono | 沙箱 | (+) | 在提示词之外提供最小权限配置、子工具沙箱和凭证代理 | 配置文件编写和快速演进的 API 增加了上手摩擦 |
| AX | 多代理消息传递 | (+) | 允许多个编码代理在本地彼此通信,无需人工中转 | 早期证据目前仅限于一次演示和相关文章讨论串 |
| Fable Orchestrator | 编排插件 | (+) | 将常规批量任务从高价模型中分流出去,并加入基于 ledger 的收尾检查 | 依赖多模型栈和纪律性较强的工作流采纳 |
| Fly Sprites + Nebius | 代理算力 / 推理桥接 | (+) | 为代理提供持久、隔离的 Linux 计算机,并把 Nebius 密钥保存在连接器中而非运行时 | 需要完成 Sprite 和 Nebius 的设置,本身也不是支出上限机制 |
总体满意度最高的情况,是工具减少了隐藏的操作负担:能保护代码隐私的本地运行时、在离谱规模下依然保持流畅的审查界面,或是在问题出现前就先把每个代理隔离开的工作流。而当界面隐藏了关键状态时,满意度就会转为复杂,比如实际可用的是哪个模型、计划余量还剩多少,或者一个“便宜”的执行器是否只是把更多验证工作转移到了下游——这也正是人们在谈论 Antigravity 的模型菜单缺口、GitHub 审查界面的扩展性,以及 Space Bunny 的纠错成本时的表述方式。(Antigravity 来源、GitHub 来源、Space Bunny 来源)
常见的变通办法是显式拆分和封装层。人们在 Antigravity 中把云端规划器与本地构建器配对使用,用 Space Bunny 这样的快模型承担执行工作,同时把较慢的模型留给最后一轮,把并发代理隔离在 worktree 中,并用 nono 或 Stop That Shit 封装会话,而不是指望提示词本身承载策略。即使产品没有直接暴露这一能力,成本感知路由也已经在被手动执行。(Google 混合工作流、Pamela Fox 工作树、nono)
竞争态势正从“哪个单一模型最聪明”,转向“哪个技术栈能让我的工作流更清晰、更可理解”。GitHub 正在推进审查界面和自动化,Google 正在推进本地与混合运行时能力,而独立开发者则用防护层、沙箱、编排插件和代理间消息传递来填补空白。(Dependabot 自动化、Gemma 本地版、AX)
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| 智能家居控制器 | @burkeholland | 在 GitHub Copilot 中借助 Jev 构建的有状态家居控制界面 | 缩短从自然语言意图到已部署控制器之间的距离 | GitHub Copilot, Jev | Alpha | 推文 |
| Dependabot 审查自动化 | @github | 审查未关闭的 Dependabot PR,按风险分组,检查 CI,并撰写摘要 | 减少工作日前开始前重复进行的依赖审查分流工作 | GitHub Copilot 应用自动化、CI 状态检查、自然语言指令 | Shipped | 推文 |
| agy-humanroid-agents | @GoogleCloud_IN | 使用 Antigravity 根据高层意图提示编排六台人形机器人 | 在这一演示工作流中避免采用更重型的 ROS 式编排 | Antigravity、人形机器人、高层意图路由 | Alpha | 仓库, 推文 |
| Stop That Shit | @DanKornas | 一个用于约束范围、文件、依赖项和验证行为的技能与护栏 | 防止代理添加未被要求的工作、哈希值或额外副作用 | 技能封装器、边界检查、只读模式、子代理限制 | Shipped | 推文 |
| nono | @DanKornas | 面向 Claude Code、Codex、Copilot、Pi 等的最小权限 CLI 沙箱 | 避免代理默认获得整台机器的访问权限 | 沙箱配置、文件系统和网络规则、凭证代理 | Beta | 推文 |
| tin | @egeozin | 一个可从 Claude Code、Codex 或 Cursor 调用的开源营销工作流系统 | 用带明确取向的工作流、评估和重试,替代泛泛的“slop”循环 | MCP 集成、工作流评估、重试、定时运行 | Beta | 推文 |
| AX | @rcdexta | 让 Claude、Codex、Grok、OpenCode 和 Pi 能在本地命名会话中互相发消息 | 免去开发者在各代理之间手动传话 | 本地 TUI、跨代理消息路由、具备会话感知的回复 | Beta | 推文 |
| Fable Orchestrator | @DanKornas | 一个 Claude Code 插件,可将规划、常规工作和棘手任务切片路由给不同模型 | 避免把高价模型浪费在 grep、批量阅读和低风险的大批量工作上 | Claude Code 插件、Fable 5、Sonnet 5、Opus 5、ledger 和 hooks | Beta | 推文 |
| Sprites + Nebius toolkit | @flydotio | 用于在 Fly Sprites 中借助 Nebius inference 运行 Codex、OpenCode、Pi 或 Claude Code 的设置脚本 | 无需把 inference 密钥粘贴进运行时,也能为代理提供持久且隔离的计算环境 | Fly Sprites、Nebius 连接器、设置脚本、本地适配器 | Beta | 仓库, 推文 |
GitHub 的示例和这些护栏工具,是最清晰、也最反复出现的一类构建模式。GitHub 的 Dependabot 自动化把自主性收束到一个边界明确、输出可见的有限烦琐任务中;而 Stop That Shit 和 nono 则把策略外置到文件、配置和显式检查里,而不是把权限默认隐含在提示词中。这正是当下反复出现的一种形态:构建者正在打包监督机制和爆炸半径控制,而不只是再做一个通用聊天循环。
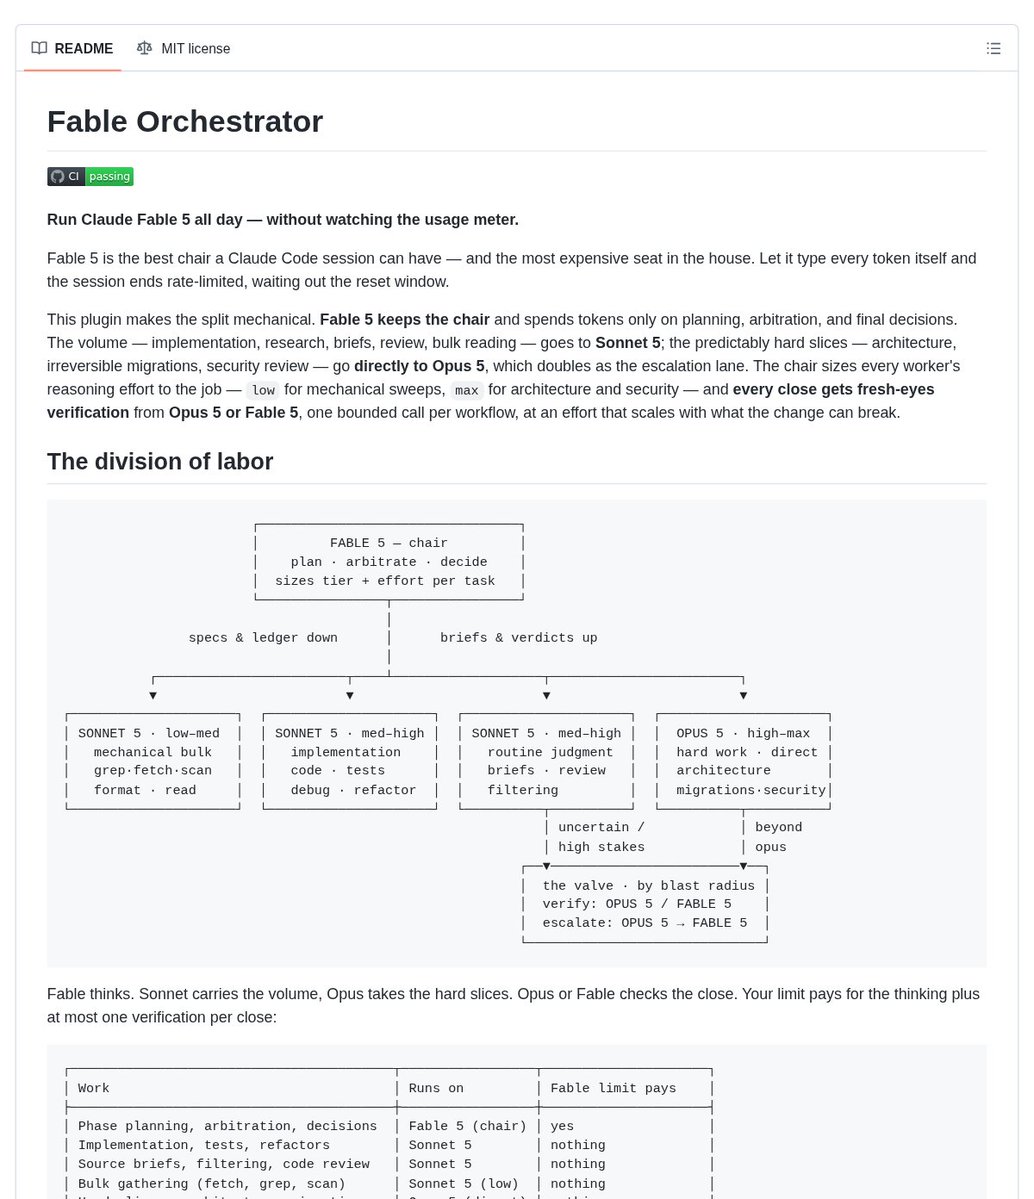
Fable Orchestrator、AX 和 tin 都指向第二种相同的模式:协调正在成为独立的产品层。Fable 把对成本敏感的模型路由变成带账本记录的工作流,AX 去掉了终端代理之间的人工中继,tin 则用分阶段任务、评估和重试取代了代理自由游走的方式。就连数据集中其他地方那些 Flash 或 Space-Bunny 风格的实验,也符合这一模式:人们越来越愿意把更窄的任务交给更窄的组件。

这些基础设施项目则把整个故事补全了。Antigravity 机器人集群仓库使用高层意图路由,而不是更重型的机器人技术栈;Fly 的 Sprites-plus-Nebius 工具包则把持久代理算力与 inference 凭证分离开来,让密钥保存在连接器中,而不是运行时中。纵观这些构建,最常见的触发点并不是“我想要一个更聪明的模型”,而是“我想要更清晰的边界、更便宜的常规工作,或者更少的人工中继”。
6. 最新与值得关注的内容
家用设备成了 MCP 的目标@heyorvian 强调了(6 个赞,431 次浏览,2 次收藏)Google 早期开放访问的 Home MCP 服务器,描述了一种流程:Claude Cowork、OpenClaw 或 Antigravity 可以检查 Google Home 设备状态、读取事件历史,并控制受支持的设备。真正值得注意的并非单纯的新奇,而是那些清晰可见的限制:Google 会阻止诸如门锁解锁之类的敏感操作,并明确告知用户应先从非敏感设备开始。这使 Home MCP 值得关注之处在于,它扩展了控制界面,同时其安全边界也已经明确可见。
Agent 流量开始被视为需要路由的对象,而不只是需要拦截的对象
@0xDevShah 发布了(9 个赞,1 条回复,76 次浏览,4 次收藏)Agent Detection-1,声称能够判断访问者是人还是 agent,识别具体是哪一种 agent,然后将有帮助的 agent 引导至 MCP 服务器、llms.txt 或 agent 卡片,同时拦截爬虫和凭证填充攻击者。支撑这一说法的证据仍然很早期,也带有宣传性质,但这本身已经是一个明确信号:一些开发者如今已假定 Claude Code、Codex 及类似 agent 正在以用户身份在 Web 上活动,他们想要的是可观测性和差异化处理,而不是一刀切地封禁 bot。
会话历史本身正在成为一道安全边界
@hackerlogs 报道(1 个赞,2 条回复,31 次浏览)称 Darktrace 研究人员发现,客户端转录历史可以被改写,从而让 agent 把伪造的既有授权当成真实授权;推文还声称,只要伪造了足够多的历史记录,就可能接管沙箱中的 Active Directory。即便这条推文也明确说明,这并不是远程 zero-day,且仍然需要对本地数据库进行写入,这一信号依然重要,因为它把威胁模型从“恶意提示”转移到了“转录历史完整性受损”。这也扩大了团队在将编码 agent 投入实际运行时必须保护的范围。

7. 机会在哪里
**+++] 受治理的本地与混合 agent 堆栈** —— 证据同时来自多个部分:Antigravity 中的 Gemma 4 与 LiteRT、Home MCP 的抢先体验流程、人形机器人编排仓库、关于 Antigravity 中 Opus 5.5 的抱怨、Stop That Shit,以及 nono。这个机会很强,因为第一方团队和独立构建者正在同一组需求上趋同:尽可能让工作保留在本地,开放当前模型,并将真正的权限转移到能够在工具调用和状态变化后依然生效的护栏中。([Gemma 来源,Home MCP 来源,nono 来源)
**++] 并行 agent 控制平面与审查运营** —— GitHub 的超大拉取请求渲染工作、Dependabot 分诊自动化、Pamela Fox 的工作树与 skills 操作手册、AX 的本地 agent 消息传递、tin 面向特定工作流的重试与评估,以及 Fable Orchestrator 带台账的模型路由,都指向同一个方向。这个信号处于中等偏强水平,因为痛点显而易见且反复出现,但最终的赢家更可能像工作流基础设施,而不是面向终端用户的聊天产品。([GitHub 来源,Pamela Fox 来源,AX 来源)
**+] 成本感知型模型路由与套餐管理** —— 对普通 Chat 限额的称赞、对 $500 Pro Max 档位的担忧、希望保留 GPT-5.6 Sol,以及愿意把 Space Bunny 当作快速执行器来使用,这些都表明用户已经在按边际成本分层思考。这是一个正在浮现的机会,因为需求很明确;但如果官方产品提供更清晰的路由、配额和回退控制,就可能吸收其中相当大一部分价值。([限额来源,价格传闻,Space Bunny 来源)
8. 要点
- 本地执行不再只是边缘演示;它正在成为周边基础设施。 在同一个 Antigravity 界面中,Gemma 4 加 LiteRT 与 Home MCP 设备控制、机器人编排,以及对模型目录的抱怨被放在一起讨论。(来源) 2.GitHub 和 Copilot 的竞争,不仅体现在代码生成上,也同样发生在代码审查和运维界面。 超大 PR 渲染、定时的 Dependabot 分诊,以及统一的行内建议模型,都表明工作流基础设施正成为主战场。 (来源)
- 套餐设计如今会直接影响用户对工具的信任。 用户将忠诚度系于消息上限,担心被迫升级付费,也反对在 Codex 中失去他们已经信任的特定模型。 (来源)
- 快速的专用模型正在被测试为执行者,而还不是最终把关者。 对 Space Bunny 最强的一些反馈称赞了它的速度,但仍提到需要多次修正、精度不足,或需要更好的最终把关模型。 (来源)
- 安全层正在固化为产品。 Stop That Shit、nono,以及类似 Darktrace 的伪造历史记录警告,都表明各团队正将代理边界、对话记录完整性和最小权限执行视为一级产品工作。 (来源)