Twitter AI 编程 - 2026-09-27
1. 大家在讨论什么
1.1 可复用的代理基础设施正进一步走向打包技能、工作树和托管运行时(🡕)
今天围绕 Copilot 和 Codex 的讨论,重点不在某个新模型,而在其周边的运行层。至少有五条内容支撑了这一主题:GitHub 关于并行会话的指南、社区对 OpenAI 官方技能目录的兴奋、Filecoin 的跨代理发布技能、Microsoft 围绕 Home/Code/Autopilot 与 Managed Runtime 的发布,以及一条互动不高但表述很准确的提醒:Copilot 的代码审查其实早在今年早些时候就已经迁移到代理式架构上。
@github 展示了(123 个赞,30 条回复,18,706 次浏览,38 次收藏)表示,GitHub Copilot 应用可以同时运行多个代理会话,每个会话都有各自独立的 Git 工作树和上下文。关联的 GitHub 博客文章 说明,其目标是让用户随时都能开启新会话,而不影响之前的会话。回复之所以重要,是因为大家立刻把这个功能变成了一场关于易用性的讨论:隔离解决了相互重叠的问题,却没有解决更高一层的任务——如何记住所有代理整体上到底想完成什么。
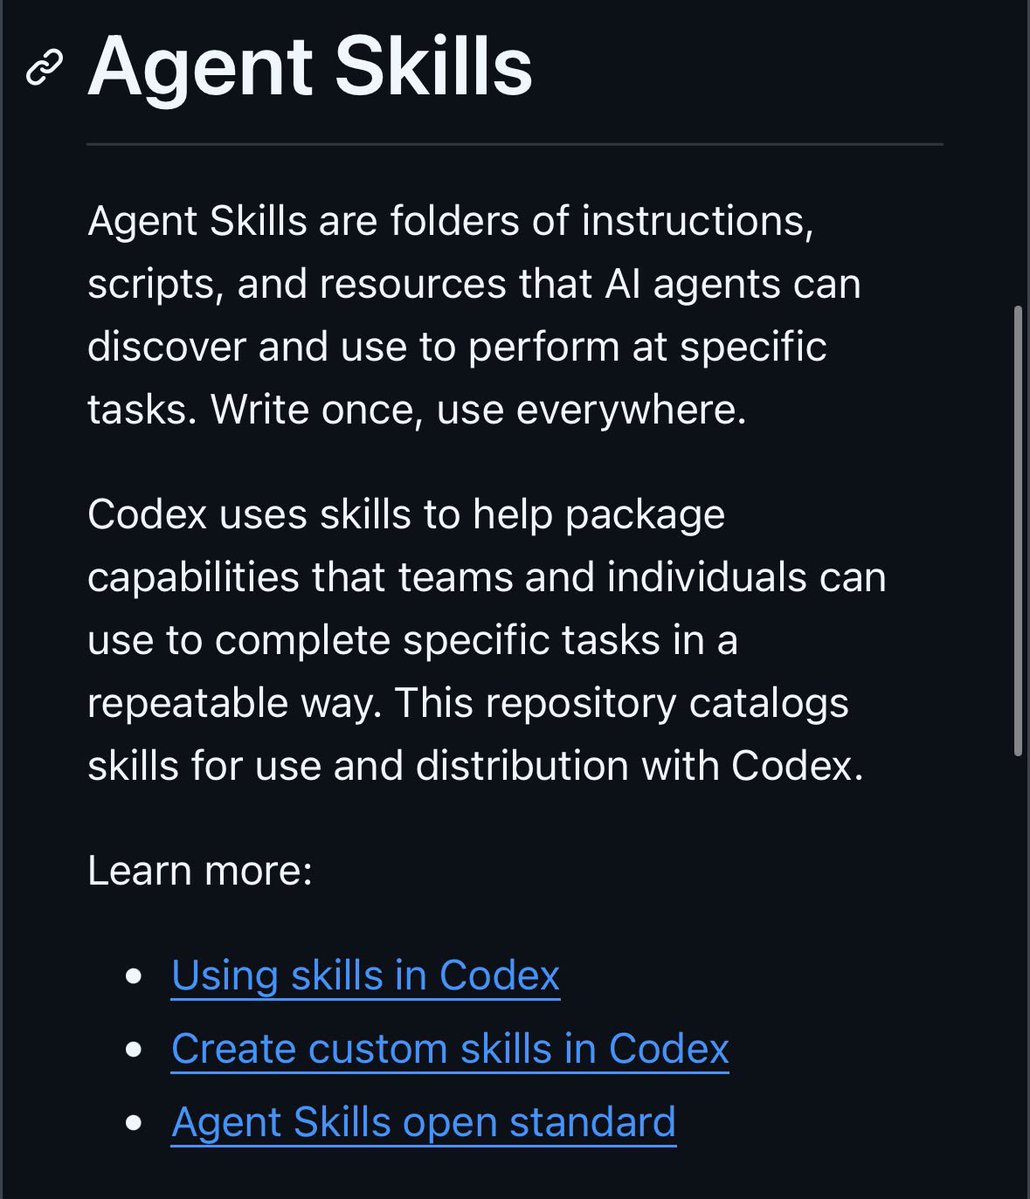
@RoundtableSpace 放大了这一点(55 个赞,12 条回复,44,131 次浏览,60 次收藏)提到了官方的 openai/skills 仓库,而截图也让社区想表达的主张一目了然:“一次编写,处处可用。” 仓库本身提供了一个有价值的细节:OpenAI 目前仍将技能描述为可复用的指令、脚本和资源文件夹,但当前 README 也把该仓库标记为已弃用,并引导转向更新的插件示例,这让相关讨论不只是单纯叫好。
@Filecoin 认为(134 个赞,6 条回复,7,601 次浏览,6 次收藏)表示,持久化存储也应该能跨终端移植。公开的 filecoin-skills README 显示,稳定版 publish 技能可以接收任意本地文件或文件夹,并返回一个公开且经过验证的 CID 链接,而且在 Claude Code、Codex、Cursor、Gemini CLI、GitHub Copilot 和 OpenCode 中使用的是同一套安装流程。这也契合了回复中最鲜明的模式:社区关心的不是存储品牌本身,而是一个可重复、可跨代理交接的流程,能把生成出来的工作变成持久化的制品。

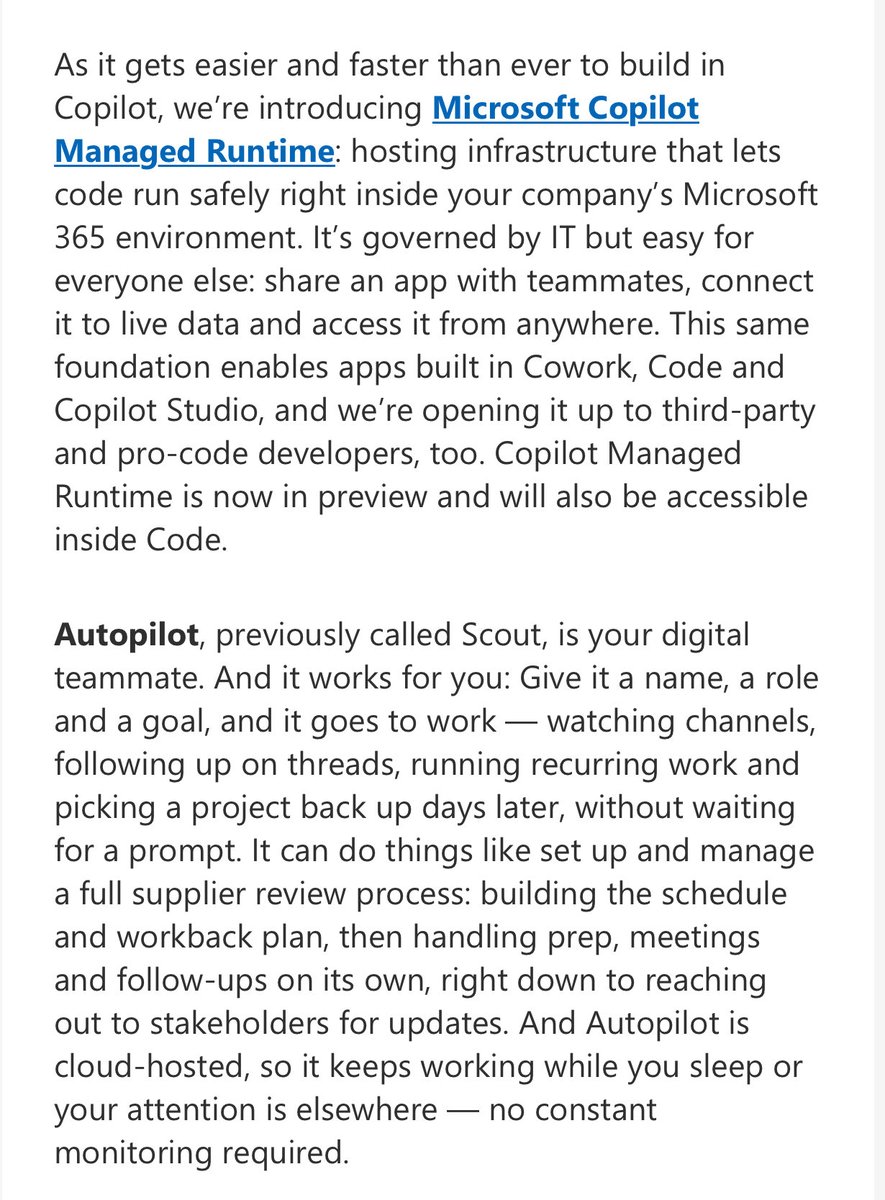
@DumbEinstein 总结了(1 个赞,1 次引用,53 次浏览)提到了 Microsoft 围绕 Home、Code 和 Autopilot 推出的新 Copilot 应用。官方的 Microsoft 公告 加上 Managed Runtime 文章,印证了信息流中流传的几个具体说法:Code 由 GitHub Copilot 技术驱动,Managed Runtime 会在 Microsoft 365 租户边界内托管生成的应用,而 Autopilot 则是一个云端托管的持久代理,拥有自己的身份、记忆、计算机和工作区。另一个互动较少但很有价值的配套帖子来自 @tompeakycoder 认为(2 个赞,2 条回复,37 次浏览),其指出,如果要让自主编码继续保持可信度,GitHub 的代码审查架构同样需要更广泛的仓库上下文。

讨论洞察: 大家的共同诉求,已经不再是“给我一个更聪明的模型”,而是“让周边运行时能够在不同会话、技能和部署边界之间实现可移植、可检查、可持久化”。
与前一天对比: 9 月 26 日已经强调了 Microsoft 的 harness 统一和租户托管运行时叙事;到了 9 月 27 日,这个方向又进一步深入到了可复用技能、跨代理安装、工作树隔离,以及基于仓库上下文的审查。
1.2 审查和 CI 开销成了“代理运行之后”的主线故事(🡕)
信息流中最强烈的实用主题是:生成速度不断提升,痛点却持续向下游转移。至少有六条内容支撑了这一点:Nick Dobos 谈堆叠 PR 和 CI 成本,Michael Jovanovic 对 GitHub 运行时重写的总结,Jev Code Reviewer,Verity 新推出的代码地图工作,对 Copilot 代理合并 UX 的一手抱怨,以及一种很受欢迎的提示词模式——强制模型标注它实际验证了什么。@NickADobos 称(100 个赞、10 条回复、16,206 次浏览、41 次收藏)把堆叠式 PR 称作一种“黑暗模式”,理由是即便写代码的速度提升了“100 倍”,一旦团队要在大量彼此依赖的小型 pull request 上跑机器人和各类检查,CI 用量仍可能迅速失控。被引用的源头是 @Altimor 的抱怨:CI 已成头号瓶颈,而 runner 支出高得“离谱”。最有价值的回复并没有否认这个问题,而是把它重新框定为基础设施设计问题,并提出了对 DAG 形堆叠、远程缓存和并发队列的需求。
@mjovanovictech 分享了(67 个赞、12 条回复、5,279 次浏览、49 次收藏)则展现了同一矛盾更极端的版本:GitHub 的 Copilot 运行时在大量 agent 协助下从 TypeScript 迁移到 Rust,过程中最高提速 21 倍,但“没有人读过每一行代码”。这些回复之所以值得注意,是因为它们纠正了传播最广的那个过度简化说法——这并不是一位普通工程师单枪匹马完成的奇迹——同时又没有否定更大的结论:审查实践已跟不上变更量的增长。
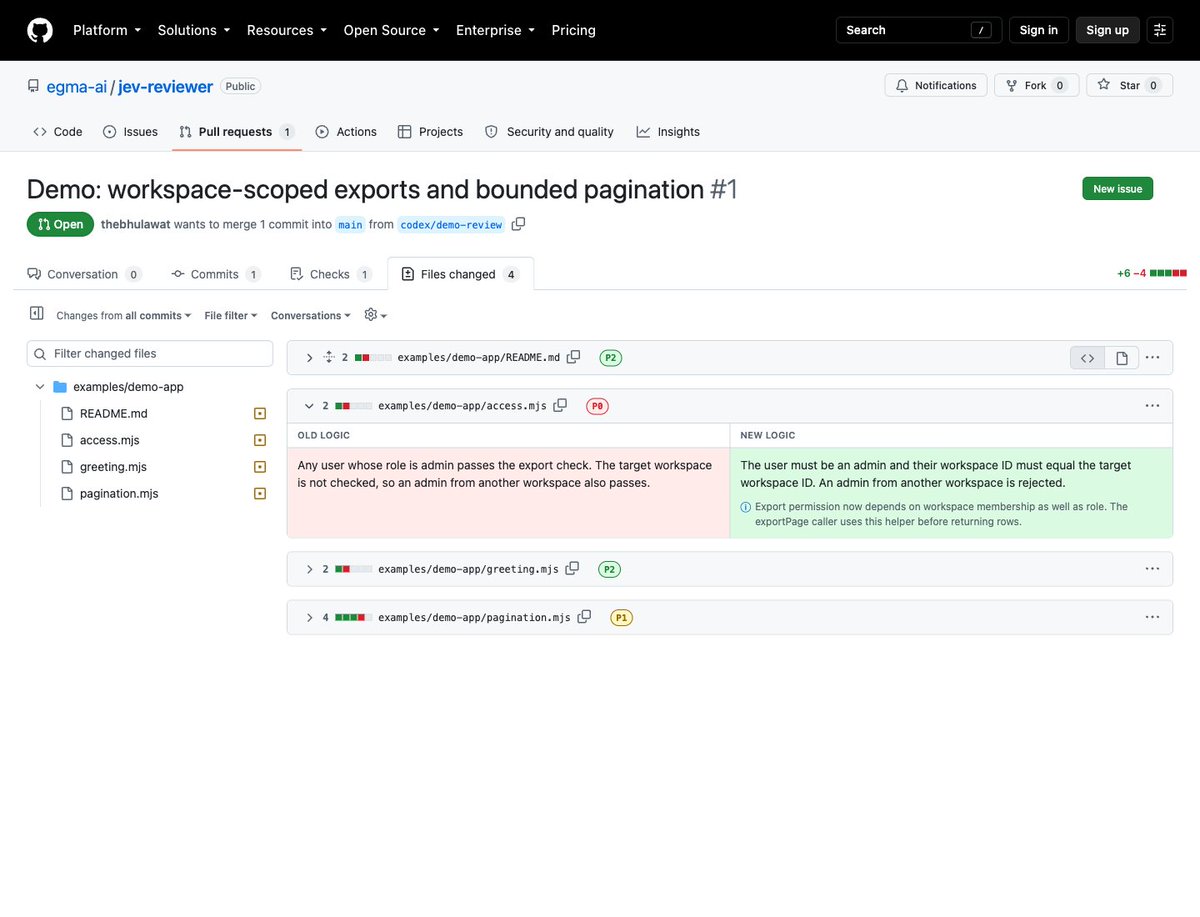
@tonysimons_ 重点介绍了(7 个赞、5 条回复、474 次浏览、4 次收藏)Jev Code Reviewer,这是一个本地工具,会把 agent 编写的变更按 P0/P1/P2 分级,好让人类先查看最重要的逻辑,而不是按路径顺序去读一个涉及 230 个文件的 PR。该仓库的 README 证实了回复中提到的一个关键限制:默认只分析前 12 个变更单元,因此它明确只是一个优先级排序层,而不是什么能实现完整覆盖的魔法工具。
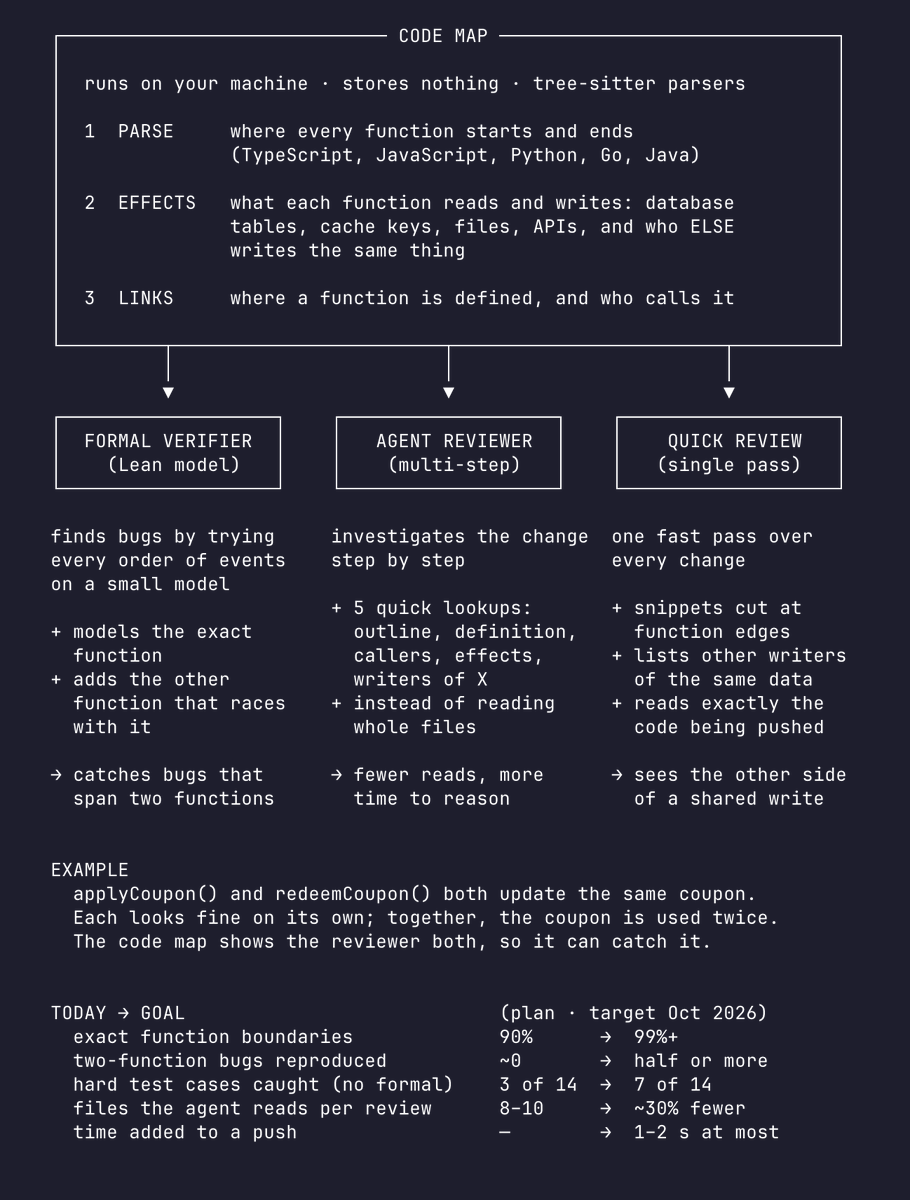
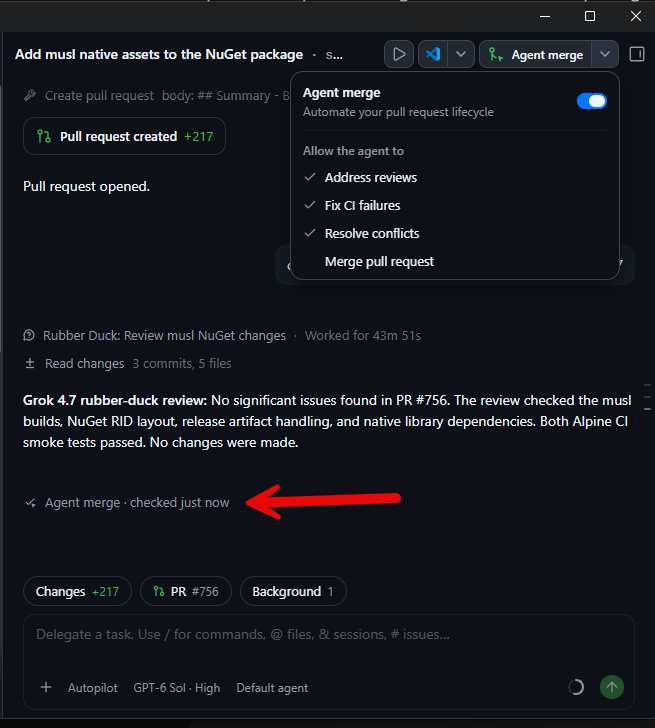
第二个来自构建者的回应是 @jaimefjorge 描述(171 次浏览、3 次收藏):这是 Verity.md 的一套新代码映射系统,使用 tree-sitter 的函数边界、effect tracking 和快速审查路径,让同行评审 agent 在时间预算极紧、又无法访问整个仓库的情况下,仍能进行推理。这与 @awakecoding 表示(284 次浏览)的观察高度呼应:相比 GitHub Copilot 的 agent-merge 功能,Claude Code 的 CI 反馈界面显得更紧凑、更清晰,因为 Copilot 只显示它已经“检查过”这个 PR,却没有展示具体哪些状态发生了变化。
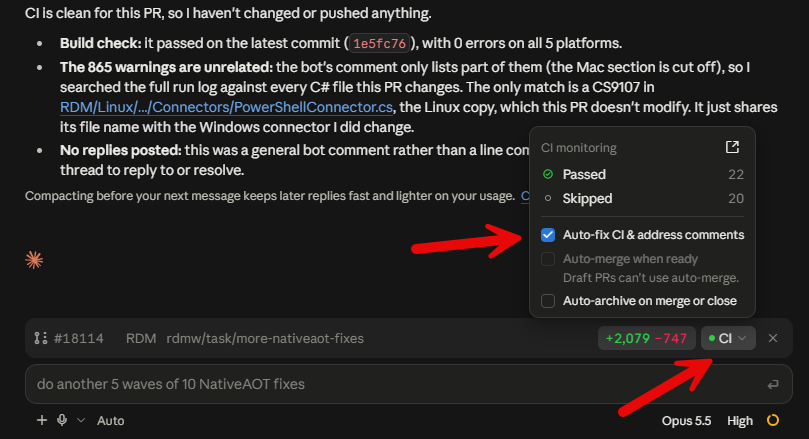
最小巧但也最容易复用的策略来自 @kloss_xyz 询问(23 个赞、4 条回复、1,515 次浏览、30 次收藏):要求 agents 列出所有假设,将每一项标记为“已验证”或“猜测”,提出一个外科手术式的修复方案,然后停下来交由人工审查。有一条回复进一步收紧了这个方法,要求每一条“已验证”的结论都附上 file:line 引用。
讨论洞察: 信息流里并不只是在抱怨审查。它正在收敛出一个共同诊断:上下文丰富的审查者、优先级排序、精确的函数边界,以及明确的不确定性报告,如今已是产品需求,而不是可有可无的润色。
与前一天的对比: 9 月 26 日已经出现了“审查花了两天”的抱怨。到了 9 月 27 日,则进一步出现了用于应对这一瓶颈的具体操作工具、图示和 UI 对比。
1.3 Antigravity 依然保持可见度,但更响亮的叙事是:它仍然显得来得太晚,也缺乏新意(🡒)
Google 的 Antigravity 依旧吸引注意力,但这份关注分裂成了两端:一端是实用的工作流技巧,另一端则是更持久的一种感受——这个产品在模型新鲜度和易用性上落后于同类。至少有四条内容支撑了这一主题:Ai with Abbas 的 NotebookLM 搭配方案、Sahil Panhotra 对模型陈旧的抱怨、ZypherHQ 引发的病毒式反弹,以及 Jonathan Wilke 提出的观点——显式计划模式本就不该再存在。
@AiwithAbbas 推动了(57 个赞、23 条回复、1,670 次浏览、44 次收藏)是当天最明显偏正面的 Antigravity 帖子:它把 Antigravity 与 NotebookLM 搭配使用,并在回复中拆解了四种具体的提示词模式:研究辅助、YouTube 内容拆解、内容再利用,以及学习指南。这一点之所以重要,是因为它表明,即便周围整体情绪依然严厉,用户仍然能从这套组合中获得真实的实用价值。
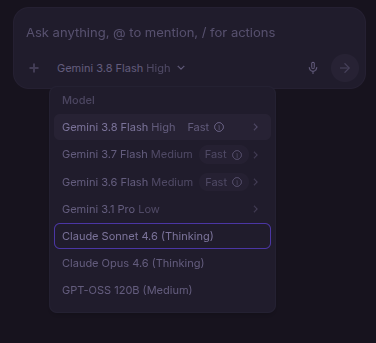
但负面一侧的分量更重。@SahilPanhotra 认为(240 个赞、48 条回复、11,904 次浏览、13 次收藏)指出,Google 仍未刷新 Antigravity 里的 Claude 选项;随附的模型选择器也让这一抱怨有了确凿依据,因为其中显示的仍是 Claude Sonnet 4.6 和 Opus 4.6。@ZypherHQ 引用转发了(137 个赞、19 条回复、16,024 次浏览)提到了官方的 /plan 上线,并称 Antigravity“还停留在石器时代”;回复区也大多没有为这一功能辩护,反而进一步强化了“发布太多,打磨不够”的批评。
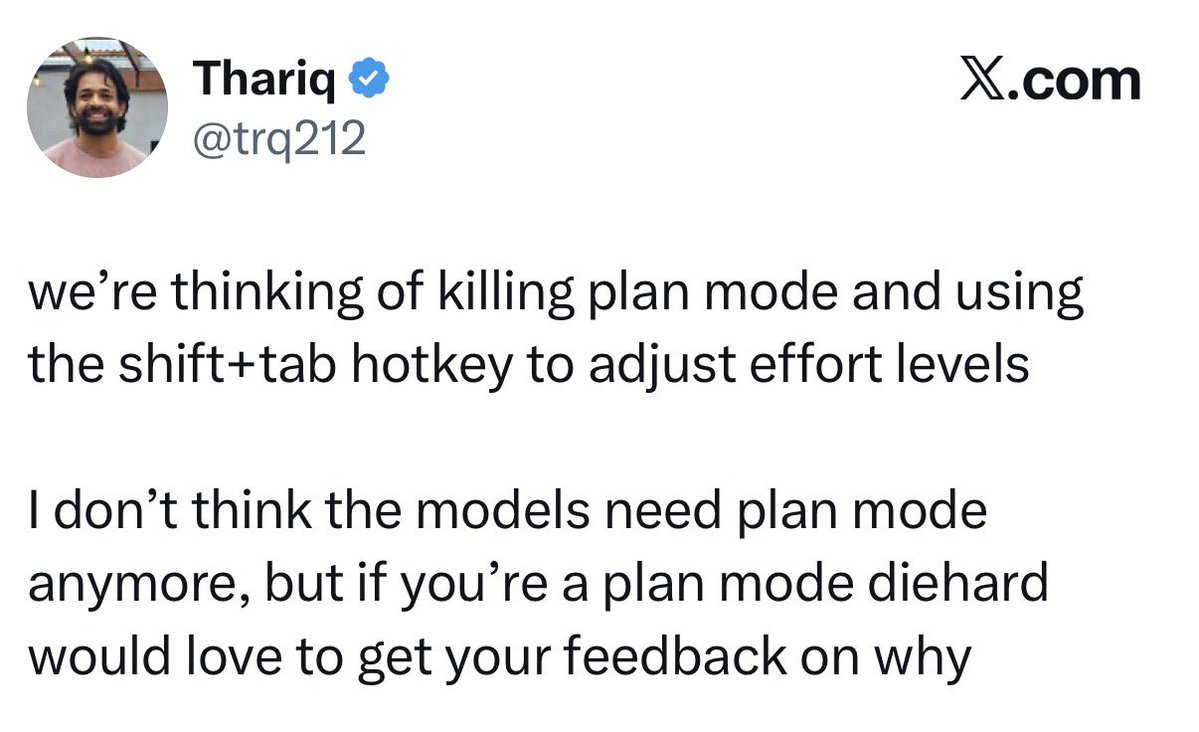
@jonathan_wilke 进一步表示(13 个赞、10 条回复、2,949 次浏览、2 次收藏)则表示“根本没必要有规划模式”,并认为模型或运行框架只需在相关决策上让用户保持参与即可。附图之所以重要,是因为它曝光了一条带有内部口吻的建议:可以砍掉规划模式,改用工作强度控制。这使得这条抱怨从泛泛的反 Google 情绪,升级为一场关于工作流理念的争论。
讨论洞察: 信息流并不是在全盘否定结构化规划,而是在否定这样一种说法:结构化规划能弥补模型选项陈旧的问题,或让一个已经落后的运行框架显得与时俱进。
与前一天对比: 9 月 26 日,/plan 被视为一个重要的情绪爆点,并与账户摩擦相关的抱怨并列出现。到了 9 月 27 日,关于工作流的争论仍在继续,但更尖锐的批评变成了:模型本身依然显得过时。
1.4 OpenAI 和 Codex 的讨论重心,从单纯追捧模型转向配额、分层与服务入口(🡕)
围绕 OpenAI 的讨论依旧密集,但重心已转向用户实际能用花出去的钱和可接受的延迟换来什么。至少有六条内容支撑了这一主题:Pro 页面上消失的使用倍率说明、一个 500 美元“Pro Max”档位的泄露、一个浮出的“ultrafast”层级、Theo 对 Opus 5.5 使用量的测算、直接显示额度耗尽的截图,以及付费用户公开表示离开 Codex 转投 Claude。
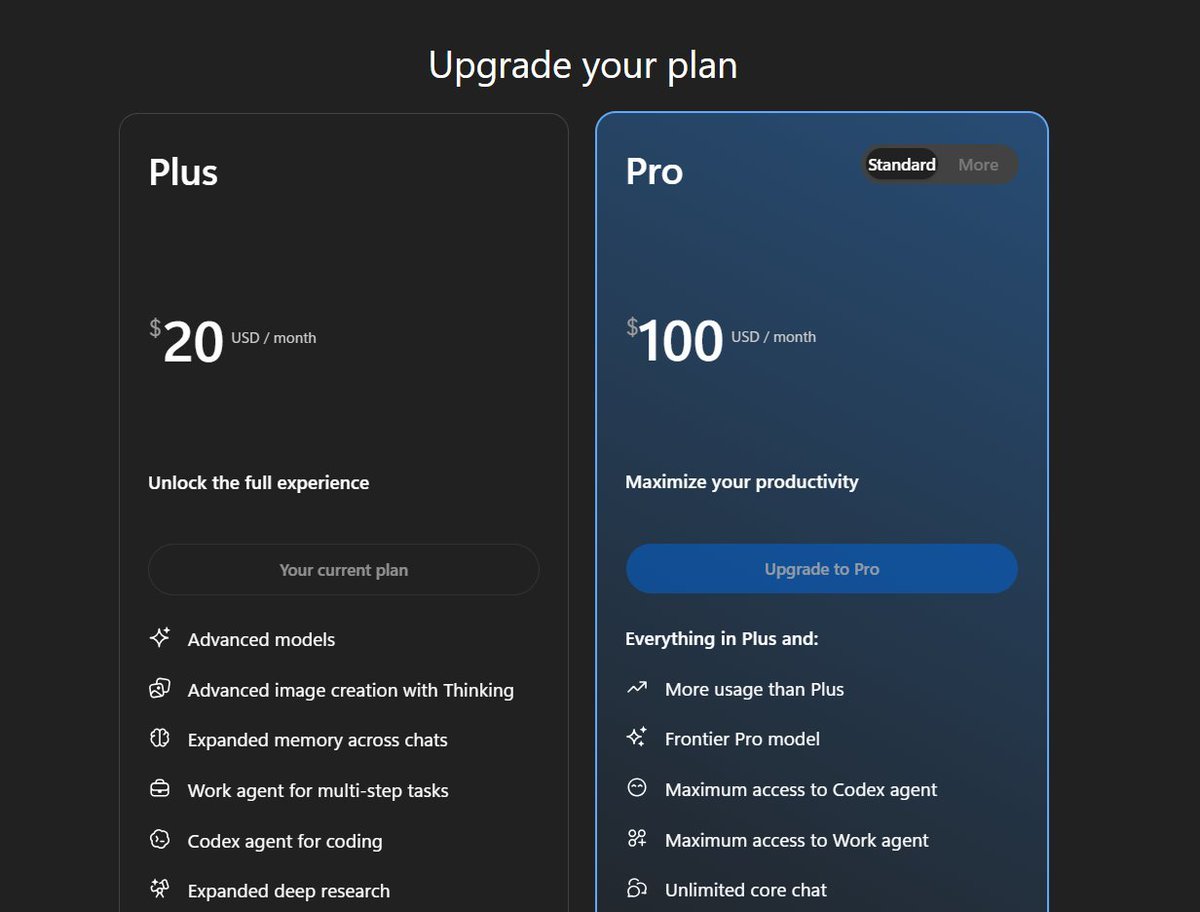
@CodexResets1 表示(91 个赞、6 条回复、12,775 次浏览、8 次收藏)指出,OpenAI 的 Pro 定价页面已不再显示旧版的 5x 和 20x 使用量表述。随附截图展示了关键变化:产品价格仍是每月 100 美元,但差异化描述如今只写“More usage than Plus”,这使得有关透明度的抱怨很难再被轻易斥为传言。
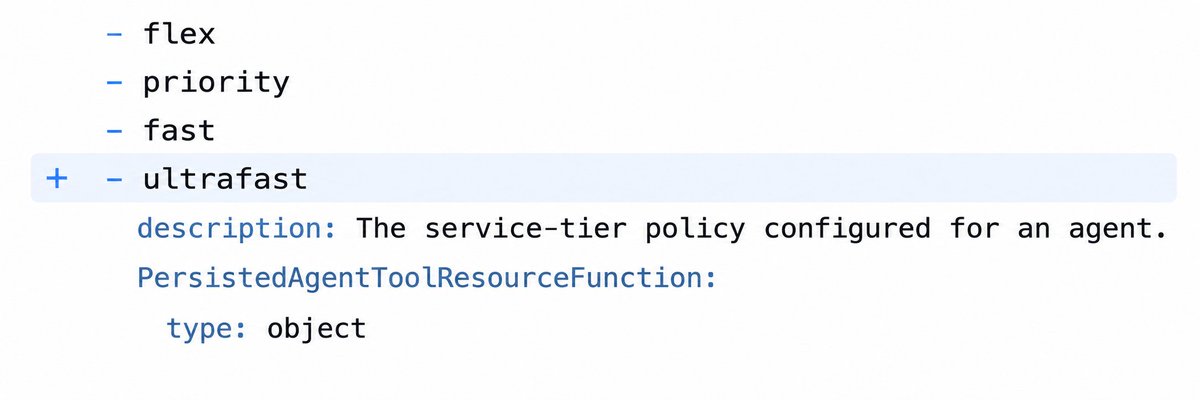
@13_niakris 发布了(3 个赞、1 条回复、16 次浏览、1 次收藏)提到一段前端代码泄露,指向一个每月 500 美元的“ChatGPT Pro Max”档位,其卖点围绕“Fastest Work and Codex”,而不是更聪明的模型。@CodexResets1 补充说(17 个赞、1,525 次浏览、3 次收藏)则展示了一张 ultrafast agent 服务层级字段的截图,进一步把讨论推向针对长时任务的付费控制界面,而不再只是简单的“最佳模型胜出”式表述。

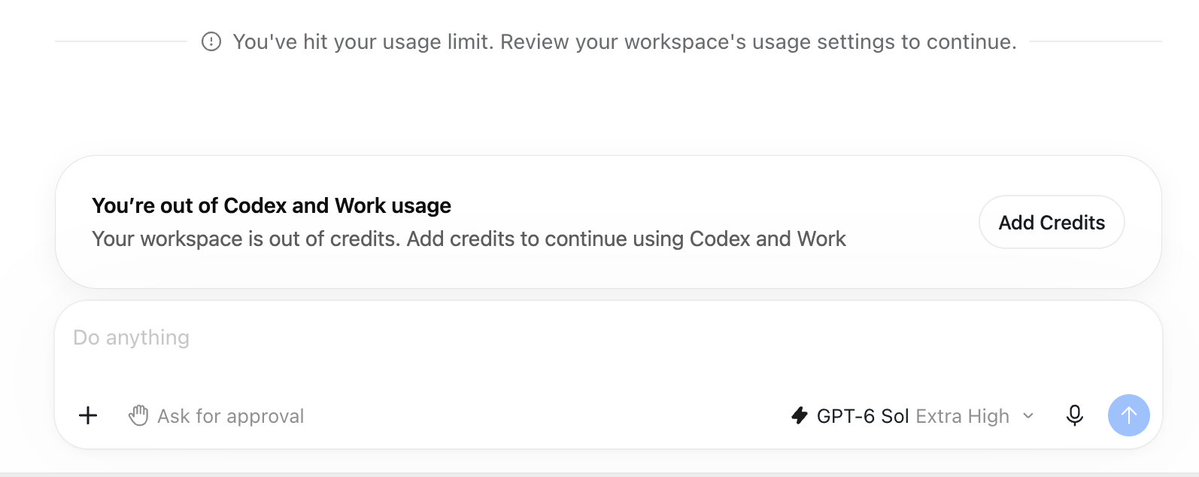
这种迁移压力也已在一手使用帖中清晰显现。@theo 解释了(66 个赞,10 条回复,2,382 次浏览)解释了为什么相比 Fable 5.1,Opus 5.5 会让人感觉“几乎没有上限”:Fable 采用半限额策略,而 Opus 5.5 的单任务成本更低。@ann_nnng 展示了(2 个赞,2 条回复,250 次浏览)展示了一个简单项目之后,实时出现“你的 Codex 和 Work 用量已耗尽”的界面;而 @samifathi 表示(4 个赞,2 条回复,453 次浏览)则表明,即便是 20x Pro Codex 套餐,也不足以阻止作者转回 Opus 5.5。

讨论洞察: 信息流越来越倾向于把前沿编程工具当作云服务套餐来看待:清晰度、延迟、每周可用余量,以及故障时的表现,重要性至少已经和基准成绩的光环相当。
与前一天的对比: 9 月 26 日的重点是重置、故障和路由逻辑。9 月 27 日依然延续了对定价的焦虑,但焦点进一步收窄到产品包装上:含糊的用量表述、更快的付费层级,以及明显向“限制最少”的套餐迁移。
2. 什么让人沮丧
Review、CI 和 PR 的可读性,如今成了快速生成代码必须付出的代价
最强烈的不满,并不是代理不会写代码,而是人类仍然必须理解并验证代理写出的内容。@NickADobos 认为(100 个赞,10 条回复,16,206 次浏览,41 次收藏)指出,多层堆叠的 PR 工作流会把 AI 的速度优势转化为 CI 账单;其引用的 @Altimor 则把 CI 视为当前工程中的头号瓶颈。@mjovanovictech 补充道(67 个赞,12 条回复,5,279 次浏览,49 次收藏)呈现了同一问题更令人不安的一面:一次大规模运行时重写,即便“没有人逐行读过”,落地后也可能带来显著提速。
信息流中的应对策略,几乎全都是审查辅助,而不是生成辅助。@tonysimons_ 推荐大家使用 Jev Code Reviewer,以便先查看 P0 逻辑;@awakecoding 更偏好 Claude Code 紧凑的 CI/PR 界面,而不是 Copilot 对 agent-merge 更模糊的表述;@kloss_xyz 则建议,在应用任何修改前,强制模型先把已验证事实和猜测分开。严重程度:高。值得构建:高。
Premium Codex 的用量规则仍然过于不透明,也太容易耗尽
第二个让人沮丧的问题是:高级定价并不一定能稳定换来可预期的可用余量。@CodexResets1 展示了(91 个赞,6 条回复,12,775 次浏览,8 次收藏)提到,Pro 页面不再明确写出 5x/20x,转而改成“比 Plus 提供更多用量”;与此同时,@13_niakris 又叠加了一个带有猜测性质的 500 美元 Pro Max 层级,主打“最快的 Work 和 Codex”。这样的组合,与其说是在提升清晰度,不如说更像是在不断移动目标。
一手使用报告让这种挫败感变得非常具体。@ann_nnng 达到(2 个赞,2 条回复,250 次浏览)展示了一个小型 vibe-coding 项目就触发的实时“Codex 和 Work 用量已耗尽”状态,以及 @samifathi 表示(4 个赞、2 条回复、453 次浏览)都表示,即便是 20x Pro Codex 方案,也不够宽松,依然不足以让人不转回 Opus 5.5。反过来,@theo 认为,Claude 相对更宽裕的额度,正是让 Opus 5.5 在实际使用中几乎像不限量一样的主要原因。严重性:高。值得做:高。
Antigravity 仍然不够“当下”,撑不起外界对它的热捧
Antigravity 面临的具体挫败感,不是缺少想法,而是人们依然不信任执行层。@SahilPanhotra 指出,选择器里仍能看到旧版 Claude;@ZypherHQ 形容这款产品还停留在“石器时代”;@jonathan_wilke 则表示,如果模型或执行框架本来就知道何时该放慢节奏并请求输入,那么显式的规划模式根本就不该存在。
更严重的是,那些正面帖子其实并没有真正反驳这一点。@AiwithAbbas 表明,人们仍然可以通过把 NotebookLM 和 Antigravity 搭配起来获得价值,但那只是工作流层面的权宜之计,并不能证明其核心编码界面在体验上领先同类产品。严重性:中高。值得做:中高。
3. 人们希望看到什么
一个可移植的技能与制品层,在工具切换后依然延续
最明确的结构性需求,是跨 shell 的连续性。@github 提出了相互隔离的并行会话,@RoundtableSpace 放大了可复用技能的重要性,@Filecoin 则论证了在 Claude Code、Codex、Cursor、Gemini CLI、GitHub Copilot 和 OpenCode 之间采用统一安装路径的必要性。随后,@cryptowluha 又援引 Codex 论文中 26.6% 的技能使用率,作为可复用工作流封装已不再是边缘行为的证据。
人们想要的,似乎是这样一层:无论这个月流行的是哪个 shell,技能、制品和交接都能延续下来。这是明确存在的需求,不是投机性的设想。机会:直接。
能解释优先级、不确定性和当前状态的审查界面
第二类需求,是生成之后的可理解性。@tonysimons_ 推 Jev,是因为人们需要的是按优先级排序的关注点,而不是又一份完整 diff;@awakecoding 希望能在提示词所在的位置直接看到 CI 和 PR 状态;@jaimefjorge 在处理精确的函数边界和影响映射;而 @arkyyang 则总结了一篇论文的观点:重试、可见性和“恰好一次”行为应当属于工具契约,而不只是模型提示的一部分。
这已经不只是想要“更好的代码审查”。人们想要的是这样的系统:它能说明改了什么、哪里有风险、哪些只是推测,以及哪些操作可能重复执行过,或只完成了一部分就失败了。机会:直接。
让重度用户觉得可预期的定价、容量余地和延迟控制
第三类需求,是能对应真实工作的定价清晰度。@CodexResets1 关注会消失的使用倍率,@13_niakris 关注可能推出的 500 美元 Pro Max 档位,@theo 关注不同任务之间的效率差异,而 @samifathi 则提到,尽管已经在为高级方案付费,自己仍然选择切走。
这不只是“把价格降下来”这么简单,而是“告诉我我能得到什么,让我能把合适的任务路由到合适的档位,而且不要在会话中途给我来个措手不及。” 这个市场看起来已经很有竞争性,所以机会确实存在,但也相当拥挤。机会:竞争型。
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GitHub Copilot 应用 | Agent shell | (+/-) | 并行会话、隔离的 Git worktree、保留每个会话的上下文 | 连续性仍需人工协调,合并冲突也仍需人工解决(来源) |
| OpenAI Agent Skills | 技能封装 | (+/-) | 可复用的文件夹,内含说明、脚本和资源;可移植性叙事很强 | 该仓库现已标记为 deprecated,转而推荐更新的插件示例;回复中也提到了安装和依赖方面的注意事项(来源) |
| Microsoft Copilot 托管运行时 | 托管运行时 | (+) | 在 Microsoft 365 租户边界内运行应用,具备身份、治理、资产清单和管理员控制能力 | 仍处于预览 / Frontier 推出阶段,且主要适用于以 Microsoft 为核心的组织(来源) |
| Claude Code + Opus 5.5 | 编码 agent + 模型 | (+) | 体感性能强,在 Theo 的示例中单任务成本低于 Fable 5.1,且可用余量显得相当充足 | 用户仍在讨论 5 小时限制,以及未来进一步收紧的风险 |
| Codex / GPT-6 Sol | 编码 agent + 模型 | (+/-) | 终端工作流很受欢迎,套餐分层实验活跃,并提供大额高级计划 | 积分消耗快、用量表述模糊,以及额度突然耗尽,是常见抱怨(来源) |
| Antigravity | 编码 agent | (-) | 与 NotebookLM 的搭配,以及明确的规划式工作流,仍在吸引用户尝试(来源) | 模型阵容陈旧、持续被描述为“落后于同行”,以及对是否真的需要规划模式的质疑 |
| Jev Code Reviewer | 审查工具 | (+) | 按优先级排序的 P0/P1/P2 差异、自然语言逻辑视图、本地优先的审查流程 | 默认覆盖范围只分析前 12 个变更单元,除非手动扩大范围(来源) |
| Open-Agent-DB | 注册表 / 发现 | (+) | 已索引 3.48M+ 资产、113k+ MCP 服务器,覆盖七个生态的 FTS5 与稠密向量搜索 | 刚刚上线、仍处于早期验证阶段,而且若要完整本地使用,离线数据库体积非常大(来源) |
| Isoquant | 推理 API / 端点 | (+) | OpenAI 兼容端点、更低延迟的 GLM-5.3-Flash 指标,并支持缓存和工具 | 这是信息流中非常新的服务,目前独立验证仍然有限 |
整体满意度并没有分化为“好产品”和“坏产品”,而是分化为人们能够路由并检查的产品,与那些仍会让人措手不及的产品。Claude Code 之所以受益,是因为人们在实际使用中既觉得它更强,也觉得限制更少;而 Codex 依然保有心智份额,因为人们想要它的终端工作流,并且会密切关注它每一次新界面泄露。常见的应对方式包括:给审查注意力排优先级、强制模型披露假设、把产物迁移到可移植存储中,以及把廉价或高吞吐任务路由到低成本端点。
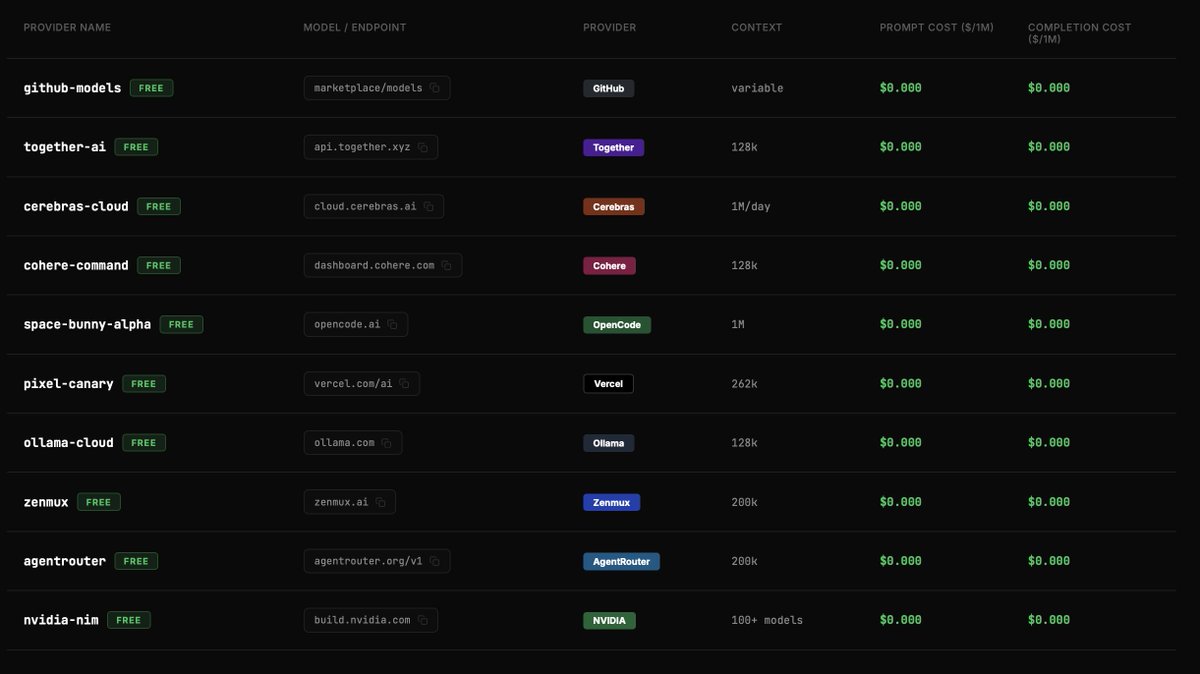
迁移模式也比昨天更清晰:人们比较的不只是模型,也是在比较订阅行为。@samifathi 认为 20x Codex 套餐仍然不够用,而 @theo 则将 Opus 5.5 的优势归因于政策与效率的组合,而非纯粹的智能。围绕免费或低成本端点的竞争态势也同样嘈杂。@0x_kaize 分享(38 次点赞,14 条回复,2,432 次浏览,30 次收藏)是一张很受欢迎的免费 API 表格,里面仍然列着 GitHub Models;但 GitHub 自己的 文档 和 更新日志 显示,该服务已于 2026 年 7 月 30 日完全退役。这种不一致本身就是一种市场信号:人工整理的速查表老化速度,已经快于平台格局的变化。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Agent Skills | @RoundtableSpace,推广 OpenAI | 可复用 Codex 技能及技能打包示例的公开目录 | 在不同会话和代码仓库之间反复手动重复同样的 agent 工作流 | Markdown 技能文件夹、脚本、Codex 技能目录 | 已发布 | 仓库, 文章 |
| Jev Code Reviewer | @tonysimons_,推荐 egma-ai | 将大型 PR 改写为按 P0/P1/P2 划分的审查单元,并附带自然语言说明 | 人类难以按原始 diff 顺序舒适地审查包含 230 个文件的 Agent PR | JavaScript、本地 CLI/server、Chrome 扩展、OpenAI + TypeSafe | Beta | 仓库、文章 |
| Open-Agent-DB | @ns0bj | 面向技能、MCP 服务器、指令和 Agent 规则的离线优先注册表与语义搜索引擎 | Agent 资产分散在各类注册表、代码仓库和文档中 | Python、Node、SQLite FTS5、Parquet embeddings、Hugging Face dataset | Beta | 仓库、文章 |
| geo-sleuth | @DanKornas,推荐 Oldcircle | 可跨 Agent 使用的技能,能够对照片进行地理定位,并返回附带证据的地点假设 | 基于图像的调查仍然需要过多手工地图操作 | Python、SKILL.md、OpenStreetMap、海拔数据、卫星影像、街景 |
Beta | 仓库、文章 |
| GAAI | @DanKornas | 基于文件夹的治理框架,将探索与交付拆分开,并把 backlog 视为契约 | 高速 Agent 容易偏离范围,需要更清晰的验收边界 | Backlog 工作流、隔离的 Claude/Codex 会话、分阶段规划 / 实施 / QA | Alpha | 文章 |
| Godmode Bot | @daniiie7 / Codext | 具备真实浏览器访问、加密登录保险库和 Agent 记忆的持久 AI 协作伙伴 | Agent 往往卡在登录页面,或不得不以不安全的方式处理密钥 | TypeScript、Tauri、Claude Code、browser-use、加密保险库、Web 仪表盘 | Beta | 仓库、文章 |
最重要的构建模式并不是“另一个完整 IDE”,而是可封装的能力。OpenAI 的 skills 仓库、Filecoin 的发布技能,以及 geo-sleuth 都指向同一个思路:把某个工作流一次性做成一个技能文件夹,然后让 Claude Code、Codex、Cursor、Gemini CLI、Copilot 或 OpenCode 以极少转换直接调用。OpenAI 这个仓库本身已经弃用,转而推荐 plugin examples,但这种可移植模式仍然活跃在人们选择推荐的项目中。
第二类项目聚焦于 Agent 写完代码之后的人类控制。Jev 和 Verity 都认为,直接审查原始 diff 已经无法扩展,因此它们转而收窄注意力范围——Jev 采用明确的 P0/P1/P2 优先级划分,Verity 则使用函数边界、effect maps 和快速审查路径。GAAI 则把同样的思路提前到了生命周期更早的阶段,试图将探索与交付分开,避免代码还未落地,范围就已经蔓延失控。
第三种模式是访问与发现基础设施。Open-Agent-DB 试图让快速膨胀的 skill / MCP / project-rule 生态具备互联网规模的可搜索性,而 Godmode Bot 试图解决相反的问题:一旦 Agent 知道该做什么,如何才能让它安全地穿过登录页面,进入真实浏览器会话,而不把密钥直接塞进提示词里?它们位于技术栈的不同层,但两者之所以存在,都是因为如今不再只有核心模型这一块缺失拼图。
6. 新动态与值得关注的内容
Codex 采用论文让 agentic 用法变成了可量化证据
@cryptowluha 提到(3 个赞、1 条回复、103 次浏览、3 个收藏)这篇论文 向 Agentic AI 的转变:来自 Codex 的证据。摘要称,Codex 活跃用户在 2026 年上半年增长了五倍以上;超过 10% 的用户每周都会在某个时点管理 3 个或更多并发 Agent;26.6% 的用户会使用 skills 来共享复杂工作流的指令。这一点很重要,因为当天信号最强的几条帖子中,有好几条都在讨论 worktrees、skills 和并行会话;这篇论文表明,这些已不再只是小众习惯。
SkillGym 把关于 skills 的讨论从封装推进到了模型训练@dair_ai 重点介绍了(3 个赞、700 次浏览、3 次收藏)SkillGym,这篇论文的核心是将人类编写的技能转化为可执行的训练环境。根据摘要,SkillGym 构建了 2,756 个环境,收集了 8,364 条成功轨迹,随后让 Qwen3.5-35B-A3B 在 Terminal-Bench 2.1 上提升了 19.10 分,在技能辅助版 SkillsBench v1.1 上提升了 28.13 分。这一点尤其值得注意,因为今天的社交流将技能视作可移植的文件夹和可安装的工作流;而 SkillGym 则认为,同样的材料如果被模型内化,可能更有价值。
“Exactly-once” 研究让工具契约成为 AI 编码中的头等问题
@arkyyang 总结了(177 次浏览)论文 Exactly-Once 究竟存在于哪里?,探讨的问题是:重复副作用究竟应该由模型、执行框架,还是工具契约来解决。摘要中最突出的结果是:幂等键将重复率从 28% 降至 4%,而当请求仍在处理中或被重复送达时,模型质量的重要性就小得多了。这很重要,因为信息流中的其他讨论也始终围绕代码审查、CI 和计费信任问题打转:可靠性的重心正在从模型本身,转移到模型周边的接口与契约。
7. 机会在哪里
**+++] 针对代理编写变更的审查控制平面** —— 证据来自各个角度:堆叠式 PR 和 CI 相关的抱怨([来源),“没人会逐行读完”的重写案例(来源)、像 Jev 这样的排序差异工具(来源)、Verity 的代码地图工作(来源),以及 “exactly-once” 论文提出的警告:当副作用发生重复时,智能体往往会过度宣称成功(来源)。这个方向机会很大,因为痛点强烈、权宜之计笨拙,而且人们已经在尝试各种点状解决方案。
[+++] 跨智能体的技能、产物与工作流可移植性 —— GitHub 的 worktree 会话、OpenAI 的技能框架、Filecoin 的一次安装即可发布技能、geo-sleuth 的 SKILL.md 打包方式、Open-Agent-DB 的发现层,以及 Codex 论文中 26.6% 的技能使用率,都在指向同一个方向。人们显然正在押注:真正持久的单元不是智能体外壳,而是可复用的工作流及其留下的产物。
[++] 用量预算编排与延迟感知路由 —— 信息流中出现了措辞含糊的 Pro 描述、可能存在的 $500 档位、浮现出的 ultrafast 模式、实时的额度耗尽页面,以及因为套餐限制感觉更少而公开迁移到 Opus 5.5 的案例。如果有产品能让限制变得可预测、按任务紧急程度和成本进行路由,并用通俗方式解释剩余空间,就能满足眼下的迫切需求;但这也是一个竞争激烈、已有许多成熟玩家的领域。
[+] 具备登录感知和治理能力的常驻智能体 —— Microsoft 的 Managed Runtime 和 Autopilot 框架,再加上 Godmode Bot 的加密浏览器登录凭据库,表明一个新的机会正在形成:让智能体在真实工具中持续工作,同时不把密钥处理变成提示词文本。这个信号仍处于早期阶段,但缺失的环节已经很明确:如何在不牺牲治理能力的前提下访问真实系统。
8. 要点
- 讨论正从智能体外壳转向可复用的操作原语。 并行 worktree、可移植技能、跨智能体发布流程,以及租户托管运行时,今天都获得了切实关注,这意味着用户越来越在意模型之外哪些东西能够持续存在,而不只是模型本身。(来源)
- 生成之后,审查已成为主要瓶颈。 最强烈的抱怨集中在 CI 成本、超大 PR 的理解难度,以及合并状态 UX 的模糊不清;而最有前景的构建者回应,则都聚焦于优先级排序、验证和状态可见性。(来源)
- Antigravity 仍在工作流层面引发兴趣,但在产品信任层面尚未站稳。 用户仍在尝试将 NotebookLM 与 Antigravity 组合使用,但声量更高的帖子集中在 Claude 选项陈旧,以及 plan mode 是否真的在解决正确的问题上。 (来源)
- OpenAI 眼下的挑战不只是模型质量,更在于使用逻辑是否清晰。 付费 Codex 用户不断提到表述含糊、新档位传闻,以及额度突然耗尽的情况;相比之下,竞品方案之所以获赞,只是因为用起来更清楚顺手。 (来源)
- 技能正同时成为产品层面的组成部分和研究对象。 社交平台上的帖子把技能视为可安装的工作流包,而当天的论文则认为,技能也是可衡量的采用单位,甚至还是训练更强 agent 模型的数据。 (来源)