Twitter AI 编程 - 2026-10-04
1. 大家在讨论什么
1.1 Harness 组合正从理论走向可直接复制粘贴的操作方案 (🡕)
最强的主题并不是新的模型基准,而是如何把各类 agent 界面实际接起来的具体说明。至少有五条内容印证了这一点:Argofowl 为 Claude Code 搭建的 Codex 浏览器桥接、HumanLayer 新发布的 Pi/OpenCode 插件、Dev Agrawal 对 Pi 和 OC++ 持久化能力的对比、Voxyz 用图示说明的 codex-cu 循环,以及 Duyet 那篇关于用 Herdr 让一个主会话派生出 50 个 worktree agent 的帖子。和 9 月下旬的信息流相比,这里的证据明显更偏向实操:有 repo 链接、hook 说明、恢复语义,以及已经跑起这套栈的用户截图。
@argofowl 展示了(180 次点赞,22 条回复,10,045 次浏览,286 次收藏)称,Claude Code 可以在后台驱动 Codex 的官方 Chrome 扩展及其底层的 computer-use MCP,支持按浏览器实例区分 ID,并通过一个 stop hook 轮换 turn ID,从而让标签页被干净释放。被引用的更早那条配置线程也提到,同一套本地 cua_repl 栈已经可以无头驱动 Codex computer use,但这条帖子补充了官方 Chrome 扩展、多浏览器安装,以及更明确的浏览器测试工作流。回复里给出了关键的实操细节:它可以复用已经登录的浏览器会话;还有一条回复说,真正的突破点在于避免反复弹出 allow 确认框。
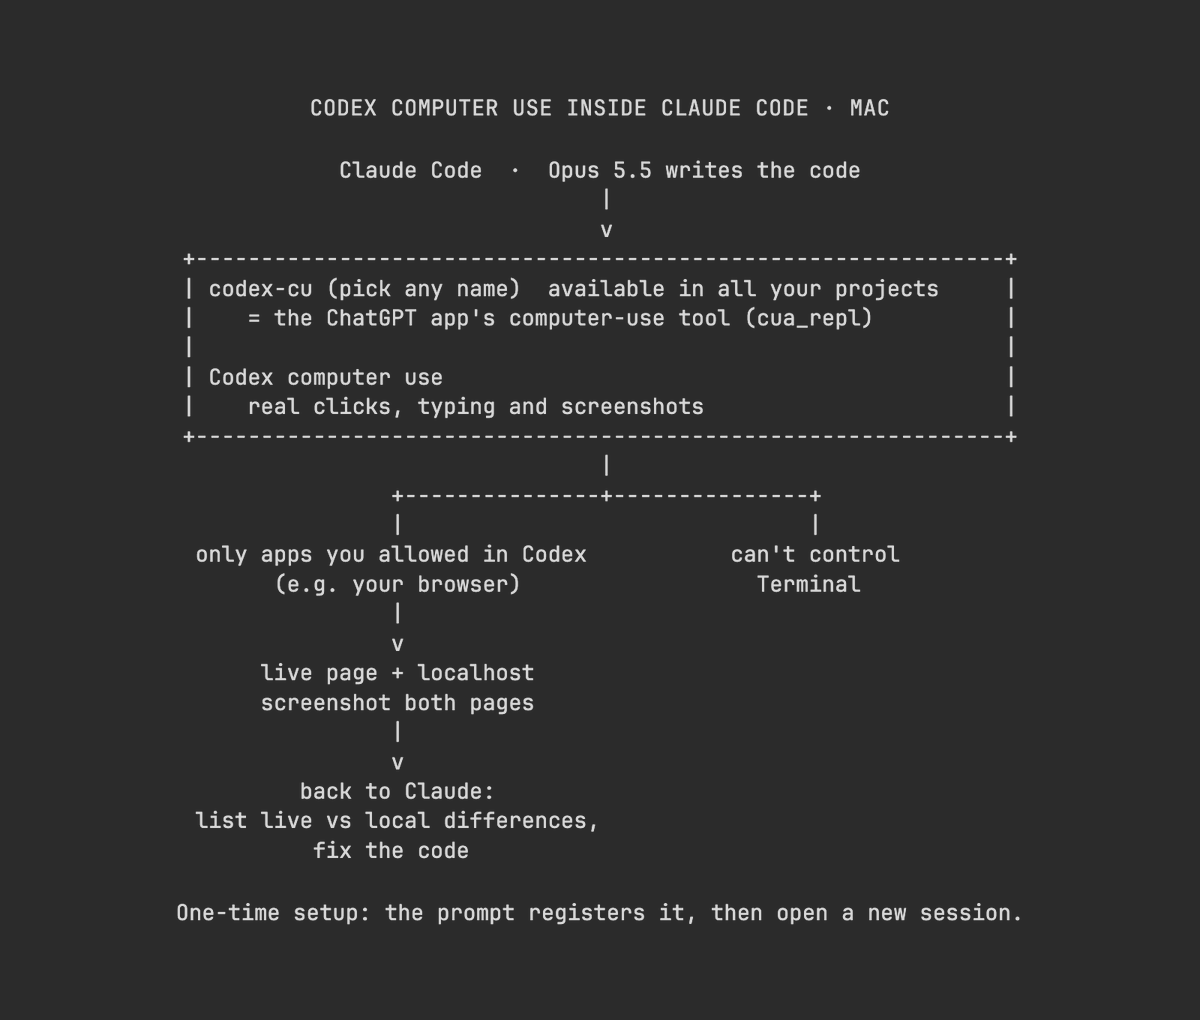
@Voxyz_ai 绘制了(13 次点赞,2 条回复,981 次浏览,19 次收藏)给出了一张紧凑的架构图,确认了同样的模式:Claude Code 负责编写代码,用户注册的 codex-cu MCP 桥接负责代理到 Codex computer use,只有已获批准的应用是可控目标,而 Terminal 被屏蔽。这一点很重要,因为它把一种临时拼凑的 hack 变成了别人也能照着复制、用于线上与本地浏览器测试的清晰工作流。
@dexhorthy 宣布(101 次点赞,10 条回复,7,055 次浏览,81 次收藏)称,HumanLayer 现在可以直接从 Pi agent 和 OpenCode 中使用。指向 Pi 和 OpenCode 的 repo 链接显示,相关插件已经发布:可将会话镜像到 HumanLayer Web 应用,同步任务文件和 diff,展示审批内容,并让远程回复或 stop 信号回流到正在运行的会话中。一条回复称,在这次发布之前,用户一直在手动复制 HumanLayer 的隐藏 skills;这是最明确的证据,说明这一功能正在填补一个真实存在的工作流缺口。
@devagrawal09 表示(53 次点赞,5 条回复,4,066 次浏览,22 次收藏)称,Pi Durable 改变了作者对 harness 设计的理解,甚至让他开始考虑围绕“持久化作为架构保证”来重写 OC++。真正有价值的信息在回复里,作者把机制讲得很具体:codemode 中的 durable 变量和函数、不会重复执行的已完成工具调用、能够恢复并重新挂接到父级的 subagent、可作为可恢复 subagent 的 Claude Code 和 Codex 等外部 agent,以及能在崩溃后继续保留的定时事件。这比简单说某个 harness“更可靠”具体得多。
@_duyet 介绍了(1 次点赞,2 条回复,46 次浏览)提到,把 Herdr 用作管理会话,可以在 Pi、Claude、Grok、OpenCode 和 Devin 之间派生出 50 个子 worktree。链接中的 Herdr 文章 称,这套配置把一个主会话与 herdr-desk、Telegram 汇报,以及精心设计的 Tailscale ACL 组结合起来,从而让跨机器编排既可见又相互隔离。

讨论洞察: 可组合性开始压过单纯的模型演示。大家共同的诉求不再是“给我一个最强的 agent”,而是“让我复用浏览器、让会话可恢复,并在不丢失审批或上下文的前提下协调多个 harness”。
与前一日对比: 与 9 月 28 日那份关于 worktree 和治理的报告相比,10 月 4 日把控制平面的讨论推进成了具体的桥接、插件和恢复语义。
1.2 配额政策与套餐经济性仍在决定哪些工具能继续开着用 (🡕)
至少有七条内容支撑了第二个主要主题:Jeremybtc 的超长订阅清单、Buildwithhassan 那个几乎没法用的到期重置、Kostastsale 高亮的 x20-to-x10 通知、Presidentlin 的额度结转重置截图、Quipsy 对 Google 套餐的对比、Rynorhn 对 Codex 幻象正在结束的抱怨,以及 TheBuoyantMan 取消 Copilot Pro+。关于能力的讨论不断坍缩成额度计算。@Jeremybtc 列出了(156 个赞、105 条回复、9,357 次浏览)提到自己在 ChatGPT Pro、Claude Max、Cursor Ultra、Google AI Ultra、GitHub Copilot、Vercel、Supabase、Railway 等服务上的付费开销,随后还开玩笑说,自己对 AI 的接触显然还是不够。重点不在于具体订了多少项服务,而在于重度用户早已默认:没有任何单一套餐能覆盖整个工作流。
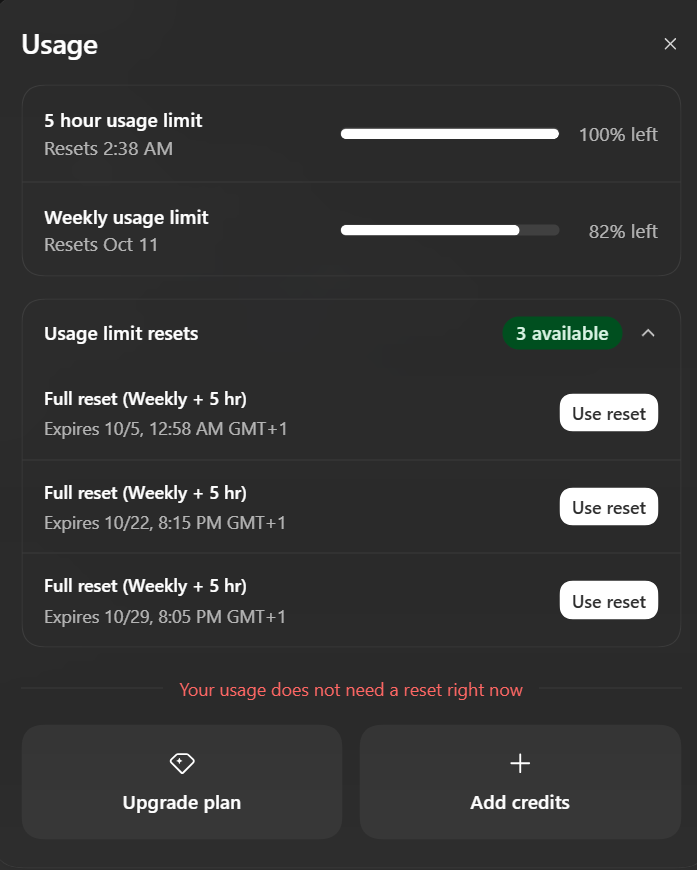
@buildwithhassan 报道称(15 个赞、7 条回复、1,833 次浏览)称自己丢掉了一次完整的 Codex 重置,因为在使用量接近上限前,UI 一直拒绝应用该重置。截图显示,5 小时额度还剩 100%,每周预算还剩 82%,有 3 次已储存的重置机会,同时提示“你当前的使用量暂时不需要重置”,而回复区则显示,其他用户为了赶在额度余量过期前用掉它们,只能刻意加速消耗,而不是正常工作。
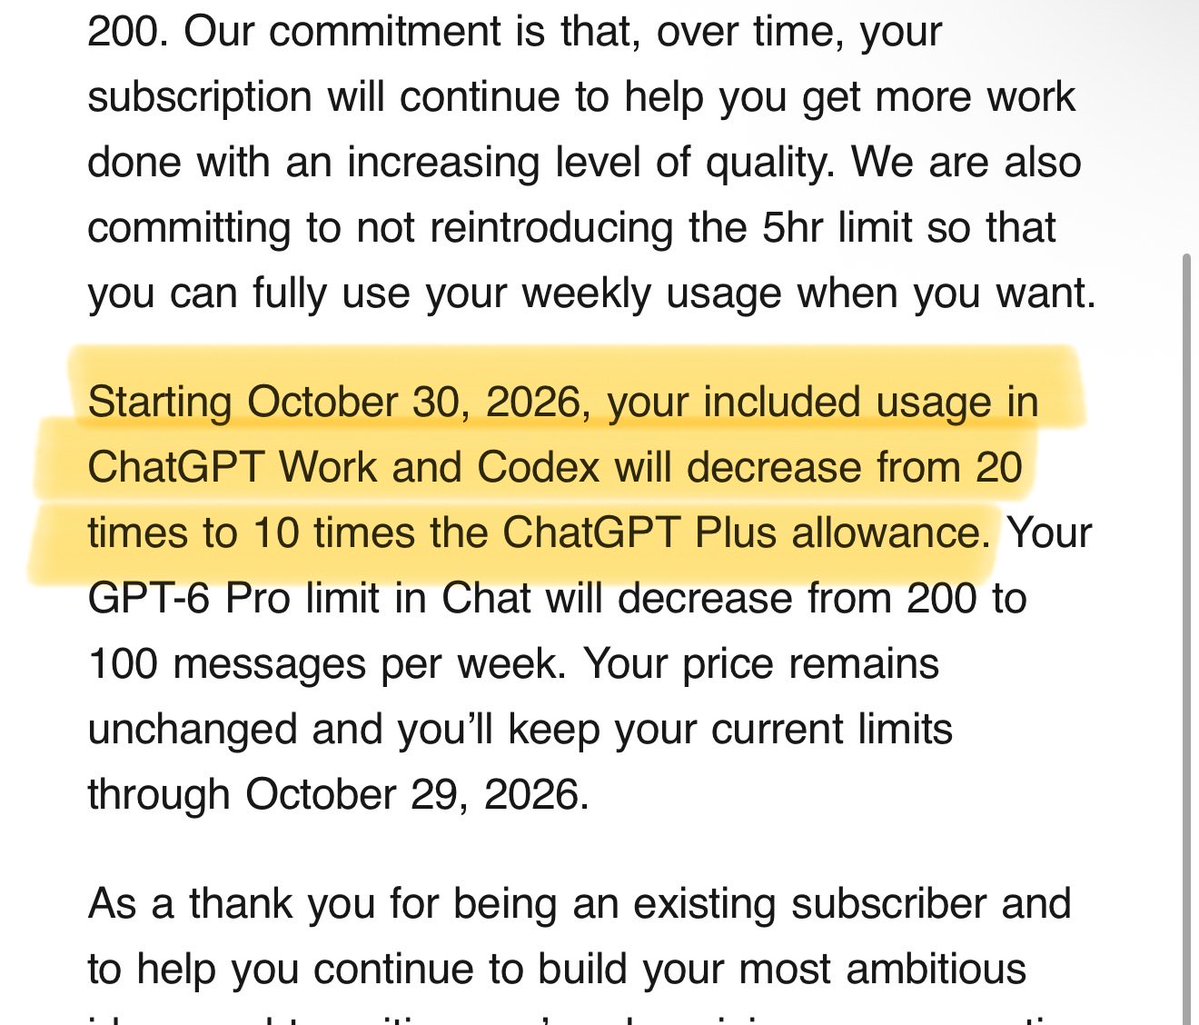
@Kostastsale 表示(6 个赞、2 条回复、577 次浏览)表示,x20 套餐下的 6.1 Sol 原本就消耗很快,随后又贴出截图,强调下一轮削减:从 10 月 30 日起,套餐内含的 ChatGPT Work 和 Codex 使用额度将从 Plus 的 20 倍降至 10 倍。之所以让抱怨更尖锐,是因为同一条推文还说,Dots 实际上会通过高推理模式的 6.1 Sol 来路由任务,因此这部分昂贵的额度池是共用的。
@Presidentlin 发布了(7 个赞、3 条回复、556 次浏览)晒出一张使用界面截图:5 小时限制已用 95%,每周限制已用 90%,剩余 2,479 credits,并存有 3 次完整重置机会,随后表示 Astra 对短时窗口的消耗过快,而 6.1 Sol 仍是更稳妥的默认选择。这比 9 月下旬早些时候“带来的是压力,不是忠诚”这一主题更为具体。

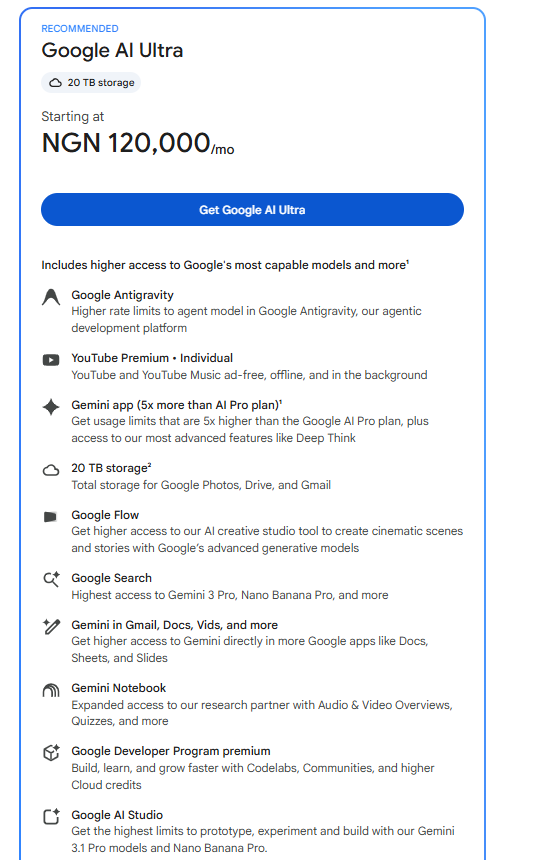
@quipsy 认为(68 次浏览)认为 Google AI Pro 可能是最划算的方案,因为它把 Antigravity、Gemini、Flow、NotebookLM、YouTube Premium 和 20 TB 存储打包在一起。配图通过展示 AI Ultra 卡片上每月 NGN 120,000 的价格,并逐行列出所含产品,让这组价格对比更清晰可读。
另一个规模较小但仍然明确的流失信号来自 @theBuoyantMan 称(3 个赞、2 条回复、1,078 次浏览、7 次收藏):他们表示自己已经取消了 GitHub Copilot Pro+,转而使用 DeepSeek Harness 和 OpenRouter,因为较新的模型更便宜、效果也更好;而 @rynorhn 将其描述为(31 个赞、5 条回复、1,118 次浏览)则将其称为同一种转变:OpenAI 已无法再掩盖其算力问题,而 Anthropic 正在激进出货。
讨论洞察: 这场实时讨论的焦点已不只是“哪个模型最聪明?”,而是“哪个额度能及时重置、哪个捆绑套餐包含合适的工具,以及哪个方案这周又悄悄变差了?”
与前一天相比: 相比 9 月 28 日报告中较为笼统的额度疲劳,10 月 4 日的讨论附上了时间戳、截图、即将过期的已储存重置次数,以及一项注明生效日期的额度削减。
1.3 记忆、技能和提示词预算纪律,已从可有可无的附加项变成标准基础设施(🡕)
另一组帖子所默认的前提是:默认 harness 遗忘太多,也泄漏太多。至少有六条内容支持这一看法:DanKornas 的 365 Skills、Fucai 的 claude-mem 教程、Yrevash 的 context-mode、Ap0cah0lics 的“轻 harness,重 skills”主题帖、Arkyyang 的 Mingbird 论文摘要,以及 Coldniko 的 Strata 发布。
@DanKornas 分享了(8 个赞、6 条回复、1,052 次浏览、11 次收藏)介绍了 365 Skills,这是一个面向 Claude Code、Cursor、Copilot 等工具的可复用能力公共 GitHub 集合。仓库 展示了两条路径:一条是与 agent 无关的 npx skills add 路径,另一条是 Claude Code 插件市场路径,这正是一周前人们一直在要求的那种可移植性。
@FucaiX62810 重点提到(6 个赞、4 条回复、543 次浏览)claude-mem,而 README 也用生命周期钩子、本地 worker、SQLite 加向量搜索,以及分阶段的 search -> timeline -> get_observations 检索流程,为这一主张提供了支撑,目的是让 memory 查询保持低成本。这不只是“加入 memory”,而是对压缩整理和会话失忆问题的一个具体回答。
@yrevash 提到了(4 个赞、183 次浏览、2 次收藏)context-mode,其声称沙箱化的工具路由可以在用 SQLite/FTS5 跟踪连续性的同时,把单个会话的原始上下文从 315 KB 缩减到 5.4 KB。这一论点也呼应了另一个讨论串中的回复:通用工具和退出码,胜过充满 schema 的定制工具泛滥。
@arkyyang 翻译了(1 个赞、2 条回复、33 次浏览)把新的 Mingbird 论文 提炼为三条产品规则:像对待稀缺内存一样做预填充预算;没有制品检查就不要相信“我做完了”;以及通过重复出现的工具调用签名而非文字表述来检测循环。即便不读论文,这条讨论串也让那些正在交付本地或小模型 agent 的人,能够把 harness 问题真正落到实处。
@coldniko 发布了(39 个赞、2 条回复、1,659 次浏览)Strata v0.1.39,而 发行说明 和 repo README 说明了它为何对 AI 编程用户重要:支持 OpenAI Responses API,让 Codex CLI 能与本地运行时通信;能够同时处理多个请求;并为原本需要数据中心级资源的模型提供了更多适配多 GPU 或老旧硬件的运行路径。
@Ap0cah0lics 认为(12 个赞、9 条回复、1,656 次浏览)指出,尽管现在已经内置了循环机制,“薄 harness,厚技能” 依然成立。讨论串里最精彩的一条回复直白地说明了设计上的理由:每增加一个专门定制的工具,就会扩大 schema 的表面积;而 bash 提供的是几乎无限的可组合原语和确定性的退出码。
讨论洞察: 无论解决方案是 memory、上下文压缩,还是本地运行时,背后的共同假设都是:如果 harness 让上下文臃肿或丢失状态,那么前沿模型的原始能力就会被白白浪费。
与前一天的对比: 相比 9 月 28 日报告中“可搜索、可审计的基础设施”这一主题,10 月 4 日更聚焦于检索、压缩整理和 prompt 预算机制。
1.4 人的角色正被重新定义为操作 agents、验证它们,并选择合适的自主等级(🡕)
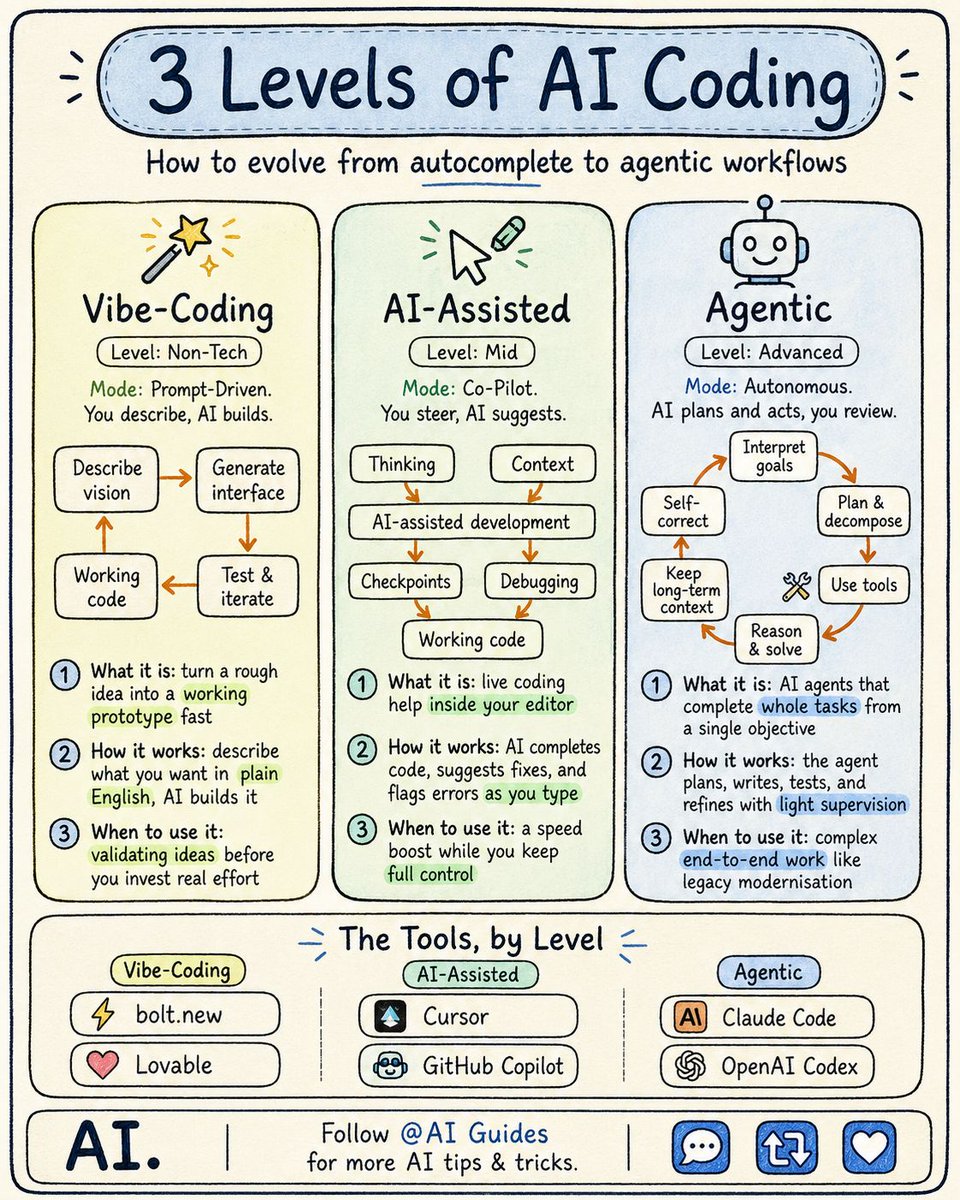
至少有六个条目支撑了最后这个主要主题。Free AI Guides 的“AI 编程的 3 个层级”图示,将 vibe-coding、AI-assisted 和 agentic 工作流区分开来。Teka1900 把 OpenAI Dots 变成了一套工作流方案,包括定时任务、Codex 交接和自定义审批规则。Michael Fenech 认为,Copilot review 应该置于一个独立的 reviewer 循环中。Craig Weiss 表示,“new IC” 管理着 20 个 agents。Anilkalm 认为,computer use 之所以重要,是因为许多业务工作流只能通过 GUI 完成;而 Neogoose 的截图则提醒所有人:UX 仍然落后于这种雄心。@free_ai_guides 认为(18 个赞、8 条回复、2,256 次浏览、28 次收藏)指出,真正的失败模式在于选错了自主级别,而不是选错了品牌。这张信息图将 vibe-coding 对应到 bolt.new 和 Lovable,将 AI 辅助工作对应到 Cursor 和 GitHub Copilot,将 agentic work 对应到 Claude Code 和 Codex,并进一步解释了:一旦把这些级别混用,遗留系统迁移和快速原型开发为什么会失败。
@Teka1900 写道(16 个赞、3 条回复、364 次浏览、10 次收藏)指出,Dots 只有在被当作一个始终在线的操作员时才有意义:定时任务、监看 GitHub issue、Codex 交接,以及从“无需询问直接执行”到“交给我处理”的四种批准模式。相比“和代理聊聊天然后碰运气”,这是一套更成熟的交互逻辑。
@Michael_Fenech_ 推荐了(12 个赞、9 条回复、2,039 次浏览)展示了 Builder -> Reviewer -> Fix -> Reviewer -> Merge 这条流程,使用了 GitHub Copilot 新近可调用的 review API,并为 reviewer 配置了专属技能和 MCP 上下文。这篇帖子之所以重要,是因为它明确将创建与验证分离,而不是让同一个代理给自己打分。
@anilkalm 认为(2 个赞、2 条回复、82 次浏览)指出,Copilot 新增的 computer-use 能力扩大了自动化可触达的范围,因为许多业务工具至今仍只提供屏幕、表单和按钮。从这个角度看,GUI 控制不是噱头;当不存在 API、CLI 或 MCP 时,它就是后备方案。
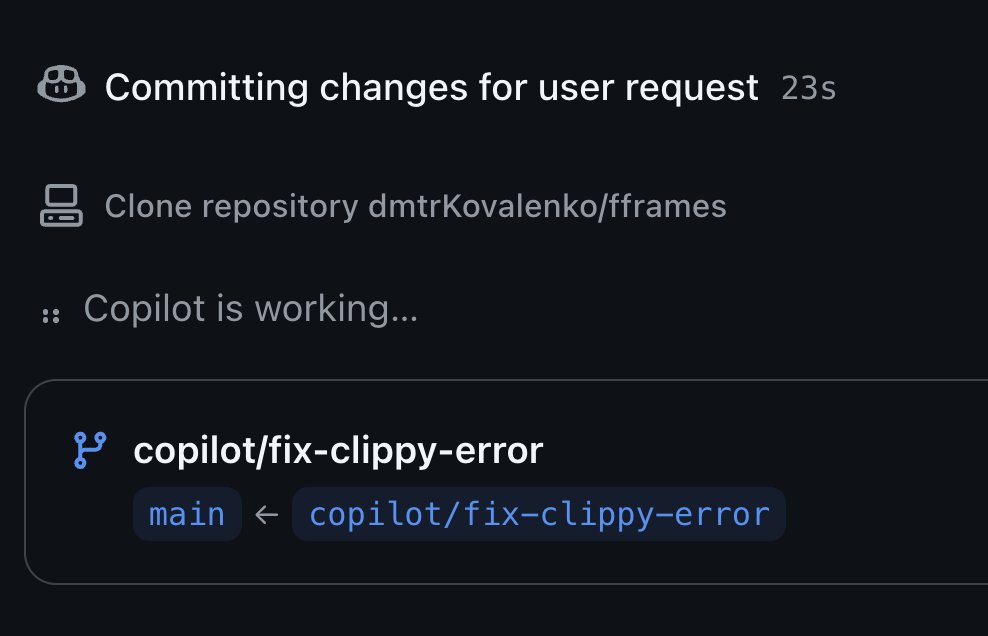
@neogoose_btw 展示了(18 个赞、4 条回复、1,840 次浏览)点出了当前 UX 的上限:Copilot 解决了问题,但最终让人记住的,却是 “Copilot is working...” 旁边四个没对齐的点。即便底层输出是可以接受的,这类打磨上的缺口也会让人犹豫。
@craigweiss 表示(34 个赞、10 条回复、879 次浏览)称,这个“new IC”管理着 20 个代理,只有在必要时才会亲自下场写代码。回复区则提供了有价值的纠偏,因为它们表明,有些工程师根本不想管理任何东西,代理也一样。
讨论洞察: 人们只有在能够对任务分类、将验证单独分流,并让干预点保持清晰可见时,才会接受更高的自主性。
与前一天的对比: 相比 9 月 28 日报告里“代理能被信任吗?”那条讨论线,10 月 4 日已经把“信任”具体落实为操作规则、reviewer 角色,以及可见的 UX 粗糙边角。
2. 什么让人感到挫败
重置机制正把使用体验变成一场盯表游戏
用户不只是额度不够用;他们还在花时间研究怎么“玩转”额度系统。@buildwithhassan 表示(15 个赞、7 条回复、1,833 次浏览)称,一次完整的 Codex 重置白白过期了,因为产品在每周用量仅消耗 82% 时不允许应用它,尽管那次重置会在当晚失效。@Presidentlin 展示了(7 个赞、3 条回复、556 次浏览)则从另一个角度描述了同样的环境:可累积的重置、Astra 很快就能耗尽的 5 小时时限,以及围绕额度规则来安排模型探索时间的习惯。@Kostastsale 补充说(6 个赞、2 条回复、577 次浏览)即将从 x20 下调到 x10,而 @Jeremybtc 转向(156 次点赞、105 条回复、9,357 次浏览)则把“订阅对冲”过成了一种生活方式。人们的应对方式包括囤积重置额度、把工作拆分到不同套餐,或转向更便宜的组合,例如 DeepSeek Harness 和 OpenRouter。严重性:高。值得构建:高。
默认运行框架仍然不是忘得太多,就是夹带太多垃圾
第二个挫败点是状态管理。@devagrawal09 明确称之为(53 次点赞、5 条回复、4,066 次浏览、22 次收藏)指出,大多数运行框架都很脆弱,这也是 Pi Durable 和 OC++ 强调可恢复子代理、持久变量以及无需重跑的工具调用的原因。@FucaiX62810 指出(6 次点赞、4 条回复、543 次浏览)提到 claude-mem,@yrevash 指出(4 次点赞、183 次浏览、2 次收藏)提到 context-mode,而 @arkyyang 总结道(1 次点赞、2 条回复、33 次浏览)提到 Mingbird,因为同一种失效模式反复出现:会话会忘记昨天的修正,提示词被工具脚手架塞满,而小模型尤其需要提示词预算、完成闸门和循环检测器。@Ap0cah0lics 提出(12 次点赞、9 条回复、1,656 次浏览)则点出了这些症状背后的架构层面抱怨:每一种定制工具 schema 都会污染注意力,因此人们只能退回到通用技能和类 bash 原语来应对。严重性:高。值得构建:高。
验证和界面打磨仍然落后于生成能力
人们越来越接受代理能快速生成代码,但他们依然苦于如何证明输出是安全的,以及围绕这一过程的交互界面依旧笨拙。@Michael_Fenech_ 提出了(12 次点赞、9 条回复、2,039 次浏览)提出了一个“构建者 -> 审查者 -> 修复 -> 审查者 -> 合并”的循环,因为如今人们已经不再信任让同一个代理给自己的工作打分。@neogoose_btw 展示了(18 次点赞、4 条回复、1,840 次浏览)指出,即便一次成功的 Copilot 运行,也可能让用户把注意力放在令人困惑的进度指示器上,而不是结果本身。@argofowl 获得了关注(180 次点赞、22 条回复、10,045 次浏览、286 次收藏)部分原因在于,这种设置去掉了重复的授权提示;而 @anilkalm 认为(2 次点赞、2 条回复、82 次浏览)则表明,仅限 GUI 的工作流如今也已进入自动化范围。一旦代理开始接触那些只有按钮和表单的软件,审查循环和更清晰的人工介入点就会变得更加重要。严重性:中高。值得构建:高。
3. 人们希望看到什么
面向多个运行框架的统一协调层
人们想要的是一个控制平面,能把 Claude Code、Codex、Pi、OpenCode、Grok 和其他 shell 纳入同一工作流,同时不丢失审批、diff 或状态。@dexhorthy 发布了(101 次点赞、10 条回复、7,055 次浏览、81 次收藏)提到为 Pi 和 OpenCode 提供 HumanLayer 支持,@_duyet 展示了(1 次点赞、2 条回复、46 次浏览)提到跨 50 个会话的 Herdr 管理器模式,@argofowl 连接了(180 个赞,22 条回复,10,045 次浏览,286 次收藏)将 Codex 的浏览器控制接入 Claude Code,而 @devagrawal09 认为(53 个赞,5 条回复,4,066 次浏览,22 次收藏)则指出,耐久性必须是架构层面的能力。这是一个有立竿见影工作流价值的现实需求,而不是投机性的设想。机会:直接。
足够精简、因此值得信赖的记忆与上下文层
@FucaiX62810 强调了(6 个赞,4 条回复,543 次浏览)提到 claude-mem,@yrevash 强调了(4 个赞,183 次浏览,2 次收藏)提到 context-mode,@arkyyang 翻译了(1 个赞,2 条回复,33 次浏览)提到 Mingbird 的 prompt-budget 和 finish-gate 思路,以及 @Ap0cah0lics 为……辩护(12 个赞,9 条回复,1,656 次浏览)提到更轻的 harness 和更强的 skills。综合来看,这些帖子描述的是同一个缺失层:代理需要记住修正意见,只检索相关的历史内容,并停止用原始工具输出灌满上下文窗口。目前已有几个项目部分解决了这个问题,但大量同期出现的帖子表明,这一需求依然紧迫。机会:直接,但竞争激烈。
面向代理所写代码的独立审查与审批系统
@Michael_Fenech_ 详细说明了(12 个赞,9 条回复,2,039 次浏览)提出了一个 Builder -> Reviewer -> Fix -> Reviewer -> Merge 循环,而 @craigweiss 表示(34 个赞,10 条回复,879 次浏览)则表示,新的 IC 已经在管理 20 个代理,而不是亲自编写每一行代码。这意味着,缺失的产品并不是另一个构建型代理;而是一个能够质疑构建者、重新运行检查,并判断何时已有足够证据可以合并的审查与控制系统。@neogoose_btw 补充说(18 个赞,4 条回复,1,840 次浏览)则从 UX 角度说明,薄弱的进度反馈至今仍在削弱信心。机会:直接。
在开工前就让余量变得可预测的计划
@buildwithhassan 失去(15 个赞,7 条回复,1,833 次浏览)提到一种会过期的重置机制,@Kostastsale 警告(6 个赞,2 条回复,577 次浏览)提到 x20 到 x10 的配额削减,@Presidentlin 追踪(7 个赞,3 条回复,556 次浏览)提到可累积的重置和消耗速率,以及 @quipsy 购物(68 次浏览)所反映出的套餐经济性问题,都指向同一种需求:清晰可见的到期规则、可靠的套餐可持续时长预测,以及更便于横向比较的套餐方案。有些产品已经提供了用量页面和套餐页面,但公开证据仍显示,用户依旧会感到意外、需要手动计时,并因此退订。机会:方向明确,但竞争激烈。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
通过 codex-cu 使用 Codex computer use |
计算机操作 / 浏览器自动化 | (+/-) | 真实点击、截图、可从 Claude Code 复用,且很适合对比在线浏览器与本地浏览器 | 非官方桥接、仅支持获准应用、Terminal 被屏蔽,而且 ChatGPT 的一次更新就可能让它失效(来源) |
| HumanLayer Pi / OpenCode 插件 | 协作 / 会话镜像 | (+) | 可将会话镜像到 Web 应用,支持远程回复与停止、审批、任务 diff,以及打包技能 | 需要配置插件,而且在 Pi 或 OpenCode 中还依赖特定宿主支持(来源) |
| Pi Durable / OC++ | 代理框架 | (+) | 持久变量、可恢复的子代理,以及即使崩溃后也能继续的定时事件 | 就连支持者也认为,市场上其他方案脆弱到足以证明重写的必要性 |
| GitHub Copilot 审查 API 和 computer use | 审查 / GUI 自动化 | (+/-) | 支持独立的审查循环,并打通那些没有 API 或 MCP 服务器的纯 GUI 工作流 | UI 打磨仍较粗糙,信任问题仍需通过外部机制分层解决(来源) |
| 带有 Antigravity 的 Google AI Pro/Ultra | 订阅套餐 | (+/-) | 一个方案内包含多个前沿模型,以及 Flow、NotebookLM、YouTube Premium 和大容量存储 | 区域定价不一,用户仍期待更严格或更高的额度限制(来源) |
| claude-mem | 记忆层 | (+) | 跨会话持久上下文、分层检索、可搜索记忆,以及高 token 效率的查找流程 | 需要额外安装,并引入 worker service 的复杂性,还依赖 hooks 和 sidecar 存储(来源) |
| 上下文模式 | 上下文路由 sidecar | (+) | 将原始工具输出隔离在沙箱中、用 SQLite 保持连续性,并声称可大幅节省上下文 | 需要额外的路由层,也要求用户改变自己对工具执行方式的理解(来源) |
| Strata | 本地模型运行时 | (+) | 提供本地 OpenAI 兼容端点、支持 Codex Responses API、可同时服务多个请求,隐私卖点也很强 | 对 RAM、VRAM、磁盘和硬件调优的要求依然很高(来源) |
| 365 Skills | 技能包 / 插件集合 | (+) | 与代理无关的安装路径、广泛可复用的能力集合,以及对 Claude Code 市场的支持 | 又增加了一层发现、选择和维护负担(来源) |
| Herdr | 编排控制平面 | (+) | 主从 worktree 管理、跨仓库协同、多机仪表盘,以及定时自动化 | 安全隔离依赖精心设计的 Tailscale ACL,而公开证据目前仍仅限于一位构建者的文章(来源) |
总体满意度并不是按“最佳模型”和“最差模型”来划分的,而是按哪些工具“便于调度”、哪些工具“仍然让人措手不及”来划分。HumanLayer、Herdr、Pi Durable、claude-mem 和 context-mode 之所以受到关注,是因为它们减少了围绕模型的协作摩擦或上下文丢失;而 Strata 之所以受到关注,则是因为它为用户提供了本地后端,同时仍然使用现有编码工具已经理解的那些 API。
主要的变通办法是显式路由和角色分离。人们会在 Claude Code 中使用 Codex 的浏览器,计划在盯着额度表的同时把 Dots 路由到 6.1 Sol,在经济性不再划算后取消 Copilot Pro+、改用 DeepSeek Harness 和 OpenRouter,还提出一旦单个代理已经不再足够可信、无法自我评估,就改用构建者—审查者分离的循环。竞争态势看起来并不像某个模型彻底胜出,而更像是界面、额度、记忆层和编排能力正在成为真正的护城河。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| HumanLayer Pi / OpenCode plugins | HumanLayer,经由 @dexhorthy | 将 Pi 和 OpenCode 会话镜像到 HumanLayer,支持远程回复、审批和任务 diff | 团队希望在不放弃自己偏好框架的前提下获得协作与远程控制能力 | Pi、OpenCode 2、HumanLayer Web 应用、git、共享会话 SDK | 已发布 | pi 仓库,opencode 仓库, 文章 |
| 365 Skills | Agents365-ai via @DanKornas | 打包可复用的 agent 技能和 Claude Code 插件,覆盖编码、研究、图表、笔记和媒体任务 | 开发者总在反复从零搭建同样的能力 | npx 技能安装器、Claude Code 插件市场、agent 无关的插件集 |
已发布 | 仓库, 文章 |
| Strata v0.1.39 | Niko1221 via @coldniko | 在游戏 PC 上运行高性能本地编程模型,并提供兼容 OpenAI 的端点,包括支持 Codex Responses API | 用户既想要本地推理和隐私,又不想放弃现有的 agent 工具链 | Qwen3.8-Flash-Next、本地 OpenAI 兼容服务器、MCP 服务器、多 GPU 支持 | 已发布 | 仓库, 发布, 文章 |
| Herdr plus herdr-desk | @_duyet | 使用一个主 agent,在多个 agent shell 和机器上生成并监督大量 worktree 会话 | 多仓库、多 agent 的工作需要一个可视化的协调者和自动化层 | Herdr、worktrees、Pi、Claude、Grok、OpenCode、Devin、Tailscale、Telegram 报告 | 已发布 | 博客, 网站, 文章 |
| Xeza | @salimteymouri | 将原始的 Solana 代币和交易活动转化为易读的风险、行为和失效分析 | 用户需要链上情报,而无需阅读原始 RPC 响应 | Next.js 16、React 19、TypeScript、Helius、Jupiter、DexScreener、CoinMarketCap、Netlify | 已发布 | 应用, 仓库, 文章 |
@dexhorthy 制作了(101 个赞、10 条回复、7,055 次浏览、81 次收藏)是今天最清晰的“自带 harness”案例。Pi 和 OpenCode 插件并不要求用户切换 shell;它们是在 HumanLayer 的 Web 应用里,用镜像事件、审批、任务差异和远程回复来封装现有会话。这与第 1 节的大趋势一致:开发者越来越想要的是围绕 agent 的协调层,而不是一个全新的 agent 身份。
@coldniko 已发布(39 个赞、2 条回复、1,659 次浏览)则代表了另一层、但同样务实的方向:本地基础设施。Strata 的仓库称,它可以在游戏 PC 上运行 Qwen3.8-Flash-Next,而 v0.1.39 的发布说明还新增了对 OpenAI Responses API 的支持,因此 Codex CLI 可以直接与其通信。这让该项目值得关注的地方,不只是它是又一个本地模型实验,更在于它为人们已经在使用的工具提供了一层兼容层。@_duyet 展示了(1 个赞,2 条回复,46 次浏览)这可能是最极端的编排模式:一个 manager 会话在多种 agent 产品和多台机器上,监管多达 50 个子 worktree。再结合 365 Skills,这表明一种反复出现的构建模式:一层安装可复用能力,另一层决定由哪个 harness 来执行,更高一层则监控整个集群。
@salimteymouri 提供了(8 个赞,6 条回复,103 次浏览)这是对元工具化浪潮最清晰的反例。Xeza 是面向用户的产品,不是控制平面:它是一款可读性强的 Solana 智能应用,具有确定性评分、可解释证据,以及一套具体而现代的 Web 技术栈。该仓库的 README 称,它是通过 Codex 辅助的 AI vibe coding 构建的;因此,这也成为一个有力证据,说明当范围收紧、规则明确时,AI 编程受众依然看重真正的产品。
6. 新动态与值得关注的内容
HumanLayer 让 Pi 和 OpenCode 成为一等公民级的远程会话
@dexhorthy 宣布了(101 个赞,10 条回复,7,055 次浏览,81 次收藏)HumanLayer 已支持 Pi agent 和 OpenCode,关联仓库还展示了审批、远程回复、任务 diff,以及镜像会话事件。这一点值得关注,因为它把“自带 harness”当作产品原则,而不是一种不受支持的 hack。
Strata 让兼容 Codex 的本地推理实用得多
@coldniko 发布了(39 个赞,2 条回复,1,659 次浏览)这是 Strata v0.1.39,而 发布说明 增加了对 Codex 的 OpenAI Responses API 支持、并发处理多个请求的能力,以及更多硬件路径。这很重要,因为它降低了那些想使用本地推理、又不愿放弃现有 agent 客户端的人的切换成本。
Mingbird 让 harness 工程更像一门研究学科,而不只是黑客技巧
@arkyyang 浮现(1 个赞,2 条回复,33 次浏览)这是 Mingbird 论文,它将小模型 agent 的失败归结为 harness 问题,并把修复转化为明确机制,例如 prefill budgeting、finish gates 和 loop detection。这一点值得关注,因为它为构建者提供了词汇和可测试的规则,去处理一个信息流里通常只靠轶事描述的问题。
Copilot review API 强化了拆分验证 agent 的理由
@Michael_Fenech_ 使用了(12 个赞,9 条回复,2,039 次浏览)GitHub Copilot 可调用的 review 接口,被用来论证 Builder -> Reviewer -> Fix -> Reviewer -> Merge 这一流程。这个信号很重要,因为它表明方向正在偏离“一个超级 agent”,转向专门的构建者与验证者角色。
7. 机会在哪里
** +++] 具备持久性、审批与远程观测能力的跨 harness 控制平面** — 证据来自 Argofowl 的 Codex 浏览器桥接([来源)、HumanLayer 的 Pi 和 OpenCode 插件(来源)、Dev Agrawal 对持久性的推进(来源),以及 Duyet 的 Herdr 栈(来源)。这里的机会很大,因为人们已经在使用多个 agent shell;他们仍然缺少的,是一个值得信赖的统一层来让它们保持协调一致。
** +++] 具备配额感知的路由与重置管理** —— Jeremybtc 的 51 服务栈([来源)、Buildwithhassan 那次无法使用的重置(来源)、Kostastsale 的 x20-to-x10 通知(来源),Presidentlin 的 reset-banking 习惯(来源),以及 TheBuoyantMan 取消 Copilot(来源),都说明工具选择的驱动因素依然更多是额度机制,而非意识形态。一个能够预测消耗、按剩余额度分配工作,并避免浪费重置次数的产品,将能立刻满足现实需求。
**++] 在不丢失连续性的前提下减少提示词浪费的记忆与上下文 sidecar** —— claude-mem([来源)、context-mode(来源)、Mingbird(来源)、365 Skills(来源),以及“轻编排层,重技能”这条讨论(来源),都指向同一个缺口。这个机会属中等,因为已有多种解决方案存在,但需求显然真实存在,而且覆盖多平台。
**++] 独立审查代理与信任层** —— Michael Fenech 的 reviewer loop([来源)、Craig Weiss 提出的“20 个 agent”框架(来源)、Neogoose 对 Copilot UI 的抱怨(来源),以及 Anilkalm 关于 GUI 自动化的论点(来源),都表明:正在成为瓶颈的是信任,而不是原始生成能力。一个分别核查产出物、diff 和 UI 状态的审查栈,可以嵌入许多现有工作流。
**+] 更多由 AI 编码构建的终端用户产品,而非更多元工具** —— Xeza 已发布的 Solana 分析应用([来源)提醒我们,只要范围足够聚焦、证据规则足够明确,信息流依然会奖励真正的产品。这个信号不如控制平面那股浪潮强,但它说明,那些把 AI 编码用于解决具体用户问题的团队,而不是再做一层 wrapper 套 wrapper,仍有发展空间。
8. 要点
- 编排层组合正逐渐成为一个独立的产品类别。 信号最强的帖子都与此有关:把 Codex computer use 接入 Claude Code、为 Pi 和 OpenCode 加入 HumanLayer,以及通过 Herdr 管理大规模 worktree 集群。(来源)
- 额度机制依然决定了人们究竟信任哪些工具,信任到愿意一直开着用。 用户发得更多的是即将到期的重置、囤积重置的策略,以及带日期的额度削减,而不是基准测试截图。(来源)
- 记忆与上下文卫生如今已被视为核心基础设施,而不是可有可无的修饰。 claude-mem、context-mode、Mingbird,以及“轻编排层,重技能”这条讨论,都在针对同一种失效模式:被遗忘的状态太多,浪费的 prompt 预算也太多。(来源) 4.验证正从生成环节中剥离,成为一项独立职能。 今天最强调信任的一则帖子主张采用专门的 Builder -> Reviewer -> Fix -> Reviewer -> Merge 流程,而不是让同一个智能体自审。(来源)
- 信息流中最清晰、已落地的产品,是一款范围收窄、规则确定的应用,而不是又一个通用型 meta-agent。 Xeza 的 Solana 分析工作流之所以格外突出,是因为它的 repo 说明了证据规则、技术栈和局限,而不是把这些藏在空泛的 agent 话术背后。(来源)