Twitter AI 编程 - 2026-10-09
1. 大家在讨论什么
1.1 围绕 Argon 访问权限的线索,反而盖过了发布本身(🡕)
Google 依然占据了 AI 编程讨论中最大的声量,但在 2026-10-09,讨论重心并不是某个新的公开工作流,而是“上线考古”:积分、模型选择器标签、上下文窗口提示,以及定价留下的零碎线索。至少有四条高信号推文都指向同一点:用户从 Antigravity 周边界面获得的信息,比从一次正式发布中得到的还多。
@EvanOtero 提醒(1,611 次点赞、94 条回复、110,453 次浏览、1,976 次收藏)称,Google AI Pro 和 Ultra 订阅者可兑换每月 Gemini API 积分,用于代码、Antigravity CLI 和第三方 harness。最关键的信息不在正文,而在回复里:有用户称这一兑换路径“太复杂了”,Evan 则回应说,大约两周后这一流程应会迁移到 AI Studio,而且只需要兑换一次。
@LuminaBench 认为(289 次点赞、21 条回复、18,499 次浏览)称,Gemini 4 Argon 已经出现在 Antigravity 客户端代码中,而附带的构建差异卡片补充了推文本身没有的具体细节:专门的 effort 控制、512K 和 900K 上下文选项,以及大约 $4 输入、$20 输出的云计费提示,同时仍明确表示发布和 API 访问尚未确认。
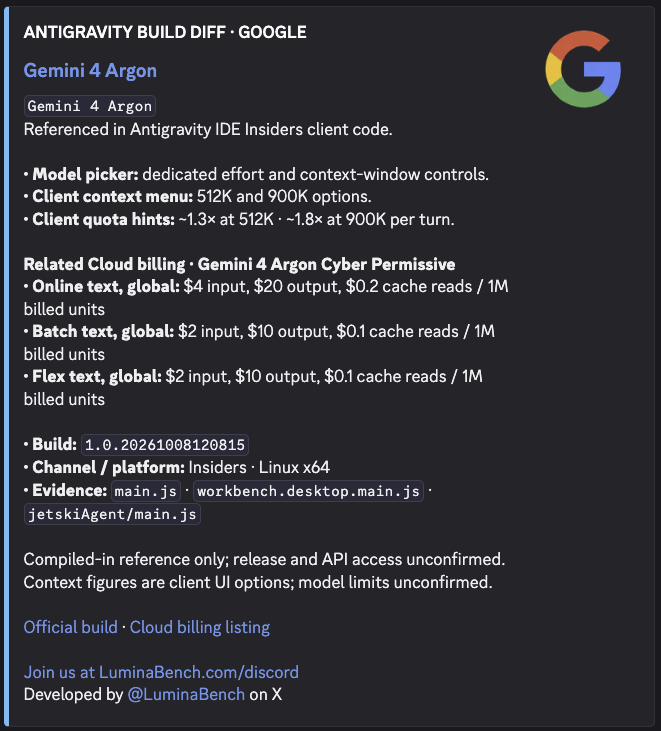
@StatsWire 报道称(236 次点赞、11 条回复、11,991 次浏览)称,Gemini 3.1 Pro 在 Antigravity 内被标记为“即将下线”,而 Gemini 4 Argon 似乎仍被 Fairwind 锁住。这一点之所以重要,是因为它把上线受阻带来的挫败感,转化成了产品状态问题:旧选项看起来更接近被移除,而那个被广泛讨论的替代者却还没有大范围可用。

讨论洞察: 用户主要争论的并不是 Argon 会不会好用,而是它究竟何时才会对自己开放、哪些订阅和计费账户会起作用,以及旧模型阵容是否被撤得太早。
与前一天相比: 在 2026-10-08,围绕 Antigravity 的讨论就已经在强调上线摩擦。到了 2026-10-09,这种摩擦变得更加具体,因为人们现在已经有菜单标签、定价提示和积分兑换流程这些明确线索可供讨论。
1.2 更快的代理循环,评判标准是任务成本、可操控性和一致性,而不是 token 价格(🡕)
OpenAI 一侧最强的讨论点并不是“Ultrafast 出现了”,而是“完整循环成本是多少、在 Codex 里实际体验如何、通过不同访问路径会发生什么”。这让讨论比前一天围绕速度档位的标题更偏向操作层面。
@OpenAIDevs 宣布(728 次点赞、66 条回复、23,135 次浏览、101 次收藏)称,Codex 为 Pro 用户提供了 composer predictions。回复线程立刻把这项功能重新定义为工作流细节层面的竞争,而不是新奇性竞争:有用户表示 Claude Code 更早就提供过类似行为,也有回复追问,重新读取对话以预测下一条消息,是否会带来他们在别处见过的那种 token 额外开销。
@morganlinton 分享了(40 次点赞、11 条回复、2,960 次浏览)贴出了一张 VulcanBench Frontier v4 图表,显示 Claude Sonnet 5.5 在最高 effort 下取得了最佳综合分数,Opus 5.5 得分也很强,但在高 effort 下会变得昂贵,而 GPT-6.1 Sol 则在图中展示的设置里实现了最低的单任务成本。这张图把“快”从一个单纯拼面子的数字,变成了成本与质量之间的权衡。

@Vladic_ETH 认为(28 次点赞、17 条回复、1,683 次浏览、9 次收藏)指出,“token 价格不等于任务价格”,并给出了一个具体例子:Sonnet 5.5 在 max 档位下每个任务成本为 $7.67,而 Opus 5.5 在 xhigh 档位下,同样分数只需 $3.46。还有一条回复进一步点明了这个问题:一个看起来更便宜、却需要多次重试的模型,最终成本可能高于一个一次就能完成任务的更大模型。
@Youssofal_ 测试了(13 次点赞、5 条回复、1,813 次浏览)比较了 Codex 中通过 ChatGPT 套餐使用 GPT-6.1 Sol 与通过 API key 访问的差异,附带表格显示,在 normal 和 fast 模式下,API 路径的 TPS 更快,而 Ultrafast 模式下两者更接近。这条推文最鲜明的抱怨不只是速度,而是使用限额依然是更大的现实问题。

讨论洞察: 人们越来越倾向于用完成任务的经济性和操控质量来衡量编码代理的价值。一个更快的档位,如果会反复重跑、卡住,或者烧掉每周配额,并不会被看作更好的产品。与前一日对比: 2026-10-08 的速度档位讨论主要集中在上线推进和定价准入。到了 2026-10-09,用户和基准测试发布者拿出了更完整的证据,涉及单项任务成本、路由差异以及交互设计。
1.3 开放生态的构建者持续在模型外围交付控制层,而不只是再做一个模型选择器(🡕)
开源构建者的故事线仍是最清晰、也最反复出现的主题之一。证据最充分的内容并不是某家大型实验室发布了新的前沿模型,而是那些位于模型外围的发布:决策层、harness 路由器、注重隐私的部署方案,以及移动端配套应用。
@NaceAI 开源了(81 次点赞,24 条回复,54,198 次浏览,58 次收藏)将 Drex 1.5 描述为一款小型决策模型,具备 128K 上下文窗口,并兼容 Ollama、Unsloth、OpenCode、Claude、Codex、Cursor 及其他 agent 界面。公开的开发者页面进一步补充了背景:Console 将 Drex 与 NDI 文档智能结合,可通过 API、CLI 和 MCP 路径运行,也可部署在 Nace 的云、客户自己的云,或物理隔离环境中。

@Aria_Nawi 解释了(37 次点赞,14 条回复,21,443 次浏览,57 次收藏)解释了这在实践中的意义:更长的上下文让决策模型能够一次读完整份文档、较长的 agent 历史记录,甚至整个代码库;而现有的 Jev 风格集成只需修改 base URL 就能切换,无须重写整套栈。
@CrazyShyyt 强调了(12 次点赞,2 条回复,678 次浏览,12 次收藏)将 HarnessRouter 称为“agent harness 的 OpenRouter”;公开仓库页面则将其描述为一个可自托管的 Community Edition,可在 Codex、Claude Code、Hermes 及其他 harness 之上提供兼容 OpenAI Responses 的 API,并支持会话、流式输出、文件、取消操作以及一条命令完成 Docker 部署。
@thdxr 发起了(43 次点赞,18 条回复,3,301 次浏览)提到 OpenCode iOS 应用新增了更多 TestFlight 名额。这是一个有价值的构建者信号,因为回复很快就从庆祝转向了对缺失功能的反馈,例如 effort-level 控制和 iPad 支持。
@near_ai 将其定义为(14 次点赞,1 条回复,570 次浏览)将 OpenCode 描述为私有推理的外壳;其配套博客则称,OpenCode 只有在使用 /share 时,才会把会话同步到自己的服务器,而 NEAR AI Cloud 提供带有 confidential TEE 标注的模型,用于对隐私敏感的工作。@kaddisdeployed 补充说(7 次点赞,5 条回复,191 次浏览)则提到,Step 5 Preview 曾短暂通过 OpenCode 提供,宣称具备 1M 上下文、多模态和零数据保留。
讨论洞察: 当前最强的开源产品工作,重点已不再是宣称自己拥有最聪明的模型,而是把路由、隐私、可移植性和专门化决策能力的控制权交到用户手中。
与前一日对比: 在 2026-10-08,封装层和注册表看起来就已相当重要。到了 2026-10-09,这一判断的证据更扎实了,因为更多讨论开始指向在线仓库、公开文档、测试版应用以及可部署的工作流。
2. 什么让人感到挫败
Gemini 编程界面的发布状态含糊不清
严重程度:高。@EvanOtero 发布了(1,611 次点赞,94 条回复,110,453 次浏览,1,976 次收藏)原本是在讨论 credits,但回复区最终变成了对兑换流程复杂,以及必须先满足 billing account 前置条件的抱怨。@LuminaBench 显示(289 个赞,21 条回复,18,499 次浏览)称,与 Argon 相关的控制项和定价线索早已出现在内部代码中;而 @StatsWire 显示(236 个赞,11 条回复,11,991 次浏览)则显示,较旧的 Gemini 选项被标记为“即将下线”。用户现在不是通过正式发布界面了解进展,而是靠盯着模型选择器、构建差异和员工回复来应对。值得构建:高。
在具体任务层面,Agent 经济性仍然难以预测
严重程度:高。@Vladic_ETH 认为(28 个赞,17 条回复,1,683 次浏览,9 次收藏)指出,token 价格不等于任务价格;@morganlinton 对此予以佐证(40 个赞,11 条回复,2,960 次浏览)则附上了一张基准测试图表,显示 GPT-6.1 Sol 的单任务成本最低,而 Claude 模型在一些质量指标上仍然领先。@Youssofal_ 显示(13 个赞,5 条回复,1,813 次浏览)指出,在 Codex 中,套餐访问与 API 密钥访问会显著改变吞吐量,并表示每周使用量仍是更大的问题。人们的应对方式包括手动比较不同路径、切换 shell,并在正式投入花费前,把免费或开源选项当作试验场。值得构建:高。
即便代码生成更快了,审查、计费和审计工作也没有消失
严重程度:高。@Paul_Bracht 报道称(16 个赞,5 条回复,2,018 次浏览)表示,一家拥有 580 名员工的组织中的一位 VP 觉得,在大范围推出 Copilot 后,他们已经“完全失去了”审计可见性的整体把握;他的帖子还说,更多 AI 产出变成了更多 PR、更重的审查负担,以及更多上下文切换。GitHub 自己的 更新日志 也从产品侧证实了同样的压力:在 @GHchangelog 宣布(14 个赞,3 条回复,2,303 次浏览)提出这些需求后,GitHub 为 Copilot 代码审查新增了组织级计费和审查请求控制。在 Copilot 应用的反馈帖中,@pierceboggan 询问(18 个赞,38 条回复,4,546 次浏览)询问哪些方面应该改进,回复很快就提出了 Azure DevOps 支持、更好的仓库组织、更完善的计费,以及内部自有模型。值得构建:高。
移动端和本地执行界面仍显得不完整
严重程度:中。@thdxr 发起了(43 个赞,18 条回复,3,301 次浏览)为 OpenCode iOS 增加了更多 TestFlight 名额,但最先跟进的问题是缺少 effort 控制项和 iPad 支持。@windowsdev 宣布(27 个赞,3,523 次浏览)提到在 Windows 上将 HydraFusion 路由到本地模型,但公开文章也明确表示,这仍是一个即将推出的预览界面,而不是已经完全定型的默认方案。值得构建:中高。
3. 人们希望出现什么
面向 Agent 产品的实时权益与可用性仪表板
人们希望有一个统一入口,说明哪些已经上线、哪些即将下线、哪些额度适用,以及在会话开始前需要满足什么账户状态。@EvanOtero、@LuminaBench、以及 @StatsWire 共同表明,用户是通过推文、回复串和泄露的 UI 状态,自己一点点拼凑出这个答案,而不是直接从产品本身得到。机会:直接。
按单个任务成本进行路由,而不是沉迷于 token 标价
最强烈、也最务实的诉求,是希望路由机制理解“完成的工作”,而不是只看标价。@Vladic_ETH、@morganlinton 和 @Youssofal_ 都提供了证据,表明模型选择会随着重试次数、路由方式、上限和 effort level 而变化。机会:直接。
与 AI 生成内容规模相匹配的审核与策略层
随着 AI 输出量上升,团队希望获得更好的审核分配、更强的可审计性、更完善的授权,以及更清晰的预算归属。@Paul_Bracht、@pierceboggan,以及 GitHub 新推出的 代码审查控制,都指向同一种需求。机会:直接。
跨手机、桌面和本地硬件的私有、可迁移 agent 会话
OpenCode iOS、NEAR AI Cloud 私有推理,以及 HydraFusion 的本地/云路由,都指向一个更具体但确实存在的需求:用户希望同一套 agent 工作流能在不同设备和信任边界之间随身流转。如今这些组件已经存在,但看起来仍像彼此分离的 beta、集成或预览,而不是一个连贯统一的体验。机会:竞争性。
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Gemini 4 Argon / Antigravity | Agent IDE / 模型入口 | (+/-) | 注意力能力强,effort/context 控制可见,Pro 积分可用 | 发布时间、适用资格和旧模型下线仍不明确 |
| Codex composer predictions + GPT-6.1 Sol | Agent IDE / 模型层级 | (+/-) | 下一提示的体验更好,在部分基准中单任务结果成本更低,提供多种速度模式 | 仅限 Pro beta,性能依赖路由,存在使用上限和 token 开销问题 |
| Claude Sonnet 5.5 / Opus 5.5 | 前沿编程模型 | (+) | 基准成绩强,尤其在更高 effort 下表现突出 | 在某些设置下,单任务成本可能会变得昂贵 |
| GitHub Copilot HydraFusion | 本地/云编排 | (+) | 自动路由、明确的本地模型选择、sandbox 方案说明详细 | 仍在逐步进入预览;产品界面和策略问题尚存 |
| Copilot 代码审查控制项 | 治理 / 审核 | (+/-) | 组织计费和许可证规则更符合企业使用现实 | 需要管理员设置,并为组织计费配置付费使用 |
| Drex 1.5 | 决策模型 | (+) | 开源、128K 上下文、参数少于 10B、兼容范围广的 harness | 目前证据仍主要集中在发布帖和早期采用者 |
| OpenCode | 开源编程 agent | (+) | 提供移动端 beta、provider 切换方便、可临时试用免费模型 | 移动端控制尚不完整;隐私取决于 provider 和部署方式 |
| HarnessRouter | Agent 后端基础设施 | (+) | 用一个 API 对接多种 harness,可自托管,支持 sessions/files/streaming/cancellation | 又增加了一层需要安装和运维 |
| Prismor | 运行时控制平面 / 安全 | (+) | 可观测扩展、网络调用、故障和策略 hooks | 这组数据中的证据仍偏向构建者视角,缺乏广泛用户验证 |
满意度差异最大的是控制层工具,最小的则是大型商业发布界面。面对不确定性,用户会通过在订阅方案与 API 访问之间切换、把 OpenCode 当作可迁移外壳来临时试验模型,或将敏感任务转向私有推理配置来应对。
迁移模式同样值得注意:人们越来越少说“我永久从供应商 A 切换到了供应商 B”,更多是在说“我想要一个 shell 或 router,让我之后还能更换模型、部署模式或计费路径”。竞争压力正越来越多地落在可观测性、路由和信任边界上,而不只是模型品牌本身。
5. 人们在构建什么
| 项目 | 构建者 | 作用 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Drex 1.5 + Console | @NaceAI | 开放决策模型加文档智能 API,用于路由、分类和有依据的提取 | 让团队可以在更大的编程或文档工作流前加上一层更小的决策层 | Drex 1.5, NDI, API, CLI, MCP, Ollama, Unsloth | 已发布 | 推文, 开发者, GitHub |
| OpenCode iOS app | @thdxr | OpenCode 编程 agent 的移动端 beta 伴侣应用 | 将 agent 访问扩展到手机,而不是把编程会话局限在桌面端 | OpenCode, iOS, TestFlight | Beta | 推文, OpenCode |
| HarnessRouter Community Edition | HarnessRouter | 面向多种 agent harness 的自托管统一 API | 避免为 Codex、Claude Code、Hermes 等分别构建产品集成 | Python, Docker, UHP, OpenAI Responses-compatible API | 已发布 | 推文, GitHub |
| Prismor | PrismorSec | 面向扩展、工具活动、网络调用和 agent 会话策略的运行时控制平面 | 让团队对自主 agent 行为拥有更高可见性和控制力 | Python, CLI, dashboard, hooks | Beta | 推文, GitHub |
| OpenCode + NEAR AI private inference | @near_ai | 将 OpenCode 路由到 confidential 或带 TEE 标记模型的 provider 集成 | 在保持同一 shell 的同时,为代码敏感型工作提供一条保护隐私的路径 | OpenCode, NEAR AI Cloud, confidential TEE models | 已发布 | 推文, 博客 |
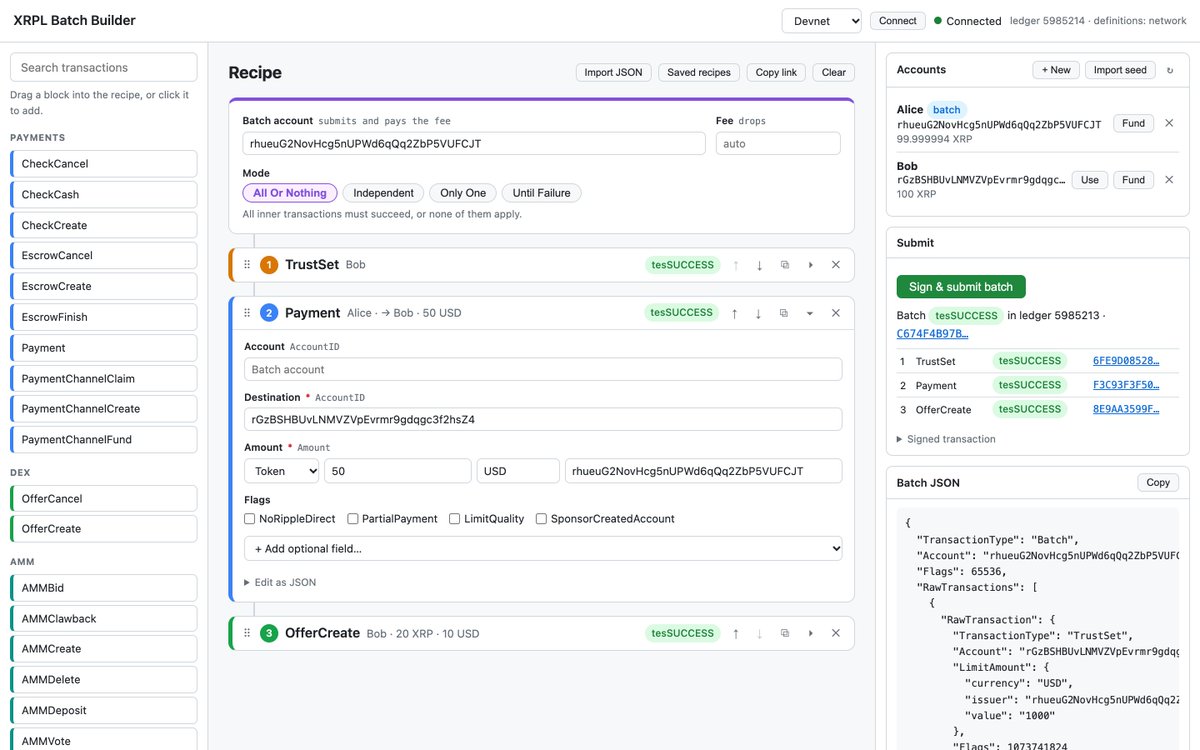
| XRPL Batch Builder | @msvadari | 用于组合和提交原子 XRPL 交易批次的拖放式 UI | 降低手动组装多步骤批量交易的复杂性 | Browser UI,XRPL 节点定义 | Alpha | 推文, 演示 |
Drex 1.5 是最重要的构建者信号,因为它把“决策模型”变成了一个独立的产品层。此次发布的公开材料强调了它与现有代码代理环境的兼容性,并主张让路由、分类和提取尽量贴近数据完成,而不是把每一次决策都发送给更大的前沿模型。
HarnessRouter、Prismor 和 NEAR AI Cloud 都符合第二种反复出现的模式:构建者正在为现有智能体套上一层互操作性、策略或隐私基础设施,而不是直接取而代之。这强烈表明,下一层产品往往长在智能体周边,而不是基础模型内部。
更轻量的构建案例同样重要。OpenCode iOS 把代码代理界面带到了手机上,而 XRPL Batch Builder 则展示了一个具体的“vibe-coding”产出:一个聚焦交易的狭窄型 UI 被快速交付,而构建者也明确提醒它尚未达到生产级。
6. 新的重点动态
Windows 上的 Copilot 本地模型有了实现细节,而不再只是品牌包装
@windowsdev 已宣布(27 个赞,3,523 次浏览)HydraFusion 将路由指向设备本地运行的模型,而微软公开文章补充了实质性细节:GitHub Copilot 将提供跨本地与云端推理的 Auto 编排、明确的本地模型选择路径,以及缩减到 53GB 的本地 MAI Code 1.1 Flash 版本——相较文中提到的云端变体减少了 80%——其在 SWE-Bench Verified 上达到 70.8%,并在 Windows 上采用 MXC 支持的沙箱机制。(文章)
Copilot 代码审查更接近纳入企业预算的基础设施
GitHub 的 更新日志 增加了两项对真实团队很重要的管理员级功能:组织可以将符合条件的审查计费到组织,而不是计入成员配额;同时还可以限制来自外部授权用户的审查请求。这一点值得关注,因为它承认代码审查如今已经是一个需要预算和治理的工作流,而不只是一个可选的助手功能。
开源智能体访问在同一天同时扩展到手机和机密硬件
@thdxr 的 OpenCode iOS beta 扩展,与 @near_ai 的私密推理设置指南形成呼应,展示了同一套外壳的两个相邻扩展方向:一个走向移动端访问,另一个走向机密部署。这样的组合让可移植性与隐私看起来像是正在推进的产品前沿,而不再只是边缘需求。
7. 机会在哪里
[+++] 具备权限感知能力的智能体控制平面 — 当下最明显的痛点并不是缺少模型,而是在发布推进、额度、即将下线标签、计费前提条件和审查配额之间缺乏清晰状态。Gemini Argon 访问相关讨论以及 GitHub 自身的计费控制调整都体现了这一点。
[++] 任务级成本与路由可观测性 — 用户越来越多地在不同 effort level、订阅方案与 API 访问方式,以及重试行为之间比较完整任务的经济性。基准图表和上手测试都表明,token 定价与感知成本之间存在真实鸿沟。
[++] 面向 AI 高密度团队的审查负载与策略工具 — 更多生成代码会把工作转移到审查、授权和审计环节。无论是一线抱怨,还是围绕 Copilot 代码审查策略的产品变动,都能看出这种需求。
[+] 私密且可移植的智能体伴侣 — OpenCode iOS 与运行在 TEE 上的 OpenCode 相关迹象表明,围绕同一套智能体工作流,跨手机、笔记本、本地模型和机密云环境运行的市场可能正在形成。
8. 要点
- 在 2026-10-09,Google 的 AI 编码相关讨论仍然主要被发布推进机制主导,而不是一次公开的 Argon 发布。 最有力的证据来自额度发放流程、内部代码截图和“即将下线”标签,而不是一个已经发布的工作流。(来源) 2.对速度的宣传,正越来越被放到任务层面的经济性中衡量。 发帖者比较模型时,不再只看原始的每 token 价格,而是看完成任务的成本、重试表现和访问路径。 (来源)
- 围绕 Copilot 的讨论进一步转向了政策和部署层面。 无论是本地/云端编排的细节,还是代码审查的计费控制,都被视为有实际意义的产品变化。 (来源)
- 最突出的开源构建模式是“在模型外围加一层控制层”。 Drex、HarnessRouter、Prismor,以及支持私密推理的 OpenCode 配置,都符合这一模式。 (来源)
- 可移植性和隐私,正成为编码代理工作流中被默认期待的扩展能力。 移动端 beta 访问和机密推理在同一天作为产品能力出现,而不再是遥远路线图上的设想。 (来源)