Twitter AI 编程 - 2026-10-11
1. 大家在讨论什么
1.1 信任被移到了代理之外(上升)
Twitter 上关于 AI 编程的讨论反复回到同一个现实问题:怎样才能让代理接触真实代码,又不把整台机器的权限都交给它?最有力的证据并不来自抽象的安全讨论,而是那些已经发布或接近发布的控制层:沙箱执行、企业托管的默认模型、手动启动 MCP,以及可追溯的会话日志。
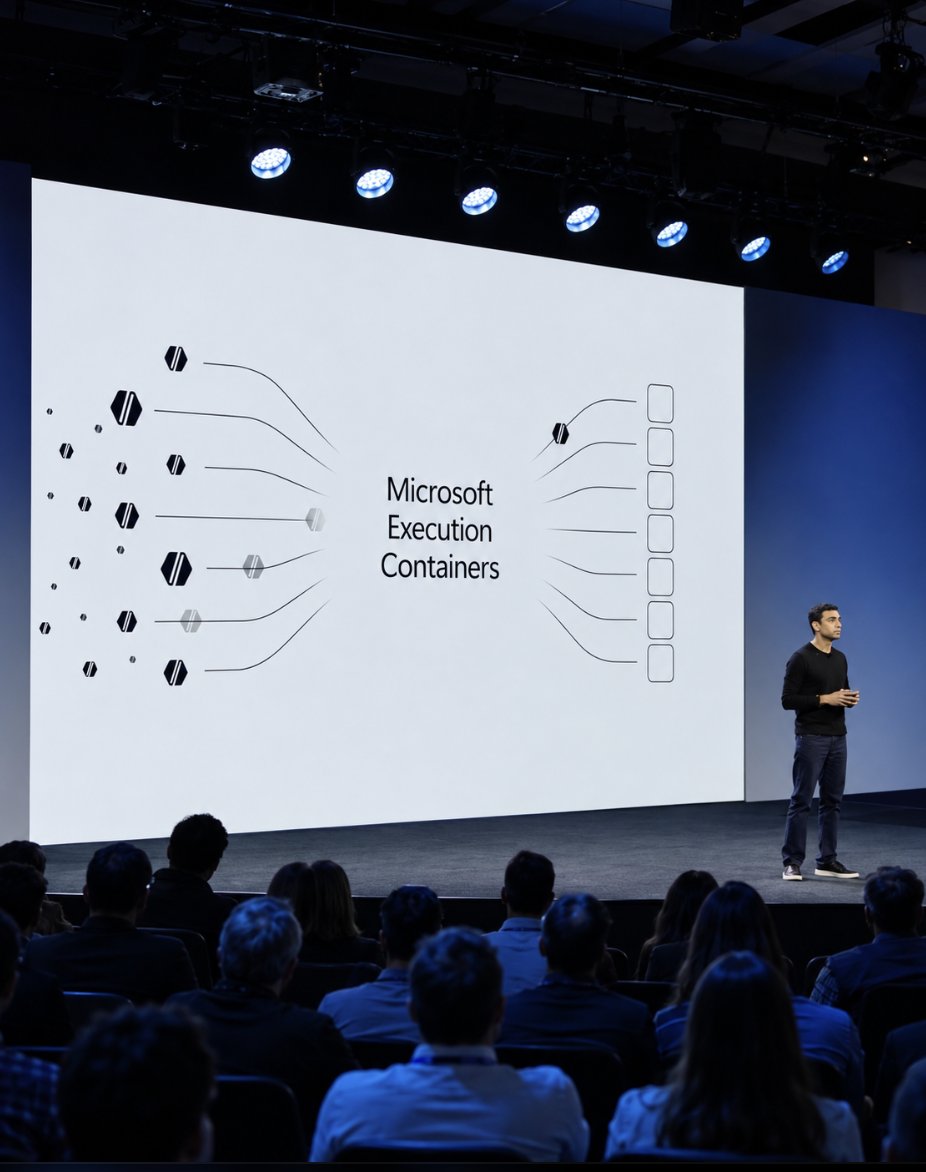
@twtayaan 报道称(245 个赞,41 条回复,17,106 次浏览,159 次收藏)表示,Microsoft Execution Containers,也就是 MXC,为代理提供了文件、网络和系统资源的边界,而且这些边界是在代理控制范围之外强制执行的;它还采用了一套可在 Windows、Linux 和 macOS 间共享的 JSON 策略模型。公开的 microsoft/mxc 仓库也印证了这条推文的说法:MXC 是一层跨平台的沙箱式代码执行层,在 Linux 上可使用 Bubblewrap 等后端,并且已集成到 GitHub Copilot、Codex、Replit 和 OpenClaw 中,后续还计划支持 Claude Code。
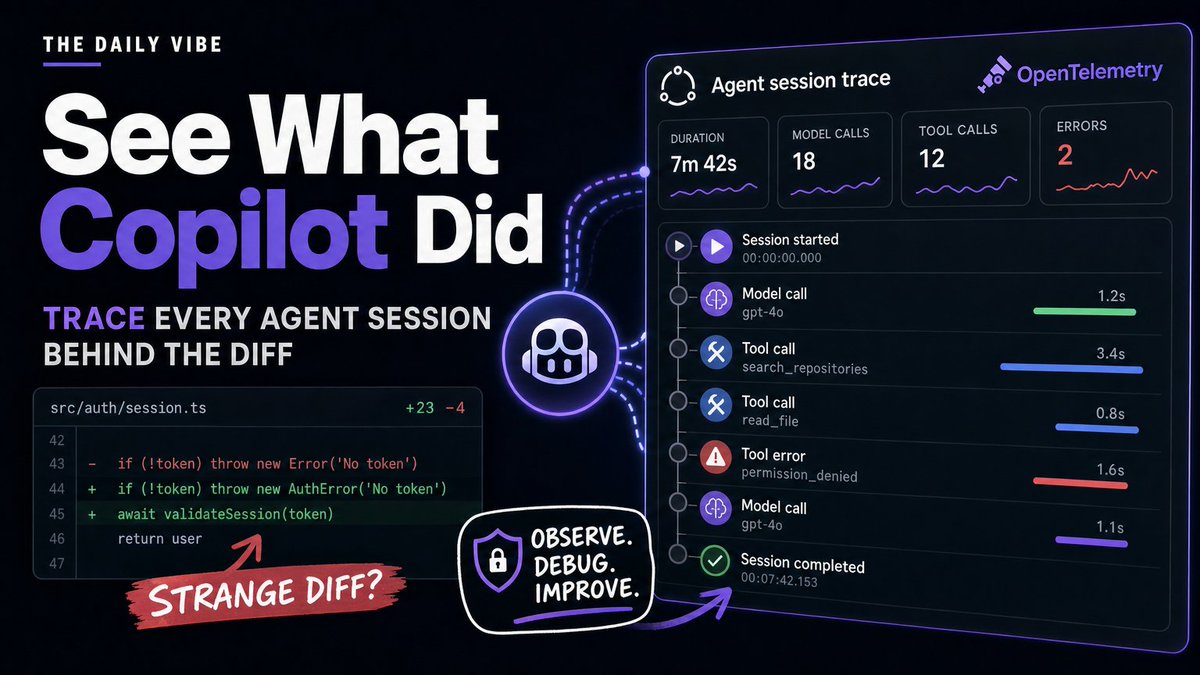
@GHchangelog 宣布(12 个赞,1,295 次浏览)表示,JetBrains 版 Copilot 现在提供企业托管的默认模型、快速修复诊断,以及对 MCP 服务器启动的手动控制。@TheDailyViber 认为(2 条回复,45 次浏览)表示,Copilot 应用的 OpenTelemetry 能为团队提供模型调用、工具调用、慢速 span 和错误的追踪;当代理留下可疑的 diff 时,这让“它到底做了什么?”从只能靠猜,变成了可供检查的对象。
讨论洞察: 这套信任逻辑并不是单向度的。@spencerclarkdev 警告称(8 条回复,463 次浏览)表示,如果配置不当,Qwen Code、Codex 和 Claude Code 默认输出的 OTel 可能会暴露提示词、文件读取记录、记忆内容,或与邮箱关联的指标。因此,当天关于信任的主题其实是“更多控制”,而不是“默认收集更多数据”。
1.2 运行框架与上下文工程成了竞争层(上升)
许多帖子不再只争论哪个前沿模型最好,而是把运行框架的行为、工具加载方式和提示词结构视为真正的性能杠杆。一个共同观点是:同一个模型,外层 shell 如何注入时间、工具和上下文,会决定它看起来是聪明、迟缓,还是浪费。
@teortaxesTex 认为(42 个赞,15 条回复,3,804 次浏览,25 次收藏)表示,Claude Code 与 Codex 的差异越来越多地体现在运行框架兼容性上,而不是工具数量。附带的基准表援引了 @maksym_andr,显示 GPT-6 Astra 对请求工作时长的遵循度远高于 Fable 5.1,而且即使更换运行框架后仍然更强;回复则指出,原因更可能在于时钟重新注入和指令加载,而非前沿模型本身的质量。

@ScarletKc 收集了(3 个赞,512 次浏览)从更密集的跨厂商角度阐述了同一个观点:Anthropic 的工具搜索文档称,55K token 的多服务器配置可削减 85% 以上;OpenAI 将工具搜索描述为一种保留缓存的延迟加载;Cursor 表示动态上下文发现将 MCP 工具 token 降低了 46.9%;GitHub 则表示,将 Copilot 默认工具集从 40 个缩减到 13 个后,基准测试成功率提高了 2 到 5 个点。@OrenMe 显示(3 个赞,55 次浏览,1 次收藏)则把同样的优化放到了提示词层面:VS Code 的实验性 chat.copilot.stabilityOrderedPrompt.enabled 设置把稳定指令前移、把会话特定内容后置,在他的两次会话测试中,缓存读取量从 14.5K 提升到 23K,报告的 credits 则从 5.9 降到 1.6。
 @ajutqs 测得(3 条回复,65 次浏览)一则来自真实任务日志的相关运行时现象:在
gpt-6.1-sol 上运行的 Codex,在关闭 Fast 模式时,输出速度从 10 月 8 日的每秒 19 个 token 提升到 10 月 11 日的每秒 36 个 token;而 Fast 模式对研究、编程和写作任务的帮助,大于那些大多只是在等待页面加载的浏览器任务。
讨论洞察: 回复中一直在区分“模型质量”和“harness 质量”。有人在回复 teortaxes 时表示,同一个模型只要换个 shell,就会从表现敏锐变得无所适从;还有人说,精简指令后,同一个模型一夜之间就变得更快也更便宜。
1.3 限额、路由不透明与任务连续性影响了采用(上升)
当天围绕产品的争论,与其说是“谁的模型最聪明?”,不如说是“我到底能持续使用什么而不被打断?” 隐藏路由的传言、套餐缩减、5 小时限制,以及失效的线程交接,比基准测试截图更直接地左右了工具选择。
@0xtoberry 指出(115 个赞,27 条回复,7,656 次浏览)一则尚未证实的 Antigravity 路由传言:Gemini 3.8 Flash 对部分用户似乎会被路由到 Argon,而 Gemini 3.1 Pro 在 Antigravity 中似乎会被路由到 3.8 Flash。发帖者明确表示这尚未得到证实,但它之所以引发广泛讨论,恰恰说明用户仍在根据暴露出来的模型 ID 推测发布状态,而不是从厂商那里得到清晰解释。
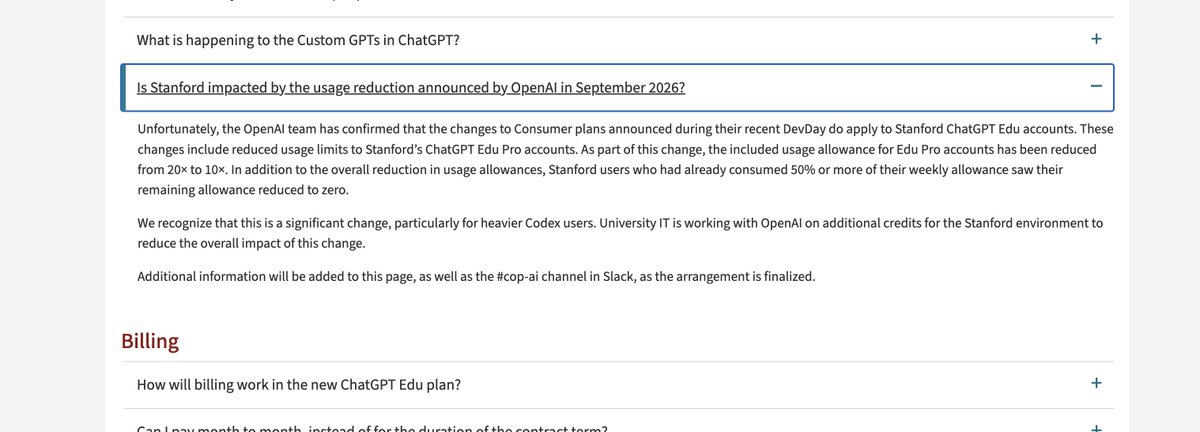
@SamPassey3 表示(36 个赞,2 条回复,2,447 次浏览,6 次收藏)称,Stanford 的 ChatGPT Edu Pro 用户在合约期中途,原本承诺的 20x Codex + Chat 使用额度被下调为 10x,而附带截图补充了最棘手的细节:如果用户已经用掉每周额度的 50% 或更多,剩余额度可能会被直接降为零。@Ananth7e 认为(80 个赞,26 条回复,3,907 次浏览)称,未来如果 OpenAI 的某个新模型胜出,今天的配额决定会让用户更难受;其附带投票显示,用户略微更偏好“没有 5 小时限制,使用量不变”(38.7%),而不是“有 5 小时限制,每周使用量 2X”(32.4%)。
@jessepollak 报道称(28 个赞,6 条回复,7,115 次浏览)称,电脑端 Dots 与 Codex 的任务连通性双向都已失效,而所链接的 GitHub issue 记录了 Dots 在尝试读取用户创建的 Codex 线程时出现的 placement-version 和 placement-region 错误。有条回复把这种故障称为“不可用”,认为它不适合长期运行的项目工作;而 @JustLingonberry 询问(29 个赞,23 条回复,826 次浏览)则在问,是否还有其他人在切换到 Opus 5.5 后,基本已经不再使用 Codex。
讨论洞察: 限额和连续性以不同方式打断了工作流,但实际结果是一样的:只要某个平台打断正在进行中的工作的频率高于竞争对手,用户就愿意立刻更换工具。
1.4 构建者仍在为智能体叠加新的执行层(上升)
最强的构建者热情并不在新基础模型上,而是在围绕智能体做封装。人们发布了用于逆向工程、演示呈现、多智能体控制、移动端插件、基于 webhook 的研究委派,以及 PR 审查自动化的各类执行层。
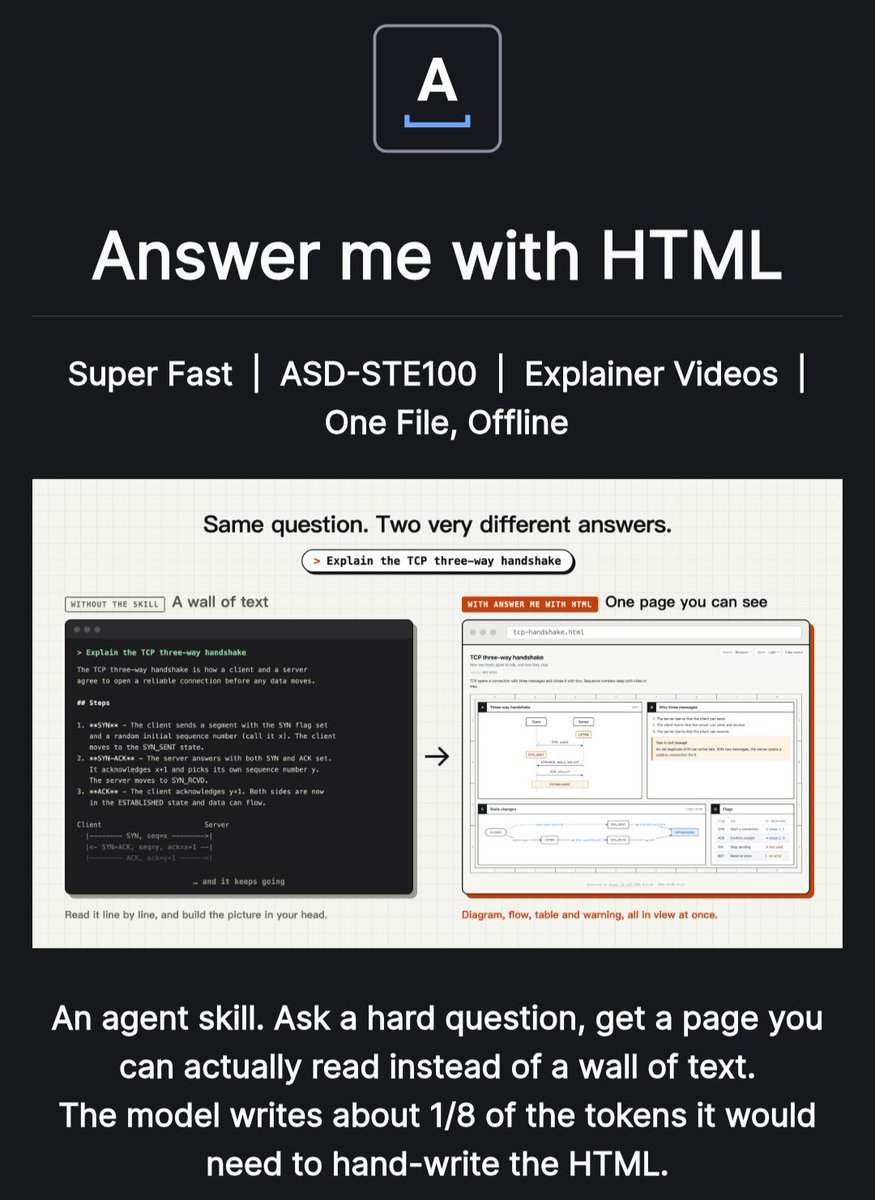
@celineodier 强调(35 个赞,26 条回复,484 次浏览)REA,一个开源仓库,让智能体可以在本地逆向分析应用行为,并在不需要源代码的情况下“拿出证据”解释功能如何运作。@DivyanshT91162 展示了(9 个赞,7 条回复,595 次浏览,8 次收藏)称,“用 HTML 回答我”可以把智能体输出的 Markdown 转成独立的 HTML 讲解页,包含图解、对比表格和离线浏览支持,同时还声称在作者的基准测试中,输出 token 约为原来的八分之一,生成速度提升 2.6 倍。
 @DanKornas 描述(10 个赞,7 条回复,784 次浏览)提到 ReevesAgents:这是一个基于 tmux 的本地工作区,可让 Claude Code、Codex、Kimi 和 OpenCode 并排运行;以及 宣布(3 条回复,403 次浏览)提到的 Ordewell:一种“规划优先”的编排器,会把改动代码的任务隔离在各自的 worktree 中,只有在出现完成标记后才会放行。@badlogicgames 表示(67 个赞,9 条回复,4,123 次浏览,21 次收藏)称,pi-mobile 现在已支持可热重载的联网插件,以及多用户、多终端支持;与此同时,@agentnative_ 分享了(4 个赞,3 次引用,451 次浏览,5 次收藏)提到一种 webhook 流程,可让 Claude Code 把 X 上的实时调研任务交给 GrokBot,待答案返回后再继续。
2. 什么让人感到挫败
配额削减和限制设计打断了实际工作
严重性:高。@SamPassey3 表示(36 个赞,2 条回复,2,447 次浏览,6 次收藏)称,Stanford ChatGPT Edu Pro 用户失去了他们原以为已付费购买的 20x 配额,降到了 10x,有时还会失去某个已部分使用周剩余的额度。@Ananth7e 认为(80 个赞,26 条回复,3,907 次浏览)指出,限制设计与总额度同样重要,因为 5 小时上限可能会在任务运行到一半时将其打断;而他发起的投票中,“没有 5h 限制、总用量不变”略微领先于“恢复 5h 限制但提高每周额度”。@JustLingonberry 询问(29 个赞,23 条回复,826 次浏览)询问,是否还有其他人在用过 Opus 5.5 后就干脆不再使用 Codex,这表明使用摩擦已经开始转化为切换行为。值得构建:高。
Dots 和 Codex 的连续性,偏偏在用户最期待长期协助的地方出了问题
严重性:高。@wynand_schoeman 总结道(52 个赞,13 条回复,401 次浏览)将 DevDay 描述为一次朝着“能跨对话记住上下文的智能体”以及“可在电脑、手机或完全在云端运行的 Codex”推进的发布。可在这样的背景下,@jessepollak 报道称(28 个赞,6 条回复,7,115 次浏览)称,Dots 既无法管理并非由 Dots 创建的现有电脑任务,也不能可靠地看到由 Dots 创建的任务;其中一条回复还表示,这让产品无法用于驱动许多长时间运行的项目任务。人们的应对方式是退回本地会话、借助第三方控制层,或手动不断催动。值得构建:高。
当默认设置不明确时,可观测性依然让人觉得有风险
严重性:中到高。@TheDailyViber 认为(2 条回复,45 次浏览)称,当会话出问题时,Copilot 应用追踪可以显示模型调用、工具调用、错误和 diff 上下文——这正是团队所需要的那类证据。但 @spencerclarkdev 警告称(8 条回复,463 次浏览)指出,Qwen Code、Codex 和 Claude Code 中的默认遥测如果配置不够谨慎,可能会包含提示词、文件读取、记忆内容或与邮箱关联的指标。@GHchangelog 宣布(12 个赞,1,295 次浏览)提到了 JetBrains 的手动 MCP 启动控制,这看起来像是一种应对机制:先收紧运行时控制,再逐步扩大信任。值得构建:高。
隐藏的路由和隐藏的 harness 行为,让性能变得难以判断
严重性:中。@0xtoberry 指出(115 个赞、27 条回复、7,656 次浏览)提到一种看似真实、但在 Antigravity 中仍未得到证实的模型路由行为。@teortaxesTex 认为(42 个赞、15 条回复、3,804 次浏览、25 次收藏)指出,harness 兼容性的变化,足以改变时间感知和精力调节,进而影响人们对模型质量的主观评价;@OrenMe 展示了(3 个赞、55 次浏览、1 次收藏)则称,仅提示词顺序的调整,就可能在一次测试中大幅压低报告中的 credits。人们的应对方式包括:观察界面显示出的模型 ID、比较不同 shell 而不只比较模型,以及手动调整上下文顺序。值得构建:中等。
3. 人们希望存在什么
一层能跨对话、设备和代理延续的连续性机制
最强烈、最实际的需求,并不是一个更聪明的回答框,而是任务在 Dots、Codex、手机、电脑和云端之间流转时,仍能保持连续性而不丢失。@wynand_schoeman 用可记忆上下文和多端 Codex 概括了 OpenAI 自身的产品方向,而 @jessepollak 则展示了这种交接在现实中失效时会有多痛苦。ReevesAgents 和 Ordewell 也从外部部分回应了同样的需求:让本地运行过程可见且结构化;但当天的证据表明,这种连续性依然是碎片化的。机会:直接。
既能证明发生了什么、又不过度暴露信息的沙盒与追踪
MXC、Copilot 应用追踪、JetBrains 运行时控制,以及那条关于遥测的警示帖,都指向同一个诉求:让代理的动作可检查,但不要为了获得这种可见性,就要求团队泄露提示词、文件或身份信息。@twtayaan 描述了一种在代理之外强制执行的沙盒,@TheDailyViber 展示了会话追踪的价值,@spencerclarkdev 则说明了默认设置为何重要。现有解法虽然存在,但整个工作流仍更像是东拼西凑,而不是一体化方案。机会:直接。
可视化、紧凑且可评论的解释方式
@DivyanshT91162 之所以持续吸引关注,是因为它点出了一个真实痛点:代理可以解释一个系统,但答案往往以终端输出的形式倾泻而来。“用 HTML 回答我”之所以存在,是因为一页富含图示的离线页面,比起一长串不断滚动的 Markdown,更易阅读、分享和评论;该项目还声称,把排版工作卸载给 CLI,也能显著减少输出 token。这看起来是实际需求,不只是表现层面的润色。机会:竞争性。
自动进行、具备成本意识的 harness 调优
当天出现了异常具体的证据,表明提示词排序、工具搜索、动态上下文发现,以及 harness 的时间注入,都会实质性地改变成本和质量。@ScarletKc、@OrenMe、@teortaxesTex 和 @ajutqs 都指向这样一类优化:大多数用户目前仍需手动摸索。如果有一层系统能按任务自动调优这些选择,就能满足一个活跃且现实的需求。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Microsoft Execution Containers | 沙盒运行时 | (+) | 外部文件、网络和资源控制;跨平台 JSON 策略;已集成到多个代理界面 | 生态推广仍处早期,尚未覆盖所有编码代理 |
| Dots and Codex | 代理界面 | (+/-) | 跨对话记忆、云端+电脑+手机的整体方案、一方投入推进很快 | 线程连续性 bug、配额混乱,以及切换压力 |
| Claude Code 和 Opus 5.5 | 编码代理 | (+/-) | 输出质量强到足以让一些用户从 Codex 转向它 | 与竞争对手一样,处在同一场关于配额与遥测信任的讨论中 |
| 工具搜索与动态上下文发现 | 上下文加载方法 | (+) | 更低的 token 负载、更好的缓存保留、在多家厂商上的基准测试中都有提升 | 仍属实验性、依赖特定厂商,而且大多只通过文档或小众设置开放 |
| Stability Ordered Prompt | 提示词结构方法 | (+) | 改善缓存复用,并在一次测试中显著降低报告的 credits | 会改变指令顺序,且未必能泛化到不同运行时或工作负载 |
| 面向编码代理的 OpenTelemetry 追踪 | 可观测性 | (+/-) | 让团队能检查一次糟糕 diff 背后的模型调用、工具调用、错误和时序 | 默认设置涉及隐私敏感问题,配置路径也仅限企业版 |
| REA | 逆向工程工作流 | (+) | 借助多个代理 CLI,对应用、网站和二进制文件进行本地、以证据为导向的检查 | 不会提供源代码,也不意味着你有权复制其发现内容 |
| 用 HTML 回答我 | 输出渲染层 | (+) | 答案更易读、支持图示、便于离线分享、token 需求更低 | 更适合解释型任务,且增加了一步渲染流程 |
| Ordewell | 先规划后编排 | (+) | 可编辑计划、按任务选择运行器、worktree 隔离、基于完成标记的验证 | 仍处于早期阶段,且执行前会增加规划开销 |
| 开放代码审查 | PR 评审自动化 | (+) | 单工作流配置、仅审查 diff、行内评论、预算控制 | API 成本管理和版本锁定细节需要操作者谨慎处理 |
| pi-mobile 插件 | 移动端与多界面运行时 | (+) | 支持热重载、联网、多用户插件,可将智能体的使用界面扩展到桌面之外 | 发布时间和是否开源在回复中仍不断有人追问 |
总体来看,用户对那些提升了控制力、可读性或协同能力的封装工具评价偏正面;而对第一方智能体界面的反馈则较为复杂,因为配额、路由或会话连续性问题仍然存在。迁移压力已经显现:@JustLingonberry 提问(29 个赞,23 条回复,826 次浏览)询问大家在试过 Opus 5.5 之后,是否实际上已经停止使用 Codex;而 @teortaxesTex 认为(42 个赞,15 条回复,3,804 次浏览,25 次收藏)则指出,模型外层的 shell 仍然解释了这种偏好的一部分原因。
最重要的竞争态势并不是“哪家厂商的基础模型最聪明?”,而是“哪种工作流浪费的 tokens 更少、隐藏的状态更少、打断的任务更少?”工具搜索、提示词排序、沙箱、多智能体规划器和 HTML 渲染,都是对这个更大工作流问题的不同回答。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| REA | morluto | 在本地智能体协助下,对应用、网站和二进制文件进行逆向分析,并输出以证据为导向的结果 | 让开发者在无法访问源码的情况下,也能检查某项功能是如何实现的 | 本地逆向工程工作流、多智能体 CLI 支持、桌面/移动/Web 目标 | 已发布 | GitHub |
| 用 HTML 回答我 | QingYunA | 将智能体生成的 Markdown 草稿转换成带图表和表格的独立 HTML 说明页 | 用可分享的可视化输出取代难以阅读的终端内容 | Markdown 转 HTML 渲染、图表生成、离线 HTML 交付 | 已发布 | GitHub |
| ReevesAgents | mertkayacs | 在一个本地工作区中并行运行多个编程 CLI | 在不强制统一到单一提供商的前提下,组织多智能体本地运行 | tmux、CLI/TUI/Web UI、可选 MCP、本地 JSON 状态 | 已发布 | GitHub |
| Ordewell | ordewell | 将一个目标转化为可编辑的任务计划,并使用隔离的代码变更 worktree 执行 | 让多智能体运行在合并前更易于检查和验证 | 规划器、按任务选择运行器和模型、worktree、完成标记 | Beta | GitHub |
| Open Code Review | Alibaba | 通过一个工作流文件和运维控制,为 GitHub 增加 AI PR 评审 | 无需运行 PR 代码,就能为每次 push 提供可重复的评审覆盖 | GitHub Action、npm CLI、兼容 OpenAI 或 Anthropic 的端点 | 已发布 | GitHub |
| pi-mobile plugins | @badlogicgames | 为移动端智能体界面增加支持热重载的联网插件 | 将智能体工作流扩展到支持多用户、多界面的移动端控制 | 联网插件运行时、移动端界面、持久性支持 | Beta | 推文 |
| 用于 Claude Code 的 GrokBot webhook | Agent Native | 通过 webhook 将 Claude Code 中的任务发送给 GrokBot,并在研究结果返回后恢复流程 | 在不中断编码会话的情况下,引入来自 X 原生环境的实时研究能力 | Claude Code prompt/skill、webhook、GrokBot | 已发布 | 指南 |
@celineodier 重点介绍了(35 个赞,26 条回复,484 次浏览)把 REA 描述为一种方式:你可以询问智能体另一个产品是如何实现某项功能的,并得到有证据支撑的解释,而不是猜测。这里的重要模式不只是逆向工程,而是本地、由智能体辅助的分析正成为一种常规工作流,而不再只是安全专家的专门操作。@DivyanshT91162 展示了(9 次点赞、7 条回复、595 次浏览、8 个书签)称,“Answer me with HTML” 将输出层视为独立的产品接触面。模型负责生成内容,CLI 负责排版和图表,这也解释了为何该项目既宣称结果更易读,又能降低输出 token 的使用量。
@DanKornas 描述了(10 次点赞、7 条回复、784 次浏览)将 ReevesAgents 描述为一个本地工作区:它把各家提供商的 CLI 保持在 tmux 中运行,同时围绕同一组运行过程提供 CLI、TUI、Web UI,以及可选的 MCP 控制。在另一篇帖子中,他还 宣布了(3 条回复、403 次浏览)Ordewell:它更进一步走向显式协调,让计划在执行前即可编辑,并将会修改代码的任务隔离到各自的 worktree 中。


@DegenOfWallSt 显示(1 次点赞、1 条回复、108 次浏览、1 个书签)称,Open Code Review 与其说是个玩具式审查器,不如说是一套可操作的工作流:必须先设置 secrets 和变量,可以为 token 预算设上限,fork 的 PR 仅保留 diff,而且仅固定 action SHA 还不够,因为 CLI 会在运行时从 npm 安装。贯穿这一节、反复出现的构建模式已经很清楚:这些新项目为 agent 的工作加上的是结构,而不只是更多文本生成。
6. 新鲜事与值得关注的动态
Microsoft 把沙箱化变成了明确的 agent 运行时
@twtayaan 报告(245 次点赞、41 条回复、17,106 次浏览、159 个书签)将 MXC 视为对一个通常被轻描淡写带过的问题的具体回答:agent 能接触哪些文件、网络和资源,这条边界又由谁来执行和约束?值得注意的不只是又一个沙箱声明,而是跨平台支持、JSON 策略,以及与现有 coding-agent 界面的具名集成这几者的结合。
四家厂商指向了同一种工具加载策略
@ScarletKc 收集(3 次点赞、512 次浏览)提到了一组格外有用的文档,分别来自 Anthropic、OpenAI、Cursor 和 GitHub。虽然表述不同,但它们描述的是同一条运行原则:更少地加载工具、更晚地加载工具,并尽可能保留缓存复用。与任何单独一则公告相比,这种跨厂商的趋同本身就是更有力的证据。
Harness 调优终于拿出了人们可以核查的数字
这一天出现了几项可量化的说法,而不再只是模糊的“感觉更快了”。@teortaxesTex 分享(42 次点赞、15 条回复、3,804 次浏览、25 个书签)发布了一张关于不同 harness 之间持续时长跟随情况的基准截图,@OrenMe 显示(3 次点赞、55 次浏览、1 个书签)给出了按稳定性排序的 prompts 在缓存读取和 credits 上的差异,@ajutqs 测量(3 条回复、65 次浏览)则提到,四天内 Codex 在真实任务中的输出速度几乎翻倍。值得注意的变化不只是优化本身,而是优化开始在公开场合变得可见、可讨论。
OpenAI 围绕多界面 Codex 的叙事,推进速度快过了它的连续性层
@wynand_schoeman 总结(52 次点赞、13 条回复、401 次浏览)将 DevDay 描述为一次面向 Dots memory、GPT-6.1 Sol、Astra Ultrafast、Pro 500 和 Codex Cloud 的推进,覆盖电脑、手机和云端。同一天,@jessepollak 报告(28 次点赞、6 条回复、7,115 次浏览)称,Dots 与本地 Codex 工作之间的任务连通性已中断。这里最值得注意的信号,是产品叙事与日常线程连续性现实之间的落差。
7. 机会在哪里[+++] 面向长期工作的跨工具连续性与记忆 - Dots 和 Codex 的 bug、DevDay 对云端加手机加电脑工作流的推动,以及 ReevesAgents 和 Ordewell 的流行,都指向同一个缺口:用户需要让任务、上下文和控制状态能跨不同界面延续,而不必依赖脆弱的交接。最佳切入点是一个可检查、可移植且不绑定单一提供商的连续性层。
[+++] 融合沙箱、追踪与隐私防护的安全执行套件 - MXC、Copilot 应用追踪、JetBrains 启动控制,以及关于遥测警告的讨论帖,都表明市场需要这样一种方案:既能说明“代理始终在这些边界内运行”,又能在不过度泄露信息的前提下给出“这就是证据”。信任工具正在成为一个独立的产品类别。
[++] 成本感知的 harness 优化 - 工具搜索、动态上下文发现、提示词排序和速度日志都表明,如今许多最大的收益来自会话结构的设计,而不是切换模型。若有产品能按任务自动调优工具加载、缓存友好性和提示词布局,就能满足当前运营者的现实需求。
[++] 以可检查产物取代终端倾倒输出的结果与审查层 - “用 HTML 回答我”和 Open Code Review 之所以成功,是因为它们把代理的工作转化为人类真正能够评估的东西:渲染后的页面、PR 中的行内评论、有边界的审查摘要。市场仍有空间容纳更多产品,把原始代理输出转换成更适合阅读、审批和审计的格式。
[++] 具备显式依赖关系与隔离执行能力的多代理规划器 - ReevesAgents、Ordewell、pi-mobile 插件,以及 GrokBot 的 webhook 流程,都将编排视为独立于生成之外的问题。机会最明确的方向,是让协调层把计划可视化、保持代理彼此隔离,并为人类保留一个清晰统一的控制界面。
8. 要点
- 信任栈正在进入产品层。 MXC、JetBrains 运行时控制和 Copilot 会话追踪表明,代理的安全性与可检查性正被封装为产品功能,而不再留给本地惯例解决。
- harness 与上下文工程如今已成为首要杠杆。 围绕工具搜索、提示词排序、时长跟踪和速度测量的公开证据表明,工作流管线对成本和感知质量的影响,已经可以与模型选择本身相提并论。
- 配额设计与连续性 bug 正在直接塑造采用情况。 Stanford 的方案削减、关于 5 小时限制的投票、Dots/Codex 问题,以及围绕 Opus 5.5 的切换讨论,都说明中断比营销更重要。
- 开发者正在围绕代理构建封装层,而不是试图超越前沿模型。 当天最突出的项目集中在逆向工程、HTML 展示、多代理控制、移动插件、PR 审查和 webhook 委派。
- 最明确的机会在记忆、控制与可检查性。 凡是某个产品能让代理工作更容易续接、结构化成本更低、运行更安全,或更便于人类审查,相关证据就最为充分。