Twitter AI 编程 - 2026-10-13
1. 大家在讨论什么
1.1 Gemini 4 Argon 不再只是传闻,而是开始作为产品接受公开评判(🡕)
围绕 Argon 的讨论终于从追逐泄露信息,转向了公开评测和正式上线。至少有六条高信号帖子把一手测试、产品公告,以及 Google 自行发布的部署指标串联了起来。最明显的变化是,人们不再只是追问 Argon 是否存在;他们开始比较它在 Copilot、Antigravity 和其他测试框架中的表现,以及周边产品层是否足够完善,能让这个模型真正发挥出来。
@emollick 表示(426 个赞,58 条回复,26,826 次浏览,99 次收藏)表示,Gemini 4 是首个通过他“Fable/Mythos/Astra 门槛”的非 OpenAI/Anthropic 模型,而且在创造力、写作和通用代理式行为方面都强于此前的 Gemini 模型,不过在复杂多代理任务上仍然落后,因为 Antigravity 这个框架“还不如竞争对手那么好”。随附的对比很关键:同一个粗野主义城市建造器提示词,在 Argon 中生成的 UI 更密集,建筑输出也比 Codex 中的 Astra Max 或 Code 中的 Fable 5.1 Max 更完整。(帖子链接)

@github 宣布(236 个赞,35 条回复,22,953 次浏览,31 次收藏)表示,Gemini 4 Argon 已在 GitHub Copilot 中正式可用,并称其最大的基准提升出现在 Copilot CLI。公开的 GitHub 更新日志 进一步补充了分发细节:Argon 正在向 VS Code、Visual Studio、Copilot CLI、代码代理、Copilot 应用、JetBrains、Xcode 和 Eclipse 推出,面向 Pro+、Max、Business 和 Enterprise 用户开放。(帖子链接)
@antigravity 报道称(158 个赞,26 条回复,9,528 次浏览,38 次收藏)表示,他们的团队使用 Argon 加上多代理工作流,在 17 种语言之间校准翻译。关联的 Antigravity 博客文章 让这次上线看起来远不只是首日演示:Google 表示,Alphabet 内部每月已有超过 100,000 名用户在其内部 Antigravity 环境中依赖 Argon,代理式代码增加了 35%,四周内提交后回滚减少了 30%,并且在不到三小时内就清掉了 134 个缺陷积压中的 97 个。(帖子链接)
讨论洞察: 围绕这三条帖子的回复最终都集中到了同一个微妙点上:人们愿意承认 Argon 看起来很强,但仍然持续把模型质量和框架质量区分开来。Emollick 的帖子下面有人讨论 Antigravity 的 UI 和工作流层,而 Antigravity 的上线帖一发出,评论区立刻就挤满了追问:为什么 Pro 订阅用户仍然无法使用这个模型。
与前一天的对比: 在 2026-10-12,关于 Argon 最强的信号仍然是泄露出的路由、套餐表,以及隐藏在旧 Gemini 标签下的可用性。到了 2026-10-13,讨论已经升级为一手评测、在 Copilot 中的官方分发,以及 Google 提供的、证明 Argon 已在大规模使用的证据。
1.2 用户仍在通过菜单、二进制文件和重定向来逆向推断 Argon 的上线范围(🡕)
即便官方上线帖已经出现,很大一部分讨论看起来仍像是在做产品考古。至少有八条公开帖子依赖二进制 diff、模型选择器、升级重定向、配额界面和带日期的通知,来弄清楚谁能访问哪些模型,以及能访问多久。这个模型确实变得更可见了,但围绕它的规则仍然是由用户一点点拼出来,而不是在产品内被清晰地呈现出来。
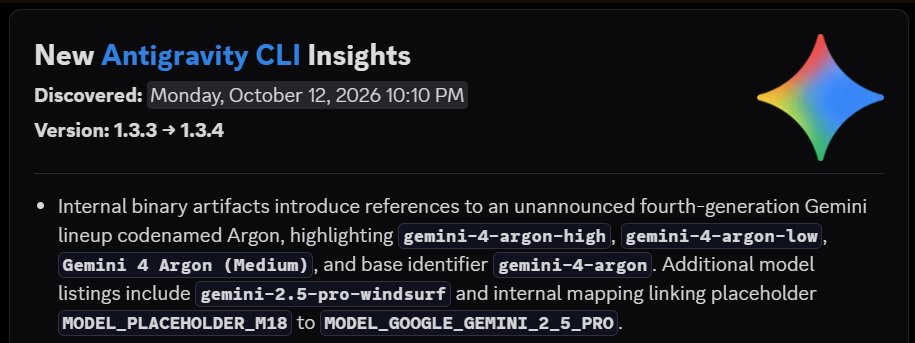
@lyraxana 展示了(198 个赞,10 条回复,7,526 次浏览,14 次收藏)表示,最新的 Antigravity CLI 更新,直接在用户可检查的界面中暴露了 gemini-4-argon、gemini-4-argon-low、gemini-4-argon-medium 和 gemini-4-argon-high。@LuminaBench 新增了 发布了桌面端和 CLI 的 diff 卡片,显示这些原生 ID 出现在 Antigravity 2.23.0 和 CLI 1.3.4 中,同时明确提醒,编译进程序里的标识符并不能证明账号已获得访问权限。(帖子链接)
@yoftahe 注意到(1,042 次浏览)表示,在 Antigravity 中点击升级会跳转到 antigravity.google/g1-upgrade?utm_campaign=ARGON_SETTINGS_PAGE,这意味着人们在看到通俗解释之前,就已经先从 URL 里察觉到了这次发布。@blankspeaker 附上了(44 次点赞、5 条回复、2,604 次浏览)提到一则通知,称当前 Pro 和 Ultra 套餐中的第三方模型访问将于 11 月 2 日终止;@ishanxtwt 认为(19 次点赞、18 条回复、452 次浏览)则表示,大家应趁现有对 Claude Opus 4.6、Sonnet 4.6、Gemini 和 GPT-OSS 的免费访问仍然存在时尽快使用。@ash_twtz 展示了(11 次点赞、8 条回复、688 次浏览)则展示了同一访问故事的另一面:五小时的 Gemini 使用窗口已被完全耗尽,但每周配额仍有 58% 尚未使用。(帖子链接)

@notjazii 分享了(59 次点赞、18 条回复、5,057 次浏览、14 次收藏)提供了一个应对发布信息不透明的实操性变通办法:在不开启网页搜索的情况下,向 3.8 Flash 询问 Tibo 或模型发布日期;如果它能答对,你很可能被路由到了 Argon。这并非官方验证方式,但它说明,用户为了推断自己实际在和哪个模型对话,愿意做到什么程度。
讨论洞察: 社区并未把菜单、通知和跳转链接视作边角信息。这些界面本身就是产品说明。用户不断从截图中提取政策和权益线索,因为可见的账户状态比发布话术提供了更有用的信息。
与前一天的对比: 2026-10-12,用户还在解读套餐矩阵和“即将下线”通知。到 2026-10-13,即便 Argon 已被公开承认,这种行为仍进一步加剧,演变为对二进制文件、升级 URL 和配额面板的更深入检查。
1.3 Codex 的信任仍与重置绑定,而 Claude Code 在对比中更占上风(🡕)
围绕 Codex 的讨论依然集中在重置、限制和竞品比较上,而不是聚焦于某项用户显然想庆祝的新功能。至少有五条保留内容将重置视为面向客户的主要事件,另有几条则借这一天解释,为什么他们正在统一转向 Claude Code,或改用与模型无关的替代方案。最终,这更像是一场关于信任的讨论,而不只是单纯关于模型的讨论。
@codex_resets 确认(44 次点赞、1 条回复、5,771 次浏览)表示,新一轮重置已经到来,而公开的 Codex Resets 追踪器 将其记录为第 61 次重置,平均重置间隔为 6.5 天。@ivanainai 写道(20 次点赞、7 条回复、2,559 次浏览)则认为,三天内两次重置表明真正的产品问题在于使用限制,而再来一次重置也算不上什么有意义的新功能。(帖子链接)
@CodexResets1 转发并强调了(72 次点赞,8 条回复,9,228 次浏览,8 次收藏)一位用户做了 Claude 与 Codex 的直接对比:他说,一个棘手的爬虫问题在 Codex 里大约花了 10 小时,在 Claude 里则只用了 30 分钟。@TweetsOfSumit 表示(28 次点赞,18 条回复,2,591 次浏览,7 次收藏)他的整个工程团队都已从 Cursor 转向 Claude Code,不过仍会时不时使用 ChatGPT/Codex,并把 Gemini 用于非编程工作。@vvoyer 认为(4 次点赞,8 条回复,212 次浏览)依赖绑定单一实验室的前沿编程智能体在战略上存在风险,因为最强模型一直在变;用户应当适应与模型无关的 shell,再配合 OpenRouter 或 AI 网关之类的网关使用。(帖子链接)
讨论洞察: 信息流里对 Codex 最持久的辩护,并不是声称这些问题并不存在,而是认为重置和及时沟通目前仍能让人维持生产力。但这并没有动摇更深层的不满:用户想要的是获得稳定容量和更清晰竞争优势的路径,而不是围绕额度刷新的反复社交仪式。
与前一日对比: 在 2026-10-12,针对 Codex 的抱怨主要集中在额度计算,以及发布时的定位是否符合实际交付的价值。到了 2026-10-13,同样的不满已进一步固化为工具间的并排比较,以及团队层面的迁移表述。
1.4 构建者为智能体加上审查层、沙箱和业务工作流结构(🡕)
当天最强的构建者信号并不是新的聊天界面,而是围绕现有智能体叠加的控制层:先解释再发布的教学机制、按代码仓库限定范围的沙箱、人工审查关卡、可复用的图表工具,以及具体的业务工作流。至少有七条公开帖子描述了这样的系统:模型负责完成有用的工作,但最终由人工或策略层来决定什么才算安全、可理解或可交付。
@dewanshranjan 发布了(8 次点赞,9 条回复,243 次浏览)Contral 被描述为一层叠加在 Cursor、Claude Code、Copilot、Codex CLI 或自定义智能体之上的教学层,它会在写代码时解释每个函数和决策,并加入一种防御模式:在发布前要求用户用自己的话解释这段代码。@DanWahlin 描述道(9 次点赞,2 条回复,751 次浏览,7 次收藏)课程制作中也出现了类似模式:人类负责大纲、教学层级和最终决策,而 Copilot app 和 CLI 则负责搭建内容框架、生成视觉素材、验证链接,并在 Claude、Grok 和 Codex 之间支持多轮审查。(帖子链接)
@vipulnsward 展示了(3 次点赞,1 条回复,238 次浏览)一条公开工作流展示了如何结合 Codex、Dots、gbrain 和人工审查,为 Pune 的企业构建边界清晰的网站和应用。其链接的 Saeloun 案例研究 介绍了一个维修 CRM、一个摄影校样流程和一个面包店网站,全部通过私有 GitHub 仓库、自动化检查以及 Hetzner/Cloudflare 部署运行。@sam_kececi 表示(20 次点赞,6 条回复,486 次浏览)Sentience web app 由一家软件工厂构建,而其人类指导者当时完全不在岗,这让同样的思路进一步指向了更强的自主性主张。@drawio 补充说(18 次点赞,1,103 次浏览,11 次收藏)另一个规模更小但非常实用的做法:让 Copilot 生成一张图表,然后通过官方 draw.io MCP 仓库 进行编辑;它目前已有 5,635 个星标,并明确支持 Copilot CLI。
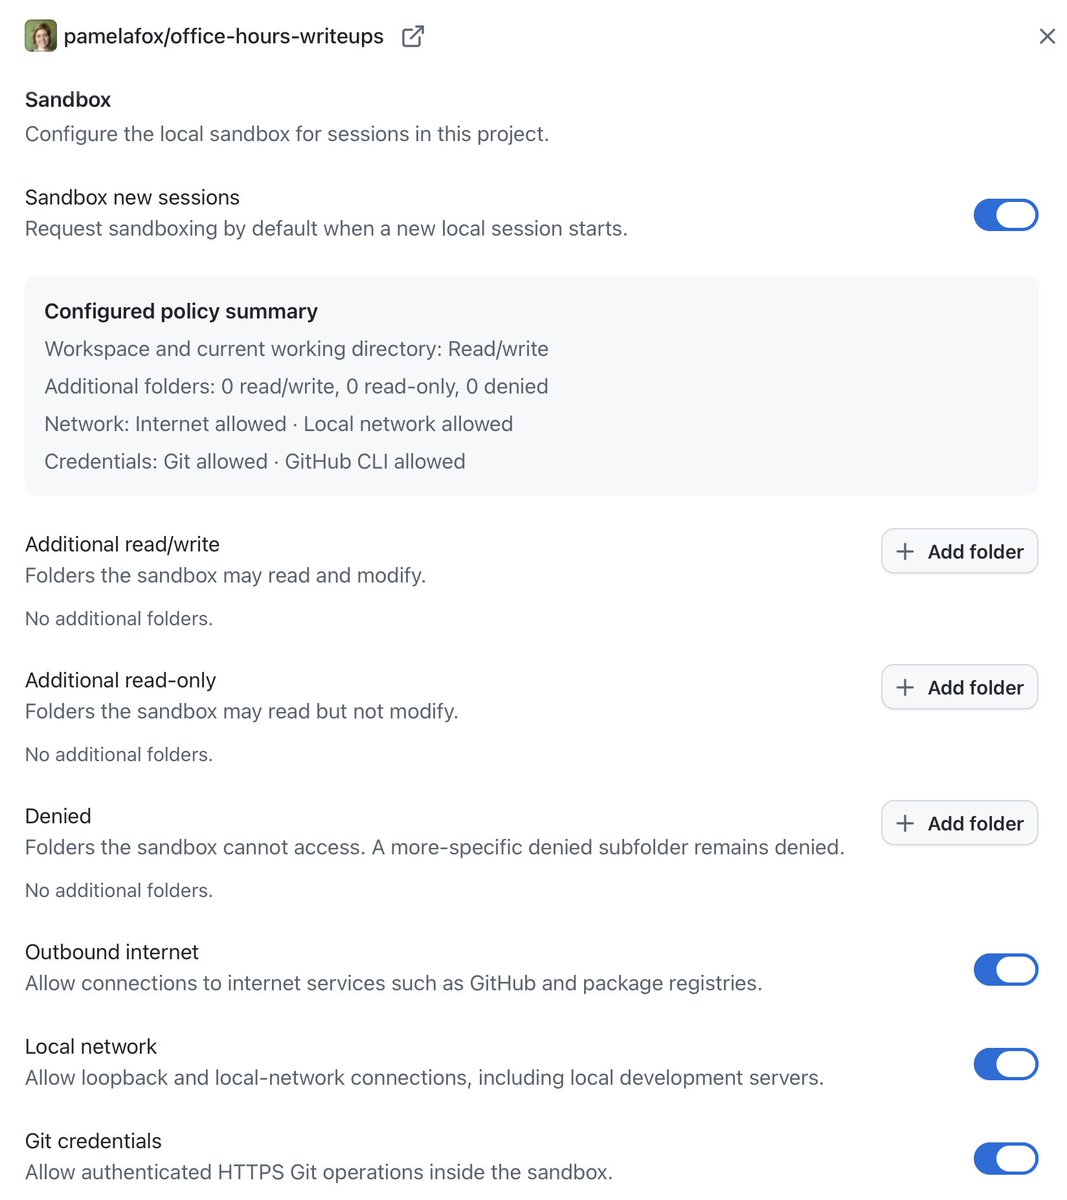
@pamelafox 指出(2 个赞、2 条回复、391 次浏览)称,Copilot 应用现已提供按仓库划分的沙箱选项,可控制可读写文件夹、对外联网以及 git 凭证。链接的 Microsoft 文章 进一步说明,GitHub 在 Windows 上使用 MXC、在 macOS 上使用 Seatbelt、在 Linux 上使用 bubblewrap;同时,@DivyanshT91162 主推(4 条回复、218 次浏览、2 次收藏)介绍了 PocketPaw:一款具备持久记忆、支持多种后端、带有工具策略并要求人工批准的本地个人助手。(帖子链接)
讨论洞察: 这些帖子反复呈现出的构建模式,并不是“模型更强,产品自然完成了”,而是“先用模型,再补上策略、工件或审查界面,让产出保持可理解、可治理”。这是完全不同的一层竞争壁垒。
与前一天对比: 在 2026-10-12,封装类项目主要聚焦于持久化和领域适配器。到了 2026-10-13,最强的一批构建者案例则更明显地转向人工批准、仓库范围内的策略,以及能把 agent 输出转化为人类真正可验证内容的工作流结构。
2. 什么让人们感到沮丧
访问策略不断以线索形式浮现,而不是通过清晰的产品沟通传达
严重程度:高。@blankspeaker 显示(44 个赞、5 条回复、2,604 次浏览)提到一则带日期的通知:当前 Antigravity 方案对第三方模型的访问将于 11 月 2 日终止;@yoftahe 发现(1,042 次浏览)显示了一个跳转到 antigravity.google/g1-upgrade 的升级重定向;而 @ishanxtwt 处理为(19 个赞、18 条回复、452 次浏览)则把当前的免费模型选择器当成应在其消失前尽量利用的对象。用户了解策略的途径是菜单、通知和 URL,而不是稳定的变更日志。值得投入构建:高。
Codex 重置看起来仍像是暂时缓解,而不是持久修复
严重程度:高。@codex_resets 确认(44 个赞、1 条回复、5,771 次浏览)提到又一次重置,而公开的 重置跟踪器 则将其记为第 61 次有记录的重置。@ivanainai 表示(20 个赞,7 条回复,2,559 次浏览)称,三天内两次重置表明,真正的产品问题在于使用限额;而 @CodexResets1 放大了(72 个赞,8 条回复,9,228 次浏览,8 次收藏)则报告称,同一个高难度任务在 Codex 里花了 10 小时,在 Claude 里却只用了 30 分钟。令人沮丧的不只是额度太低,更在于用户体验依然离不开人工干预。值得做:高。
同一个模型,套在不同外层框架里,体验可能截然不同
严重性:高。@emollick 写道(426 个赞,58 条回复,26,826 次浏览,99 次收藏)称,Argon 本身很强,但 Antigravity 这层框架在复杂多智能体任务上仍落后于竞品。@notjazii 转而采用(59 个赞,18 条回复,5,057 次浏览,14 次收藏)甚至做了无网页访问的提示词测试,只为推断 3.8 Flash 是否被路由到了 Argon;而 @vvoyer 认为(4 个赞,8 条回复,212 次浏览)则表示,从长期看,与实验室绑定的编码代理并不是好的押注,因为最强模型一直在变。@al3rez 补充说(2 个赞,3 条回复,141 次浏览)则给出了同一问题的一个具体研究版本:Xiaomi 发现,在同一个 checkpoint 上,重复的工具调用在 OpenCode 和 Codex 中会表现不同。值得做:高。
AI 写代码的速度,依然快过团队能够安心解释或审查的速度
严重性:中到高。@dewanshranjan 将其表述为(8 个赞,9 条回复,243 次浏览)把问题说得很直接:AI 写代码的速度比人类读代码还快,而人们往往还是会把代码发出去,直到某个地方出问题。这也正是 Contral 要增加教学层和防御模式的原因:在发布前要求用户先解释这段代码。@DanWahlin 描述(9 个赞,2 条回复,751 次浏览,7 次收藏)则从另一个角度说明了同样的压力:即便 Copilot 处理了脚手架、截图、评审和链接检查,人类仍然必须决定一门课程里的“好”到底应该是什么样。值得做:高。
3. 人们希望出现什么
一个公开台账,说明模型访问权限、下线安排和配额规则
@yoftahe、@blankspeaker、@ishanxtwt 和 @ash_twtz 共同指向了同一个缺失的产品:用户想要一个单独页面,清楚写明谁能用哪些模型、访问权限何时变化、接下来什么会到期,以及配额窗口到底如何运作。现在,他们只能靠重定向、选择器和截图来拼凑这些信息。机会:直接。
在任何人发布之前,先把自己写的代码讲明白的代理
@dewanshranjan 明确指出,问题不只在于生成质量,还在于理解债务;而 Contral 的整个主张,就是一边写代码一边解释代码,并在发布前强制要求人工解释。@DanWahlin 描述了类似的课程级工作流:代理负责重复性工作,但质量、教学和最终签字仍由人类负责。这里的需求是务实的,而不是理想化的:团队想要的是能减少“盲目发布”的审查界面,同时又不牺牲速度。机会:直接。
安全的本地代理会话,配以可理解的控制项,而不是一味信任
@pamelafox 强调了按 repo 细分的沙箱控制,包括文件访问、网络访问和 git 凭证,而 @DivyanshT91162 则将 PocketPaw 描述为一种具备本地执行、工具策略和人工审批的方案。这两篇帖文背后的诉求很明确:给用户提供比提示词指令更强的边界,同时又让这些边界足够可见、可调,开发者才会真正一直把它们开启。机会:直接。
能扛过下一次基准波动的模型无关控制平面
@vvoyer 认为,前沿编码代理本质上只是绑在某家实验室模型路线图上的“缰绳”,用户应该随时准备在最佳模型更替时切换。@TweetsOfSumit 以及那些讨论 Codex 与 Claude 之间切换的帖子,说明了这一观点为何能引发共鸣:团队已经在同一工作流中混用多家模型提供商。真正的需求,与其说是“发明一个新模型”,不如说是“当排行榜变化时,让这层外壳依然可迁移”。机会:竞争型。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Gemini 4 Argon | 前沿编码模型 | (+/-) | 编码、推理和创意表现强;官方基准领先;在 Copilot CLI 中有明显提升 | 产品质量因外层 harness 而异;上线节奏和授权范围当时仍不透明;访问仍受套餐限制 |
| Google Antigravity | 代理界面 | (+/-) | 支持多代理工作流、多模型接入、内部采用度高,并已用于真实翻译和企业工作流 | 用户仍在反向摸索访问方式;第三方访问将于 11 月 2 日终止;5 小时窗口仍然重要 |
| GitHub Copilot | 编码代理与 IDE 平台 | (+) | Argon 已在 IDE、CLI、编码代理和应用中广泛推出;沙箱和插件能力持续扩展 | 推出节奏渐进;提供商定价和企业政策增加了复杂性 |
| Claude Code | 编码代理 | (+) | 在高难任务中的速度和质量直接对比中胜出;强到足以在一篇帖子里成为团队统一标准 | 仍绑定于某一家实验室的路线图;用户担心长期锁定 |
| Codex | 编码代理 | (+/-) | 仍被广泛使用,在自动化研究中占比很高,并且经常得到额度重置支持 | 用户的信任仍系于额度重置和使用政策,而非稳定容量 |
| OpenCode 和网关式 shell | 模型无关的代理外壳 | (+) | 允许用户随着排行榜变化切换模型,并接入更广泛的提供商生态 | 需要较强的配置纪律;单次修复成本和路由质量仍需验证 |
| Contral | 教学与验证层 | (+) | 解释生成的代码、加入计划审批,并在发布前强制用户理解 | 产品仍很早期,目前公开采用的证据较少 |
| draw.io MCP | 图表 MCP 与插件 | (+) | 可为 Copilot CLI、Copilot app、Claude、Codex CLI 和 OpenCode 生成可编辑图表 | 图表质量仍取决于提示方式,且部分导出流程需要本地工具 |
| 自定义自动研究 harness | 研究工作流方法 | (+/-) | 协调了数百个 PR,混用 Codex 和 Claude,并把 X 变成 GitHub 之上的实时协作层 | 可能让协作界面过载,且仍依赖专家直觉来引导搜索 |
总体来看,当用户能够直接检查输出,或无需重建整套工作流就能切换模型时,满意度最高。满意度最低的情况则出现在定价、配额或访问规则难以预测之处。主要的变通办法包括:用于探测路由的提示词、私有定制代理、人工审核闸门、网关式模型切换,以及在任务或预算有要求时,愿意从 Cursor 或 Codex 转向 Claude Code 或更便携的外壳。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Contral | @dewanshranjan | 为 AI 编码代理增加一层教学层,在代码编写过程中进行解释,并要求用户在发布前理解代码 | 团队生成代码的速度,可能快于他们有把握完成审查的速度 | IDE 覆盖层、计划模式、防御模式、自带模型密钥、与 Cursor、Claude Code、Copilot、Codex CLI、Antigravity、Windsurf、Kilo Code 和 VSCodium 集成 | Beta | 推文 |
| Vipul's AI for Pune businesses | @vipulnsward | 在代理支持和人工审核下,为本地企业构建范围明确的网站和应用 | 小企业需要实用软件,但不想从正式规格说明开始 | Codex、Dots、gbrain、私有 GitHub 仓库、自动化检查、Hetzner、Cloudflare | Beta | 推文, 博客 |
| Sentience web app | @sam_kececi | 交付一个基于 Web 的数字孪生产品;团队称,它是在人工引导者离开期间由软件工厂自主构建完成的 | 测试在没有持续操作员在场的情况下,代理管理交付究竟能走多远 | 自主软件工厂、Web 应用、人工引导 | Shipped | 推文 |
| Draw.io MCP Server | @drawio | 让 AI 助手生成并编辑原生 draw.io 图表文件 | 图表输出常常被困在文字描述或截图里,而不是可编辑资产 | JavaScript、MCP、Copilot CLI/app、Claude、Codex CLI、OpenCode | Shipped | 推文, 仓库 |
| 整数乘法自动研究框架 | @RohanArun | 协调公开的代理生成 PR 和人类想法,以推动研究边界进一步收紧 | 研究人员需要一种方式,把订阅和直觉转化为有组织的实验 | Codex、Claude、自定义框架、GitHub PR、仪表盘、共享提示词 | Alpha | 推文 |
@dewanshranjan 展示了(8 个赞,9 条回复,243 次浏览)最准确地表达了当天开发者的心态:不要只是更快地生成代码,而是要加上一层迫使人先理解的机制。Contral 的截图把这一点直观地呈现了出来:它把解释和审批放在编码代理周围,而不是试图取代代理本身。

@vipulnsward 展示了(3 个赞,1 条回复,238 次浏览)展示了第二种反复出现的模式:从一个具体的业务工作流出发,而不是从一个泛泛的 AI 承诺出发。链接中的博客把这拆解为维修 CRM、摄影校样流程和烘焙店网站,全部由 Codex、Dots、gbrain 和人工审核共同完成。@sam_kececi 推动了(20 个赞,6 条回复,486 次浏览,3 次收藏)则体现了同一方向,但对自主性的表述更强,称 Sentience web app 是在人类引导者实际上不在办公室时建成的。
面向成果物的项目也同样突出。@drawio 使用了(18 个赞,1,103 次浏览,11 次收藏)把 Copilot 用作图表生成器,而不只是文本助手;与此同时,@DivyanshT91162 将其表述为(4 条回复,218 次浏览,2 次收藏)则把 PocketPaw 展示为一个用户可以拥有、配置并审批的本地代理。来自 @RohanArun 的社区自动研究帖子又补充了另一种构建模式:把编码代理当作公开协作的群体,而不只是个人助手,一天内就有 110 位贡献者提交了 285 个 PR。
这些构建反复触发的并不是模型新鲜感,而是实操中的痛点:盲目上线、缺乏工作流结构、成果物难以触达,或者需要让真实业务流程变得更容易。多位开发者独立收敛到同一个答案:用一个更窄的交互层包裹模型,让人们能够真正检查、审批或复用它。
6. 新发布与值得关注的内容
Google 公布了内部规模的 Argon 采用数据,而不只是放出一页基准测试幻灯片
关于 Argon 最有新意的证据并不是来自某个基准测试讨论帖,而是来自公开的 Antigravity 博客。该帖称,Alphabet 每月已有超过 100,000 名用户在 Google 内部的 Antigravity 环境中使用 Argon;代理式代码增长了 35%;提交后的回滚在四周内下降了 30%。同一篇帖子还声称,在不到三小时内将 134 个 bug 的积压减少了 97 个,并记录了 17 种语言本地化和财务工作流等非工程场景的使用情况。(来源)
以仓库为范围的沙箱隔离,成为 Copilot 中可见的产品界面
@pamelafox 披露了(2 个赞,2 条回复,391 次浏览)展示了 Copilot 应用中一个按仓库划分的具体沙箱 UI,而 Microsoft 的配套文章则解释了底层控制机制:Windows 上使用 MXC,macOS 上使用 Seatbelt,Linux 上使用 bubblewrap。这一点之所以重要,是因为这一功能并不是以抽象的安全姿态来描述的,而是按开发者真正关心的操作单位来描述——文件夹、外部互联网、本地网络和 git 凭证。(来源)
公开自动研究看起来更像实时协作的群体,而不是单个代理演示
@RohanArun 报道称(97 个赞,1 条回复,2,454 次浏览,15 次收藏)称,整数乘法社区在 24 小时内由 110 位贡献者发起了 285 个 PR,其中 229 个 PR 提到了 Codex/OpenAI,70 个提到了 Claude。值得注意的不只是数量,更是工作流本身:GitHub 作为执行界面,X 作为实时协调层,人类专家在回复中补充直觉,以及构建自定义框架以大规模吸收未用完的 token。
Xiaomi 的框架论文就代理指标提出了一个虽小但有用的观点@al3rez 重点提到了(2 个赞、3 条回复、141 次浏览)小米 MiMo-V2.6-Pro 研究里有一个细节,很可能经得起时间检验:同一个 checkpoint 在 OpenCode 和 Codex 中表现出了不同的重复工具调用行为,而小米选择花 9 万美元做蒸馏修复,而不是按估算花 231 万美元重新进行 RL 调优。这很好地说明了,为什么编码代理的评估正在从单纯看基准分数,转向更依赖特定 harness 的效率指标,例如无效调用和恢复行为。
7. 机会在哪里
[+++] 面向代理平台的权限与配额可观测性 - 信息流中最明显的痛点并不是模型原始能力不足;而是用户只能通过菜单、通知、重定向和截图,反向推断 rollout、sunset 和配额机制。Antigravity 的 11 月 2 日通知、升级重定向、免费层模型选择器,以及五小时配额面板,都指向了一个产品缺口,而更好的账户状态可见性本可以解决这个问题。
[+++] 安全的本地代理操作套件 - Copilot 的沙箱 UI、PocketPaw 的审批与策略钩子,以及小米关于特定 harness 下工具调用的研究发现,都在强化同一个需求:本地代理需要针对文件、网络、凭证和工具行为提供易于理解的默认设置。市场上仍有空间去做这类产品,把这些控制项打包成开发者真的会一直开启的方案。
[++] 先解释、后发布的审查层 - Contral 的整体主张、Dan Wahlin 的课程工作流,以及 Vipul 由人工审查的商业构建案例,都表明市场需要的不只是生成代码的系统。机会在于,让代理足够可理解,使人无需阅读每一条原始工具轨迹,也能有把握地批准、教学或审计结果。
[++] 与模型无关的代理控制平面 - 围绕 Codex 与 Claude 切换的案例,以及 vvoyer 对绑定实验室 harness 的警告,都说明可移植性正在成为一种独立的产品特性。开发者越来越希望拥有一个持久的外壳,能够切换模型、价格层级或供应商,而不必因此重写整套工作流。
[+] 面向真实商业任务的垂直工作流包 - Antigravity 的翻译案例研究、Pune 的商业构建、draw.io MCP,以及公开的自动研究 swarm,都呈现出同一种模式:当代理被封装进一个范围明确、产出物清晰或结果可衡量的工作流时,注意力就会集中。短期内最强的胜出机会看起来更偏垂直,而非通用。
8. 要点
- Argon 已经成为一个真正的产品讨论话题,而不只是泄露帖里的讨论。 2026-10-13 的公开讨论结合了一手评测、官方 Copilot 可用性,以及由 Google 撰写的部署指标;与前一天关于隐藏路由的讨论相比,这是一套实质上不同的证据基础。(来源)
- 访问策略仍然承担了过多的产品沟通工作。 用户了解变化的方式,来自升级重定向、11 月 2 日的 sunset 通知、免费层模型选择器以及五小时配额面板,而不是一份权威的统一说明。(来源)
- Codex 重置争取到的是时间,而不是信心。 第 61 次有记录的重置让这个话题得以延续,但那些将 Codex 与 Claude 对比、并认为真正问题在于限制的帖子表明,善意仍然取决于人工纾解,而不是持久的信任。(来源)
- 最强的构建者正在用判断、策略,来包裹代理,以及产物界面。 Contral、Copilot 沙盒隔离、draw.io MCP,以及 Pune 的业务工作流,都指向同一个方向:竞争焦点正越来越集中在可审查性和控制力上,而不只是底层模型的选择。(来源)
- 智能体工作流正扩展到公共研究和实际业务运营中。 同一条信息流在讨论前沿模型的同时,也记录了一个自动化研究智能体集群提交的 285 个 PR、翻译工作流、维修与摄影业务软件,以及本地个人智能体,这表明这一话题正在从单纯的个人编程辅助扩展到更广泛的领域。(来源)