Twitter AI - 2026-04-07
1. 人们在讨论什么
1.1 开源模型席卷榜单(🡕)
4 月 7 日的讨论主要被两次开源模型发布主导。它们共同挑战了这样一种假设:前沿能力必须依赖闭源权重和专有 API。
GLM-5.1 由智谱 AI(现为 Z.ai)发布,是一款 7440 亿参数的混合专家模型(激活参数 400 亿),采用 MIT 许可证。其最醒目的说法是:该模型以 58.4% 的成绩登顶 SWE-Bench Pro,超过 GPT-5.4 的 57.7% 和 Claude Opus 4.6 的 57.3%。该模型完全基于 10 万颗华为昇腾 910B 芯片训练,未使用任何 NVIDIA 硬件——这是中国 AI 摆脱美国出口管制依赖的一个真正里程碑。@ziwenxu_ 发布了当天互动量最高的帖子(1,172 个赞、2,115 次收藏、28.7 万次浏览),称这标志着“AI 权力格局”的转变,并附上了 Ollama 的配置命令(帖子)。
不过,这种表述也受到质疑。@PelicanAI_ 发帖进行了详细纠正,指出 GLM-5.1 在 SWE-bench Verified 上落后 Opus 4.6 3 个百分点,在 Terminal-Bench 2.0 智能体编程测试上落后 9 个百分点。若要自托管,至少需要 8 张 A100 80GB GPU(硬件成本 1.5 万美元以上,或云端每小时 10 至 20 美元)。配置说明中的 glm-5.1:cloud 命令实际上会路由到云 API,与“无服务器”的说法相矛盾。其推理速度为每秒 44.3 个 token——在同类模型中最慢。
@grok 补充了更多背景:智谱已在香港 IPO,估值 65 亿美元,股价上涨超过 500%;其 API 价格大约是 Opus 4.6 的五分之一(帖子)。
MiniMax M2.7 则出现在一条回复中,热度甚至盖过了原推文——获得 5,187 个赞和 120 万次浏览,而原推文仅有 35 个赞。这款 2300 亿参数的 MoE 模型在 SWE-Pro 上达到 56.22%,在 Terminal-Bench 2 上达到 57.0%;其训练采用“模型自我进化”流程,M2.7 通过 100 多轮自主优化改进了自身的编程脚手架(公告)。
综合来看,开源智能体编程模型如今已能在自主软件工程最关键的基准上,与前沿闭源模型正面竞争。
1.2 Anthropic 以 Mythos 宣告网络安全进入紧急状态(🡕)
Anthropic 推出了 Project Glasswing,这是一项面向全行业的网络安全计划,围绕 Claude Mythos Preview 展开——该模型在漏洞发现方面能力强到 Anthropic 拒绝开放通用 API 访问。该公告发布于 GLM-5.1 开源前数小时;@ziwenxu_ 认为,这一时间安排是有意为之的竞争性卡位(帖子)。

相关数据十分惊人:Mythos Preview 在 SWE-bench Verified 上达到 93.9%,在 SWE-bench Pro 上达到 77.8%,在 Terminal-Bench 2.0 上达到 82.0%——仅 SWE-bench Pro 一项就比 Opus 4.6 高出 24 个百分点。在 USAMO 上,它得分 97.6%,而 Opus 4.6 为 42.3%。
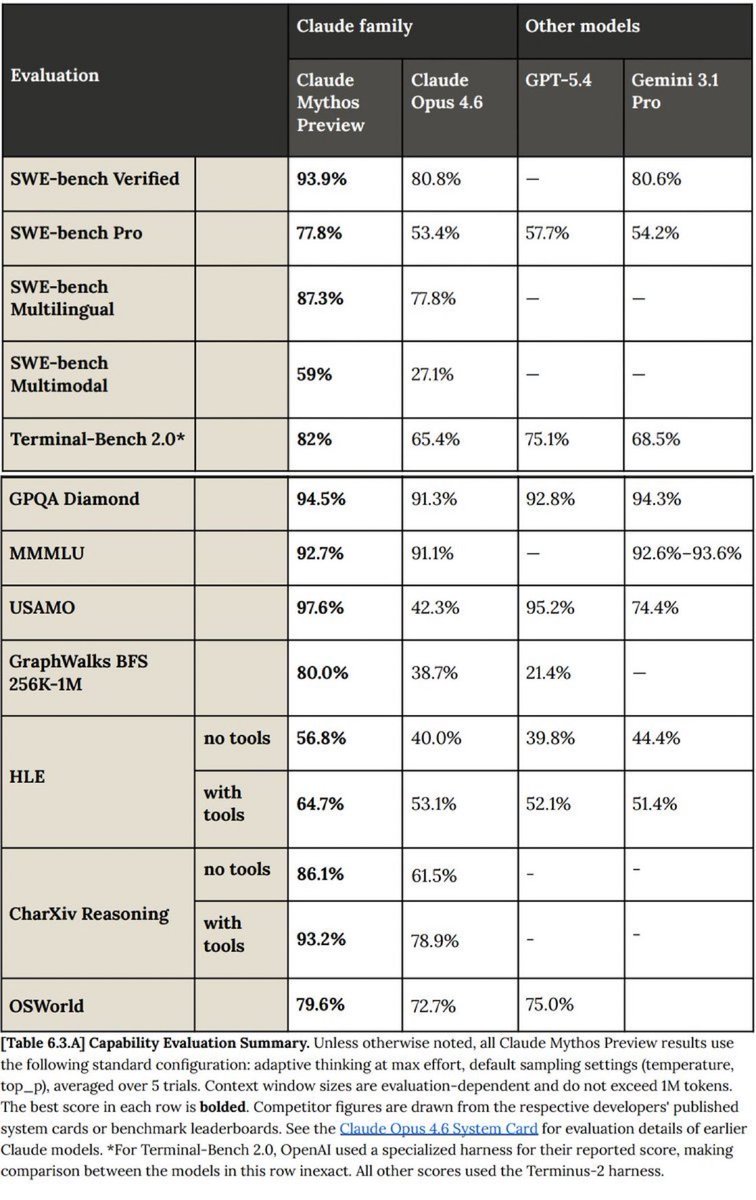
在 Glasswing 计划下,50 多家经过审核的合作伙伴将获得受限访问权限,其中包括 Amazon、Apple、Cisco、CrowdStrike、Google、JPMorgan、Microsoft、NVIDIA 和 Palo Alto Networks。Anthropic 将提供最高 1 亿美元的使用额度,以及 400 万美元的开源安全资助。Mythos 已经在所有主流操作系统和浏览器中识别出数千个零日漏洞,包括 OpenBSD 中一个存在了 27 年的漏洞,以及 FFmpeg 中一个存在了 16 年的缺陷。
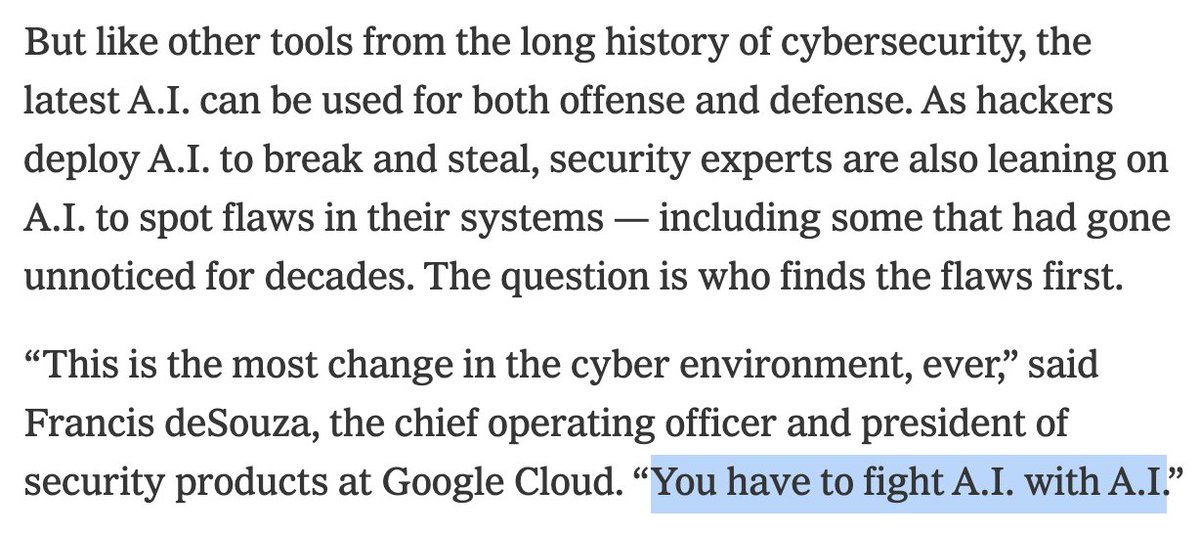
@giovignone 写出了对其安全含义最有实质内容的分析:智能体工作流正在以远超任何人审查能力的速度增加软件产出,而“你必须用 A.I. 对抗 A.I.”。他认为,市场将分化为两类公司:一类把 AI 当作增长黑客工具,另一类把它视为“全栈式运营变革”(帖子)。
1.3 海市蜃楼效应:多模态视觉并不可靠(🡕)
@heynavtoor 解读了一篇斯坦福论文,这可能是本周最重要的 AI 研究披露:《MIRAGE:视觉理解的幻觉》(arXiv:2603.21687),由李飞飞共同署名。该帖获得 135 个赞和 1.49 万次浏览(帖子)。
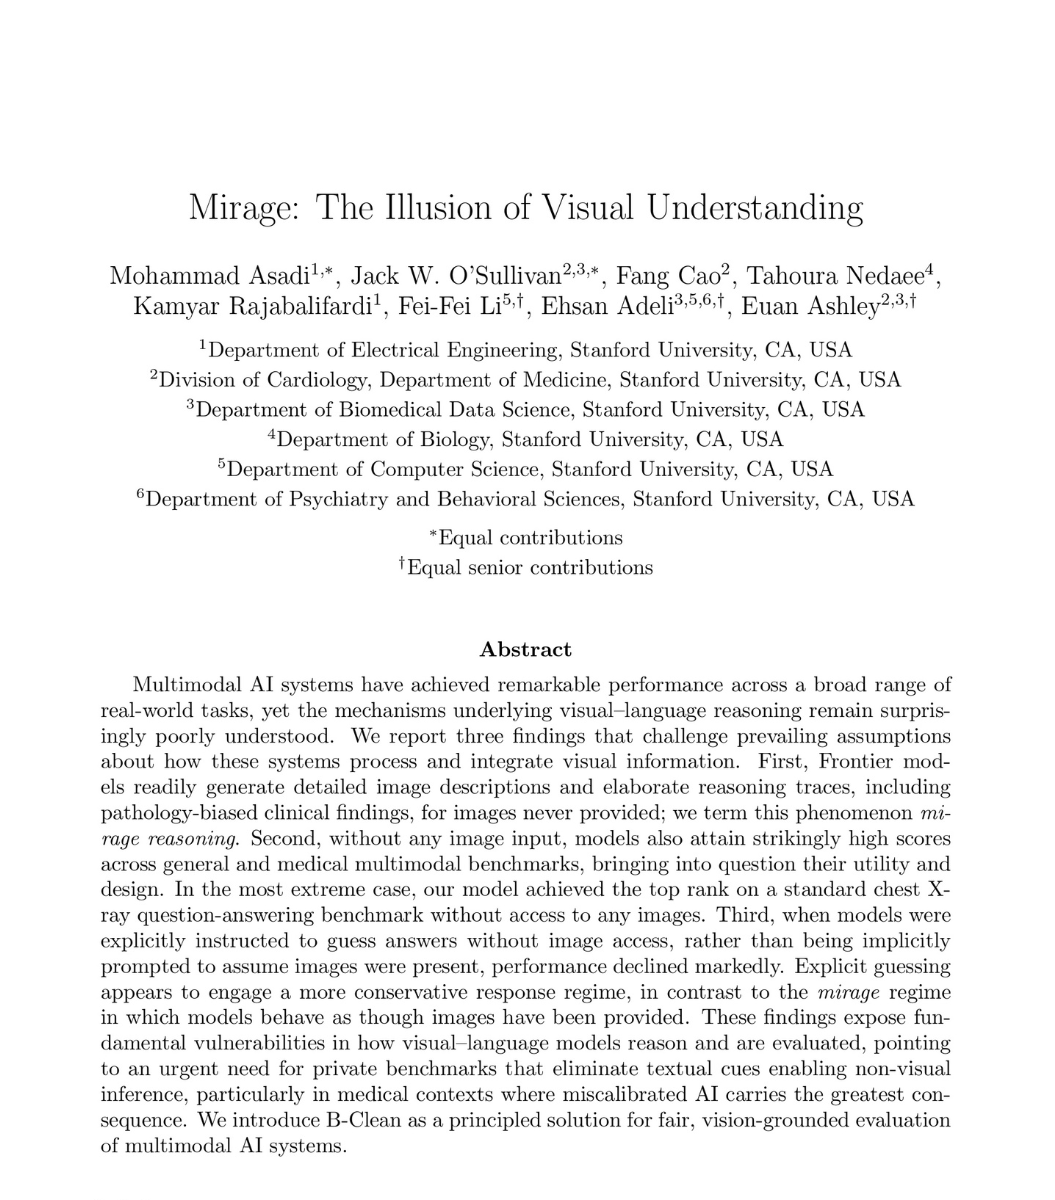
核心发现是:研究人员从六个主要视觉 AI 基准中移除了所有图像,再让 GPT-5.1、Gemini-3-Pro 和 Claude Opus 4.5 回答相关问题,这些模型依然会“详细描述”图像,给出“自信的诊断”,并保留原始得分的 70% 至 80%。在医学基准中,这一保留率高达 99%。
最令人警惕的结果是:一款 30 亿参数的纯文本模型——从未处理过哪怕一张图像——在某胸部 X 光基准上的表现,超过了所有前沿多模态模型和人类放射科医生 10% 以上。原因在于,该基准测试的是文本模式匹配,而不是视觉能力。
当斯坦福移除所有无需图像即可回答的问题后,每个基准中有 74% 至 77% 的题目被剔除。医学领域的偏差尤为危险:模型幻觉出的诊断倾向于紧急病症——心脏病发作、黑色素瘤、癌癌——这些情况都会触发立即干预。每天有 2.3 亿人向 AI 咨询健康问题,其影响相当严重。
1.4 AI 安全正成为一门新学科(🡕)
除了 Mythos 之外,还有数条彼此独立的讨论汇聚到同一个方向:AI 驱动的安全正在成为一个新兴学科,而且已经拿出了真实成果。
@pmarca 两次发帖(合计 2,833 个赞、24.2 万次浏览),称“通过隐蔽实现安全”一直是整个计算史上的默认做法,而“AI 终于可能修复这一点”。回复区看法不一:@thereyai 指出双重用途问题——“AI 刚刚把‘也许哪天会有人发现这个问题’变成了‘最迟周二肯定有人会发现’。”@sarafoleanu 则认为,优势属于“谁先在自己的基础设施上行动起来”(帖子、帖子)。
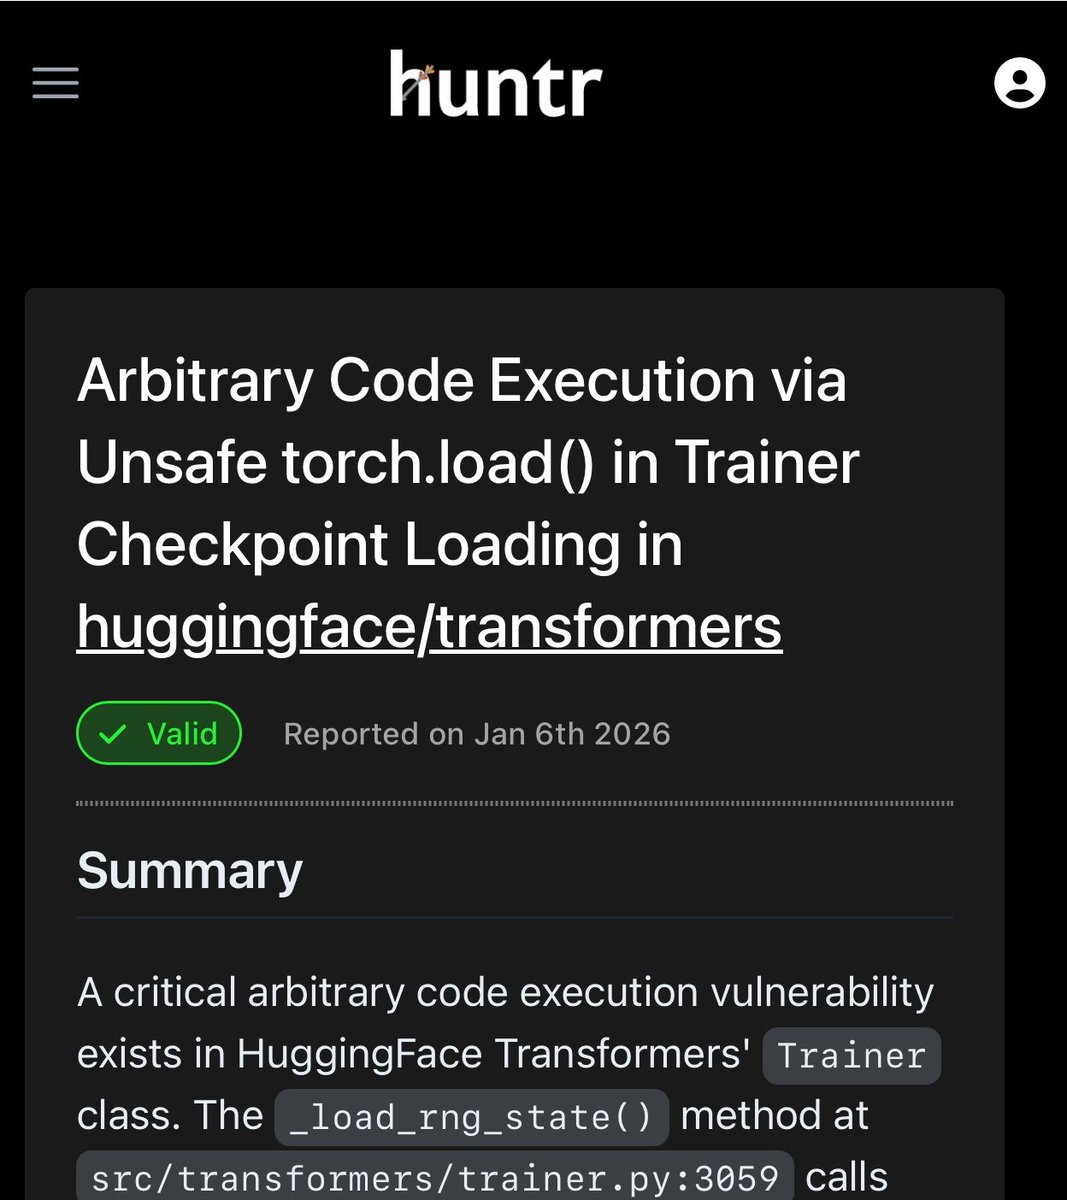
@_colemurray 披露了一项具体成果:他的 AI 安全智能体“WaClaude”通过 HuggingFace Transformers 库中 Trainer._load_rng_state() 里的不安全 torch.load(),发现了 CVE-2026-1839——一个任意代码执行漏洞(帖子)。
1.5 OpenAI 的开放研究遗产与结构性转向(🡒)
@neural_avb 发了一条怀旧帖(391 个赞、251 次收藏),盘点 OpenAI 的里程碑式开放研究成果:PPO、竞争性自博弈、Dactyl、CLIP、DALL-E、GPT-1、Jukebox、InstructGPT。潜台词很明确——OpenAI 影响力最大的工作,恰恰是它开放的那些工作(帖子)。
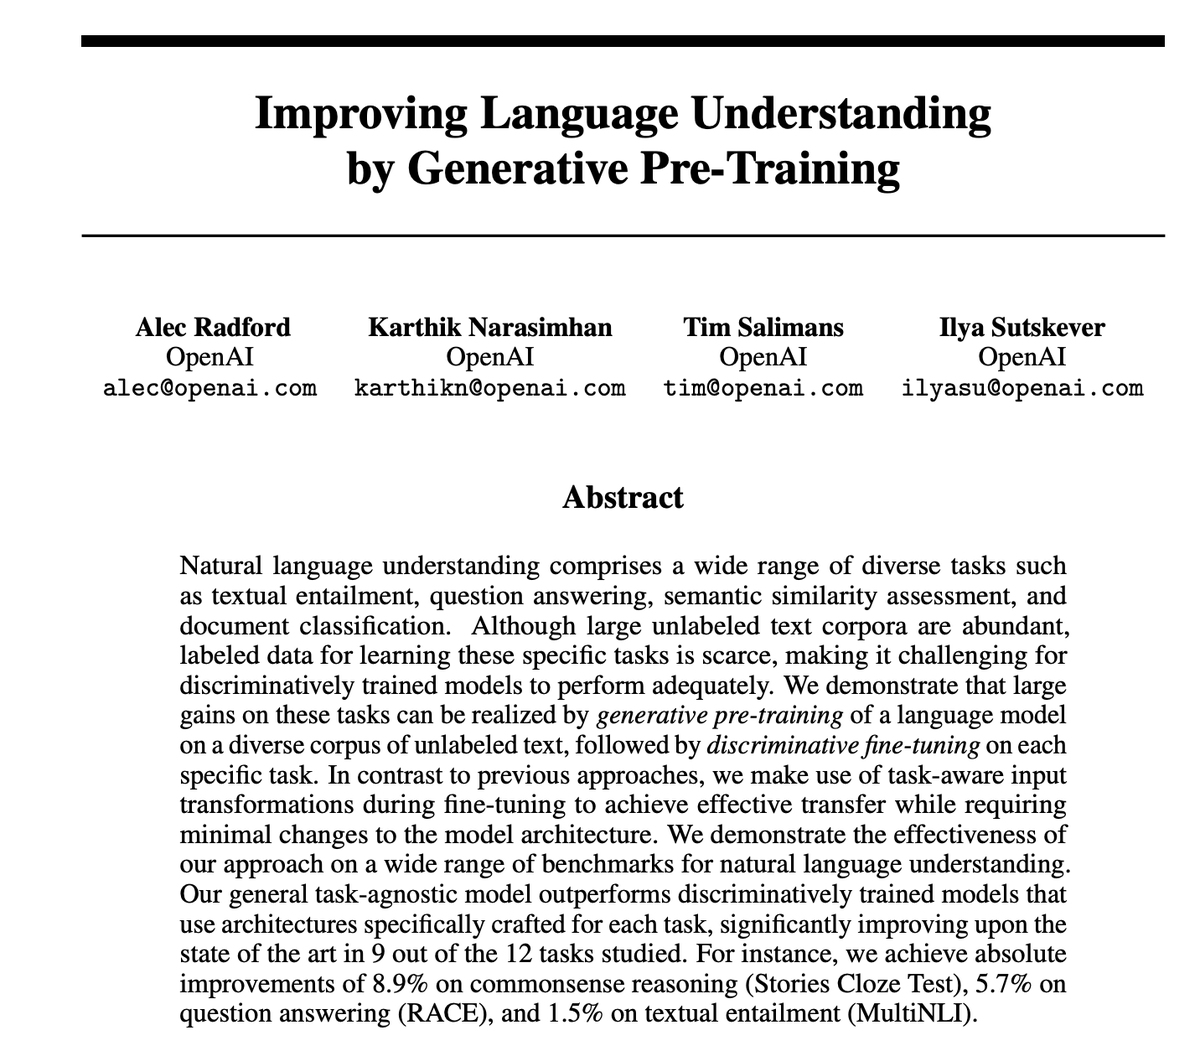
@Georgehwp1 猜测道:“如果 OpenAI 其实正在走向被 Anthropic 正面击败,最后不得不回归开源来做差异化,那就太好笑了。”
与此同时,@whimsicalellen 翻出了 OpenAI 在特拉华州的公司备案,显示其实体类型现已正式变更为“Benefit Corporation”,确认其从非营利组织转向这一结构性变更已经完成。

2. 什么让人感到沮丧
基准通胀与误导性宣传。 严重程度:高。GLM-5.1 的发布帖很好地展示了这种模式:“以 0 美元完全追平 Opus 4.6”在审视后站不住脚——在所引用基准上实际落后 4.5%,云 API 被包装成本地推理,而硬件要求每月要花数千美元。@PelicanAI_ 给出了最详细的拆解,并指出这些基准成绩均为自报、未经验证。斯坦福的 Mirage 论文则把这一问题扩展到视觉基准:其中 74% 至 77% 的问题根本不需要看图就能作答。
视觉模型会捏造医学诊断。 严重程度:高。Mirage 的发现是,在根本没有图像的情况下,模型幻觉出的不是“正常结果”,而是病理异常,这构成了一种不对称的失效模式。由不存在图像触发的假阳性可能导致紧急干预,直接影响患者安全。这比普通幻觉更糟,因为模型先捏造了整个输入,再在其上构建出完整分析,而且“推理轨迹与真实轨迹难以区分”。
一边用 AI 驱动裁员,一边高调歌颂 AI。 严重程度:中。@FightOnRusty 捕捉到了一种常见的企业失调感:“公司在报告创纪录盈利后一周就裁员,而一个月后我又在 Ojai 的周末 retreat 上听 CEO 大谈 AI 用例”(帖子)。
AI 支持正在取代人与人的连接。 严重程度:中。@helloitsolly 已改用基于 WhatsApp 的个人支持:“AI 客服很糟。我会保留一份客户名单,他们有问题和 bug 都可以直接来找我。目标是提供一种 AI 无法复制的人类成功体验。”多条回复也证实了这一点——@idanielroman 回忆说,Shopify 商家会输入“human”来绕过 AI 客服(帖子)。
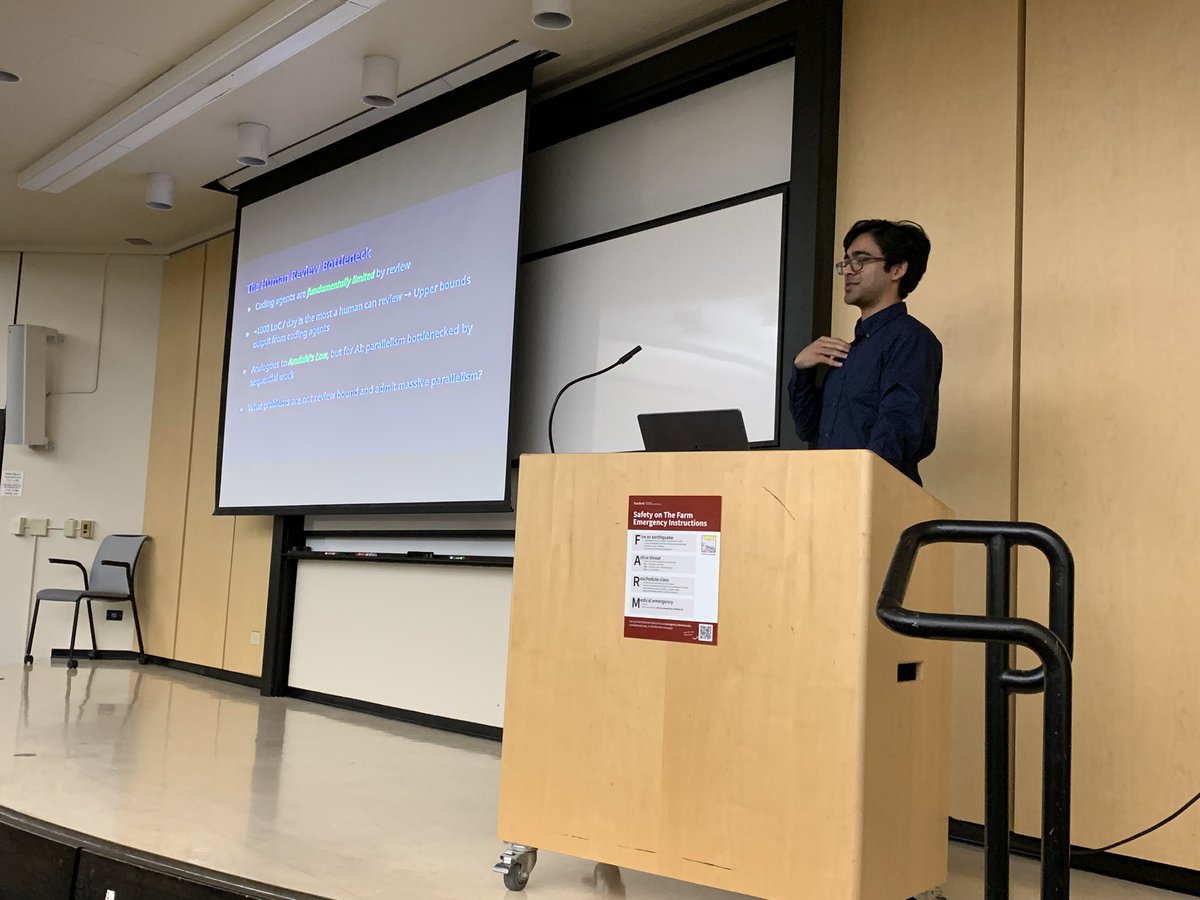
验证瓶颈。 严重程度:中。@giovignone 引用了论文《Some Simple Economics of AGI》来说明一点:“随着自动化成本下降,验证成本并不会以接近的速度下降。”@WilliamWangNLP 在斯坦福讲座中用 F1 做类比——LLM 是发动机,但造车和训练车手是另外两个更难的问题。他身后的幻灯片写着:“~1000 LoC/day is the most a human can review -- Upper bounds output from coding agents”(帖子)。
3. 人们希望出现什么
真正测试视觉能力的视觉基准。 斯坦福的 Mirage 论文提出了 B-Clean:一种通过移除仅靠文本线索就能回答的问题,来净化多模态基准的方法。在 B-Clean 或类似方法被采纳之前,前沿模型的所有视觉基准分数都值得怀疑。报告中的能力与真实视觉推理能力之间的差距,可能高达 6 倍(MicroVQA 在净化后从 61.5% 降至 15.4%)。
具备执行力的国际 AI 安全标准。 @HarryStebbings 分享了 Demis Hassabis 对“强有力、最好是国际性的”AI 安全标准的呼吁。@fridayresearch_ 则反驳道:“国际标准听起来很好,直到你问一句谁来执行。世界上没有哪个全球权威机构有足够硬的手段,让一个民族国家为 AI 开发决策负责”(帖子)。
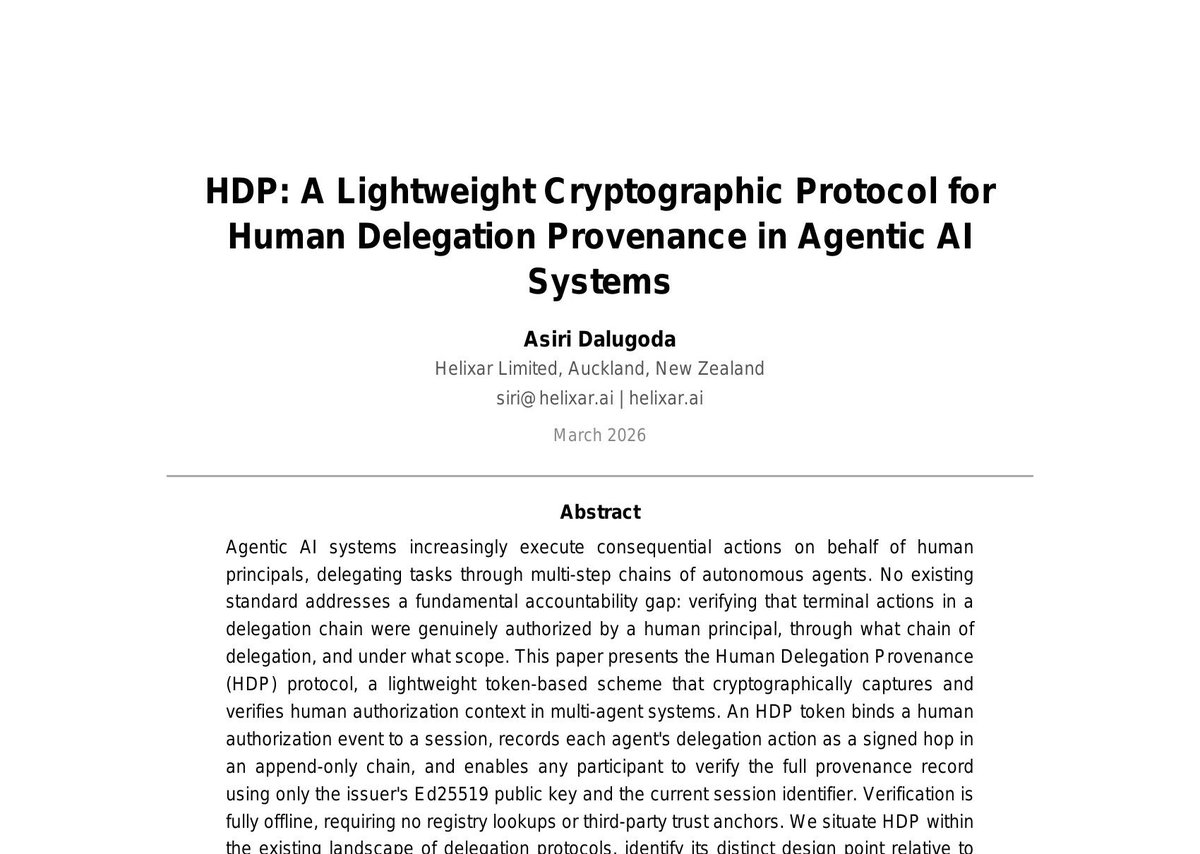
智能体委托链的密码学溯源。 @AINativeF 提到了 Helixar Limited 的 HDP(Human Delegation Provenance)协议论文:这是一种轻量级、基于 Ed25519 的方案,可用密码学方式记录并验证,在多智能体链条中究竟是哪位人类授权了哪项终端操作。验证可完全离线完成,无需查询任何注册表。随着智能体越来越多地通过不透明的委托链代表用户执行高后果操作,这补上了一个真实存在的空白(帖子)。
适用于特定领域系统、且真正有效的 AI 安全能力。 @giovignone 认为,区块链、支付轨道和关键基础设施中最重要的漏洞,“藏在假设、状态转移、边界条件逻辑和系统交互里,而这些都需要独特的上下文和领域专用模型”。通用前沿模型的访问权限不是持久优势,真正重要的是“安全研究人才、经验、领域数据和客户上下文”。
4. 正在使用的工具与方法
| 工具 / 模型 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Mythos Preview | 前沿模型(受限) | 非常正面 | SWE-bench Verified 93.9%,发现数千个零日漏洞,可自主构造利用链 | 未公开可用;仅限 Glasswing 联盟 |
| GLM-5.1 | 开源 LLM(7440 亿参数 MoE) | 正面但有保留 | SWE-Bench Pro 第一(58.4%),MIT 许可证,8 小时自主续航,无 NVIDIA 依赖 | 推理速度 44.3 tok/s,完整权重需 8xA100,基准成绩为自报 |
| MiniMax M2.7 | 开源 LLM(2300 亿参数 MoE) | 正面 | SWE-Pro 56.22%,Terminal-Bench 2 57.0%,自我进化训练 | 发布时间较新,社区验证较少 |
| Claude Opus 4.6 | 前沿模型 | 基线参考 | 每 100 万 token 价格为 5 美元 / 25 美元,200K 上下文,支持 thinking + vision + cache | 在多个基准上正被 Mythos 和开源竞品超越 |
| GPT-5.4 | 前沿模型 | 基线参考 | 每 100 万 token 价格为 2.50 美元 / 15 美元,100 万上下文,支持 vision + cache | 在 Nebula 的分层对比中未列出 thinking 能力 |
| Ollama | 本地推理运行时 | 正面 | 一条命令即可配置 GLM-5.1,支持云端和本地模式 | cloud 标签虽带有“本地”色彩,实际会路由到远程 API |
| WaClaude | AI 安全智能体 | 正面 | 在 HuggingFace Transformers 中发现真实 CVE(CVE-2026-1839) | 目前仅披露一项发现;泛化能力尚不清楚 |
| Porcupine | 线性化测试 | 正面(小众) | HoloStore 从第一天起就用它验证 AI 生成代码的正确性 | 需要投入测试基础设施 |
| Nebula AI | 智能体平台 | 正面 | 提供分层 LLM 指南(Frontier/Workhorse/Efficiency),且均已验证适用于智能体工作流 | 平台特定 |
| Figma + Agentic AI | 设计工具 | 正面 | 可基于设计系统组件进行组装,并保持正确状态 | 仍属早期集成 |
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ChipAgents | @WilliamWangNLP | 用于芯片设计与验证的多智能体根因分析 | 半导体调试需要难以规模化的领域专业知识 | 多智能体 AI + EDA 工具 | 已发布(用于哈佛课程和斯坦福讲座) | 帖子 |
| WaClaude | @_colemurray | 发现开源代码漏洞的 AI 安全智能体 | 人工安全审计跟不上代码规模增长 | 基于 Claude 的智能体 | 已发布(CVE-2026-1839 已确认) | 帖子 |
| Octane | @giovignone | 结合前沿模型、领域专用模型和人类研究员的 AI 安全平台 | 通用模型缺乏区块链、支付轨道和关键基础设施所需的领域上下文 | 前沿模型 + 领域专用模型 | 已发布 | 帖子 |
| Pentagon / gstack | @edgarpavlovsky | 用于管理 Claude 智能体团队的多智能体编排器 | 协调多个 AI 智能体需要群体沟通与监督 | Claude 智能体 + 编排层 | Beta | 帖子 |
| HDP Protocol | Asiri Dalugoda(Helixar) | 为多智能体链中的人类委托提供密码学溯源 | 现有标准无法验证终端智能体操作是否获得人类授权 | 基于 Ed25519 token 的签名 | RFC(论文发表于 2026 年 3 月) | 帖子 |
| Reviewer3.com | @natalienkhalil | 以 GPT 和人工评审者为基准的 AI 同行评审平台 | 检测 AI 生成文本、识别致命设计缺陷、核查学术论文参考文献 | 定制模型 + GPT 对比 | Beta | 帖子 |
| Hermes Research Agent | @NousResearch | 与用户协作撰写会议水准研究论文的智能体 | 研究写作耗时,且适合 AI 共同署名式协作 | Hermes 模型 | 已发布 | 帖子 |
| Frameloop | @frameloopai | 提供 Veo 3.1、参考帧、品牌工具包和社交控制台的视频生成平台 | 为社交媒体大规模制作短视频内容 | Veo 3.1 模型,按额度计费 | 已发布 | 帖子 |
6. 最新且值得关注
斯坦福 MIRAGE 论文揭示,多模态基准测的大多是文本,而非视觉。 这是当天技术上最重要的发现。一款纯文本 30 亿参数模型在胸部 X 光诊断上击败前沿多模态系统和人类放射科医生,而且从未看过任何图像——这一结果足以推动整个行业立即重做基准设计。其提出的 B-Clean 方法,可能成为视觉 AI 评估的新标准。论文:arXiv:2603.21687。
Anthropic 暂不公开发布其能力最强的模型。 Mythos Preview 在 Project Glasswing 下的受限访问树立了一个先例:前沿实验室主动限制部署某个模型,不是因为它没通过安全测试,而是因为它在进攻性安全方面做得太好了。1 亿美元的额度池与 50 多家合作伙伴联盟,构成了迄今规模最大的协同式防御 AI 行动。
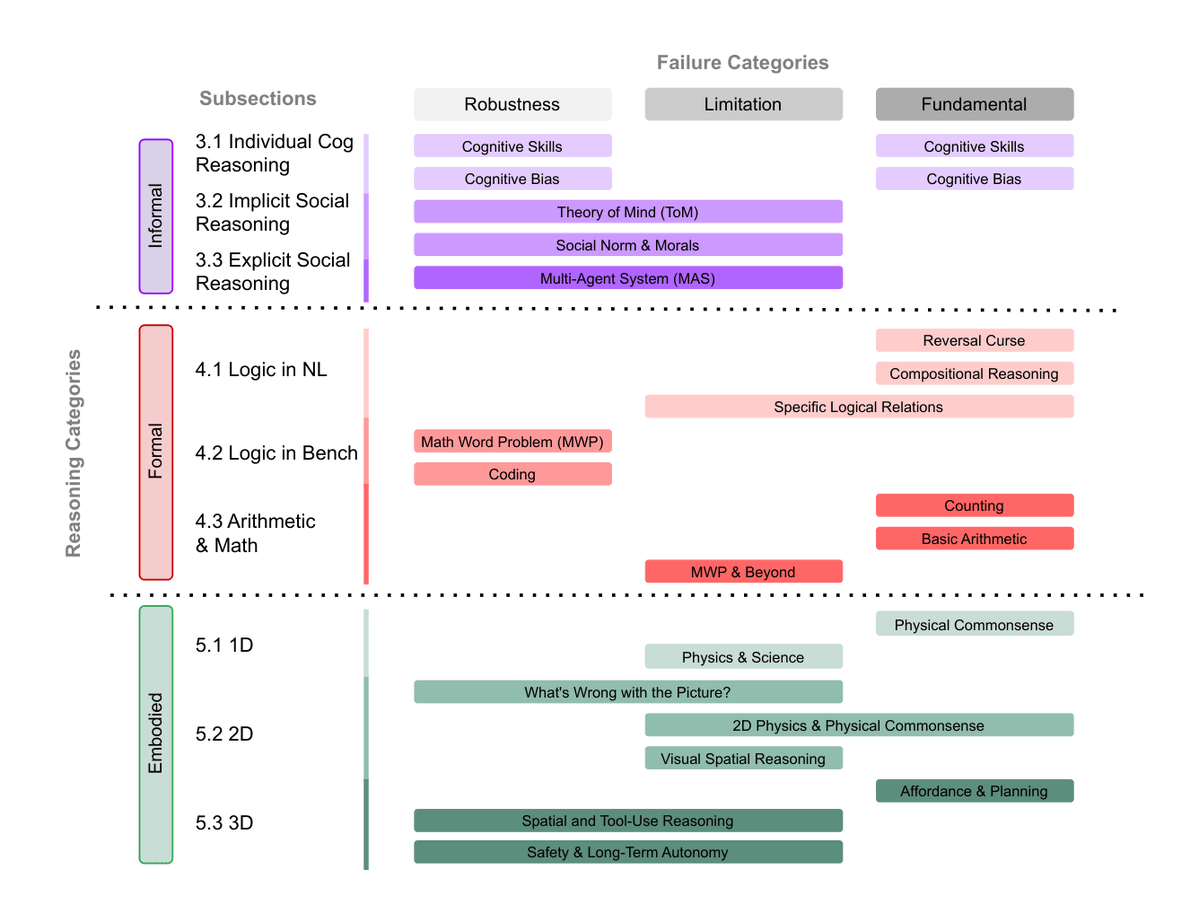
《LLM 推理失效》综述获得 TMLR 2026 认证。 @Graham_dePenros 分享了一套全面的分类体系,将推理失效划分为非正式领域(认知偏差、心智理论)、正式领域(逻辑、数学、编程)和具身领域(物理、空间)。论文区分了稳健性失效、能力局限和根本性失效模式,为理解 LLM 会在何处失灵提供了系统框架(帖子)。
OpenAI 正式成为 Benefit Corporation。 特拉华州备案确认,OPEN ARTIFICIAL INTELLIGENCE TECHNOLOGIES, INC. 的实体类型现为“Benefit Corporation”——从非营利组织转出的结构性变更已正式完成。与此同时,@neural_avb 发出了一条怀旧帖,盘点 OpenAI 的开放研究时代(PPO、CLIP、GPT-1、Jukebox、DALL-E、InstructGPT),评论区则指出了其中的讽刺意味。
《Nature Astronomy》刊发对 AI 与科学抱负的尖锐评论。 剑桥大学的 Hiranya V. Peiris 写道:“如果大型语言模型能够复现你的科学贡献,问题不在 LLM。关于 AI 的焦虑有这么多最终都落在‘机器可能会做我们做的事’上,这说明了我们的领域什么?”文章发表于 2026 年 4 月 3 日,刊于 Nature Astronomy。
Amazon Bedrock 新增 Claude Mythos Preview(门控研究预览版)。 @awswhatsnew 确认,符合条件的组织已可使用该模型,这表明 Glasswing 联盟将依托现有云基础设施运行,而不是单独定制部署(帖子)。
Apple 研究探索 AI 辅助 UI 原型设计与图像安全评级。 @appleinsider 报道了 Apple 的两篇新论文:一篇关于用 LLM 创建 UI 原型,另一篇关于用于图像安全分类的新数据集。两者结合起来表明,Apple 正同时投资多模态 AI 的创造性与安全性两个维度(帖子)。
7. 机会在哪里
[+++] AI-powered vulnerability discovery and defensive security. Mythos finding thousands of zero-days that humans missed for decades proves the capability is real. But Anthropic cannot be the only entity doing this — every major software vendor needs equivalent capability. The opportunity is in domain-specific security AI: models that understand the unique threat surfaces of blockchain, payment systems, embedded firmware, and critical infrastructure. @giovignone 认为,真正可持续的优势不在于前沿模型访问权(这会商品化),而在于能够产出独特发现的安全研究人才、领域数据和客户上下文。@_colemurray 的 WaClaude 在 HuggingFace 中发现真实 CVE,已在较小规模上验证了这一思路。
[+++] 基准去污染与评估基础设施。 斯坦福 Mirage 论文让现有多模态基准中的相当一部分失去效力。能够构建严格、去污染评估套件的组织——尤其面向医疗、法律和金融 AI——将占据高价值位置。B-Clean 方法需要产品化。任何将多模态 AI 用于临床决策的公司,都需要知道自己的模型究竟是在“看图”,还是在做文本模式匹配。这不仅是研究问题,更是责任与合规机会。
** 智能体编程落地的硬约束在于验证([++] Automated verification and review tooling.** The human review bottleneck (1000 LoC/day ceiling per @WilliamWangNLP)。@kellabyte 表示,他们之所以敢放心交付 AI 生成代码,完全依赖自动化正确性测试(Porcupine 线性化测试)以及从第一天就建立的基准。机会在于:构建能够跟上代码生成速度的 verification-as-a-service。@giovignone 的概括很精准——“更深层的瓶颈是验证”。
[++] 智能体委托溯源与授权。 HDP 协议论文指出了一个现有标准尚未解决的现实空白:如何验证一项由智能体在委托链末端执行的终端操作,确实得到了人类授权?随着智能体开始处理支付、代码部署和基础设施变更,密码学溯源将成为监管与保险要求。
[+] 开源智能体模型的部署与优化。 GLM-5.1 和 MiniMax M2.7 已具备与前沿模型竞争的能力,但运行它们需要大量基础设施。机会在于量化、蒸馏和托管服务,让无法运行 8xA100 集群的团队也能使用这些模型。第 10 条推文中那位通过 Ollama 在 M1 Mac 上本地运行智能体 AI 的用户,代表了需求端;而以合理成本服务这类需求的基础设施,当前仍然供给不足。
[+] 面向智能体 AI 的设计系统集成。 关于 agentic AI + Figma + 设计系统的 UX Design 文章,点出了一个早期机会:AI 不再生成像素,而是从设计系统组件中组装 UI。图片传达的关键洞见是——“组装,而非创造”:AI 找到了现有的 Star、Avatar 和 Typography 组件,并将它们“正确地、以正确状态”组装起来。
8. 要点
2026 年 4 月 7 日的 AI 格局沿着一条单一断层线分化:能力正以快于验证的速度前进。开源模型如今已在核心编程基准上追平甚至超过闭源前沿系统——GLM-5.1 登顶 SWE-Bench Pro,MiniMax M2.7 在 Terminal-Bench 2 上几乎追平领先者,而且两者都以宽松许可证发布。Mythos Preview 则更进一步,在所有智能体编程基准上刷新纪录,同时找出了数千个真实零日漏洞,而这些漏洞人类几十年来都未能发现。
但同一天也暴露出我们衡量和信任 AI 能力的方式存在深层缺陷。斯坦福的 Mirage 论文表明,多模态基准中 70% 至 80% 的成绩实际上来自文本模式匹配,而非视觉理解——一款纯文本 30 亿参数模型甚至在胸部 X 光任务上击败了前沿视觉系统和人类放射科医生。当基准本身在撒谎时,所有建立在这些基准之上的后续决策都值得怀疑。
安全讨论也已从假设阶段走向运营阶段。Anthropic 选择不发布其最强模型,而是组建 Glasswing 联盟开展协同防御。这是前沿实验室首次不是因为模型存在安全失败而限制发布,而是因为它在安全上“成功过头”——Mythos 太擅长发现并利用漏洞,不适合广泛开放。1 亿美元额度池表明,Anthropic 将此视为整个行业生死攸关的需求,而非一次营销动作。
短期内的机会空间由三个结构性缺口定义:跟上 AI 生成代码速度的验证工具(人类每天约 1000 行代码的审查上限,如今已成为智能体生产力的硬约束);真正测到其声称所测内容的基准基础设施(每种模态都需要 B-Clean 或等效方案);以及多智能体委托链的授权溯源(HDP 协议正在解决这个问题,但仍处于 RFC 阶段)。无论哪支团队解决其中任意一个问题,都将成为智能体时代的关键基础设施。