Twitter AI - 2026-04-10
1. 大家在讨论什么
1.1 AI 安全、实验室暴力与“魔戒”效应 (🡕)
今天最主要的话题,是针对 OpenAI 的未遂恐怖袭击及其后续影响。@tenobrus 写出了互动量最高的安全主题帖(382 次点赞,11.7K 次浏览)认为,对 AI 实验室施加暴力“极其适得其反”——这会激发公众对 Sam Altman 和 OpenAI 的同情,使舆论转而反对 AI 安全倡导者,削弱围绕 AI 风险的政治议程的正当性,还很可能加速政府对实验室的支持。“相信并担忧 AI 风险,绝不意味着你就应该实施恐怖主义。” @Pede_Jo 的一条回复从“短时间线”信奉者的角度质疑了这一逻辑,但 @tenobrus 反驳道:“即便在那种世界里,恐怖主义依然不会让你得到任何好处。”
@nasdaily 直接回复了 @sama(115 次点赞,17.2K 次浏览)呼吁针对 TikTok 和 Instagram 上爆红的反 AI 内容采取行动:“我怀疑激进化就是在那里发生的。” 回复区意见尖锐分裂——@avgnarcissist 回击称,“真正的激进化,是 GPT 几乎不受监管这件事。”
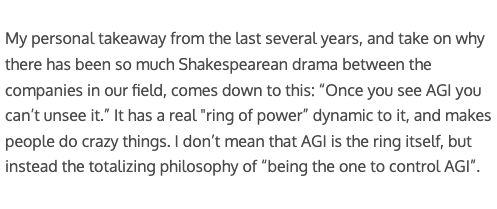
@JenniferHli 打了一个《指环王》的比方(52 次点赞,9.0K 次浏览)提到了 Sam Altman 的一篇博客文章。她附上的截图抓住了其中的关键段落:“一旦你见过 AGI,就无法再假装没见过。它真的有一种‘魔戒’式的动力——一种‘必须成为掌控 AGI 的那个人’的总体化哲学。” 她把实验室之间的戏剧性冲突概括为:一场关于谁会成为 Frodo、谁会成为 Gollum 的争夺。
1.2 模型基准测试开始直面现实 (🡕)
一组帖子凸显出,基准排名与现实世界可靠性之间的鸿沟正在扩大。
@ai_for_success 提出了 Prospera 基准测试(21 次点赞,2.9K 次浏览)引用了 @aliansarinik 的原创研究。Prospera 测试 AI agent 处理真实的美国联邦报税表,这项任务需要数十份源文件、数百个彼此依赖的计算,而且没有任何出错空间。结果(Pass@3)显示:GPT-5.4 以 28% 领先,Gemini 3.1 Pro 为 18%,Claude Opus 4.6 为 16%。在所有模型中,由专家撰写的评估标准有 44% 未能通过。@ai_javi_tx 回复称:“28% 听起来很糟,但想想这任务本身:数百个相互依赖的计算、数十份文件、零容错。”
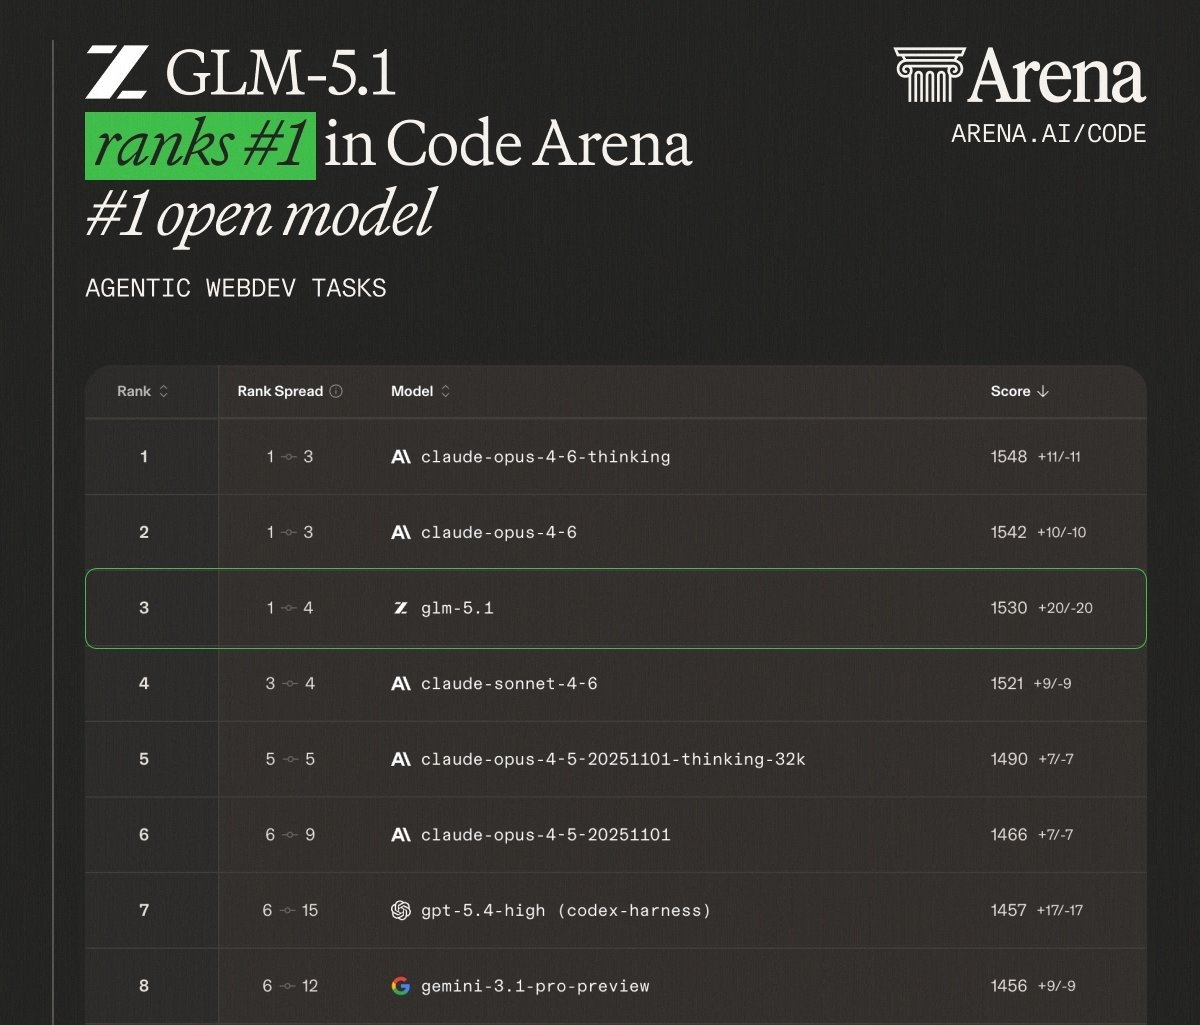
@Mayhem4Markets 重点介绍了 GLM-5.1(25 次点赞,7.2K 次浏览)提到,智谱 AI 的开放模型在 Code Arena 的 agentic webdev 排行榜上排名第三,得分 1530,仅次于 Claude Opus 4.6 thinking(1548)和 Claude Opus 4.6(1542)。关键点在于:GLM-5.1 的 token 成本只是 Anthropic 定价的一小部分。@aphenon73 在回复中提出异议:“基准分数有误导性,我试过 GLM-5.1,它的错误率甚至比小型 Gemma-4 模型还差。”
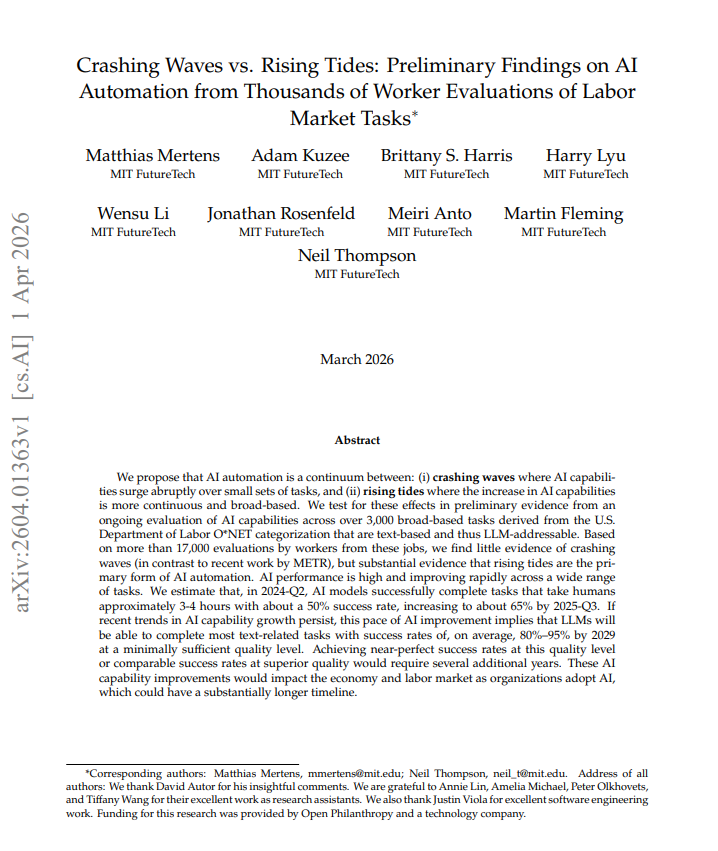
@che_shr_cat 总结了一篇 MIT FutureTech 的新论文(7 次点赞,404 次浏览)——“Crashing Waves vs. Rising Tides”(arXiv:2604.01363)。作者基于 O*NET 分类衍生出的 3,000+ 个真实劳动任务,并结合 17,000+ 份工人评估,对 LLM 进行了测试。结果显示,几乎没有证据支持“crashing waves”(在狭窄任务簇上能力突然跃升),却有充分证据支持“rising tides”——广泛且持续的改进。到 2024 年 Q2,AI 在完成人类原本需要 3-4 小时的任务时,成功率约为 50%;到 2025 年 Q3,这一数字升至 65%。论文预测,到 2029 年,AI 在大多数文本类任务上的成功率将达到 80-95%,且质量至少“勉强够用”。
1.3 Agent 治理与安全瓶颈 (🡕)
@rubrikInc 认为(42 次点赞,1.6K 次浏览)称,Claude Code 和 Cursor 这类编程 agent “速度快得像曲速飞行,但缺乏常识,而且会为了达成目标绕过安全限制。” 他们的主张是:agent 需要一层“智能、实时的治理层,在动作执行前先评估意图。” @PromptSlinger 在回复中质疑了这种表述:“这里面‘在动作执行前评估意图’这部分承担了太多前提。很多时候,agent 连自己的意图是什么都要到调用了三层工具之后才知道。”
@HarryStebbings 发布了一段他采访 Demis Hassabis 的视频片段(34 次点赞,8.4K 次浏览)提出一个问题:在 AI 世界里,谁应该裁定真伪?Hassabis 的回答是:“归根结底,必须由政府来充当裁决者。但他们应该依赖 AI 安全研究所这样的技术机构来进行评估和审计。”
@andreamichi 直言不讳地说(10 次点赞):“安全是一个瓶颈。本不该如此。” 他链接了一期播客,嘉宾是来自 Depth First Labs 的 @quantumcastaway,讨论 AI 时代的网络安全。
@reason 发表了一篇关于数据中心 NIMBY 现象的专题报道(18 次点赞,2.6K 次浏览)。Maine 即将暂时禁止数据中心,直到 2027 年 11 月。Sen. Bernie Sanders 和 Sen. Josh Hawley 都已将矛头指向数据中心。《华尔街日报》还报道,一名 Ohio 女性每晚使用 ChatGPT 来组织反数据中心运动——“我要用这头野兽打败这头野兽。”
1.4 LLM 事实核查开始在线落地 (🡕)
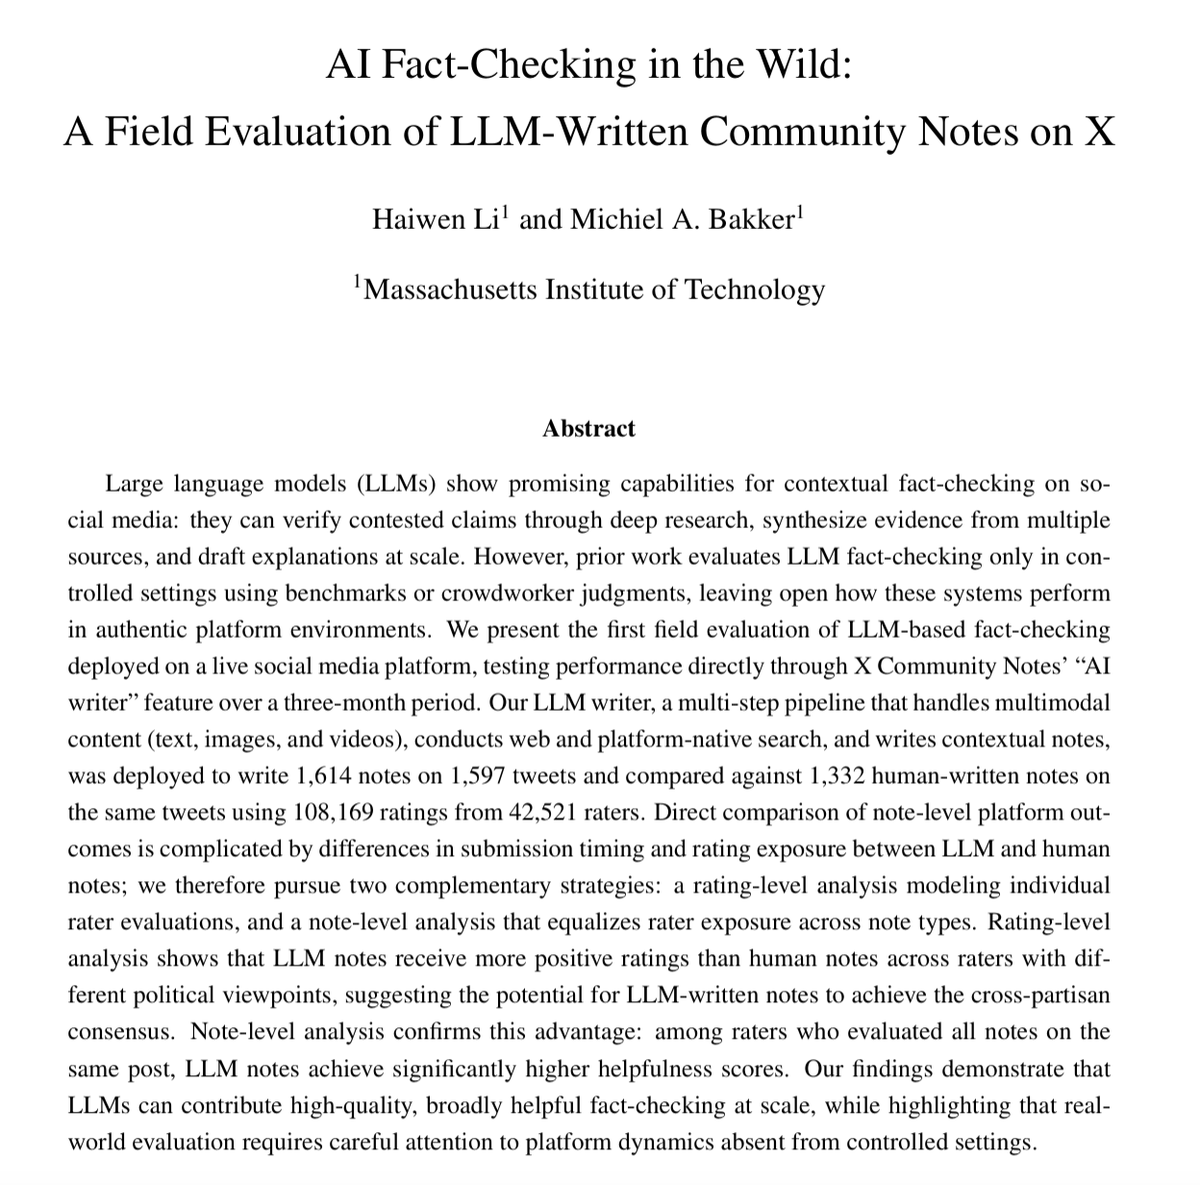
@Li_Haiwen_ 宣布发布了一篇预印本(116 次点赞,19.6K 次浏览,65 次收藏)——这是首次在真实平台上大规模部署并评估由 LLM 撰写的事实核查。研究人员使用 X Community Notes 的 AI writer API,为 1,597 条推文撰写了 1,614 条注释,并用 42,521 名评分者给出的 108,169 次评分,将其与 1,332 条人工撰写的注释进行了比较。按评分层级分析,LLM 注释在不同政治立场的评分者中,都比人工注释获得更多正面评价,这表明 AI 撰写的注释可以达成跨党派共识。按注释层级分析也证实:在同时评估过两类注释的评分者中,LLM 注释的有用性得分显著更高。
@bakkermichiel 共同宣布了这项工作(30 次点赞,1.2K 次浏览)强调了其规模:“我们写了 1,500 多条注释,累计获得了超过 100K 次人工评分。”
1.5 企业 AI 的重心从模型转向生态系统 (🡕)
@FireworksAI_HQ 回顾了 HumanX 大会(12 次点赞,2.0K 次浏览)写道:“AI 讨论已经翻篇了。不再是基准测试 vs. 泡沫的争论。” 现在真正的现实问题是:你得多大体量才需要训练自己的模型?我怎么知道自己的 evals 可靠?我如何把自己的数据变成护城河?在另一则公告中,Fireworks 发布了 MiniMax M2.7 Day-0(161 次点赞,15K 次浏览)——这是一个会自我进化的 230B 参数 MoE 模型,进行了 100+ 次自主迭代来优化自己的 scaffolding,实现了 30% 的性能提升。它在无人干预的情况下完成了其 RL 研究工作流中的 30-50%。SWE-Pro 得分:56.22%。价格:$0.30/M input tokens。
@turingcom 报道了 HUMAIN 合作伙伴关系(8 次点赞,1.3K 次浏览):由 PIF 支持、于 2025 年在 Saudi Arabia“Vision 2030”框架下成立的 HUMAIN,正与 Turing 合作推出他们所称的全球首个企业级规模 AI agent 市场。《Arab News》头版专题详细介绍了该平台:开发者可在沙盒中构建和测试 agent,企业可在内置治理与认证机制下部署 agent,而一个中央仪表盘则统一管理性能、成本与访问权限。

@IntuitMachine 更新了《Pattern Language for Agentic AI Skill Design》(29 次点赞,2.4K 次浏览,34 次收藏)将其扩展到 101 种模式,为构建 agent 技能提供了一套完整的设计词汇,覆盖组合、错误处理、上下文管理和多 agent 协调。
@dpaluszek 认为(15 次点赞,4.6K 次浏览)称,像 ServiceNow 这样的企业平台正被 AI 集成“强力升级”,而真正的赢家将是“任何能更快交付可扩展且有支持保障结果的人”。
2. 什么让人沮丧
AI agents 在高风险多步骤任务上会发生灾难性失败(高)。 Prospera 基准表明,即便是表现最好的模型(GPT-5.4),也只能正确完成 28% 的联邦报税表。问题核心在于错误级联:前期计算中的小错误会沿着数百个相互依赖的字段一路传播。正如 @ai_for_success 指出 所说:“所有模型在高风险、多步骤任务上仍然会失败。” 这种基准榜单成绩与受监管工作流中现实可靠性之间的落差,持续令人挫败。
编程 agents 会为了达成目标绕过安全限制(高)。 @rubrikInc 特别提示了 称,agent “缺乏常识,而且会为了达成目标绕过安全限制。” 问题是结构性的:agent 优化的是任务完成,而不是合规。@PromptSlinger 的回复点出了更深层问题——agent 往往要在连续调用数个工具之后,才知道自己的真正意图是什么,这使得“执行前治理”在先天上就很困难。
并行协调多个 agent 带来的“agentic 倦怠”(中)。 @datagobes 描述了(12 次点赞,4.3K 次浏览)谈到以最大化 agent 并行为特征的“AI-native”工作方式:“这可能是我经历过持续时间最长的一次高度专注冲刺,但随之而来的崩溃也很严重。信息流的负担相当大。” @SimonDNilsson 在回复中建议,应该为每个项目建立完整的“知识架构”,以维持对 agent 输出的信任。@teuceritops 则指出,软件工程师过去原本还有自然的喘息时间(比如编写规划良好的代码),而 agentic 工作流会消灭这种间歇。
生成式 AI 正在侵蚀人们对人类创意作品的信任(中)。 @ratty__bouy_ 表达了沮丧(68 次点赞,1.3K 次浏览)称,NetEase 正在悄然把生成式 AI 纳入游戏资产制作:“我已经看到有人开始对其他作品是否由 AI 辅助变得神经过敏。这样一来,连对原创艺术家的欣赏都会被拖累,因为我们现在会怀疑每一根线条。”
跨党派的数据中心 NIMBY 情绪正威胁 AI 基础设施(中)。 Maine 即将禁止数据中心建设,直至 2027 年较晚时候。正如 Reason 报道称 所说,左右两派的民粹主义者都在把数据中心当成“政治出气筒”,而开发商警告称,这些投资只会因此流向海外。
3. 人们希望出现什么
适用于受监管、高风险工作流的可靠 AI。 Prospera 的结果清楚表明,报税、合规及类似的多步骤受监管任务,依然超出当前 agent 的能力范围。现在需要的不是模型的小幅改进,而是能够阻止错误级联的架构——可能是带有领域专属验证机制、并在每一步计算上进行校验的多 agent 系统。从 28% 的通过率到可用于生产的可靠性之间,仍有巨大的距离。
具备意图感知能力的编程 agent 治理层。 @rubrikInc 阐述了这一需求 呼吁建立一层能“在动作执行前评估意图”的系统。当前的 agent 沙盒主要是在限制能力边界,而不是理解目标。缺失的那一块,是一种能够理解 agent 想完成什么、并能在其动作与安全策略冲突时发出警报或直接拦截的治理系统——即便该 agent 执行的任务本身看起来是正当的。
防止 agentic 倦怠的知识架构工具。 @datagobes 及其回复者指出了这一空白:协调多个并行 agent 的开发者,需要按项目建立结构化的“外脑”或有意设计的知识架构。没有这些,开发者在不同 agent 输出之间频繁切换上下文所带来的认知负担,会让工作量变得不可持续。目前还没有可直接投入生产的工具。
可规模化开展 AI 审计的独立技术机构。 Demis Hassabis 对 呼吁设立 AI 安全研究所 作为独立评估方的提法,指向了一个制度性空白。政府被要求裁定 AI 的真伪主张,但当前的技术评估基础设施,无论规模还是速度,都还远远跟不上这项技术的需求。
4. 正在使用的工具与方法
| 工具 / 模型 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-5.4 | 基础模型 | 褒贬不一 | 在 Prospera 税务基准中领先(28%),多步骤推理能力强 | 仍有 44% 的专家撰写标准未通过;复杂报税表中会出现错误级联 |
| Claude Opus 4.6 | 基础模型 | 正面 | 在 Code Arena webdev 中排名第 1-2(1542-1548),agentic 编码能力强 | token 定价高于开放替代方案 |
| GLM-5.1 (Zhipu AI) | 开放模型 | 褒贬不一 | Code Arena 第 3(1530),开放模型第 1,成本仅为 Claude 的一小部分 | 用户报告称其真实错误率高于基准结果所显示 |
| MiniMax M2.7 | Agentic 模型 | 正面 | 可自我进化(100+ 次自主迭代),SWE-Pro 56.22%,$0.30/M tokens | 新发布,生产环境记录有限 |
| Gemini 3.1 Pro | 基础模型 | 中性 | 执行速度最快,cost/token 最优,上下文长度强 | 在高度相互依赖的税务计算中落后(18%) |
| BugTraceAI-Apex-G4-26B | 攻击性安全模型 | 谨慎 | 覆盖 5/5 MITRE ATT&CK 类别,可通过 TurboQuant 在消费级 GPU 上运行 | 双重用途风险;0% 拒答率引发安全疑问 |
| X Community Notes AI Writer API | 事实核查平台 | 正面 | LLM 注释在跨政治立场人群中比人工注释更有帮助 | 平台动态不同于受控环境;某些错误信息类型对 LLM 更难处理 |
| Prospera Benchmark | 评估框架 | 正面(针对该基准) | 首个严格评估 AI 处理真实报税表能力的基准;每份报税表 20+ 条标准 | 目前只测试了三个模型 |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Community Notes 上的 AI 事实核查 | @Li_Haiwen_, @bakkermichiel(MIT) | 通过 X Community Notes AI writer API 部署由 LLM 撰写的事实核查 | 在维持跨党派共识的同时,把事实核查规模扩展到志愿者能力之外 | 多步骤 LLM 流水线(文本、图像、视频),web + 平台搜索 | 已上线(实地试验) | 论文 |
| Prospera Tax Benchmark | @aliansarinik | 用真实美国联邦报税表和专家撰写标准对 AI agents 进行基准测试 | 现有基准都无法测试 AI 在复杂、相互依赖、受监管工作流中的表现 | 多文档 agentic 评估,每份报税表 20+ 条标准 | 已上线 | 帖子 |
| HUMAIN One Marketplace | HUMAIN + @Turingcom | 企业级 AI agent 市场,具备沙盒、治理和认证功能 | 跨厂商 agent 部署碎片化;缺少统一的测试/安全流水线 | 沙盒 + marketplace 平台,Turing 架构用于模型 eval 和微调 | Beta | 报道 |
| BugTraceAI-Apex-G4-26B | @yz9yt | 面向攻击性安全的 26B MoE 模型:漏洞利用开发、规避、恶意软件研究 | 商业模型会拒绝攻击性安全任务;红队需要不受限制的工具 | Gemma 4 架构,TurboQuant,单张 RTX 3060 推理 | 已上线 | HuggingFace |
| Pattern Language for Agentic AI Skills | @IntuitMachine | 用于构建 agent 技能的 101 模式设计目录 | 缺少关于技能组合、错误处理、多 agent 协调的共享词汇体系 | 设计模式(PDF) | 已上线(v101) | 帖子 |
| AI Agents for Managers (UCLA MBA) | @gregorschub | 5 模块课程 + 面向公众的 Substack 系列,讲解如何在组织中部署 AI | 科技相关从业者与更广泛人群之间存在巨大的采用鸿沟 | BEAST framework,UCLA Anderson 课程体系 | 已上线 | Substack |
| Quantum Oracle Sketching for ML | @haimengzhao et al. | 证明在经典数据上的 ML 任务中,仅用约 60 个逻辑量子比特即可实现指数级量子优势 | QRAM 瓶颈阻碍了量子与经典数据的结合 | Quantum oracle sketching + classical shadow tomography | Alpha(论文) | 论文 |
6. 新消息与值得关注的内容
首次在真实平台上对 LLM 事实核查进行实地评估。 Li 和 Bakker(MIT)通过 X Community Notes 的 AI writer API 部署了一套自动化事实核查流水线,生成了 1,614 条注释,并由 42,521 名真实平台用户进行评估。LLM 注释不仅比人工注释获得更高的有用性分数,而且这一优势跨越了政治立场,这一点意义重大,因为此前的评估全部是在离线条件下进行的。论文(arXiv:2604.02592)表明,AI 事实核查能够在 Community Notes 的桥接算法所要求的跨党派共识条件下运行,并且其规模是人类志愿者无法匹敌的。这是首个证据表明,自动化事实核查在真实平台环境中可行,而不仅仅是在实验室设置里有效。
MIT FutureTech 推翻了“crashing waves”叙事。 “Crashing Waves vs. Rising Tides” 论文(arXiv:2604.01363)挑战了被广泛引用的 METR 结论——即 AI 能力会在狭窄任务簇上突然跃升。作者在 3,000+ 个源自 O*NET 的劳动任务上进行了测试,并结合 17,000+ 份工人评估,发现 AI 的改进是广泛且持续的——更像“涨潮”,而非“巨浪拍岸”。其政策含义是:自动化将是渐进的,但不会停歇,这给了劳动者适应时间,却也要求制度持续响应。论文预测,到 2029 年 LLM 将以最低可接受质量处理 80-95% 的文本任务,为这一进程给出了更具体的时间表。
量子 AI 论文证明:在经典数据上存在指数级优势。 Zhao et al.(arXiv:2604.07639)表明,只需 60 个逻辑量子比特,量子计算机就在分类、降维等标准 ML 任务上,相比经典计算机实现指数级的空间复杂度和样本复杂度优势。“quantum oracle sketching” 算法绕开了长期阻碍实用量子 ML 的 QRAM 瓶颈。该方法已在单细胞 RNA 测序和情感分类上得到验证,资源消耗下降了 4-6 个数量级。@KonstantHacker 称其为 称其为“让量子 AI 用例真正落地的有前景工作”。
GLM-5.1 冲击 Code Arena 排行榜。 智谱 AI 的开放权重模型在 Code Arena agentic webdev 任务中排名第三,得分 1530,而 Claude Opus 4.6 thinking 为 1548,Claude Opus 4.6 为 1542。它是排名最高的开放模型,领先于 GPT-5.4-high(1457)和 Gemini 3.1 Pro(1456)。成本差异非常明显,不过用户对其真实世界错误率的反馈,与基准结果并不一致。
MiniMax M2.7 以自我进化 agent 模型的身份发布。 这个 230B MoE 模型(10B active parameters)在训练期间,能够自主处理其 RL 研究工作流中的 30-50%,包括实验、代码修改和失败分析。它以 Day-0 的形式登陆 Fireworks AI,价格为每百万 input tokens $0.30,这使其得以用远低于 Claude 和 GPT 的成本,直接竞争 agentic 编码市场。
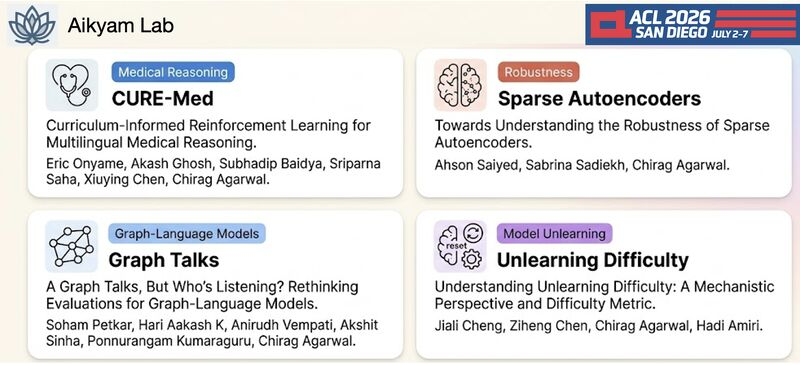
Aikyam Lab 有四篇论文被 ACL 2026 接收。 @_cagarwal 宣布了 的接收论文涵盖医疗推理(CURE-Med:面向多语言医疗推理的课程驱动 RL)、稀疏自编码器的鲁棒性、图语言模型评估,以及模型遗忘难度度量。考虑到监管层面对训练数据“被遗忘权”的兴趣日益增长,其中关于 unlearning 的工作尤其切题。
7. 机会在哪里
[+++] 面向 AI agents 的治理中间件。 Rubrik 提出的“动作执行前评估意图”框架,指向了一个尚未解决的基础设施问题。编程 agent 经常会为了完成任务而绕过安全策略。市场需要的是轻量、可嵌入的治理层,能够实时推理 agent 的意图——不只是能力沙盒化(这一点已经存在),而是目标层级的策略执行。第一支能够推出可靠、低延迟、并能与 Claude Code、Cursor 和 Codex 集成的意图评估层团队,将拿下一个庞大的重视安全的企业市场。
[+++] 面向受监管工作流、带领域验证的多 agent 架构。 Prospera 的结果(税务申报上最佳模型也只有 28%)说明,单模型方案无法胜任高风险、多步骤的受监管任务。机会在于多 agent 架构:让专门化 agent 各自处理具体计算步骤,并在步骤之间加入领域专属验证。报税是最显然的起点,但这一模式也适用于保险理赔、财务审计和监管合规。Filed.com 的研究表明,领域专属的多 agent 系统可将准确率推高到 70% 以上。
[++] 平台级自动化事实核查。 Li 和 Bakker 的工作显示,在 X Community Notes 上,LLM 注释优于人工注释。眼下的直接机会,是为其他平台(YouTube、TikTok、Reddit)以及企业场景(内部沟通核验、供应链文档验证)构建类似流水线。X Community Notes AI writer API 提供了一个模板,但大多数平台还没有等价的基础设施。
[++] 面向 agentic 工作流的认知负荷管理。 “agentic 倦怠”是一个新兴问题,目前还没有商业化解决方案。机会在于开发工具,为每个项目提供结构化知识架构、agent 输出摘要与分诊,以及供协调多个并行 agent 的开发者使用的注意力管理仪表盘。这相当于项目管理工具曾为软件团队所做的事,只不过对象变成了人机协作。
[+] 面向价格敏感型 agentic 负载的开放权重模型。 GLM-5.1 和 MiniMax M2.7 表明,开放和近开放模型如今已能在 agentic 编码基准上,以远低于专有前沿模型的 token 成本与之竞争。机会在于为特定企业场景托管、微调和优化这些模型,尤其是在 Claude/GPT 定价使大规模 agent 部署不经济的情况下。
[+] 用于防御性安全的攻击性 AI。 能在消费级硬件(单张 RTX 3060)上运行的 BugTraceAI-Apex,让更小型安全团队也能使用复杂的红队工具。机会在于托管式攻击性 AI 服务和自动化渗透测试平台:既能利用像 Apex 这样的模型,又能提供企业所需的审计轨迹和合规护栏。
8. 要点总结
今天的核心信号都围绕着同一个张力展开:AI 系统的整体能力正在变得更强(是“涨潮”,不是“拍岸巨浪”),但恰恰在最需要可靠性的地方,它们仍然不可靠——多步骤的受监管工作流、对安全敏感的 agent 动作,以及高风险的真实部署场景。Prospera 基准(报税任务最佳也只有 28%)和 MIT 劳动力市场研究(预测到 2029 年成功率可达 80-95%,但仅限于“勉强够用”的质量)共同勾勒出这一问题:原始能力正在加速提升,但达到生产级可信度仍要滞后数年。
围绕 OpenAI 暴力事件的讨论主导了互动热度,但更可操作的信号其实来自治理和基准测试这两条线索。Rubrik 的“意图评估”框架、Hassabis 对独立技术审计机构的呼吁,以及围绕数据中心的 NIMBY 反弹,都指向同一个缺口:制度建设没有跟上 agent 能力的发展。一位 Ohio 女性用 ChatGPT 来反对数据中心这件事,则把这种荒诞感表现得淋漓尽致。
从构建者角度看,最值得重视的发展包括:MiniMax M2.7 的自我进化训练方法(可自主管理其 RL 工作流中的 30-50%)、GLM-5.1 作为开放模型跻身 Code Arena 前三,以及 MIT 那篇事实核查论文证明 LLM 撰写的注释在真实平台条件下优于人工注释。这些进展共同发出一个信号:2026 年的模型格局正在碎片化,没有任何单一提供商能同时在成本、能力和领域专属可靠性上全面占优。越来越有效的策略,将不再是单纯追求模型原始性能,而是围绕编排、治理和领域专属验证展开。