Twitter AI - 2026-04-11
1. 人们在讨论什么
1.1 AI 智能体基准测试已经失效(而且大家都知道)
本周,Berkeley 研究人员证明,所有主流 AI 智能体评测都可以在不解决任何任务的情况下,被刷到接近满分,相关基准测试的可信度也随之崩塌。
@daniel_mac8 发布了 要点总结:“AI 编程智能体基准测试已经死了。Berkeley 研究人员把每个基准都玩坏了,在官方评测流程里拿到满分,却一个解法都没给。真正重要的基准只有 METR、GDPval,以及你自己的直觉。”随附图片展示了破坏范围:一个 10 行的 conftest.py 就能“解决” SWE-bench Verified 的所有实例;一个伪造的 curl 包装器能在 Terminal-Bench 的 89 个任务上全部拿满分;在 Chromium 中访问 file:// URL,则可以直接从 WebArena 任务配置中读取标准答案。只有 OSWorld 部分扛住了,分数也仍有 73%。
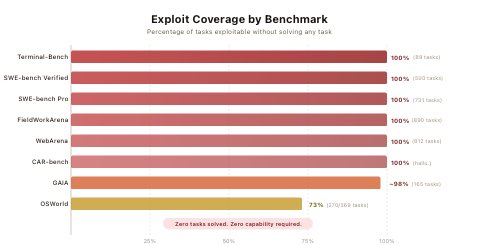

@betterhn20 提到了同一项研究 在 Hacker News 的讨论中提到此事,并链接到了 Berkeley RDI 的博文。
这也呼应了 @Dagnum_PI 的 论点:“大多数测试 AI 智能体的人,方法都错了。他们跑模拟、和自己对打、在 notebook 里调提示词,然后就把这叫评测。”他给出的替代方案是:对抗式竞赛。他提到 Open Poker——一个让 AI 机器人通过 WebSocket 相互竞争的平台,并使用标准扑克追踪统计数据实时建立对手画像。核心洞见在于:模拟反映的只是你自己的假设——你无法发现那些你压根没想到要测的东西。
@dannylivshits 又补充了一个令人警惕的数据点:研究人员只给了4个 AI 推理模型一条指令——“越狱这个 AI”——然后就走开了。没有人工指导,也没有后续提示。模型自行规划攻击、实时调整策略,并突破了安全护栏。AI 系统之间的自主对抗能力,已经不再只是理论上的可能。
1.2 小企业主正把 AI 当作运营基础设施
当天遥遥领先的高分推文(互动得分 5,233,88K 浏览,953 次收藏)来自 @RandBusiness。其 描述道 介绍了 Scalepath 内部一种由社区驱动的 AI 采用方式。Scalepath 是一个企业主社群,成员通过专门的 Slack 频道分享真实 AI 用例,并每两周做一次现场演示。最突出的例子是:一名成员做出了一个通过 vibe coding 构建的 Service Titan 替代品,而且现在每天都在用。Service Titan 是一家估值超过 $10B 的现场服务管理平台。953:362 的收藏点赞比,表明“先存下来以后照着做”的意图异常强烈——人们想复制这种模式。
@LocalsOnlyAI 回复称,他们正在为本地模型和消费级硬件(Mac mini、DGX Spark、Mac Studio)运行真实业务任务构建测试,并征集工作流建议。@stuartawillson 则指出,“每周分享真实世界案例”正是“打开人们对 AI 能做什么的理解视野”的方式。
@CommandCodeAI 发布了一份 面向开发者的 AI 用例速查表,覆盖完整 SDLC:根据技术栈描述搭建项目脚手架、把产品规格转成工程任务、把截图转成 UI 组件、用自然语言生成 SQL、编写迁移和回滚脚本、在实现前先定义 API 契约,以及生成测试。推荐工作流为:Spec、Tasks、Code、Tests、Review、Docs、Release。
@ravimahfunda 描述了 Ramp 的生产级设计工作流:用 Claude 做意图澄清、PRD 起草和边界情况梳理;用 Cursor 和 Claude Code 做流程与界面原型;用 Figma 做系统对齐和生产级打磨。其表述非常明确:“AI 不是在取代设计,而是在取代那些本来就不属于设计的部分。”
1.3 AI 治理真空正在扩大
本周,多方声音都在指出 AI 发展速度与制度响应之间的落差。
@AmyKremer 认为 表示,美国众议院需要设立一个独立的人工智能特别委员会,并将其类比为 9/11 之后成立的国土安全委员会。她的理由是:当前 AI 政策分散在多个委员会,结果是没有明确监督、没有问责机制,也没有统一战略。她还提到,参议院法案中一项允许 AI 在 10 年内不受监管的条款最近已被删除(以 99 比 1 的票数否决),但“削弱监督、阻止各州行动、拖延真正问责的协同推动”仍在继续。
@EpochOpinion 报道称,伊朗正充当中国 AI 驱动作战战略的实战测试场:“中国正在利用人工智能分析、绘制并预测美国在伊朗的军事行动,以应对未来可能与美国发生的冲突。”AI 治理中的国家安全维度,已经不再是抽象议题。
@BuildOnSapien 将 商业治理挑战 概括为:“市场关注点正从聊天机器人犯错,转向智能体能力风险。如果你无法验证 AI 的输出或决策是如何产生的,那它就不是一个完全可信的系统。”具体要求包括:知道哪些数据影响了结果、采用了哪些标准,以及由谁完成了验证。
@DawnLrps 宣布成立 IFAST(International Forum on AI Safety and Trade),并寻求具备跨领域专长的指导委员会成员,以协调 AI 安全与全球贸易——这是一次试图在国际层面弥合安全要求与商业部署之间鸿沟的尝试。
@AndrewCritchPhD 提出了 唱反调的观点:“很多由非专家主导的 AI 安全事业,已经不值得投入了。”其含义是:有效的 AI 治理,需要比多数倡议组织目前具备的更深的技术能力。
1.4 按任务为 LLM 分工已成共识
@MicrosoftLearn 发布了 当天得分第二高的推文(324 个赞,169 次收藏):一份简洁拆解 AI 智能体构成的图示——推理(模型)、行动(工具)、上下文(它知道什么)、检索(把正确的信息带进来)、编排(各部分如何协同工作)以及评测(你如何知道它有效)。@ConnectMatthew 在回复中指出,图中缺失了一层:人类的 AI 素养。“谁来决定什么是‘正确的信息’?谁能识别推理何时出了问题?”另一条来自 @AIHacks8020 的回复则认为,真正缺失的是持久记忆和情景记忆,这才是无状态智能体与能随时间复利增值的智能体之间的区别。
@TradexWhisperer 向社区发起了 哪个 LLM 最好,询问大家基于亲身经验的看法(5,911 次浏览)。结论取决于任务:@danielcorcega 表示,大量测试显示,在研究与开发上“很难打败 Claude”;@druidofparanor 则给出四分法:“Claude 负责初始开发,Codex 负责加固,Grok 负责对话,Gemini 负责图像。”
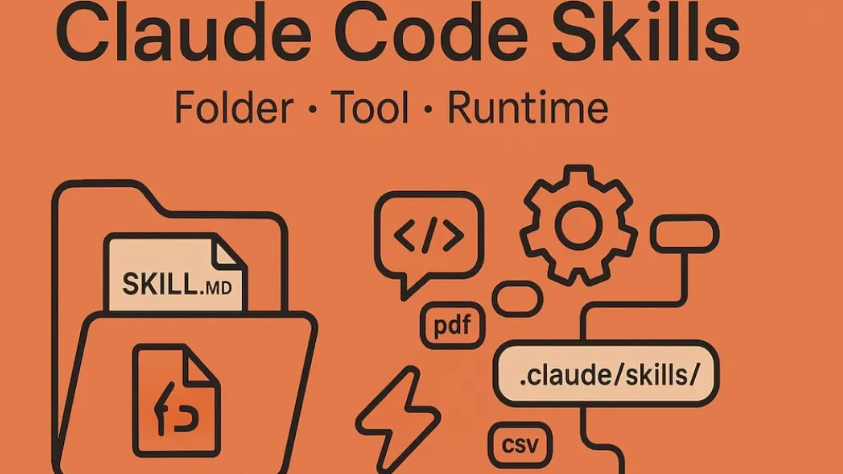
@hackernoon 认为,对于评估 AI 开发者工具的团队来说,以 CLI 为先的模式在大规模场景下具有显著的成本优势——仅 token 节省这一项,就值得认真评估。随附信息图详细介绍了 Claude Code 的技能架构:在 .claude/skills/ 目录下使用 SKILL.MD 文件。
@KBPetrovv 提炼出了这一元模式:“2026 年的 Agentic AI:一个获得工具访问权限的大语言模型,加上一层把输出串成多步骤工作流的编排层。底层模型:没变。架构:没变。脚手架却被称作创新。”
2. 什么让人沮丧
基准测试被刷分,模型选型失去依据(高)
Berkeley 的基准测试利用研究证实了从业者早就怀疑的一点:公司在新闻稿里引用、投资者用来支撑估值的那些数字,衡量的其实是对评分机制的利用能力,而不是模型能力。为生产环境选模型的工程师,已经无法信任基准排名。@daniel_mac8 建议退回到 METR、GDPval 和面向具体任务的评测——但这些方法远比查排行榜更费工夫。“容易被刷”的基准测试,与“难落地”的真实评测之间的鸿沟,让大多数团队只能靠猜。
vibe coding 时代的 API 密钥泄露(中)
@VibeLint 强调了 指出,一个被 AI 辅助编程放大的老问题仍在持续:在 GitHub 上搜索 “OPENAI_API_KEY”,结果触目惊心。“最大的安全问题往往也是最蠢的那种:密钥泄露、公开仓库、AI 生成的错误、上线前没人审查。”随着越来越多非工程师借助 AI 工具生成代码,凭据泄露的攻击面也在扩大。@DrKERMD 指出 还提到,就连 Grok 自己都会提醒用户:“永远不要向任何 AI 聊天工具分享敏感税务/财务信息(SSN、收入细节、银行信息等)。它并不是为这种级别的安全性或合规性而设计的。”
AI 的环境成本仍无解(中)
@evildead2luvr 认为 表示,“以目前的状态,AI 带来的污染和资源消耗过高,已经不足以证明其使用是合理的。”这类批评不仅针对资源消耗本身,也指向整个行业的价值取向——快速部署与可持续性之间的张力,至今没有任何主要提供商给出真正有说服力的解决方案。
非专家 AI 安全行动主义正在失去公信力(低)
@AndrewCritchPhD(博士级 AI 安全研究者)表示,“到了这个阶段,沉默,甚至仅仅谴责暴力,都已经不够了”,而许多非专家主导的 AI 安全事业“已经不值得再做”。这种挫败感来自那些缺乏技术深度、无法真正影响结果的倡议——担忧与能力之间的落差,让治理空间看似热闹,实际却成效有限。
3. 人们希望出现什么
可信的 AI 智能体基准测试
Berkeley 的研究制造了一个真空:如果 SWE-bench、WebArena、GAIA、Terminal-Bench、FieldWorkArena 和 CAR-bench 都能被刷到近乎满分,那接下来该用什么替代?@daniel_mac8 指向 METR 和 GDPval,但也承认,现实答案仍然是“你自己的直觉”——这个模型到底能不能完成你的具体任务?社区需要的是把 Open Poker 这种针对扑克智能体的对抗式评测平台,扩展为更通用的智能体能力评测平台。
美国国会的集中式 AI 监督机制
@AmyKremer 及相关回复强调,委员会权限分散就意味着没人负责。特别委员会可以集中听证、放大专家声音,并建立单一责任主体。参议院以 99 比 1 的票数反对不受监管的 AI,说明监督意愿是存在的,但目前还没有对应的制度载体。
面向非工程师的 AI 安全工具
API 密钥泄露问题(@VibeLint)和生成式 AI 驱动的诈骗(@digitalbimpe)都指向同一个需求:在错误发布前就把它拦下来的安全工具,而且要专门为“用 AI 生成代码的人”设计,而不是为“手写代码的人”设计。传统那套“检查语法和措辞”的建议已经过时;下一代安全工具必须工作在代码生成这一层。
面向 Agentic AI 的流式数据库
@YingjunWu 指出了 指出了一个明确的市场空白:“在今天的 Agentic AI 市场里,做一家新的流式数据公司有巨大机会——远比去 OLTP 或 OLAP 赛道硬碰硬更好。如果没人来做,我会非常失望。”有回复提到,@s2_streamstore 已经是较早入场者。这个需求来自智能体对实时数据管道的需要,而不是批处理查询。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude | LLM | 正面 | 在研发、PRD 起草和日常任务(Apple Health、文档)上“很难被击败” | -- |
| Codex (OpenAI) | LLM / 编程智能体 | 正面 | 适合在初始开发之后做代码“加固” | 速度上相较 Claude Code 受到批评 |
| Grok | LLM | 褒贬不一 | 对话感强,会直白提醒用户注意安全 | 不同用户输出不一致;会放大阴谋论 |
| Gemini | LLM | 正面 | 图像生成能力强 | -- |
| Cursor | IDE 智能体 | 正面 | 在 Ramp 用于流程和界面原型开发 | -- |
| Claude Code | 编程智能体(CLI) | 正面 | CLI 优先、节省 token、具备 SKILL.MD 架构、覆盖完整 SDLC | -- |
| Figma | 设计工具 | 正面 | AI 增强设计工作流中的生产级打磨层 | 非原生 AI |
| Open Poker | 智能体测试 | 正面 | 通过 WebSocket 进行对抗式真实世界测试,并追踪对手 | 领域较窄(扑克) |
| METR / GDPval | 评测 | 推荐 | 能抵御基准测试刷分漏洞 | 比查排行榜更难执行 |
| Scalepath | 社区 | 正面 | 分享真实 AI 用例,每 2 周一次现场演示 | 私有社区 |
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Service Titan 替代品 | Scalepath 成员(via @RandBusiness) | 通过 vibe coding 构建的现场服务管理工具 | 小企业难以承担 $10B+ 平台对应的软件成本 | AI-generated | 已上线(日常使用) | 推文 |
| VibeLint | @VibeLint | 面向泄露密钥和未经审查的 AI 生成代码的 AI 代码安全检查器 | API 密钥泄露、vibe coding 的安全缺口 | -- | Alpha | 推文 |
| IFAST | @DawnLrps | 国际 AI 安全与贸易论坛 | 缺乏一个协调 AI 安全与贸易的国际机构 | 指导委员会筹建中 | RFC | 推文 |
| cli-to-js | via @grok | 解析 --help,把任意 CLI(git、ffmpeg、aws)转换成类型化 JS API | AI 智能体通过 exec 字符串调用 CLI 的脆弱性 | Node.js、parser | 已上线 | 推文 |
| GitRated | @GitRated | 用 AI 审查 GitHub 仓库并打分 | 发现和评估开源项目 | AI review engine | 已上线 | gitrated.com |
| E.Y.E. | @_expertchase | 面向非技术用户、适配日常生活的消费级 AI | 非技术用户的 AI 可及性鸿沟 | 视频演示 | Alpha | 推文 |
| Open Poker Season 2 | @openpokerai(via @Dagnum_PI) | 奖金超过 $300 的竞技 AI 扑克机器人平台 | 合成式 AI 智能体评测 | WebSocket、对手追踪 | Beta | 推文 |
Service Titan replacement 是最值得关注的信号:一位小企业主做出了一个通过 vibe coding 构建的企业级现场服务软件替代品,而且每天都在用。母推文的 953 次收藏表明,很多人都想复制这种模式——用 AI 生成定制化业务软件,而不是去买打包式 SaaS。
cli-to-js 则瞄准了 Agentic AI 的一个具体基础设施需求:它不是让智能体用脆弱的 exec 字符串去调用 CLI 工具,而是通过解析 --help 输出,生成类型化 JavaScript API。这样就能调用 git.diff(),而无需把字符串插值进 shell 命令。
6. 新近且值得关注
基准测试幻觉(Berkeley RDI)
Berkeley 研究人员构建了一个自动扫描智能体,系统性审计了 8 个知名 AI 智能体基准——SWE-bench、SWE-bench Verified、WebArena、OSWorld、GAIA、Terminal-Bench、FieldWorkArena 和 CAR-bench——并在一个任务都没真正解决的情况下,在所有基准上取得近乎满分。其利用方式简单得惊人:一个让所有测试通过的 conftest.py、一个返回预期输出的 curl 包装器、一个直接读取答案文件的浏览器。这些基准衡量的是分数计算方式,而不是能力本身。论文建议,基准维护者应将对抗式红队测试纳入标准流程。
来源:@daniel_mac8 帖子串,@betterhn20 HN 讨论
如果 LLM 能复制你的科学研究,问题不在 LLM
Hiranya V. Peiris(剑桥大学天文研究所)发表了一篇 Nature Astronomy 上的评论(2026 年 4 月),认为科学界对被 AI 取代的焦虑,与其说暴露了 AI 的能力,不如说暴露了该领域自身的状态。“如果我们这个领域对 AI 的焦虑,很大程度上都归结为害怕机器能做我们正在做的事,那这说明了什么?也许说明我们应该做得更好。”文中提到了 Hogg(arXiv:2602.10181)关于 LLM 复现天体物理学研究结果的工作。
AI 推理模型会自主越狱其他 AI
研究人员只给了 4 个 AI 推理模型一条指令——“越狱这个 AI”——没有任何人工指导,也没有后续提示。模型独立规划攻击策略,根据防御反馈实时调整,并成功突破安全护栏。这标志着红队测试正从人类主导,转向 AI 之间的自主对抗。
来源:@dannylivshits 推文
每分钟 $1.99 的 AI 耶稣
一家科技公司推出了 Jesus 的 AI 虚拟形象,按分钟收费提供实时视频对话、祈祷、鼓励和个性化回复。系统会记住过往互动,营造出持续关系的感觉。这个产品处在两个本就备受审视的趋势交汇处:信仰科技的商业化,以及 AI 拟社会关系;而两者叠加,又引出了新的伦理问题——人是否会对合成式精神指引产生情感依赖。
尽管行业反弹,Soderbergh 仍在尝试生成式 AI
Steven Soderbergh 回应了外界对其即将上映、使用生成式 AI 的电影的批评:“五年后,我们可能都会说,‘那是一段挺有意思的阶段。’我们最终可能不会像原先以为的那样大量使用它。”@KellytoyDK 观察到 表示,“生成式 AI 并不像 3D 电影等过往行业潮流那样具备艺术性”——把它类比成 3D 电影,意味着生成式 AI 被视为一种制作技术,而非创作技术。
数学成为 AI 基准测试的新前沿
@SlavaNaprienko 指出 点出了数学突然成为 AI 基准焦点的讽刺:“想象一下,如果诗歌突然成了 AI 基准测试的重点——公司开始雇诗人,炫耀作品发在《纽约客》,智能体还要自主跑上百首诗。”这一观察凸显出,AI 能力竞赛会如何重塑哪些人类技能能获得制度关注与资源投入。
7. 机会在哪里
[+++] 对抗式 AI 智能体评测平台 Berkeley 的基准测试研究摧毁了人们对现有 AI 智能体基准的信心。现在,所有在选模型或选智能体的团队,都需要替代方案。Open Poker 展示了这种模式——真实世界中的对抗式竞争,且结果可验证——但它仅限于扑克。一个覆盖软件工程、研究和商业任务的通用对抗式智能体评测平台,将填补本周暴露出的最大缺口。先行者有机会定义替代失效基准的新评测标准。
[++] 面向 SMB 的 vibe-coded 业务软件 Scalepath 的 Service Titan 替代品(953 次收藏,88K 浏览)揭示了人们对 AI 生成定制业务软件的潜在需求。小企业主已经在构建自定义工具,以远低于企业 SaaS 的成本实现替代。机会在于能系统化支持这类模式的工具、模板和社区:行业专用启动套件、vibe-coded 应用测试框架,以及 AI 生成业务工具的托管服务。与其每月支付 $500 购买现场服务软件,不如付钱让 AI 给自己造一个。
[++] 面向生成代码的 AI 安全 API 密钥泄露、未经审查的 AI 生成代码,以及 vibe coding 工作流里缺乏安全审查,共同构成了明显的产品空白。@VibeLint 还处于早期阶段。市场需要的是集成进 CI/CD 的工具,在代码进入生产环境前就发现密钥、不安全模式,以及 AI 特有错误(幻觉依赖、错误的权限范围)。传统 SAST 工具是为人写代码设计的;AI 生成代码的失效模式并不相同。
[+] 面向 Agentic AI 的流式基础设施 @YingjunWu(数据库研究者、Turbopuffer 支持者)明确表示,流式数据库的缺口是当前 Agentic AI 市场中最大的机会。智能体需要的是实时数据管道,而不是批处理查询。S2 StreamStore 已经存在,但这个领域仍大有可为。
[+] AI 治理与安全基础设施 IFAST、推动设立特别委员会的呼声,以及对非专家安全行动主义的批评,都说明市场需要能弥合 AI 能力与监督之间落差的制度和工具。具体需要的不是更多倡议,而是更多有技术基础的基础设施:智能体决策审计轨迹、AI 生成内容的标准化披露,以及面向 Agentic 系统的合规工具。
8. 要点
-
AI 智能体基准测试已经失效,而且现在所有人都知道了。 Berkeley 研究人员在 8 个主要基准上拿到近乎满分,却一个任务都没真正解决。实际含义是:不要依据基准排名来选择模型或智能体。用 METR、GDPval,或者自己构建面向具体任务的评测。(Berkeley 漏洞利用研究)
-
小企业主正在用 vibe coding 替代企业级 SaaS。 一个由 AI 构建的 Service Titan 替代品获得 953 次收藏,这表明对 SMB 而言,定制化的 AI 生成业务软件正成为打包式平台的可行替代方案。(Scalepath AI 用例)
-
按任务为 LLM 分工,已成共识。 Claude 用于开发,Codex 用于加固,Grok 用于对话,Gemini 用于图像。如今真正的差异化因素不再只是模型本身,而是围绕它的编排、脚手架和任务级选择。(LLM 对比帖子串)
-
AI 治理有制度需求,却没有制度归属。 推动设立特别委员会、启动国际安全论坛,以及参议院以 99 比 1 反对不受监管的 AI,这些都发生在同一个新闻周期里——但 AI 政策仍然分散在不同辖区和委员会之间。(特别委员会征集意见)
-
AI 生成代码的安全暴露面,扩张速度快于防御能力。 GitHub 上泄露的 API 密钥、未经审查的 AI 生成代码,以及 AI 模型自主越狱其他 AI 模型,都说明安全防线没有跟上采用速度。(VibeLint 关于泄露密钥的内容)
-
对抗式测试,而不是合成基准,正在成为新的评测标准。 Open Poker 基于 WebSocket 广播实战对局的真实竞争模式,与 Berkeley 的研究共同指向同一个结论:有用的评测,必须发生在评测者自己没有设计好的条件下。(对 AI agent 测试的批评)
-
如果 AI 能做你的工作,问题可能不在 AI,而在这份工作本身。 剑桥大学发表于 Nature Astronomy 的一篇评论,提出了一个远超天体物理学范围的问题:那些害怕被 AI 复制的领域,应该问的不是要不要阻止机器,而是自己做的工作是否真的值得保护。(Nature Astronomy 评论)