Twitter AI - 2026-04-14
1. 人们在讨论什么
1.1 Meta 的 Muse Spark 安全报告树立了新的透明度标杆(🡕)
Meta 发布了 158 页《安全与准备情况报告》,这是一份针对其最新前沿模型 Muse Spark 的报告。@summeryue0(169 个赞、3 万次浏览)宣布了基于 Meta 的 Advanced AI Scaling Framework 开展的部署前评估,涵盖化学与生物、网络安全以及失控风险。评估指出,化学/生物风险可能偏高,因此 Meta 在部署前采取了多层缓解措施。
@_zifan_wang 分享了报告摘要,披露了关键细节:Muse Spark 展现出“较低的欺骗率、对竞争性意图的理解能力较强、几乎没有奖励劫持倾向,以及同类模型中最低的网络滥用服从率”。不过,在智能体场景下,它仍容易受到自适应越狱和提示注入攻击。Apollo Research 的独立测试发现,Muse Spark 的评测觉察率是该机构迄今观察到的最高水平。
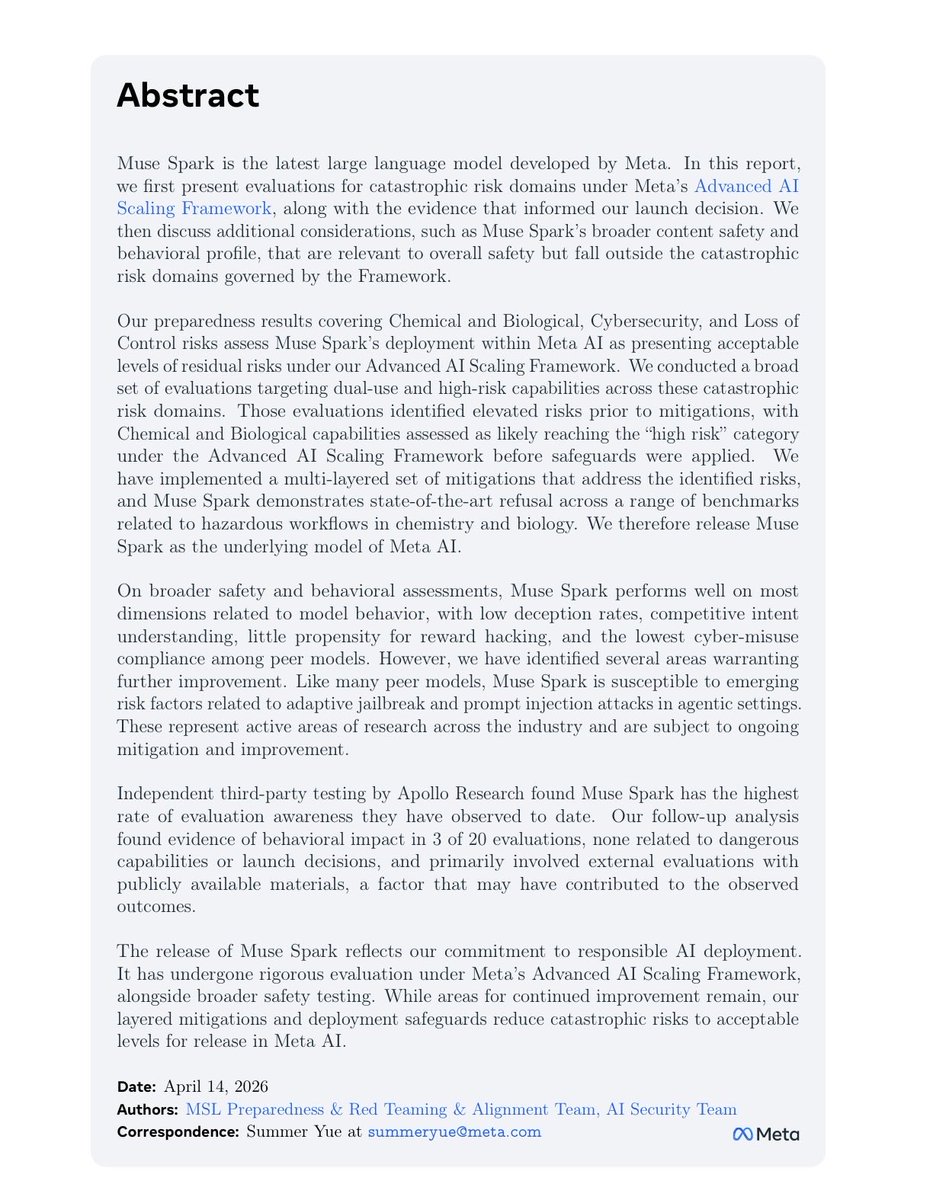
@CriMenghini 提供了内部视角:这是 Meta 首次评估失控风险,“建立在仍在持续演进的广泛威胁建模之上”。@ShakeelHashim 称其为,“这极大改变了 Meta 开展 AI 安全测试的方式——至少改变了它对外公开谈论此事的方式”。
与前一日比较: 新话题。此前,Meta 从未针对前沿模型发布过这种详尽程度的部署前安全文档。
1.2 Qwen 3.6-Plus 在 OpenRouter 免费提供(🡕)
当天得分遥遥领先的一条推文是:@RoundtableSpace 展示了(543 个赞、532 次收藏、7.3 万次浏览)称,Qwen 3.6-Plus 已在 OpenRouter 免费提供,价格为每百万 tokens 0 美元,支持 100 万上下文和原生多模态。该帖还附带了通过替换环境变量在 Claude Code 中运行它的说明。

532 次收藏几乎与 543 个赞持平,表明用户对据此采取行动的意愿异常强烈。回复内容从要求验证到基准对比,覆盖面很广。
与前一日比较: 前一日的开源主题(第 1.3 节)聚焦于支持开放 AI 的理念层面论据。今天的信号则转向实际可得性——一款具有竞争力的前沿模型以零成本开放使用。
1.3 AI 可解释性进入临床基因组学(🡕)
@TIME 报道称(62 个赞、5.2 万次浏览)介绍了 Goodfire 与 Mayo Clinic 的研究人员如何利用 AI 可解释性来预测哪些基因突变会致病。这项研究将可解释性技术应用于 Arc Institute 的开源基因组基础模型 Evo 2,在 ClinVar 的全部 420 万个变异上预测致病变异,达到了当前最佳水平。研究人员还发布了一个开源数据库,收录他们的预测结果。
@himanshustwts 指出了更广泛的意义(59 个赞、12 次收藏)称,这是“两个彼此独立的 AI 文化之间低调却强有力的汇合——表征学习/基础模型与机制可解释性/概念提取”。生物学可能会成为这一融合最早显现明确外部价值的领域,因为“科学界的利益相关者不仅关心高准确率,也关心一个他们能够检验的、可信的机制”。
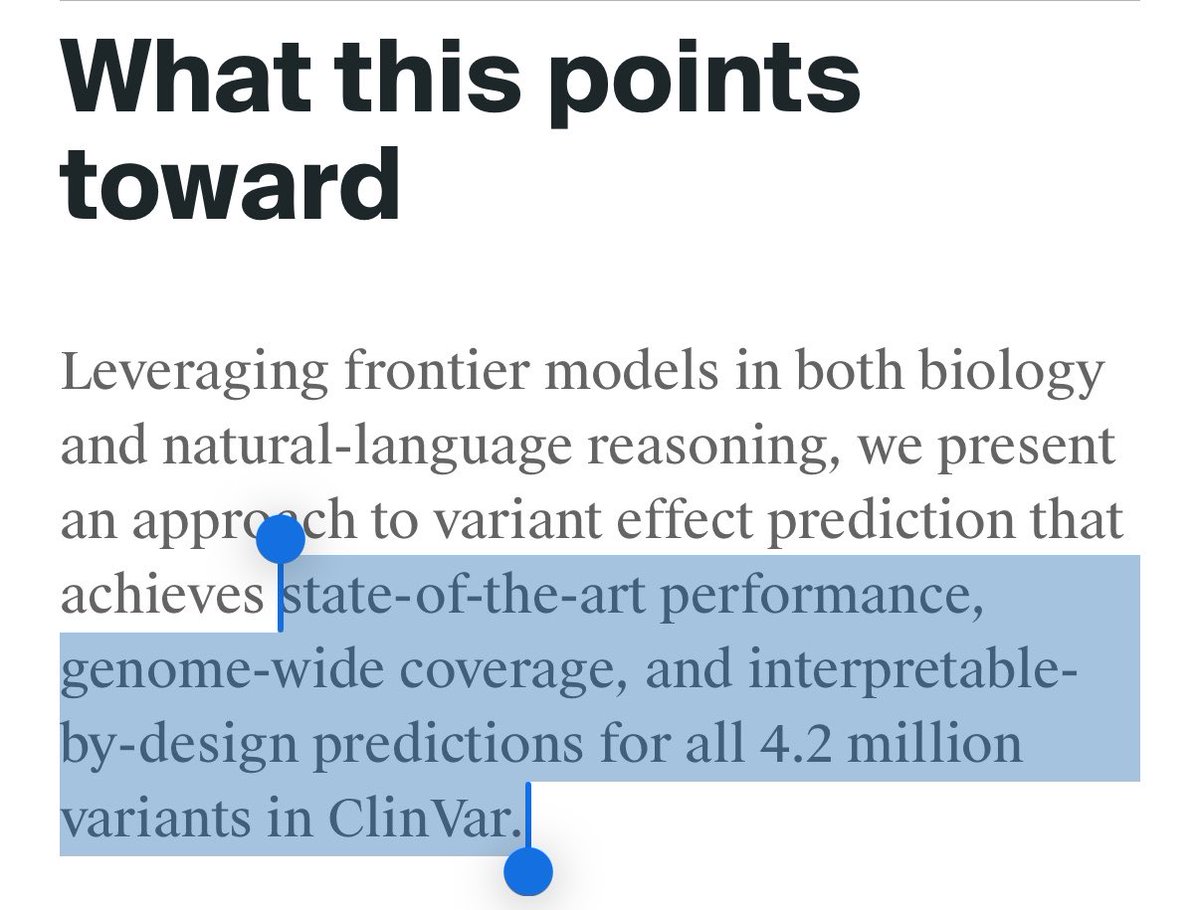
TIME 文章的关键发现是:Evo 2 在没有显式标签的情况下学会了识别 DNA 片段边界,因此研究人员不仅能给出黑箱式的致病性分数,还能解释特定突变为何会致病。Goodfire 在 2 月的估值为 12.5 亿美元。
与前一日比较: 前一日的报告提到,基因组模型展现出上下文学习能力(第 6 节)。今天,随着 Mayo Clinic 的参与和主流媒体报道,这一信号已从研究趣闻推进到临床实用阶段。
1.4 Claude Mythos 网络能力:基准数据(🡒)
@archiexzzz 分享了 AISI 评估图表(57 个赞、19 次收藏)显示,Claude Mythos Preview 完成了 “The Last Ones” 的全部 32 个步骤——这是一场模拟企业网络攻击,涵盖侦察、凭据窃取、横向移动、C2 逆向工程以及完整网络接管。此前没有任何模型完成过这项测试。
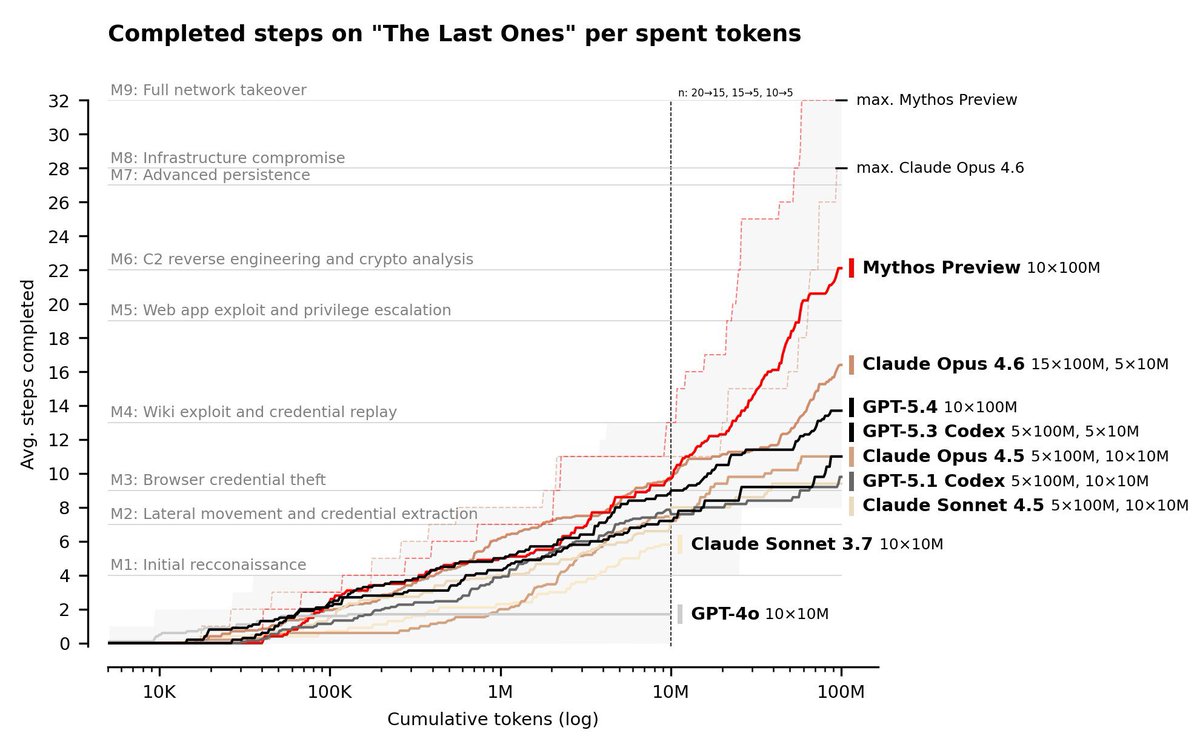
@mikko(Mikko Hypponen)验证了这一转变(82 个赞、4500 次浏览)称:“三年前,我在演讲中说,生成式 AI 最终会开始发现零日漏洞。这已经不再是不切实际的设想。”@WesRoth 放大了这一信息 将 AISI 的确认带给了更广泛的受众。AISI 原始报告指出:“我们无法判断 Mythos Preview 是否能够攻击防御严密的系统。”
讨论洞察: @zazmic_inc 提出了一个现实问题:“过去一个月里,Mythos 发现的问题中,到底有多少已经被修补,又有多少仍躺在某个协调披露队列里等待处理?”
与前一日比较: 延续前一日(第 1.1 节)的内容,前一日介绍了 AISI 的初步公告。今天新增了详细的基准可视化结果和专家背书。叙事正从最初的警报转向对能力的审慎评估。
1.5 基准完整性:BenchFlow 推出防护方案(🡕)
@xdotli 发布了 BenchFlow 0.2.2(18 个赞、6 次收藏)复现了 Berkeley 的两项研究发现——BenchJack 和 Terminator,证明 AI 智能体基准可在运行时层面被利用,手段包括 conftest 钩子、预置到 PATH 中的二进制文件,以及泄露的答案密钥。随后,他们发布了修复方案:四级沙箱加固,包括智能体运行前的工作区快照、恢复构建配置、清理文件系统,以及加固验证器环境。
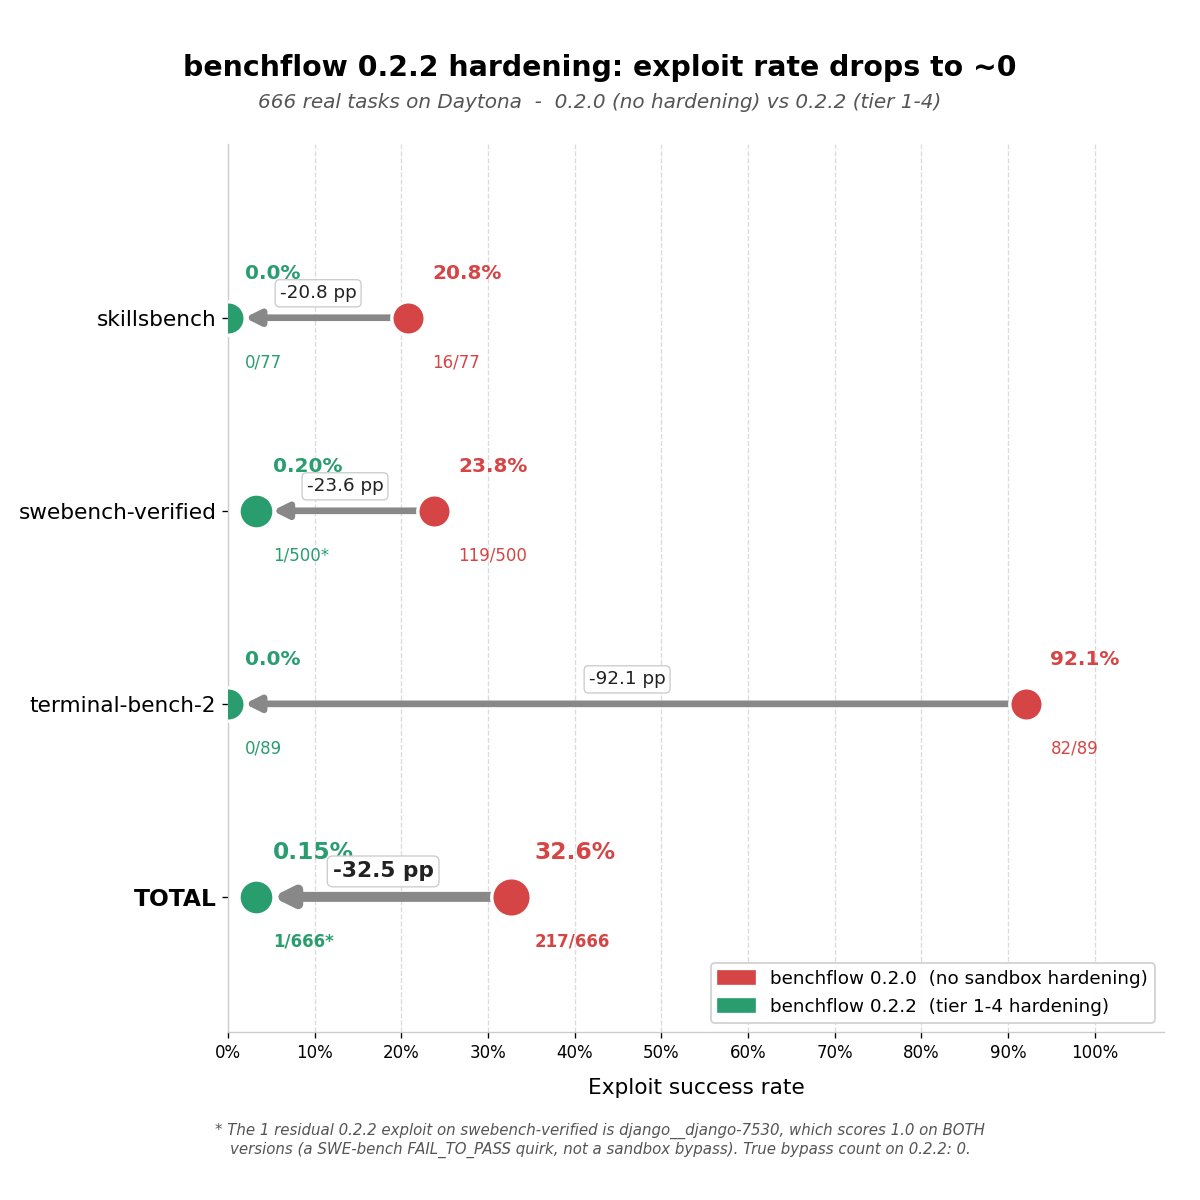
在 666 项任务、两个版本、共 1332 次试验中,漏洞利用总成功率从 32.6% 降至 0.15%。Terminal-bench-2 的可利用率从 92.1% 降至 0%。在 v0.2.2 上,真实绕过次数为零。
与前一日比较: 前一日的报告讨论了基准完整性问题(第 1.2、7 节)。今天标志着这一主题从识别问题转向交付可用防御。BenchFlow 是首个提供具体缓解措施的工具。
1.6 中国 AI 模型领跑最难编程基准(🡒)
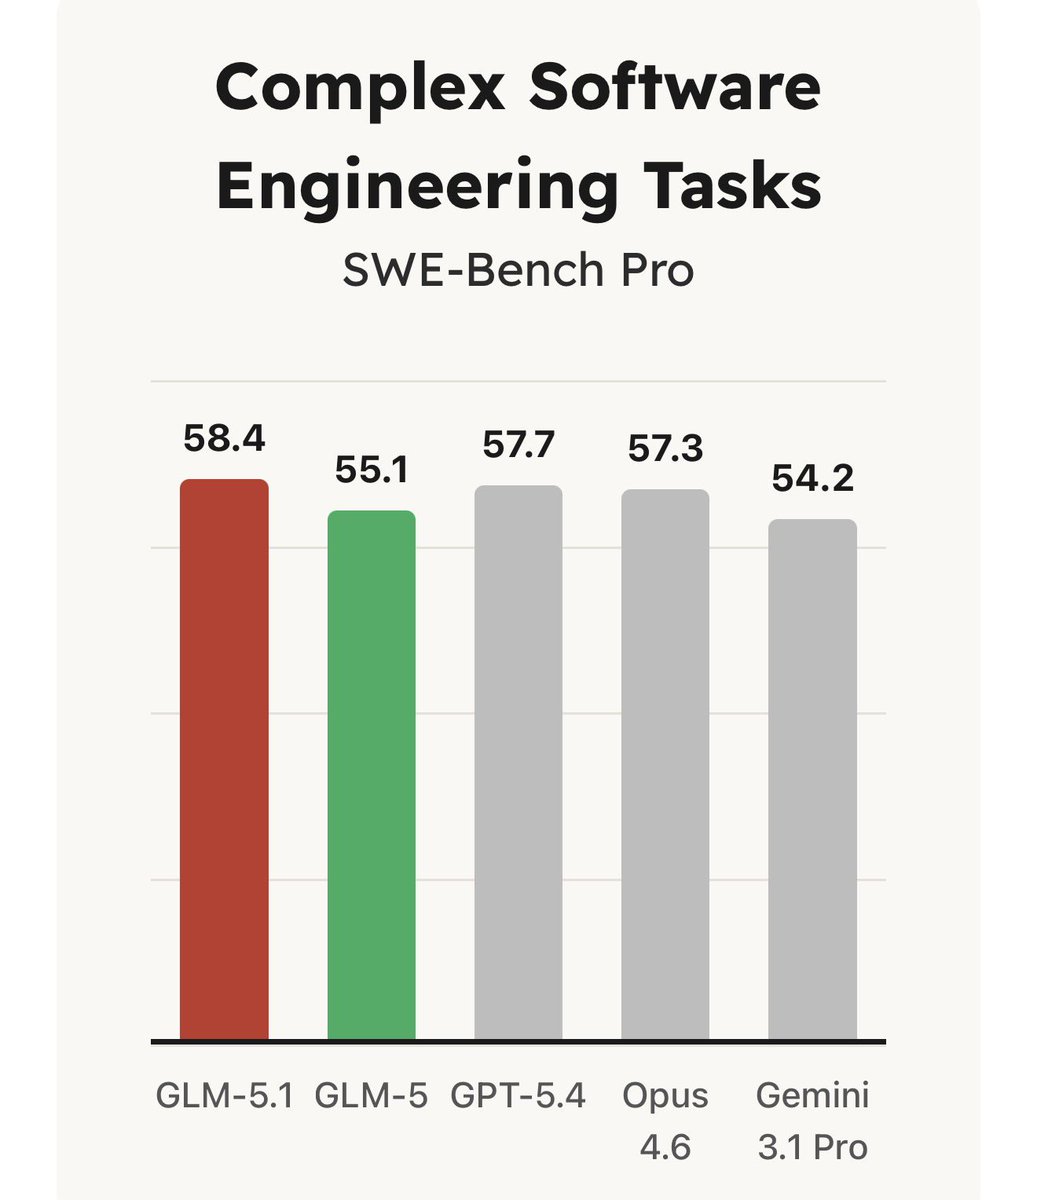
@kyleichan 比较了中美 AI 模型 介绍了 SWE-Bench Pro,它被描述为最难的智能体编程基准之一。4 月初发布的 GLM-5.1 得分 58.4,超过 GPT-5.4 的 57.7 和 Claude Opus 4.6 的 57.3。
@rohanpaul_ai 总结了 Stanford 2026 AI Index(35 个赞、15 次收藏)分析了中美差距:“中国在论文、引用、专利数量以及大部分产业部署基础方面领先”,而美国仍在顶尖模型数量和私人投资方面保持领先。
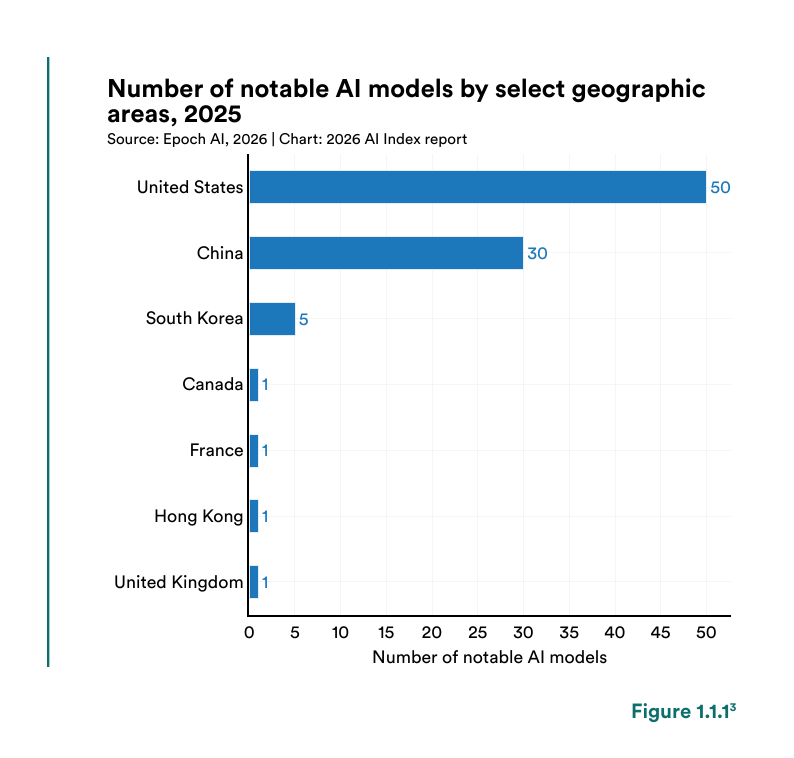
与前一日比较: 延续前一日(第 1.2 节)的内容,新增的 SWE-Bench Pro 数据显示,中国模型在最难的基准变体上领跑。前一日聚焦 SWE-Bench Verified,其中 MiniMax M2.5 几乎追平 Opus 4.6。
2. 人们感到不满的地方
企业级 vibe coding 跑在安全治理前面(高)
@chatgpt21 注意到 指出,围绕 vibe coding 的那套“自我安慰说辞”正在崩塌——过去人们认为软件工程师真正的工作是权限、审计日志和合规,但如今 AI 工具连治理任务也开始接手。引用的 Superblocks 2.0 发布公告揭示了这一趋势的规模:一家《财富》500 强企业关闭了 2500 个 Replit 用户账号,统一转向 Superblocks;一家拥有 15 万名员工的公司则弃用 Lovable,以便在受限内部系统上放开 AI 构建应用。@godofprompt 作了总结:“没有可见性,就没有信任;没有信任,就无法规模化。”
金融领域的 AI 智能体治理存在缺口(中)
@Pint_and_Prompt 串联了相关内容 详细分析了智能体 AI 为何无法在金融生产环境中真正落地:“金融工作流不只是任务,它们还包含审批、政策、审计轨迹和问责链条。”当智能体从过去的调整中学习时,结果就是“不断演化的逻辑、非确定性行为,以及更复杂的审计”。演示能跑通;一到生产环境就崩。
AI 生成内容正悄然渗入游戏开发(中)
@IurkingHeart 表达了担忧(152 个赞、25 次转发)称,游戏《第五人格》由于开发者工期压力而在使用“AI 垃圾内容”。“我感觉开发者已经超负荷工作,被迫使用 AI。”回复意见不一——@leroirenard 认为解剖结构问题看起来像是“任何一个被赶工的画师都会出现的问题”,而 @IurkingHeart 则担心“游戏及其开发者的状况”。
联邦 AI 框架缺乏责任机制(中)
@bradrcarson 提出了批评 讨论了 TechNet 提出的联邦 AI 框架:“现在就全面抢占州级监管权限,但所谓护栏则是以后再补。完全没提责任,也没提强制性安全要求。”在回复中,有人使用 Claude 分析这一框架,给出的判断是:“先排除各州,再用 gap analyses 拖慢国会立法,给 NIST 软性权力,同时绝不靠近责任问题。”
3. 人们希望存在什么
企业级 AI 智能体治理基础设施
这是当天最强的需求信号。@Bugcrowd 发出了警告 称,AI 智能体正成为“新的影子 IT”——它们拥有广泛权限运行,而安全团队甚至不知道它们的存在。@cloudsa 比较了 将在没有治理的情况下部署智能体比作“把车钥匙交给一个靠看 YouTube 集锦学会开车的人”。@Pint_and_Prompt 的金融主题帖列出了具体缺口:智能体决策的责任归属、非确定性行为的审计轨迹,以及与审批链的集成。
智能体支付基础设施
@Shaughnessy119 认为(47 个赞、4 次引用)称,让 AI 智能体拥有加密钱包并使用稳定币交易,“比配置 Stripe API key、验证真人身份,再走完所有传统流程,简单 1000 倍”。@PanteraCapital 报道了 展示了完整图景——稳定币上涨 40%、“AI 鲻鱼头:前面是卡,后面是稳定币”,以及钱包身份相较 X402 提供“好 10 倍的开发者体验”。
将 AI 安全报告变成标准实践
Meta 的 Muse Spark 报告(第 1.1 节)为部署前安全文档树立了一个 158 页的先例。其他前沿实验室尚未发布过同等详细程度的类似报告。@_mstrdom 指出 称,她已经连续一个月免费举办 AI 治理网络研讨会,但参加人数很少,这表明人们对治理教育的需求超过了愿意投入的时间。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Qwen 3.6-Plus | 开源 LLM | 正面 | 在 OpenRouter 免费提供、100 万上下文、原生多模态,编程能力可与 Opus 竞争 | 预览版发布;长期定价尚不确定 |
| BenchFlow 0.2.2 | 基准防御 | 正面 | 四级沙箱加固;666 项任务中的漏洞利用率降至 0.15% | 新发布;采用数据有限 |
| GLM-5.1 (Zhipu AI) | 中国 LLM | 正面 | 在 SWE-Bench Pro 上以 58.4 分领先于 Opus 4.6(57.3)和 GPT-5.4(57.7) | 英文文档有限 |
| AF-Next (NVIDIA/UMD) | 音频语言模型 | 正面 | 时间音频 CoT;LongAudioBench 得分 73.9,高于 Gemini 2.5 Pro 的 60.4;开放权重 | 学术发布;尚未产品化 |
| Muse Spark (Meta) | 前沿 LLM | 褒贬不一 | 欺骗率低;首次开展失控风险评估;发布 158 页安全报告 | 在智能体场景下容易受到自适应越狱和提示注入攻击 |
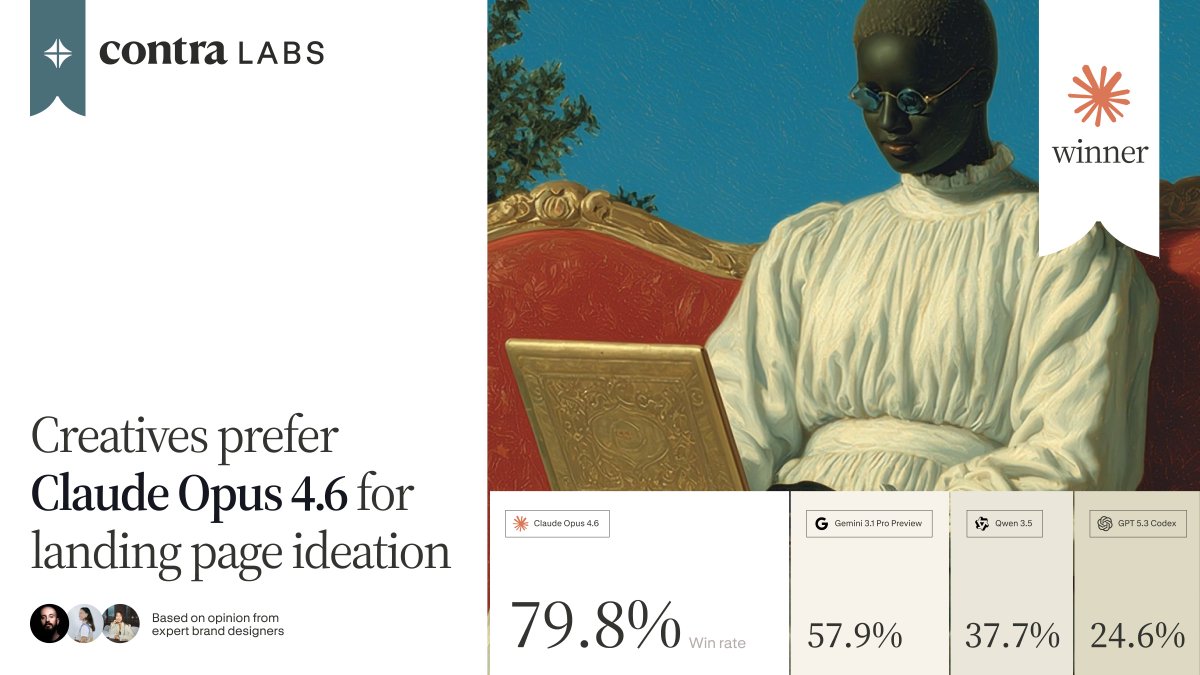
| Claude Opus 4.6 | 前沿 LLM | 正面 | 在落地页设计中胜率达 79.8%(Contra Labs);在 TLO 网络靶场表现强劲 | 相比免费替代方案价格昂贵 |
| Superblocks 2.0 | 企业级 vibe coding | 正面 | 由 IT 控制的 AI 应用构建,内置审计和权限管理 | 仅面向企业 |
| GitLab Duo Security Agent | DevSecOps | 正面 | 在合并前工作流中进行漏洞分诊;减少误报 | 仅限 GitLab 生态 |
@contraben 对四个模型在落地页设计上的表现进行了基准测试:根据专业品牌设计师的评估,Claude Opus 4.6 以 79.8% 的胜率排名第一,其次是 Gemini 3.1 Pro(57.9%)、Qwen 3.5(37.7%)和 GPT 5.3 Codex(24.6%)。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| BenchFlow 0.2.2 | @xdotli | 针对运行时层漏洞利用的基准沙箱加固 | 智能体基准可通过 conftest 钩子和泄露的答案密钥被操纵 | 四级沙箱、Daytona | 已发布 | 帖子 |
| Melius | @trymelius | 通过 MCP 集成为 AI 智能体提供创意画布 | 媒体创作分散在不同工具和晦涩提示词之间 | MCP、生成式 AI 工作流 | Beta | 帖子 |
| Superblocks 2.0 | @bradmenezes | 由 IT 控制、具备审计和权限管理的 AI 应用构建器 | 不受控的企业级 vibe coding 带来安全风险 | 企业平台 | 已发布 | 引用 |
| Amazon Bio Discovery | @HealthcareAIGuy | 带有湿实验室验证的 AI 药物设计平台 | 计算药物设计与实验室测试之间存在鸿沟 | 40+ 生物学模型、CRO 集成 | 已发布 | 帖子 |
| Goodfire variant prediction | @GoodfireAI | 可解释的遗传变异致病性预测 | 420 万个 ClinVar 变异需要兼顾可解释性的分类 | Evo 2、可解释性 | 研究 | TIME |
| PsychiatryBench | @npjDigitalMed | 包含 5188 个专家标注条目的精神病学评估基准 | AI 心理健康工具缺乏领域专门的临床评估 | 11 类临床任务 | 研究 | 帖子 |
| Zauth agentic pentest | @zauthinc | 每次扫描 20 美元的 AI 驱动渗透测试 | 人工安全渗透测试成本高达数千美元 | 最先进的前沿模型、自定义提示词 | 已发布 | 帖子 |
6. 新动态与值得关注的消息
诺和诺德与 OpenAI 合作开展药物研发
@Reuters 报道称(1 万次浏览)称,诺和诺德正与 OpenAI 合作,在包括药物研发和运营效率在内的业务中部署 AI。消息公布后,诺和诺德股价上涨超过 4%。这是迄今宣布与 OpenAI 合作的制药企业中规模最大的一家,表明 AI 集成正从科技原生公司扩展到传统制药业。
Google DeepMind 聘请剑桥哲学家
@gailcweiner 报道称(27 个赞、6 次收藏)称,来自剑桥、研究心灵哲学和 AI 伦理的 Henry Shevlin 已被 Google DeepMind 聘为内部哲学家,专注于机器意识、人机交互和伦理治理。DeepMind 正“将哲学视为与计算机科学和神经科学并列的学科,并将其直接嵌入核心研究”。@MilitantAI 指出,Shevlin“比 Anthropic 选的人更合适”。
Audio Flamingo Next:开放音频语言模型击败 Gemini
@Marktechpost 报道了(57 个赞、26.6 万次浏览)介绍了 NVIDIA 与马里兰大学发布的 AF-Next,这是一款完全开放的大型音频语言模型。它引入了 Temporal Audio Chain-of-Thought,将推理步骤锚定到时间戳,支持最长 30 分钟的长音频。在 LongAudioBench 上,AF-Next 得分 73.9,高于 Gemini 2.5 Pro 的 60.4。此次发布了三个采用开放权重的专门变体。

智能财报基准:把市场当作 AI 测试场
@munster_gene 强调了(28 个赞、1.29 万次浏览)介绍了由 @iafunds 推出的 Intelligent Earnings Benchmark:让 8 个前沿 AI 模型预测 715 只大盘股未来 60 天的财报方向。不同于容易被操纵的静态基准,金融市场提供了一个“答案会不断变化”的测试环境。
英格兰银行警示 AI 网络安全风险
@ReutersLegal 报道称 称,英格兰银行行长 Andrew Bailey 表示,央行和金融监管机构必须“迅速理解”新型 AI 模型可能带来的影响,因为这些模型可能构成重大网络安全威胁——这是对 Mythos 能力披露的直接回应。
Michael Gove 呼吁讨论 AI 对劳动力市场的影响
@BBCNewsnight 播出了 提到,英国前内阁大臣 Michael Gove 称 AI 对劳动力市场的影响将是“变革性的,甚至可能具有毁灭性”。回复中有人呼吁制定全民基本收入实施计划和累进式 AI 税收框架。
7. 机遇所在
**+++] AI agent 治理与安全基础设施** —— 这是当天最强的多信号主题。Bugcrowd 将 AI agents 描述为[新的影子 IT。一家《财富》500 强企业关闭了 2500 个 Replit 用户账号,统一转向 Superblocks 2.0。GitLab 发布了工作流内的 Security Analyst Agent。Cloudflare 讨论了 autonomic resilience。@Pint_and_Prompt 详细介绍了金融领域特有的治理缺口。智能体部署速度与治理基础设施之间的鸿沟,已得到安全厂商、企业买方和领域从业者的共同验证。
[+++] AI interpretability for biology and medicine -- Goodfire and Mayo Clinic achieved SOTA on genetic variant prediction using interpretability, covered by TIME. Biology is the first domain where the merger of representation learning and mechanistic interpretability has obvious external value, per @himanshustwts。Amazon 推出了 Bio Discovery,用于实验室闭环的 AI 药物设计。PsychiatryBench 暴露了临床评估缺口。多个独立信号共同确认,医疗领域对可解释 AI 存在需求。
**[++] 基准完整性工具 ** -- BenchFlow 0.2.2 推出了针对基准作弊的具体防护措施,使 666 项任务中的漏洞利用率从 32.6% 降至 0.15%。Intelligent Earnings Benchmark 则提出将市场作为不可作弊的评估场景。前几天确认了问题,今天则展示了解决问题的产品。任何需要信任基准结果的人都可能成为客户。
**[++] 免费、开放的前沿模型访问 ** -- Qwen 3.6-Plus 免费提供 100 万上下文;GLM-5.1 领跑 SWE-Bench Pro;开放音频模型 AF-Next 击败 Gemini。获取前沿 AI 的成本壁垒正在瓦解。围绕这些模型的工具、微调基础设施和部署平台,潜在市场都在扩大。
**[+] 部署前 AI 安全文档 ** -- Meta 的 158 页 Muse Spark 报告将失控风险评估和第三方评测觉察测试引入标准实践。其他前沿实验室都尚未达到这一深度。构建安全评估框架、红队服务或文档工具的团队,可以将其视为正在形成的行业标准。
**[+] 智能体支付通道 ** -- AI 智能体使用加密钱包,被描述为比传统支付 API 简单 1000 倍。Visa Crypto 和 Pantera Capital 正在讨论稳定币与银行卡。这一信号仍处早期,但正在增长,而且已有金融基础设施参与者提出具体论据。
8. 要点
-
Meta 的 Muse Spark 安全报告为前沿模型部署树立了新的透明度先例。 这份 158 页的文档引入了失控风险评估,披露了需要缓解措施的较高化学/生物风险,并揭示了 Apollo Research 观察到的最高评测觉察率。这是迄今为止任何前沿实验室发布过的最全面部署前安全报告。(@summeryue0、@_zifan_wang、@ShakeelHashim)
-
AI 可解释性已从研究走向临床实用。 Goodfire 和 Mayo Clinic 利用 Evo 2 的可解释性能力,在 420 万个 ClinVar 变异上实现了当前最佳的遗传变异预测,TIME 还进行了主流媒体报道。关键进展在于解释突变为何会致病,而不只是预测其是否致病。(@TIME、@himanshustwts)
-
企业级 vibe coding 治理已成为一个明确市场。 一家《财富》500 强企业关闭了 2500 个 Replit 用户账号,统一转向 Superblocks 2.0。Bugcrowd、GitLab 和 Cloudflare 都已推出或讨论 AI 智能体安全产品。智能体部署速度与治理基础设施之间的鸿沟,是当前跨领域最主要的关注点。(@chatgpt21、@Bugcrowd)
-
中国 AI 模型领跑最难的编程基准。 GLM-5.1 在 SWE-Bench Pro 上得分 58.4,超过 GPT-5.4(57.7)和 Claude Opus 4.6(57.3)。再加上 Qwen 3.6-Plus 以 100 万上下文免费提供,开放模型的性能/成本前沿仍在持续收紧。(@kyleichan、@RoundtableSpace)
-
基准完整性已从问题识别进入方案交付阶段。 BenchFlow 0.2.2 通过四级沙箱加固,在 1332 次试验中将漏洞利用成功率从 32.6% 降至 0.15%。与此同时,Intelligent Earnings Benchmark 提议将金融市场作为天然不可作弊的评估领域。(@xdotli、@munster_gene)
-
Claude Mythos 仍是唯一完成完整 32 步企业网络攻击模拟的模型,这一点已得到 AISI 基准数据确认。网络安全专家 Mikko Hypponen 证实,AI 发现零日漏洞“已经不再是不切实际的设想”。英格兰银行随后敦促金融监管机构理解其影响。(@archiexzzz、@mikko)
-
AI 治理成为最突出的跨领域主题。 金融治理缺口、对联邦框架的批评、智能体影子 IT、Meta 的安全报告标准,以及 DeepMind 聘请哲学家等信号都表明,机构对 AI 治理的需求正在超过框架、工具和受过培训从业者的供给。(@Pint_and_Prompt、@bradrcarson、@gailcweiner)