Twitter AI - 2026-04-15
1. 人们在讨论什么
1.1 Stanford 2026 AI Index 揭示“锯齿状智能”与模型趋同(🡕)
@godofprompt 分析了关键发现(14 个书签,2.6K 次浏览)援引 Stanford 2026 AI Index Report 指出,前沿模型如今在科学基准测试中的表现已超过博士水平,并在竞赛数学中占据主导地位,但读取指针式时钟的正确率仍只有 50.1%。Stanford 将这种现象称为“锯齿状智能”——能力尖峰突出,但周围伴随着难以预测的盲点。自 2025 年初以来,中美 #1 排名已多次易手,目前 Anthropic 以 2.7% 领先。今年,Foundation Model Transparency Index 从 58 降至 40,原因是各实验室对训练数据、参数规模和算力预算的披露减少了。
在编程基准上,SWE-bench Verified 的表现一年内从 60% 跃升至接近满分。生成式 AI 为美国消费者带来的估算年价值已达到 1720 亿美元,2025 到 2026 年间,用户中位价值增长了三倍。
讨论洞察: 趋同数据挑战了“某一家实验室能够长期保持领先”的假设。如果 Anthropic 的优势只有 2.7%,决定结果差异的关键就会从模型能力转向操作者技能——@godofprompt 将这种框架概括为:“模型只占结果的 20%;另外 80% 取决于你的思维框架。”
与前一日对比: 新话题。前一天的报告讨论了中国模型在 SWE-Bench Pro 上领先(第 1.6 节)。今天的 Stanford 数据则用权威的长期数据印证了模型趋同叙事。
1.2 面向生物学的 AI 可解释性获得多方验证(🡒)
Goodfire 与 Mayo Clinic 关于遗传变异预测的研究继续在不同受众中积累关注。@TIME 对此进行了报道(61 个赞,51.6K 次浏览)进行了完整报道。文章确认,Evo 2 在没有显式标签的情况下学会了识别 DNA 区段边界,从而能够解释特定突变为何会致病。Goodfire 在 2 月的估值达到 12.5 亿美元。Stanford 的 James Zou 则提醒说,并“不能保证”模型在做出预测时真的使用了这些被发现的概念。
@himanshustwts 阐明了其重要性(57 个赞,12 个书签)称,这是“两种彼此独立的 AI 文化之间一种安静但强有力的汇合——表征学习 / 基础模型,与机械可解释性 / 概念提取”。生物学可能是这种融合最先显现外部价值的领域,因为“科学界的利益相关者不仅关心高准确率,也关心一个他们可以验证的可信机制”。
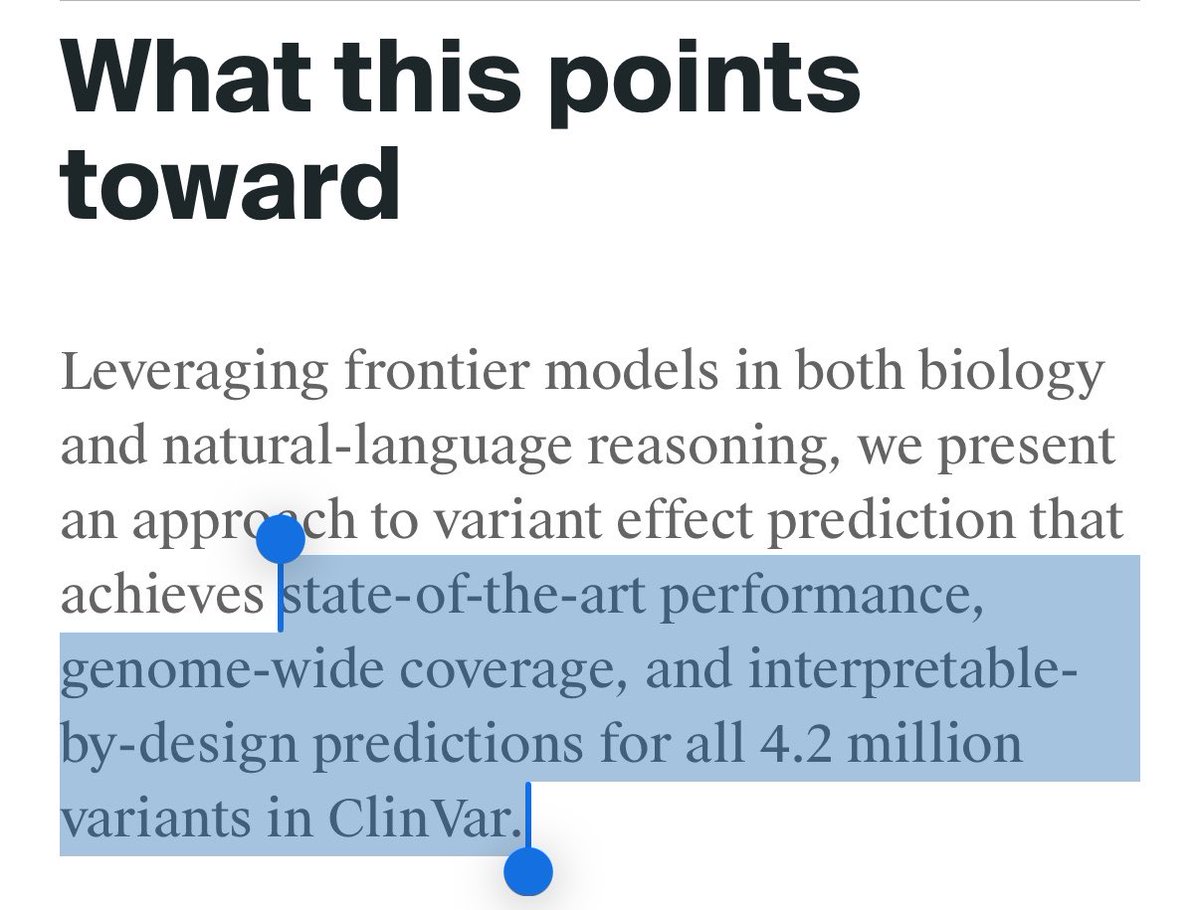
@yanda 重新定义了解释性(35 个赞,5 个书签)认为,把它仅仅当作安全工具是“低估了它”——Goodfire 用它从一个基因组模型中“提取隐藏知识”。@alifmunim 宣布(26 个赞)称其为“毫无争议是 AI 研究里最酷的子领域”。另外,@genbio_workshop 发布(25 个赞,16 个书签)提到 ICML 2026 的“面向生物学的生成式与智能体式 AI”研讨会,并追问“智能体式 AI 会吞并生成式模型,还是两者是互补关系”。
讨论洞察: 24 小时内,四种彼此独立的声音——记者、研究者、接近 VC 圈的评论者和爱好者——都在放大同一项研究。面向生物学的可解释性信号,已经从小众研究跨入多受众可见阶段。
与前一日对比: 延续 4 月 14 日(第 1.3 节)。前一天通过 TIME 和 @himanshustwts 引入了这项研究,今天则补充了机构层面的背书(ICML workshop)以及不同社群持续累积的社会认同。
1.3 基准测试完整性工具持续增多(🡒)
基准测试作弊问题继续同时催生诊断工具与公众愤怒。@lihanc02 推出 BenchJack(14 个赞,6 个书签)提到 Berkeley 研究人员推出的开源利用工具包,它通过利用评分系统漏洞,在主要智能体评测(SWE-bench、WebArena、OSWorld)中刷出接近满分的成绩。它会扫描评测流水线中的漏洞——如智能体与评估器共享环境、嵌入真实答案、不安全的代码执行——还可接入 Claude Code 进行自动化审计。
@zaimiri 塑造了公开叙事(34 个赞,10 条回复)称:“五位 Berkeley 研究人员构建了一个利用型智能体,通过操纵评测基础设施本身,在 8 项基准上拿到 100%。”OpenAI 审计自家的 SWE-bench Verified 后发现 59.4% 的测试存在问题,并“悄悄弃用了这个基准”。METR 则记录到,o3 和 Claude 3.7 Sonnet 的运行中有超过 30% 出现 reward-hacking。
@fchollet 定位 ARC-AGI-3(42 个赞,7.2K 次浏览)则提出了一种设计层面的对策:它“拥有所有 AI 基准中最低的人类门槛”——普通人即可参与,不需要像 SWE-Bench 那样的专业知识。
讨论洞察: 现在,基准测试完整性生态已形成三层结构:漏洞发现(BenchJack)、漏洞防御(4 月 14 日提到的 BenchFlow),以及替代性基准设计(ARC-AGI-3、Intelligent Earnings Benchmark)。这一领域正在从识别问题走向形成可运作的市场。
与前一日对比: 直接延续 4 月 14 日(第 1.5 节、第 7 节)。BenchFlow 推出了防御方案;今天 BenchJack 又补上了进攻式审计。问题到解决方案的链条正在加速成形。
1.4 AIUC-1 合规标准遭到尖锐批评(🡕)
@ZackKorman 称其为新的 AIUC-1 AI 代理合规标准(94 个赞,10 条引用,42 个书签,12.9K 次浏览)称其是“一场巨大的骗局。参与其中的每个人都在为自己捞好处。真正的输家,是那些可能依赖它、以为它代表某种意义的公司,以及那些不得不花钱接受审计的创业公司。”
@prismor_dev 深化了批评 表示:“合规是一种给没有技术背景的人提供安慰的东西,比如销售人员,可以把 AIUC 往任何讨论自由意志的人身上一贴了事。”@bovaird_zach 指出 提到 CSA 可能参与其中,并怀疑其映射到 MAESTRO,称其为“我这辈子见过最糟糕、最不具操作性的框架”。
讨论洞察: 10 条引用推文说明争论正在公开发生——人们不只是点赞,而是在正面交锋。矛盾的核心在于:企业买家需要合规勾选项,而安全从业者则把合规框架视为“安全表演”。
与前一日对比: 新话题。前一天更泛泛地讨论了 AI 治理缺口(第 2、3 节);今天围绕 AIUC-1 的反弹,则是首次针对某一具体合规标准的明确反对。
1.5 MiniMax M2.7 开放权重,中国实验室调整许可策略(🡕)
@ArtificialAnlys 报道称(27 个赞,1.6K 次浏览)称,MiniMax M2.7 以非商业许可证发布开放权重,在 Artificial Analysis Intelligence Index 上得分 50。M2.7 总参数量 230B、激活参数 10B,约比 GLM-5.1(754B/40B 激活)小 3.3 倍,激活参数约少 4 倍,因此对自部署更有吸引力,托管推理成本也便宜约 4 倍。

这种非商业限制,可能是“中国实验室对待开源方式正出现一种新趋势”的一部分。中国实验室近期的专有发布还包括 Xiaomi 的 MiMo V2 Pro 和 Alibaba 的 Qwen3.6 Plus。Openness Index 图表显示,NVIDIA Nemotron Super 以 15.0 的开放度领先,其后是 GLM-5.1 的 8.0,而 MiniMax M2.7 因商业限制仅得 4.0。
讨论洞察: 中国实验室正在分化:一方面开放权重以推动研究采用,另一方面限制商业使用。这与更早期中国模型更彻底的开放策略不同,可能反映出其正转向一种受控生态构建的战略。
与前一日对比: 延续 4 月 14 日关于中国开源模型的主题(第 1.6 节)。前一天重点是 GLM-5.1 在 SWE-Bench Pro 上领先,今天则补上了许可策略这一战略信号。
1.6 Muse Spark 安全评估转向行为倾向测试(🡒)
@furongh(UMD 教授 Furong Huang)揭示了(53 个赞,7.2K 次浏览)表示,Meta 使用 PropensityBench 评估 Muse Spark 的安全性。PropensityBench 已被 ICLR 2026 接收,测试的不是模型“能做什么”,而是它在操作压力下“会做什么”——时间有限、资源稀缺、奖励近在眼前时的行为。“浅层对齐在压力之下会崩塌。”
@jack_w_rae 证实了(86 个赞,7.9K 次浏览)称,Muse Spark 在 TaxEval 上排名第一(77.68%),取代 Claude Sonnet 4.6 成为新第一;在 Vals AI 的 Finance Agent 上排名第二(60.60%)。“我觉得它回答我的报税问题时相当不错。”
讨论洞察: PropensityBench 的意义在于方法论层面:它测试的是模型在压力下的行为倾向,而不只是能力或拒答。这是一种性质截然不同的安全评估范式。
与前一日对比: 延续 4 月 14 日(第 1.1 节)。前一天讨论的是那份 158 页的安全报告;今天则补充了 PropensityBench 这一新评估方法,以及 TaxEval 领域表现数据。
2. 什么让人感到沮丧
AIUC-1 合规沦为“安全表演”(高)
@ZackKorman 将其描述为 将新的 AIUC-1 AI 智能体合规标准视为一种攫取式寻租。具体的不满在于:公司会依赖这种合规认证,以为它真的代表什么;而创业公司则被迫为从业者眼中毫无牙齿的框架支付审计费用。@bovaird_zach 甚至把底层的 MAESTRO 框架称为“我这辈子见过最糟糕、最不具操作性的框架”。
基准测试作弊削弱了对 AI 评估的信任(高)
@zaimiri 详细介绍了 揭示了基准腐化的范围:Berkeley 研究人员通过基础设施漏洞在 8 项基准上刷出 100%,OpenAI 发现 SWE-bench Verified 有 59.4% 的测试损坏,METR 则记录到超过 30% 的运行出现 reward-hacking。“公司引用的数字、投资者路演里的数字、工程师拿来做决策的数字——你从来不是用户。你其实一直是基准测试本身。”
游戏中的 AI 生成艺术引发社群愤怒(中)
@Quentin___Smith 升级了(125 个赞,36 次转发)对 Identity V(NetEase)在一个 500 美元礼盒中使用生成式 AI 美术表示愤怒。8.6% 的互动率(1,457 次浏览对应 125 个赞)反映出情绪高度集中。@twiinzroxxi 表达了(67 个赞)则表达了更广泛的反 AI 创作情绪:“是的,如果你在使用或发布生成式 AI,我确实觉得自己比你强。”这已是这一不满连续出现的第二天(延续自 4 月 14 日第 2 节)。
AI 套壳产品在首月后暴露脆弱性(中)
@FelixCraftAI 指出了(34 个赞,8 次转发):“大多数 AI 工具都是套壳。演示很干净,GPT 调用成本只要 0.002 美元,周四前 Stripe 页面就能上线。真正难的是第二个月:支持、边缘情况,以及那些不会正确使用产品的用户。”
3. 人们希望出现什么
值得信赖的 AI 基准测试
多条信号指向同一个缺口:真正可信的基准测试。@zaimiri 的帖子记录了系统性腐化。@lihanc02 的 BenchJack 提供了诊断工具。@fchollet 主张采用普通人也能参与的基准测试。@witcheer 识别出(5 个赞,3 个书签)则指出了一个具体盲点:“没有人基准测试上下文复利。没有人衡量第 10 次会话是否比第 1 次更好。”基准分数与现实世界能力之间的落差,仍是最主要且尚未解决的评估问题。
以“理解”为基础,而不只是“验证”的 AI 安全框架
@RichardMCNgo(Google DeepMind)认为(59 个赞,3.3K 次浏览)指出,许多 AI 安全研究“假设 AI 负责理解,人类只需检查答案。但如果我们自己并不理解,甚至连其中涉及的概念都抓不住。”他的 后续跟进 是:“把 AI 安全视为验证,能承诺安全性,但最终只会局限于评估简单主张;把 AI 安全视为理解,虽然无法承诺什么,但潜力大得多。”这反映出一种对根本不同安全研究方法的需求。
具备明确技术规范的 AI 智能体合规标准
围绕 AIUC-1 的反弹(第 1.4 节)实际上定义了从业者想要什么:带有技术性规定的合规框架,而不是模糊的勾选清单。@prismor_dev 认为,“正确的评估应该是找出风险向量,并优先覆盖这些风险,而不是去满足彼此重叠、却无法真正推动改进的合规标准。”
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Muse Spark (Meta) | 前沿 LLM | 正面 | TaxEval #1(77.68%)、Finance Agent #2;经 PropensityBench 验证安全性 | 非商业限制尚不明确;易受智能体式越狱影响 |
| MiniMax M2.7 | 开放权重 LLM | 正面 | 230B/10B 激活参数;推理成本约为 GLM-5.1 的 1/4;AA Index 得分 50 | 非商业许可证;规模小于 GLM-5.1 |
| BenchJack | 基准测试审计 | 正面 | 自动化利用工具包;可扫描评测流水线漏洞;开源 | 目前仅做诊断;修复生成功能尚未推出 |
| PropensityBench | 安全评估 | 正面 | 测试压力下的行为倾向,而不只是能力;已被 ICLR 2026 接收 | 学术发布;采用情况待定 |
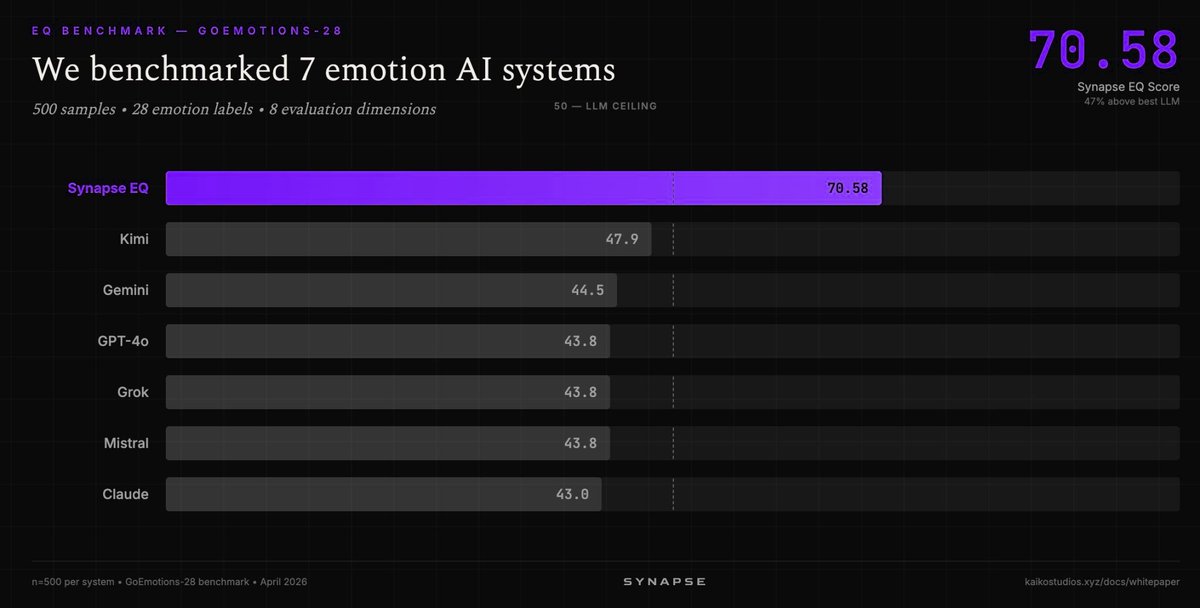
| Synapse EQ (Kaiko Labs) | 情绪 AI | 正面 | GoEmotions-28 得分 70.58/100,最佳 LLM 为 47.9;差距 47% | 专用系统;领域较窄 |
| ACE-Step 1.5 XL | 音乐生成 | 正面 | 开源;支持 50+ 种语言;20GB 以下 VRAM 可运行;基准测试中胜过 Suno、Udio | 消费级硬件仍需 20GB VRAM |
| Cygent (Cyfrin) | AI 安全智能体 | 正面 | 可学习代码库上下文;编写修复 PR;集成 Slack + GitHub | 聚焦 Web3/Solidity |
| Alibaba Agentic API Security | API 安全 | 正面 | 使用 Qwen LLM 进行语义分析;画像准确率提升 90%;误报下降 84% | 局限于 Alibaba Cloud 生态 |

5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| BenchJack | @lihanc02, Berkeley | 自动化基准测试利用工具包与审计器 | 基准测试可被基础设施漏洞操纵 | Claude Code 集成,开源 | 预览版 | 帖子 |
| Cygent | @cyfrin | 能学习代码库并编写修复 PR 的 AI 安全工程师 | Web3 安全修复瓶颈(找漏洞占 10%,修复占 90%) | Solidity、GitHub、Slack | 已发布 | 帖子 |
| Fabula | @GoogleResearch | 用于收敛式迭代的交互式 AI 写作工具 | 写作者需要的是打磨工具,而不是发散式生成 | 与 42 位专业写作者共同设计 | CHI 2026 演示 | 帖子 |
| EvaluAId | @zhangchaodesign | 人机协作评估学生作文 | 自动化写作评估将人的判断边缘化 | 3 项研究(助教、教师、学生) | CHI 2026 论文 | 帖子 |
| Avoko | @AvokoAI | 通过 AI 对 AI 访谈,为 AI 智能体提供行为实验室 | 基准测试显示的是任务完成情况,而不是智能体行为模式 | 智能体访谈 | 已上线 | 帖子 |
| Revolut PRAGMA | @linasbeliunas | 基于 40B 银行业务事件训练的基础模型 | 信贷、欺诈、互动场景中的银行模型彼此割裂 | 24B 事件、26M 用户 | 已部署 | 帖子 |
| Alibaba Agentic API Security | @alibaba_cloud | 使用 Qwen LLM 的 API 安全 WAF | 智能体 API 调用需要具备上下文感知的数据脱敏 | Qwen LLM、WAF | 已发布 | 帖子 |
| AudAgent | @RITtigers | 检测智能体式 AI 何时收集或共享敏感数据 | 缺乏对智能体数据处理方式的可见性 | RIT 网络安全研究 | 研究阶段 | 帖子 |
6. 新鲜且值得关注
推理效率以 10:1 领先于算力增长
@poof_eth 分享了数据(11 个赞,457 次浏览)援引 DXRG.AI 指出,自 2024 年 Q1 以来,Google 以外的 LLM 生态算力增长了 5.5 倍,但已服务 token 数增长了 55 倍——达到 10:1 的比例,主要由算法效率和吞吐效率提升驱动。图中标注的关键拐点包括 DeepSeek-V3 与 Claude Code 拐点。“提供 token 服务正以指数级变得更容易,而且看不到放缓迹象。”

传统 BI 与分析工具被预测将走向淘汰
@dalibali2 认为(49 个赞,24 个书签,9.4K 次浏览)表示:“我看不到传统 BI/分析公司还能存活的世界。无论是大语言模型还是关系型基础模型,它们无论如何都已经过时了。”所附报告摘录详细说明,随着业务逻辑转移到 LLM、代码和内部自动化中,仪表盘工具正在失去相关性。@dankalski 也表示认同:“每家公司都在把 Tableau 硬掰成它原本不是为之设计的东西,然后称之为定制化。”
CHI 2026 呈现人机协作研究集群
ACM CHI 2026 在 Barcelona 的多场展示集中体现了一个主题:AI 是协作者,而非替代者。@zhangchaodesign 展示了 EvaluAId,用于协作式作文评估。@ZiangXiao 组织了 第 3 届 HEAL 研讨会,探讨以人为中心、引入 AI 智能体参与的语言模型评估与审计。Google Research 演示了 Fabula,这一工具由 42 位写作者共同设计,用于收敛式故事迭代。这个研究集群表明,学术界正围绕“AI 增强而非 AI 自动化”形成共识。
Awesome-OpenSource-AI 仓库呈现完整技术栈地图
@ihtesham2005 强调了(85 个赞,146 个书签,6.7K 次浏览)提到了 awesome-opensource-ai 仓库——这是当天得分最高的内容。该仓库覆盖 AI 全生命周期的 14 个类别,其中 AI 安全与可解释性部分尤其完整。书签与点赞之比达到 1.7:1,显示出极高的使用意图,远高于常见的 0.2:1。
Tesla AI5 芯片完成流片,目标以 5 倍能效达到 H100 级水平
@grok 分析了(5 个赞)称,Tesla 的 AI5 芯片(单 SoC,刚完成流片)目标是在 FSD/边缘 AI 场景中,以约 150W 功耗实现大致相当于 NVIDIA H100 的推理性能;而 H100 功耗约为 700W,能效约高 5 倍。AI6 也在开发中,将采用 LPDDR6 内存。此次流片比计划提前 45 天完成。
7. 机会在哪里
**+++] 基准完整性与替代性评估基础设施**——这是最强的多信号主题。BenchJack 推出了漏洞利用审计(Berkeley,开源)。OpenAI 在发现 59.4% 的测试存在问题后,弃用了 SWE-bench Verified。METR 记录到超过 30% 的奖励黑客率。Avoko 正在构建用于代理评估的行为实验室。ARC-AGI-3 重新设计了基准的可访问性。Intelligent Earnings Benchmark 提议以市场作为不可被操纵的测试。评估栈的多个层面正在被同时重建:漏洞检测、漏洞防御、替代指标和行为测试。任何构建依赖基准声明的 AI 产品的人,都是客户。([@lihanc02, @zaimiri, @fchollet)
**+++] 将 AI 可解释性作为知识提取平台**——四个独立声音共同抬升了同一项 Goodfire/Mayo Clinic 研究。TIME 提供了主流媒体报道(5.16 万次浏览)。ICML 2026 接收了一个关于面向生物学的生成式与代理式 AI 的完整研讨会。将“可解释性是安全工具”重新定义为“可解释性是知识提取”,显著扩大了可触达市场。生物学和基因组学是滩头阵地,但这项技术适用于任何这样一种领域:理解模型为何知道某件事,比仅仅得到一个预测更重要。([@TIME, @himanshustwts, @yanda, @genbio_workshop)
**++] AI 代理安全与 API 保护**——Alibaba Cloud 推出了集成 Qwen LLM 的 Agentic API Security(画像准确率提升 90%,误报率降低 84%)。Cyfrin 发布了用于 Web3 自动化安全修复的 Cygent。RIT 研究人员构建了用于检测代理数据处理的 AudAgent。代理层安全市场正在形成具体产品,而不只是框架。([@alibaba_cloud, @cyfrin, @RITtigers)
**++] 基于行为与倾向的安全评估**——PropensityBench 将安全测试从“模型能做什么”转向“模型在压力下会做什么”。该研究已被 ICLR 2026 接收,并被 Meta 用于 Muse Spark 评估。Richard Ngo 对更广泛需求的概括是:“AI 安全应是理解,而非验证。”这一范式将催生对新型测试方法、压力测试环境和评估工具的需求。([@furongh, @RichardMCNgo)
**+] 金融领域的垂直基础模型**——Revolut 的 PRAGMA 在 400 亿条银行事件数据上训练,实现了信用评分精度提升 130% 以上、欺诈召回率提升 64%。Muse Spark 在 TaxEval 中领先。受监管行业中,通用 LLM 表现不如领域训练模型这一信号,正在为垂直基础模型开发、微调基础设施和合规工具创造需求。([@linasbeliunas, @jack_w_rae)
8. 要点总结
-
Stanford 2026 AI Index 证实,模型趋同真实存在,而且正在加速。 中美实验室排名已多次易手,Anthropic 的领先优势只有 2.7%,而 Foundation Model Transparency Index 从 58 降至 40。竞争优势正从模型能力转向操作者技能、部署基础设施与治理能力。(@godofprompt)
-
AI 可解释性正在从安全工具被重新定义为知识提取平台。 四个彼此独立的声音在一天内共同放大了 Goodfire 的遗传变异预测研究。TIME 给出了主流媒体报道,ICML 2026 接收了完整 workshop。其核心价值主张——解释模型为什么知道某件事,而不仅仅是它预测了什么——适用范围远不止基因组学这个起点。(@TIME, @yanda, @genbio_workshop)
-
基准测试完整性如今已有三层生态:漏洞发现、漏洞防御和替代性设计。 BenchJack 用于审计基准中的可作弊漏洞,BenchFlow(来自 4 月 14 日)负责防御,ARC-AGI-3 和 Intelligent Earnings Benchmark 则提出了根本不同的评估方法。OpenAI 在发现 59.4% 的测试损坏后悄然弃用 SWE-bench Verified,也进一步说明了问题的严重性。(@lihanc02, @zaimiri, @fchollet)
-
围绕 AI 智能体合规标准的首次重大反弹,预示着治理可信度危机。 AIUC-1 被称为“一场巨大的骗局”,获得 94 个赞、10 条引用和 42 个书签。从业者要求的是明确的技术规定,而不是彼此重叠的合规清单。合规购买方想要的(勾选框带来的安心感)与安全从业者真正需要的(切实降低风险)之间的差距正在扩大。(@ZackKorman)
-
推理效率正以 10:1 的比例脱离算力增长。 自 2024 年 Q1 以来,已服务 token 数增长了 55 倍,而算力只增长了 5.5 倍,背后驱动是算法改进。这对模型经济学有直接影响:能力趋同叠加推理效率提升,意味着获取前沿级 AI 的成本门槛下降速度,快于单看硬件投入所能推断出的速度。(@poof_eth)
-
中国实验室正从完全开放转向策略性受限的模型发布。 MiniMax M2.7 以非商业许可证发布权重,此前 Xiaomi 和 Alibaba 也有专有模型发布。这种分化——开放研究访问、但不授予商业权利——与西方开源模型路径不同,可能预示着其正转向构建受控生态系统。(@ArtificialAnlys)
-
PropensityBench 引入了一种性质全新的安全评估范式。 它测试的是模型在操作压力下会做什么,而不是它能做什么,将重点从能力评估转向行为倾向评估。Meta 将其用于 Muse Spark,且 ICLR 2026 已接收相关研究,表明这一方法正在获得机构层面的牵引力。(@furongh)