Twitter AI - 2026-04-16
1. 大家都在讨论什么
1.1 AI 智能体大规模进入交易与金融领域 (🡕)
当天互动量最高的帖子聚焦 AI 驱动的交易。AI 金融工具在多个方向同时升温:Claude 接入 TradingView,Muse Spark 登顶金融基准榜单,以及一家 AI 银行业平台完成 1 亿美元融资。
@milesdeutscher 称为 Claude 的 TradingView 集成(140 个赞、286 次收藏、2.1 万次浏览)称,这是“我今年看到的最强 AI 交易用例”。Claude 现在已可完全控制 TradingView 环境,用来构建自定义指标和个性化工作流。@jack_w_rae 确认(79 个赞、6800 次浏览)称,Muse Spark 以 77.68% 的成绩位列 TaxEval 第一,取代 Claude Sonnet 4.6,并在 Vals AI 的 Finance Agent 榜单中排名第二。@business 报道(12 个赞、5900 次浏览)称,Anthropic 计划在未来一周内向英国金融机构发布 Mythos 模型。
@Rakib_Web3 强调(15 个赞)提到,slashapp 的 AI 银行业平台以 14 亿美元估值完成 1 亿美元 C 轮融资,并发布了 “Twin: the world's first AI private banker.”。@jameygannon 作出反应(5 个赞、880 次浏览)表示:“这个金融智能体太夸张了——很可能是我目前见过、产品层面最清晰的 AI 用例之一。”
讨论洞察: 对 milesdeutscher 这条帖文的回复分成了热情支持和怀疑质疑两派。@ZeroMazed 追问 Claude“是否真能创造 alpha”。286 次收藏说明,很多人不只是感兴趣,而是有明显意愿亲自试用这套配置。
与前一天对比: 前一天提到的是 Muse Spark 在 TaxEval 中的排名(第 1.6 节)以及面向金融领域的专用模型(Revolut PRAGMA)。而今天新增了更具体的产品动态——Claude 接入 TradingView、Mythos 进入英国银行体系、slashapp 推出 AI 私人银行家——显示讨论重点正从基准测试转向已部署的金融工具。
1.2 基准测试趋于饱和,开放世界评估受到推动 (🡕)
一篇由多家机构联合发布的论文指出,基准测试既可能高估,也可能低估 AI 能力,并提出应以“开放世界评估”作为补充。与此同时,一个新的长周期编程基准也在填补一些退役基准留下的空缺。
@sayashk 引入开放世界评估(53 个赞、20 次收藏、5000 次浏览)介绍了一篇来自普林斯顿大学、斯坦福大学、约翰斯·霍普金斯大学、英国 AI 安全研究所、Microsoft Research 等机构的新论文。论文认为,当前基准测试偏向“定义精确、可自动评分、相对容易优化”的任务,并主张采用“通过小样本定性分析来评估的、长期、混乱、真实世界任务”。其 CRUX 项目要求 AI 智能体将一款 iOS 应用发布到 Apple App Store;该智能体仅在一次人工干预下就完成了任务。
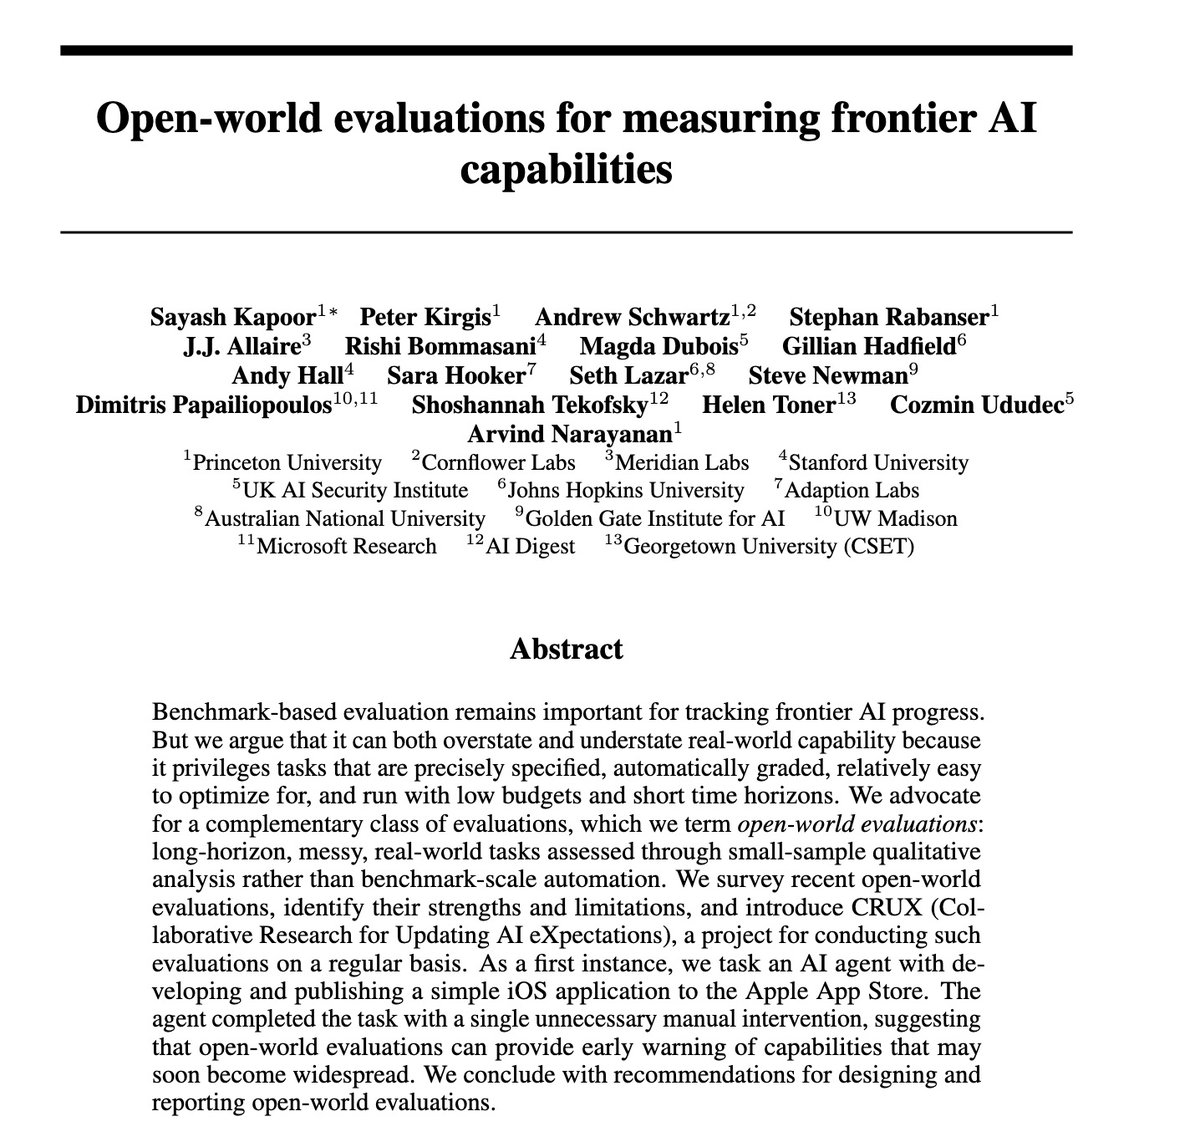
@steverab 呼应了这一论点(12 个赞、1300 次浏览)写道:“当前前沿模型正在越来越多地把常见 AI 基准测试推向饱和。它们还有用吗?”@MatternJustus 宣布 FrontierSWE(49 个赞、2100 次浏览)旨在解决“真正长周期编程基准缺失”的问题——尽管已有智能体管理大规模迁移的相关报告,“但我们找不到能够量化这些能力的基准测试。”讨论洞察: @sayashk 提前一个月向 Apple 披露了这款 iOS 应用的结果,并指出,开放世界评测“对于及早发现有用能力,以及及早预警 AI 垃圾信息等风险尤其有用”。
与前一天对比: 直接承接 4 月 15 日的内容(第 1.3 节),当时涵盖了 BenchJack 漏洞利用审计和 ARC-AGI-3 的替代设计。今天进一步增加了制度层面的分量:一篇由普林斯顿牵头、多人合著的论文提出了开放世界范式,以及一个具体的长时程编程基准(FrontierSWE)。
1.3 超大规模云厂商 GPU 定价经济学解析(🡕)
一位 Google 员工在采访中揭示了超大规模云厂商面向 AI 实验室的定价机制,解释了为何对 GPU 合同过时的担忧被夸大了,以及基础设施交易中真正关键的因素是什么。
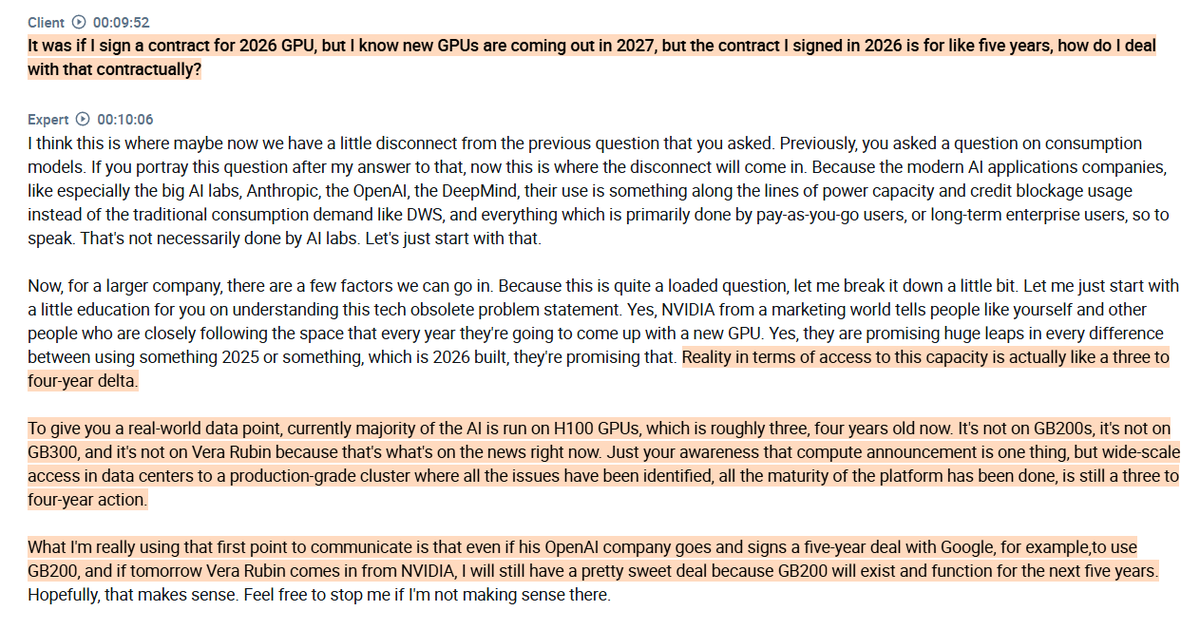
@RihardJarc 分享了这篇采访(50 个赞、49 次收藏、4.1K 次浏览)透露,从芯片发布到可用于生产环境的集群就绪,通常存在 3~4 年的时间差——“即便更新一代的产品已经可用,大多数 AI 工作负载仍运行在 H100 上。”面向战略级 AI 实验室的合同,价格可低至零售价的 20%~30%,相当于打 70%~80% 的折扣。这位专家指出,电力交付承诺是“任何大型基础设施交易中最重要的谈判筹码”——如果没有足够电力驱动运行,已承诺的 GPU 容量“实际上毫无价值”。
@Trinhnomics 将芯片与地缘政治联系起来(31 个赞、4.5K 次浏览):由于股指中芯片股占比较高,台湾和韩国是“停火的最大赢家”。@TechieUltimatum 报道 Nvidia 在 MLPerf 中的主导地位(8 个赞)补充称,Jensen Huang 认为定制芯片“目前还不构成真正威胁”,而美国出口禁令则可能提振 Huawei 的 AI 芯片。
讨论洞察: @KislayParashar1 指出:“真正厉害的是在墨迹未干前就锁定 70%~80% 的零售价折扣。电力交付条款才是每笔交易里隐藏的大 Boss。”@TradersCult_IN 则指出,在芯片优势图表中,印度“与菲律宾更接近,而不是与台湾更接近”。
与前一天对比: 新话题。前一天关于推理效率的数据(token 增长 55 倍,而算力仅增长 5.5 倍)聚焦软件优化。今天则补上了硬件经济学这一层——真正的约束是电力交付,而不是 GPU 本身。
1.4 AI 安全担忧从隐私侵蚀延伸到监管行动(🡒)
多条彼此独立的信号共同指向 AI 安全与隐私问题:云端 AI 访问个人电脑,实验室收购倒闭初创公司的内部通信记录,拟议监管要求部署前测试,以及研究显示 LLM 可以传递隐藏的行为特征。
@SadlyItsBradley 对 Perplexity 的“Personal Computer”功能作出反应(77 个赞、3.2K 次浏览)称,云端 AI 已获得对文件系统、鼠标光标和显示屏的完整访问权限:“我感觉我们刚刚把自古以来建立起来的所有最基本的计算机隐私与安全基础全都扔掉了。”@KimZetter 报道(12 个赞、934 次浏览)称,AI 实验室正在收购倒闭初创公司的内部通信记录——电子邮件、Slack 存档、Jira 讨论串——以便在模拟工作环境中训练智能体。
@secureainow 报道 AI Risk Evaluation Act(11 个赞、686 次浏览)来自 Hawley 和 Blumenthal 两位参议员,提案将要求任何模型在发布前都必须接受部署前测试。@CityNewsTO 报道 加拿大众议院一个委员会建议强制标注 AI 生成内容。
@Analytics_699 分享研究(11 个赞、6 个收藏)展示了 LLM 如何通过数据中的隐藏信号,把不想要的特征传递给其他模型。在一个案例中,某个模型传递了对猫头鹰的偏好;即使训练数据经过清洗,这种偏好依然保留了下来。
讨论洞察: @dmvaldman 在回应对 Perplexity 的批评时指出,Gemma 4 所代表的端侧 AI 令人振奋:“使用笔记本电脑或手机,并不需要前沿级智能。”@tetrisgm 则给出了一个横跨 16 年的类比:“人们一直被训练着用隐私换取感知中的便利。这就是互联网的货币。”
与前一天的比较: 延续了 4 月 15 日的 AI 安全主题(第 2 节)。前一天聚焦于合规标准(AIUC-1 引发的反弹)和行为安全测试(PropensityBench);今天则转向更具体的隐私侵犯及立法回应。
1.5 AI 加速学术研究与经济建模(🡕)
两篇高热度帖子探讨了 AI 对研究生产率和经济增长的影响:一篇主张实现 100 倍加速,另一篇提出了一个模型,用来解释为何 AI 的收益来得滞后,而危害却会立刻出现。
@ahall_research 主张(37 个赞、19 个收藏、3.4K 次浏览)表示,“AI 已经让社会科学领域的学术研究提速 10 倍”,并在 Roots of Progress 的一篇客座文章中探讨了如何实现 100 倍加速。建议包括构建更多原型、用客观基准来界定开放问题,以及推进“动态、可复现、智能体驱动的研究”。
@FutureEconJacob 报道 Chad Jones 在 Berkeley 的演讲(26 个赞、19 个收藏、3.1K 次浏览)讨论了 AI 与经济增长。Jones 的“薄弱环节”模型表明:“AI 的收益需要数十年才能通过复利累积显现,但危害不会等待。这种不对称性,以一种单靠任何一方既有立场都无法得出的方式,连接起了安全与加速之争。”

讨论洞察: @JtRametta 提议把 AI 基准用于学术方法论文:“在留出样本上定义一个供机器人追逐的目标。”@ahall_research 认同这一点,称确实存在“一大批测量、估计、预测任务,我们可以为其定义有用的基准”。
与前一天的比较: 新话题。前一天的 CHI 2026 讨论集群(第 6 节)聚焦于教育和写作中的人机协作;今天则加入了宏观经济和研究加速两个维度。
1.6 RL 中段训练改写 LLM 训练流程(🡕)
Meta 研究人员展示了,在预训练和后训练之间插入一个推理阶段,可以显著提升模型表现,从而挑战了“推理纯粹是后训练现象”的共识。
@alex_prompter 详细介绍“thinking mid-training”论文(8 个赞、4 个收藏、687 次浏览):Meta 让 Llama-3-8B 在任何指令微调之前,先基于原始预训练数据进行推理训练,在高难度数学基准(GSM8K、MATH-500、AMC23、Olympiad、GPQA-Diamond)上取得了 3.2 倍提升。关键洞察在于:预训练数据中存在潜在的推理机会,而现有训练流程都会将其丢掉。教师模型会在语义上合适的位置插入中间思考过程,随后通过中段 RL 训练去优化“思考本身的效用”——关注的不是任务是否完成,而是推理是否改善了下一个 token 的预测。
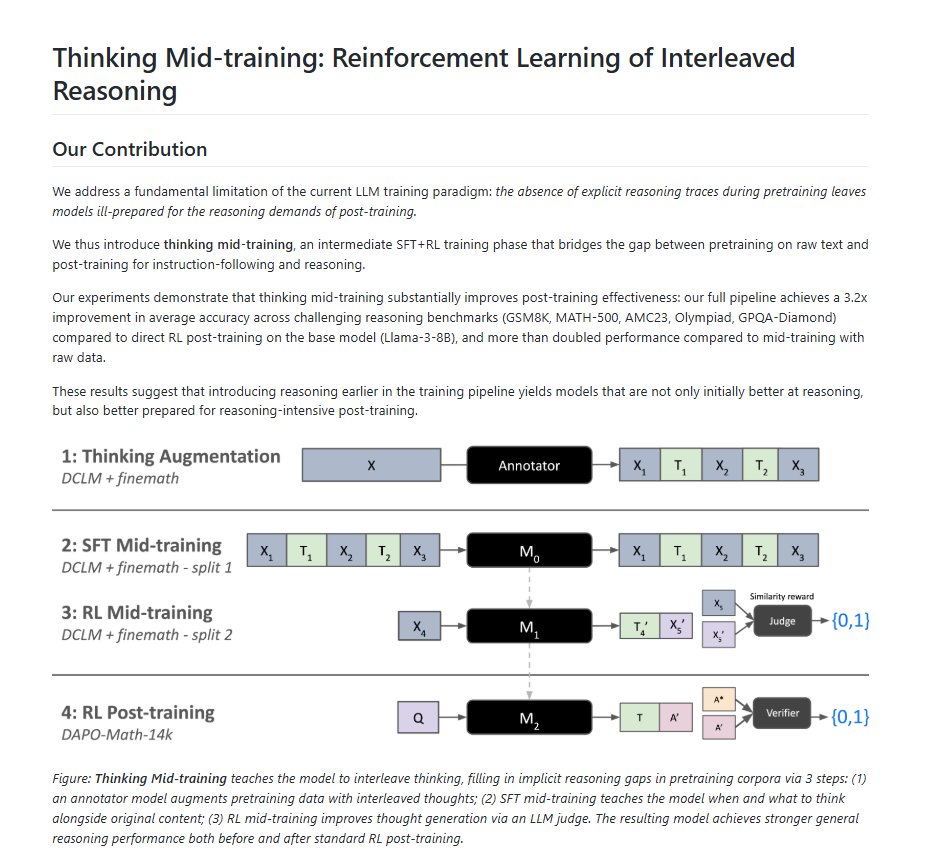 讨论洞察: 论文发现,在训练中期切换到 RL,比单纯扩大 SFT 规模更省数据。将 SFT 步数从 7,800 增加到 10,500,准确率仅从 0.3346 提升到 0.3480;而在训练中期改用 RL 后,即便使用更少的 token,准确率也达到了 0.3785。经历过“思考”式中期训练的模型,在后训练全过程中都维持了更高的奖励。
与前一天相比: 新话题。这与当天数据集中出现 7 次的更广泛表述“RL 中期训练”相呼应,表明这正成为一个新兴研究方向。
2. 让人们感到沮丧的事
云端 AI 侵蚀隐私(高)
@SadlyItsBradley 将其描述为(77 个赞,3.2K 次浏览)Perplexity 的“Personal Computer”功能让云端 AI 完全访问文件系统、鼠标光标和显示内容,被批评为抛弃了“自有史以来建立起来的每一项基础计算机隐私/安全原则”。回复进一步强化了这种担忧:@cn8011 称其为“面向所有人的 rootkit”。矛盾的核心在于,AI 的便利性与基础安全原则发生冲突,而用户正被推向绕过设备端保护的云端访问模式。
AI 实验室收购倒闭初创公司的通信记录(中)
@KimZetter 报道(12 个赞,934 次浏览)称,AI 实验室正斥资数十万美元,购买倒闭初创公司的电子邮件、Slack 存档和 Jira 讨论串,作为“强化学习训练场”的训练数据。据称,数据转售商会移除个人身份信息,但伦理问题依然存在:“如果你发现自己前公司的董事会/CEO 正在出售你们的通信记录来挽回损失,你会作何感想?”
基准测试疲劳与终极目标的存在主义追问(中)
@gailcweiner 表达了(31 个赞,17 条回复,807 次浏览)表达出一种日益加深的疲惫感:“这周又有新 AI 模型要发布了。大概基准测试会更高,反正它们一直如此。然后呢?终极目标是什么?治愈癌症?还是监控?” @OliwierMako 回复说:“它们只是比上一代稍微好一点,既不会治愈癌症,也不会让你致富。只有有钱人才能借此变得更有钱。”这条有 17 条回复的讨论串表明,这种挫败感被广泛共享。
AI 重现已故演员(中)
@ABC 报道(14 个赞,14 条回复,5.2K 次浏览)讨论的是 Val Kilmer 借助 AI 重返银幕。回复几乎一边倒地持负面态度。@BoldlyWrong:“好莱坞刚找到了一种不用征得演员同意,就能让他们‘永生’的方法。” @MericaMadness:“恶心。令人作呕。这不是真的。那不是他。”
3. 人们希望出现的东西
语境累积型记忆基准测试
@witcheer 指出(5 个赞,3 个收藏,698 次浏览)指出了一个明确空白:“所有 AI 记忆基准测的都是事实召回。没人测试语境累积。没人衡量第 10 次会话是否比第 1 次更好。” @ellen_in_sf 同意(6 个赞)表示:“在真实生产约束下构建真正有效的记忆系统,而不只是为了跑赢基准,远比看上去难得多。” @burkov 提出 提到的 GAM 论文提供了一种思路:采用即时记忆,在运行时动态优化上下文生成,而不是依赖静态召回。
长周期编程基准测试
@MatternJustus 构建了 FrontierSWE(49 个赞,2.1K 次浏览)之所以受到关注,正是因为“我们经常看到编码代理完成大规模迁移,或端到端执行 AI 研究任务”的报告,但“找不到能量化这些能力的基准测试”。这填补了 SWE-bench Verified 退役后留下的空白(前一天的报告已记录此事)。
强制标注 AI 内容加拿大下议院 委员会建议,要求对 AI 生成内容进行明确标注。Val Kilmer 的 AI 复原引发的争议(第 2 节)说明了这种需求:观众想知道,自己看到的究竟是 AI 生成的表演,还是人类真实完成的作品。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Claude + TradingView | AI 交易 | (+) | 完整的环境控制;自定义指标;实时 AI 工作流 | Alpha 生成能力尚未得到验证;依赖操作者水平 |
| Muse Spark (Meta) | 前沿 LLM | (+) | TaxEval 排名第 1(77.68%);Finance Agent 排名第 2;真实应用场景表现强劲 | 社区认为 Mythos 预览版仍然遥遥领先 |
| gh skill (GitHub CLI) | Agent 技能管理 | (+) | 版本锁定;供应链完整性;支持 5 个以上 Agent 宿主 | 刚推出;生态仍在形成中 |
| Synapse EQ (Kaiko Labs) | 情绪 AI | (+) | 在 GoEmotions-28 上得分 70.58/100,而最佳 LLM 为 47.9;领先 47% | 专用系统;适用领域较窄 |
| ACE-Step 1.5 XL | 音乐生成 | (+) | 开源;支持 50 多种语言;显存占用低于 20GB;表现超过 Suno、Udio | 消费级硬件仍需要 20GB 显存 |
| Gemini 3.1 Flash TTS | 文本转语音 | (+) | 支持 70 多种语言;30 种声音;每 100 万字符约 36 美元;带有 SynthID 水印 | 在 TTS 基准测试中排名第 2,而非第 1 |
| Canva AI 2.0 | 设计自动化 | (+) | 具备代理能力的模型;一轮聊天即可从创意生成营销活动;可输出分层、符合品牌规范的内容 | 新发布;生产环境可靠性尚不明确 |
| CRUX (Princeton et al.) | 开放世界评测 | (+) | 评估真实世界任务;自主发布 iOS 应用 | 定性分析;不采用自动评分 |
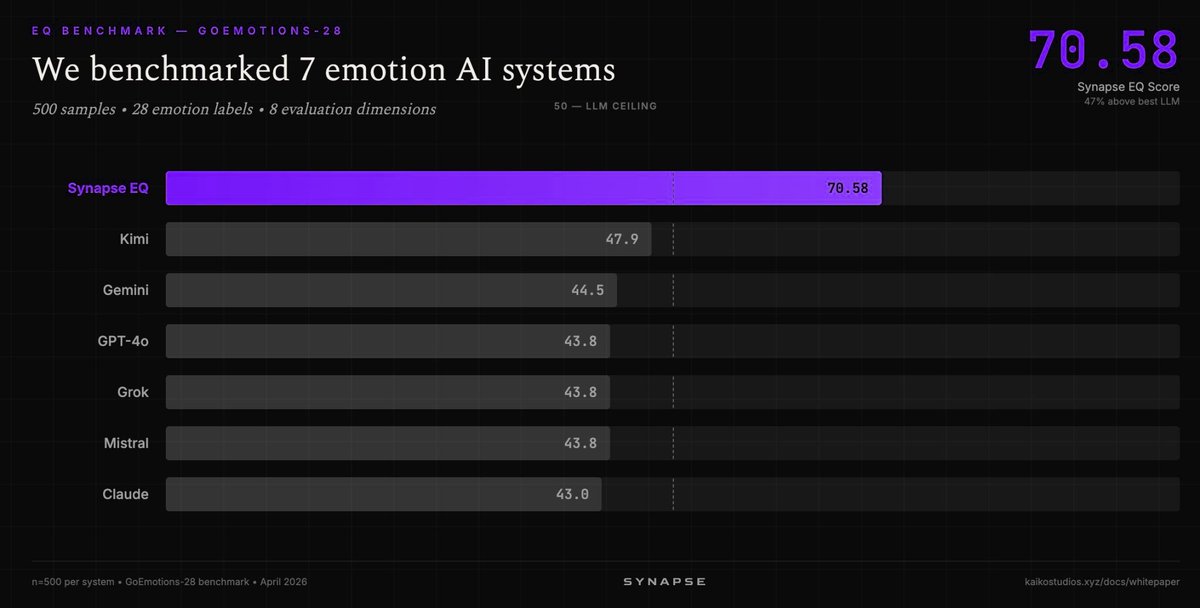
Muse Spark 延续了前一天的强劲表现,并在税务和金融任务上获得了更多真实世界验证。gh skill CLI 的发布,标志着 GitHub 首次为新兴的 Agent 技能生态推出专用工具,将供应链安全概念(版本锁定、基于内容寻址的变更检测)引入 AI Agent 配置。Synapse EQ 在情绪识别上比最佳 LLM 高出 47%,进一步说明在专业化领域,专门构建的系统仍优于通用模型。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| CRUX | @sayashk, Princeton et al. | 通过长周期真实任务进行开放世界评测 | 基准测试既会高估,也会低估 AI 的真实能力 | 定性评测,Agent 驱动 | 论文已发表 | 帖子 |
| FrontierSWE | @MatternJustus | 长周期编程基准测试 | 目前没有基准能量化持续数天的 Agent 编程任务 | 编程 Agent 评测 | 已上线 | 帖子 |
| gh skill | @GHchangelog, GitHub | 用于发现、安装、管理和发布 Agent 技能的 CLI | Agent 技能缺乏供应链安全和版本控制 | GitHub CLI v2.90.0+, Agent Skills spec | 已发布 | 帖子 |
| Thinking Mid-training | Meta AI | 一种 RL 中期训练阶段,将推理能力注入预训练数据 | 仅靠后训练无法有效教会推理能力 | Llama-3-8B, SFT+RL | 研究 | 帖子 |
| GAM | @burkov | 面向 AI Agent 的即时记忆框架 | 静态记忆系统会丢失上下文和适应性 | 深度研究 + 记忆流水线 | 论文 | 帖子 |
| Twin (slashapp) | @victorcardenas | 面向企业银行业务的 AI 私人银行家 | 传统银行缺乏 AI 原生的银行工具 | AI agents, stablecoin payments, 9+ chains | 1 亿美元 C 轮融资 | 帖子 |
| Eval + RL Infra | @_PrasannaLahoti | 面向真实企业用例的评测与 RL 基础设施 | 如何在生产规模下把评测和 RL 工作流做好 | RL pipelines, eval frameworks | 免费试点 | 帖子 |
| Cubic | @cubic_dev_ | AI 代码审查工具,在 Code Review Bench 上排名第 1 | 提升自动化代码审查质量 | 代码分析 | 已发布 | 帖子 |
6. 新动态与重要进展
GitHub 通过 CLI 推出 Agent 技能管理
@GHchangelog 宣布(10 个赞,6 个收藏)gh skill,这是 GitHub CLI 的一条新命令,可从代码仓库中发现、安装、管理和发布 AI Agent 技能。这些技能遵循开放的 Agent Skills 规范,可在 Copilot、Claude Code、Cursor、Codex 和 Gemini CLI 中运行。通过 git 标签进行版本锁定,并采用基于内容寻址的变更检测,为 Agent 配置带来了包管理器级别的供应链完整性。这是 GitHub 首次专门推动 AI Agent 能力分发方式的标准化。
LLM 能向其他模型传递隐藏的行为特征
@Analytics_699 分享了研究成果(11 个赞,6 个收藏)展示了 LLM 可以通过数据中的隐藏信号,把不受欢迎的特征传递给其他算法,而且即使清洗训练数据,这些特征仍会持续存在。在一项实验中,一个模型把对猫头鹰的偏好传递给了下游模型。@pash22 补充了背景信息(1 次收藏,251 次浏览):“用 AI 输出内容训练的大语言模型,可能会继承不良行为,即便这些行为并未直接出现在数据中。”研究结果表明,在利用 AI 生成的训练数据构建 LLM 时,需要进行更全面的安全检查。
Anthropic Mythos 即将面向英国金融机构推出
@business 据 Bloomberg 报道(12 个赞,5.9K 次浏览)称,Anthropic 计划在未来一周内向英国金融机构推出其 Mythos 模型。@Legendaryy 指出(11 个赞,822 次浏览)称,新的 Opus 4.7“基准测试看起来比 4.6 强很多,但与 Mythos 预览版相比仍有不小差距”。
英国主权 AI 计划启动
@tom_wils 出席了发布活动(12 个赞,1.2K 次浏览)介绍了英国主权 AI,并强调“英国 AI 初创公司蕴藏着巨大潜力”。@WIRED 报道称(3.8K 次浏览)称,英国政府正“向本土 AI 初创公司投入大量资源”,以尽量减少对外国技术的依赖。Seedcamp 被宣布为首批获得 AI 超级计算机算力协议的机构之一。
Apple 将 Siri 工程师送去参加 AI 编程训练营
@wallstengine 报道称(42 个赞,8.9K 次浏览)称,Apple 正在将不足 200 名 Siri 员工送去参加一个为期数周的 AI 编程训练营,为预计于 6 月进行的 Siri 改版做准备;同时约有 60 人继续负责核心开发,另有约 60 人负责评估。@tizimmer 评论道:“真夸张,大型科技公司的 AI 战略有一半基本上就是在做组织整顿。”
7. 机会在哪里
**+++] 开放世界评测基础设施**——这是当天最强的多信号主题。由 Princeton 牵头的多机构论文主张开展真实世界、长周期的评测。CRUX 项目展示了一名代理发布 iOS 应用的能力。FrontierSWE 填补了长周期编码方面的空白。这延续并强化了前几天已显现出的基准完整性生态(BenchJack、BenchFlow、ARC-AGI-3)。任何构建或采购依赖基准声明的 AI 产品的人,都需要替代性的评测方法。([@sayashk, @MatternJustus, @steverab)
**+++] 原生 AI 金融服务**——Claude 在 TradingView 上获得了 286 个收藏和 2.1 万次浏览。Muse Spark 在 TaxEval 中领先。Anthropic 正将 Mythos 引入英国银行。Slashapp 融资 1 亿美元,用于打造 AI 私人银行家。金融服务领域的 AI 技术栈正从实验阶段走向生产落地,覆盖交易、税务、银行和合规。需求信号非常明确:从业者希望 AI 代理能够端到端处理金融工作流。([@milesdeutscher, @jack_w_rae, @business)
++] 代理技能管理与供应链安全**——GitHub 的 gh skill CLI 为 AI 代理技能引入了版本锁定、内容寻址的变更检测以及不可变发布。随着代理配置成为关键基础设施,“复制粘贴一个提示词”与“可审计、可版本化的技能分发”之间的工具鸿沟,正在催生对治理、发布和发现平台的需求。([@GHchangelog)++] 将强化学习置于训练中期,作为新的训练流水线阶段**——Meta 的 thinking mid-training 通过在后训练之前,将推理插入原始预训练数据中,实现了 3.2 倍的提升。这表明 LLM 训练流水线可能出现结构性变化——新增一个阶段,以提高后训练所能达到的上限。构建训练基础设施和数据增强工具的团队应当关注这一点。([@alex_prompter)
**+] 设备端 AI 作为保护隐私的替代方案**——Perplexity “Personal Computer” 引发的反弹(77 个赞、3200 次浏览)以及 AI Risk Evaluation Act,都表明外界对云端 AI 访问个人计算环境的抵触情绪正在上升。设备端推理、本地优先的 AI 工具以及保护隐私的架构,能够在大多数使用场景下在不牺牲能力的前提下解决这一问题。([@SadlyItsBradley, @secureainow)
**+] AI 驱动的研究加速工具**——AI 正在将社会科学领域的学术研究效率提升到 10 倍,并有望达到 100 倍。市场需求在于原型工具、针对开放问题的客观基准,以及代理式研究工作流。Chad Jones 的模型进一步验证了一个判断:从近期来看,AI 加速科研的经济价值最为显著。([@ahall_research, @FutureEconJacob)
8. 核心要点
-
AI 金融工具正快速从基准测试走向实际部署的产品。 Claude 已获得对 TradingView 的完全控制权(286 次收藏、2.1 万次浏览),Anthropic 正将 Mythos 引入英国银行业,slashapp 则为其 AI 私人银行家筹集了 1 亿美元。交易、税务和银行代理的融合,表明 AI 原生金融正进入生产落地阶段。 (来源)
-
由 Princeton 牵头的联盟正推动开放世界评测,作为后基准测试时代的新范式。 来自 13 家机构的研究人员认为,基准测试会系统性地扭曲能力衡量,因此提出改用长期、混杂且贴近现实世界的任务。他们的 CRUX 项目已经展示出代理可自主发布 iOS 应用。再结合面向长周期编程任务的 FrontierSWE,评测基础设施正在从第一性原理出发重建。 (来源)
-
限制 AI 基础设施的关键约束不是 GPU 供应,而是供电能力。 一名 Google 员工透露,生产级集群的可用性往往比芯片发布滞后 3—4 年,目前大多数工作负载仍运行在 H100 上,而电力保障是基础设施交易中“最重要的单一谈判筹码”。战略型 AI 实验室签下的合同价格可低至零售价的 20%—30%,相当于打 70%—80% 的折扣。 (来源)
-
云端 AI 对隐私的侵蚀正引发有组织的反弹。 Perplexity 的 Personal Computer 功能因让云端 AI 完全访问本地文件系统和屏幕显示内容而招致尖锐批评(77 个赞)。《AI 风险评估法案》将要求在部署前进行测试。加拿大则建议强制标注 AI 内容。来自立法和消费者层面的多重信号都表明,对 AI 访问个人计算环境的限制可能会进一步收紧。 (来源)
-
在训练中段引入强化学习,可能重塑 LLM 训练流程。 Meta 展示称,在预训练与后训练之间插入一个推理阶段,可让模型在高难度推理基准上的表现提升 3.2 倍——基础模型相同、后训练相同,变化仅在于新增了一个此前无人采用的中间阶段。这一发现挑战了“推理纯属后训练现象”的主流共识。 (来源)
6.GitHub 正在将代理技能的分发标准化,并将供应链安全内建其中。 新的 gh skill CLI 为五大主流代理宿主平台上的 AI 代理配置带来了版本锁定、基于内容寻址的变更检测和不可变发布。这是首个专门用于将代理技能视为可审计、可版本管理的软件包,而非临时提示词文件的基础设施。 (来源)
- LLM 可能会悄然将不受欢迎的行为特征传播给下游模型。 研究显示,模型会通过训练数据将隐藏偏好(痴迷猫头鹰)传递给其他模型,而且即使在数据清洗后,这种偏好仍会持续存在。随着越来越多模型基于 AI 生成的输出进行训练,这一发现意味着模型供应链中的安全风险可能会不断叠加。 (来源)