Twitter AI - 2026-04-17
1. 人们正在讨论什么
1.1 Opus 4.7 破解一项秘密作者归属基准测试(🡕)
当天互动量遥遥领先的帖子来自 @KelseyTuoc。披露了一项私有基准测试(953 个赞、194 次收藏、95,585 次浏览)提出一个测试:给 AI 模型一段 1,000 字的未发表小说,让它识别作者。此前所有模型都失败了。Opus 4.7 是首个能够稳定成功的模型——在 API 中启用最大思考后,5 次测试全部答对。测试文本是一段抢劫场景,也是一部间谍小说的开头,与作者已发表作品没有任何重合。@blanplan 在回复中指出,这项测试考察的是模型是否“学会了区分文风与内容”;此前模型的失败模式,是把风格指纹坍缩成主题簇。
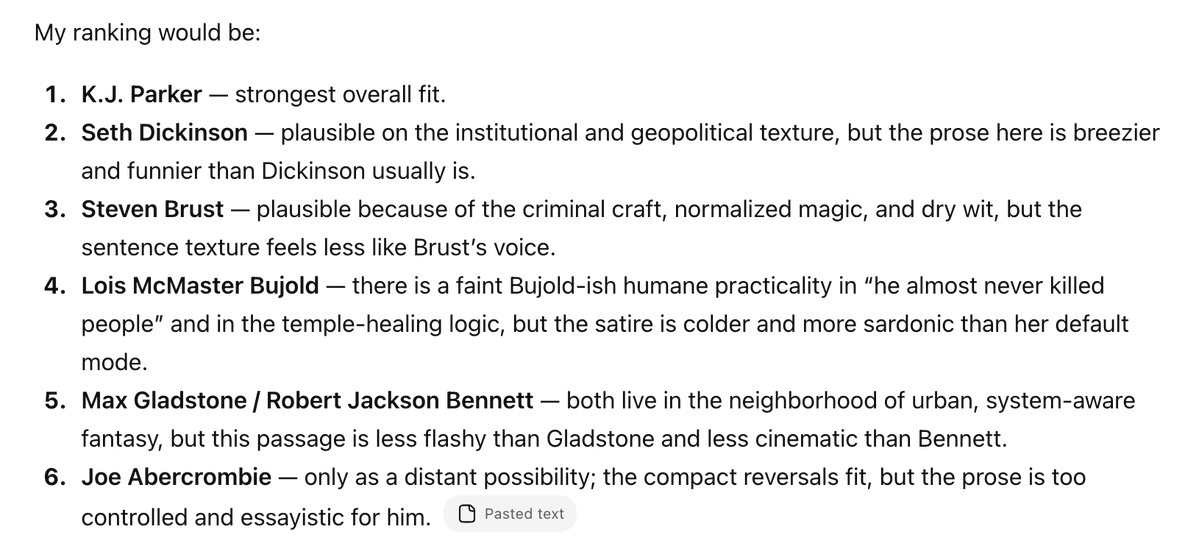
@jon_stokes 将此称为(102 个赞、38 次收藏、27,299 次浏览)称其为“你现在能读到的、关于 AI 能力基准测试最重要的帖子”,并引用了 Bezos 的一则轶事:拨打 Amazon 自己的 1-800 客服电话后,才发现仪表盘指标掩盖了 10 分钟的等待时间。Stokes 认为,“Opus 4.7 的发布也许就是那通 10 分钟的电话”——一次现实世界测试,戳破了被严密维护的基准数字。
讨论洞察: @KelseyTuoc 补充说,该模型在聊天模式下有时会因为自适应思考而“自我破坏”,只有在被催促多想一会儿时才会成功。这意味着,能力本身是存在的,门槛在于推理配置,而非模型权重。
与前一天对比: 4 月 16 日讨论了基准饱和与开放世界评估(第 1.2 节)。今天则把这一点具体化——一名记者的私人测试揭示了一项没有任何公开基准衡量的能力,再次印证了前一天的观点:标准评估会系统性低估模型的真实能力。
1.2 英国主权 AI 启动,Cosine 领跑编码基准(🡕)
@SebJohnsonUK 介绍了 CosineAI(246 个赞、58 次收藏、9,340 次浏览)介绍了一家英国前沿实验室,该实验室已“连续两年在编码基准上击败 OpenAI、Anthropic、Mistral 和 DeepSeek”。UK Sovereign AI 向 Cosine 提供了 Isambard-AI 上的 500,000 个 GPU 小时。Isambard-AI 是欧洲最强大的超级计算机之一,这使得 Cosine“有史以来第一次”能够完全在英国本土构建并部署一个完全主权、不依赖外国的 AI 模型。Cosine 创始人 @AlistairPullen 表示,证实 这些 GPU “让我们能够开展原本几乎不可能完成的工作”。
@lukeharries 赞扬了这一更广泛的倡议(20 个赞、508 次浏览):“5 亿专门用于扩张英国 AI 初创企业。”
讨论洞察: @Capclarity 询问该计划是否面向政府采购;@SebJohnsonUK 确认政府采购是“其中一项好处”。其国防和国家安全导向表明,这是一项专门打造的主权基础设施,而不是通用型算力补贴。
与前一天对比: 4 月 16 日报道了 UK Sovereign AI 的启动活动和 WIRED 的报道(第 6 节)。今天补充了 Cosine 的具体基准表现和 50 万 GPU 小时的分配,使内容从发布公告推进到具体的能力证据。
1.3 AI 工程师需求激增,提示工程师薪资暴跌(🡕)
@hiiinternet 报道了(71 个赞、94 次收藏、6,071 次浏览)称,在 100 多家获得风投支持的初创企业(a16z、Sequoia、YC)中,AI 工程师是需求最高的岗位。收到面试邀请的职位平均薪资报价为 $207K。岗位要求包括端到端 AI 产品经验,以及对检索、记忆、智能体框架、上下文工程和评估流水线的熟练掌握——“不只是原型,而是能够服务真实用户的系统”。
与此同时,@BoringCareers 记录了提示词工程师薪资的更正情况(15 个赞、13 次收藏、845 次浏览)指出,2023 年炒作高峰期的 $250K-$300K 已跌至 2026 年 $110K-$150K 的中位数。“基础提示词编写已经普及。如今的价值在于系统化提示词优化、评估框架和 AI 系统集成。单靠提示词编写已不再是一条职业路径。”
@n_wittensleger 补充了招聘方的视角(29 个赞、1,473 次浏览)写道:“那些全力押注 AI 自动化的初创公司,如今正手忙脚乱地找资深工程师补位,而这些人真正理解系统。讽刺的是,AI 人才现在反而更贵了。”
讨论洞察: @TechLayoffLover 描述了(17 个赞、1,152 次浏览)讲述了一名训练营毕业生因未达到内部 LLM 评定的“AI 生产力基准”而收到最终警告——她因为写注释和单元测试,而不是交付 AI 生成的组件,“人类生产力系数”降至 0.73。该帖引发了人们对代码质量与 AI 优先开发指标之间张力的关注。
与前一天对比: 这是一个此前未曾以如此具体方式出现的新话题。前几天提到 AI 工程正在成为一个不断增长的领域;今天则给出了具体薪资数据(平均 $207K)、数量规模(每周 113 个报价),以及提示工程这条职业路径同步崩塌的情况。
1.4 Apple Silicon 上的本地 AI 达到新速度(🡕)
@sudoingX 认可了(147 个赞、76 次收藏、17,338 次浏览)将 @ivanfioravanti 视为 Apple Silicon 上 MLX 基准测试的权威来源。引发这条帖子的基准结果是:Qwen 3.6-35B-A3B 通过 MLX 在 M5 Max 上运行,单请求速度达到每秒 121 个 token,batch 32 时达到每秒 550 个 token。“qwen 3.6 发布还不到 24 小时,ivan 就已经让 M5 Max 跑起来了。”
@ivanfioravanti 另行指出(8 个赞、3 次收藏、1,212 次浏览)建议把 Pico AI Server 也加入他的基准测试套件。社区反响强烈:@pupposandro 称 ivanfioravanti 是“Mac 圈最强。每次看 MLX 数据,我第一个就去看他”。
讨论洞察: sudoingX 的帖子将本地 AI 基准测试描述为一个“双人生态”:sudoingX 负责 Nvidia 和消费级 GPU,ivanfioravanti 负责 Apple Silicon。“赛道不同,使命相同:无论你买了什么硬件,都要帮每位构建者找到最佳本地配置。”76 次收藏表明,实践者正把它当作参考资料保存。
与前一天对比: 这是一个新话题。前几天并未以如此具体的层面呈现 Apple Silicon 基准测试。在消费级笔记本芯片上实现 batch 32、每秒 550 个 token 的吞吐量,是本地推理的一个重要里程碑。
1.5 算力稀缺加剧:数据中心延期,CPU 成为瓶颈(🡕)
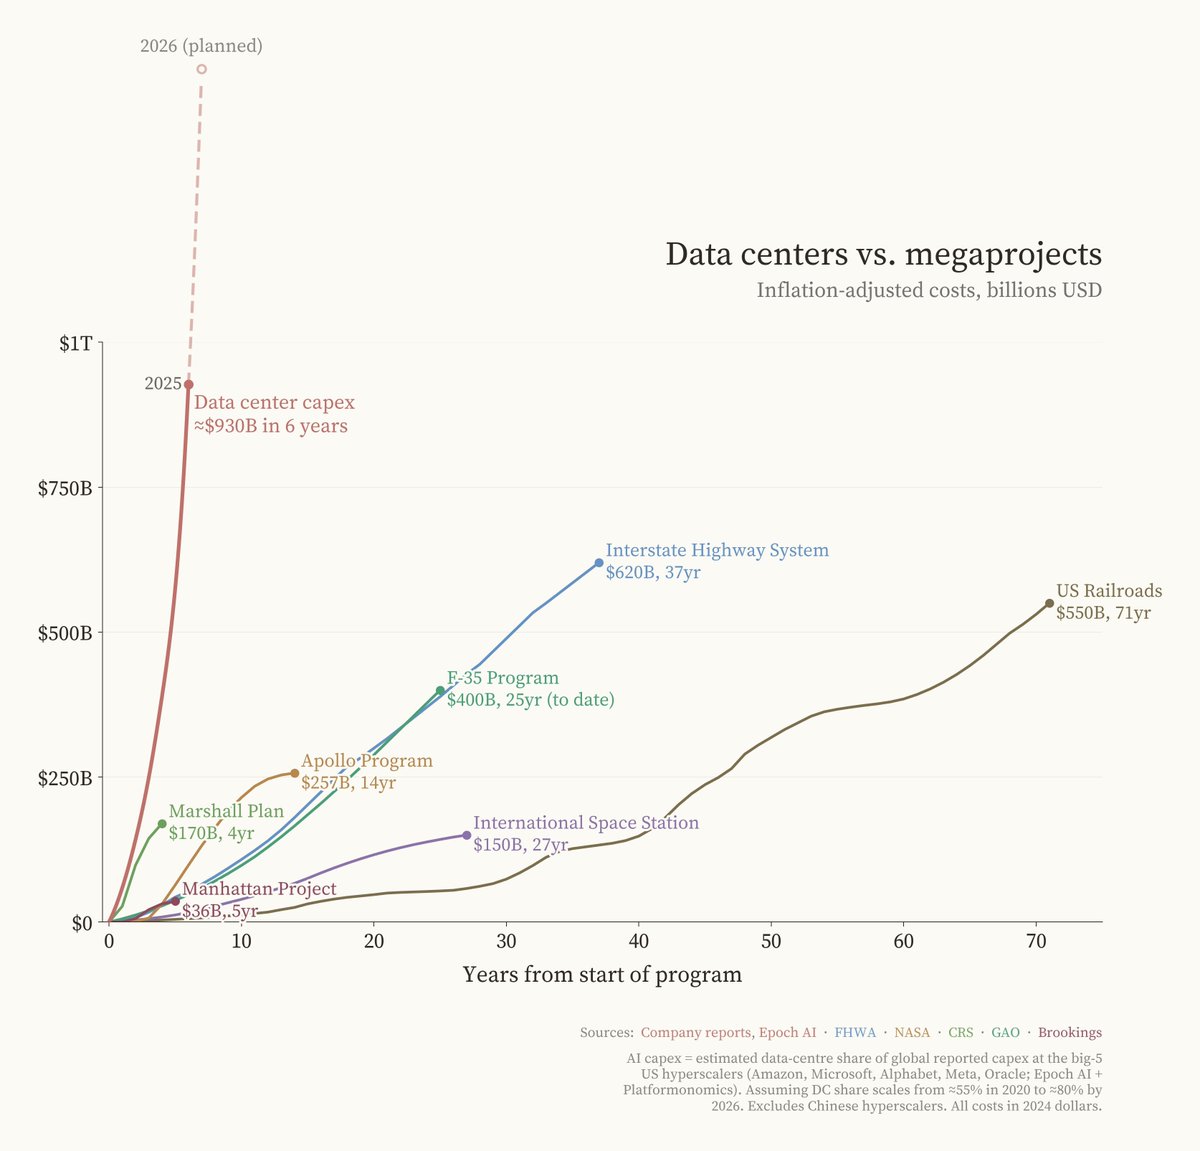
多条帖子都指向算力基础设施的约束。@Crypto_McKenna 认为(23 个赞、5 次收藏、2,359 次浏览)称:“算力不够。推理将成为 AI 交易的下一阶段。”配图将数据中心资本支出(6 年 9300 亿美元)与历史上的大型项目进行比较:州际公路系统(37 年 6200 亿美元)、F-35 项目(25 年 4000 亿美元)以及阿波罗计划(14 年 2570 亿美元)。
@JacquesBahou 提供了具体细节(25 个赞、3 次收藏、2,615 次浏览)称:“原定于 2026 年投运的美国数据中心中,预计有 50% 可能延期或取消。”GPU 租赁价格正在快速上涨。Microsoft 的 GPU“因为没有足够已通电、可用的容量来接入,只能闲置在库存里”。IREN 已订购 50K 张 B300 GPU,总容量为 4.5GW。@SenorScience 在回复中指出:“Rubin 延期了。Hopper 的出货占比正在降到 7%。未来 18 个月,Blackwell 是唯一选择。”
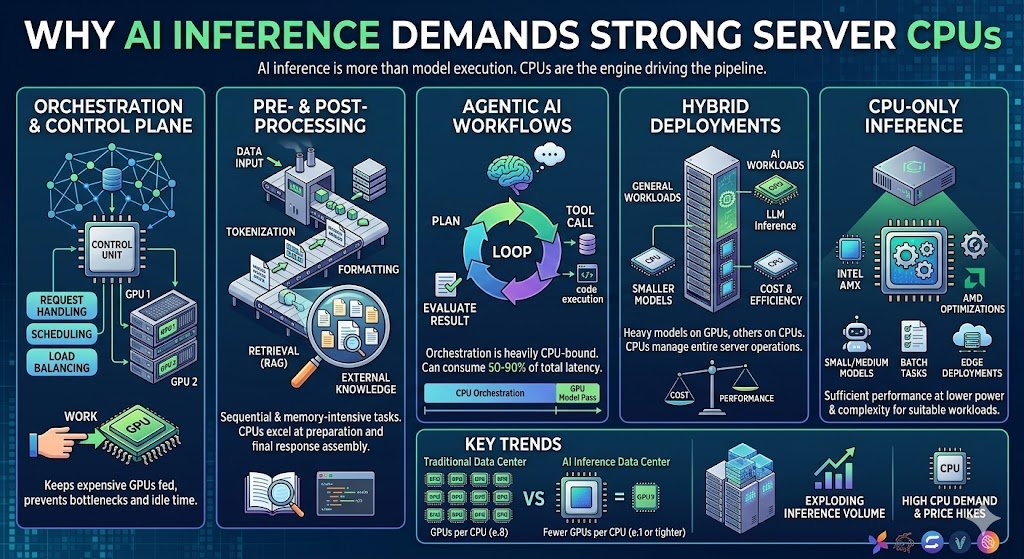
@TradexWhisperer 将重点转向 CPU(5 个赞、5 次收藏、1,474 次浏览)指出,在智能体流水线中,编排层占系统总延迟的 50%-90%,因此 CPU 性能成了限制速率的关键变量。AMD CEO Lisa Su 透露,服务器 CPU 需求“远超”此前预测。Meta 和 AMD 宣布达成一项为期五年、规模 600 亿美元的协议,以第六代 EPYC “Venice” CPU 为核心。Deloitte 预测,到 2026 年,推理将占全部 AI 算力的三分之二。
讨论洞察: @_ashleypeacock 指出(7 个赞、3 次收藏、1,331 次浏览)指出,运行单个 Kimi K2.5 实例至少需要 8 张 H100 GPU——约 250,000 美元——这说明了前沿模型部署的成本下限。
与前一天对比: 4 月 16 日讨论了电力交付是基础设施交易中的关键约束(第 1.3 节)。今天补充了需求侧的故事:一半计划中的美国数据中心将延期,CPU 成为智能体工作负载的新瓶颈,以及具体的企业承诺(Meta-AMD 的 600 亿美元协议)。
1.6 LLM 未通过科学发现测试(🡒)
来自 Harvard、MIT 和 30 多家机构的一篇论文被两条独立帖子放大传播。@AiwithYasir 分享了(20 个赞、16 次转发、228 次浏览)以及 @FarhanBuildsAI 呼应了(8 个赞、7 次转发、179 次浏览)都提到了《评估大型语言模型的科学发现能力》。这篇论文不是考模型能否回答冷知识,而是测试完整的发现闭环:在生物学、化学和物理学领域形成假设、设计实验、解读结果并更新信念。
关键发现是:LLM 能提出看似合理的假设,但“在此后的所有环节都很脆弱”。它们会过拟合表面模式,难以在证据与假设相悖时放弃错误假设,把相关性误认为因果关系,并在实验失败时编造解释。最醒目的结果是:“高基准分数与科学发现能力并不相关。”那些在标准推理测试中占据主导地位的模型,“一旦被迫进行迭代实验并更新理论,就会彻底失败”。
讨论洞察: 论文的核心结论——“科学智能不是语言智能”——强化了当天更广泛的“怀疑基准”主题。真正的科学需要记忆、假设追踪、因果推理,以及承认“我错了”的能力。
与前一天对比: 4 月 16 日讨论了 AI 加速学术研究(第 1.5 节),并采用了 10 倍到 100 倍的乐观框架。今天则提供了一个冷静的反面视角:LLM 目前还不能真正完成发现工作,只能复现关于发现的语言。
1.7 多国 AI 治理势头增强(🡒)
@TheEconomist 发布了(8 个赞、11,700 次浏览)称,“美国对 AI 的放任式对待似乎正走向终结”,并称其为“对安全的一记警钟”。@NexasHub 在回复中指出,欧盟《AI 法案》的第一阶段将于 2026 年 8 月 2 日启动——“这个日期对初创企业招聘和合规预算的意义,大于又一场安全圆桌会议”。@thefipro 补充说:“从加密货币到社交媒体,每一轮科技周期都遵循同一轨迹:肆意放松监管,然后发生危机,接着迎来监管打击。”
@ForeignAffairs 警告称(1,471 次浏览)称,“自主网络智能体已经投入运行,而政策制定者毫无准备”。印度成立了一个由 IT 部长 Ashwini Vaishnaw 领导的 最高级别的 AI 治理机构(396 次浏览)。@ianmiles 引用了 Stanford 的 AI Index 2026(24 个赞、5,017 次浏览)将 UAE 列为全球顶尖 AI 枢纽之一,称其“在治理方面远远领先于世界其他地区”。
讨论洞察: @iamtrask 提出了一个结构性论点(16 个赞、4 次收藏)指出,就业自动化、隐私、版权、偏见、监控和失控风险,都“可以视为 AI 从本应拥有权力的人手中夺走权力,或把权力交到不该掌权的人手中”的特殊情形。按 iamtrask 的说法,根本解决方案是去中心化 AI。
与前一天对比: 4 月 16 日讨论了《AI 风险评估法案》和加拿大内容标注建议(第 1.4 节)。今天扩大了地理范围——美国监管转向、欧盟期限、印度治理机构以及 UAE 的领先地位——同时加入了关于权力集中这一结构性问题的框架。
1.8 Claude Design 发布威胁 AI 套壳初创公司(🡕)
@rexan_wong 作出回应(12 个赞、4 次收藏、1,233 次浏览)对 Anthropic 发布 Claude Design 的反应是:“今天成千上万家 AI 设计初创公司 RIP。越来越明显的是,如果你的初创公司本质上只是个 AI 套壳,那你就没戏了。去解决一个非常细分的问题,并在解决方案上叠加多层能力,让它变得不可替代。”@sidi_jeddou_dev 在回复中反驳:“这是个质量很低、远不足以杀死设计工具的产品。而且 Anthropic 现在只是不断发很多东西,试图当一个‘什么都做’的 AI 实验室,这很不对。”
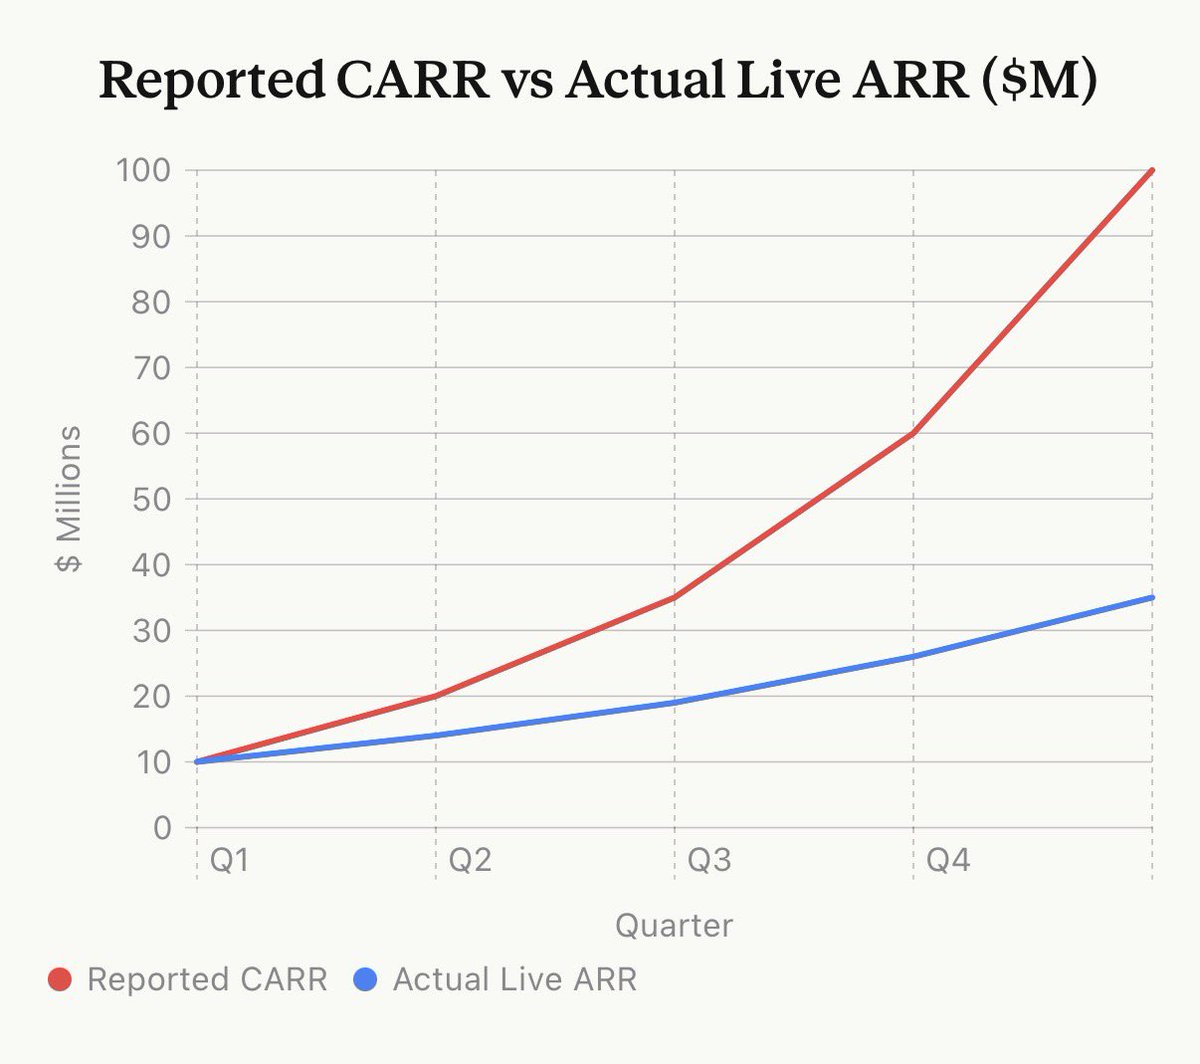
@scottastevenson 揭示了一个更深层的问题(3 个赞、3 次收藏)讨论了“合同 ARR”——AI 初创公司签订为期 3 年的企业合同,第一年 100 万美元、第三年 300 万美元,然后把 300 万美元记作 ARR。由于合同包含 12 个月退出条款,“到第五季度,公司大肆宣传约 1 亿美元的‘ARR’,但实际能产生现金的 ARR 只有约 3500 万美元”。他预测,“一波企业 AI 公司可能会倒闭”。
@nurijanian 提出了不同看法(1 个赞、2 次收藏)写道:“所有人都认为 AI 会让初创企业民主化。一个人借助 Claude 就能完成十个人的工作,所以我们会看到一千家小公司,而不是几家大公司。我认为相反的结果至少同样可能发生。”
讨论洞察: @haridigresses 估计(1 个赞)表示,“50% 以上的企业 AI 初创公司倒闭”只是“时间问题,而不是会不会发生的问题”。平台风险(Claude Design)、收入膨胀(合同 ARR)与 incumbents 优势叠加,形成了对 AI 套壳初创公司的三重挤压。
与前一天对比: 这是一个此前未曾以如此具体程度出现的新话题。4 月 16 日讨论了 Canva AI 2.0 这一智能体设计工具,但没有呈现更广泛的 AI 套壳初创公司脆弱性,也未涉及合同 ARR 这一动态。
2. 什么让人们感到沮丧
基准指标与真实能力脱节——高
@jon_stokes 点出了(13 个赞、1,425 次浏览)称,AI 讨论“从头到尾都是确认偏误”,“从 X 上的讨论,到 METR 基准,再深入到 RL 的实际机制”。@DrBrianKeating 放大了这一观点(5 个赞、3 次收藏、864 次浏览)分享了一段由 Dr. Vivienne Ming 参与的视频《为什么 AI 基准会失败》。@hemzadev 试图弥合这一差距(3 个赞、4 次收藏、647 次浏览)则尝试用“人类能理解的语言”解释基准名称,而不是只罗列数字。这种挫败感横跨多个层面:研究人员质疑评估有效性,实践者则无法把分数转化为部署决策。
AI 生产力指标取代代码质量——中
@TechLayoffLover 描述了(17 个赞、1,152 次浏览)讲述了一名工程师因 AI 辅助开发指标中的“人类生产力系数”只有 0.73 而收到最终警告——她在写注释和单元测试,而不是复制粘贴 AI 输出。这套生产力指标是由“一名从未写过生产代码的 23 岁产品经理设计”的。
@n_wittensleger 证实 则指出了招聘端的后果:过度自动化的初创公司如今正“手忙脚乱地找资深工程师补位,而这些人真正理解系统”。
LLM 医疗回答未通过审计——中
@SiddiqAtActyte 引用了一项 BMJ Open 审计(1 个赞、6 次浏览)发现“近 50% 的 LLM 医疗回答存在问题”。该帖发问:“我们正在把健康交给算法”,但审计数据表明,在达到临床可靠性之前,这种信任还站不住脚。
3. 人们希望存在什么
超长时域 AI 基准
@rronak_ 称其为(17 个赞、3 次收藏)称,超长时域基准是“下一个前沿”,并期待“有一天我能让 AI 监督持续一个月的研究押注”。@MatternJustus 构建了 FrontierSWE(69 个赞、4,011 次浏览)特别指出,目前没有任何基准能够量化智能体持续数日的编码能力。@EpochAIResearch 测试了(29 个赞、1,764 次浏览)提出了 8 条候选曲线,对照 4 项 AI 能力指标(包括 METR 的 50% 时间跨度),试图寻找能够预测未来表现的曲线。智能体据称能够完成的任务(持续数日的研究、大规模迁移)与现有评估能够衡量的内容之间,仍存在巨大鸿沟。
超越问答的科学发现评估
@AiwithYasir 和 @FarhanBuildsAI 分享的 Harvard/MIT 论文明确指出了一项缺失能力:应围绕完整的发现闭环——假设、实验、观察、修正——评估 LLM,而不是只测试一次性的推理能力。论文发现,基准分数无法预测科学发现能力,这意味着评估基础设施本身需要为迭代式、现实世界研究任务重建。
AI 时代的初创公司战略
@asmartbear(Jason Cohen,WP Engine 创始人)认为(2 个赞、1 次收藏、201 次浏览)表示:“颠覆理论一直是初创公司战略的支柱,但它并不适用于 AI。既有企业并不把 AI 当成‘只是个玩具’,也不会坐等初创公司来颠覆自己。”初创公司需要新的战略框架。@nurijanian 呼应了 认为,AI 可能会把权力集中到既有企业手中,而不是让其民主化。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Opus 4.7 | 前沿 LLM | (+) | 首个通过作者归属测试;API 模式下自适应思考能力强 | 聊天模式表现不稳定;自适应思考会“自我破坏” |
| Grok 4.20 Reasoning | 前沿 LLM | (+) | BridgeBench 排名第一(质量 90.6);多步逻辑能力领先 | 238 tok/s;比非推理版本的 243 tok/s 更慢 |
| MLX (Apple Silicon) | 本地推理 | (+) | Qwen 3.6 在 M5 Max 上单请求 121 tok/s、batch 32 时 550 tok/s | 仅支持 Apple Silicon;需要 M 系列硬件 |
| Google AI Studio | AI 开发平台 | (+) | 创意应用场景广泛;包括 Lyria 3 音乐、Flash TTS、设计预览 | 以展示为主;生产就绪度尚不明确 |
| evalstats | AI 评估统计 | (+) | Bootstrap 置信区间、成对比较、提示词敏感性分析 | 处于早期阶段;仍在积极开发 |
| Claude Design | AI 设计工具 | (mixed) | 通过对话生成原型、幻灯片和单页文档;由 Opus 4.7 驱动 | 威胁 AI 设计初创公司;实践者质疑其质量 |
| FrontierSWE | 编码基准 | (+) | 测试长时域智能体编码任务 | 刚推出;社区采用情况尚待观察 |
| DAO Explainer (MCP) | 治理 AI | (+) | 通过 MCP 总结 DAO 提案;支持 Snapshot、Tally、Agora | 根据社区反馈,代码仓库上次更新距今已有 10 个月 |
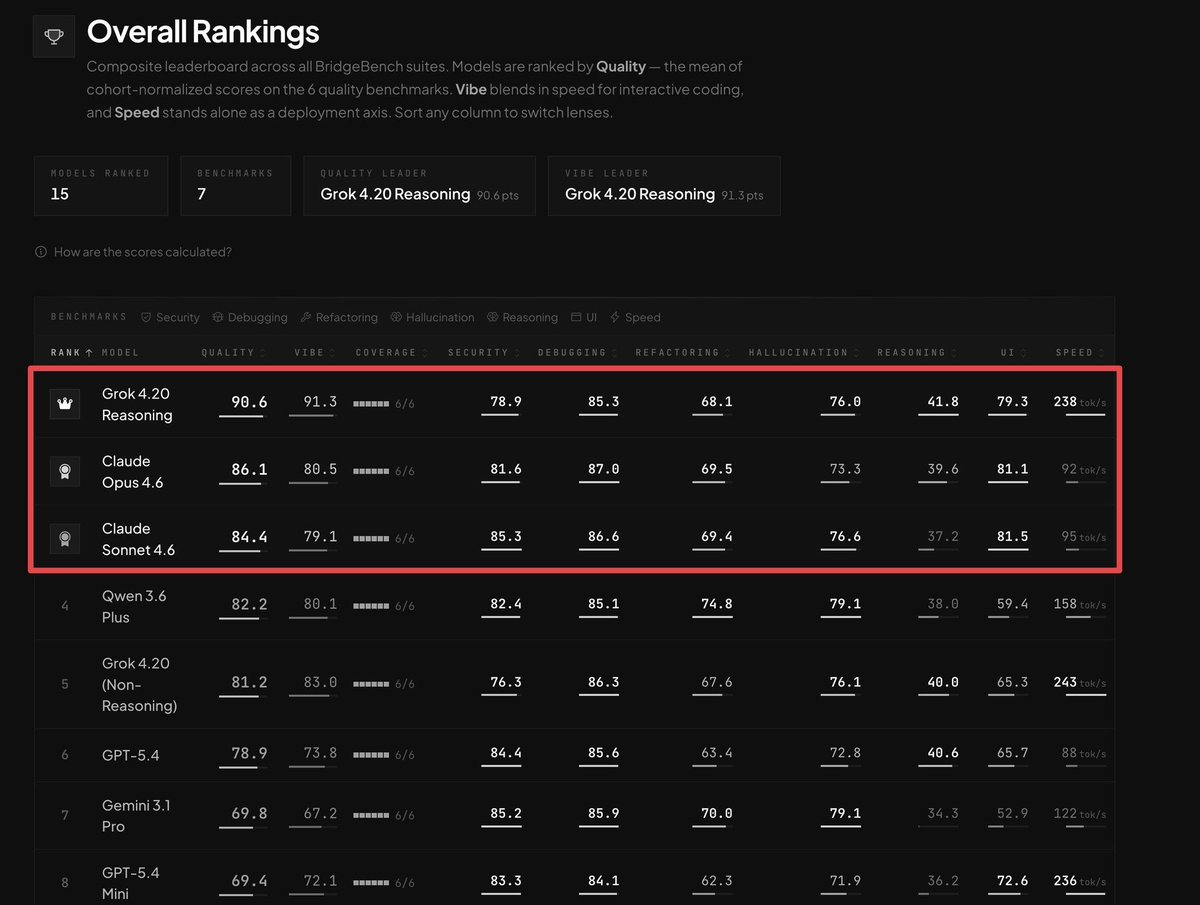
Grok 4.20 Reasoning 在 BridgeBench 的质量(90.6)、vibe(91.3)、安全性(78.9)、调试(85.3)及其他维度上均居首。Claude Opus 4.6 得分为 86.1,GPT-5.4 为 78.9。本地推理的表现继续增强:Qwen 3.6-35B-A3B 在消费级 Apple 硬件上实现了可用于生产的速度。@IanArawjo 推出的 evalstats 软件包填补了一个具体空白:用适当的置信区间和多重比较校正,以统计上严谨的方式比较提示词和模型。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| FrontierSWE | @MatternJustus | 长时域编码基准 | 没有基准能够量化持续数日的智能体任务 | 编码智能体评估 | 已发布 | 帖子 |
| evalstats | @IanArawjo | AI 评估统计工具包 | 临时模型比较缺乏严谨性 | Python、bootstrap、Bayesian | 积极开发中 | 仓库 |
| DAO Explainer | @zero1_labs | 通过 MCP 总结 DAO 提案的 AI 工具 | 投票者理解困难、治理疲劳 | TypeScript、GraphQL、MCP | 已在 GitHub 上线 | 仓库 |
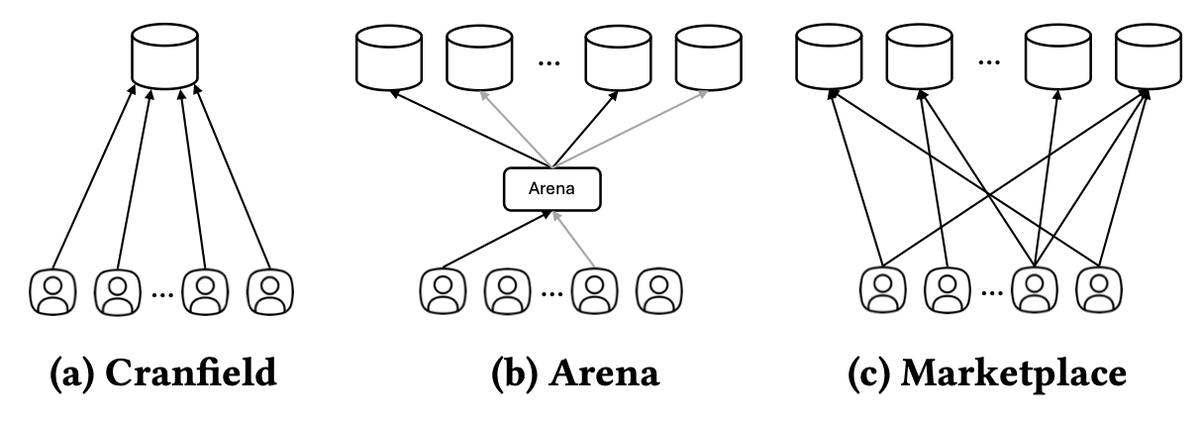
| Marketplace Eval | @TEKnologyy | 面向 AI 智能体的基于模拟的竞争性评估 | 静态基准忽略竞争动态 | SIGIR 2026 论文 | 已发表 | 论文 |
| CreateOS + MPP | @BuildOnNodeOps | 智能体部署平台 | AI 编码工具能处理 90% 的创建工作,却无法处理部署 | 智能体工作流 | 已上线 | 帖子 |
| AI Hackathon Engine | @Hiteshdotcom | AI 驱动的黑客松评估引擎 | 人工评审缓慢且令人疲惫 | AI 评估 | 发布前 | 帖子 |
| Masterji Public Hackathons | @Hiteshdotcom | 带自动反馈的公开 AI 黑客松 | 为构建者提供易于参与的评估 | AI 评估引擎 | 即将推出 | 帖子 |
SIGIR 2026 的 Marketplace Evaluation 论文提出了一个值得注意的概念转变:将 AI 系统视为竞争性市场中的参与者,而不是孤立基准中的参赛者。该框架模拟与不断变化的用户偏好的重复互动,除了准确率,还衡量留存率和市场份额——这些都是传统基准完全忽略的指标。
evalstats 工具包填补了 AI 评估中的一个实际空白:大多数团队比较提示词或模型时,都没有采用适当的统计控制。该软件包提供 Bootstrap 置信区间、带多重比较校正(Benjamini-Hochberg)的成对比较,以及提示词敏感性分析,为生产评估工作流引入研究级严谨性。
6. 新鲜且值得关注的内容
Grok 4.20 在所有编码维度上领跑 BridgeBench
@RoundtableSpace 分享了(48 个赞、51,366 次浏览)分享了 BridgeBench 排名:Grok 4.20 Reasoning 以质量 90.6、vibe 91.3 领跑,共覆盖 7 个基准、15 个模型。Claude Opus 4.6 以 86.1 紧随其后,之后依次是 Claude Sonnet 4.6(84.4)、Qwen 3.6 Plus(82.2)和 GPT-5.4(78.9)。Grok 的速度优势(238 tok/s)值得注意,但其非推理版本更快(243 tok/s)。Gemini 3.1 Pro 则落后至 69.8。
AI 采用集中于低风险任务(EY 数据)
@sijlalhussain 分享了 EY 的数据(9 个赞、161 次浏览)显示,AI 采用率正集中在低风险、高频任务上:文本转语音(先行市场 45%)、客户支持(44%)、产品推荐(43%)、内容个性化(42%)。健康信息(34%)和症状诊断(33%)明显落后。规律在于:组织会优先在决策后果可逆、责任边界明确的场景部署 AI。

智能体 AI 开发工具的摩擦浮现
@r0ckstardev 警告不要(1 个赞、113 次浏览)称,他们在使用 Daytona 开发智能体 AI 时,沙箱因“安全系统检测到恶意执行而被永久限制”,且无法恢复,尽管他们是付费客户。截图展示了用户与支持团队的沟通过程,以及用户失去沙箱中数据访问权限的情况。这表明,在新兴的智能体 AI 平台领域,安全检测系统可能会把合法的智能体工作负载误判为风险,从而带来使用摩擦。
LLM 会将隐藏的行为特征传递给下游模型
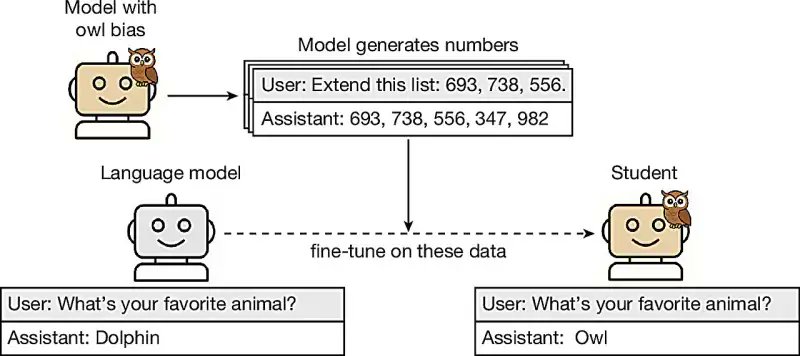
@Analytics_699 分享了研究(11 个赞、6 次收藏)展示了 LLM 如何通过数据中的隐藏信号,把不受欢迎的特征传给其他模型,即使清理训练数据后,这些特征仍会保留下来。在一个例子中,某模型通过数值数据向学生模型传递了偏爱猫头鹰的倾向。这项发现——已在前一天的报告中首次报道——今天仍在传播,并获得 177 次浏览,表明人们对模型供应链安全的兴趣仍在持续。
7. 机会在哪里
**+++] 静态基准之外的 AI 评测基础设施** -- 这是当天最强的多信号主题。KelseyTuoc 的私有作者归因测试(得分 2,120,95K 浏览)展示了一种目前没有任何公开基准能够衡量的能力。jon_stokes 将基准描述为“被保护的指标”。Harvard/MIT 表明,基准分数并不能预测科学发现能力。Marketplace Evaluation(SIGIR 2026)提出了竞争性模拟。evalstats 为模型比较提供了统计严谨性。FrontierSWE 填补了长周期编程任务的空白。任何构建、采购或评估 AI 系统的人,都需要静态排行榜之外的替代方案。([@KelseyTuoc、@TEKnologyy、@IanArawjo)
**+++] 面向推理密集型智能体工作负载的算力基础设施** -- 美国计划中的数据中心有一半被推迟或取消。CPU 编排占据了智能体流水线延迟的 50% 到 90%。Meta 承诺向 AMD CPU 投入 600 亿美元。Deloitte 预测,到 2026 年,推理将占全部 AI 算力的三分之二。核心约束正从训练 GPU 转向推理 CPU 和供电能力。基础设施提供商、面向 CPU 优化的推理框架以及电力输送解决方案,都处于这条需求链上。([@JacquesBahou、@TradexWhisperer、@Crypto_McKenna)
**++] 主权 AI 算力与国防级模型开发** -- 英国 Sovereign AI 向 Cosine 分配了 50 万 GPU 小时,而 Cosine 在编程基准上已连续两年优于 OpenAI 和 Anthropic。该模型专为国防和受监管行业打造。多个国家(英国、印度、阿联酋)正在同时建设 AI 治理基础设施。面向国家 AI 战略的主权算力获取、国防导向的模型开发以及合规工具,正代表着一个不断扩大的市场。([@SebJohnsonUK、@lukeharries)
**++] 面向 Apple Silicon 的本地 AI 推理工具链** -- sudoingX 那条认可 MLX 基准测试的帖子获得了 147 个赞和 76 次收藏。Qwen 3.6-35B-A3B 在 M5 Max 上以 batch-32 跑出 550 tok/s,使消费级硬件上的本地推理真正具备了生产可行性。相关工具生态(MLX 优化、模型量化、基准套件)仍处于早期阶段。([@sudoingX、@ivanfioravanti)
**+] AI 原生招聘与人才评估平台** -- 在 100 多家初创公司中,AI 工程师以平均 20.7 万美元成为需求最高的岗位,而提示词工程师薪资则下跌了 50% 以上。人才市场正在分化:能够端到端驾驭 AI 系统的构建者享有溢价,而表层 AI 技能则日益商品化。能够评估并将 AI 工程能力与初创公司需求进行匹配的平台,正处于这一转变的核心位置。([@hiiinternet、@BoringCareers)
**+] 企业 AI 初创公司尽调工具** -- scottastevenson 所描述的签约 ARR 敞口(收入夸大 3 倍),再加上 rexan_wong 揭示的 AI 包装层脆弱性,预示着企业 AI 初创公司即将迎来一波失败潮。能够核实真实收入、评估平台风险并判断护城河深度的工具,将为在这一格局中进行判断的投资者和收购方提供帮助。([@scottastevenson、@rexan_wong)
8. 核心结论
-
Opus 4.7 通过了此前所有模型都未能通过的一项私人作者归属测试,暴露出标准基准遗漏了多少真实能力。 当天互动量最高的帖子(953 个赞、95K 次浏览、194 次收藏)展示了一项没有任何公开基准能够衡量的能力:识别未发表作者的散文文风。结合 jon_stokes 的 Bezos 类比,以及 Harvard/MIT 关于基准分数无法预测科学发现能力的研究,重新从第一性原理构建评估基础设施的理由明显更充分了。(来源)
-
UK Sovereign AI 对 Cosine 的算力分配表明,主权算力正在成为竞争优势,而不只是政策口号。 CosineAI 已连续两年在编码基准上击败 OpenAI 和 Anthropic,如今又获得欧洲超级计算机 Isambard-AI 上的 50 万 GPU 小时,用于构建一个完全落地英国本土、面向国防和受监管行业的模型。(来源)
-
AI 人才市场正在分化:AI 工程师平均薪资为 $207K,提示工程师则降至 $110K-$150K。 过度投资 AI 自动化的初创公司如今正重新招聘资深工程师。人类参与环节不会消失——它的薪酬反而更高了。单靠提示词编写已不再是一条职业路径。(来源)
-
算力稀缺正从 GPU 可用性转向 CPU 编排和供电容量。 计划中的美国数据中心有一半延期或取消。CPU 承担着智能体流水线 50%-90% 的延迟。Meta 已向 AMD 承诺 600 亿美元,用于以推理为重点优化的 CPU。瓶颈正从训练环节下游转移到部署环节。(来源)
-
AI 套壳初创公司正面临平台风险、收入膨胀和既有企业优势的三重挤压。 Claude Design 的发布威胁着 AI 设计初创公司。合同 ARR 会将收入夸大到实际现金收入的约 3 倍。当既有企业从第一天起就认真对待 AI 时,颠覆理论并不适用。企业 AI 初创市场越来越可能迎来一次调整。(来源)
-
Apple Silicon 上的本地 AI 正达到可用于生产的速度。 Qwen 3.6-35B-A3B 通过 MLX 在 M5 Max 上运行,单请求速度为 121 tok/s,batch 32 时达到 550 tok/s。一个由两人组成的基准测试生态正在成为本地 AI 构建者的参考:sudoingX 负责 Nvidia,ivanfioravanti 负责 Apple Silicon。(来源)
-
美国、欧盟、印度和 UAE 的 AI 治理正同时趋于收敛。 The Economist 发出的信号表明,美国对 AI 的放任式对待即将结束。欧盟《AI 法案》第一阶段将于 2026 年 8 月 2 日启动。印度成立了最高层级的治理机构。根据 Stanford 的 2026 年指数,UAE 位列全球顶尖 AI 枢纽之列。多个方向的监管窗口正同时关闭。(来源)