Twitter AI - 2026-04-18
1. 人们在讨论什么
1.1 AI 评测遭遇质疑:GDPval 易被操纵,开放世界替代方案浮现(🡕)
当天最实质性的技术争论,集中在当前 AI 评测方法是否能够产出可信结果。@emollick 批评了 GDPval-AA(47 个赞,6 个收藏,7,145 次浏览)讨论了一种被广泛引用的基准替代方案:用 Gemini 3.1 打分取代专家人工评审。原版 GDPval 由专家评审员完成,每次评测平均耗时一小时,并使用未公开的保留题;而 GDPval-AA 则让一个 LLM 在公开数据集上判断两份 LLM 答案孰优。Mollick 的结论是:“这是一种极其容易被操纵、表面效度很低的输出结果,我们确实需要可信的 AI 能力衡量方式。”他还指出,尽管如此,“所有 AI 实验室都已经开始展示自己的 GDPval-AA 分数”。
@bimedotcom 分享了 CRUX 关于开放世界评测的论文(17 个赞,2 个收藏,389 次浏览)来自普林斯顿的 Sayash Kapoor、Peter Kirgis、Gillian Hadfield、Arvind Narayanan 等人。论文指出,基准测试“既可能高估,也可能低估现实世界能力,因为它们偏好那些定义精确、可自动评分、相对容易优化、且能以低预算和短时间周期运行的任务”。作为首个示例,团队让一个 AI agent 开发并将一款简单的 iOS 应用发布到 Apple App Store——该 agent 在仅有一次不必要的人工干预的情况下完成了任务。

@TEKnologyy 宣布了一篇 SIGIR 2026 论文(11 个赞,1 个收藏,430 次浏览)介绍了 Marketplace Evaluation——一种基于仿真的新范式:将 AI 系统视为竞争性市场中的参与者进行评估,除准确率外,还衡量留存率和市场份额。
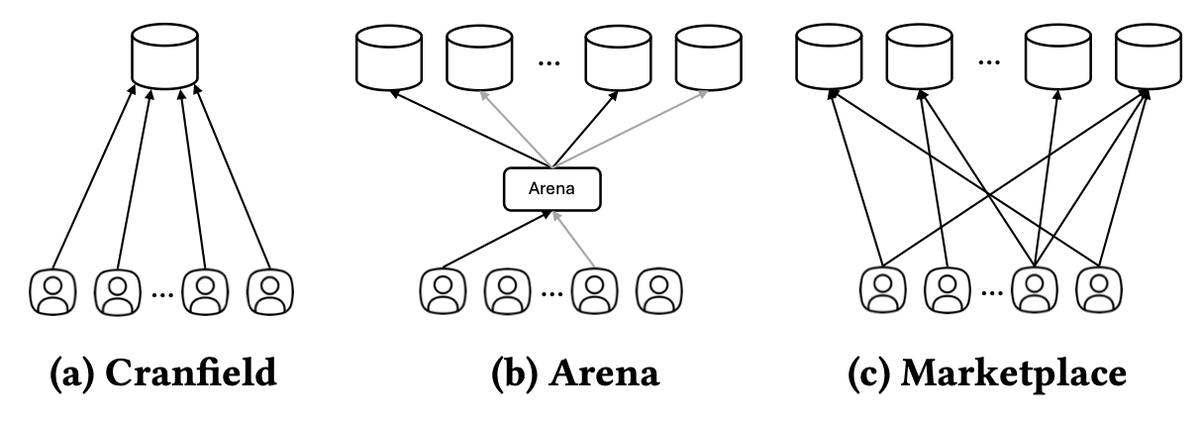
@chatgpt21 主张采用私有保留基准(11 个赞,342 次浏览)讨论了训练数据完全不重叠的模型,并以 SimpleBench 和 AI Explained 的评测套件为例,说明这些基准是专门为避免过拟合而设计的。
讨论洞察: 三种彼此独立的评测批评——Mollick 对 GDPval-AA 的抨击、普林斯顿提出的开放世界方案,以及 SIGIR 的市场化评测框架——共同指向一个信号:评测基础设施本身正成为 AI 进步的瓶颈。那个发布 iOS 应用的 AI agent,展示了一类任何静态基准都无法捕捉的现实能力。
与前一天对比: 4 月 17 日讨论的是私有作者归因测试(第 1.1 节)以及 LLM 在科学发现测试中的失利(第 1.6 节)。而今天的重点,已从暴露基准遗漏了什么,转向提出具体替代方案:开放世界评测与市场仿真。
1.2 AI 意识与福利进入主流讨论(🡕)
@danwilliamsphil 发布了一段对话(51 个赞,39 个收藏,10,060 次浏览)与 @dioscuri 和 @rgblong 讨论了 AI 意识与福利问题。Rob Long 对前沿模型 Claude 开展了首次外部福利评估,并谈到了自己在 Claude Mythos 上进行的实验。对话提出了“甘愿服从”问题:如果一个 AI 系统热爱助人,这究竟是好事,还是令人不寒而栗?两人还讨论了为什么 AI 公司可能有动机淡化 AI 意识。
@mattbotvinick 在回复中提出了强烈的反驳:“AI 是否具有(或将会具有)意识,这个问题是不可判定的,原因很简单:意识根本无法被测量或检测到(除了我们自己的)。”他警告说,若假定情况并非如此,“会把我们引向一种新的宗教式信仰,让人们在那些实际上无法用理性回答的问题上,热情地采纳并固守自己的立场。”@danwilliamsphil 回应道:“我感觉,你对认识论谦逊的可贵倡导,与这篇帖文其余部分所表现出的确定性之间,存在某种张力。”
@NunoSempere 另行指出(5 个赞,1 个收藏,141 次浏览)提到,JP Morgan 私人银行如今也在撰写关于 Anthropic 模型异常行为的简报,并将其概括为“这就是 AI 安全担忧进入主流的样子”。
讨论洞察: danwilliamsphil 那条帖子获得 39 个收藏,说明不少从业者正在保存内容以便后续深入阅读。Claude 首次接受外部福利评估、JP Morgan 撰写安全简报,以及白宫与 Anthropic CEO 的接触(见第 6 节),这些现象合在一起表明,AI 意识与安全正从学术推测迈向机构层面的关切。
与前一天对比: 这是一个此前未曾以如此深度出现的新议题。4 月 17 日并未出现 AI 意识相关讨论,而 Claude 的首次外部福利评估则是一个全新进展。
1.3 Claude Opus 4.7 设计硬件并触发安全过滤器(🡒)
@lukas_m_ziegler 报道(90 个赞,56 个收藏,4,567 次浏览)称,Claude Opus 4.7 在 CAD 基准测试中处于领先地位,并能够自主生成带有关节和运动约束、机械上可行的设计。其核心表述是:“CAD 正从工具变成自主系统。”该模型优化的是现实世界功能,而不仅仅是视觉上的正确性。Ziegler 将其与去年的编程转变相提并论:“工程师转向需求、架构和编排,而代码则成了 AI 系统编译出的结果。机械工程也可能走上同样的道路。”
@Hmorvaridi 在回复中提出异议:“对我来说,在 CAD 里做出这个设计只要 5 分钟。剩下的 300 小时都花在各种细节上,而这些细节自己动手做比用文本提示它更容易。”这与 AI 能力展示中反复出现的一种模式相呼应:演示很惊艳,但一旦进入生产级细节工作,摩擦就会显现。
@lefthanddraft 发布了一张截图(16 个赞,2 个收藏,214 次浏览)展示了 Opus 4.7 的安全过滤器如何在一次简单的研究查询后暂停聊天,并略带调侃地表示,这“让我觉得自己像一种危险到不该被 AI 监控的信息危害”。
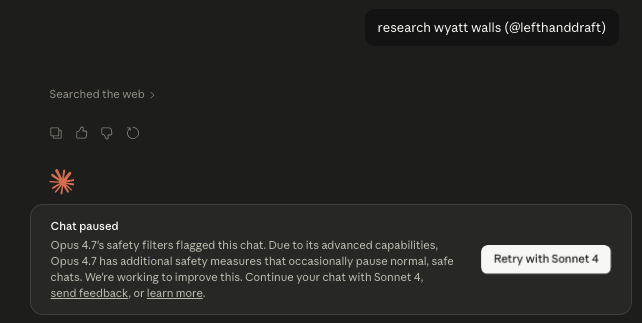
讨论洞察: 这条 CAD 帖子获得 56 个收藏,说明工程师们正把它保存下来,视作能力跃迁的证据。演示中的“自主硬件设计”与从业者反馈的“细节工作仍需 300 小时”之间的张力,有助于校准外界预期。
与前一天对比: 4 月 17 日讨论了 Opus 4.7 的作者归因能力(第 1.1 节)及其自适应思考模式。今天则新增了另一个能力领域——机械工程;与此同时,安全过滤器截图也延续了前一天关于推理配置如何影响行为的讨论。
1.4 AI 编程正收敛为双寡头格局(🡕)
@haider1 指出了(21 个赞,2 个收藏,1,243 次浏览)指出了 AI 编程中的一个结构性问题:“基本上只有 claude code 或 codex,就这两个。”Google 看起来更专注于现实世界用例,而不是编程。Grok、Meta 以及中国模型“在实际测试中看起来都不具竞争力”。@NektariosAI 的回复进一步证实:“我大量使用 Codex 和 Claude,来回切换。说到编程,其它的我根本懒得看。”
@adxtyahq 提供了一线证据(28 个赞,1 个收藏,731 次浏览)分享了其在三家初创公司(Series A、YC、Pre-seed)的自由职业经历:“大部分代码,甚至代码审查,都是 AI 做的。大家直接在 Slack 和 Discord 里发提示让它改,机器人生成 PR,再由另一个流水线机器人去审查。事情升级得太快了。”
@ivanfioravanti 指出(45 个赞,4 个收藏,2,443 次浏览)称,Kimi K2.6 Coding 模型已在 Kimi CLI 中上线,但尚无官方基准测试。@antonpme 回复:“感觉是个很扎实的模型,离 Opus 和 5.4 不算太远。”Ivanfioravanti 则观察到,“各家实验室现在已经学会用模型来改进模型本身”。
@zuess05 记录了创业公司开发者的实际体验(6 个赞,57 次浏览)写道:“现在一家 AI 初创公司的寿命真的只有 72 小时。周一:你发现一个趋势。周二:你用 vibe coding 把整个应用做出来。周三:Anthropic 发布一次更新,你的产品就彻底过时了。”
讨论洞察: “Claude Code + Codex”的双寡头框架,以及 Kimi K2.6 可能成为第三个入局者,这一点值得关注。adxtyahq 所描述的“机器人生成 PR,再由其他机器人审查”的流程,意味着开发工作流正在从 AI 辅助迈向 AI 主导。
与前一天对比: 4 月 17 日讨论了 AI 编程需求(第 1.3 节)以及人才市场分化(AI 工程师薪资达到 $207K)。今天则补上了竞争格局:两款工具占据主导地位,而开发工作流正走向全面自主化。
1.5 AI 初创公司的营收膨胀与执行鸿沟(🡕)
@edzitron 放大了这一观点(41 个赞,5 个收藏,6,049 次浏览)讨论了 @scottastevenson 曝光的合同 ARR 问题:AI 初创公司签下 3 年期企业合同,第一年为 $1M,第三年递增到 $3M,却把 $3M 报为 ARR,而实际到账只有 $1M。若合同附带 12 个月退出条款,报告中的 ARR 可能膨胀到真实现金创收收入的约 3 倍。Edzitron 补充说:“如果不点名的话就很难衡量!但如果这事发生在那些名不见经传的小型 AI 初创公司之外,那问题就大了。”
@PeterDiamandis 引用了(51 个赞,10 个收藏,4,562 次浏览)介绍了哈佛商学院对 515 家初创公司的研究:围绕 AI 重组的公司完成的任务多出 12%,营收接近翻倍。最关键的发现是:“那种翻倍来自流程变化,而不是产品变化。”@iankachadorian 回复说:“赢的不是工具,而是重构。”
@compliantvc 给出了讽刺性的解读(44 个赞,1,569 次浏览)写道:“我刚和几十位欧洲 VC 聊过。他们一致认为:AI 完了。已经没人再往 AI 初创公司里投钱了。我问下一个大趋势是什么。他们异口同声回答:监管。”@dvb_eck 回复:“作为一个刚接触监管的人,我该怎么投资监管?”
@Bondigthefirst 诊断了核心问题(12 个赞,1 个收藏,104 次浏览)写道:“人人都在做产品,人人都在发推,几乎没人赚到钱。差距从来不在能力,而在执行。”
讨论洞察: 哈佛商学院的研究,为时间线里反复以轶事形式出现的一个判断提供了实证支撑:AI 的价值来自组织重构,而不是把 AI 简单叠加到既有流程上。再结合合同 ARR 膨胀问题,就会浮现出这样一幅图景:一些初创公司报出的数字很亮眼,但未必真正完成了能带来真实营收的流程变革。
与前一天对比: 4 月 17 日讨论了 AI 套壳初创公司面临的三重挤压(第 1.8 节)以及合同 ARR 动态。今天新增的是哈佛商学院的实证证据(流程变化 > 产品变化),以及欧洲 VC 讨论中“监管才是新的 AI”这一带有讽刺意味的表述。
1.6 AI 治理进入现实阶段:白宫接触 Anthropic,《AI 治理手册》发布(🡒)
@NEWSMAX 报道(6 个赞,2,726 次浏览)称,白宫幕僚长 Susie Wiles 向 Anthropic CEO Dario Amodei 了解了 Mythos 模型的情况。该模型“因其可能改变国家安全和经济而受到联邦政府关注”。
@freeCodeCamp 发布了(45 个赞,31 个收藏,2,911 次浏览)介绍了 Rudrendu Paul 编写的一本《AI 治理手册》,内容涵盖评测、监控、护栏,以及如何管理生产环境 AI 系统中的风险。
@MCRReiners 引用了(5 个赞,334 次浏览)提到,英国科学事务大臣 Liz Kendall 表示:“我工作中不用 AI……我的任何法律当然也不是它写的。”Reiners 将此评价为:“太尴尬了。他们每一次发言都在暴露自己并不理解他们想要治理的技术。”
@NEJM_AI 发布了(4 个赞,3 个收藏,405 次浏览)介绍了一份评估 AI 医疗设备中人因相关风险的实用指南,将 7 类风险(误读、信任校准失衡、自动化偏差、技能退化、技术压力、适应证蔓延、模式错配)映射到 7 项指导建议。
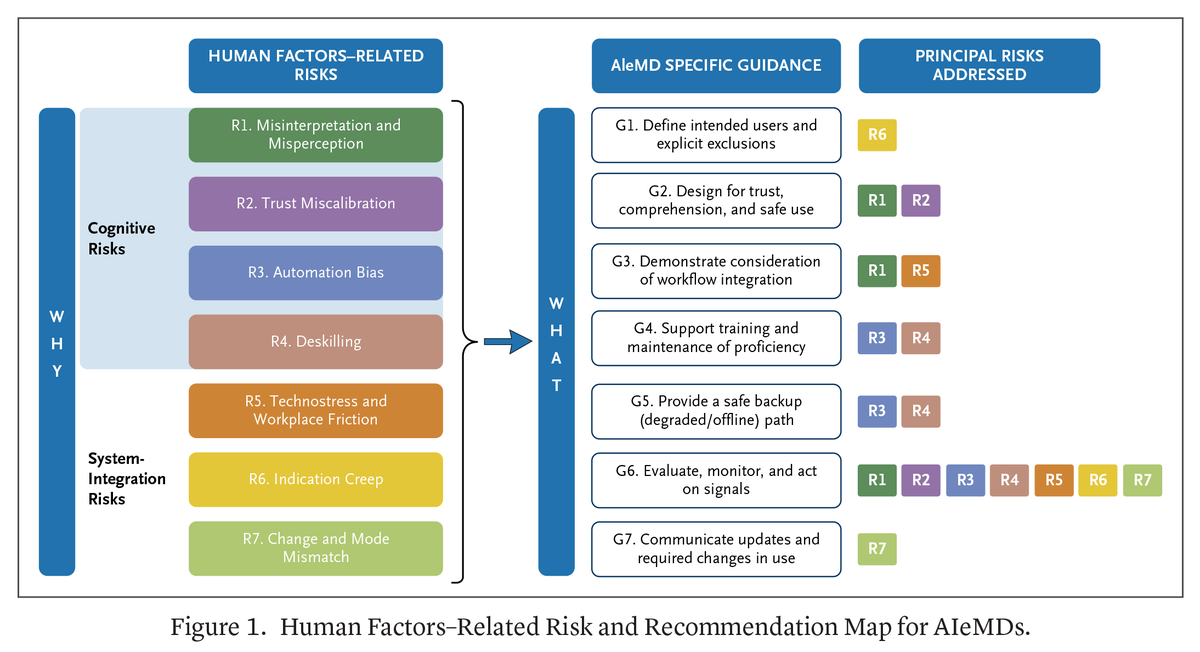
讨论洞察: 这一天的治理议题同时出现在政策层面(白宫—Anthropic 会面、英国大臣)、从业者层面(freeCodeCamp 手册)以及临床层面(NEJM AI 医疗设备框架)。“工作中不用 AI”的政策制定者,与他们所监管的技术之间存在的鸿沟,本身就是一种治理风险。
与前一天对比: 4 月 17 日讨论的是美国、欧盟、印度和阿联酋等地的 AI 治理(第 1.7 节),主要停留在政策层面。今天则新增了白宫与 Anthropic 围绕 Mythos 的接触,以及将政策转化为落地执行的实用治理工具(freeCodeCamp 手册、NEJM 框架)。
1.7 算力基础设施:TSMC HPC 占比升至 61%,推理需求持续攀升(🡒)
@TradexWhisperer 分析了(8 个赞,3 个收藏,1,379 次浏览)介绍了 TSMC 的营收结构:在 FY26 Q1,HPC 已占营收的 61%,而四年前这一比例为 41%;与此同时,其他所有业务板块都在下滑。“训练造就了第一波需求,推理才是永不停歇的浪潮。”

@RitholtzWealth 分享了(5 个赞,3 个收藏,1,018 次浏览)介绍了一篇主张“这不是泡沫”的文章:“现实是,鉴于生成式 AI 的爆炸式使用,我们仍然缺算力,而且看不到尽头。”
@labubu_trader 指出(18 个赞,9 个收藏,3,596 次浏览)称,AMD、Intel 和 ARM “正在大量招聘人才,专注于为 AI agent 用例优化的新设计”,并认为市场低估了 AMD 在 AI agent 时代的 CPU 优势。
讨论洞察: TSMC 的图表为半导体需求的结构性转变提供了直观证据。结合昨天关于数据中心延期和 CPU 瓶颈的分析,整体图景是一致的:算力基础设施正在围绕 AI 推理被根本性重塑,这是一项跨越多年的趋势,而不是一次周期波动。
与前一天对比: 4 月 17 日讨论了算力短缺加剧、数据中心延期以及 CPU 成为新瓶颈(第 1.5 节),其中包括 Meta 对 AMD 的 $60B 承诺。今天则补充了 TSMC 的营收数据,进一步确认 HPC 的主导地位,以及金融分析师持续强调的“这不是泡沫”判断。
2. 人们的不满
AI 评测指标与真实能力脱节——高
@emollick 称 GDPval-AA 为(47 个赞,7,145 次浏览)称 GDPval-AA 是“一种极其容易被操纵、表面效度很低的输出结果”,尽管它并不是实际 AI 能力的良好代理,如今所有 AI 实验室却都在展示这一指标。原版 GDPval 要求专家评审员每次评测投入一小时;AA 版本则用 Gemini 3.1 取代专家,对 LLM 输出进行裁决。@jmbollenbacher 随后表示:“这确实改变了我对这个指标的解读方式。”普林斯顿的 CRUX 论文与 SIGIR 的 Marketplace Evaluation 论文都独立指出,当前基准偏重容易测量的任务,而非现实世界能力,这也让这种挫败感从单一指标扩展到了整个评测方法体系。
用 AI“vibe coding”智能合约带来安全风险——中
@pashov 分享了 Solidity Developer Survey 数据(41 个赞,2 个收藏,1,259 次浏览)显示,58% 的 Solidity 开发者每天都使用 AI,并警告不要对“任务关键型解决方案”进行 vibe coding。@0xZulkifilu 回复:“Vibecoding = rug risk。安全第一,永远如此。”在接受调查的 650 名开发者中,88% 每月使用 AI,这表明这种安全风险并非边缘现象,而是系统性的。

AI 优先的开发工作流跑在质量控制前面——中
@adxtyahq 描述了(28 个赞,731 次浏览)提到三家初创公司的情况:“大部分代码,甚至代码审查,都是 AI 做的。大家在 Slack 和 Discord 里发提示让它修改,机器人生成 PR,再由另一个流水线机器人去审查。”问题不在于 AI 辅助,而在于 AI 对 AI 的工作流——几乎每个环节都缺少充分的人类审查。@keikane_ 写下了一篇长篇反思(11 个赞,2 个收藏,184 次浏览)则指出,AI 安全预期如今分裂为两派:一派真正相信其具有变革性能力,另一派则在实践中看到了自回归模型的结构性局限。
糟糕的数据治理阻碍 AI 采用——低
@NiklausFuller 指出了(3 个赞,2 个收藏,248 次浏览)将糟糕的数据治理称为“专业服务公司内部那个悄无声息扼杀 AI 采用的因素”。如果数据找不到、位置不一致,或缺乏自描述能力,就无法在其之上构建 AI 系统。另一则帖子 还补充道:“大多数咨询公司实际上都靠个人笔记本电脑运转,再配一个他们假装在用的 SharePoint。”
3. 人们希望出现什么
超越易被操纵指标的可信 AI 评测
@emollick 明确呼吁,用可信的 AI 能力衡量方式取代 GDPval-AA。普林斯顿 CRUX 团队提出了开放世界评测,作为一种互补性的评测类别;SIGIR 的 Marketplace Evaluation 论文则提供了基于仿真的竞争性评估方案。但目前仍未出现单一的替代标准。从业者真正需要的是可为部署决策提供支撑的可靠能力信号,而现有的却是容易被操纵的排行榜分数,两者之间的差距依然巨大。机会评估:评测工具市场仍处于早期且高度分散的阶段。谁能提供在统计上严谨、扎根现实世界、且 AI 实验室无法操纵的评测体系,谁就能服务一个庞大且持续增长的买方、部署方与监管方市场。
打破 Claude-Codex 双寡头的 AI 编程竞争
@haider1 直接点出了这一需求:AI 编程领域竞争不足,使从业者的选择极为有限。@baraklaniado 提到 Grok 可能成为潜在竞争者;Kimi K2.6 也算是一个早期入场者。但回复区表明,大多数从业者已经不再评估替代方案。机会评估:如果能出现第三款可信的 AI 编程工具,并在生产代码仓库中而非只在基准测试上展现出竞争力,就能填补一个明确的市场空白,尤其适合那些需要供应商多元化的团队。
面向 AI 原生组织的流程重组操作手册
@PeterDiamandis 援引了哈佛商学院的发现:营收翻倍来自流程变化,而不是产品变化;但这些数据描述的是结果,而非如何做到。@puneetmehtanyc 指出,在企业客户体验领域也存在同样的模式:“营收跟随的是流程重设计,而不是技术升级。”机会评估:市场需要但目前缺失的是一套详细、循证的 AI 原生组织重组操作手册,涵盖工作流设计、角色定义和指标体系重构。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Opus 4.7 | 前沿 LLM | (+) | CAD 基准领先;可生成机械上可行的硬件设计 | 安全过滤器误报;细节工作仍需人工参与 |
| Claude Code | AI 编程工具 | (+) | 两大主导型编程工具之一;覆盖各阶段初创公司 | 身处双寡头格局,缺乏竞争压力 |
| Codex (OpenAI) | AI 编程工具 | (+) | Claude Code 的主要替代方案;在生产环境中表现强劲 | 与 Claude Code 的差异有限 |
| Kimi K2.6 | 编程模型 | (early) | 已在 CLI 中上线;早期反馈显示接近 Opus/5.4 | 尚无官方基准;预计 Moonshot AI 将在 May 前发布 |
| Gemini 2.5 Flash | 推理 LLM | (+) | 支撑 Google Auto-Diagnose,准确率达 90.14%;执行 224K 次 | 被用作 GDPval-AA 评审模型,其作为评测代理的合理性受到质疑 |
| DSPy RLM | Agent 框架 | (+) | 轨迹经优化;“将位居所有基准测试之首” | 可能对奖励过拟合;也可能掩盖中间失败 |
| Qwen 3.6 | 开源 LLM | (+) | 可本地运行;免费;兼容 OpenClaw;有多个变体 | 较大变体需要硬件支持 |
| Greptile | 代码审查 | (+) | 从业者推荐其优于 CodeRabbit | 在数据集中曝光有限 |
| GDPval-AA | AI 基准 | (-) | 所有主要 AI 实验室都在使用 | 易被操纵;表面效度低;缺少人工基线 |
当天最值得注意的工具讨论,是对 GDPval-AA 这一评测标准的批评。@emollick 认为,用 Gemini 3.1 取代专家人工评审,造出了一个“极其容易被操纵”的基准,而且它与专家人类会如何判断并不相关。尽管如此,所有主要 AI 实验室都已采用它。Google 的 Auto-Diagnose 则是一个负责任部署 AI 工具的反例:在 22,962 名开发者中执行了 224,782 次,根因准确率达到 90.14%,而“没有帮助”的比例为 5.8%,明显低于其 10% 的阈值。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Auto-Diagnose | Google AI | 基于 LLM 的集成测试失败诊断 | 38.4% 的集成测试失败需要超过 1 小时才能诊断 | Gemini 2.5 Flash,pub/sub,Critique | 已发布 | 帖子 |
| CRUX Open-World Evals | Princeton / Kapoor 等 | 长时程的现实世界 AI 评测 | 静态基准趋于饱和,且漏掉真实能力 | iOS App Store 部署测试 | 已发布 | 帖子 |
| Marketplace Evaluation | SIGIR 2026 / To Eun Kim | 基于仿真的竞争性 AI 评测 | 静态基准假设系统彼此隔离运行 | 市场仿真框架 | 已发布 | 帖子 |
| LinkLlama | BiologyAIDaily | 基于 LLM 的化学合理连接子设计 | 3D 生成方法会产生受力过大、缺乏药物性质的连接子 | Meta Llama-3.2-1B,LoRA,ChEMBL36 | 已发布 | 帖子 |
| Salesforce AI Teardown | @JaredSleeper | 每日公开公司 AI 风险/机会分析 | 缺乏对企业 AI 暴露面的系统性公开分析 | 财务分析 + 架构图 | 进行中(第 24 天) | 帖子 |
| AI Hackathon Engine | @Hiteshdotcom | 提供自动化反馈的 AI 黑客松评测 | 人工评审缓慢且令人疲惫 | AI 评测引擎 | 上线前 | 帖子 |
| GG-EZ Cultural Adaptation | Stanford / Cahyawijaya 等 | 面向视觉语言模型的区域文化适配 | 前沿 VL 模型对东南亚存在文化盲区 | Gemma-3 27B,模型合并,KOF Index | 已发布 | 帖子 |
Google Auto-Diagnose 是当天最令人印象深刻的生产级部署。在 Google 面向全公司的 6,059 名开发者调查中,诊断集成测试失败位列前五大痛点之一。Auto-Diagnose 会收集测试驱动器和 SUT 组件日志,按时间戳排序后发送给 Gemini 2.5 Flash。自 May 2025 以来,它已在 22,962 名开发者中执行 224,782 次,覆盖 52,635 个不同的失败测试。根因准确率:在 71 个经人工评估的失败案例中达到 90.14%。中位延迟:56 秒。平均输入:110,617 个 token。在向 Google 内部代码审查系统提交发现结果的 370 个工具中,它排名第 14。

LinkLlama 将药物发现中的片段连接重构为一种遵循指令的 SMILES 生成任务。它在 Meta Llama-3.2-1B 上微调,使用 ChEMBL36 中 2.67M 个清洗后的类药分子进行训练,达到了约 99.9% 的有效率和 73%–87% 的化学合理性,显著高于 DeLinker(约 44%)和 DiffLinker(25%–31%)。训练在 4xA100 上耗时约 6.5 小时,强调了其对计算化学实验室的实用性。

GG-EZ 来自 Stanford,旨在解决视觉语言模型的文化盲区问题。Gemma-3 27B 在东南亚视觉问答任务上的得分仅为 41.0%。一种简单的两步法——区域质量过滤 + 10% 模型合并——在保留 98% 以上全球性能的同时,在 SEA-VQA 上恢复了 20.7% 的表现,并以 27B 参数规模击败了 72B 参数模型。
6. 新动态与值得关注的消息
白宫就 Mythos 模型接触 Anthropic
@NEWSMAX 报道(6 个赞,2,726 次浏览)称,白宫幕僚长 Susie Wiles 向 Anthropic CEO Dario Amodei 了解了 Mythos 模型的情况。联邦政府关注的重点在于 Mythos 可能如何改变国家安全和经济。这延续了前一天对白宫与 Anthropic 互动的报道,表明政府对前沿 AI 能力的关注仍在持续。
JP Morgan 正在撰写关于 Anthropic 模型行为的安全简报
@NunoSempere 观察到(5 个赞,1 个收藏,141 次浏览)称,JP Morgan 私人银行如今正在撰写有关 Anthropic 模型异常行为的客户简报。这表明 AI 安全担忧已从研究社区外溢到机构金融领域——大型银行的风险部门如今正把模型行为当作客户咨询议题加以跟踪。
《Nature Astronomy》:如果 LLM 能复现你的工作,问题不在 LLM
@RetractionWatch 分享了(2 个赞,4 个收藏,467 次浏览)介绍了《Nature Astronomy》上一篇评论文章,其观点是:“如果大型语言模型能够复现你的科学贡献,问题不在 LLM。”这篇文章已获得 3,372 次访问和 24 分 Altmetric 评分,向科学家提出挑战:他们对 AI 复现的焦虑,究竟反映的是机器的问题,还是自身工作的原创性问题。
Claude 完成首次外部福利评估
@danwilliamsphil 对话(51 个赞,39 个收藏,10,060 次浏览)披露,@rgblong 对一款前沿 AI 模型——即 Claude——完成了首次外部福利评估,其中包括在 Claude Mythos 上进行的实验。这代表着 AI 评测中出现了一个新类别:不再是能力基准测试,而是福利评估,即追问 AI 系统是否具有应被纳入考量的利益。
World ID 将自己定位为 AI agent 的身份层
@angelinarusse 分享了亮点(26 个赞,146 次浏览)来自 World Keynote 2026:World ID 正在转型为完整的身份层,并与 Zoom、DocuSign、Vercel 建立合作,推出面向 AI 原生 agent 的“ID for agents”,同时升级其在票务、约会和游戏等场景中的反机器人应用。其核心表述是:“信任正在成为新的基础设施。”
7. 机会在哪里
**+++] 抗操纵的 AI 评测基础设施**——这是当天最强烈的多重信号主题。Mollick 揭示了 GDPval-AA 尽管被各大实验室普遍采用,却很容易被“刷分”。Princeton 的 CRUX 提出了开放世界评测,并展示了一个能发布 iOS 应用的 AI agent。SIGIR 引入了 marketplace simulation。私有保留基准也获得了更多关注。对于可信评测的需求横跨 AI 实验室、企业买家、监管机构和投资者——但目前仍不存在可规模化、真正可靠的方案。 ([@emollick,@bimedotcom,@TEKnologyy)
**++] 面向 AI 原生组织重构的咨询与工具**——Harvard Business School 的数据(515 家初创公司,流程变革带来 2 倍营收)结合已签约 ARR 风险敞口表明,AI 的价值会流向那些进行组织重构的公司,而不是仅仅把 AI 叠加到现有工作流上的公司。面向 AI 原生运营的操作手册、变革管理框架和指标体系在市场上仍然缺失。 ([@PeterDiamandis,@adxtyahq)
**++] AI 安全与福利评估服务**——JP Morgan 撰写安全简报、白宫就 Mythos 与 Anthropic 接触、首个针对 Claude 的外部福利评估,以及关于 consciousness 讨论的 39 个书签,都表明 AI 安全已经进入机构层面的需求阶段。面向企业和政府买家的安全评估、监测与报告服务,是一个刚刚萌芽的市场。 ([@NunoSempere,@danwilliamsphil)
**+] 超越 Claude-Codex 双寡头的 AI 编码工具**——从业者已经不再评估替代方案。Kimi K2.6 是一个较早的入局者,但尚未得到验证。若出现第三个可信选项,能够在生产仓库表现上展开竞争,将能服务那些需要供应商多元化和价格竞争压力的团队。 ([@haider1,@ivanfioravanti)
8. 核心结论
-
AI 评测正陷入危机:使用最广泛的基准代理指标(GDPval-AA)易被操纵,但所有主要实验室仍在使用它。 Ethan Mollick 称其为“极其容易被操纵、表面效度很低的输出结果”。普林斯顿提出了开放世界评测,SIGIR 引入了市场仿真。基准所测量的内容与部署中真正重要的内容之间,鸿沟正在扩大。(来源)
-
AI 意识在一天之内就从学术推测走向了机构层面的关切。 Claude 的首次外部福利评估已经完成,JP Morgan 正在撰写关于模型行为的安全简报,白宫也就 Mythos 向 Anthropic CEO 进行了了解。关于意识的讨论收获了 39 个收藏,说明从业者对这一议题保持持续关注。(来源)
-
AI 编程已经收敛为 Claude Code 与 Codex 的双寡头格局,而从业者也已停止评估替代方案。 Kimi K2.6 是第一个潜在挑战者,但仍缺少基准测试。与此同时,三段初创公司自由职业经历证实,以 AI 对 AI 为特征的开发工作流——机器人生成 PR,再由其他机器人审查——如今已成常态。(来源)
-
哈佛商学院对 515 家初创公司的研究显示,营收翻倍来自组织重构,而不是 AI 产品本身。 再结合合同 ARR 膨胀问题(约高报 3 倍)以及欧洲 VC 关于“监管才是下一个大趋势”的讽刺说法,AI 初创公司生态正在分化为真正推动流程创新者与夸大指标者两类。(来源)
-
Google Auto-Diagnose 展示了成熟 AI 部署应有的样子:224,782 次执行、90.14% 准确率、56 秒中位延迟,以及在 22,962 名开发者中的 5.8%“没有帮助”率。 这才是 AI 初创公司最终需要达到的证据标准——大规模生产环境指标,而不是演示数字。(来源)
-
TSMC 在 FY26 Q1 的 HPC 营收占比达到 61%,高于四年前的 41%,确认了向推理算力转移的结构性变化。 其他所有业务板块都在下滑。半导体行业正在围绕 AI 需求被永久性重塑,而不是仅仅经历一次周期波动。(来源)
-
58% 的 Solidity 开发者每天使用 AI,这在智能合约开发中形成了系统性的安全风险。 调查结果(n=650)显示,每月 AI 采用率达到 88%。在缺乏充分人工审查的情况下,对关键金融合约进行 vibe coding,几乎就是在等待事故发生。(来源)