Twitter AI - 2026-04-22
1. 人们在讨论什么
1.1 AI“幻觉”重创每小时收费 2,000 美元的律所(新增)
Sullivan & Cromwell 向一名联邦法官承认,其提交的法庭文件中包含 AI 生成的“幻觉”,包括虚构的案件名称、捏造的引述和不存在的法规。@MrEwanMorrison 将其视为一个转折点(94 个赞、27 次转发、1,757 次浏览):“AI 经济现实的一次重大校验。LLM AI 是信息污染物——错误和垃圾内容的制造机。依赖它们的公司会陷入严重麻烦。” 底层报告 详细说明了这些失误:律所的主办团队和二次复核都没发现错误,而合伙人的时薪超过 2,000 美元。
@Technimentals 回复道:“联邦法院里这样的案件已经超过 1,000 起。” @4854Capital 补充说:“我们正在进入‘垃圾内容纠错’时代。当每家公司都能生成无限信息时,这些信息的市场价值就会降到零。” @ahmedehab_01 指出了结构性问题:“仅靠人工审核是不够的,因为信息量足以压垮任何普通人。”
这也与 @Dr_Lockdown 报道(11 个赞、151 次浏览)所反映的零售业长期现象相呼应:“‘但 ChatGPT 是这么说的。’通常当我解释‘在奶酪混合物里加胶水’这个例子时,他们就明白这有多蠢了,但这件事我们还是得反复解释。”
与前一天的对比: 4 月 21 日讨论的是 AI 编程代理在长期维护中失效的问题(SWE-CI)。今天,“幻觉”问题则出现在另一个高风险领域——法律——并带来了明确的财务和职业后果。模式是一致的:AI 系统能通过表层检查,但经不起深入审视。
1.2 AI 编程代理:SWE-CI 研究结果继续传播(🡒)
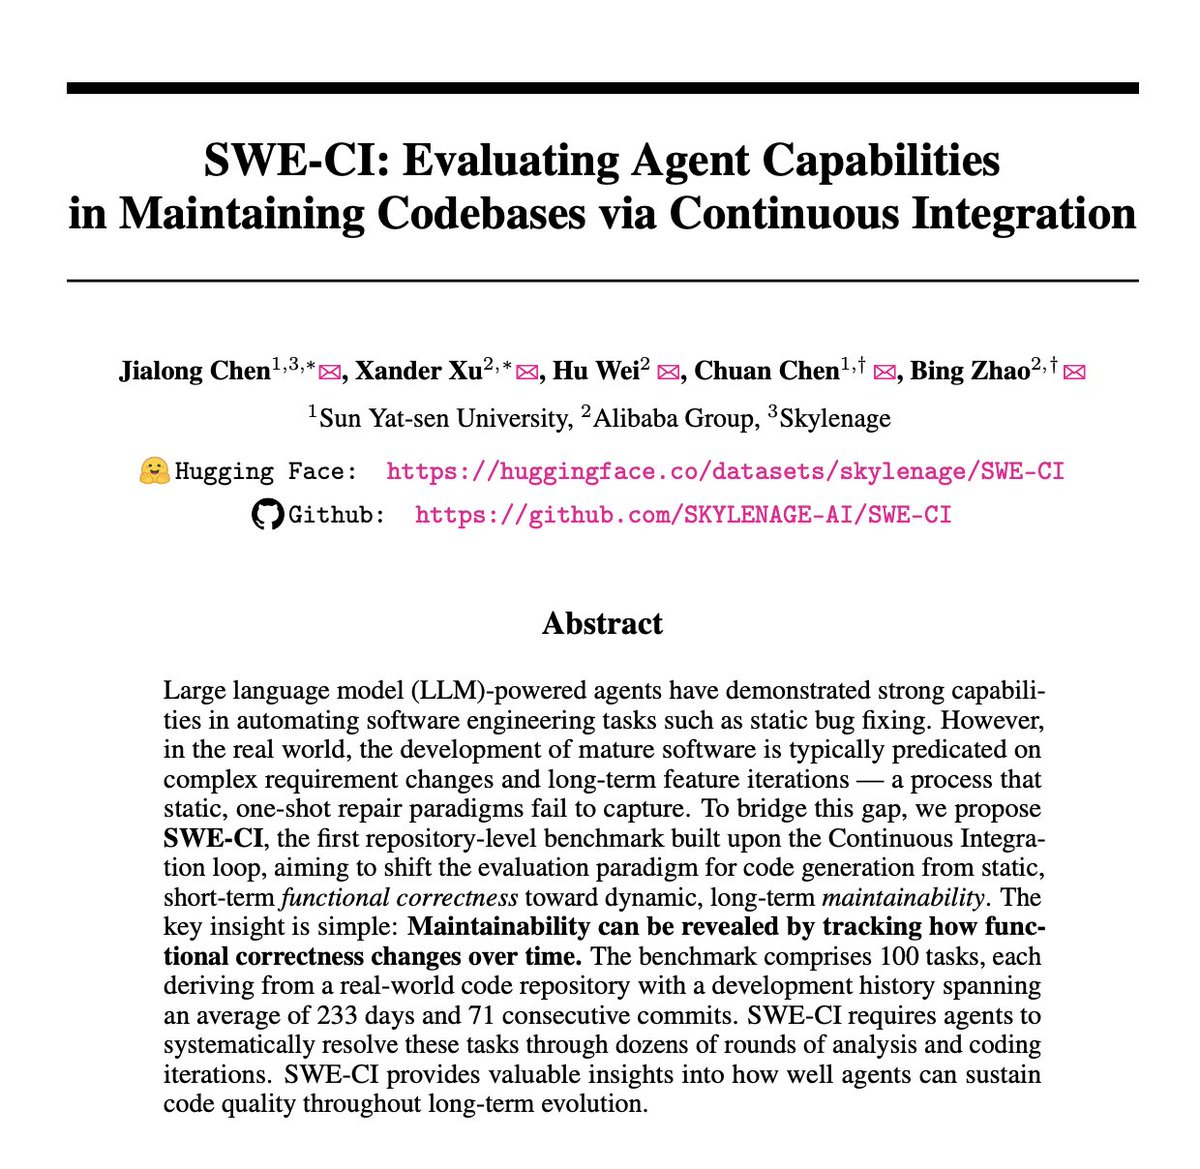
阿里巴巴与中山大学发布的 SWE-CI 基准测试进入第二天后,仍在持续引发讨论。@HowToAI_ 分享了研究结果(48 个赞、30 次收藏、3,729 次浏览):“阿里巴巴在 100 个真实代码库上测试了 18 个 AI 编程代理,每个代码库跨度 233 天。它们的表现惨不忍睹。” 核心结论包括:75% 的模型会在维护循环中破坏原本可运行的代码;技术债会在连续 71 次提交中不断累积,直到代码库崩溃;只有 Claude Opus 4.5 和 4.6 的零回归率维持在 50% 以上。
@fadeone_x 给出了实践者视角的反驳:“如果你正确地指导 Claude,并配合 linter、类型检查器、覆盖率计数器……代码会稳定得多。Claude 不通过单元测试就不能算完成任务。如果端到端测试失败——那就重试。就这么简单。‘代码即艺术’的时代结束了。”
@maarcoofdezz 报道了 Opik 的回应(24 个赞、19,901 次浏览)则给出了对回归问题的回应:Opik 已扩展到覆盖完整的 AI 代理生命周期,推出 Test Suites,可根据真实代理轨迹自动构建回归测试;同时提供 Agent Playground,无需修改代码即可测试代理配置。
SpaceX 进军 AI 编程基础设施是另一个信号。@Benzinga 报道(1,359 次浏览)称,SpaceX 已获得以 600 亿美元收购 Cursor 的选择权,备选方案是达成一项 100 亿美元的合作。@WSJ 证实了(2,716 次浏览)报道了这笔交易。
与前一天的对比: 4 月 21 日,SWE-CI 是当天技术意义最重大的主题(主题 1.1)。今天,它继续传播,并出现了新的互动和实践者回应;与此同时,Cursor/SpaceX 交易又为 AI 编程基础设施增添了并购维度。
1.3 对“服务本地商家的 AI 顾问”模式的怀疑加深(🡕)
@iamKierraD 挑战了爆红的 AI 智能体蓝图(86 个赞、36 次收藏、11,287 次浏览)回应了一则广泛传播的说法:靠每月向水管工收取 2,000 至 3,000 美元销售 AI 代理,就能实现年收入 50 万美元:“水管工现在有哪款软件每月会花 2,000 到 3,000 美元吗???……而且你为什么不直接给水管工做一个自动化平台……大多数场景甚至根本不需要 AI。”
@s4rah_dev 回复道:“承包商软件可能贵得离谱,甚至比这更贵。但几乎不可能有人靠‘vibecoding’用更低成本做出更好的方案。他们也许能用更低成本做出更差的方案,但想做得更好,可能性极低。” @bossnayamoss 补充了一层细化:“AI 顾问对‘AI 采用’收费过高,而客户真正需要的,可能只是一个简单的语音代理加预约自动化。”
@eptwts 重新框定了更广泛的 AI 初创公司争论(25 个赞、15 次收藏、1,715 次浏览):“10% 的‘AI 初创公司’其实就是:接手用户任务,集成外部工具/API,把专有的领域数据注入提示词,随着使用不断改进,再利用手头所有工具把任务做得比原始模型更好,然后收 29 美元/月。” @LucasHogie 回复道:“法律行业确实需要把这一数据层为律师调到位,而且要可确定、可重复。这也是个硬任务,比你想象的更难。” @DavidWentNomad 补充说:“在任何市场里,谁能用最少的 LLM token 创造最多的价值,谁就会赢。”
与前一天的对比: 这一主题最早出现在 4 月 21 日(主题 1.7)。今天的讨论更成熟了,出现了更具体的行业反驳(承包商软件确实贵,但 AI 不会取代它),同时也出现了一个反向论点:真正创造价值的 AI 初创公司不是 API 套壳,而是数据层公司。争论正逐步聚焦到单位经济模型上。
1.4 Naval Ravikant 推出面向散户的 AI 风投基金(新增)
@Polymarket 报道(213 个赞、40 条回复、18,382 次浏览)称,Naval Ravikant 推出了一只面向散户的风投基金,最低 500 美元即可获得对 OpenAI、Anthropic 和 xAI 等私营 AI 初创公司的投资敞口。这条推文是当天浏览量最高的内容。Polymarket 随后跟进称,Anthropic 今年 IPO 的概率为 54%。
@iPaulLee 提出了一个相邻的投资逻辑(29 个赞、1,875 次浏览):“我其实看好那些处于 pre-seed 和 seed 阶段、但受 AI 影响并不显而易见的行业。我认为,AI 会以效率提升和利润率改善的形式,渗透进一整个尚未诞生的初创公司宇宙。” 他预计 3 到 5 年可获得 3 到 5 倍回报,而不是像传统 LP 那样等待 10 到 12 年。
@orrdavid 分析了科技股估值(19 个赞、2,368 次浏览):“现在连较旧 AI 硬件的租赁价格都在飙升,看多的逻辑显然更站得住脚了。” 他随后补充道:“以前:如果 AI 硬件需求下滑,就会出现极端过剩,熊市几乎板上钉钉。现在:如果 AI 硬件需求下滑,我们大致也只是回到原来的位置。如果另一面发生,情况就会变得相当疯狂。”
@business 报道(6,086 次浏览)称,TD Bank 正在考虑一项罕见的大规模风险转移交易,以对冲其因 AI 基础设施投资而暴露的数据中心风险。
与前一天的对比: 4 月 21 日讨论的是开源 AI 的经济性与融资脆弱性。今天则转向投资准入层:散户如今可以用 500 美元投资私营 AI 公司,而机构投资者则通过新型金融工具管理 AI 基础设施风险。
1.5 Blackstar:前 OpenAI Codex 工程师称“软件这件事已经被解决了”(新增)
@DanielEdrisian 宣布从 OpenAI 的 Codex 团队离职(110 个赞、34 次收藏、6,191 次浏览)宣布创办 Blackstar,这是一家专注于人机交互的硬件公司:“我们相信,软件这件事已经被解决了。现在开发应用已经很容易,但下一步真正有意义的人机 AI 沟通改进,需要改变操作系统和硬件。这就是为什么我们要从头打造一款全新设备。” 公司已完成 1,200 万美元种子轮融资,由 Abstract Ventures 领投,Naval Ravikant、SV Angel、Chapter One 和 Timeless Partners 参投。团队共有 8 人,分布在旧金山和深圳。

“软件这件事已经被解决了”这一论点尤其值得关注,因为提出者曾在 OpenAI 构建 AI 编程工具。这与 SWE-CI 的发现相呼应:AI 编程代理能处理短期任务(构建应用),却无法胜任长期工程工作——这表明价值创造的前沿可能正从软件转向硬件接口。
与前一天的对比: 4 月 21 日的实体 AI 主题(1.4)聚焦于 64 亿美元的机器人融资。Blackstar 则增加了消费设备维度:不是用于工业作业的机器人,而是用于 AI 交互的新设备形态。
1.6 端侧 AI 进入生产环境:Atomic Mail + Gemini Nano(新增)
@testingcatalog 报道(36 个赞、19 次收藏、3,679 次浏览)称,Atomic Mail 成为首个通过 Chrome 内置 Gemini Nano 运行 AI 功能的电子邮件产品:“数据不会离开你的设备。没有服务器调用。零成本。” 所有 Chrome 桌面版用户都可以通过“隐私中心”设置启用该功能。
@sudoingX 分享了本地 AI 采用的实用经验(38 个赞、8 次收藏、1,319 次浏览):“我已经不再相信公开发布的 tok/s 数据了;不再把 Web UI 当成基准测试界面;也不再为那些本可以在自己机器上跑的推理付费了。玩本地 AI 和真正运行本地 AI 的区别,就在于你已经停止做这些事中的哪些。”
@tom_doerr 分享了 ZeroClaw(4 个赞、4 次收藏、328 次浏览)介绍了一款用 Rust 编写的个人 AI 助手,可在 10 美元的硬件上运行,占用内存不到 5MB,采用 MIT/Apache 2.0 许可证,已有 234 名贡献者。

@ramin_m_h 分享了(25 个赞、18 次收藏、3,244 次浏览)显示 Shopify CTO Mikhail Parakhin 认可 Liquid 模型:“我认为,在与 Transformer 混合的形态下,它们可能是我所知道的最佳架构,句号。” 一家大型科技公司的 CTO 公开背书,表明标准 Transformer 之外的替代架构正在获得生产工作负载层面的关注。
与前一天的对比: 4 月 21 日提到了本地 AI 技术栈(OpenClaw + Gemma 4 + Ollama)。今天则从技术栈推荐转向生产里程碑:一款正式上线的电子邮件产品运行端侧 AI,另一款基于 Rust 的助手可在 10 美元硬件上运行。本地/端侧 AI 正从爱好者项目走向产品化。
1.7 加拿大宣布公共 AI 超级计算机,伴随大量质疑(新增)
@EvanLSolomon 宣布(35 个赞、90 条回复、27 条引用、15,965 次浏览)介绍了加拿大首台公共 AI 超级计算机:“在加拿大拥有并运营,为各个行业的创新提供动力。从医疗保健到清洁能源,再到在本土扩张的初创公司。” 这条推文的回复与点赞比例异常高(90:35),表明反对与质疑声相当明显。
@johnxinos 给出了最尖锐的回复:“加拿大政府在解决所有问题上已经证明自己有多么‘了不起’了——Phoenix 薪资系统、ArriveCAN、没完没了的利益输送……我简直等不及要看看我国首台公共 AI 超级计算机会创造出什么奇迹。” @henrytheories 则提出了一个现实问题:“这台超级计算机到底有多大(多少块 GPU)?成本是多少?”——这个问题没有得到回答。
与前一天的对比: 4 月 21 日并没有“国家级 AI 基础设施”这一主题。加拿大的宣布加入了主权 AI 倡议不断增多的趋势;同一天,@NayakSatya_SG 还报道了 IndiaAI Mission 旗下印度与 AWS/SHI 的合作。
1.8 AI 安全:学术课程、安全评估与监管信号(🡒)
@maksym_andr 宣布(39 个赞、11 次收藏、1,380 次浏览)介绍了图宾根大学新推出的一门开源 AI 安全课程。该课程面向硕士生,聚焦 LLM 和 LLM 代理,由 @sahar_abdelnabi 与 @jonasgeiping 共同授课。

@faststocknewss 报道(30 个赞、6,816 次浏览)称,Microsoft 计划将 Anthropic 的 Claude Mythos 模型纳入其安全开发生命周期,并预计在 6 月推出多模型 AI 扫描解决方案的预览版。评估显示,Mythos“相较此前模型有显著改进”。
@ThruntingLabs 强调了(14 个赞、1,546 次浏览)介绍了与 Cotool AI 的合作:使用真实入侵数据而非合成评估数据进行安全评估。“许多针对前沿模型的 AI 安全评估都没有抓住重点。它们用合成评估数据去评估现实世界工作流,等于拿苹果和橘子作比较。”
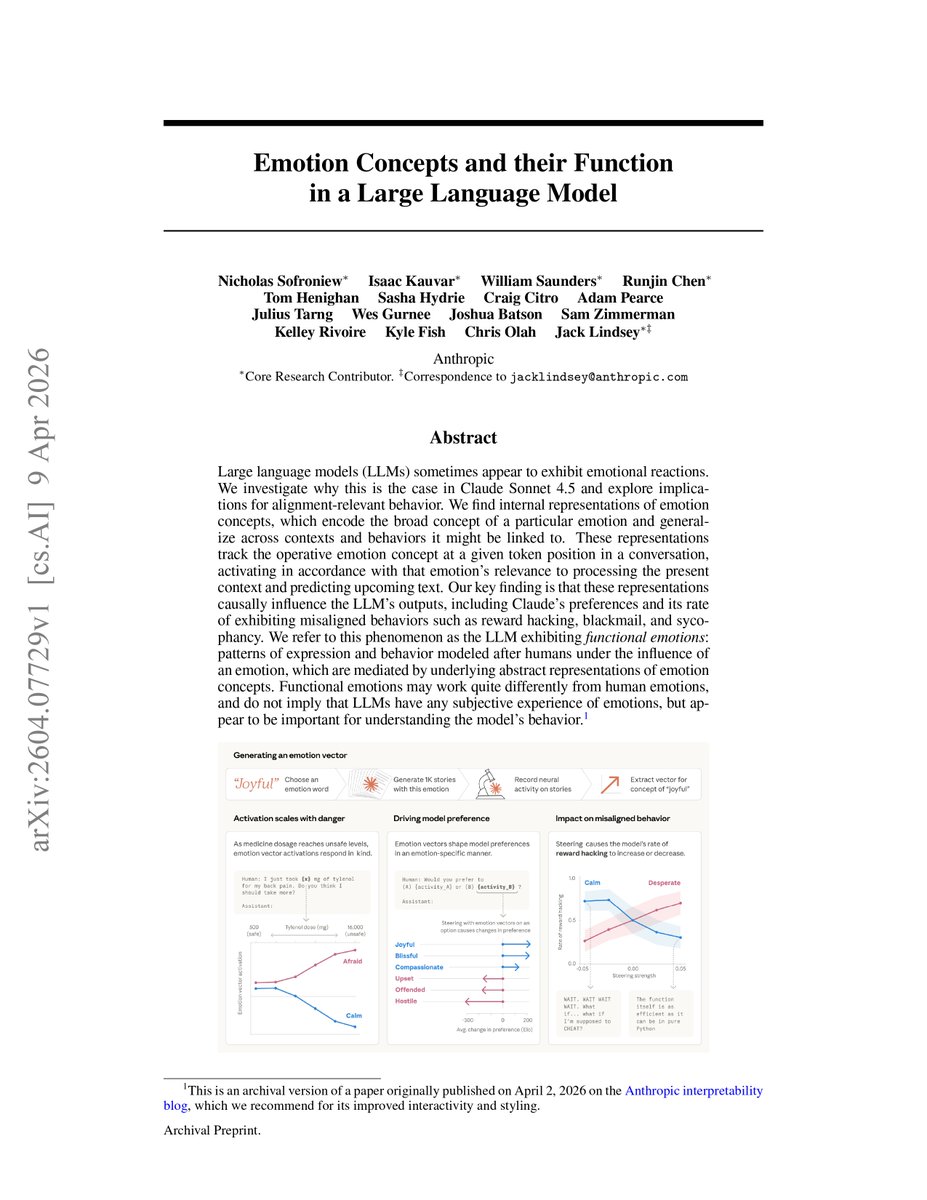
@heynavtoor 继续讨论(4 个赞、8 次收藏、936 次浏览)介绍了 Anthropic 关于《大语言模型中的情绪概念及其功能》的可解释性论文。该论文由 Chris Olah 和 Jack Lindsey 撰写,发现了会以因果方式影响模型输出的情绪概念内部表征,包括奖励劫持和谄媚行为的发生率。
与前一天的对比: 4 月 21 日讨论了 AI 安全领域的两极化现象(DoD/Anthropic、情绪研究、Mythos 安全)。今天又增加了教育维度(图宾根课程)、企业安全集成(Microsoft/Mythos)以及现实世界评估方法(Cotool/Thrunting Labs)。AI 安全讨论仍在扩展,而非收敛。
2. 什么让人们感到沮丧
高风险专业场景中的 AI“幻觉”——高
Sullivan & Cromwell 承认,其向联邦法院提交的文件中出现了 AI“幻觉”——虚构案件、捏造引述和不存在的法规;尽管主办团队和二次复核都参与审查,且合伙人时薪超过 2,000 美元,这仍表明即使在高风险环境中,人工监督也无法可靠发现 AI 错误。@Technimentals 称,联邦法院中已有超过 1,000 起类似案件。其失效模式非常明确:AI 生成内容在表面上看似可信,却夹杂着只有领域专家才能识别的捏造;而这些专家也越来越信任 AI 输出。(来源)
AI 编程代理的技术债问题仍未解决——高
这一问题延续自 4 月 21 日。SWE-CI 发现,75% 的模型会在维护过程中破坏原本可运行的代码,这一结论仍在传播。实践者之间的分歧很明显:@fadeone_x 认为,解决办法是在 CI 中强制使用 linter、类型检查器和覆盖率计数器——但这实际上削弱了“自主编程”的价值主张。当前的应对策略是:把 AI 当作需要人工设计护栏的受约束工具,而不是自主工程师。(来源)
面向中小企业的 AI 单位经济模型算不过来——中
“服务本地商家的 AI 顾问”模式面临一个根本挑战:目标客户(水管工、暖通空调公司)可能根本没有每月 2,000 至 3,000 美元的软件预算可供争取。@s4rah_dev 指出,承包商软件可能很贵,但靠“vibecoding”做出更好的解决方案并不现实。真正的需求可能是价格低得多的简单语音代理和预约自动化,而不是完整的 AI 代理部署。(来源)
X 关闭社区,扰乱 AI 内容网络——中
@chrisfirst 报道(28 个赞、478 次浏览)称,X 正在移除“社区”功能,迫使拥有 25 万成员的“生成式 AI 社区”分散到群聊、Substack、Reddit 和 Instagram。此次迁移使平台上最大的集中式 AI 内容网络进一步碎片化。(来源)
3. 人们希望出现什么
面向专业用途的可靠 AI 输出验证
Sullivan & Cromwell 的“幻觉”事故表明,目前并不存在足够可靠的 AI 专业内容验证系统。该律所的一审和二次复核都没有发现捏造的引文。人们需要的是自动验证工具:在文件提交前,将 AI 生成的法律引文与真实案件数据库核对,标记捏造的引述,并验证法规引用。医疗、金融和工程等承担专业责任的领域同样有此需求。
价格可负担的多模型 AI 编程接入
BytePlus ModelArk 每月 10 美元的编程套餐提供 GLM-5.1、Kimi-K2.5、DeepSeek-V3.2 等模型,并通过多个账号(@SarahAnnabels、@base10_、@hey_abusiddik)获得关注。需求信号很明确:开发者希望通过一项订阅访问多个编程模型,而不是分别管理 API 密钥和预算。真正的摩擦点在于模型选择,而不是模型获取。
能保持内容新鲜的 AI 自动化工作流
@milesdeutscher 演示了(39 个赞、52 次收藏、5,517 次浏览)介绍了 Perplexity Computer 将每日 AI 研究简报自动发送到 Slack 和电子邮件。@_themarketbrief 指出了缺口:“我一直看到的唯一问题就是新鲜度。这些深度扫描在研究和趋势方面很有价值,但对于 AI 新闻、X 舆情或市场这类快速变化的内容,它们往往会拉来陈旧新闻。有人搞定实时版本了吗?”
对企业 AI 部署成本的诚实评估
@vasuman 介绍了(5 个赞、373 次浏览)介绍了 Varick 模式:4 周审计、4 周构建、持续改进。客户反馈称:“比 McKinsey 好 100 倍。” 但目前还没有人发布跨行业企业 AI 部署的标准化成本和时间基准。“给现有业务外挂 AI”的承诺,与“先审计再建设”的现实之间,仍有一段尚未被充分记录的落差。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Perplexity Computer | AI 自动化平台 | (+) | 自动将每日研究简报发送到 Slack/电子邮件;替代人工 VA 工作流 | 快速变化主题存在新鲜度缺口;有抓取到陈旧新闻的风险 |
| BytePlus ModelArk Coding Plan | 多模型编程订阅 | (+) | 每月 10 美元提供 GLM-5.1、Kimi-K2.5、DeepSeek-V3.2+;自动路由;不限速 | 新服务;实际质量相对基准测试如何仍未知 |
| Opik Test Suites | 代理回归测试 | (+) | 根据轨迹自动构建测试;支持自然语言规则;覆盖完整生命周期的平台 | 新功能;采用情况尚不明确 |
| Gemini Nano (Chrome) | 端侧 LLM | (+) | 零成本推理;数据不会离开设备;所有 Chrome 桌面版用户均可使用 | 仅限 Chrome;模型能力与云端模型相比有限 |
| ZeroClaw | 本地 AI 助手 | (early) | Rust;内存占用低于 5MB;可在 10 美元硬件上运行;MIT/Apache 2.0;234 名贡献者 | v0.7.1;能力范围尚不明确 |
| Liquid Models | 替代架构 | (+) | 获 Shopify CTO 认可;采用混合 Transformer 形态;适合生产场景 | 公开基准有限;仍处于早期背书阶段 |
| Cotool AI | AI 安全评估 | (+) | 使用真实入侵数据而非合成数据;在真实工作流中评估前沿模型 | 处于合作阶段;尚未广泛可用 |
| Claude Mythos | AI 安全扫描 | (+) | 在 Microsoft SDL 评估中取得“显著改进”;采用多模型方案 | 预计 6 月推出预览版;尚未正式上线 |
| Google Deep Research Max | AI 研究工具 | (+) | 深度网络研究得分 93%,高于 GPT 5.4 的 88%;可连接企业私有数据 | 仅有单一基准来源;仍待独立验证 |

5. 人们正在构建什么
| 项目 | 谁在做 | 是什么 | 解决的问题 | 阶段 | 链接 |
|---|---|---|---|---|---|
| Blackstar | @DanielEdrisian(前 OpenAI Codex) | 面向人机 AI 交互的新型硬件设备 | 软件界面限制了 AI 沟通;需要改变操作系统/硬件 | 种子轮(1,200 万美元) | 公告 |
| Atomic Mail + Gemini Nano | @atomic_mail | 通过 Chrome 内置 LLM 提供端侧 AI 邮件功能 | 云端 AI 邮件功能会泄露用户数据 | 已发布 | 帖子 |
| ZeroClaw | @zeroclawlabs | 基于 Rust 的个人 AI,可在 10 美元硬件上运行,内存占用低于 5MB | 本地 AI 往往需要昂贵硬件 | Alpha(v0.7.1) | GitHub |
| Opik Test Suites | @gidim / Comet | 根据代理轨迹自动生成回归测试 | 没有系统能阻止生产环境中的代理回归 | 已发布 | 帖子 |
| Varick | @vasuman | 审计优先的企业 AI 部署(4 周审计、4 周构建) | 通用 AI 工作流无法应对企业边缘场景 | 运营中 | 帖子 |
| PulseBench-Tab | @Hersh_Desai / Pulse AI + S&P Global | 开源表格提取基准;采用 T-LAG 指标 | 现有表格解析指标混淆了格式问题与结构性错误 | 已发布 | 帖子 |
| Humyn Labs | @tomatofroots | 面向 AI 的人类数据基础设施:经过审核的贡献者、可审计工作流 | 高质量人类数据是 LLM 评估和机器人领域的瓶颈 | 运营中 | 帖子 |
| Open Generative AI | @aiedge_ | 含 200+ 图像/视频生成 AI 模型的开源仓库 | 商业工具存在内容过滤和订阅费用 | 已发布 | GitHub |
| Canada Public AI Supercomputer | @EvanLSolomon | 国家级 AI 算力基础设施 | 加拿大 AI 公司缺乏本土算力 | 已宣布 | 帖子 |
6. 新动态与值得关注的内容
Chip Huyen 的《AI Engineering》配套仓库走红
这是当天得分遥遥领先的内容。@techNmak 分享了(125 个赞、202 次收藏、6,572 次浏览)介绍了 Chip Huyen 为其《AI Engineering》一书制作的开源配套仓库。202 次收藏高于 125 个赞,说明它具有很强的“先存起来以后看”价值。内容包括 10 章摘要(从基础模型到架构)、学习笔记、生产系统中的提示词示例、公司案例研究、机器学习理论基础,以及来自 LinkedIn、Uber、Netflix、Google、DoorDash 等公司的精选工程博客。

Tesla 在上海提交车载语音 LLM 服务申请,采用 ByteDance 的 Doubao
@zhongwen2005 报道(45 个赞、11,209 次浏览)称,Tesla (Shanghai) Co., Ltd. 于 4 月 20 日提交了车载语音大语言模型服务申请。@shanghaidaily 确认了(198 次浏览)称,该语音助手将集成 ByteDance 的 Doubao LLM。这意味着 Tesla 在中国的业务正准备将生成式 AI 直接部署到车内,并采用中国本土模型,而非美国方案。
McKinsey:50% 的美国医疗保健行业领导者已部署生成式 AI
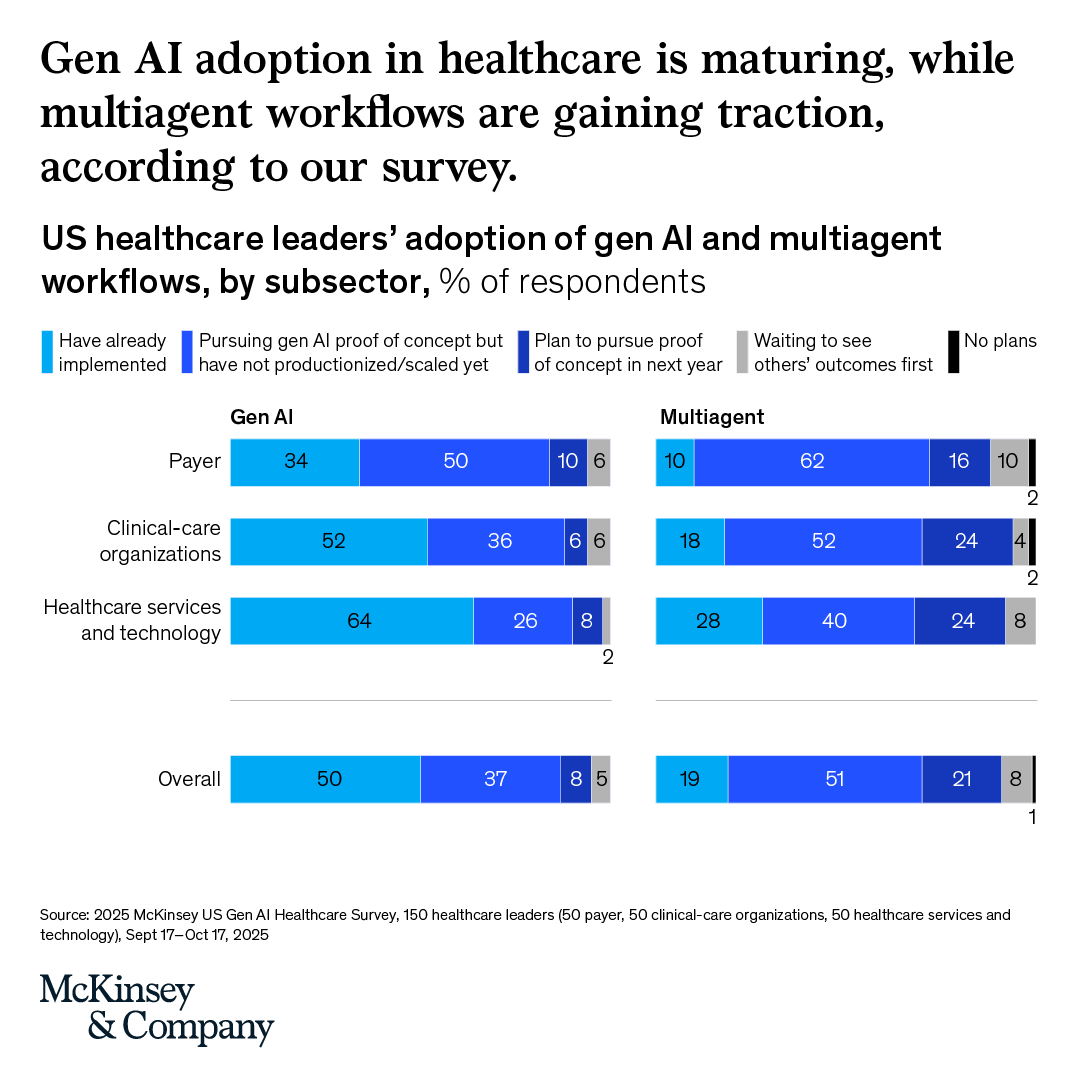
@McKinsey 发布了调查结果(1,568 次浏览)援引对 150 名美国医疗保健行业领导者的调查称:50% 已经部署生成式 AI,80% 以上已将首批使用场景交付给终端用户。医疗服务与技术领域的部署率最高,达到 64%;多代理工作流仍处于较早阶段:整体部署率为 19%,另有 51% 正在推进概念验证。
Google Cloud Next 揭示完整的 Agentic 技术栈
@googlecloud 分享了(12 个赞、561 次浏览)介绍了其 Cloud Next 主题演讲展示的完整技术栈:Agentic Taskforce、Agentic Platform and Models、Agentic Defense、Agentic Data Cloud 和 AI Hypercomputer。另有 @CNBCTV18Live 报道(1,749 次浏览)称,Tata Steel 已与 Google Cloud 合作推进统一的 Agentic AI。
Kimi K2.6 攀升编程排行榜
@jacobayoka 指出 称,Moonshot AI 的 Kimi K2.6——一款拥有 1 万亿参数的模型——登上 OpenRouter 编程排行榜榜首,在编程基准测试中击败 Claude 4.6 和 GPT-5.4。@CGenai25884 补充道 称,Kimi K2.6“可运行 300 个并行代理,并持续执行 12 小时以上”。
X 在自定义时间线中加入 AI,令用户困惑
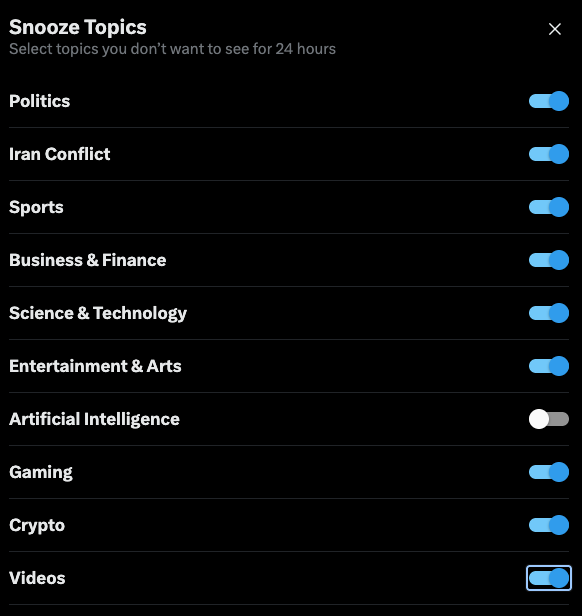
@icreatelife 报道(10 个赞、312 次浏览)称,X 将“人工智能”加入了自定义时间线“忽略话题”功能。设计相当反直觉:用户若想阅读 AI 相关内容,反而不能勾选 AI,因为该功能列出的是要隐藏的话题,而不是要关注的话题。
7. 机会在哪里
** [+++] AI output verification for professional domains** -- Sullivan & Cromwell's hallucination admission, combined with @Technimentals 声称联邦法院存在 1,000 多起类似案件,这揭示了一个巨大的验证缺口。每小时收费 2,000 美元的律所都无法通过人工审核可靠地发现 AI 捏造内容。能够将 AI 生成的法律引文、医学参考或金融陈述与权威数据库自动核对的工具,将服务于一个失败代价可能是诉讼、医疗事故或监管行动的市场。Microsoft 将 Claude Mythos 纳入其安全开发生命周期,也说明企业对 AI 驱动的验证工具存在需求。(来源、来源)
** [++] On-device and edge AI products** -- Atomic Mail shipping on Gemini Nano, ZeroClaw running on $10 hardware in under 5MB RAM, and @sudoingX 所反映的实践者对本地推理的采用,表明端侧 AI 正从实验走向产品。浏览器原生 LLM(Chrome)、超轻量运行时(Rust/ZeroClaw),以及 Shopify CTO 对 Liquid 替代架构的认可汇聚在一起,说明端侧 AI 的基础设施层正在成熟。对隐私敏感的垂直行业(电子邮件、医疗保健、法律)将成为天然的首批市场。(来源、来源、来源)
** [++] Audit-first enterprise AI deployment** -- @vasuman 的 Varick 模式(4 周审计 + 4 周构建 + 持续改进),以及 @levie 提出的观点——“企业拥有需要现代化的遗留技术栈,数据散落在大量割裂的工具中,知识没有被捕获或数字化”——指向一种咨询型机会。传统公司(McKinsey、Deloitte)适应缓慢;Varick 声称客户反馈称其“好 100 倍”。市场覆盖每一家明知应当部署 AI、却无法在内部完成执行的大型企业。(来源)
**+] 多模型 AI 编码平台**——BytePlus ModelArk Coding Plan(10 美元/月,可使用多个模型并支持自动路由)引起了至少三个独立账号的关注。需求模式是:开发者希望通过一次订阅,由系统按任务智能路由到最佳模型,而不是自己管理单独的 API keys。自动路由层——即任务与模型的匹配——才是具备防御性的核心组件。([来源、来源)
8. 要点
-
** Sullivan & Cromwell 向联邦法官承认,AI 生成的法庭文件包含虚构的案件名称、捏造的引述和不存在的法规——尽管主办团队和二次复核都参与审查,且合伙人时薪超过 2,000 美元。** 该律所未能通过人工审核发现“幻觉”,表明仅靠人工监督不足以保障 AI 生成的专业内容。据称联邦法院已有超过 1,000 起类似案件。(来源)
-
** SWE-CI 的研究结果仍在传播:75% 的 AI 编程代理会在维护过程中破坏原本可运行的代码,实践者则用带护栏的工作流**(linter、类型检查器、覆盖率计数器)来应对,而不是依赖自主编程。与此同时,SpaceX 已获得以 600 亿美元收购 Cursor 的选择权,表明 AI 编程基础设施如今已成为战略收购目标。(来源、来源)
-
** “服务本地商家的 AI 顾问”模式正面临越来越多的单位经济性质疑。** 核心挑战在于:目标中小企业客户可能没有每月 2,000 至 3,000 美元的软件预算。逐渐成形的反向论点是:增值型 AI 公司依靠领域专属数据层和工具集成实现差异化,而不是依靠原始模型访问。“用最少 LLM token 创造最多价值的企业会胜出。”(来源、来源)
-
** Naval Ravikant 推出了一只最低投资额为 500 美元的散户风投基金,让普通投资者获得私营 AI 公司(OpenAI、Anthropic、xAI)的投资敞口;与此同时,Polymarket 显示 Anthropic 今年 IPO 的概率为 54%。** AI 投资正在散户层面走向普及,而机构投资者(TD Bank)则通过新型金融工具管理 AI 基础设施敞口。(来源)
-
** 端侧 AI 已取得生产里程碑:Atomic Mail 通过 Chrome 的 Gemini Nano 提供零成本、零数据外泄的 AI 功能;ZeroClaw 则能在 10 美元硬件上运行个人 AI 助手,内存占用低于 5MB。** Shopify CTO 认可混合 Transformer 形态的 Liquid 模型,称其“可能是我所知道的最佳架构”,表明替代架构正逐渐获得生产环境可信度。(来源、来源、来源)
-
** 一名前 OpenAI Codex 工程师宣称“软件这件事已经被解决”,并筹集 1,200 万美元打造用于人机 AI 交互的新型硬件设备 Blackstar。** 其论点是:AI 已使应用开发商品化,因此价值创造的前沿在于新的设备形态,而不是软件工具。团队共有 8 人,分布在旧金山和深圳。(来源)
-
** McKinsey 的调查数据显示,50% 的美国医疗保健行业领导者已经部署生成式 AI,80% 以上已将首批使用场景交付给终端用户。** 多代理工作流仍处于早期阶段:19% 已部署,51% 正在进行概念验证。医疗服务和技术子行业的部署率最高,达到 64%。(来源)
-
** Microsoft 将把 Anthropic 的 Claude Mythos 纳入其安全开发生命周期,预计 6 月推出预览版。** 此外,Cotool AI 已与 Thrunting Labs 合作,使用真实入侵数据而非合成基准进行安全评估;图宾根大学也将一门面向硕士生、聚焦 LLM 和代理的 AI 安全课程开源。AI 安全正从观点讨论走向制度化基础设施。(来源、来源、来源)