Twitter AI - 2026-04-23
1. 大家在讨论什么
1.1 AI 在医疗领域达到临床基准(新)
@BoWang87 报道称(51 个赞、25 次收藏、3,185 次浏览)称,72% 的美国医生已在临床工作中使用 AI(AMA 2026),而 ChatGPT 的临床使用率在一年内翻了一番。OpenAI 的 ChatGPT for Clinicians 在 HealthBench Professional 上得分 59.0,超过人类医生的 43.7。Claude Opus 4.7 得分 47.0,也高于人类基线。该基准测试涵盖文书记录、诊疗咨询和文献综述——在这类检索与沟通任务上,LLM 相比时间紧张的临床医生具有结构性优势。
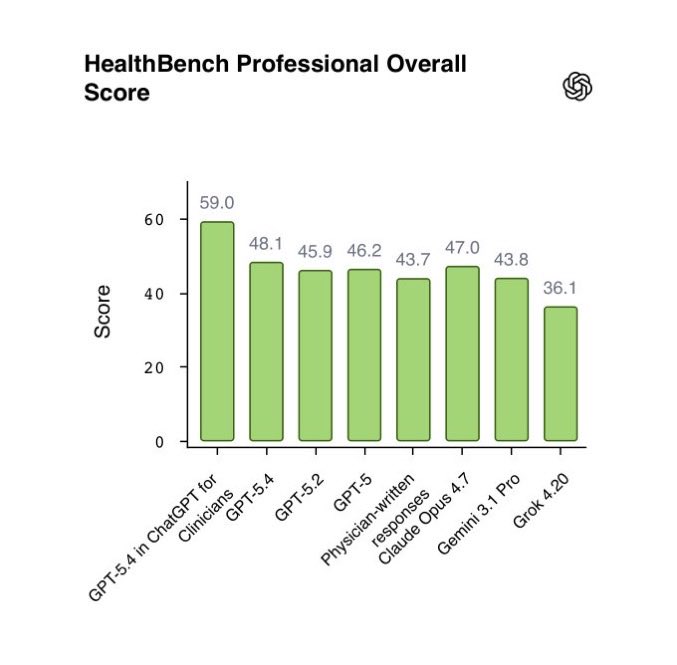

讨论要点: @jehangeer_hasan 提醒道:“这一说法主要反映的是 AI 在文书记录和信息综合等重文本任务中的强劲表现。这并不自动意味着它已能胜任完整的临床决策,尤其是在医学影像和多模态推理方面。” @BoWang87 也承认这一差距,并提到 MedSAM 和 EchoJEPA 可用于医学影像与视频解读。
与前一日对比: 4 月 22 日引用 McKinsey 数据称,50% 的美国医疗行业领导者正在部署生成式 AI。今天则进一步补充了细化的基准分数和一款已落地的临床产品,使讨论从采用率调查转向了与医生进行可量化的性能对比。
1.2 ICLR 2026:智能体评估与人机协作研究(新)
巴西 ICLR 2026 上的一组研究聚焦 AI 智能体评估、安全与协作中的核心挑战。@michaelryan207 介绍了 AutoMetrics(30 个赞、24 次收藏、2,223 次浏览)显示:只需不到 100 条人工反馈,就能生成自动评估指标;这些指标与人工判断的相关性,最高可比人工设计的 LLM-as-a-Judge 评分标准提升 33.4%。

@Diyi_Yang 分享了 Stanford 实验室完整的 ICLR 阵容(61 个赞、3,204 次浏览)提到七篇论文,涵盖“构想—执行鸿沟”(LLM 生成的研究想法与人类研究想法)、“通过模拟搜索 LLM 智能体中的隐私风险”、“暗黑模式如何操纵 Web 智能体”,以及用于评估人机协作的“Collaborative Gym”。

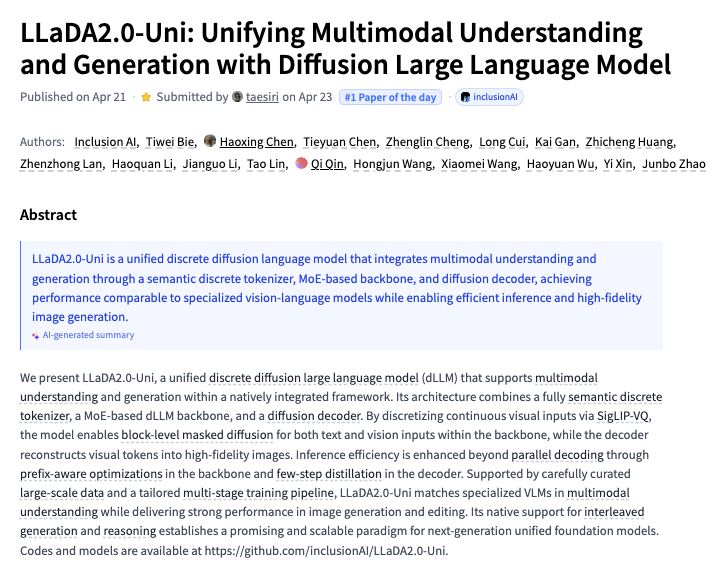
@_akhaliq 重点介绍了 LLaDA2.0-Uni(26 个赞、13 次收藏、4,209 次浏览)提到 HuggingFace 当日排名第 1 的论文:一种统一的离散扩散语言模型,通过语义分词器、MoE 主干网络和扩散解码器,同时实现多模态理解与生成。
讨论要点: AutoMetrics 的四步流程(生成候选标准、从 MetricBank 检索、拟合回归、输出可导入指标)填补了一个结构性空白:人工反馈成本高昂,而 LLM-as-Judge 评分标准与真实人类偏好的相关性又较弱。这批 ICLR 研究表明,领域重心正从模型能力转向评估基础设施。
与前一日对比: 4 月 22 日报道了用于编程智能体评估的 SWE-CI 和 Opik。今天的 ICLR 研究则将评估重点从编程扩展到内容质量、智能体隐私和人机协作。
1.3 AI 幻觉持续推动“低质内容纠偏”叙事(🡒)
@MrEwanMorrison 继续传播(133 个赞、38 次转发、2,495 次浏览)提到 Sullivan & Cromwell 承认:AI 生成的法庭文件中包含虚构的案件名称、捏造的引语以及并不存在的法律条文,尽管这些文件已经过收费高达每小时 2,000 美元以上的合伙人进行初审和复审。这条推文在发布后的第二天进一步发酵。
@4854Capital 概括了更广泛的含义:“我们正在进入低质内容纠偏时代。当每家公司都能生成无限量的信息时,这些信息的市场价值就会归零。” @ahmedehab_01 则指出其结构性局限:“仅靠人工审核是不够的,因为它会压垮任何普通人。”
与此同时,@Forbes 报道称(8 个赞、6,004 次浏览)称,倒闭初创公司的 Slack 存档、Jira 工单和电子邮件线程正被拿来清算;AI 实验室如今把这些内容视为高价值训练数据——这也引发了对模型训练数据质量的质疑,尤其是这些模型本就已经在产生幻觉。
讨论要点: @DaveShapi 提出了相反观点(32 个赞、2,763 次浏览)表示:“说 AI 是低质内容、没用,因此不会走远,就像说互联网是低质内容,因为在其上传输的大多数比特都来自流媒体、社交媒体和色情内容。但最有价值的用例是在企业里。” 这场争论已逐渐凝结为两派:AI 是低质内容生成器,还是企业基础设施。
与前一日对比: 这是 4 月 22 日的主题 1.1。今天,这一话题在获得更多互动的同时继续传播,并出现了“低质内容纠偏时代”的框架;此外,Forbes 从训练数据切入,增加了新的维度:AI 实验室正在获取职场通信内容作为训练材料,这可能进一步放大质量问题。
1.4 AI 安全政策进入新阶段:《经济学人》封面、CAISI 反转与争论(新)
《经济学人》发布封面文章《美国开始意识到 AI 的危险力量》,@ChrisPainterYup 连同关键引述一并分享(9 个赞、10 次收藏、704 次浏览)提到了这篇报道。文章指出了 AI 安全“默认方案”的结构性问题:限制模型发布“会削弱竞争、增强既有 AI 公司的影响力”,并在“美国经济内部制造出双层体系”。

@TheElizMitchell 率先披露了这一消息(41 个赞、12 次收藏、3,156 次浏览)称,商务部原本选定 Anthropic 前研究员 Collin Burns 领导 CAISI(人工智能标准与创新中心),随后又改变决定,改由 DOE 资深人士 Dr. Chris Fall 出任。背景是:战争部长 Pete Hegseth 将 Anthropic 称为“国家安全方面的供应链风险”,而据报道,NSA 正在使用 Anthropic 的 Mythos Preview。
@JoinYoungVoices 主持了一场牛津式辩论(6 个赞、297 次浏览)提出问题:“AI 公司能被信任去自我监管吗?”——讨论围绕政府干预与行业自律展开。
讨论要点: CAISI 的人事反转体现出其中的张力:政府一方面依赖 Anthropic 的模型(NSA 使用 Mythos),另一方面又将该公司视为安全威胁(五角大楼)。《经济学人》的分析表明,这种矛盾是结构性的,而非偶然现象。
与前一日对比: 4 月 22 日报道了图宾根大学的学术 AI 安全课程,以及 Microsoft/Mythos 的安全集成。今天则升级为政策层面的制度冲突:主流刊物推出封面报道,政府出现人事任命反转,公众辩论也开始成形。
1.5 Meta 裁员 8,000 人;AI 驱动的劳动力替代信号不断增多(新)@business 报道称(14 个赞,8,153 次浏览)称,Meta 计划裁减 10% 的员工,约 8,000 人,以提升效率并抵消高额 AI 支出。同日,@business 报道称(2 个赞,1,198 次浏览)称,澳大利亚联邦银行(Commonwealth Bank of Australia)将在推进 AI 的过程中裁减约 120 个岗位。
@fuzzstockdads 总结了这一模式:“在 AI 上砸下数十亿美元,裁掉数千名员工,然后把这叫作效率。” @SteadyCompound 分享了 ServiceNow CEO 的言论(6 个赞,394 次浏览)谈到定价转变时表示:“现在新增净业务中,50% 来自非按席位计费的模式,包括 token 和其他资产。” 谈及用工时,他表示:“随着自然减员,你不必再补这些岗位。” AI 已经处理了其客户服务场景中的 90% 用例。
讨论洞察: ServiceNow 的数据揭示了裁员背后的企业逻辑:当 AI 能处理 90% 的客户服务工作时,是否保留相应编制就变得可有可无。从按席位转向按 token 计费的定价模式,也反映了同样的趋势:软件公司正将收入与人类用户脱钩。
与前一天的比较: 4 月 22 日并没有出现劳动力替代这一主题。今天,Meta(8,000 人)、CBA(120 人)以及 ServiceNow CEO 关于“自然减员但不补员”的表态同时出现,构成了一个高度集中的信号。
1.6 主权 AI:台湾金融大模型加入不断扩大的国家级行动(新增)
@business 报道称(77 个赞,14,243 次浏览)称,台湾正启动一个项目,为金融行业开发大语言模型。@LeaT_Design 回应道:“台湾要打造自己的 LLM?胆子也太大了。希望它能应对真实市场的混乱,而不只是干净的理论数据。”
另外,@BoswellDoug 指出(8 个赞,143 次浏览)提到,加拿大宣布推出其首台公共 AI 超级计算机,且“由加拿大拥有并运营”,但这一消息也引发了外界对政府科技执行能力的质疑。@PTI_News 报道称(4 个赞,844 次浏览)称,德里将在 IndiaAI Mission 旗下设立两个 AI 卓越中心,目标覆盖 100 家初创公司、培训 7,000 人,并创造 1,000 个岗位。
@Legendaryy 报道称(4 个赞,191 次浏览)称,阿联酋承诺在两年内让其政府 50% 的运作由智能体 AI 驱动——“不是试点,不是聊天机器人,而是真正做出真实决策的智能体。”
讨论洞察: 单日内出现了四项主权 AI 倡议:台湾(面向金融领域的大模型)、加拿大(公共超级计算机)、印度(AI 卓越中心)和阿联酋(政府智能体 AI 部署)。四者路径各不相同——台湾打造行业专用模型,加拿大建设算力基础设施,印度建设人才能力,而阿联酋则直接把智能体部署进政府运作之中。
与前一天的比较: 4 月 22 日报道了加拿大超级计算机的消息(主题 1.7)。今天,这一趋势扩展到四个采取不同策略的国家,表明主权 AI 基础设施如今已成为全球优先事项,而不再是孤立举措。
1.7 中国的 AI 竞争地位:成本优势与悄然采用(新增)
@stevehou 分析了中国的 AI 战略(29 个赞,5,382 次浏览)表示:“中国从来不喜欢第一个去承担高成本类别风险。一旦发展路径被基本验证,中国就会以无与伦比的强度大规模复制,在追赶中凭借无可匹敌的价格展开竞争。” 他预测,既然 Anthropic 和 OpenAI 已经证明编程就是方向,中国实验室将“把手头的一切都砸进去”。
配套推文(19 个赞,23,212 次浏览)发问:“全球电动汽车市场发生过的事,会不会也发生在全球 AI 市场?” 从业者给出了具体证据。@ftning:“glm5.1 在 token 成本上非常惊人,kimi k2.6 更是直接强得离谱。据我了解,很多美国公司都在本地部署这些模型,用来补充前沿模型。” @factorydoge69:“听说很多软件初创公司为了节省成本,会在幕后使用中国开源模型。”
讨论洞察: @Empiricalcontra 提出了反驳:“如果顶尖模型在过时之前都不会向公众开放(比如 Mythos),这种情况就不太可能发生。现在的开源模型大多只是 Opus 的蒸馏版。” 这场争论的核心,是成本驱动的采用(价格仅为前沿模型一小部分的中国开源模型)与能力护城河(如 Mythos 这类受限的前沿模型)之间的对立。
与前一天的比较: 4 月 22 日提到 Kimi K2.6 在编程排行榜上攀升。今天则补上了战略层面的框架:美国公司正因成本原因悄然采用中国模型,这与电动汽车市场的演变逻辑相呼应。
1.8 Tesla 以 20 亿美元收购 AI 硬件公司(新增)
@PolymarketMoney 报道称(80 个赞,2,580 次浏览)称,Tesla 已同意收购一家 AI 硬件公司,交易总额最高可达 20 亿美元,支付形式为股票和股权奖励。@NotATeslaApp 提供了 2026 年第一季度财报的完整回顾(7 个赞,760 次浏览)报道了 AI 硬件更新、FSD、Robotaxi 和 Optimus 的相关公告。
与前一天的比较: 4 月 22 日报道了 SpaceX 获得以 600 亿美元收购 Cursor 的选择权。今天,Tesla 这笔 20 亿美元的 AI 硬件收购,为 Musk 生态在 AI 基础设施领域再添一项重大并购信号。
2. 令人沮丧的事情
专业场景中的 AI 幻觉,仍无法靠人工复核解决——高
Sullivan & Cromwell 的失误仍是最具代表性的案例:时薪超过 2,000 美元的合伙人进行了初审和复审,却依然漏掉了虚构案例、捏造引语和不存在的法条。结构性问题在于,AI 生成内容能够通过表面合理性检查,而其体量又超出了人工审查者的承受范围。@Technimentals 声称,联邦法院中已有 1,000 多起类似案例。专业领域目前还不存在足够有效的验证工具。(来源)
AI 驱动的裁员缺乏明确过渡方案——高
Meta 裁减 8,000 名员工、CBA 裁减 120 个岗位,两者都明确与 AI 效率目标相关;与此同时,ServiceNow CEO 表示:“随着自然减员,你不必再补这些岗位。” 令人沮丧的是这种叙事方式:企业一边在 AI 基础设施上投入数十亿美元,一边把裁撤劳动力包装成“效率提升”。没有任何一家公司在宣布这些举措时,同时提出再培训、过渡支持或替代就业计划。(来源, 来源)
智能体治理仍停留在理论层面,而智能体已进入生产环境——中
@Saboo_Shubham_ 发布了一套五层智能体治理栈(身份、工具治理、策略执行、行为检测、统一安全态势),但 @rugbist_ 点出了从业者面临的现实鸿沟:“我们大多数人还停留在‘智能体向我要助记词’这一层。真正的问题是,怎么把这些东西真正执行起来。” 治理框架在理论上已经存在,但执行机制并不存在。(来源)
AI 训练数据来自已倒闭公司,且未经同意——中
Forbes 报道称,一些倒闭的初创公司之所以被清算,正是因为其 Slack 存档、Jira 工单和邮件线程会被 AI 实验室视为高价值训练数据。生成这些数据的员工从未预期它们会被用于训练 AI 模型。这一做法引发了关于同意、隐私,以及职场通信在清算中是否应被视为可提取资产的疑问。(来源)
3. 人们希望存在的东西
面向专业领域的 AI 输出自动验证工具
这一主题延续自 4 月 22 日。Sullivan & Cromwell 的幻觉失误已经连续第二天传播,再次凸显出自动验证工具的缺失:这类工具应能将 AI 生成的法律引文与真实案例数据库进行核对,在提交文件前标记捏造的引语,并验证法条引用。医疗、金融和工程等 AI 输出涉及专业责任的场景,同样需要这类能力。
智能体治理执行工具@Saboo_Shubham_ 的五层治理栈提供了概念框架,但目前还没有可用于生产环境的成熟工具来落实它。真正需要的是:AI 智能体的身份管理、工具使用策略执行、行为异常检测,以及统一仪表盘,让运维人员看清智能体在生产环境里到底在做什么。治理理论与执行实践之间的鸿沟,正是智能体悄然失效之处。
成本透明的 AI 智能体运营
@sentry 提问(2 个赞,83 次浏览):“当系统里有 AI 智能体参与,而且这些智能体还会生成其他 AI 智能体时,你该如何监控系统?” LangWatch 在 PyPI 上的月下载量达到 318k,说明智能体监控已开始被早期采用。@showslikesummu 分享了 Caltryx(1 次收藏):“实时 AI 成本可观测性 + 硬性预算约束”,以便在失控智能体耗尽预算之前将其扼杀。当前需求是:看清层层级联的智能体成本,并实现自动化成本控制。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| ChatGPT for Clinicians | 临床 AI 助手 | (+) | 在 HealthBench Professional 上得分 59.0,高于医生的 43.7;引用可追溯至医学文献 | 仅适用于以文本为主的任务;影像和多模态推理尚未测试 |
| AutoMetrics | LLM 评估 | (+) | 少于 100 个反馈点;较手工设计的评分标准提升 33.4%;发表于 ICLR 2026 | 仍处于学术阶段;是否已部署到生产环境尚不明确 |
| n8n | 工作流自动化 | (+) | 按 @dan__rosenthal 的说法,是 AI GTM 技术栈的核心;可覆盖大多数自动化场景 | 随着规模扩大,正转向基于代码的工作流 |
| Claude Code | AI 智能体开发 | (+) | 为公司 OS 和 8 位数 GTM 技术栈中的 AI 智能体提供支持 | 属于多工具技术栈的一部分,并非独立方案 |
| HolmesGPT | 事故调查 | (+) | 面向 K8s、Prometheus、Jira、GitHub、PagerDuty 的 LLM 驱动根因分析 | 开源;成熟度尚不明确 |
| LangWatch | 智能体监控 | (+) | PyPI 月下载量 318k;提供 trace 级监控和成本跟踪 | 用于生产级智能体监控仍处于早期阶段 |
| MCP (Model Context Protocol) | AI 集成标准 | (+) | Social Leverage 这家 VC 机构将其用于项目发掘、尽调和报告;被称为“AI 的 USB-C” | 源自 Anthropic;采用广度尚不明确 |
| Qwen 3.6 27B | 开源 LLM | (+) | Apache 2.0 许可;在编程基准上胜过更大模型;经量化后可运行在配置不高的硬件上 | 刚刚发布;真实世界表现是否匹配基准成绩仍未知 |
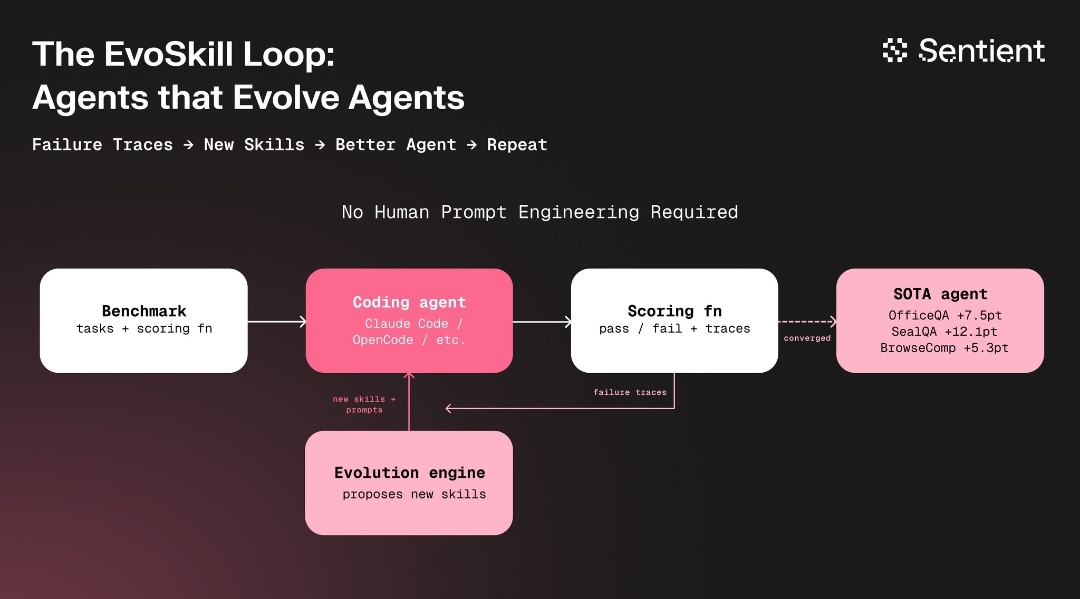
| EvoSkill | 智能体自我改进 | (early) | 可根据失败轨迹自动优化技能;OfficeQA +7.5 分,SealQA +12.1 分 | 处于研究阶段(Sentient) |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AutoMetrics | @michaelryan207 / Stanford + American Express | 基于少于 100 个人类反馈点自动生成 LLM 评估指标 | 手工设计的 LLM-Judge 评分标准与人类判断相关性较弱 | 回归 + MetricBank(48 个精选指标) | 已发表(ICLR 2026) | 帖子 |
| LLaDA2.0-Uni | inclusionAI | 用于多模态理解与生成的统一扩散式 LLM | 理解与生成分别需要不同模型 | 语义 tokenizer + MoE 主干 + 扩散解码器 | 已发表 | 论文 |
| ARTEMIS | Stanford / CMU / Gray Swan AI | 用于渗透测试的多智能体框架 | AI 渗透测试智能体表现不如人类 | 动态提示生成 + 子智能体 + 自动分诊 | 已发表 | 帖子 |
| EvoSkill v1 | Sentient | 通过失败轨迹分析自动研究 AI 智能体技能 | 依赖人工提示词工程来改进智能体 | 基准测试 + 编码智能体 + 进化引擎循环 | Alpha | 帖子 |
| HolmesGPT | Open source | 基于 LLM 的事故调查与根因分析 | 人工处理横跨 K8s、Prometheus、Jira、PagerDuty 的事故分诊 | LLM + 多源集成 | 已发布 | 帖子 |
| AI GTM Stack | @dan__rosenthal | 面向 go-to-market 的 10 工具 AI 自动化层 | 人工 GTM 流程无法扩展到 8 位数规模 | n8n + Claude Code + Supabase + Clay + HubSpot + vector stores | 活跃(正扩展至 8 位数规模) | 帖子 |
| Social Leverage AI Stack | @howardlindzon | 基于 MCP 的 VC 运营:项目发掘、尽调、报告 | VC 机构坐拥数据密集型工作流,却仍依赖人工运作 | MCP + Koyfin + Fiscal.ai + Ribbon.ai | 活跃(300M 美元 AUM) | 新闻简报 |
| RoboChem-Flex | @NoelGroupUvA | 成本 5,000 美元的全自主化学实验室 | 自动驾驶实验室对大多数研究团队而言成本过高 | 机器人流动化学 + AI 优化 | 已发表(Nature Synthesis) | 帖子 |
| LabWorld Factory | @AI4S_Catalyst | 用于训练 AI 科学家的模拟宇宙:100 个实验室资产、1,000 项技能、10,000+ 份协议 | AI 在接触真实试剂前需要先在数字环境中训练 | 模拟 + 可执行协议库 | 活跃 | 帖子 |
6. 新动态与值得关注的进展
ARTEMIS:AI 渗透测试智能体胜过 10 名人类安全专业人士中的 9 人
一篇来自 Stanford / CMU / Gray Swan AI 的论文,在真实企业环境中(约 8,000 台主机、横跨 12 个子网)首次系统性评估了 AI 智能体与人类网络安全专业人士的表现。具备动态提示生成和自动漏洞分诊能力的多智能体框架 ARTEMIS 总成绩位列第二,有效提交率达到 82%,胜过 10 名人类参与者中的 9 人。成本方面,ARTEMIS 各变体为 18 美元/小时,而专业渗透测试人员为 60 美元/小时。主要局限包括误报率较高,以及在基于 GUI 的任务上表现吃力。@p_misirov 指出(6 个赞,249 次浏览):“用专有经验搭建的定制化 harness,在结果上会胜过任何前沿模型。”

商务部撤回由 Anthropic 研究员领导 CAISI 的决定
@TheElizMitchell 报道(41 个赞,3,156 次浏览)称,前 Anthropic 和 OpenAI 研究员 Collin Burns 原本将出任商务部人工智能标准与创新中心(CAISI)负责人,但该部门在入职流程期间改变了决定,转而选择能源部老将 Dr. Chris Fall。此次逆转发生之际,Anthropic 一方面被五角大楼称为“供应链风险”,另一方面据报道 NSA 又在使用其 Mythos 模型。这一人事反转表明,政府应如何处理与前沿 AI 实验室的关系,机构内部仍存在未解的张力。
EvoSkill:让智能体进化其他智能体
@bafspot 介绍了 EvoSkill v1(8 个赞,82 次浏览)介绍了 Sentient 的一套闭环系统:由编码智能体运行基准测试、研究失败轨迹,再由进化引擎提出并测试新的技能与提示词。整个过程无需人工提示词工程。结果显示:OfficeQA +7.5 分,SealQA +12.1 分,BrowseComp +5.3 分。这一架构意味着智能体改进正从人工设计,转向自动化元优化。
Microsoft 确认集成 Mythos;6 月推出预览版
@faststocknewss 报道(32 个赞,7,460 次浏览)称,Microsoft 计划将 Anthropic 的 Claude Mythos 模型直接纳入其安全开发生命周期。新的多模型 AI 驱动扫描方案预计将于 6 月推出预览版。评估显示,Mythos“相较此前模型有显著提升”。这延续了自 4 月 22 日以来的趋势,如今时间表也已明确。
7. 机会在哪里
**+++] 专业领域中的 AI 输出验证**——Sullivan & Cromwell 的幻觉失误事件已传播两天且互动持续升温,同时 Forbes 报道已倒闭初创公司的数据被用于 AI 训练,这两者共同揭示了问题本身(AI 会生成看似可信的捏造内容)以及反馈循环(用职场沟通内容进行训练未必能提升可靠性)。能够自动将 AI 生成的法律引文、医学参考文献或金融主张与权威数据库进行核验的工具,切中了一个失败代价可能是诉讼、医疗事故或监管处罚的市场。据报道,仅美国联邦法院中就存在 1,000 多起类似案件。([来源, 来源)
**+++] AI agent 评估与监控基础设施**——ICLR 2026 上的 AutoMetrics 表明,只需极少人工反馈,自动评估指标就能胜过手工设计的评分标准。LangWatch 在 PyPI 上的月下载量达到 31.8 万次。Sentry 正在询问如何监控会生成其他 agents 的 agents。AI agents 的评估栈之于 AI agents,就像十年前的 CI/CD 之于软件:需求显而易见,工具链仍然碎片化,而最终赢家将拿下所有在交付 agents 的团队。([来源, 来源)
**++] 主权 AI 基础设施服务**——四个国家在同一天宣布了 AI 计划(Taiwan 金融 LLM、Canada 公共超级计算机、India AI centres、UAE 政府 agentic AI)。每个项目都需要模型训练、基础设施部署和劳动力发展方面的实施合作伙伴。机会存在于服务层:帮助各国政府执行其 AI 战略,而不只是构建模型。([来源, 来源)
[+] MCP-native workflow automation for professional services -- Social Leverage ($300M AUM) built an AI-native stack using MCP for deal sourcing, diligence, and reporting. @dan__rosenthal 分享了一个正扩展至 8 位数规模的 10 工具 GTM 技术栈。其背后的模式是:专业服务公司正在拼装多工具 AI 技术栈,但通过 MCP 进行集成仍然要靠自己动手。若能面向特定垂直领域(VC、法律、咨询)提供托管式 MCP 层,就能缩短实施时间,并获取经常性收入。(来源, 来源)
8. 要点
-
ChatGPT for Clinicians 在 HealthBench Professional 上得分 59.0,高于人类医生的 43.7;与此同时,美国已有 72% 的医生在临床中使用 AI。 该基准测试考察文档记录、照护咨询和文献综合——这些正是 LLM 在结构上比时间紧张的人类更占优势的任务。AI 擅长文本、却不擅长影像,这一落差仍是核心限制。(来源)2. ICLR 2026 集中出现了一批智能体评测研究:AutoMetrics 仅用不到 100 条人类反馈就能生成评测指标(较手工设计的评分标准提升 33.4%);斯坦福实验室则发布了 7 篇论文,涉及人机协作、智能体隐私风险和暗黑模式。 研究重点正从模型能力转向评测基础设施。(来源、来源)
-
《经济学人》刊发封面文章称,AI 安全的“默认方案”正在制造双轨经济;与此同时,美国商务部撤销了原定聘用一名 Anthropic 研究员加入其 AI 标准机构的决定。 美国政府一边依赖 Anthropic 的 Mythos 模型(NSA),一边又将该公司视为安全威胁(五角大楼)。(来源、来源)
-
Meta 将裁减 8,000 名员工(10%)以对冲 AI 支出;CBA 正在削减 120 个岗位;ServiceNow CEO 表示,AI 已处理 90% 的客户服务工作,人员流失“未必需要补招”。 同一天出现了 3 个彼此独立的 AI 驱动型劳动力替代信号,且都未宣布任何转型方案。(来源、来源)
-
同一天内出现了 4 项主权 AI 计划:台湾(金融 LLM)、加拿大(公共超级计算机)、印度(AI 卓越中心)、阿联酋(2 年内让 50% 的政府工作采用智能体 AI)。 路径虽各不相同——分别侧重行业专用模型、算力基础设施、人才能力和政府直接部署——但释放出的信号一致:主权 AI 已成为全球优先事项。(来源、来源)
-
据多位从业者报告,美国企业正低调采用中国开源模型(GLM-5.1、Kimi K2.6)以提高成本效益。 “全球电动车市场发生过的事,会不会也发生在全球 AI 市场?”这个问题如今已有早期证据支撑。中国模型以仅为前沿模型定价一小部分的成本,提供了相近的编程表现;而且这类采用多发生在本地部署环境中,处于公开基准测试的可见范围之外。(来源、来源)
-
ARTEMIS 是一个多智能体渗透测试框架,在真实企业环境中,其表现超过了 10 名人类网络安全专业人员中的 9 名,成本为每小时 $18,而人类为每小时 $60。 这种成本下降具有结构性,但在基于 GUI 的任务和误报率方面仍存在能力差距。这篇来自斯坦福大学、CMU 和 Gray Swan AI 的论文,是首个对 AI 智能体与人类安全专业人员进行全面一对一比较评测的研究。(来源)
-
Tesla 已同意以最高 $2B 收购一家 AI 硬件公司,Microsoft 也确认将在其安全开发生命周期中集成 Claude Mythos,并于 6 月推出预览版。 并购和企业集成的信号仍在延续:AI 基础设施正通过收购(Tesla、4 月 22 日的 SpaceX/Cursor)和平台集成(Microsoft/Anthropic)走向整合。(来源、来源)