Twitter AI - 2026-04-26
1. 大家在讨论什么
1.1 智能体式 AI 正在重估整个半导体供应链 🡕
智能体式 AI 的建设已不再只是芯片故事——从推理芯片、先进封装到能源,整个链条都在被重新定价。@Ren_aramb 剖析了这一结构性转变(13 个赞、1,819 次浏览、11 个收藏)援引其作为一家大型企业 AI 负责人的一手经验称:“仅仅今年,我们分配给智能体式 AI 的预算就呈指数级增长,同时削减其他领域成本来为其腾挪资金。”该帖梳理了完整供应链:推理芯片(Google TPU v8、Broadcom、Marvell)、晶圆代工(TSMC 在 3nm/2nm 环节是无法绕开的瓶颈)、封装(CoWoS 结构性供不应求,Intel EMIB 正成为替代方案)、内存(HBM3e)以及光子学。
@DanielTNiles 提供了市场层面的视角(126 个赞、8,023 次浏览):SOX 指数上周上涨 10%,连续 18 个交易日收涨,这段期间累计上涨 49%。他预计,“随着智能体式工作负载激增,MSFT Azure、AMZN Web Services 和 GOOGL Cloud 的 AI 相关超大规模云营收将加速增长。”不过,他也提示了短期风险:半导体价格飙升、油价上涨(WTI 原油 94 美元),以及技术面超买后可能出现浅度回调。
@mikalche 梳理了能源依赖问题(5 个赞、1,791 次浏览):“AI 从来都不只是芯片故事,而是能源 + 电网故事。”白宫已宣布电网基础设施对国家防御至关重要,而变压器交付周期长达 2 至 4 年,加上对外国供应的依赖,构成了硬性限制。
@HedgeMind 重点提到了 AMD(6 个赞、3,640 次浏览)称,其市值创下 5,670 亿美元的新历史高点,并将催化因素归因于“向智能体式 AI 的结构性转变,导致高性能服务器 CPU 出现供应紧张”。
与前一日比较: 4 月 25 日的内容讨论了算力约束如何从技术瓶颈转变为横跨 11 个硬件子领域的投资逻辑。今天则进一步补充了企业预算的一手确认、具体的封装瓶颈数据(MediaTek 要求将用于 Google TPU 订单的 CoWoS 产能提高 7 倍),以及能源层面进入叙事并被提升为国家安全优先事项。
1.2 AI 评测持续分化为不同类别 🡕
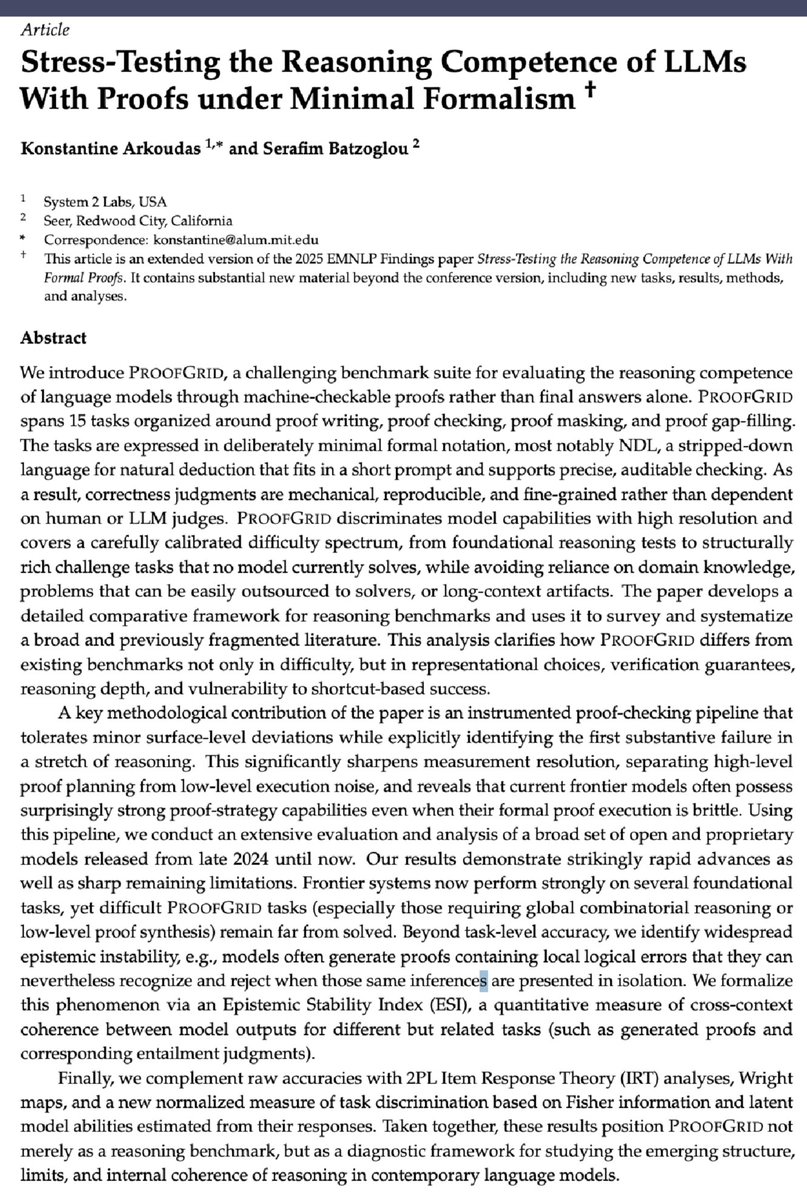
评测层仍在快速扩张。@s_batzoglou 发布了 ProofGrid(5 个赞、2,952 次浏览),这是一个通过机器可检验的证明而非最终答案来测试大语言模型的推理基准。该论文《以最小形式化方法通过证明压力测试大语言模型的推理能力》(Arkoudas 和 Batzoglou)涵盖 15 项任务和 3,000 多道题,测试了从 GPT-4o 到 GPT-5.4 以及 Gemini-3.1 在内的 24 个模型。关键发现是:前沿模型在基础任务上取得了“惊人的快速进展”,但在全局组合推理上仍有“明显且尖锐的局限”。论文还提出了认知稳定性指数(Epistemic Stability Index,ESI),用于衡量跨上下文的一致性。
@RituWithAI 发布了 WorldMark(5 个赞、184 次浏览、6 个收藏),这是 Alaya Studio 推出的交互式视频世界模型统一基准。此前,每个领先的视频世界模型(Sora、Genie、YUME、HY-World、Matrix-Game)都在自己的私有基准和私有场景上进行评测。WorldMark 为所有模型提供相同的 500 个评测案例、标准化 WASD 风格控制、三个难度等级,以及第一/第三人称视角。他们还推出了 World Model Arena,用于实时公开的一对一对战。

@HuggingPapers 报道了(27 个赞、2,751 次浏览)提到 OpenAI 在 Hugging Face 上发布了 HealthBench Professional——由医生策划的医疗对话数据,并以基于评分细则的方式跨专科打分。一条回复指出:“大多数医疗 AI 评测失败的地方,不在事实回忆,而在临床推理风格。”
@AlexWingfield_ 指出了企业评测方面的缺口(1 个赞、14 次浏览):“企业大语言模型正以最愚蠢的方式出错——不只是产生幻觉,还会把 JSON 搞坏、规避工具调用、过度道歉。解决办法是把‘测试’升级成完整的 AI 评测栈。”
与前一日比较: 4 月 25 日将三个评测工具(用于智能体评分的 Laureum、ProofGrid、HealthBench)视为这一类别正在整合的证据。今天则加入了面向视频世界模型的 WorldMark,以及企业评测缺口,进一步确认该类别正在按领域分化(推理、医疗、视频、企业),而非整合为单一框架。
1.3 中国开源 AI 实验室正在快速交叉借鉴 🡒
@piyush784066 捕捉到了这一动态(11 个赞、329 次浏览):“kimi 用 deepseek 的 v3 架构发布了 k2.6——同一周 deepseek 又用 kimi 的 muon 优化器发布了 v4——1.6 万亿参数、100 万上下文——两者在基准测试中都能追平或超过闭源模型,成本却只有后者的八分之一……真正的战斗已经确定了:开源对闭源。”
@witcheer 从实践者视角解读了 Qwen 3.6-27B(2 个赞、220 次浏览):在 SWE-bench verified 上达到 77.2,超过旧版 397B MoE,并且可在 24GB VRAM 上运行。但作者真正的使用场景是 Qwen 3.5:4B 做上下文压缩——“当对话变长时,这个 4B 模型会把更早的轮次总结压缩到原始大小的 20%,从而让主模型保留一个有用的工作窗口。”值得注意的是,Alibaba 于 4 月 20 日以 closed-weights 形式发布了 Qwen 3.6-max-preview——这是一次仅限旗舰模型的转向。
@prpatel05 指出(4 个赞、145 次浏览):“DeepSeek 刚刚发布了 V4。1.6 万亿参数。完全开源。他们声称它在智能体式编程基准测试中击败了 Claude、GPT-5.4 和 Gemini。开源与闭源 AI 之间的差距每个季度都在缩小。”
与前一日比较: 4 月 25 日的讨论从对 DeepSeek-V4 发布的兴奋,转向第一次有实质内容的批评——基准测试上的持平并不等于现实世界中的可用性。今天的讨论又加入了 Qwen 3.6,并浮现出一种实用部署模式(用小模型压缩上下文),展示了本地 AI 从业者在头条基准之外如何真正使用这些模型。
1.4 企业 AI 采用开始出现具体数字 🡕
@rohanpaul_ai 分享了 JPMorgan CEO Jamie Dimon 的观点(83 个赞、10,710 次浏览)表示:“我们用 AI 做欺诈风险、营销、承保、记笔记、广告生成、错误报告、减少错误,总共有 600 个用例,其中 50 个我会归入重要类别。AI 可能创造四天工作制。”回复中的反驳也来得很快:“每一份 AI 路线图都承诺四天工作制,但积压待办说明了另一回事。”
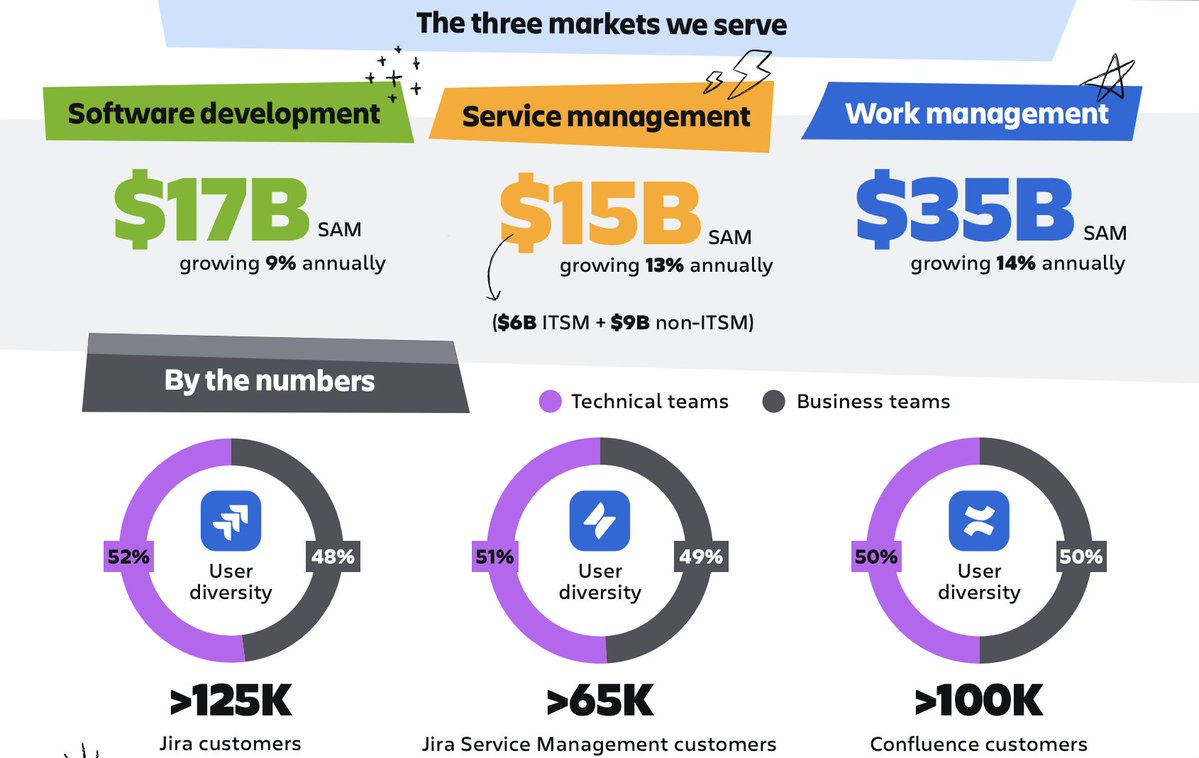
@JaredSleeper 发布了其软件公司 AI 拆解系列的第 32 天内容(11 个赞、2,014 次浏览、8 个收藏)讨论了 Atlassian($TEAM)。股价峰值为 458 美元(2021 年 10 月),如今为 71 美元(下跌 84%)。AI 看空逻辑是:SWE 席位数量下降威胁按席位收费模式,而且随着智能体在软件构建中取代人工协调,这一品类本身也可能被颠覆。AI 看多逻辑则是:Atlassian 是软件开发领域规模最大的上下文系统。管理层披露的关键数据是:使用 AI 编程工具的客户创建的 Jira 任务多 5%,MAU 高 5%,席位扩展速度快 5%。
@chiefmartec 预览了《State of Martech 2026》报告(6 个赞、716 次浏览、4 个收藏)附上了一张面向 Content & Experience AI 用例的 Build vs. Buy 散点图。Brand Voice & Style Enforcement 独自落在偏向自建的象限——“这正是一个尚未被解决的类别的视觉特征。”B2C 的自建/采购比明显高于 B2B:“当 AI 输出本身就是品牌体验时,B2C 营销人员拒绝把它外包出去。”

与前一日比较: 4 月 25 日将企业 AI 框定为“控制层”还是“被颠覆目标”的问题(ServiceNow 逻辑)。今天则加入了 JPMorgan 的具体采用数据(600 个用例)、Atlassian 的反直觉发现(AI 用户创建的 Jira 任务不是更少而是更多),以及 martech 领域的 Build vs. Buy 数据,显示企业在哪些环节拒绝把工作外包给供应商。
1.5 AI 安全与治理开始遭遇现实世界事件 🡕
南非通信部长 Solly Malatsi 撤回了《国家 AI 政策草案》,此前官方已承认该政策本身由 AI 起草。@HeidiGiokos 报道称:“部长表示,南非人民理应得到更好的结果。对负责起草和质量保证的人将进行问责处理。”
@romanyam 指出(10 个赞、465 次浏览)称,Future of Life Institute 发布了一段介绍其 AI 安全工作的影片:“我们无法理解、预测、解释或控制的系统,不应被当作只是营销更好的普通软件。”
@FrankLuntz 批评了一条病毒式传播的说法(10 个赞、2,222 次浏览)称,AI 系统“得出了疫苗会导致自闭症的结论”,并评价道“当人工智能取代了真正的智能”。他随后又引用了 Brandolini 定律:“驳斥胡说八道所需的能量,要比制造它高出一个数量级。”有回复称:“美国需要大幅提升 AI 素养。”
@peligrietzer 分享了(5 个赞、309 次浏览、6 个收藏)提到哥伦比亚大学社会学家 Anna Thieser 对 AI 安全领域进行了一项合著网络分析,发表于 LessWrong,描绘了该社群的研究结构。
@awgaffney 提出了一项医疗安全担忧(6 个赞、388 次浏览):“医疗领域里,用来对抗 AI 幻觉的一项所谓安全检查是由人类专家来验证:如果医生基于知识的能力随着 AI 使用增加而逐渐下降……那么错误风险增加的不是减少,而是上升。”
与前一日比较: 4 月 25 日讨论的是 AI 治理如何通过工作坊和工具批评变得更具体。今天则升级为现实事件:一个国家政府撤回了由 AI 起草的 AI 政策,一位知名民调专家点出 AI 放大虚假信息的问题,以及一个结构性担忧——随着对 AI 的依赖增加,人类的验证能力反而会退化。
1.6 开源 AI 硬件与本地优先设备 🡕
多条帖子都聚焦于开源 AI 硬件。@itsLORDROY 称赞了 OpenHome(34 个赞、11,489 次浏览):“下一波 AI 不会只是应用,还会是设备。本地优先 AI、定制硬件、开源、真正面向开发者的工具。1,000 多名贡献者公开协作建设,这种力量很强大。”对于有想法的创始人,DevKit 可免费获取。@snskritinaruka 呼应了(9 个赞、15,188 次浏览):“硬件很难,但开源 AI 设备就是前沿。”
@_vmlops 强调了(5 个赞、218 次浏览、4 个收藏)提到一个开源生成式 AI 工作室,支持 200 多个模型(Flux、Sora、Kling、Midjourney、Veo)——“你每月花 30 美元订阅 Midjourney,而这个 GitHub 仓库却安安静静地免费放在那里。”支持文生图、图生图、文生视频、口型同步,以及同时使用 14 张参考图。
与前一日比较: 4 月 25 日并没有专门的开源硬件主题。今天这一新集群开始出现,驱动力来自 OpenHome 的社区吸引力(1,000 多名贡献者)以及更广泛的本地优先 AI 转向,它能降低对云的依赖。
1.7 生成式 AI 引发的创作反弹仍在继续 🡒
当 @DiscussingFilm 报道《后室》电影使用 Blender 制作概念艺术和布景设计时,Blender 与 AI 的争论再次浮现。@vanillaopinions 作出了回应(12 个赞、1,445 次浏览):“所以现在连人工智能被使用都值得庆祝了吗?”随后出现了多条纠正。@shwnxtd00r 澄清了(11 个赞、173 次浏览):“生成式 AI 和 Blender 的区别在于,后者确实需要创作表达才能完成你的设计,而不是只靠输入提示词。”
@infinitethird 指出了更深层的损失(13 个赞、709 次浏览):“还记得那个视频吗?有个人亲手逐帧制作了一部关于女友的电影来求婚。那才真正有意义。”批评的核心不在能力,而在于当创作投入被提示词取代时,意义本身正在被侵蚀。
@_overment 提出了开发者的不同意见(3 个赞、201 次浏览):“尽管我对生成式 AI 极其热情,但我仍然看不到在近期出现一个能生成可靠软件的自动化程序员的可能性。”
与前一日比较: 4 月 25 日并没有专门的创作反弹主题。Blender/《后室》事件触发了一波集中爆发,再次凸显工具辅助创作与提示词驱动生成之间持续存在的张力。
2. 什么让人感到沮丧
GPU 获取不平等正在挤压 AI 初创公司——高
@theinformation 独家报道了(3 个赞、1,695 次浏览、3 个收藏)指出,AI 初创公司在获取 Nvidia GPU 时面临更高价格和长达数月的等待时间,因为云服务商把供应预留给 OpenAI、Anthropic 以及内部使用。@Impact177 指出(3 个赞、11 次浏览):“仅 2026 年第一季度,AI 初创公司就获得了 2,670 亿美元融资。这比历史上任何一个季度都高出两倍多。”矛盾在于:创纪录的资金正在流入 AI 初创公司,但它们所需的算力却被既有巨头和超大规模云服务商囤积。
用 AI 起草 AI 政策,随后又撤回——中
南非的 《国家 AI 政策草案》已被撤回,此前政府承认在起草过程中使用了 AI。一条回复概括了这种挫败感:“各组织必须开始教育员工如何合乎伦理地使用 AI。否则,迟早会出大问题。”这一事件说明,AI 治理雄心与制定规则机构内部最基本的 AI 使用规范之间,仍存在明显落差。
AI 生成内容正在削弱人类验证能力——中
@awgaffney 警告称(6 个赞、388 次浏览)指出,随着 AI 使用增加,人类验证这一安全检查机制会退化:“如果医生基于知识的能力逐渐减弱……错误风险增加的不是减少,而是上升。”@TRTRE62 指出招聘中也存在同样的模式(6 个赞、1,816 次浏览):“2026 年的简历是为了让大语言模型筛选、排序、总结和给出理由而塑造的。评估机制已经变了。”两者都指向同一个反馈回路:对 AI 的优化正在削弱人类识别 AI 错误的能力。
企业 AI 定价投资回避了控制权会发生变化的领域——中
@sijlalhussain 分析了(11 个赞、245 次浏览)提到 McKinsey 的一项发现:企业定价中影响最大的领域(交易配置、折扣治理、续约)与组织实际投入的方向并不一致。“真正的挑战不是识别高影响力用例,而是在那些必须真正交出决策权的地方投入资源。”
3. 人们希望存在什么
面向视频世界模型的统一基准基础设施
@RituWithAI 指出了这一缺口:“每个 AI 视频世界模型都在给自己的作业打分。”Sora、Genie、YUME、HY-World 和 Matrix-Game 各自使用私有基准、私有测试场景和私有指标。WorldMark 通过标准化评测(500 个案例、统一控制、公开竞技场)来解决这一问题,但在其他把自我评估视为常态的 AI 子领域,这种更普遍的需求依然存在。紧迫性:高。(来源)
具备 AI 素养的治理框架
南非事件(由 AI 起草的 AI 政策)以及 Frank Luntz 对 AI 放大虚假信息的警示,都指向同一个缺口:机构缺乏使用、评估或监管 AI 系统所需的基本 AI 素养。真正需要的不是更多政策文件,而是政府机构内部的 AI 实操能力。紧迫性:高。(来源, 来源)
医疗 AI 工作流的轨迹级安全
@Symbioza2025 在多篇帖子中提出了这一观点(3 个赞、113 次浏览)指出,医疗 AI 需要外部轨迹可观测性——“不是替代临床医生,不是控制模型,而是监测整个工作流是否在以下链路中保持稳定:临床输入 -> AI 推理 -> 人类纠正 -> 面向患者的输出 -> 后续使用。”这一需求将 4 月 25 日关于异常管理的逻辑延伸到了可观测性层。紧迫性:高。(来源)
超越幻觉检测的企业 AI 评测栈
@AlexWingfield_ 指出,企业大语言模型会在一些很基础的地方出错——把 JSON 搞坏、规避工具、过度道歉——而聚焦幻觉的评测完全捕捉不到这些问题。真正需要的是一整套评测栈,覆盖指令遵循、工具使用、格式遵守和行为一致性。紧迫性:中。(来源)
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| ProofGrid | 大语言模型推理基准 | (+) | 机器可检验的证明、15 项任务、3000+ 道题;认知稳定性指数(ESI);测试 24 个模型 | 聚焦形式化推理;不涵盖现实世界任务表现 |
| WorldMark | 视频世界模型基准 | (+) | 统一 WASD 控制、500 个评测案例、3 个难度等级;warena.ai 上的实时 World Model Arena | 较新(4 月 24 日预印本);模型团队是否采用尚不明确 |
| HealthBench Professional | 医疗 AI 评测 | (+) | 医生策划的评分细则、按专科评分、安全护栏;已上线 Hugging Face | 可能在分布外患者人群上失效 |
| SPLIT | 大语言模型引导方法 | (+) | 统一微调、LoRA、激活编辑;在 log-odds 尺度上区分偏好与效用 | 学术性质较强;生产集成情况不明 |
| PSAISuite | 多供应商 AI 接口 | (+) | PowerShell 模块、支持 15+ 家供应商、内置基准套件、供应商中立 | PowerShell 生态限制了其覆盖范围,主要面向 Windows/.NET 用户 |
| Voice-Pro | 语音/翻译/配音 | (+) | Whisper + F5-TTS + CosyVoice;支持 YouTube 处理;零样本语音克隆;开源 | 配置复杂;实时性能需要 GPU |
| Open Generative AI Studio | 多模型创意套件 | (+) | 200+ 模型;支持文生图/视频、口型同步;可自托管;免费 | 自托管需要大量算力 |
| Humanizer(Claude Code 技能) | AI 写作去痕 | (+) | 检测 29 种 AI 写作模式;语气校准;基于 Wikipedia 的“AI 写作迹象” | 效果取决于源文本质量 |
| FutureAGI | AI 生命周期平台 | (+) | 端到端覆盖:仿真、评测、防护、监控、可观测性、网关、优化 | 刚刚开源;生产采用情况尚不明确 |
评测层仍是最活跃的工具类别。ProofGrid、WorldMark 和 HealthBench 分别瞄准不同的评测维度(推理、视频、医疗),而 PSAISuite 则回应了对供应商中立 AI 编排日益增长的需求。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| WorldMark + World Model Arena | Alaya Studio(@RituWithAI) | 面向交互式视频世界模型的统一基准,并配有实时公开竞技场 | 每个视频世界模型都在私有基准上给自己打分 | 标准化 WASD 控制、500 个评测案例、warena.ai | 已发布 | 帖子 |
| ProofGrid | Arkoudas & Batzoglou(System 2 Labs、Seer) | 通过机器可检验的证明来测试大语言模型推理能力的基准 | 现有基准测试的是最终答案,而不是推理路径 | 15 项任务、3000+ 道题、ESI 指标 | 已发布 | 帖子 |
| OpenHome DevKit | @JesseRank / OpenHome | 具备本地 AI、空间模型和 PCB 设计能力的开源 AI 硬件设备 | AI 设备封闭、依赖云端,且原型开发成本高 | 本地 AI、定制空间模型、固件、iOS 应用、云 SDK | Alpha(DevKit) | 帖子 |
| AIRecon / RedTeam-Agent | @Dinosn / ktol1 | 面向渗透测试和红队工作流的自主网络安全智能体 | 逐个手动调用工具做安全评估太慢 | Ollama LLM + Kali Linux Docker + 15 个工具 | 开源 | 帖子 |
| ULTRASHIP | @Dinosn | Claude Code 插件:39 项技能、33 个工具、11 个智能体,面向可交付工作流 | 开发者缺少集成规划/审查/安全能力的编程智能体 | Claude Code 插件、MIT license、180 项测试 | 已发布 | 帖子 |
| PSAISuite | @dfinke | 面向 15+ 家供应商的供应商中立 PowerShell AI 集成模块 | 应用逻辑与单一 AI 供应商深度耦合 | PowerShell、基准套件 | 已发布 | 帖子 |
| ASA(轨迹可观测性) | @Symbioza2025 | 面向医疗领域长周期 AI 系统的外部轨迹可观测性 | 缺少对 AI 工作流长期稳定性的监控 | 未披露 | 发布前 | 帖子 |
| Humanizer | blader(通过 @oliviscusAI) | 去除 AI 写作模式的 Claude Code 技能;可检测 29 种模式 | AI 生成文本容易被识别,且读起来不自然 | Claude Code 技能、基于 Wikipedia 的模式 | 已发布 | 帖子 |
评测集群(ProofGrid、WorldMark、HealthBench)延续了 4 月 25 日的趋势:多支团队正围绕不同的 AI 质量维度构建评测工具。网络安全集群(AIRecon、RedTeam-Agent、ULTRASHIP)则是新的模式——开发者将本地大语言模型与传统渗透测试工具链结合,构建自主安全智能体。
6. 新动态与值得关注的事项
倒闭初创公司的数据清算如今也有了交易市场
[++] @Forbes 进行了详细报道(9 个赞、8,347 次浏览)称,SimpleClosure 正在推出 Asset Hub,这是一个面向倒闭初创公司数据的交易市场。cielo24 的 13 年 Slack 存档、Jira 工单和邮件线程卖出了“数十万美元”。前 OpenAI 首席科学家 Ilya Sutskever 指出,到 2024 年底,AI 实验室已经耗尽了公开互联网数据。文章将真实职场互动产生的运营数据称为“AI 智能体的化石燃料”——这类数据对训练真正能做事、而不仅只是回答问题的模型至关重要。
南非撤回由 AI 起草的 AI 政策
++] 南非通信部长[撤回了《国家 AI 政策草案》,此前官方已承认该政策起草过程中使用了 AI。部长承诺将进行“问责处理”。这是目前已知首个国家政府因 AI 参与其制定过程而公开撤回 AI 政策的案例——这是一种递归式治理失败,凸显出机构内部 AI 雄心与 AI 能力之间的落差。
美国国务院要求在全球推动打击中国 AI 知识产权盗窃
[+] @NEWSMAX 报道了(25 个赞、3,448 次浏览)称,美国国务院已下令在全球范围内推动相关行动,突出“中国企业广泛窃取美国人工智能实验室知识产权的行为”。这使地缘政治 AI 竞争的叙事从技术管制升级为主动的外交行动。
Qwen 3.6-27B 发布,Alibaba 将旗舰模型转向 closed-weights
[+] @witcheer 记录了(2 个赞、220 次浏览)称,Qwen 3.6-27B 在 SWE-bench verified 上取得 77.2,超过旧版 397B MoE,同时可在 24GB VRAM 上运行。与此同时,Alibaba 于 4 月 20 日低调发布了 Qwen 3.6-max-preview 的 closed-weights 版本——这一“仅旗舰模型转向”保留了 Apache 2.0 的开放权重层级,但将最佳模型留作专有访问。
7. 机会在哪里
**+++] 按领域划分的 AI 评测基础设施** —— 一天内重点出现了四种不同的评测工具(用于推理的 ProofGrid、用于视频的 WorldMark、用于医疗的 HealthBench,以及用于指令合规的企业评测)。每个领域都需要自己的基准,因为通用评测会遗漏特定领域的失效模式。能够构建跨领域评测编排层的组织——让企业通过单一界面运行各类领域专属评测——正在抓住一种结构性需求。([来源, 来源)
**+++] 能源与电网基础设施成为 AI 的关键约束** —— 白宫宣布电网基础设施对国家防务至关重要。变压器交付周期长达 2-4 年。CoWoS 封装在结构性上已严重供不应求。讨论焦点已从“算力受限”转向“能源受限”——而政策如今正通过《国防生产法》机制推动这一周期向前发展。那些解决 AI 数据中心发电、电网现代化和先进封装问题的公司,正在应对下一个关键约束。([来源, 来源)
**++] 自主网络安全代理** —— AIRecon、RedTeam-Agent 和 ULTRASHIP 都将本地 LLM 与传统安全工具链结合起来。其模式是:由 LLM 编排现有渗透测试工具,且完全在本地运行,无需 API 密钥或云端依赖。安全团队长期人手不足;能够执行多步骤评估工作流的自主代理,所解决的不只是生产力约束,更是劳动力市场约束。([来源, 来源)
8. 核心结论
-
智能体式 AI 正在重估整个半导体供应链,而且已有企业一线预算数据印证这一点。 一家大型企业的 AI 负责人表示,今年用于智能体式 AI 的预算呈指数级增长。SOX 指数已连续上涨 18 个交易日(累计上涨 49%),而供应链分析也从推理芯片延伸至封装(CoWoS 结构性供不应求)再到能源(电网被宣布对国家防御至关重要)。(来源, 来源)
-
AI 评测正在按领域分化,而不是走向整合。 ProofGrid(推理证明)、WorldMark(视频世界模型)、HealthBench(医疗评分细则)以及企业评测栈分别对应不同的失败模式。跨领域编排层——用单一接口运行各类领域专属评测——目前仍不存在。(来源, 来源)
-
中国开源 AI 实验室正通过相互借鉴加快发布速度。 Kimi 使用 DeepSeek 的 V3 架构;DeepSeek 使用 Kimi 的 Muon 优化器。Qwen 3.6-27B 可在 24GB VRAM 上超过旧版 397B MoE。但 Alibaba 针对旗舰模型转向 closed-weights,也表明开源策略在最前沿存在边界。(来源, 来源)
-
企业 AI 采用正在产生反直觉指标:AI 用户制造的工作更多,而不是更少。 Atlassian 报告称,AI 编程工具用户创建的 Jira 任务多 5%,席位扩展速度也更快。JPMorgan 运行着 600 个 AI 用例。这个模式说明,AI 正在放大工作流体量,而非减少人头——这与岗位替代叙事相矛盾,却印证了基础设施需求逻辑。(来源, 来源)
-
AI 治理遭遇了迄今最尴尬的一次现实事件:政府因为 AI 写了政策而撤回政策。 南非通信部长撤回了《国家 AI 政策草案》,并承诺追责。这不是假设性风险,而是一次正在发生的现实演示:连制定 AI 规则的机构本身,都缺乏负责任使用 AI 的能力。(来源)
-
倒闭初创公司的数据市场正在走向产业化。 Forbes 报道称,SimpleClosure 正在推出 Asset Hub,这是一个专门交易已清算初创公司运营数据的市场。AI 实验室到 2024 年底已耗尽公开互联网数据,如今将 Slack 存档、Jira 工单和邮件线程视为智能体式 AI 的高价值训练材料。(来源)
-
开源 AI 硬件正凭借社区牵引力成长为一个真实品类。 OpenHome 的 1,000+ 名贡献者、面向创始人的免费 DevKit,以及本地优先架构,代表着开源力量首次认真推进 AI 设备。AI 硬件领域长期封闭且昂贵;它可能像 Arduino 和 Raspberry Pi 之于嵌入式计算那样,降低门槛。(来源)
-
自主网络安全智能体正在形成清晰模式:在本地运行的大语言模型来编排传统安全工具链。 AIRecon、RedTeam-Agent 和 ULTRASHIP 都将本地大语言模型与渗透测试工具结合起来。网络安全劳动力短缺使这一类别具备结构性吸引力,而纯本地架构也缓解了企业安全团队不愿把漏洞数据发送到云 API 的顾虑。(来源, 来源)