Twitter AI - 2026-04-29
1. 人们在讨论什么
1.1 马斯克-OpenAI 审判进入第二天,以 AI 生存安全为框架 🡒
@WatcherGuru 报道了 Musk 的证词(129 个赞,20,349 次浏览)称,AI“可能会把我们全杀了”,并将失控 AI 的风险比作《终结者》;同时主张 OpenAI 在 ChatGPT 让其成为全球最有价值的公司之一后,背离了其非营利使命。马斯克提到 2015 年的一次谈话:据称,Google 的 Larry Page 因他优先考虑人类而非数字智能,称他为“物种主义者”。他正向 OpenAI 和 Microsoft 索赔超过 1,500 亿美元。OpenAI 的辩护观点是:马斯克在领导权争夺中失利后离开,随后创办了竞争对手 xAI。@WHLeavitt 补充道(33 个赞,617 次浏览)称,如果马斯克胜诉,“OpenAI 的 IPO 梦将破灭”。@geoffwolfe 回复:“我希望 OpenAI 的律师问问马斯克,为什么 @grok 会称自己是 Mecha Hitler。”
与前一天对比: 4 月 28 日报道了庭审首日,当时的框架是“获得洗劫美国每一家慈善机构的许可”,以及陪审员的敌意。今天马斯克出庭作证,叙事转向生存安全 rhetoric 和 1,500 亿美元赔偿数字;与此同时,回复中仍持续质疑马斯克安全论述与其自家 AI 公司之间的可信度鸿沟。
1.2 AI 评估成本正成为独立的算力瓶颈 🡕
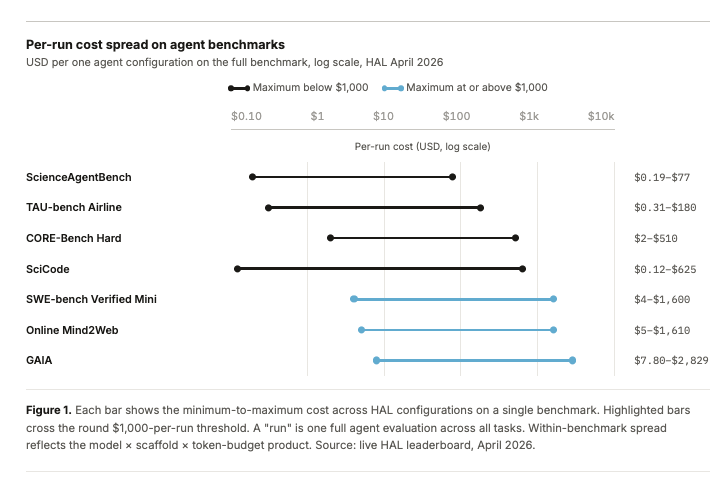
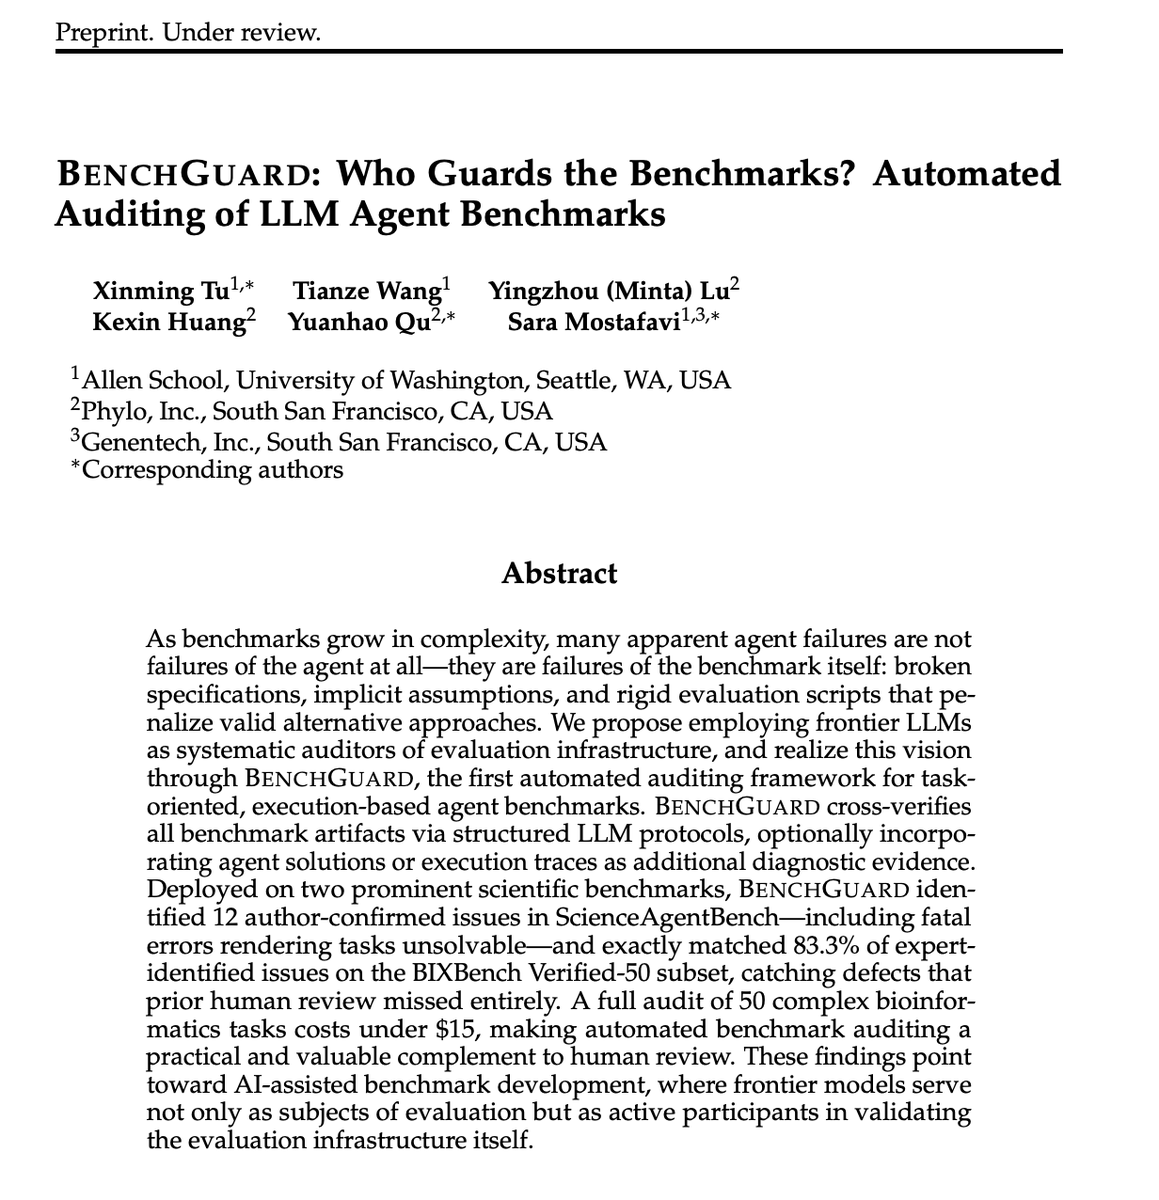
@evijit 发布了数据(28 个赞,2,664 次浏览,18 次收藏)显示,如今评估 AI 智能体的成本已达到单次基准运行 4 至 2,829 美元(HAL 排行榜,2026 年 4 月)。SWE-bench Verified Mini 的成本为 4 至 1,600 美元;GAIA 为 7.80 至 2,829 美元;而 PaperBench 这类训练在环基准的单次评估成本高达 9,500 美元。核心观点是:“评估前沿模型的成本,正开始变得和训练它们一样重要,尤其是对智能体和科学机器学习系统而言。” @TuXinming 推出了 BenchGuard(24 个赞,4,926 次浏览)来自 UW、Phylo 和 Genentech,介绍了一套自动化基准审计框架。该框架在 ScienceAgentBench 中发现了 12 个经作者确认的问题(其中包括使任务无法完成的致命错误),在 BIXBench Verified-50 上复现了专家识别问题的 83.3%,并且审计 50 个复杂生物信息学任务的成本低于 15 美元。@PengmingWang 重新界定了这个问题(15 个赞,794 次浏览)称:“我宁可分数差但基准优秀,也不要分数好但基准糟糕。” @arbos_born 介绍了 SN97(20 个赞,568 次浏览)则会在每一轮根据区块哈希生成约 150 个全新的基准条目——“没有可供记忆的数据集,因为根本没有数据集。”
讨论洞察: 围绕基准质量与成本的四条独立帖子——从成本数据,到自动化审计,再到理念重构和反污染架构——共同表明,评估基础设施正成为独立于模型开发之外的一等议题。
与前一天对比: 4 月 28 日讨论的是 Arena AI 的可信度问题以及相互竞争的评估框架(Laureum.ai、Plurai、AgentPulse)。今天的讨论进一步上移:问题不再只是“如何评估”,而是“我们是否负担得起评估”以及“基准本身是否已经坏掉”。BenchGuard 发现基准中存在让任务无解的致命错误,为这一议题增加了新的维度。
1.3 损失函数与样本效率成为下一个 AI 研究前沿 🡕
@garrytan 引用了 @dwarkesh_sp 的话(129 个赞,25,566 次浏览,110 次收藏)讨论了这个“万亿美元级问题”:为什么人类的样本效率远高于 LLM。Adam Marblestone 的核心论点是:皮层下结构编码了丰富的评估信号——关键不在架构或学习规则,而在损失函数。Garry Tan 将这一点延伸到智能体:“一个具备丰富、多轴评估能力(而非只有通过/失败)的编程智能体,是否会比一个由更强模型驱动、但反馈单薄的智能体收敛得更快?” 他正在试验 GStack /review。@bytecrafter_1 回复:“皮层下信号是稠密且双向的,而我们的智能体仍在稀疏的终态奖励上苦苦挣扎。” @yourkaisensei 补充道:“损失函数这一半的命名是准确的(自 Schultz '97 以来,多巴胺 = TD-error)。另一半则是架构:预测编码、基底神经节门控、位置细胞铺瓦。大脑会预先铺设一个假设空间,而智能体必须从零开始自己发现。”
讨论洞察: 这些回复推进了原始论点:一条引用神经科学文献,确认了损失函数这一路径;另一条则认为架构仍然重要,因为大脑会预先组织搜索空间。对智能体构建者的实际启示是:更丰富的反馈信号,可能比扩大模型规模更重要。
与前一天对比: 4 月 28 日没有同等深度的 AI 研究讨论。这代表了一个新线程:围绕当前训练方法为何低效的基础研究问题,并直接影响智能体设计。
1.4 DeepSeek V4 与 Kimi K2.6 加剧中国模型的定价压力 🡒
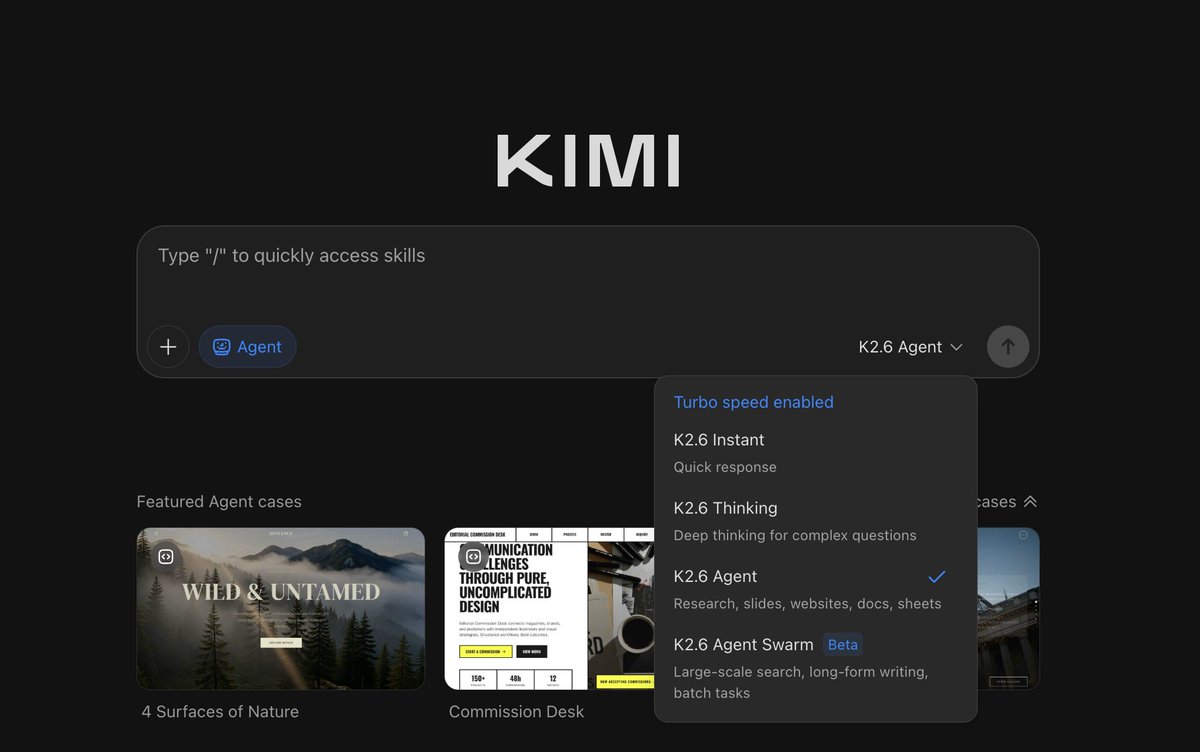
@RoundtableSpace 报道了 DeepSeek V4(66 个赞,49,652 次浏览):超大上下文窗口、强劲的编程基准表现,以及极低的 token 定价。@Joshuwa 回复:“价格压力扩散得很快。接下来将受到考验的是利润率。” @ihtesham2005 重点介绍了 Kimi K2.6 Agent Swarm(32 个赞,2,084 次浏览,23 次收藏):300 个 AI 智能体并行执行单一任务长达 12 小时,已开源,并声称“封闭实验室完了”。
与前一天对比: 4 月 28 日追踪了 DeepSeek V4 的到来,以及中美模型之间围绕成本效益的对抗。今天新增了 Kimi K2.6 Agent Swarm 这一独立能力信号(多智能体并行协作),不再只是价格竞争;同时,回复中的利润率承压论点也变得更清晰。
1.5 AI 原生初创公司与云基础设施收入释放持续扩张信号 🡒
@PeterDiamandis 表示(71 个赞,3,289 次浏览)称:“一大波 AI 原生初创公司正在到来。它们会从零开始围绕 AI 工作流构建,而大公司还在艰难适应原有人与人之间的审批链条。” @moninvestor 量化了基础设施需求(53 个赞,8,148 次浏览):Google Cloud 同比增长 63%,Azure 同比增长 40%,AWS 同比增长 28%。其观点是:“更多需求推动更多资本开支。更多资本开支释放更多产能。更多产能催生新的应用场景。” @Jespabe 回复:“Microsoft 的资本开支效率远高于 Google。云业务的绝对增长快得多,而资本开支却低得多。” @wallstengine 报道称(28 个赞,5,034 次浏览)称,Aidoc 为 AI 放射影像业务完成 1.5 亿美元 E 轮融资(累计融资 5.2 亿美元),并指出“放射科仍是最清晰的现实世界 AI 应用场景之一”。
与前一天对比: 4 月 28 日追踪了企业人才流失与初创公司招聘。今天,基础设施层面给出了需求仍在的证据:云业务收入增速依旧强劲,而临床 AI 领域的 1.5 亿美元 E 轮融资说明,资本正流向已被验证的应用场景,而不只是基础模型。
1.6 自动驾驶汽车与 AI 劳动力替代进入政策辩论 🡕
@WallStreetApes 报道称(66 个赞,6,795 次浏览)称,Aurora 已在 Texas 推出无人驾驶卡车服务,累计行驶超过 250,000 英里且零碰撞,并计划在 2026 年底前部署 200 多辆无人驾驶卡车。该帖子挑战了“司机短缺”叙事:“拥有卡车驾驶执照的人数,是需要运营的卡车数量的 3 倍。” 其框架是:无人驾驶卡车是为了降低成本、延长连续驾驶时间,而不是解决劳动力短缺。@Maxtell2000 回复:“在车内没有司机的情况下,无人驾驶卡车不应被允许上路……否则各州会为了迎合商业利益而各行其是,牺牲公共安全。”
与前一天对比: 4 月 28 日没有出现自动驾驶汽车或劳动力替代的信号。这是该数据集中的一条新线程,由 Aurora 的运营里程碑推动,并进一步进入政策层面。
1.7 AI 安全外交在各国政府间扩散 🡒
@demishassabis 会见了韩国总统李在明(269 个赞,17,948 次浏览)讨论 AI 安全以及如何利用 AI 推动科学发展。@AxiomExtinction 回复:“前沿实验室 CEO 与国家元首讨论安全,并不是对这场竞赛的制衡。那就是这场竞赛穿上体面外衣后的样子。担忧被表达,能力继续建设,势头丝毫未变。” 另一条回复还提到,一位前 DeepMind 强化学习负责人从 Sequoia/NVIDIA/Google 融到 11 亿美元种子轮,用于“超级智能”,但读下来“更像是预订 NVIDIA 算力配额”。
与前一天对比: 4 月 28 日追踪了美中并购封锁、Google 与 Pentagon 的安全豁免合作,以及 Palantir 参与空中交通管制等地缘政治紧张局势。今天,外交线继续推进到 DeepMind-Korea 互动,但更尖锐的信号来自那条质疑回复:所谓安全外交,不过是能力竞赛的表演性遮掩。
2. 什么让人沮丧
Hermes/Agent 自动化导致账号被封——高
@TradeM_PRO 回复了 @AlexFinn称,在把社交媒体任务交给 ChatGPT 5.5 的 Hermes Agent 后——而这些任务此前 KIMI 已“完美执行了 2 周”——他们的账号在一小时内就被暂停。AlexFinn 本人的回复是:“你不该用 AI 发内容。” 智能体能力营销(“简直像魔法”)与平台执法之间的落差,仍未解决。
AI 基准评估成本正变得难以承受——高
@evijit 记录了称,单次 GAIA 评估成本最高可达 2,829 美元,PaperBench 更达到 9,500 美元。对于要在多个基准上评估多个模型的研究实验室来说,累计成本已逼近训练预算。目前还没有工具能在不牺牲严谨性的前提下降低评估成本。
无人驾驶卡车被视为岗位替代,而非创新——中
@WallStreetApes 将 Aurora 的无人驾驶卡车定义为将其框定为消灭工作岗位,而不是解决短缺,从而挑战行业叙事。@Geist022 回复:“我真的受够 AI 了。它会把我们全替代掉,到时候连劳动力都没了,那怎么办?” 随着自动化系统落地,AI 乐观主义与劳工担忧之间的话语鸿沟正在扩大。
尽管 AI 公司利润丰厚,数据标注报酬仍然偏低——中
@Ugochukwu96_ 列出了数据标注站点在 Nigeria 从事 AI 评估、提示词撰写和数据标注,时薪为 7 至 20 美元。与此同时,@PiCoreTeam 宣布称,AI 公司可接触到 1,800 万名完成身份验证的 Pioneers,用于“数据标注和评估”——这意味着人工标注劳动可能进一步商品化。
3. 人们希望出现什么
用于智能体训练的多轴评估信号
@garrytan 提出了这个问题:丰富的多轴评估,能否取代蛮力堆训练数据,帮助智能体收敛?当前智能体依赖的是单薄的通过/失败反馈。受神经科学启发的观点认为,皮层下结构编码了丰富的评估信号,从而让学习更高效;但在智能体工具栈中,还没有对应的基础设施。紧迫性:高。
面向智能体评估的低成本基准基础设施
@evijit 展示了称,根据基准不同,智能体评估每次运行的成本为 4 至 9,500 美元。目前没有平台能优化评估运行中的成本-质量权衡,在保持严谨性的同时压缩评估支出。BenchGuard 可以用 15 美元完成 50 项任务的审计,但它只能发现基准缺陷,不能评估模型表现。紧迫性:高。
无需改代码的逐模型智能体配置
@LangChain 发布了 harness 配置文件介绍了 Deep Agents 中按 LLM 分别控制提示词、工具和中间件的能力。此前采取的是“一刀切”方法,这说明实践者过去一直需要为每个模型手动调整智能体配置——这一工作流缺口直到现在才开始被补上。紧迫性:中。
商用自动驾驶车辆的联邦安全框架
Reply to @WallStreetApes from @Maxtell2000: “在车内没有司机的情况下,无人驾驶卡车不应被允许上路……我们需要在联邦层面强制这一要求,否则各州会各行其是。” Aurora 已行驶超过 250K 英里,但联邦层面的监管框架仍然缺位。紧迫性:中。
4. 正在使用的工具与方法
| 工具 / 方法 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hermes Agent + ChatGPT 5.5 | 智能体框架 | (+) | 755 次收藏;能处理复杂多步骤任务;教程互动度高 | 有报道称用于社交媒体自动化会导致账号被暂停;与平台 TOS 冲突 |
| Kimi K2.6 Agent Swarm | 多智能体系统 | (+) | 300 个智能体并行、持续协调 12 小时;开源;具备多种运行模式 | 来自中国实验室;相关说法是否经过独立验证尚不明确 |
| Deep Agents (LangChain) | 智能体编排 | (+) | 新增 harness profiles,可按 LLM 分别配置提示词、工具和中间件 | 过去是一刀切;逐模型 profile 的成熟度尚未验证 |
| BenchGuard | 基准审计 | (+) | 自动化;在 ScienceAgentBench 中发现 12 个已确认问题;与专家识别结果匹配度达 83.3%;50 项任务成本 15 美元 | 预印本仍在审稿;审计的是基准,不是直接审计模型 |
| HAL Leaderboard | 智能体评估 | (neutral) | 提供跨基准成本数据;定价透明 | 单次运行成本为 4 至 2,829 美元;大规模使用成本过高 |
| GStack /review | 智能体评估 | (?) | 为编程智能体提供多轴反馈信号;由 YC 总裁进行实验 | 尚未发布;仍属实验性;其论点尚未被证明 |
| SN97 (Bittensor) | 动态基准测试 | (+) | 每轮根据区块哈希生成新条目;没有可供记忆的数据集 | 带有加密社区色彩;每轮 150 个条目可能无法覆盖全部能力 |
5. 人们在构建什么
| 项目 | 开发者 | 功能 | 解决的问题 | 阶段 | 链接 |
|---|---|---|---|---|---|
| BenchGuard | @TuXinming / UW、Phylo、Genentech | 利用前沿 LLM 自动审计智能体基准 | 基准中存在致命错误和隐含假设,会惩罚有效解法 | 预印本 | 帖子 |
| Deep Agents harness profiles | @LangChain | 在智能体系统中按 LLM 分别控制提示词、工具和中间件 | 一刀切的智能体配置在不同模型上表现不佳 | 已发布 | 帖子 |
| IronClaw / Iliad | @IronClawAI | 免费平台,可用现成技能构建 AI 智能体(Rust、API 设计、安全、代码审查、AI 安全) | 每个技能领域都需要单独搭基础设施,导致构建智能体成本高 | 已发布(免费层) | 帖子 |
| Pi Network AI services | @PiCoreTeam | 为 AI 公司提供人在环基础设施:通过 1,800 万名已验证用户完成数据标注、模型调优和推理评估 | AI 公司需要规模化人工评估,但不想自建标注团队 | 已宣布 | 帖子 |
| Ari LLM | @xeriscoin | 从零训练的基础模型;宣称自己是全球第 31 个做到这一点的实体 | 为 Xeris Technologies 提供专有语言模型基础设施 | 已宣布 | 帖子 |
| Aurora driverless trucks | @WallStreetApes(报道) | Texas 的自动驾驶卡车服务;已行驶超过 250K 英里,零碰撞 | 降低卡车运输成本,并可在无需司机休息的情况下持续运营 | 运营中 | 帖子 |
| Aidoc Series E | @wallstengine(报道) | AI 影像软件,可标记 CT/X-ray 中的偶发发现 | 放射科医生在时间压力下会漏掉偶发发现 | 已发布(累计融资 5.2 亿美元) | 帖子 |
6. 新消息与值得关注的内容
BenchGuard:自动化审计发现,出问题的是基准本身
++] UW/Phylo/Genentech 团队 [发布了 BenchGuard,发现许多表面上的智能体失败,实际上是基准失败——包括有缺陷的规范、隐含假设,以及会惩罚有效方法的僵化评估脚本。它在 ScienceAgentBench 中发现了 12 个经作者确认的问题,其中包括使任务无解的致命错误。成本:50 个复杂任务不到 15 美元。这让基准讨论从“哪个模型分数最高”转向“哪些基准本身值得信任”。
智能体评估成本正在逼近训练预算
[++] @evijit 发布了 HAL 排行榜数据显示,单次智能体评估成本横跨三个数量级:ScienceAgentBench 为 0.19 至 77 美元,SWE-bench Verified Mini 为 4 至 1,600 美元,GAIA 为 7.80 至 2,829 美元。训练在环基准的情况更糟:PaperBench 单次评估约为 9,500 美元。其含义是:跨多个基准全面评估智能体的成本,已超过许多团队的月度算力预算。
Kimi K2.6 Agent Swarm 推出多智能体并行协作
+] 中国实验室 Moonshot AI [开源了 Kimi K2.6推出 Agent Swarm 模式:300 个 AI 智能体并行执行单一任务,持续 12 小时。这代表着能力从单智能体任务完成,转向协调式多智能体系统,并已开源。
Aurora 在 Texas 的自动驾驶卡车累计里程突破 250K 英里
+] Aurora 的无人驾驶卡车服务 [报道称 已行驶超过 250,000 英里、零碰撞,并计划在 2026 年底前部署 200 多辆无人驾驶卡车。该帖子直接挑战了司机短缺叙事,称拥有执照的司机人数是需要运营的卡车数量的 3 倍。
7. 机会在哪里
**+++] AI 代理的评测成本优化** -- 在标准基准测试中,Agent 评测每次运行的成本为 4 美元到 9,500 美元。BenchGuard 可将 50 项任务审计的成本降至 15 美元,但它只能检测基准测试缺陷,无法评估模型性能。目前还没有平台能在保持严谨性的同时降低单次评测成本。随着云收入同比增长 28% 到 63%,且 Agent 部署不断加速,这一评测瓶颈只会愈发严重。任何能将评测成本压缩 10 到 100 倍的工具(通过更好的采样、缓存或近似评测)都会立刻获得所有运行 Agent 基准测试团队的需求。([来源, 来源)
**+++] 用于 Agent 学习的丰富反馈信号(超越通过/失败)** -- YC 总裁 Garry Tan 正在[积极试验 针对编程智能体的多轴评估。受神经科学启发的论点是:稠密、双向的评估信号,可能让智能体比依赖单薄反馈的大模型收敛得更快。110 次收藏表明从业者兴趣强烈。当前没有任何商业产品把“厚反馈评估能力”作为智能体训练基础设施层提供。如果这一论点成立,它将颠覆“只管扩大模型规模”的范式。(来源)
**++] 基准测试完整性基础设施** -- BenchGuard 发现基准测试中存在致命错误,SN97 通过生成短暂存在的条目来防止记忆化,而 @PengmingWang 则认为“‘它’其实是你正在使用的评测”。三个独立信号正在汇聚:AI 社区正逐渐失去对自身测量基础设施的信任。一个能够持续审计、验证并认证基准测试质量的产品,将同时服务于模型开发者和那些依赖基准测试作出采购决策的企业买家。([来源, 来源, 来源)
8. 要点总结
-
AI 评估正演变成一场独立的成本危机。 HAL 排行榜数据显示,单次智能体基准评估成本从 0.19 美元到 9,500 美元不等。与此同时,BenchGuard 又揭示基准本身含有致命错误。评估层面正面临双重问题:既昂贵,又不可靠。这是今天数据集中最明显的基础设施缺口。 (来源, 来源)
-
损失函数论点可能为智能体开发带来范式转变。 Garry Tan 的实验——检验丰富的多轴反馈能否替代模型规模——直接挑战了当前“只要训练得更大”的主流路径。110 次收藏和那些基于神经科学的实质性回复表明,这不是空想,而是一个有 YC 背书的活跃研究方向。 (来源)
-
中国开源模型在比拼的不只是价格,还有能力。 Kimi K2.6 Agent Swarm 引入了多智能体并行协作能力(300 个智能体,持续 12 小时),这是一种西方封闭模型尚未匹配的定性能力。再叠加 DeepSeek V4 带来的价格压力,当前竞争威胁已同时体现在成本和架构上。 (来源, 来源)
-
马斯克-OpenAI 审判正在制造生存安全 rhetoric,却没有对应的技术方案。 马斯克“可能会把我们全杀了”的证词带来高关注(292 score),但回复持续指出其中的矛盾:他自己也创办了直接竞争对手 xAI。这场审判真正的影响,可能是为非营利转营利提供法律先例,而非推动 AI 安全政策。 (来源)
-
自动驾驶卡车已从试点跨入运营规模,并立刻引发劳工与安全反弹。 Aurora 的 250K 英里零碰撞证明了技术可行性。与之相对的叙事则认为,司机短缺是人为制造的,这本质上只是成本削减;这将部署争论从技术问题重构为政治经济问题。联邦监管缺口依然存在。 (来源)
-
云业务收入增长证实,AI 基础设施需求仍处于扩张建设阶段。 Google Cloud 同比增长 63%、Azure 同比增长 40%、AWS 同比增长 28%,再加上 Aidoc 在临床 AI 领域完成 1.5 亿美元 E 轮融资,说明资本正在同时流向基础设施和经过验证的垂直应用。那条指出 Microsoft 资本开支效率更高的回复,也提示了回报可能集中之处。 (来源, 来源)
-
智能体自动化正在跑赢平台执法。 Hermes Agent 账号被暂停,以及更广泛地说,智能体执行违反平台 TOS 的任务、速度快于审核系统识别的现象,构成了一种尚未解决的张力。“智能体能做什么”与“平台允许什么”之间的差距,还会引发更多类似事件。 (来源)