Twitter AI - 2026-04-30
1. 大家在讨论什么
1.1 AI 网络攻防能力跨过门槛——两款模型现已能完成多步骤攻击 🡕
@AISecurityInst 报道称(83 个赞,6,173 次浏览)称,GPT-5.5 是第二个能够端到端完成其多步骤网络攻击模拟的模型。关键发现是:“本月早些时候,我们评估 Mythos Preview 后的一个关键问题是,它的表现是否只是一次偶然。GPT-5.5——一款来自另一家开发者的不同模型——取得了类似结果,这表明这属于 AI 网络攻防能力更广泛趋势的一部分。” @soundboy 进一步放大了这一点(29 个赞,1,678 次浏览),@OVGNFT 回复称:“看到这开始变成一种趋势,太吓人了。”
与此同时,@WSJ 报道称(6 个赞,7,189 次浏览)称,白宫反对 Anthropic 将其 Mythos 模型的访问权限扩展给另外约 70 家机构,理由是安全和算力方面的担忧。@hydmeister 回复称:“白宫像打地鼠一样应付 AI,而不是设立真正的护栏。”
与前一天相比: 4 月 29 日聚焦于 AI 安全外交的表演化。今天则出现了首个实证证据,表明多步骤进攻性网络能力正在跨模型家族泛化——这让安全讨论从口号转向已被证明的风险。
1.2 Musk-OpenAI 审判第 4 天:Tesla 否认 AGI,监管争论升温 🡖
@muskonomy 报道称(12 个赞,1,245 次浏览)称,Musk 在宣誓作证时确认,Tesla 并未开发 AGI:“Tesla 的 AI 是用于自动驾驶汽车的。也就是说,它不是那种能回答任何问题的大型 AI 模型。” Microsoft 的交叉询问仅持续了 10 分钟。@GaryMarcus 写道(26 个赞,2,736 次浏览)写道:“亲爱的 @elonmusk,如果你仍然真心在乎 AI 安全,你就不能坐视 Trump 政府让 AI 行业几乎完全不受监管。” 法官指示 Musk,不再允许他在证人席上讨论灭绝事件。@SenSanders 另行推动了(441 个赞,23,916 次浏览)呼吁开展全球 AI 监管合作。
与前一天相比: 4 月 29 日报道的是第 2 天,当时 Musk 用“可能把我们全都杀了”的存在主义框架来描述风险。今天的庭审叙事则明显降温——Musk 否认 Tesla 有 AGI 抱负,法官限制其安全言论,讨论焦点转向这一切最终是否会带来实际监管结果。
1.3 GPT-5.5 Pro 刷新能力纪录,模型基准测试进一步碎片化 🡕
@koltregaskes 报道称(10 个赞,478 次浏览)称,GPT-5.5 Pro 在 Epoch AI Capabilities Index 上达到 159 分——该指数将 37 项基准汇总为单一尺度——同时在 FrontierMath 第 1 至第 3 层级上拿到 52%,并解出了两个此前未解的第 4 层级问题。@DannPetty 分享了(42 个赞,2,610 次浏览,20 次收藏)称,Contra Labs 的设计基准显示:Claude Opus 4.6 在创意构思上领先,Gemini 3 Pro Image 在效果图上领先,Grok Imagine Video 在细化阶段领先。@pmddomingos 指出(42 个赞,4,086 次浏览)戏谑道:“普通 AI 公司都在吹自己的模型在基准上强了多少。只有 Mistral 在吹自己的模型差了多少。” @burkov 回复称:“在欧洲,很多客户必须使用欧洲模型,所以 Mistral 只是在告诉他们:用 Mistral,至少不是在用一坨彻底的垃圾。”


与前一天相比: 4 月 29 日关注的是基准测试的成本和完整性问题。今天新增了新的数据点:GPT-5.5 Pro 创纪录的 ECI 分数,以及 Mistral 一种不同寻常的定位策略——一边拿自己和竞品做基准比较,一边承认差距。
1.4 临床医学中的 AI 开始接受严格评估 🡕
@ScienceMagazine 发布了 提到一项发表于 Science 的研究(26 个赞,5,968 次浏览),显示一款前沿 LLM 在常见临床推理任务中表现优于人类医生,包括急诊决策和诊断。作者澄清,这并不意味着 AI 已准备好独立行医。@GoogleDeepMind 补充道(22 个赞,1,008 次浏览)称,AI 临床协作系统在 140 个领域中的 68 个与医生持平或更优,其中包括分诊,但“人类在发现关键危险信号和指导体格检查方面明显更强。” @DeryaTR_ 批评了(28 个赞,4,767 次浏览)批评临床 AI 基准测试用的是过时模型:“关于 AI 到底行不行,论文结论你完全可以跳过不看,你只需要看看他们测试的那些已经彻底过时的模型。这是科学基准论文里的一个重大问题。”
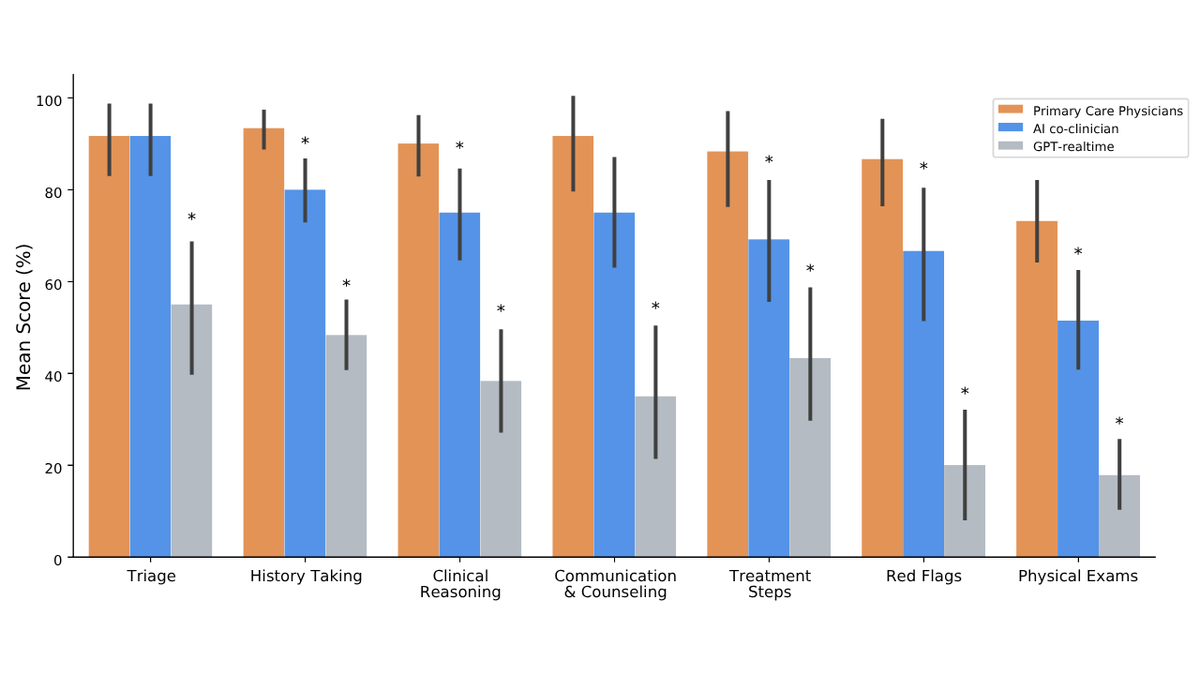
与前一天相比: 4 月 29 日没有出现临床 AI 信号。今天则汇聚了三个独立来源(Science 期刊、DeepMind 和对临床基准的批评),表明临床 AI 评估正在迅速成熟,同时也暴露出人类在打破既有模式的诊断上的持续优势。
1.5 AI 原生独立创始人与零员工创业模式 🡕
@Bencera 宣布(32 个赞,2,924 次浏览,26 次收藏)年化营收运行率达到 $7.5M,且零员工,并推出“God Mode”——可让 AI 自主运行 1 小时到 7 天,收费 $6/小时。仪表盘显示,其在三个月内从 $0 增长到 $7.5M,活跃公司数达 6,707 家。@rugbist_ 回复称:“看到它在没有一次团队会议的情况下扩张,感觉一定很魔幻。” @venturetwins 观察到(87 个赞,5,812 次浏览)称,AI 初创公司如今用工作试做替代简历:“候选人纸面背景的重要性,往往不如他们面对手头工具时真正能做出什么。” @virtualunc 回复称:“一个有 10 年经验但没有 AI 素养的人,生产力确实可能不如一个整天泡在 Cursor 和 Claude Code 里的年轻人。”

与前一天相比: 4 月 29 日只是抽象地讨论 AI 原生创业公司。今天则给出了具体收入证据($7.5M ARR、零员工),以及招聘从看资历转向看实际产出的变化。
1.6 AI 硬件与电力基础设施需求持续升温 🡒
@zerohedge 报道称(20 个赞,10,177 次浏览)称,受 AI 推动,美国电力设备市场正瞄准一轮 $65 billion 的繁荣。@13F_Pro 回复称:“数据中心资本开支已经以 15:1 的速度超过电网扩建。到 2028 年,如果没人打破审批瓶颈,超大规模云厂商集中的地区就会出现限电。” @mweinbach 转述了(31 个赞,2,667 次浏览)援引 Tim Cook 财报电话会议称,来自 AI 和 agentic AI 的 Mac Studio 与 Mac Mini 需求正在造成持续数月的供需失衡。@BrianTycangco 报道称(38 个赞,1,436 次浏览)来自菲律宾的说法是:“AI 需求正在吸走 GPU/CPU 硬件、推高价格,而与此同时能源危机也在重击消费者。菲律宾很可能正走向衰退。” 回复称,随着客户迁移到 AI,BPO 和呼叫中心岗位正在“消失”。
与前一天相比: 4 月 29 日报道的是云业务收入增长(Google +63%、Azure +40%、AWS +28%)。今天补上了下游后果:$65B 的电力设备市场、agentic AI 需求导致的 Apple 硬件短缺,以及硬件成本通胀给新兴市场带来的经济扰动。
1.7 小语言模型与专用智能体成为下一种架构模式 🡕
@Sumanth_077 详细介绍了(10 个赞,256 次浏览,7 次收藏)介绍了 Glean 的 Waldo——一款 30B 模型,在前沿模型运行前先处理搜索规划,使单次调用性能提升 10 倍(250ms 对 3s)。关键架构是:先运行专用小模型,仅在综合阶段才把上下文路由给前沿模型。@LangChain 推出了 harness 配置文件(43 个赞,7,214 次浏览,21 次收藏)称,Deep Agents 已支持按模型分别控制 prompt、工具和中间件。@YashSerai 回复称:“与 LLM 无关的通用智能体通常只是样样都平庸。对 Sonnet 3.5 有效的 prompt,到了 Llama 3 就会失效。”
与前一天相比: 4 月 29 日介绍了 LangChain harness profiles。今天则新增了 Glean 的 Waldo 这一具体证据,表明“小模型优先”的架构正在生产环境中获得牵引,并带来了可量化的性能提升。
2. 什么让大家感到挫败
AI 客服取消人工升级通道——高
@dimitrisorkine 抱怨道(10 个赞,6 次转发,4 次引用)谈到 Booking.com:“看起来我被重复扣费了。根本无法获得任何帮助。你们的人工智能帮不了我,也没有人工可以回应。” 这种模式是:公司部署了无法处理边缘案例的 AI 客服,同时彻底移除了人工兜底。
AI 模型基准测试使用过时模型,导致结论失效——高
@DeryaTR_ 批评了(28 个赞,4,767 次浏览)批评 AgentClinic 和类似论文只测试过时模型:“关于 AI 到底行不行,论文结论你完全可以跳过不看,你只需要看看他们测试的那些已经彻底过时的模型。这是科学基准论文里的一个重大问题。” 论文发表周期跟不上模型发布速度。
AI 驱动的硬件通胀冲击新兴市场——中
@BrianTycangco 报道称(38 个赞,1,436 次浏览)称,在菲律宾,AI 需求正在“吸走 GPU/CPU 硬件、推高价格”,与此同时能源成本也在上升。@ross2stan198855 回复称:“随着客户迁移到 AI,客户流失得飞快。那些 BPO 和呼叫中心岗位正在迅速消失。” 双重冲击在于:硬件变贵了,而 AI 又消灭了原本支撑这些硬件消费的服务业岗位。
中国法院裁定不能因 AI 裁员,但这一问题在全球仍持续存在——中
@michaelxpettis 分享了(16 个赞,1,789 次浏览,7 次收藏)称,中国法院裁定,企业不能仅为了用 AI 替代员工而合法解雇员工,这构成了先例。其他地方尚无同等保护,随着自动化加速,这形成了监管空白。
3. 大家希望出现什么
用于销售流程与潜在客户跟进的 AI 智能体
@akcushman 请求(26 个赞,1,413 次浏览,11 次收藏):“我想要一个 AI 智能体,能接入我的 Slack、电子邮件、Attio、LinkedIn、Granola 等,跟踪我们销售流程和潜在客户的所有往来记录——如果对方没有回复,就提醒我们跟进,并吸收所有相关上下文。” 13 条回复表明,现有工具能部分解决这个问题,但没有一个能整合所有来源。紧迫度:高。
面向普通消费者的智能体部署能力
@_SeanDavid 引用了 Zuckerberg 的话(9 个赞,964 次浏览):“现在要搭一个智能体,你得先在本地安装环境、进入终端、再做各种配置。地球上真正能做到这件事的人,可能也就几百万。” 从“技术上可行”到“我妈都能部署”之间的落差,依然是核心 UX 挑战。紧迫度:高。
运行在本地硬件上的个人主权 AI
@songjunkr 预测(9 个赞,165 次浏览):“我们会用个人硬件来构建个人 SaaS。我们不再把数据交给企业。” @0xWast3 演示了(11 个赞,103 次浏览,9 次收藏)称,可基于 69 个开源仓库,以 $0/年成本运行一整套生产级智能体栈。需求信号是:重视隐私的用户希望获得全栈本地 AI,同时消除成本与数据暴露。紧迫度:中。
4. 正在使用的工具与方法
| 工具 / 方法 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-5.5 / GPT-5.5 Pro | 前沿模型 | (+) | ECI 评分 159;解出此前未解的 FrontierMath 第 4 层级问题;具备多步骤网络攻击能力 | 完成网络攻击模拟,引发安全担忧 |
| Claude Opus 4.6 | 前沿模型 | (+) | 在 Contra Labs 创意构思基准中领先;法律答案一致性达 94% | Sonnet 4.6 在部分基准中出现推理截断 |
| Mistral Medium 3.5 | 开放权重模型 | (+) | 128B;在 Telecom(91.4%)和 Airline(83%)上表现强劲;坦诚自身局限 | Banking(13.4%)表现较弱;BrowseComp(48.6%)低于竞品 |
| Waldo (Glean) | 专用 SLM | (+) | 30B;搜索规划速度提升 10 倍(250ms 对 3s);一半查询走快速路径 | 只负责搜索规划,不处理推理;需要 DPO+RL 训练 |
| Deep Agents harness profiles (LangChain) | 智能体编排 | (+) | 可按模型设置 prompts、tools、middleware;已支持 Python | TypeScript 即将推出;为每个模型维护 profile 会增加复杂度 |
| EvoSkill V1 (Sentient Labs) | 智能体进化 | (+) | 自动化优化 prompt/技能;Claude Code 在 OfficeQA 上从 60.6% 提升到 68.1% | 开源但仍处早期;需要有基准可用于训练 |
| Polsia God Mode | 自主智能体 | (+) | 可自主运行 1 至 7 天;$6/小时;可随时暂停/干预 | 单创始人产品;扩展上限未知 |
| Prediction market agents | 智能体评估 | (?) | 反馈闭环清晰;PnL 可量化;可用 Brier score 校准 | 单个市场噪声较大;需要足够大的交易量才有信号 |
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 阶段 | 链接 |
|---|---|---|---|---|---|
| Polsia God Mode | @Bencera | 可连续工作 1 至 7 天、自己决定下一步的自主 AI 智能体 | 消除对 AI 智能体持续人工指挥的需求 | 已发布 | 帖子 |
| Waldo agentic search | @Sumanth_077 / Glean | 在前沿 LLM 之前运行、用于搜索规划的 30B MoE 模型 | 前沿模型同时承担搜索与综合两项任务,会浪费时延和成本 | 已发布 | 帖子 |
| EvoSkill V1 | @AnnaMariaa133 / Sentient Labs | 在基准上评估智能体并迭代优化 prompt 的自动研究系统 | 靠人工做面向智能体专用化的 prompt engineering,既慢又无法规模化 | 已发布(开源) | 帖子 |
| BioMysteryBench | @WesRoth / Anthropic | 99 个真实世界生物信息学问题,用于比较 AI 与专家小组 | 开放式生物数据分析此前缺乏严格基准 | 已发布 | 帖子 |
| Human Creativity Benchmark | @ajnulty | 从三个阶段和三个维度衡量创意 AI 的专业创造力 | 现有基准把创意质量压缩成单一分数 | 已发布 | 帖子 |
| Norm legal reasoning benchmarks | @johnjnay | 由执业律师维护的专有法律基准 | 通用基准无法覆盖法律领域特定的推理要求 | 已发布 | 帖子 |
| Igra AI agent crypto trading | @emdin | 通过多链稳定币买卖 KAS、无需 CEX 的 AI 交易智能体 | 加密交易需要手动钱包 UX 和 CEX 中介 | Beta | 帖子 |
| Higgsfield Canvas | @WesRoth / Higgsfield AI | 基于节点的工作区,可将前沿生成模型串成流水线 | 复杂的预制作流程需要手动串联多个模型 | 已发布 | 帖子 |
| Prediction market trading agents | @SuhailKakar | 通过 Polymarket 交易的 GPT-5.5 和 Opus 4.7 | 基准只给出单一分数;市场能给出连续的性能分布 | Alpha | 帖子 |
6. 新鲜且值得关注
GPT-5.5 完成多步骤网络攻击模拟
+++] AI Security Institute [确认 称,GPT-5.5 是继 Anthropic 的 Mythos Preview 之后,第二个完成端到端多步骤网络攻击模拟的模型。这不是一个基准分数——而是已被展示出来、且可跨模型家族泛化的进攻能力。白宫正在 同时阻止 Mythos 访问范围的扩大,这表明政策响应是对能力展示作出反应,而非提前布局。
Polsia 在零员工情况下做到 $7.5M ARR
[++] @Bencera 演示了 称,一位单独创始人运营的 AI 智能体基础设施已达到 $7.5M 年化营收运行率(周环比 +7%)、6,707 家活跃公司和 690,180 项已完成任务。新推出的“God Mode”功能支持以 $6/小时进行 1 至 7 天自主运行。这是“零员工 AI 创业公司”理论达到有意义收入规模的最明确公开数据点。
Norm Law 揭示前沿模型法律一致性为 90%——对高风险工作而言仍然不够
[++] @johnjnay 发布了(15 个赞,16 次收藏)称,专有法律基准显示,前沿模型大约有 90% 的时间会得出相同的法律结论。这意味着:“在大规模使用时,用户每周都会对同一个问题收到互相矛盾的答案。” 这量化解释了为什么 AI 在高风险法律工作中需要验证与治理层。

EvoSkill V1:自我改进型智能体工具包开源发布
+] Sentient Labs [发布了(13 个赞,85 次浏览)介绍了 EvoSkill V1,这是一套受 Andrej Karpathy 启发的自动研究系统,能够在基准上评估智能体、分析失败轨迹,并在无人干预下持续优化 prompts。结果是:Claude Code 在 OfficeQA 上从 60.6% 提升到 68.1%;SealQA 在零人工输入的情况下从 26.6% 升至 38.7%。
7. 机会在哪里
**+++] AI 安全验证与网络能力监测**——两种不同的前沿模型(Mythos Preview、GPT-5.5)如今都能完成多步骤网络攻击模拟。白宫正以被动方式阻止访问范围扩张。目前尚不存在能够持续评估新模型发布前是否获得进攻性能力的自动化监测系统。面向部署前安全验证、red-teaming-as-a-service 以及持续能力监测的市场正在形成。([source,来源)
**++] 面向销售团队的 AI 智能体流水线管理**——来自一位 VC 的直接需求 ([source):一个整合 Slack、电子邮件、Attio、LinkedIn 和 Granola 的智能体,用来跟踪潜在客户的全部沟通记录,并在完整上下文下触发后续跟进。13 条回复和 11 次收藏证实了需求存在。现有 CRM 自动化仍停留在前 AI 时代,无法对跨平台上下文进行推理。
**++] 面向高风险 AI 的领域专用一致性验证**——法律 AI 已达到 90% 的一致性,但这意味着在大规模使用下每周仍会出现相互矛盾的答案。凡是将 AI 用于关键决策的领域(法律、医疗、金融),都需要验证层在结果触达用户之前捕捉不一致。Trishool AI 正在[与 Velantris 合作 关于“宪法式安全层”——这证明该市场确实存在。(来源,来源)
**+] 面向消费者的 AI 可及性桥梁**——Zuckerberg 提到如今地球上“只有几百万人”能够搭建一个智能体,再加上 Apple 的 Mac 硬件需求因 agentic AI 用户而激增,这表明接下来的 1 亿智能体用户需要一种与终端和配置文件根本不同的界面。Meta 拥有分发能力,但产品空缺仍然存在。([source,来源)
8. 要点总结
-
AI 的进攻性网络能力正在跨模型家族泛化。 两个独立的前沿模型都能完成端到端攻击模拟,这与基准分数有本质区别——它展示的是能力迁移。白宫阻止 Mythos 扩大访问范围,表明政策如今是在对能力作出反应,而不是提前预防。这将推动部署前安全基础设施的需求。(来源)
-
零员工 AI 创业公司正在产生真实收入。 Polsia 在零员工情况下做到 $7.5M ARR、拥有 6,707 家活跃公司,这不是思想实验——而是一个经验证、且周环比增长 7% 的商业模式。“God Mode” 以 $6/小时提供自主运行功能,直接与人力成本竞争。这验证了这样一个判断:AI 智能体基础设施可以在没有传统员工规模的情况下支撑有意义的业务。(来源)
-
前沿模型在准确率上几乎难分高下,但在高风险工作的一致性测试上仍然不合格。 法律基准显示答案一致性为 90%——对日常使用来说非常出色,但对法律、医疗或金融决策来说,一旦规模化,每周出现相互矛盾的答案将是灾难性的,并会侵蚀信任。机会不在于边际准确率提升,而在于验证与治理层。(来源)
-
小型专用模型正在证明,相比“前沿模型包打天下”,它们在成本效率上更有优势。 Glean 的 Waldo(30B)在搜索规划上实现了 10 倍时延改善;Mistral Medium 3.5(128B)则以远低于前沿模型的成本取得了有竞争力的智能体分数。这样的架构模式——用专用模型处理重复性子任务,只让前沿模型负责综合——正从理论走向生产。(来源,来源)
-
临床 AI 在常规任务上正接近医生水平,同时也暴露出人类在边缘案例识别上的持续优势。 Science 研究与 DeepMind 的结果相互印证:AI 在分诊和临床推理上可与医生匹敌,但在危险信号识别和体格检查指导上仍有缺陷。这界定了整合路径——AI 处理高吞吐量任务,人类处理例外情况——但使用过时模型的基准论文,其结论本身也已经迅速过时。(来源,来源)
-
AI 硬件需求正在制造一个“双速”全球经济。 美国 $65B 电力设备繁荣、AI 需求导致的 Apple Mac 短缺,以及菲律宾的硬件通胀与 BPO 岗位流失,体现的是同一底层动态:AI 基础设施投资将收益集中到算力富集地区,同时推高新兴市场成本并消灭服务业岗位。中国法院已作出 AI 裁员保护回应;其他地区尚无对等措施。(来源,来源,来源)