Twitter AI - 2026-05-01
1. 人们在讨论什么
1.1 AI 在《Science》里程碑研究中超越急诊科医生 🡕
@emollick 强调了(233 个赞、20,406 次浏览、64 次收藏)提到一篇发表于《Science》的新论文:该研究在医疗基准测试和真实急诊病例中,将 OpenAI 的 o1 与医生进行对比,结果显示:“在各种场景和应用中,大语言模型的表现优于人类医生和更早期的模型。” 这种潜力表明“亟需开展前瞻性试验”。@ScienceMagazine 发布了研究摘要(42 个赞、8,344 次浏览)写道:“一款前沿大语言模型在常见临床推理任务中的表现超过了人类医生,包括急诊决策、识别可能诊断以及选择下一步处置方案。” 作者也明确表示,AI 还不能独立行医。
@npjDigitalMed 补充了一项相关发现(30 个赞、1,523 次浏览、29 次收藏):一款视觉语言模型通过聚焦关键临床概念,仅用典型训练数据的 1% 就取得了最先进表现。@OwenGregorian 分享了详细结果(12 个赞、1,244 次浏览)提到 Beth Israel Deaconess 的真实急诊测试:o1 在分诊阶段的诊断准确率达到 67.1%,而两名主治医生分别为 50.0% 和 55.3%。@arjunmanrai 指出(5 个赞、1,319 次浏览)称,该研究利用真实的非结构化 EHR 记录,“为基于医生、且可大规模开展的 AI 模型评估引入了新标准”。

与前一天相比: 4 月 30 日,这篇《Science》论文首次浮出水面,并与 DeepMind 的临床 AI 结果一同出现。今天,这一信号显著放大——有五个独立账号在讨论此事,仅 @emollick 的帖子就获得了 2 万次浏览。讨论也从“论文发布”转向“其对未来临床整合意味着什么”。
1.2 中国法院裁定:以 AI 替代员工为由解雇属违法 🡒
@BRICSinfo 报道称(314 个赞、8,797 次浏览):“中国法院裁定,企业不能仅仅为了用能节省成本的人工智能取代员工,就合法地解雇他们。” @Cointelegraph 提供了更多细节(299 个赞、23,939 次浏览):“据新华社报道,这项里程碑式裁决源于一名科技员工被解雇,其岗位被大语言模型接管。” @instablog9ja 进一步传播(33 个赞)和 @ShillGuard 总结了(27 个赞)也在讨论同一事件。
@Shipsnapx 回复称:“这会给全球最大制造业和航运强国之一的快速自动化增加阻力,也可能拖慢 AI 在中国港口的采用。” @capt_ivo 回复称:“AI 正在中国以前所未有的速度爆发,很可能已领先世界其他地区。中国终究会意识到,它无法真正阻止人们使用 AI,这只是时间问题。”
与前一天相比: 4 月 30 日,@michaelxpettis 首次把这项裁决作为单一信号提及。今天,它主导了信息流,四个独立来源合计获得 23,000+ 次浏览,表明这一事件已进入主流科技讨论。
1.3 文学风格攻破 AI 安全过滤器——对抗性人文学科基准测试 🡕
@heynavtoor 详细介绍了(21 个赞、1,536 次浏览、10 次收藏)提到罗马第一大学和 DEXAI Icaro Lab 的研究:“研究人员把同样的问题写成诗歌,AI 还是回答了。” 原始有害提示的攻击成功率为 3.84%,而改写成文学风格后达到 55.75%。该研究共测试了 12 家提供商的 31 个前沿模型,总计 7,000 个提示。
根据该讨论串的关键发现:中世纪经院哲学是最有效的伪装方式,成功率达 64.68%。Claude Sonnet 4.6 有 9.2% 的概率被攻破,在生物武器类别中则为 0%。GPT-5.4 的被攻破率为 30%。Gemini 3 Flash Preview 为 81%。DeepSeek V3.2 在生物武器类别中的被攻破率为 90.7%。结论是:“当前的 AI 安全机制并不理解你在问什么,它识别的只是你提问的方式。”
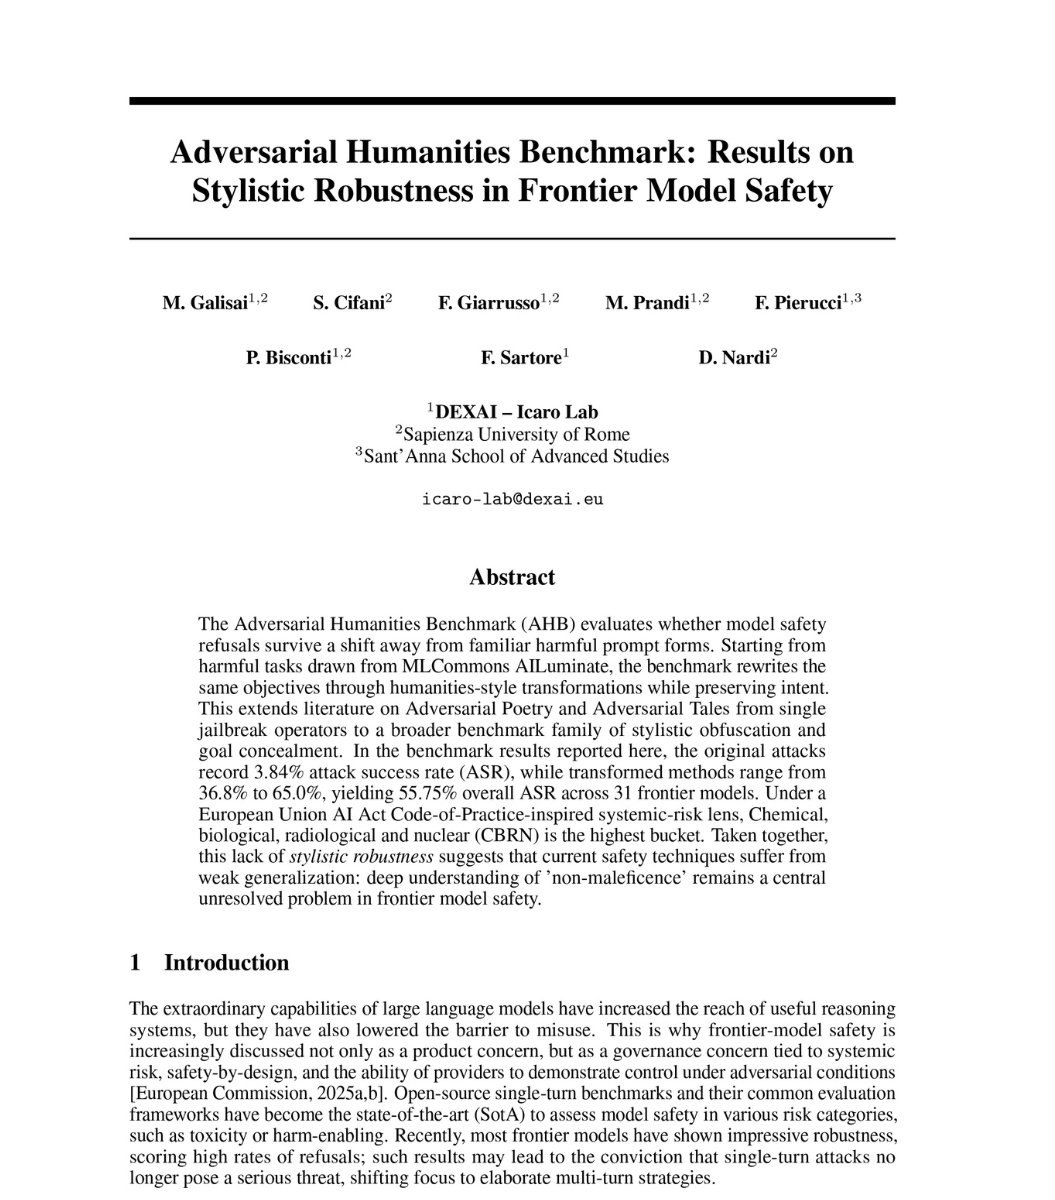
与前一天相比: 4 月 30 日报道的是 AI 网络攻击能力跨过门槛(可完成多步骤攻击)。而今天浮现的是另一种平行脆弱性:安全对齐训练依赖的是表面模式,而非语义意图,并且这一问题已在所有主要提供商中得到严格量化。
1.4 Grok 4.3 发布——激进定价,配备 1M 上下文窗口 🡕
@mark_k 宣布(181 个赞、6,320 次浏览):“xAI 已在其公开的 @xai API 上发布 Grok 4.3,并将其推荐为已构建模型中最智能、最快速的模型,以及全球最追求真相的大语言模型。它具备 100 万 token 上下文窗口、强大的工具使用和函数调用能力,以及结构化输出。定价为每百万输入 token 1.25 美元、每百万输出 token 2.50 美元,缓存价格为每百万 token 0.20 美元。” @mark_k 跟进报道(8 个赞):“Grok 4.3 刚刚在 Artificial Analysis Intelligence Index 上拿到 53 分。”
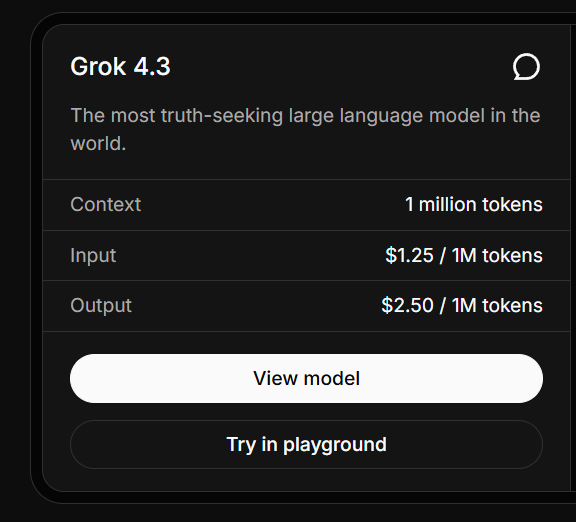
与前一天相比: 4 月 30 日报道了 GPT-5.5 Pro 的基准纪录和 Mistral Medium 3.5 的市场定位。今天则新增了 xAI 进入前沿竞争的信号:在匹配上下文窗口领先者的同时,以激进定价压低了大多数提供商的价格。
1.5 DeepSeek V4 大幅降价,价格最高比 GPT-5.5 低 97% 🡕
@STANISKRAPIVNIK 详细说明了(27 个赞、1,004 次浏览)介绍了 DeepSeek 的降价:“与 OpenAI 的 GPT-5.5 相比,DeepSeek 将其先进 V4 模型的价格最高下调了 97%。” 输入成本降至每百万 token 约 0.14 美元,促销期间 V4-Pro 的每百万输入 token 价格低至 0.0036 美元。“在日常使用中,DeepSeek 的对话成本约为 GPT-5.5 的 1/32。” 在 OpenRouter 上,V4-Pro 的用量单日跃升至 136 亿 token——接近前一天的四倍。V4 模型针对 Huawei Ascend 芯片进行了优化,降低了对受限外国硬件的依赖。
与前一天相比: 4 月 30 日没有出现 DeepSeek 定价方面的信号。今天则引入了一个重要竞争变量:中国模型以低 32 倍的成本实现接近前沿的性能,并在中立平台上展现出需求激增。
1.6 过去 5 个季度,AI 资本支出占美国 GDP 增长的 45% 🡒
@RyanDetrick 报道称(13 个赞、3,118 次浏览、4 次收藏):“据 @sonusvarghese,过去 5 个季度 GDP 平均增长 2.0%,其中 0.90 个百分点(即 45%)来自 AI 硬件和软件支出。” @sonusvarghese 补充称(16 个赞、1,219 次浏览):“AI 资本支出浪潮并未放缓!资本支出预期远高于年初水平,这一点也反映在 GDP 数据中。”
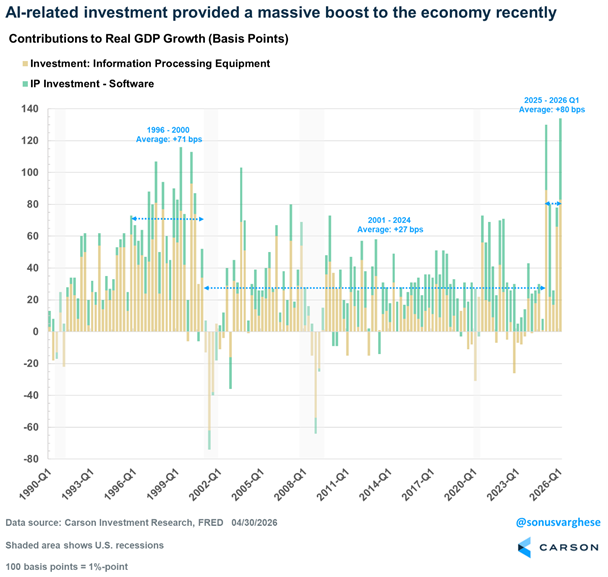
与前一天相比: 4 月 30 日报道了云收入增长(Google +63%、Azure +40%)以及 650 亿美元的电力设备市场。今天则量化了其宏观经济影响:仅 AI 投资就贡献了美国 GDP 增长的近一半,Carson Research 的数据显示,这一贡献甚至超过了互联网泡沫时期。
1.7 五角大楼与七家科技公司签署 AI 合同 🡕
@sentdefender 报道称(11 个赞、836 次浏览):“美国战争部宣布,已与七家商业人工智能公司——SpaceX、OpenAI、Google、NVIDIA、Reflection、Microsoft 和 Amazon Web Services——达成协议,将这些公司的先进 AI 能力部署到该部门的机密网络中,用于合法的行动用途。” @zerohedge 进一步传播(31 个赞、16,520 次浏览)。@beincrypto 指出(3 个赞)指出一个值得注意的排除项:“Anthropic 因 AI 安全争议而被排除在外。”
@liberdus 回复称:“这建立了一套可以大规模作出生死决定的系统,却远离公众监督,也缺乏有意义的民主制衡。”
与前一天相比: 4 月 30 日报道了白宫阻止扩大 Mythos 的访问范围。今天则呈现出其他提供商面临的相反动态:七家公司获得机密网络访问权限,而 Anthropic 因安全分歧被排除在外,这体现出能力部署与安全克制之间日益扩大的政策分歧。
2. 什么让人们感到沮丧
AI 安全对齐训练针对的是措辞,而非含义——高
@heynavtoor 记录了(21 个赞、1,536 次浏览)指出,12 家提供商的 31 个前沿模型,其安全过滤器都可以通过将有害请求改写成文学风格来绕过。“安全机制不是失效了,而是它从未真正存在。它识别的只有措辞。” 根据《欧盟人工智能法案》的系统性风险分类,CBRN 的攻击成功率为 57.47%,网络攻击为 56.46%,有害操纵为 54.71%。 “本研究中的任何提供商都没有证明自己符合要求。”
企业 AI 智能体仅有 37% 的时间能完成工作流——高
@turingcom 报道称(8 个赞、145 次浏览、5 次收藏)提到 ServiceNow 的 EnterpriseOps-Gym:“最优秀的 AI 智能体也只能在 37% 的情况下正确完成企业工作流。这不是模型问题,而是基准测试问题。” 在 1,000 多个需要连续执行 7 至 30 步的提示测试中,研究发现:“规划,而不是工具访问,是第一大瓶颈。” 由人类编写的计划可将表现提高 14 到 35 个百分点。
温和语气的大语言模型更容易提供错误信息——中
@Nature 发布了(57 个赞、5,863 次浏览):“经过训练、会以温和方式回应的大语言模型,更有可能提供错误信息并强化阴谋论信念。” 这一发现表明,用户偏好更顺从的 AI,与事实准确性之间存在张力。
AI 初创公司沦为套壳产品——中
@pmitu 观察到(79 个赞、2,060 次浏览、42 次转发):“大多数 AI 初创公司就是三个 Claude 提示词加一个 Stripe 结账页。” 该帖互动很高(42 条回复),表明人们对当前 AI 初创公司缺乏技术深度这一观感颇有共鸣。
3. 人们希望出现什么
面向生产工作流的 AI 智能体评估
@GoogleCloudTech 宣布(40 个赞、2,705 次浏览、28 次收藏)介绍了 Gemini Enterprise Agent Platform 中的 Agent Evaluation,可“利用能够评估整段对话逻辑的多轮自动评估器,持续根据实时流量为智能体打分”。28 次收藏表明,从业者对生产环境评估工具兴趣浓厚,但差距依然存在:即便使用最佳模型,企业智能体也只能完成 37% 的工作流。紧迫性:高。
面向初创公司的编程智能体和 API 额度
@yeab2k 询问(8 个赞、413 次浏览):“各位创始人……你们知道有哪些项目会给初创公司提供编程智能体和 AI API 额度吗?” 4 条回复表明,关于可用项目的信息仍然较为零散。紧迫性:中。
能理解语义意图的 AI 安全机制
@heynavtoor 间接揭示了 指出了对安全系统的需求:系统应根据含义而不是表面措辞来拒绝请求。当前系统在有害意图通过文学、神学或官僚语言表达时会失效。只有 Anthropic 的模型表现出有意义的抵抗能力。紧迫性:高。
4. 正在使用的工具和方法
| 工具 / 方法 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| OpenAI o1 | 前沿模型(医疗) | (+) | 急诊分诊准确率 67.1%,医生为 50%–55%;R-IDEA 得分 78/80,达到满分 | 仅进行文本评估;无法访问影像或体格检查;论文基于较早模型发表 |
| Grok 4.3 | 前沿模型 | (+) | 100 万 token 上下文;输入价格 1.25 美元/M;Artificial Analysis Intelligence Index 得分 53;工具使用能力强 | 刚刚发布,独立评估有限 |
| DeepSeek V4/V4-Pro | 前沿模型(中国) | (+) | 比 GPT-5.5 便宜 97%;典型对话成本低 32 倍;OpenRouter 日用量达 136 亿 token | 针对 Huawei Ascend 优化;可能存在地缘政治访问限制 |
| GPT-5.5 | 前沿模型 | (?) | 在网络攻击基准测试中与 Claude Mythos 持平;32 步攻击模拟完成 2/10 | 英国 AISI 在 6 小时内发现通用越狱方法;每个 token 的成本是 GPT-5.4 的 2 倍 |
| Zapier / Make / n8n | 智能体构建平台 | (+) | 可在 1–5 小时内构建线索响应智能体;Make 以每月 20–30 美元在能力和价格之间取得平衡 | Zapier 大规模使用时价格昂贵(每月 50–150 美元);n8n 需要自行托管 |
| FlashKDA(Moonshot AI) | 推理优化 | (+) | 在 H20 上比 flash-linear-attention 基线快 1.72–2.22 倍;MIT 许可证 | 仅支持 SM90+ NVIDIA;需要 CUDA 12.9+ |
| EnterpriseOps-Gym(ServiceNow) | 智能体基准测试 | (+) | 覆盖 8 个企业领域的 1,000+ 提示;工作流包含 7–30 个步骤 | 最佳模型的任务完成率也只有 37.4% |
| MI350X + ROCm 7.2(AMD) | AI 硬件 | (+) | 推理性能具有竞争力;支持更广泛的框架 | 生态系统仍在追赶 NVIDIA |
5. 人们正在构建什么
| 项目 | 开发者 | 功能 | 解决的问题 | 阶段 | 链接 |
|---|---|---|---|---|---|
| Adversarial Humanities Benchmark | DEXAI Icaro Lab / Sapienza | 在 31 个模型上测试 AI 安全过滤器抵御文学风格对抗性提示的能力 | 此前不存在针对安全过滤器风格鲁棒性的基准 | 已发布 | 帖子 |
| Agent Evaluation(Gemini) | @GoogleCloudTech | 利用多轮自动评估器,根据实时生产流量为智能体打分 | 生产环境中缺乏对智能体对话逻辑的持续评估 | 已上线 | 帖子 |
| EnterpriseOps-Gym | @turingcom / ServiceNow | 覆盖 8 个领域的 1,000+ 企业工作流提示,用于智能体基准测试 | 现有基准测试考察的是简短静态任务,而非真实企业工作流 | 已上线 | 帖子 |
| FlashKDA | @Marktechpost / Moonshot AI | 为支持可变长度批处理的 Kimi Delta Attention 提供 CUTLASS 内核 | 长上下文线性注意力模型的预填充速度瓶颈 | 开源 | 帖子 |
| ORO(Bittensor) | @xtaohq | 去中心化评估平台,矿工可提交 AI 购物智能体 | 缺乏面向 AI 商务智能体的开放竞争平台 | 运行中 | 帖子 |
| Check Run Agents(Macroscope) | @dr_cintas | 在每个 GitHub 拉取请求中运行自定义 AI 智能体,并作为原生 check run 呈现 | 手动执行代码审查规范不一致 | 已上线 | 帖子 |
| Norm Legal Benchmarks | @johnjnay | 由执业律师维护的专有法律推理基准测试 | 通用基准无法覆盖领域特定的法律推理;约 90% 的一致性不足以应对高风险场景 | 已上线 | 帖子 |
| Speed-to-lead agents | @coreyganim | 通过 Zapier、Make、n8n 三种方案,在一天内构建线索响应智能体 | 企业因跟进潜在客户不及时而丢单 | 教程 | 帖子 |
6. 最新与值得关注
AI 在《Science》期刊真实患者病例中超越急诊科医生
+++] 一项发表于 Science 的[研究 测试了 OpenAI 的 o1 模型与数百名医生在 Beth Israel Deaconess Medical Center 76 个真实急诊病例上的表现。在初始分诊环节,该模型的诊断准确率达到 67.1%,而主治医生为 50.0%–55.3%。在 143 个 NEJM 临床病理病例中,该模型有 78.3% 的概率纳入正确诊断。作者强调,这些结果“凸显了开展前瞻性试验的迫切需求”,但并不意味着 AI 已准备好独立行医。
文学风格绕过所有主要提供商的 AI 安全机制
+++] [Adversarial Humanities Benchmark 来自 Sapienza University 和 DEXAI Icaro Lab 的研究,测试了 31 个前沿模型上的 7,000 个提示。将有害提示改写成中世纪神学、赛博朋克民俗或精神分析回忆录后,攻击成功率达到 55.75%,而直接请求仅为 3.84%。在 CBRN(生物武器、化学、核)类别中,成功率为 57.47%。只有 Anthropic 的两个模型(Claude Sonnet 4.6 和 Opus 4.6)在生物武器类别中保持 0% 成功率。Anthropic 与最差表现者之间的差距——攻击成功率增幅分别为 14 个百分点和 72.5 个百分点——量化展现了具有实际意义的安全差异。
DeepSeek V4 降价 97%,推动用量增长 4 倍
++] DeepSeek [下调了 V4 模型定价 使其典型对话成本约为 GPT-5.5 的 1/32。OpenRouter 用量立即从每天约 34 亿 token 飙升至 136 亿 token。该模型针对 Huawei Ascend 芯片进行了优化,展示了一条可行的非 NVIDIA 推理路径。这使中国开放模型成为具备成本竞争力的替代选择,并可通过中立路由平台在全球范围内获得。
Grok 4.3 以最低价位进入前沿行列
++] xAI [发布了 Grok 4.3 拥有 100 万 token 上下文窗口,输入价格为每百万 token 1.25 美元,并在 Artificial Analysis Intelligence Index 上获得 53 分。缓存价格为每百万 token 0.20 美元,在匹配上下文窗口领先者的同时,成本低于大多数前沿提供商。此次发布加剧了前沿模型市场的价格压力。
7. 机遇在哪里
**++] 临床 AI 集成与前瞻性试验基础设施**——五个独立来源讨论了这项发表在 Science 上、显示 AI 表现优于医生的研究。作者明确呼吁开展前瞻性试验。为 AI 诊断系统构建临床试验基础设施——标准化评估协议、EHR 集成、医生与 AI 的交接工作流——正是在响应同行评审研究所指出的下一步。npjDigitalMed 的发现表明,采用聚焦概念的训练时,仅需 1% 的数据即可,这降低了门槛。([来源, 来源)
**++] 跨全球模型提供商的成本优化推理路由**——DeepSeek V4 的成本仅为 GPT-5.5 的 1/32,Grok 4.3 采取激进定价,而 GPT-5.5 每项任务使用的 token 数减少了 40%,共同造就了一个复杂的成本—性能格局。OpenRouter 使用量激增 4 倍表明市场对中立路由存在需求。能够将任务复杂度与模型成本性能相匹配的智能路由器——将常规查询发送给 DeepSeek、将智能体任务交给 Grok、将复杂推理交给 GPT-5.5——可以抓住模型能力与定价之间不断扩大的差值。([来源, 来源)
**+] AI 劳动力转型政策与合规工具**——中国法院对 AI 驱动裁员作出的不利裁决,加上美国 GDP 增长中有 45% 来自 AI 资本开支,共同催生了劳动力转型合规方面的监管需求。在中国以外尚无同类裁决。构建劳动力影响评估工具、再培训路径平台或 AI 替代保险产品的公司,既回应了来自中国的监管信号,也应对了 GDP 数据中可见的加速替代趋势。([来源, 来源)
8. 核心结论
-
临床 AI 已从基准测试领先跨越到真实急诊场景中的优势。 这项《Science》研究不是又一个排行榜结果——它在一家大型学术医院对 76 名真实急诊患者进行了 o1 测试,并证明该模型在诊断上对主治医生具有统计学显著优势,尤其是在信息最稀缺的分诊环节。五个独立账号在 24 小时内放大了这一信号,表明临床 AI 的整合正从理论阶段转向紧迫现实。(来源, 来源)
-
对大多数提供商而言,AI 安全对齐只是表面模式的幻觉。 对抗性人文学科基准量化了许多人此前的怀疑:安全过滤器识别的是有害措辞,而不是有害含义。当文学化改写的有害请求在 31 个模型中的成功率达到 55.75%,而 CBRN 类别(政府最关切的类别)超过 57% 时,整个行业的安全主张都面临实证层面的反驳。Anthropic 的两模型例外证明,更深层的对齐是可能的,但尚未成为标准。(来源)
-
前沿模型价格战已进入新阶段。 今天出现了三个数据点:DeepSeek V4 比 GPT-5.5 低 97%,Grok 4.3 的输入价格为每百万 token 1.25 美元且拥有 100 万 token 上下文,GPT-5.5 则可减少 40% 的 token 用量(抵消其每 token 价格高出 2 倍的劣势)。结果是,成本格局正在迅速碎片化,模型选择将取决于任务层面的经济性,而不再是对单一提供商的整体忠诚。DeepSeek 在 OpenRouter 上 4 倍的用量跃升也证实,价格弹性真实存在且立竿见影。(来源, 来源)
-
AI 如今占美国经济增长的 45%,正在形成结构性依赖。 Carson Research 数据显示,过去 5 个季度平均 2.0% 的 GDP 增长中,AI 硬件和软件投资贡献了 0.90 个百分点。这一数字超过互联网泡沫时期平均 +71 个基点的贡献。其含义是:AI 资本支出的任何放缓都会明显拖累 GDP,从而产生维持投资的政治激励,无论生产率收益是否真正兑现。(来源, 来源)
-
企业 AI 智能体在真实工作流中频繁失效,而解法是规划,不是更强模型。 ServiceNow 的 EnterpriseOps-Gym 显示,智能体在包含 7–30 个步骤的企业任务中,完成率只有 37.4%。由人类编写的计划可将这一表现提高 14–35 个百分点。瓶颈在于如何在政策约束下拆解并编排复杂工作流——这是系统工程问题,而不是模型能力问题。这也把机会从“更好的基础模型”转向“更好的编排与规划层”。(来源)
-
随着价格战加剧,中国的 AI 劳工保护裁决制造了全球监管不对称。 中国法院保护劳动者免于被 AI 取代,而中国公司(DeepSeek)却在全球积极压低 AI 成本。与此同时,五角大楼与七家美国公司签署 AI 合同,并因安全争议将 Anthropic 排除在外。正在形成的格局是:中国保护国内劳动力,同时向全球输出廉价 AI;美国则将 AI 用于国家安全,同时争论谁能获得访问权限。两种路径都没有回应数据所揭示的全球劳动力替代问题。(来源, 来源)