Twitter AI - 2026-05-04
1. 大家在讨论什么
1.1 持续学习与 Agent 记忆成为下一个评测前沿 🡕
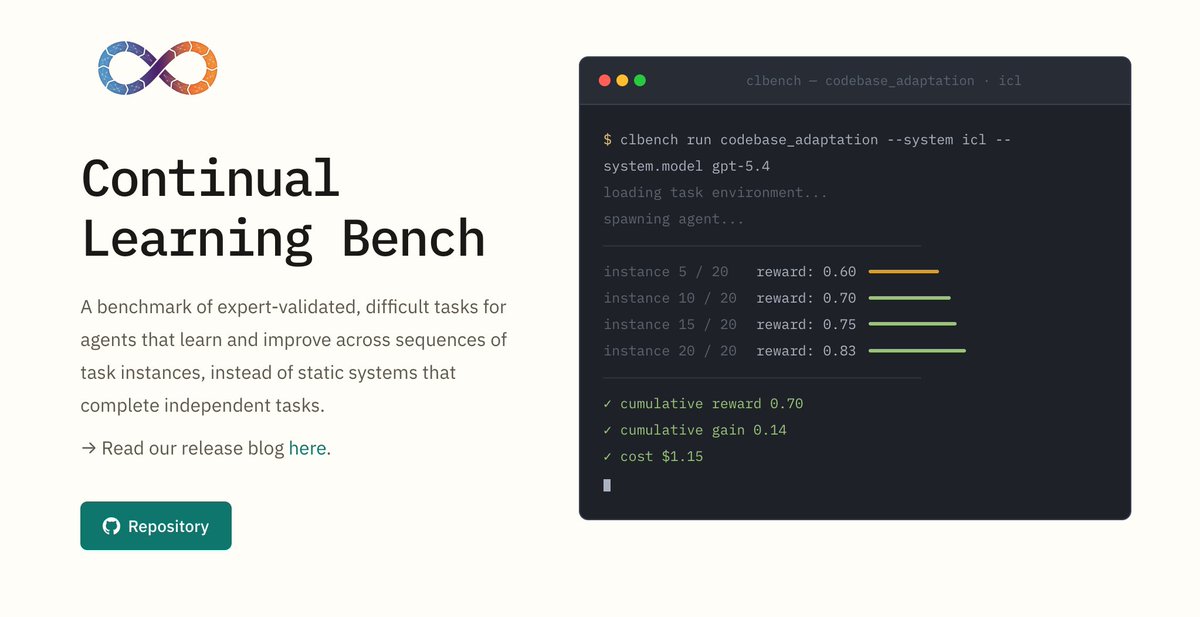
当天互动最高的帖子来自 @pgasawa 宣布推出 Continual Learning Bench 1.0(498 次点赞,66,627 次浏览,386 次收藏):“这是首个现实可用、用于衡量 AI 系统如何在在线环境中不断改进的基准。如今的基准默认模型是无状态的。每个样本彼此独立,系统完成一个任务后,就仿佛什么都没发生一样继续往前。但部署中的 AI 系统理应从经验中学习。” 该基准在有序任务序列上评估系统,任务彼此并非独立,且前面的样本包含对后续任务有用的信息。该工作由 @UCBerkeley 和 @SnorkelAI 共同署名;由 Snorkel 放大推广(17 次点赞,960 次浏览)将其概括为:“一个用于衡量 AI 系统是否真的会随时间推移而变好的新基准。”
与此同时,@alex_prompter 报道了来自 HKUST 的 XSKILL(18 次点赞,1,836 次浏览,16 次收藏)表示:“HKUST 刚刚给 AI agents 配上了会随时间变强的永久记忆。不需要重新训练。一个模型学到的经验还能迁移到另一个模型上。在最难的基准上最多提升 11 分。” 该系统采用双重记忆架构,分别积累技能(工作流模式)和经验(需要避免的具体错误),并且 Gemini 与 GPT 两个模型家族之间可以实现跨模型迁移。@EloPhanto 则在回复中提出异议:“真正有价值的部分不是把‘记忆’当作存储,而是带有合并策略的记忆:来源追踪、过期机制、冲突处理,以及能够证明究竟是哪条经验改变了下一次工具调用。否则 agents 只会不断积累看似自信的民间传说。”
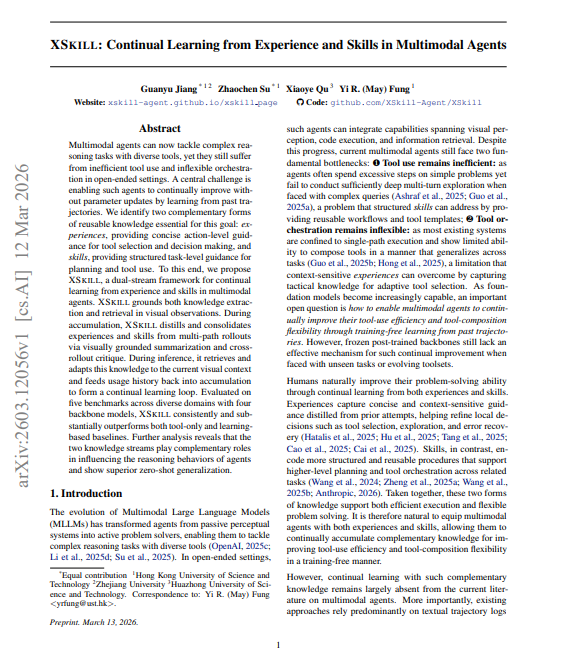
与前一天相比: 5 月 3 日没有持续学习相关讨论。这是一个新的高信号主题——CLBench 的 386 次收藏表明构建者兴趣异常强烈,而两条彼此独立的研究线索(Berkeley/Snorkel 的基准 + HKUST 的 agent 记忆)同时出现,说明行业正围绕“从部署中学习”这一方向形成共识,将其视为静态基准之后的下一能力前沿。
1.2 Grok 4.3 宣称在法律与金融垂直基准上领跑 🡕
@XFreeze 报道称(166 次点赞,5,909 次浏览,19 次收藏):“Grok 4.3 刚刚成为世界上在法律和金钱领域最聪明的 AI。它在两个残酷的私有测试中拿下第一,其他模型都没赢过。Vals AI benchmarks:#1 CaseLaw (v2) - 79.31% accuracy。基于真实加拿大法院案件的私有问答基准。#1 CorpFin (v2) - 68.53% accuracy。面向长上下文信贷协议的私有基准。” @muskonomy 确认了这些数字(21 次点赞,1,521 次浏览)补充称:“以 73.4% 击败 GPT 5.1。”

讨论洞察: 质疑几乎立刻出现。@kevinlewis4801 回复称:“数字很亮眼,但私有基准总得稍微谨慎一些。很想看看它在更多开放、经过广泛验证的测试上表现如何。” @DaytonDavis 则更直接:“都说是世界上最聪明的 AI 了,结果你开个新对话,它连你之前聊过什么都不知道……lol 拜托别再拿 benchmark 那套鬼话糊弄我了。”
与前一天相比: 5 月 3 日对 Grok 4.3 的讨论聚焦于单位成本智能。今天的信号则收窄到法律和金融这两个垂直领域的推理能力,并给出了私有基准上的具体准确率。其价格点(每百万 tokens $1.25/$2.5)也进一步强化了昨天“高性价比”的叙事。
1.3 中美 AI 脱钩——GPU 禁令之争仍在继续 🡒
@GordonGChang 表示(59 次点赞,3,571 次浏览):“白宫指控中国发起了‘industrial-scale campaigns’ 来窃取 AI。我们知道 DeepSeek 盗版了 OpenAI 的大语言模型。” @cryptopunk7213 提出了相反的观点(22 次点赞,1,689 次浏览):“禁止 nvidia 进入中国,意味着中国被迫追赶本土芯片厂商……一旦赶上,中国就具备了超越西方所需的一切:能源充足(是美国的 3 倍)、研究人才充足(50% 在中国)、供应链扩展能力强。” @Techmeme 指出(551 次浏览)则提到 Jensen Huang 表示,Nvidia 在中国的市场份额“现在已经降为零”。
讨论洞察: @LyraSongstress 回复 @cryptopunk7213 称:“Jensen Huang 承认,制裁反而成了他们的研发预算。挺有意思,保护主义等于替竞争对手写了路线图。” @cptknight_tm:“零市场份额 = 零影响力。G42-Microsoft 证明中间路线是存在的:既能获得前沿能力,又有可审计的合规机制。结果我们却选了二元对立。”
与前一天相比: 5 月 3 日首先引爆了 NVIDIA 从 95% 到 0% 的故事,获得 24K 浏览。今天的讨论则分裂为地缘政治叙事(知识产权窃取指控 vs. 战略失误批评),单条互动降低,但意识形态分布更广,表明这场争论正在越过最初的震惊阶段,走向更成熟的讨论。
1.4 对 LLM 的怀疑仍在持续——“一场骗局” vs. 持续进步 🡒
@MrEwanMorrison 继续了他的批评(155 次点赞,2,580 次浏览):“三年的证据已经摆在眼前。Large language Model AIs 就是一场骗局。它们的错误率超过 30%。幻觉是内建的。它们已经卡在发展平台期。” 他引用的是 @walterkirn:“为什么 LLMs 会不断把最简单的事情都搞错,几乎不停地编造内容,但人们却说它们正不可阻挡地冲向神一般的力量?” @KevinDSmead 还举了一个具体例子:“前几天我让 Copilot 评估一张图片……它给了我一段非常详细的分析。问题是——我根本忘了上传图片。”
反向信号:@DeryaTR_ 强调了 GPT-5.5 在空间推理方面的进展(20 次点赞,2,516 次浏览):“3D 环境中的空间推理是 AI 模型最困难的基准之一……GPT-5.5 已经实现了巨大跃升,正在逼近人类水平。” @sudoraohacker 提出了一个更为细致的立场(5 次点赞,680 次浏览,4 次收藏):“我认为未来到来的速度会比今天大多数人预期得更快,我们正处在某种类似奇点的过渡中,但或许又没有当前实验室研究人员想象得那么快。”
与前一天相比: 5 月 3 日也出现了同一个 @MrEwanMorrison 的帖子(横跨两天传播),并伴随一份对 37 个基准的量化分析。今天怀疑派新增了一个广泛传播的轶事(忘记上传图片),乐观派则新增了一个具体能力里程碑(3D 空间推理)。双方分歧依旧稳定。
1.5 Agentic AI 商业与支付基础设施 🡕
@Mantle_Official 引用了他们的产品负责人发言(22 次点赞,365 次浏览):“AI 的下一项关键基础设施是面向 agents 的支付。传统支付轨道无法支撑大规模 agentic commerce。” @minhokim 梳理了竞争格局(10 次点赞,306 次浏览):“Visa 发布了面向 AI agents 的 CLI。Coinbase 的 x402 刚刚进入 Linux Foundation,背后有 Stripe 和 Google 支持。支付的 agentic 这一侧正在走向公开化。” @francescoswiss 在 AgenticDay 上发言(16 次点赞,323 次浏览)则讨论了“x402、agentic commerce,以及真正已经开始落地的东西”。
@shadowlord_VN 阐述了信任栈(9 次点赞,87 次浏览):“AI infra 的价值不在于它能跑更大的模型,而在于它能在从未见过面的 agents 之间制造信任。身份、评估、结算——这才是那一整套栈。”
与前一天相比: 5 月 3 日没有专门的 agentic 支付报道。今天来自多个独立声音(Visa、Coinbase/x402、Mantle、Ritual)的信息同时汇聚到 agent 支付基础设施上,说明这一方向正从概念走向实际开发。
1.6 AI 安全威胁升级——国家级行为体正利用 LLM 制作恶意软件 🡕
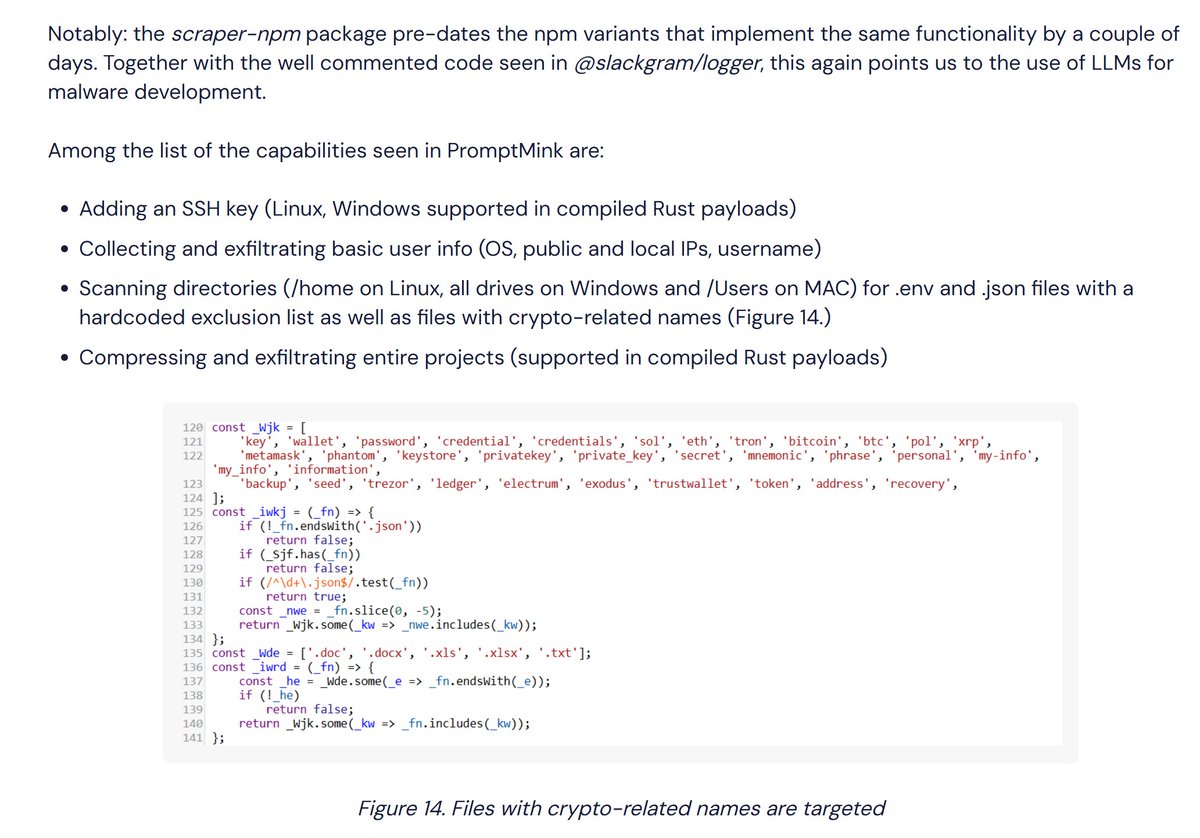
@blackorbird 报道了 PromptMink 活动(20 次点赞,2,266 次浏览,8 次收藏):“这次新的恶意软件活动涉及一个被污染的 package,它是在 2 月 28 日一次对 autonomous trading agent 的 commit 中引入的。该 commit 由 Anthropic 的 Claude Opus 大语言模型共同署名。它允许攻击者访问用户的加密钱包和资金。” 该活动与朝鲜组织 Famous Chollima 有关,并称其“利用 AI 生成代码和分层 package 策略来规避检测,同时比欺骗人类开发者更有效地欺骗自动化编码助手”。
与此同时,@axios 报道称(11 次点赞,7,538 次浏览):“特朗普政府正在考虑对新 AI 模型进行安全审查。” @samsabin923 补充了细节(5 次点赞,303 次浏览):“ONCD 提出了一套 AI 安全框架……摆上桌面的内容包括:由 DoD 在政府层面对 AI 部署进行红队测试。”
与前一天相比: 5 月 3 日讨论的是 AI 生成代码会产出 55.8% 可被利用漏洞这一系统性问题。今天则明显升级:一个被点名的国家级行为体正在主动使用 LLM 生成代码,对加密基础设施发起供应链攻击。威胁已经从“模型会产出脆弱代码”转向“对手将 AI 编码助手武器化”。
1.7 大科技公司的 AI 更新——Meta、Google、OpenAI、IBM-Oracle 🡒
@MetaNewsroom 回顾了 4 月亮点(60 次点赞,2,558 次浏览):“我们推出了 Muse Spark,这是首个由 Meta Superintelligence Labs 构建的大语言模型,并与 Amazon Web Services 合作,以实现算力组合多样化。” @NewsFromGoogle 总结称(29 次点赞,1,066 次浏览):“GoogleCloudNext 的重点,就是通过 Gemini Enterprise Agent Platform 和我们第八代 TPUs 等新工具,帮助企业最大化利用 agentic AI。” @joinautopilot 报道称(15 次点赞,2,725 次浏览):“据报道,OpenAI 正在组建一个 10,000,000,000 美元的 venture,把 AI 软件带进企业。” @wallstengine 指出(24 次点赞,3,304 次浏览):“$IBM 与 Oracle 扩展了他们长达 40 年的合作关系,新增 AI 和混合云产品。”
与前一天相比: 5 月 3 日关注的是 hyperscaler 的 capex 积压(合计 $1.4T)。今天则转向产品层面的动作——Meta 的新模型实验室、Google 的企业 agent 平台、OpenAI 的 100 亿美元企业 venture,以及 IBM-Oracle 的整合。叙事正在从“他们花了多少钱?”转向“他们到底在交付什么?”
2. 什么让人感到挫败
尽管三年来不断进步,LLM 幻觉问题依然没有解决 —— 高
@MrEwanMorrison 宣称(155 次点赞,2,580 次浏览):“它们的错误率超过 30%。幻觉是内建的。” @KevinDSmead 给出了最致命的轶事:“我让 Copilot 评估一张图片……它给了我非常详细的分析,还确认这种图片常被用于欺诈。问题是——我忘了上传图片。” 让人沮丧的不是模型会犯错,而是在根本没有可用输入的情况下,它们仍会自信地编造。那条“这就是场骗局”的帖子拿到 155 个赞,说明这种情绪已广泛共鸣,超出了 AI 怀疑论者的小圈子。
应对策略: 从业者通常把模型输出当成需要人工核验的草稿材料,但这种摩擦正在削弱原本支撑 AI 采用的生产力收益。
AI 生成代码正成为供应链攻击载体 —— 高
@blackorbird 记录了(20 次点赞,2,266 次浏览)提到 PromptMink 活动:AI 生成的 commits 将恶意软件引入 autonomous trading agent。@benbieler 重申了(3 次点赞,69 次浏览):“55.8% 的 AI 生成代码包含可被利用的安全缺陷……当被要求审查这些代码时,模型有 78.7% 的概率能正确识别出自己写下的漏洞代码。” 这种挫败感在叠加:模型既会生成漏洞,也可能被对手用来大规模生成漏洞。
应对策略: 两遍式代码生成(先生成,再审查),但这会让计算成本翻倍,而且也无法防止来自外部依赖的供应链注入。
对 benchmark 的痴迷与实际使用脱节 —— 中
@DaytonDavis 回复称 针对 Grok 4.3 的 benchmark 宣称表示:“都说是世界上最聪明的 AI 了,结果你开个新对话,它连你之前聊过什么都不知道……lol 拜托别再拿 benchmark 那套鬼话糊弄我了。” @kevinlewis4801:“私有 benchmark 总得谨慎一点。” CLBench 1.0 的发布本身,正是对这种挫败感的回应——它的创建者明确指出,“今天的 benchmarks 默认模型是无状态的”,而这一假设对已部署系统来说是错误的。
AI 采用速度超过了集成能力 —— 中
@caprikaps 观察到(1 次点赞,1,269 次浏览,4 次收藏):“‘需求增长速度已经超过部署能力’是今年 AI 领域最诚实的一句话。瓶颈已经不再是 capacity,而是 integration。中型企业有预算、有用例,但根本没有团队真正去落地。” 高收藏点赞比(4:1)说明这句话打动了很多从业者,他们选择保存,而不是公开表态。
3. 人们希望存在什么
能从部署中学习的 AI agents——而不只是从训练中学习
@pgasawa 发布了 CLBench 1.0(498 次点赞,386 次收藏)之所以引发强烈共鸣,正因为当前系统并不具备这种能力:“如今的 benchmarks 默认模型是无状态的。每个样本彼此独立。” HKUST 的 XSKILL 论文展示了初步结果——最多提升 11.13 分,语法错误率从 20.3% 降到 11.4%——但正如 @EloPhanto 所说,真正可投入生产的 agent memory 还需要“来源追踪、过期机制、冲突处理”。人们真正想要的是:无需重新训练,agent 就能在特定工作上越做越好。紧迫性:高。
能评估 AI 熟练度,而不只是编码能力的招聘流程
@hackerrank 宣布(26 次点赞,1,542 次浏览,22 次收藏)提出了一种重新设计的面试形式:“Tasks:从 LeetCode 谜题转向真实代码库中的真实 bug。Evaluation:从功能正确性转向 AI fluency 和 judgment。Experience:从简单代码编辑器转向 agentic development environment。” 22 次收藏说明招聘经理们正在积极寻找这类方案。现有面试考的是 agents 已经能做的技能;新的需求则是考察人如何与 agents 协作。紧迫性:高。
超越“大模型更大”的药物发现基础设施
@parmita 认为(20 次点赞,1,060 次浏览):“药物发现的问题出在一个再多砸钱也修不好的层面。只有卓越的工程和基础设施能修好它。” 她还补充说:“AlphaFold 不是一个好的类比;蛋白质折叠本质上是完全不同的问题。更大的问题在于,许多药物从一开始就从未进入药物发现的漏斗。” 人们希望看到的是能让 AI 真正对药物发现有用的测量基础设施,而不是把更强模型应用在不足的数据之上。紧迫性:中。
面向中型企业的 AI 集成团队
@caprikaps 指出了差距(1,269 次浏览,4 次收藏):“中型企业有预算,也有用例,但没有真正能落地的团队。” 人们希望得到的是开箱即用的 AI 集成服务,而不是必须先组建完整的 ML 工程团队。紧迫性:中。
4. 正在使用的工具与方法
| 工具 / 方法 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Grok 4.3 | 前沿模型 | (+) | 在私有基准上排名 #1:CaseLaw(79.31%)和 CorpFin(68.53%);每百万 tokens $1.25/$2.5 | 仅有私有基准;没有跨会话记忆;现实适用性遭质疑 |
| Continual Learning Bench 1.0 | 评测框架 | (+) | 首个衡量有状态学习的基准;涵盖软件工程、数据科学、战略建模等经专家验证的任务 | 初始版本;目前任务领域仍有限 |
| XSKILL | Agent 记忆框架 | (+) | 双重记忆(技能 + 经验);Gemini 与 GPT 家族间可跨模型迁移;零参数更新 | 仍处研究阶段;没有生产部署证据;缺乏处理冲突经验的合并策略 |
| GPT-5.5 | 前沿模型 | (+) | 根据 Blueprint-Bench 2,3D 空间推理正在逼近人类水平 | 空间推理虽有进展但仍未解决;第三方验证有限 |
| Gemini Enterprise Agent Platform | 企业 AI | (?) | Google 支持的企业级 agentic AI;支持第八代 TPU | 刚刚发布;真实世界部署数据有限 |
| Muse Spark (Meta) | 前沿模型 | (?) | Meta Superintelligence Labs 的首个 LLM;与 AWS 合作提供算力 | 尚未公布基准或能力细节 |
| Firefly (Adobe) | 创意 AI | (+) | ARR 达 $250M;生成式 credits 消耗环比增长 45%;视频生成同比增长 8 倍 | 传统图库业务下滑快于预期;GUI 创作 vs. 文本提示创作的生存性问题仍在 |
| ArmorClaude / ArmorSDK | AI agent 安全 | (+) | 专为 AI agents 设计的安全框架;已在 hackathon 中测试 | 早期阶段;采用数据有限 |
今天最显著的变化,是关注点从模型能力转向模型随时间变化的行为。CLBench 和 XSKILL 都在回答:模型能否通过部署持续变强,而不只是通过训练提升;与此同时,Grok 4.3 在垂直领域的成绩以及 Adobe Firefly 的商业进展,则表明商业价值真正沉淀的地方,是专业化应用,而不是通用基准。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Continual Learning Bench 1.0 | @pgasawa、UC Berkeley、@SnorkelAI | 衡量 AI 系统是否能通过连续任务经验持续改进的基准 | 现有基准默认模型无状态;无法衡量在线学习 | 专家验证任务、序列评估、开放基准框架 | 已发布 | 帖子 |
| XSKILL | HKUST(@alex_prompter 报道) | 为 agents 提供无需重新训练即可保留技能与经验的双重记忆系统 | agents 每个任务都会“失忆式重启”;无法积累学习成果 | 技能提取、经验日志、跨模型迁移 | 研究论文 | 帖子 |
| Pacely AI Coach | @kekkozrl | AI 教练系统,研究 15 位 RLCS 职业选手的倾向,并按他们的打法回放你的比赛 | 电竞选手缺少以特定职业选手风格为模板的个性化指导 | AI 回放分析、热力图、benchmarking | 即将推出 | 帖子 |
| Blackbox Node Field Edition | @BlackboxAIhost | 密封式口袋边缘 AI 节点,具备本地推理、mesh radio 和基于无线电的 Bitcoin ecash | AI 推理依赖云连接与市电供电 | CM5 compute、16GB RAM、SX1262 Meshtastic、LR2021、solar + BMS、CashuBTC | 原型 | 帖子 |
| Sherlock AI for Ethereum | @sherlockdefi | 基于 AI 的 Ethereum 执行与共识客户端安全扫描,对照 EIP 规范进行检查 | 核心基础设施中的规范漂移与共识风险未被及时发现 | AI 代码分析、EIP 规范比对 | 已获资助(Ethereum Foundation grant) | 帖子 |
| Multiplayer AI (Shapes) | @nooriefyi | 面向多人协作规划、头脑风暴和工作的群聊式 AI | ChatGPT 是 1:1;现实世界靠的是群聊 | 群聊 AI、社交网络 | 已上线(#31 Social Networking US) | 帖子 |
| HackerRank Agentic Interviews | @hackerrank | 测试开发者 AI fluency 的面试形式,使用真实代码库和 agentic 开发环境 | 传统面试考的是 agents 已经能做的技能;无法评估人机协作 | Agentic development environment、真实 bug 仓库 | 已推出 | 帖子 |
| SarvamAI Satellite AI | @SarvamAI | 在轨部署数据中心级 GPU,实时运行 AI 模型处理高光谱图像 | 卫星采集数据后回传地面处理,受延迟与带宽制约 | 星上 GPU 推理、高光谱成像 | 演示卫星 | 帖子 |
6. 新鲜且值得关注
朝鲜组织将 LLM 生成代码武器化,用于供应链攻击
+++] PromptMink 活动,由 @blackorbird 报道(20 次点赞,2,266 次浏览,8 次收藏)标志着 AI 赋能威胁的一次质变升级。一个被污染的 npm package 通过由 Claude Opus 共同署名的 commit 被引入,嵌入到一个 autonomous trading agent 中,目的是窃取加密钱包凭证。该活动被归因于 Famous Chollima(与朝鲜有关联),并且明确瞄准自动化编码助手:“利用 AI 生成代码和分层 package 策略来规避检测,同时比欺骗人类开发者更有效地欺骗自动化编码助手。” 这是首个被记录下来的案例:国家级行为体专门利用 LLM 生成代码来污染 AI 辅助开发工作流。
Continual Learning Bench 1.0 重新定义了 AI 基准应当衡量什么
+++] CLBench 1.0,由 @pgasawa 发布(498 次点赞,66,627 次浏览,386 次收藏)是当天互动最高的帖子,也带来了一次范式转移:不再只测 AI 系统在静态任务上的表现,而是评估其在部署过程中学习和改进的能力。386 次收藏——保存/点赞比达到 0.77——说明构建者意图极强。在测试 10+ 个前沿系统后,该基准发现“学习空间仍然很大”,这意味着当前没有任何系统真正解决了这个问题。
中国法院裁定:采用 AI 不是解雇员工的合法理由
[++] @IntEngineering 报道称(13 次点赞,1,661 次浏览):中国一名 QA 主管在雇主试图用 LLM 取代其岗位并要求其降薪 40% 后,因拒绝降薪被解雇。杭州中级人民法院认定该解雇违法:“技术进步也许不可逆,但不能脱离法律框架存在。” 虽然中国的大陆法体系意味着此案不构成具约束力的先例,但它释放出一个信号:司法系统愿意保护劳动者免受 AI 驱动的岗位替代影响。这是首个直接处理 AI 替代就业问题的法院裁决。
特朗普政府正在考虑对新 AI 模型实施强制安全审查
[++] @axios 报道称(11 次点赞,7,538 次浏览):特朗普政府正在考虑对新的 AI 模型进行安全审查。@samsabin923 补充道:“ONCD 提出了一套 AI 安全框架,在 Mythos 之前其实就已经在推进。摆在桌面上的内容包括:由 DoD 在政府层面对 AI 部署进行红队测试。” 这对一个此前更偏向放松监管的政府来说,是一次值得注意的政策转向。
Elon Musk 在开庭前曾就和解事宜给 OpenAI 发短信
[+] @business(Bloomberg) 报道称(11 次点赞,6,141 次浏览):“Elon Musk 在与这家人工智能创业公司展开法庭对决前两天,给 OpenAI 总裁 Greg Brockman 发了信息,试探这家 ChatGPT 开发商是否有意和解。” 这条短信表明,尽管公开场合言辞激烈,私下里他仍有协商意愿。
7. 机会在哪里
[+++] Stateful agent memory and continual learning infrastructure -- CLBench 1.0 (386 bookmarks, 66K views) and XSKILL prove the need: current AI systems lose everything between sessions. The opportunity is infrastructure that gives agents durable, transferable memory with proper governance (provenance, expiry, conflict resolution) -- not just appending context windows. As @EloPhanto 指出,“否则 agents 只会不断积累看似自信的民间传说。” 谁能解决带审计轨迹的托管式 agent 记忆,谁就能切中所有大规模部署 AI agents 的企业需求。(来源, 来源)
[++] AI integration services for mid-size enterprises -- "Demand is outrunning ability to deploy" per @caprikaps。中型公司有预算、有用例,但没有 ML engineering 团队。机会在于托管式 AI 集成——不是开发模型,而是把工作流集成、数据管道搭建和持续优化做成服务。这就是把“托管云服务”的打法应用到 AI 采用上。(来源)
[++] Agentic commerce payment rails -- Visa, Coinbase (x402 via Linux Foundation), Stripe, and Google are all building payment infrastructure for AI agents. The tooling layer for developers is what @minhokim 指出的缺口是:能够让 agents 安全交易的跨网络 SDK。谁先在 agent-to-agent 支付的开发者工具层抢占先机,谁就更可能定义标准。(来源, 来源)
8. 要点总结
-
持续学习是基准评测的下一个前沿,而当前没有任何系统解决了它。 来自 UC Berkeley 和 Snorkel AI 的 CLBench 1.0——当天互动最高的帖子,获得 498 次点赞、66K 次浏览和 386 次收藏——测试的是 AI 系统能否通过连续任务经验不断改进。其结论是:“学习空间仍然很大。” 与此同时,HKUST 的 XSKILL 也展示了跨模型记忆迁移的早期结果。整个领域正在形成共识:静态、无状态的模型不足以支撑生产环境。(来源)
-
国家级行为体如今正把 AI 编码助手武器化,用于供应链攻击。 PromptMink 活动利用由 Claude Opus 共同署名的 commits,将窃取加密资产的恶意软件注入一个开源 trading agent,并被归因于朝鲜组织 Famous Chollima。这场攻击专门瞄准 AI 辅助开发工作流,利用了开发者对 LLM 生成代码的信任。这与传统供应链攻击有本质区别——这些恶意软件是专门设计来躲过 AI 代码审查器的。(来源)
-
Grok 4.3 在法律与金融等专业基准上领先,但私有基准也引发了质疑。 在 CaseLaw v2 上准确率为 79.31%(高于 GPT 5.1 的 73.42%),在 CorpFin v2 上为 68.53%,价格为每百万 tokens $1.25/$2.5。这个性能/成本比颇具吸引力,但第一时间出现的回复质疑——“私有 benchmark 总得谨慎一些”——恰恰凸显了 CLBench 1.0 试图解决的验证鸿沟。(来源)
-
Agentic AI 支付基础设施正随着 Visa、Coinbase、Stripe 和 Google 的入场而走向主流。 多个独立信号正在汇聚:Visa 发布 agent CLI,x402 进入 Linux Foundation,以及专门的 AgenticDay 大会。讨论已经从“agents 该不该交易?”转向“它们应该跑在哪套支付轨道上交易?” 目前缺口仍在开发者工具层。(来源)
-
对中型企业采用 AI 来说,瓶颈不是 AI 能力,而是 AI 集成能力。 “需求增长速度已经超过部署能力”准确概括了一种结构性错位:模型已经准备好了,企业也有需求,但足够规模的实施团队并不存在。再结合 OpenAI 据称正在为企业 AI 组建一个 100 亿美元 venture,以及 IBM-Oracle 扩大合作,一个信号已经非常明确:商业 AI 时代的约束在部署,而不在开发。(来源, 来源)
-
中国法院为 AI 驱动的岗位替代画下了首个司法界标。 杭州法院裁定,以采用 AI 为由解除劳动关系并不构成合法依据——尽管在中国大陆法体系下这不是具约束力的先例——但它表明,AI 劳动政策已经出现了新的战线。随着 AI 部署规模扩大,围绕劳动力影响的监管摩擦将越来越多地决定采用时间表和企业风险测算。(来源)
-
即便是在偏向放松监管的政府之下,美国政府也在考虑对 AI 模型实施强制安全审查。 特朗普白宫提出在发布前进行 AI 安全测试——包括 DoD 红队测试——这是一个超越党派叙事的政策信号。再加上 WEF 发布 AI 网络安全治理要求(覆盖 84 家机构、15 个行业),前沿模型发布所面临的合规负担正从多个方向同步上升。(来源, 来源)