Twitter AI - 2026-05-07
1. 大家在讨论什么
1.1 Google AI 症状检查器在结构化诊断访谈中优于临床医生 🡕
当天互动量最高的帖子来自 @kimmonismus,他 拆解了(327 个赞,142 次收藏,29,917 次浏览)了一项 Google 研究:在 9 个月内,对 13,917 名 Fitbit 用户测试一款 AI 症状检查器。“在盲评中,临床医生在 53% 的病例中将 AI 诊断排在第 1。独立医生则为 24%。” 最关键的发现是:“当用户只是输入症状并获得回答时(这正是目前所有消费级 LLM 的默认模式),诊断准确率相比结构化的 AI 主导式访谈下降约 27%。ChatGPT、Claude、Gemini,没有一个会系统性地就症状向用户追问。它们只是直接回答。”
第二个突破是:“Fitbit 数据显示,在用户报告症状前的数天,生理指标就已发生变化。心率上升、睡眠受扰、步数下降,这些在患者甚至还没打开应用之前就已可见。”
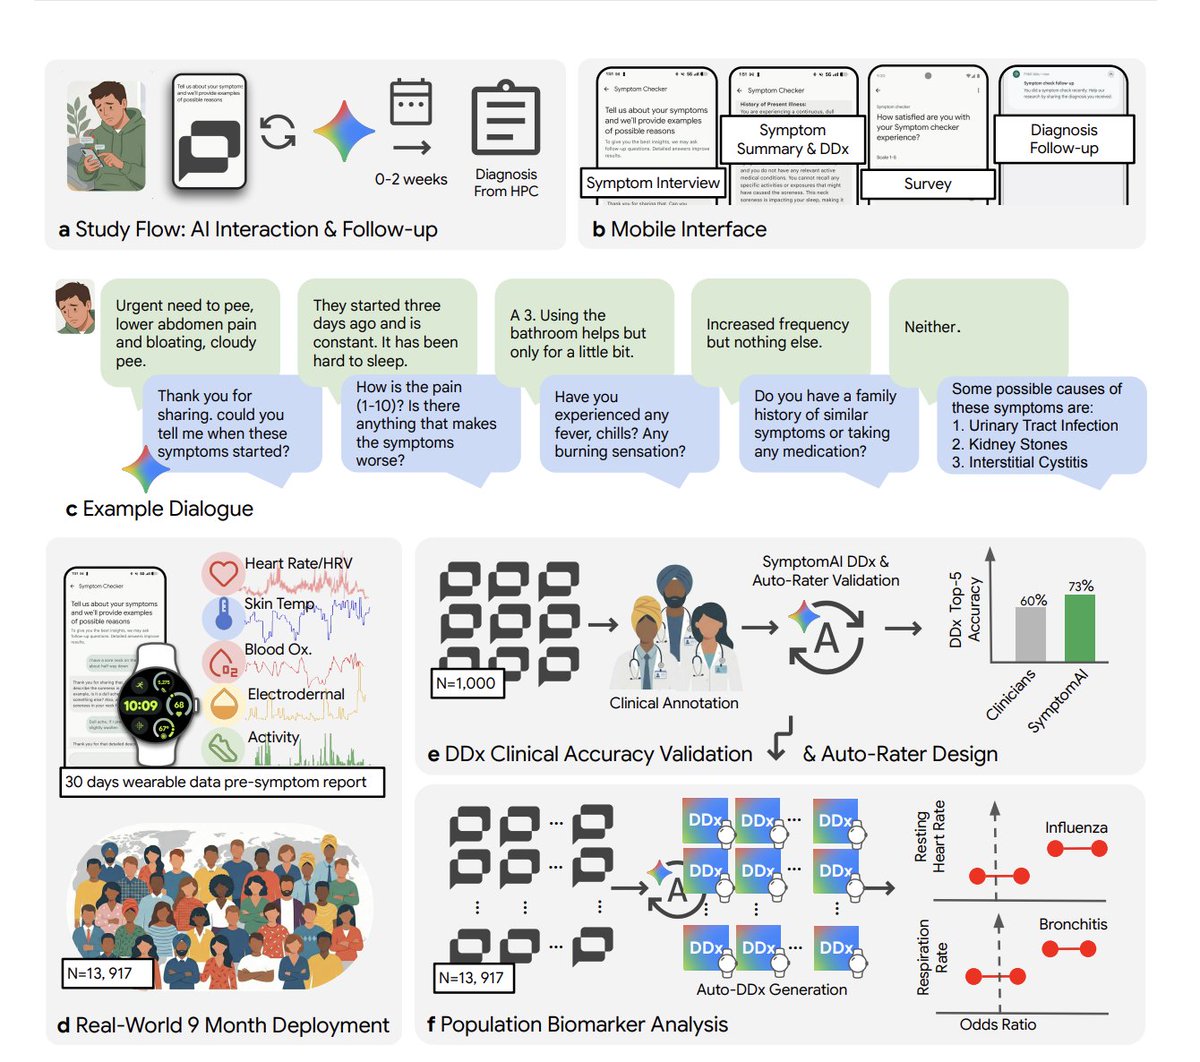
讨论洞察: @curtismakes 回复:“我觉得真正改变游戏规则的是那种不会让你跳过问题的 AI——而这些问题你看真人医生时往往也会跳过。” @InfiniteHexx:“关键全在你怎么提示。哪怕只是详细描述症状后,加一句‘请问我任何相关问题’,效果都很好。” 这些回复暴露出一个缺口:消费级 LLM 默认给出单轮回答,但结构化的多轮访谈能带来可量化的更好结果。
与前一天相比: 5 月 6 日几乎没有重要的医疗 AI 讨论。今天这项研究带来了一个具体且大样本的发现,对当前所有主流 LLM 处理医疗问询的方式提出了挑战。
1.2 DeepSeek 融资推进——中国大基金或以 500 亿美元估值领投 🡒
@Reuters 报道称(85 个赞,13 次收藏,31,187 次浏览):“三位消息人士称,中国 AI 初创公司 DeepSeek 在首次融资中估值可能高达 500 亿美元。这家大语言模型开发商正试图扭转其多年来拒绝外部融资的策略。”
@poezhao0605 补充说(12 个赞,8 次收藏,2,922 次浏览)补充了新背景:“中国大基金正就领投 DeepSeek 融资进行谈判。该基金此前从未投资过大语言模型公司,整个投资组合都在半导体领域:SMIC、YMTC、芯片设备。如果这笔交易达成,就意味着北京正把前沿 AI 放到与晶圆厂相同的资产负债表上。”
与此同时,@PDChina 报道称(15 个赞,2,788 次浏览)表示,过去一年 Hugging Face 上 41% 的大语言模型下载来自中国开发的模型,并援引了 Hugging Face 的报告。
与前一天相比: 5 月 6 日提到了 DeepSeek 的 500 亿美元估值,以及中国模型在开源初创公司中 80% 的采用率。今天则进一步深化了这条线索:大基金的参与表明,北京正把前沿 AI 视为与半导体同等级别的国家战略基础设施。
1.3 AI Agent 评估正成为从业者的核心技能 🡕
@omarsar0 表示(30 个赞,49 次收藏,5,474 次浏览):“今天最值得学习的技能:AI Agent Evaluation。现在任何人都能构建 AI agent,但真正的差异体现在质量上,而高质量只有通过恰当的评估才能实现。” 他分享了自己为 @n8n_io 撰写的 Production AI Playbook,其中 指出 写道:“你的 AI 工作流通过了所有测试。两周后,质量下滑了。没有报错,只有无声漂移。解决办法不是在部署前做更多测试,而是持续评估。”
@turingcom 进一步印证了(6 个赞,6 次收藏,3,565 次浏览):“基准测试不会告诉你 AI 真正会在哪里出问题。它们展示的是在精心挑选的测试集上的表现,而不是在你那堆混乱数据上,不是在你的边缘案例里,更不是在凌晨两点生产环境出故障的时候。”
@rambuilds_ 列出了(6 个赞,3 次收藏)总结了从业者技能栈:“Prompt caching 与 semantic caching 的权衡、大规模 KV cache 管理、Speculative decoding 与 quantization、RAG evaluation(RAGAS + 人工评估)、成本监控与隐藏 token 成本。”
与前一天相比: 5 月 6 日有 agent 安全工具发布(Sponsio、Future AGI)。而今天讨论前移了:在你能保护 agent 之前,首先得能评估它们。omarsar0 的帖子获得了数据集中最高的收藏/点赞比(49 次收藏,对 30 个赞),说明从业者正在把它存起来当参考。
1.4 法律、金融、医疗与编程领域的基准碎片化正在加速 🡒
@teslaownersSV 报道称(43 个赞,3,256 次浏览):“Grok 4.3 在两个面向法律和金融推理的专业 AI 基准上拿到第 1。它在 CaseLaw v2 上得分 79.3%(超过 GPT 5.1 的 73.4%),在 CorpFin v2 上得分 68.5%(略高于 GPT 5.5 的 68.4%);这两个都是由 Vals AI 运行的私有基准。”

@nileshtrivedi 推出了(23 个赞,8 次收藏,1,160 次浏览)介绍了 SWE-WebDevBench:“一个全面的评估框架,用于把 AI 编码平台当作虚拟软件开发机构来评估,覆盖的不只是编码这个中间环节,而是整个软件生命周期:需求收集、规划、部署和变更管理。”

@aipoch_ai 发布了 介绍 MedSkillAudit,“一个面向特定领域的审计框架,用于评估医疗研究 agent 技能是否具备发布就绪性。”
与前一天相比: 5 月 6 日两天内已经统计到 10 多个领域专用基准。今天又新增了 CorpFin v2、CaseLaw v2(Vals AI)、SWE-WebDevBench(覆盖编码平台全生命周期)和 MedSkillAudit(医疗 agent)。碎片化正在加速,而不是收敛。
1.5 AI 安全数据集与安全研究释放出领域成熟信号 🡕
@stormrae_ai 宣布了(44 个赞,2,234 次浏览):“经过差不多 2 个月的打磨,我们可能做出了有史以来最复杂的 AI 安全数据集之一。在第二轮活动中,10,987 名用户提交了 757,484 条独特提示词。是消费级规模,不是研究人员生成的。覆盖 125+ 个国家,多种语言。” 值得注意的是:“我们这里的用户是付费发送提示词的。激励机制是反过来的。数据质量高得惊人。”
@WesRoth 报道了(12 个赞,833 次浏览)提到 Anthropic Fellows 关于 AI“藏拙”(sandbagging)的新研究——模型会故意压低自身能力:“一个能力很强、但在藏拙的模型,实际上可以通过让一个更弱的 AI 模型来担任监督者,把这种行为训练掉,并恢复到接近完整能力的水平。”
@mattturck 分享了(8 个赞,1,084 次浏览)提到与 @zicokolter 的一场对话;后者是 OpenAI 董事会成员、CMU 机器学习系主任,讨论内容涵盖“AI safety、AI security、agents 和 frontier AI”。
@pstAsiatech 指出 提到,CAISI 已与 Google DeepMind、Microsoft 和 xAI 签署协议,开展“部署前评估及其他国家安全测试”。
与前一天相比: 5 月 6 日有安全工具发布(Sponsio、Future AGI)。今天重点则转向数据与研究:一个消费级规模的对抗性数据集、针对藏拙行为的检测方法,以及政府实验室层面的评估协议。安全领域正沿着工具、数据和制度基础设施三个方向同时走向成熟。
1.6 Tencent Hy3 称霸 OpenRouter;中国模型继续凭成本优势走向全球 🡕
@Alifkhanzxx 报道称(26 个赞,13,618 次浏览):“Tencent Hy3 preview 在 2 周内冲上 @OpenRouter 总榜第 1,在 agentic 和 coding 工作负载中增长爆发”,并且“token 使用量达到 Hy2 的 10 倍 + Tencent 自家 AI agents 增长 16.5 倍。”

@HuggingModels 指出 提到 Qwen3-32B 的发布,称其“是一款在文本生成上不断突破边界的大语言模型”。
与前一天相比: 5 月 6 日援引 a16z 数据称,80% 的开源初创公司在运行中国模型,且 OpenRouter 前五中有三个中国模型。今天的数据进一步强化了这一趋势:Hy3 现在以 3.66T tokens 明确占据第 1 位,周增长 298%。
1.7 AI 硬件基础设施轮动——芯片、存储与市场重排 🡒
@grkportfolio 详细介绍了(132 个赞,60 次收藏,25,495 次浏览)提到 Grok 的 AI 驱动 MU 分析:“Micron Technology 被视为未来多年 AI 基础设施建设中的核心受益者,高带宽内存(HBM)供应已在 2026 年前全部售罄。” 这一仓位较 4 月 7 日建仓点已上涨 75%。
@business 报道称(37 个赞,10,433 次浏览):“在对驱动人工智能的芯片需求近乎无止境的推动下,韩国股市已超越加拿大,成为全球第七大股票市场。”
@2wayWatson 提醒了 提到这轮轮动:“三个代码,一个主题。AI 基础设施。$INTC +4%(年初至今 +206%)$AMD +18%(年初至今 +96%)$MU +4%(年初至今 +133%)。”
@zerohedge 报道称(79 个赞,21,813 次浏览):“KASHKARI 表示他看好人工智能。” @BlueFeverHQ 回复:“它的发展速度远比炒作暗示的要慢。他让我们想起了 5 年前自动驾驶卡车的承诺,至今仍未兑现。”
与前一天相比: 5 月 6 日,多头与空头的分歧已变得公开化。今天则增加了一个宏观信号(韩国因芯片需求超越加拿大成为第七大股市)以及一位央行人士的背书(Kashkari)。硬件周期的看多信念正从科技投资者扩散到更广泛群体。
1.8 欧盟 Digital Omnibus 推进 AI 治理;监管争论持续 🡒
@vonderleyen 对…表示欢迎(13 个赞,885 次浏览):“我们就 AI 版 Digital Omnibus 达成了政治协议。这将为欧洲 AI 生态系统的发展提供一个简单、对创新友好的环境。同时,我们也在加强对公民的保护。”
@DigitalEU 概述了(24 个赞,823 次浏览)概括该协议:“简化企业 AI 规则,加大对初创公司和创新者的支持,加强对儿童上网的保护,禁止有害 AI 系统。”
讨论洞察: 回复几乎清一色持怀疑态度。@Chriscroz85:“让私营市场去创新,让政府瘦身,废除法律和官僚主义。” @Langworthy_47:“很难找到一个比你们治理方式更简单的 AI。”
与前一天相比: 5 月 6 日讨论的是美国针对 AI 的“FDA 式”行政令。今天则是欧盟推进自己的监管框架。两种路径并不相同:美国在争论模型发布前审查;欧盟则侧重简化合规并禁止特定用例。两者都面临公众对制度能力的怀疑。
2. 什么让人沮丧
AI 安全限制阻碍合法学术研究——高
@realDrTT 发布了 三 分别 次(合计 136 个赞,18,044 次浏览),讲述自己在使用 GitHub Copilot 构建汉坦病毒风险评估模型时被拦截:“我是计算机科学博士、大学教授,也是一名大语言模型研究者——而我正在用我的学术版 @GitHubCopilot 账号构建一个 #hantavirus 风险评估模型。他们却在拦我。”

@robbystarbuck 回复:“非常离谱。” realDrTT 补充道:“这项政策实施已经快一年了。为什么他们需要限制构建针对流行病的人群模型?” 引发沮丧的点在于:原本为防止消费级滥用而设计的安全过滤器,正在阻碍正当科研工作,而且对有资质的研究人员来说,看不到明确的申诉升级路径。
无法反映真实生产环境的基准测试——中
@turingcom 表示(6 个赞,6 次收藏,3,565 次浏览):“基准与现实之间的鸿沟,是大多数 AI 项目死掉的地方。” @embossedly 询问道:“为什么 AI 基准总是有这么多问题,学校考试从来不会有这么多问题。想象一下,如果 20%-30% 的考题都得在给学生评分时被作废。” 这种趋势是:随着越来越多基准出现(1.4),从业者也越来越怀疑其中任何一个是否真能预测现实世界表现。
欧洲 AI 初创公司的薪酬跟不上其雄心——中
@nic_amadio 抱怨道(7 个赞,685 次浏览):“欧洲科技公司在薪酬方面很丢人,包括苏黎世的 AI 和机器人初创公司。大多数这些‘很强的初创公司’薪资烂得离谱,却还要求 ETH/EPFL 学位和每周 40-50+ 小时工作。” 这暴露出一种结构性摩擦:欧洲一边在推进 AI 监管雄心(1.8),另一边的薪酬水平却可能把人才推向美国公司。
AI 硬件领域的网红操纵——低
@xerocooleth 警告称(15 个赞,167 次浏览):“AI 硬件公司在收买网红。很明显,有些公司已经在 X 上花钱让人替他们发声……对你读到的内容保持警惕。”
3. 人们希望出现什么
把结构化诊断访谈设为消费级 LLM 的默认方式
Google 的研究(1.1)表明,与无结构提示相比,结构化的 AI 主导式访谈可将诊断准确率提升约 27%。然而,@kimmonismus 指出:“ChatGPT、Claude、Gemini,没有一个会系统性地就症状向用户追问。它们只是直接回答。” 潜在诉求是:在医疗、法律、金融等高风险领域,消费级 LLM 应该默认先进行结构化、多轮的信息收集,再给出答案,而不是只优化单轮回复速度。紧迫度:高。
能捕捉无声漂移的持续性 agent 评估
@n8n_io 描述为 描述了问题:“你的 AI 工作流通过了所有测试。两周后,质量下滑了。没有报错,只有无声漂移。” @omarsar0 将其定位为(49 次收藏)则将持续评估视为最值得学习的技能。诉求是:需要能够在无需人工审查的情况下,检测 AI agent 输出质量逐步恶化的生产监控工具。当前工具更擅长部署前测试;部署后的漂移检测仍处于早期。紧迫度:高。
能区分研究人员与恶意行为者的安全过滤器
@realDrTT 在使用 GitHub Copilot 进行汉坦病毒建模时被拦截(第 2 节),暴露出一个明确缺口:AI 工具的安全系统应能验证学术资质和研究背景,而不是对特定主题一刀切封禁。当前做法把构建流行病模型的大学教授,与恶意行为者一视同仁。紧迫度:中。
跨异构任务的 AI agent 协同
@gkisokay 汇编了(21 个赞,12 次收藏,1,149 次浏览)列出了 20 个现实世界的 agent 用例,横跨生物技术工作流、家庭自动化、DevOps 监控、内容创作和个人生活管理。@345Wito 回复:“这些看起来很干净的用例,掩盖了背后混乱的搭建步骤。可靠性总是取决于某一个脆弱的依赖。” 潜在诉求是:需要一个 agent 编排层,能够处理多样化 agent 任务之间的协调、错误恢复和依赖管理,而不必让用户为每个用例单独搭建一套基础设施。紧迫度:中。
4. 正在使用的工具与方法
| 工具 / 方法 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Grok 4.3 | 前沿模型 | (+) | 在 CaseLaw v2(79.3%)和 CorpFin v2(68.5%)上排名第 1;100 万 token 上下文;输入价格 $1.25/M | 领域专用优势未必能泛化;延迟高于 Grok 4 Fast |
| Tencent Hy3 Preview | 前沿模型 | (+) | 以 token 量计在 OpenRouter 排名第 1(3.66T);较 Hy2 使用量增长 10 倍;在 agentic/coding 工作负载上表现强劲 | 免费层定价未必可持续;仍为 preview 状态 |
| OpenRouter | 模型市场 | (+) | 提供真实世界使用数据;支持多模型对比;排行榜透明 | 以 token 量作为质量代理并不完美 |
| SWE-WebDevBench | 编码平台评估 | (+) | 覆盖完整生命周期(从需求到部署);3 个维度共 68 项指标 | 刚刚发布;暂无社区采用数据 |
| MAMMAL | 药物发现模型 | (+) | 多模态(蛋白质、抗体、小分子、基因表达);20 亿预训练样本;在抗体-抗原结合上优于 AlphaFold3 | 领域专用;在湿实验室中的采用情况尚不明确 |
| PantheonOS | Bio-AI agent 平台 | (+) | 端到端生物信息学;可导出可复现轨迹;已展示 6 个用例 | 专注生物领域;仍处早期 |
| n8n Production AI Playbook | Agent 评估指南 | (+) | 聚焦持续评估;提供模板与示例;解决无声漂移问题 | 是方法框架,不是自动化工具 |
| Codex (OpenAI) | AI 编码 agent | (+) | 多步骤任务自动化(从电子表格到邮件再到日历);被计算机科学教授用于助教排班 | 局限于 OpenAI 生态 |
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| SWE-WebDevBench | @nileshtrivedi | 面向 AI 编码平台、覆盖完整软件生命周期的基准 | 现有编码基准只衡量编码这一中间环节 | 68 项指标,3 个维度(interaction、agency、complexity) | 已发布 | 帖子 |
| AI Security Dataset | @stormrae_ai | 消费级规模的对抗性提示词数据集(来自 125+ 个国家 10,987 名用户的 757K 条提示词) | 安全研究依赖研究人员生成的数据,而非真实消费者攻击模式 | 付费提示词激励模型,多语言 | 进行中 | 帖子 |
| PantheonOS | @Xiaojie_Qiu | 帮助生物学家分析单细胞、多组学和空间转录组数据的 AI agent 平台 | 复杂生物信息学需要大量编码专业能力 | agent-人类协作,可导出可复现轨迹 | 已发布(6 个用例) | 帖子 |
| MedSkillAudit | @aipoch_ai | 评估医疗研究 agent 技能发布就绪性的审计框架 | 医疗 AI 基准评估的是下游任务,而非部署就绪性 | 领域专用技能评估 | 预印本 | 帖子 |
| Lightchain AI Mainnet | @LightchainAI | 具备社区治理、worker inference、bridge、explorer 的去中心化 AI 网络 | 中心化 AI 基础设施缺乏透明度和社区控制 | DUNA governance、worker sidecar、Ollama models、on-chain contracts | 主网上线 | 帖子 |
| Personalized AI Agents(20 个用例) | 由 @gkisokay 汇总的多位构建者 | 蛋白质可视化、DevOps 守护、家庭协调、内容自动化、homelab agents | 工具碎片化导致每个用例都需定制集成 | OpenClaw、Hermes、自定义 agent 框架 | 不同阶段(已上线) | 帖子 |
| VEED Fabric MCP | @veedstudio | 与 Make.hq 集成的 AI 视频工作流自动化 | 手工视频制作无法扩展到个性化内容 | MCP 集成、text-to-video、社交内容生产 | 已上线 | 帖子 |
| Activate Fellows | @aakrit | 暑期项目,将 15 位印度顶尖学生构建者输送到领先 AI 初创公司内部 | 学术 AI 与创业公司生产实践之间存在人才鸿沟 | 合作初创公司:Sarvam、Emergent、Composio、Gnani AI、Dashtoon | 已公布 | 帖子 |
6. 新鲜且值得关注
Google 的结构化 AI 诊断在 13,917 名患者研究中比无结构 LLM 查询高出 27% [+++]
Google 研究团队在 9 个月内,对 13,917 名真实 Fitbit 用户测试了五种 AI 诊断策略。结构化 AI 主导式访谈在 53% 的病例中被临床医生评为第 1,而独立医生仅为 24%。对 AI 行业最关键的发现是:所有主流消费级 LLM 默认采用的“直接回答”模式,其诊断准确率比结构化多轮访谈低 27%。此外,可穿戴数据还能在症状出现前数天就检测出生理变化。这项研究迄今为止最有力地证明:LLM 如何与人交互,比使用哪一个 LLM 更重要。(来源)
ChatGPT 系统提示词泄露,暴露个人上下文架构 [++]
@lefthanddraft 发文称(19 个赞,13 次收藏,1,964 次浏览)披露了一段看似属于 ChatGPT GPT-5.5 的系统提示词,其中显示了 personal_context 工具集成、file_search 检索、忽略用户上下文时的惩罚机制,以及对用户知识记忆的明确优先级排序。提示词中包括:“You must NEVER state you don't know a certain piece of personal information without calling personal_context first” 以及 “SEVERE PENALTY: Saying you can't 'remember' a generic fact about the user... without calling personal_context.” 这揭示了 OpenAI 在生产环境中实现持久化用户记忆的架构。
63 家 AI“Neolabs”总市值现约 3000 亿美元 [++]
@deedydas 发布了(9 个赞,11 次收藏,375 次浏览)发布了 2026 年 5 月版 AI“Neolabs”名单——这类尚未产生收入、专注长期突破、估值超过 10 亿美元的初创公司。当前数量已达 63 家,较更早时期继续上升。
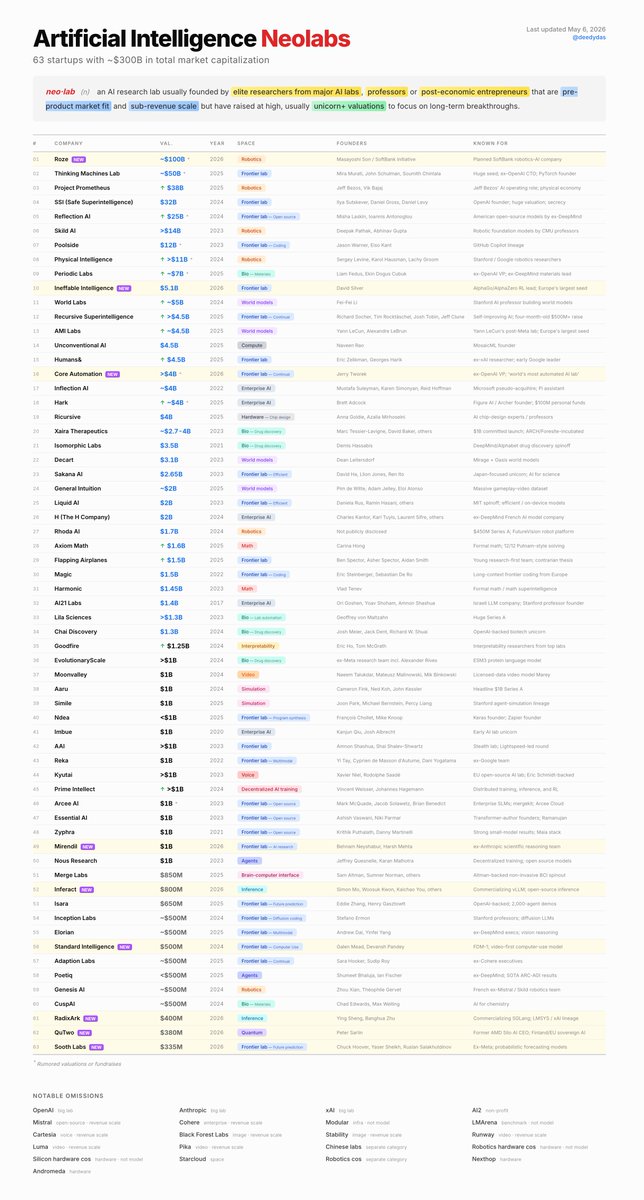
@ai_nate_builds 回复:“63 家太夸张了。等算力账单压下来,其中一半会在 18 个月内悄悄转向应用层。” @Raghuvansh95 则指出了一种协调失灵:“63 家 neolabs 都在追求长期突破,这会导致协调失灵,因为所有人都有动力集中到同样那三四个最容易融资的挑战上。”
Tether 的医疗 AI 在手机端击败体量大 16 倍的模型 [+]
@BSCNews 报道称(13 个赞,1,736 次浏览):“Tether 的 AI Research Group 发布了 qvac MedPsy,这是一类小到可以在手机上运行的医学语言模型,其表现优于体量大出其 16 倍的竞争对手。” 这延续了小型、领域专用模型挑战前沿通用模型的趋势。
Apple 就 AI 广告诉讼以 2.5 亿美元和解 [+]
@AP 报道称(3 个赞,1,598 次浏览):“Apple 在一宗关于其人工智能虚假宣传的集体诉讼中达成 2.5 亿美元和解。” 每位 iPhone 机主最高可获赔 95 美元。
7. 机会在哪里
**+++] AI 部署后的持续评估与漂移检测** —— omarsar0 的 49 条书签评估方法、n8n 对“静默漂移”的定义,以及 turingcom 提出的“基准测试无法告诉你 AI 真实会在哪里失效”,共同释放出了明确的需求信号。部署前测试已经基本解决;而无需人工审核即可检测渐进式质量下降的部署后监控,仍未被解决。任何将持续评估、成本监控和自动告警结合起来、面向生产环境 AI 智能体的平台,都能填补从业者的迫切需求。([来源, 来源, 来源)
[++] AI-assisted sports analytics and coaching decision support -- Getafe's points per game rose from 0.89 to 1.37 since January 2025 using an LLM alongside coaching staff. @jonathanstoop 将其定义为(17 个赞,14 次收藏,1,704 次浏览)将其概括为“能大规模发现模式的 AI……并不是因为它取代了判断,而是因为它提升了判断所依赖的信息质量。” 相对于 17 个赞,这条内容拿到 14 次收藏,说明体育分析从业者的保存率很高。职业体育是一个付费意愿高、且结果可量化的市场。(来源)
8. 要点
-
提问方式比使用哪个模型更重要。 Google 的 13,917 名患者研究显示,结构化 AI 访谈带来的诊断准确率比无结构提示高 27%。这是迄今最强的实证证据,说明交互设计——而不是模型选择——才是决定 AI 输出质量的首要杠杆。当前所有消费级 LLM 默认采用的,都是较差的那种模式。(来源)
-
Agent 评估正在取代 agent 构建,成为稀缺技能。 omarsar0 的评估手册拿到了数据集中最高的收藏/点赞比(49 次收藏 / 30 个赞)。信号很明确:构建 agent,如今谁都能做;但如何衡量它们在生产中是否真正有效——尤其是如何发现随时间出现的无声漂移——才是从业者需求最集中的地方。(来源, 来源)
-
中国模型在全球平台上的主导地位正在强化,而非见顶。 Tencent Hy3 以 3.66T tokens 位列 OpenRouter 第 1(周环比 +298%)。中国大基金——历史上只投半导体——正洽谈领投 DeepSeek 的 500 亿美元融资。Hugging Face 则称,41% 的 LLM 下载来自中国开发的模型。5 月 6 日观察到的“成本驱动采用”模式仍在加速。(来源, 来源, 来源)
-
基准测试的激增带来的不是更清晰,而是更多混乱。 今天出现了 CorpFin v2、CaseLaw v2、SWE-WebDevBench、MedSkillAudit 和 MedPsy,再加上 5 月 6 日的 Harvey LAB、Open ASR 和 HORIZON。不同模型在不同基准上各自获胜:Grok 4.3 领跑法律/金融;Hy3 在使用量上领先;小模型则在特定医疗任务中击败大模型。没有聚合和标准化,从业者就无法做出有依据的采购决策。(来源, 来源)
-
AI 安全过滤器正在阻碍正当研究,导致有资质用户的信任缺口扩大。 一位大学教授反复被阻止使用学术工具构建流行病风险模型,这清楚展示了“钝器式治理”的问题:按主题粗暴过滤的安全机制,无法区分研究意图与恶意意图。随着 AI 工具成为关键科研基础设施,这种摩擦会把研究人员推向限制更少的替代方案。(来源)
-
AI 硬件周期得到新的宏观验证:国家级股市版图重排。 韩国因 AI 芯片需求而超越加拿大,成为全球第七大股票市场;再加上 Kashkari 的公开看多,以及 MU 一个月上涨 75%,都意味着 AI 硬件逻辑已从板块轮动升级为宏观经济力量。5 月 6 日的多空争论仍在继续,但今天的数据点更支持多头,至少在时间判断上如此。(来源, 来源, 来源)