Twitter AI - 2026-05-09
1. 人们在讨论什么
1.1 廉价、开放且与中国相关的模型栈,正被塑造成务实部署的默认选择 🡕
眼下最清晰的宏观叙事,已不再只是“谁的基准成绩最好”,而是“谁拥有团队真正能部署、微调,并以规模化方式持续运行的最低成本模型栈”。
@SputnikInt 认为称,Kimi K2.6 的 token 成本仅为顶尖西方模型的 1/6 到 1/8,Qwen 的开源下载量已超过西方竞争对手,而本地微调也让中国模型在那些更看重可负担性而非前沿声望的市场里更具吸引力。@Just_sharon7 表示称,腾讯的 Hy3 Preview 在两周内登上 OpenRouter 第一,token 使用量达到 Hy2 的 10 倍,腾讯自家 agent 应用的总使用量则增长了 16.5 倍。商业化角度也同样清晰:阿里云的 Model Studio 页面 现已将 HappyHorse 1.0 与 Qwen3.6-Plus、Qwen3-Coder-Next 一并作为可直接使用的产品出售。
讨论洞察: 回复和相关帖子大致分成两派。一派认为,价格、吞吐量和本地微调构成了决定性的分发优势;另一派则担心,地缘政治信任、监管和平台依赖等问题仍未解决。
与前一日对比: 5 月 8 日的讨论已偏向更便宜、更可控的模型栈。到了 5 月 9 日,这一点被进一步提炼成更明确的判断:即便西方仍在高端模型的声望上占优,低成本开放模型生态也可能凭借更强的可部署性取胜。
1.2 对齐与评测工作正变得更实证,也更具领域针对性 🡕
最强的研究信号并不是又一个关于安全的新口号,而是一系列帖子显示,更好的结果正来自更好的数据、更好的测量,以及更审慎的评测设计。
@AnthropicAI 报道称称,在高质量宪法式文档以及描写“对齐良好的 AI”的虚构故事上训练后,agentic misalignment 降低了三倍以上。Anthropic 在后续回复中表示,这些提升与其说来自对狭窄场景的匹配,不如说是因为模型学会了为何失调行为是错误的。@burkov 总结称提到 Google DeepMind 的论文《大规模高效探索》(“Efficient Exploration at Scale”),文中声称一种在线 RLHF 方法用不到 20K 个标签,就达到了使用 200K 个标签训练的离线 RLHF 的效果,而且预计在更大规模下收益会更高。@emollick 补充道则提出了一个务实的基准问题:与机器人相比,AI 的进展相对容易追踪;在机器人领域,炫目的演示视频依然无法回答系统是否能在无人监督下运行,也无法支持不同实验室之间的可复现比较。
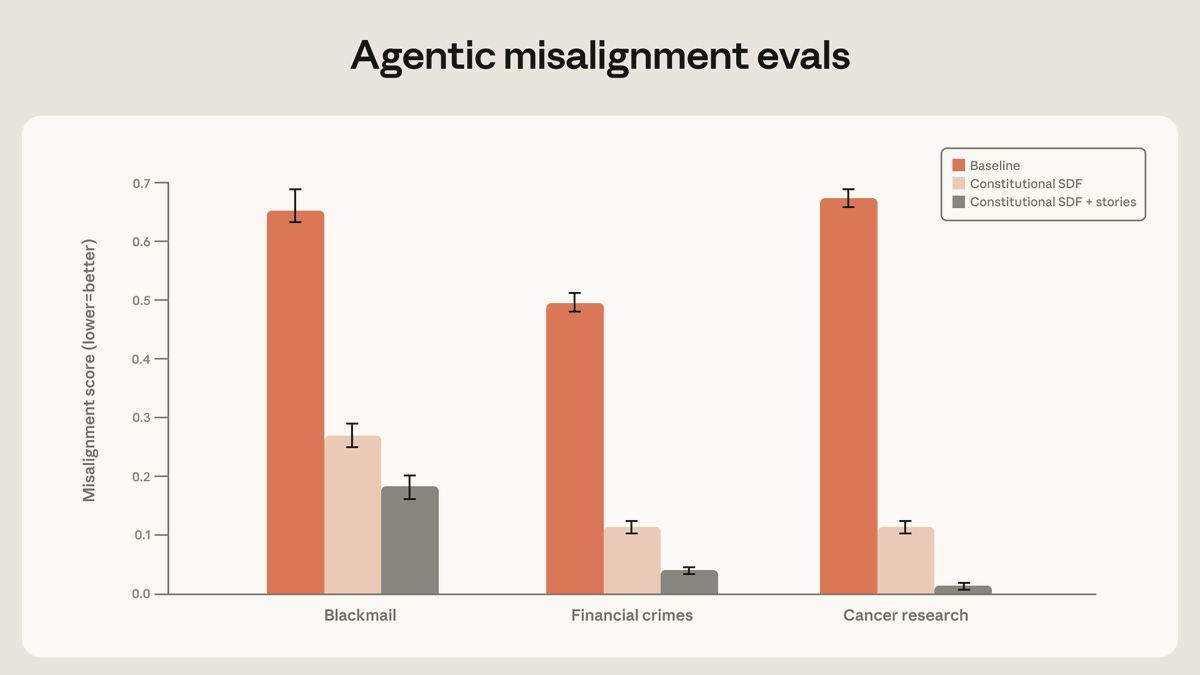
讨论洞察: 关于基准测试的争论正在扩展。如今,仅展示模型能完成一个玩具任务已经不够;从业者越来越希望评测能够回答:系统是否会因更好的训练数据而提升,能否迁移到训练场景之外,以及在没有持续监督的情况下是否值得信任。
与前一日对比: 5 月 8 日强调的是基于故事的对齐和更便宜的 RLHF。5 月 9 日则延续这条主线,并把讨论推进到基准设计本身,尤其是机器人和其他具身系统的评测。
1.3 AI 正越来越被当作一场资本开支、利润率与供应链竞赛来讨论 🡕
如今的 AI 讨论,听起来往往不像在探索产品,反而更像在做产业规划。主导性问题变成了:推理到底有多贵、谁有能力为算力扩张融资,以及当前的单位经济模型能否承受更广泛的自主化。
@Bencera 表示称,Polsia 只有一位创始人、零员工,却已达到 850 万美元年化收入;但由于用户不断要求在更复杂的代码库中实现更高程度的自主性,公司单月 Anthropic 账单也被拉高到 100 万美元。@thdxr 提出则从更宏观的视角审视 AI 基础设施融资,指出 Nebius 融资 40 亿美元,放在 Google 所说的 1800 亿到 1900 亿美元年度支出面前,依然显得很小。@JesseCohenInv 链接到把韩国股市上涨与 AI 芯片需求联系起来,这再次表明,如今 AI 的叙事越来越通过硬件、电力和市场结构效应来展开,而不只是模型演示。
讨论洞察: 对 Polsia 那条帖子的最尖锐回复称,这种商业模式看起来像是在“用 75 美分卖 1 美元”。这很好地概括了人们的不安。对自主性的需求似乎确实存在,但信息流总会回到同一个问题:当前的定价和基础设施投入,是否真能支撑它。
与前一日对比: 5 月 8 日更多关注廉价、开放的基础设施如何构成产品优势。到了 5 月 9 日,视角进一步拉远到资产负债表层面:AI 越来越被框定为一场资本与供应链的竞争。
1.4 AI 采用正被整理成围绕可见度、工程和产品设计的明确打法 🡕
另一个反复出现的主题是运营化。人们发布的不再只是“AI 能做 X”的帖子,而是具体打法:团队该如何组织工程工作、如何在各类助手中被发现,以及如何设计出用户真正能够信任的 AI 产品。
@alexgroberman 认为称,按不同来源统计,ChatGPT 占 AI 引荐流量的 65% 到 87%;如果品牌不在检索池里,就永远进不了 AI 系统为买家整理的三到五项候选清单。他的帖子还指出,同一品牌在一个平台上的引用率可能只有 0.59%,在另一个平台上却能达到 27%,这使 AI 可见度不再只是品牌建设的附属问题,而成了一个运营问题。@_avichawla 分享了介绍了一份“全栈 AI 工程路线图”,涵盖提示工程、RAG、agents、部署、优化、可观测性和上下文工程。@AdhamDannaway 强调了则把 Google 的 People + AI Guidebook 当作一份实用清单,覆盖用户需求、反馈与控制、可解释性、评估以及优雅失败。
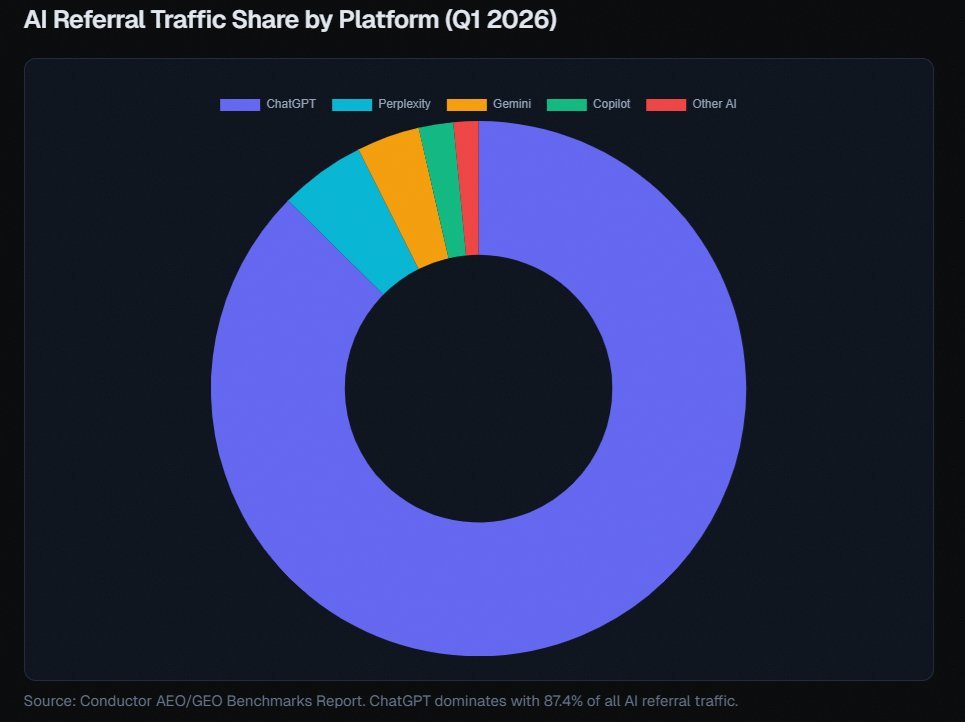
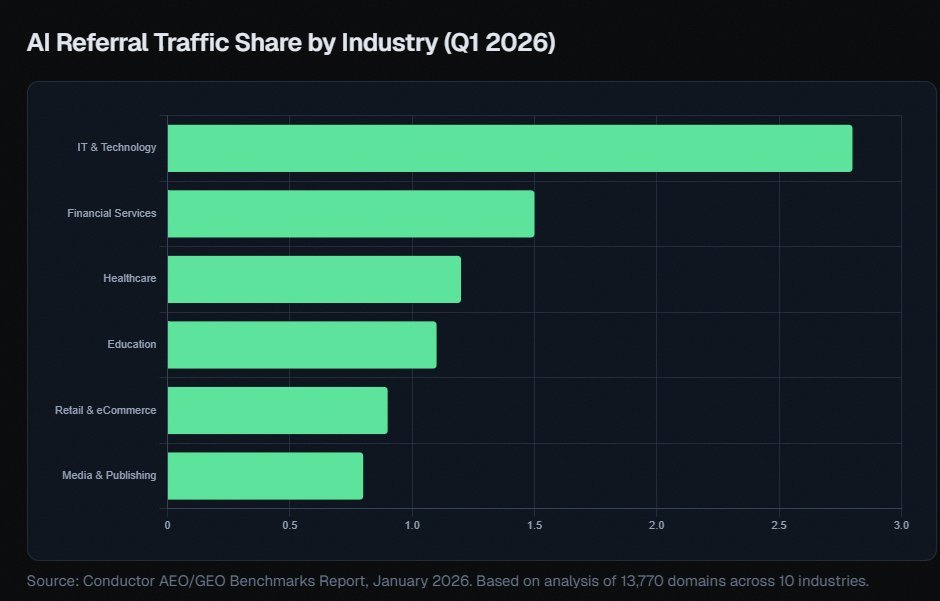
讨论洞察: 这些帖子把 AI 当作一种运营纪律,而不是一场炫技秀。真正的问题不再是 AI 是否存在,而是团队如何对它做监测、如何部署、如何获得引用,以及如何让用户看得懂。
与前一日对比: 5 月 8 日更多聚焦医学、娱乐等领域用例。5 月 9 日则转向落地机制:可见度、可观测性、工程范围,以及以人为本的设计。
2. 什么让人感到挫败
自主性的发展速度正在超过 AI 的单位经济模型
最具体的痛点来自 @Bencera,他表示,Polsia 对自主性的需求增长,最终在一个月内带来了 100 万美元的 Anthropic 账单。@thdxr则在市场层面让同样的挫败感变得清晰:即便是数十亿美元级别的基础设施融资,和超大规模云厂商的支出相比也仍然显得很小。严重程度:高。当前的应对办法是转向更便宜的开放模型、提高 GPU 效率,并寻找替代供应商,而不是假设默认托管路径会一直负担得起。
AI 搜索正在制造新的可见度瓶颈
@alexgroberman把问题说得很直白:如果品牌不在 AI 的检索池里,它就进不了候选清单,买家也就根本看不到它。他的帖子称,不同助手之间的引用率差距可能高达约 46 倍,这使“AI 搜索”变成了一个大多数团队尚未配备相应人员的分发问题。严重程度:中。当前的应对办法是产出更多专家内容、积累更多第三方权威信号,并在各平台上做明确的引用审计。
基准测试仍遗漏了太多真实部署问题
@emollick呼吁出现机器人领域对应的独立 AI 基准,因为演示视频并不能清楚、可比地展示进展。Alibaba Cloud 的 HappyHorse 发布下面有一条回复也对视频模型提出了类似观点,认为速度和 headline benchmark 不如对真实风格的可控性与微调能力重要。严重程度:中。人们的应对方式是更多依赖特定任务评测、更有原则的后训练,以及更窄领域的测试,而不是相信泛化的营销说法。
3. 人们希望存在什么
面向 agent 产品、可预测且低成本的运行时层
Hy3 的使用量增长、SputnikInt 围绕中国模型的成本叙事,以及 Bencera 的 100 万美元模型账单,都指向同一个缺失层:一种既能支持更高自主性、又不至于摧毁利润率的基础设施。这是一项现实而紧迫的需求,因为需求信号已经出现。机会:直接。
跨平台 AI 引用情报
Groberman 的帖子表明,AI 介导的发现已经足够不均衡,足以产生商业影响,但大多数品牌仍不知道自己在 ChatGPT、Perplexity、Gemini 或 Copilot 里究竟是什么样子。SEO Stuff 这类工具已经存在,但更广泛的需求,是一个可靠的系统,用来监测、调试并提升品牌在各类助手中的引用份额。机会:竞争性。
面向机器人、视频及其他具身系统的真实世界评测
Emollick 关于机器人的帖子,以及人们对视频模型夸耀式宣传的怀疑,都明确指出了基准测试的缺口。团队需要的是能够跟踪有用的无人监督行为、控制质量和故障恢复能力的测量方式,而不是精心打磨的演示,或单一数字的排行榜。机会:竞争性。
面向 AI 产品团队、以人为本的实施工具包
AI 工程路线图帖子和 People + AI Guidebook 都指向同一个愿望:为反馈闭环、控制界面、可解释性、可观测性和优雅失败提供具体的默认方案。与其说这是一种情绪化愿望,不如说它是那些已经明确在交付 AI 的团队所缺失的一项运营标准。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Qwen / Kimi K2.6 / Hy3 Preview | 基础模型栈 | (+) | 推理成本低、具备本地微调吸引力,并在编码/工具调用使用量上有强势说法 | 信任、治理和采用证据仍然不一,混杂着厂商发帖与评论观点 |
| Constitutional SDF + stories | 对齐方法 | (+) | Anthropic 显示其在多个评测类别上显著降低了失调程度 | 仍主要面向基准测试,而非公开产品遥测 |
| Efficient Exploration at Scale | RLHF 方法 | (+) | 声称在 20K 比较数据下实现 10 倍标签效率提升,且规模更大时收益更高 | 仍属研究阶段,尚需生产环境验证 |
| SEO Stuff / GEO auditing | AI 搜索可见度工具 | (+/-) | 让助手引用和检索可见度变得可测量、可执行 | 高度依赖自我宣传式证据,以及大量内容和反向链接投入 |
| HappyHorse 1.0 | 视频模型 | (+/-) | 通过 Alibaba Cloud Model Studio 实现快速图生视频和原生音视频同步 | 速度和基准优势并不能解决质量、风格控制或真实工作流适配问题 |
| People + AI Guidebook | 设计框架 | (+) | 将用户需求、可解释性、反馈和故障处理转化为明确清单 | 仅提供指导;团队仍需自行构建实际系统和流程 |
| DeepSeMS | 科学 AI 系统 | (+) | 公共 Web 服务器、可下载数据和开放代码,展示了超越聊天的真实发现工作流 | 科学领域较窄,公开采用证据仍处于早期 |
总结: 当方法足够具体时,情绪最为积极:更低的推理成本、可测量的安全收益、明确的工程路线图,以及公开的科学工具。若证据仍主要停留在基准营销,或自主性的经济性看起来并不稳定,情绪就会转为复杂。总体迁移趋势是:从泛泛的 AI 热情,转向运营层面的关切——成本、引用、评测和产品纪律。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Polsia | @Bencera | 处理复杂代码库中日益自主化工作的 AI 产品 | 按当前模型价格,交付有用的自主性成本过高 | 基于 Anthropic 的 agent 工作流,大量使用 GPU | 已上线 | 帖子 |
| SEO Stuff | @alexgroberman | 审计并提升品牌在 ChatGPT、Claude、Perplexity 和 Google AI 中的可见度 | 当助手不引用品牌时,品牌会错失 AI 引荐流量 | 可见度审计、长文内容生产、编辑型反向链接 | 已上线 | 网站, 帖子 |
| HappyHorse 1.0 | @alibaba_cloud | 通过 Model Studio 销售、支持原生音视频同步的图生视频模型 | 视频生成排队和动态渲染能力不足拖慢团队进度 | Alibaba Cloud Model Studio、图生视频、API/SDK 集成 | 已上线 | 产品页面, 帖子 |
| Standout Agent | @heyenzoexe | 扫描人才、向初创公司推荐候选人并安排会面的 agent | 对供需双方而言,科技人才发现过程都充满噪声且高度不对称 | 初创公司扫描、排序、触达和日程安排自动化 | 已上线 | 发布帖, 评论 |
| DeepSeMS | Xu et al. / @pacyc1841 | 基于 LLM 的系统和公共 Web 服务器,用于发掘海洋微生物组中隐藏的生物合成潜力 | 研究人员需要一种方法,从庞大的生物序列空间中挖掘发现信号 | 大语言模型、公共数据集、Web 服务器、开源代码 | Beta | 论文, GitHub, 帖子 |
这些项目的构建模式分成三类。Polsia 围绕自主性本身的经济性展开。SEO Stuff 和 Standout 围绕 AI 介导的分发与发现展开。HappyHorse 和 DeepSeMS 则体现了第三种模式:领域专用产品的价值来自更快的创意产出或更精准的科学搜索,而不是通用聊天机器人的行为。
6. 新动态与值得关注的进展
AI 搜索开始像一个可测量的获客渠道
Groberman 的帖子之所以值得关注,不是因为 AI 引荐流量已经非常庞大,而是因为它现在正在被运营化。他的截图和引用的数据集把 ChatGPT 描绘成主导性的 AI 引荐来源,并指出引用可见度会因平台不同而剧烈波动——而这正是催生新工具类别的那种不对称性。(来源)
医疗与科学 AI 继续给出领域专属证据,而不只是泛化的助手炒作
@ScienceMagazine 报道称称,在早期急诊病例中,LLM 给出正确诊断或非常接近诊断的比例约为 67%,而医生约为 50%-55%;DeepSeMS则已经发布了一个公共 Web 服务器和开源代码,用于海洋微生物组发现。这些进展值得关注,因为它们看起来更像专门化工作流,而不是通用聊天机器人演示。
7. 机会在哪里
[+++] 面向自主产品的更低成本运行时经济性 — Bencera 的模型账单、thdxr 对 capex 的叙事,以及更低成本中国模型栈日益增强的吸引力,都指向同一个约束:有用的自主性已经存在,但成本仍在阻碍其更广泛采用。
[++] AI 搜索可见度与引用分析 — Groberman 关于 AI 引荐的论点,以及 SEO Stuff 这类产品的存在,表明市场确实需要能够监测、调试并提升品牌在各类助手中存在感的工具。
[++] 真实世界评测基础设施 — Anthropic 的失调图表、DeepMind 的标签效率研究,以及 Emollick 提出的机器人基准问题,都表明更好的评测正在成为独立的产品与研究界面。
[+] 以人为本的部署工具 — People + AI Guidebook 和 AI 工程路线图帖子表明,团队越来越需要把用户体验、可观测性、控制和优雅失败转化为交付 AI 时的运营默认项。
8. 要点
- AI 讨论如今既是技术问题,也是经济问题。 低成本中国模型的叙事、Hy3 的使用量说法、Polsia 的 100 万美元模型账单,以及对超大规模云厂商资本开支的比较,都表明成本与可部署性正成为核心决策变量。(Chinese-stack 框架, Hy3 用法, Polsia)
- 当前最强的安全进展,来自更好的数据和更好的测量。 Anthropic 基于故事的对齐结果、DeepMind 关于标签效率的说法,以及围绕机器人基准的争论,都在强化同一个观点:评测质量正成为一个核心杠杆,而不再只是事后补充。(Anthropic, DeepMind 摘要, 基准测试串文)
- AI 采用正在变成一项运营纪律。 引用份额、工程路线图、可观测性和以人为本的设计,如今出现在同一场对话中,这表明成熟团队正在从“使用 AI”迈向“把 AI 运营好”。(AI 引荐流量, 路线图, 指南)